著者注:Agentの長期タスクにおけるToken料金の内訳を分解し、入力Tokenが大部分を占める理由と、プレフィックスキャッシュの再利用率を高めるためのコンテキスト構成の調整方法を解説します。
多くのチームが、複数ステップを実行するAgentを製品に組み込んだ後、月末の請求書を見て問題に気づきます。ユーザーからの依頼は1つだけなのに、消費したTokenは通常の会話の数十倍。まず「モデルの出力が冗長すぎる」と考え、出力の長さを抑えようとしがちです。しかし、実際に大部分を占めるのは入力側で、主な原因は毎回のラウンドで再び渡す必要がある過去のコンテキストです。
これは経験則に基づく推測ではありません。最近公開されたエンジニアリング事例では、具体的なデータが示されています。中国国内の本番環境では、1回のユーザーリクエストにつき平均約7.2回のモデル呼び出しが発生します。また、50ステップの呼び出しチェーンでは、入力Tokenが約99.4%を占め、出力はわずか約0.6%です。推論エンジンの開発チームも、Agentのワークロードを「長いプレフィックス、短い出力、複数ラウンドのループ」と同様に説明しています。
この記事でわかること:Agentの長期タスクにおけるToken料金の内訳を把握し、プレフィックスキャッシュがコスト削減につながる理由を理解できます。さらに、アプリケーション側ですぐに実践できる、コンテキストの整理方法を5つ紹介します。
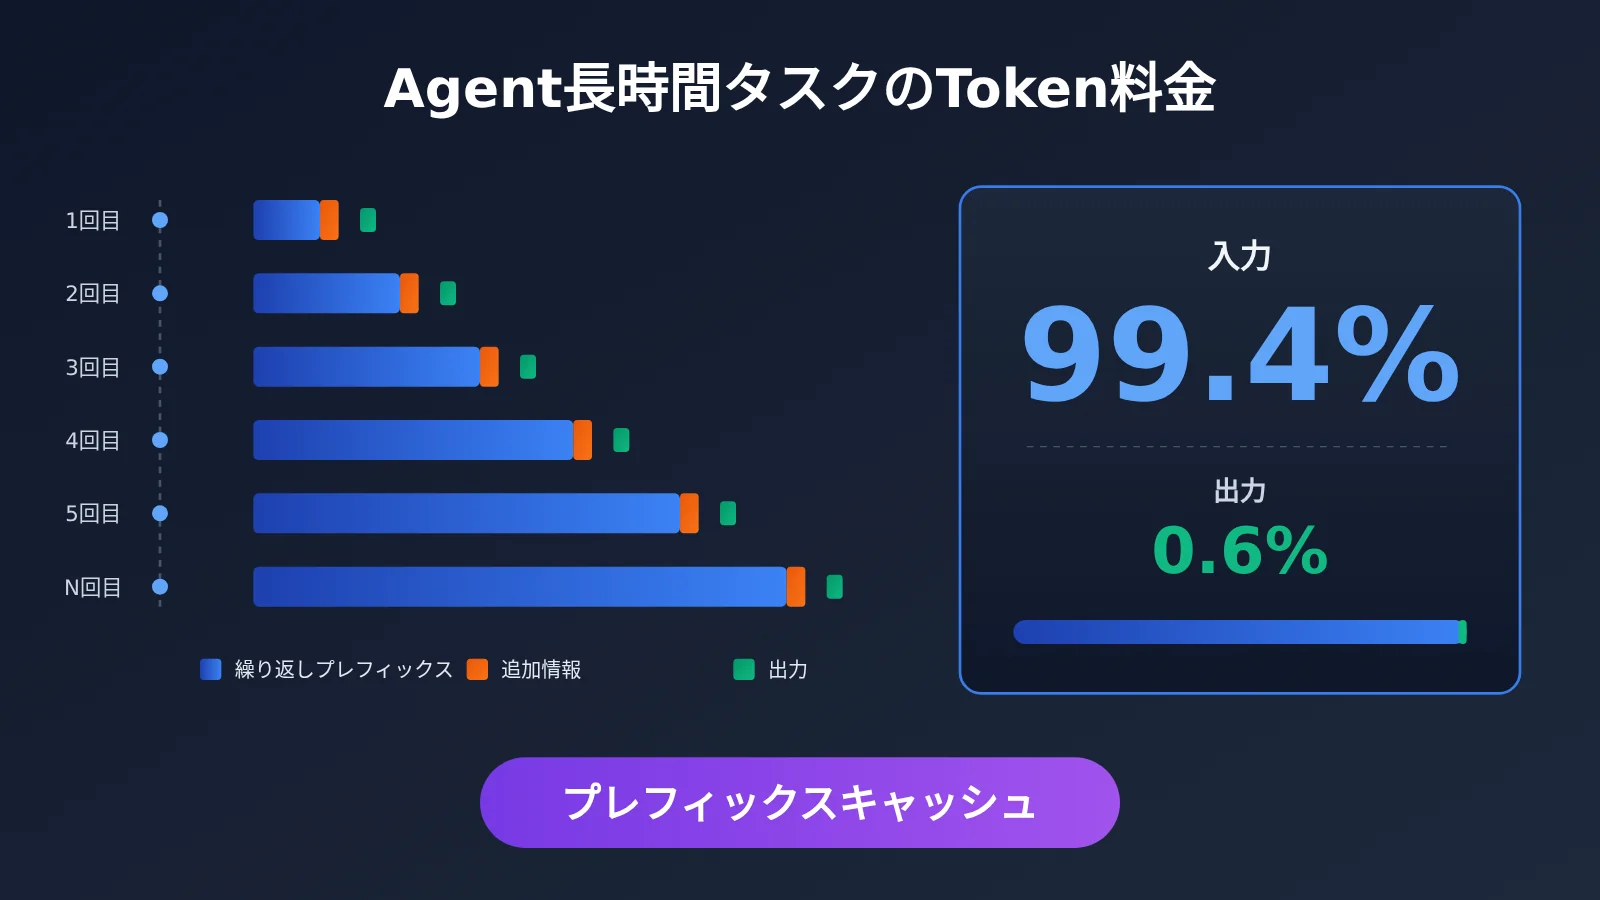
Agentの長時間タスクにおけるトークン料金の要点
まずはこの記事の結論を表にまとめます。各項目については、後のセクションで詳しく解説します。
| 要点 | 説明 | 押さえておきたいこと |
|---|---|---|
| 呼び出し回数が増える | ユーザーからの1回のリクエストに対して、モデル呼び出しは平均約7.2回。複雑なタスクでは50ステップを超えることも珍しくない | コストは「リクエスト」単位ではなく「タスク」単位で見積もる |
| 入力が大半を占める | 50ステップの呼び出しチェーンでは、入力が約99.4%、出力が約0.6%を占める | コスト削減には入力への対策を優先する。出力の削減だけでは効果が限られる |
| 主な原因はコンテキストの繰り返し | 各ステップで過去のコンテキストが再び渡され、同じ内容に繰り返し料金が発生する | 本当のコスト要因を把握できる |
| プレフィックスキャッシュを再利用できる | 同じプレフィックス部分がキャッシュにヒットすれば、prefillの計算を繰り返さずに済む | 構造が安定したコンテキストはコストを抑えやすい |
| 構造がキャッシュヒット率を左右する | プロンプトやツールの構造を固定し、変化する情報は末尾に置き、適切なタイミングで履歴を圧縮する | モデルを変更しなくてもコストを削減できる |
Agentの長時間タスクで発生するトークンコストを詳しく解説
Agentと通常のチャットの最大の違いは「ループ」にあります。たとえばPPT資料の作成では、システムは資料の読み込み、内容の構成、各ページの生成、ツールを使った資料の作成、結果の確認を順に行います。ユーザーから見ると1つのタスクですが、システム内部では複数回の推論とツール呼び出しが行われます。各ステップでコンテキストが再び読み込まれることもあり、結果が不十分なら前の工程に戻って修正します。
各回の呼び出しでモデルに渡されるのは、「システムプロンプト + ツール定義 + それまでの全履歴 + 今回の新しい情報」です。履歴はどんどん長くなる一方、各回で追加される内容はわずかです。数十回のやり取りを重ねると、同じプレフィックスに数十回分の料金が発生します。入力の割合が99.4%に達するのは、この積み重ねによるものです。
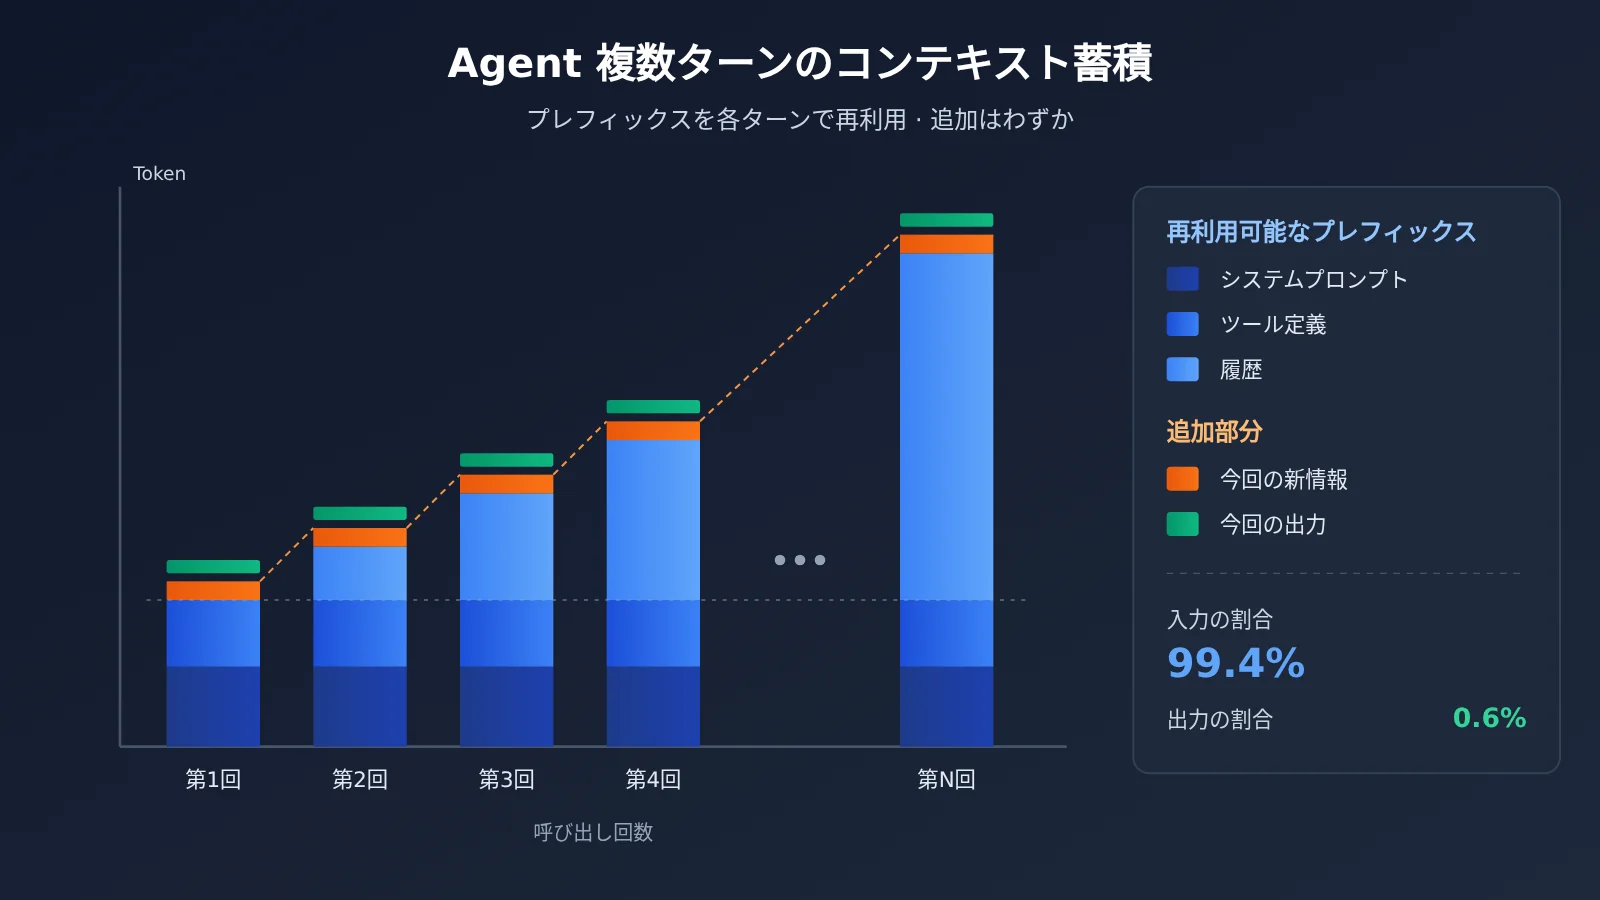
なぜ Agent の長時間タスクでは入力 Token が出力よりはるかに多いのか
推論エンジンの側から見ると、その構造がよりはっきりします。TokenSpeed の発表では、coding agent を例に挙げています。モデルは思考し、ツールを呼び出し、結果を受け取って、また思考を続けます。このプロセスは、短いリクエストを何度も繰り返すことで成り立っています。最初のリクエストには数十 K のプレフィックスコンテキストが含まれることもありますが、その後の各サイクルでの出力は、多くの場合、数百 token にとどまります。
下表では、チャットのワークロードと Agent のワークロードを比較しています。自分のアプリケーションがどちらに近いか、判断する参考にしてください。
| 観点 | 従来の Chat ワークロード | Agent の長時間タスクのワークロード |
|---|---|---|
| リクエストの形式 | 一問一答で、完全な回答を一度に生成 | 短いリクエストを繰り返し、途中でツールを呼び出す |
| プレフィックスの長さ | 通常は短め | 開始時点で数十 K に達することもあり、サイクルごとに増加 |
| 1 サイクルあたりの出力 | 比較的長い | 多くの場合、数百 token にとどまる |
| コンテキストの再利用 | 一度読み込んだ後に解放 | 同じプレフィックスをタスク内で繰り返し送信 |
| コストの主な内訳 | 入力と出力の両方が相応の割合を占める | 入力、特に繰り返し送信されるプレフィックスが大部分を占める |
Agent の長時間タスクでプレフィックスキャッシュはどう機能するか
推論エンジンによるリクエストの処理は、2 つの段階に分かれます。prefill 段階では入力全体を計算して KV Cache を生成し、decode 段階では出力 token を一つずつ生成します。Agent のシナリオでは、数十 K のプレフィックスをサイクルごとに prefill する必要があり、この計算がコストの原因となります。同じプレフィックスをすでに計算済みで、その結果がキャッシュに残っていれば、直接再利用することで、その部分の prefill を省けます。
推論エンジンの開発チームは、KV Cache の再利用率を推論コストを左右する重要な変数と捉えています。発表によると、DeepSeek のキャッシュ再利用率は 99% 以上とされ、業界の多くのシステムでは現在 70% から 80% の間です。Agent のワークロードでは、prefill 時のプレフィックスのキャッシュヒット率は通常 90% 以上で、ヒットすれば数百 token を追加で計算するだけで済みます。
もう一つ、見落としがちな点があります。プレフィックスキャッシュは先頭から順に照合されます。TokenSpeed は初期に SGLang を参考にし、Radix Tree を使ってプレフィックスキャッシュを管理していました。ツリー上の各ノードは token 列の一部分に対応し、リクエストはルートから照合されます。その後、Flat KV の設計に変更されましたが、再利用は引き続き固定サイズの論理ブロック(128 token)単位で行われます。アプリケーション開発者にとっての結論は明快です。途中で 1 token でも異なると、それ以降の内容は再利用できません。
コンテキストを整理して Agent の長時間タスクにおけるプレフィックスキャッシュのヒット率を高める
キャッシュの照合方法を理解すれば、最適化の方向性は明確です。各リクエストの先頭部分をできるだけ長く、変わらないようにします。WorkBuddy チームは、プロンプトとツール構造を固定し、変化する情報をコンテキストの末尾に置く方法を採用しています。コンテキストが長くなったら、履歴を圧縮します。具体的には、次の5つの方法があります。
| 方法 | 具体的なアクション | よくある反例 |
|---|---|---|
| 1. システムプロンプトを固定する | システムプロンプトを一字一句変えず、バージョン変更はまとめてリリースする | 先頭に現在時刻、ユーザー名、ランダムな例を挿入する |
| 2. ツール構造を固定する | ツール一覧の順序とパラメータの説明を変えない | 各ターンで必要に応じてツールを追加・削除したり、シリアライズの順序が安定していなかったりする |
| 3. 変化する情報は末尾に置く | タイムスタンプ、今回の観察結果、動的な状態を最後に追加する | 「現在の進捗」をシステムプロンプトの先頭に書く |
| 4. 履歴は追加のみで書き換えない | 送信済みの履歴はそのままにし、新しい内容だけを末尾に追加する | 各ターンで過去のメッセージを再整形したり、並べ替えたりする |
| 5. 履歴を段階的に圧縮する | コンテキストが長くなりすぎたらチェックポイントで一度圧縮し、その後は再び追加する | 各ターンで要約を再生成し、プレフィックスが毎回変わってしまう |
プロンプトとツール構造を固定する Agent の長時間タスクの実践
1と2は特に見落とされがちです。多くのフレームワークでは、システムプロンプトに現在の日付を組み込んだり、ステップに応じてツールを動的に選んだりします。どちらも先頭部分が各ターンで変わるため、プレフィックスキャッシュが最初のトークンから使えなくなります。
より確実なのは、システムプロンプトにはルールと役割だけを置き、日付などの情報は通常のメッセージとして末尾に追加する方法です。ツールは全種類を一度に列挙し、ツール一覧自体を変更するのではなく、プロンプトで「この段階ではどのツールだけを使うか」を指定します。
シリアライズの方法にも注意が必要です。同じツール定義でも、JSON のフィールド順がプロセスごとに異なれば、バイト単位では異なるプレフィックスになります。ツール定義を一定の順序に並べてから送信し、プレフィックスのハッシュ値をログに記録しておくと、「変更していないはずなのにヒットしない」というケースを調査しやすくなります。
履歴の圧縮とキャッシュ再利用のトレードオフ
5には検討すべきトレードオフがあります。履歴を圧縮すると入力は短くなりますが、圧縮によってプレフィックスが変わるため、そのターンでは必ずキャッシュがミスします。毎ターン圧縮すれば、そのたびにキャッシュの再利用を放棄することになります。
そこで、コンテキストが一定の長さに達したときや、サブタスクが終わったときに一度圧縮する、といった基準を設けるのが合理的です。圧縮後の内容を新たな安定したプレフィックスとし、その後は書き換えずに追加だけを続けます。
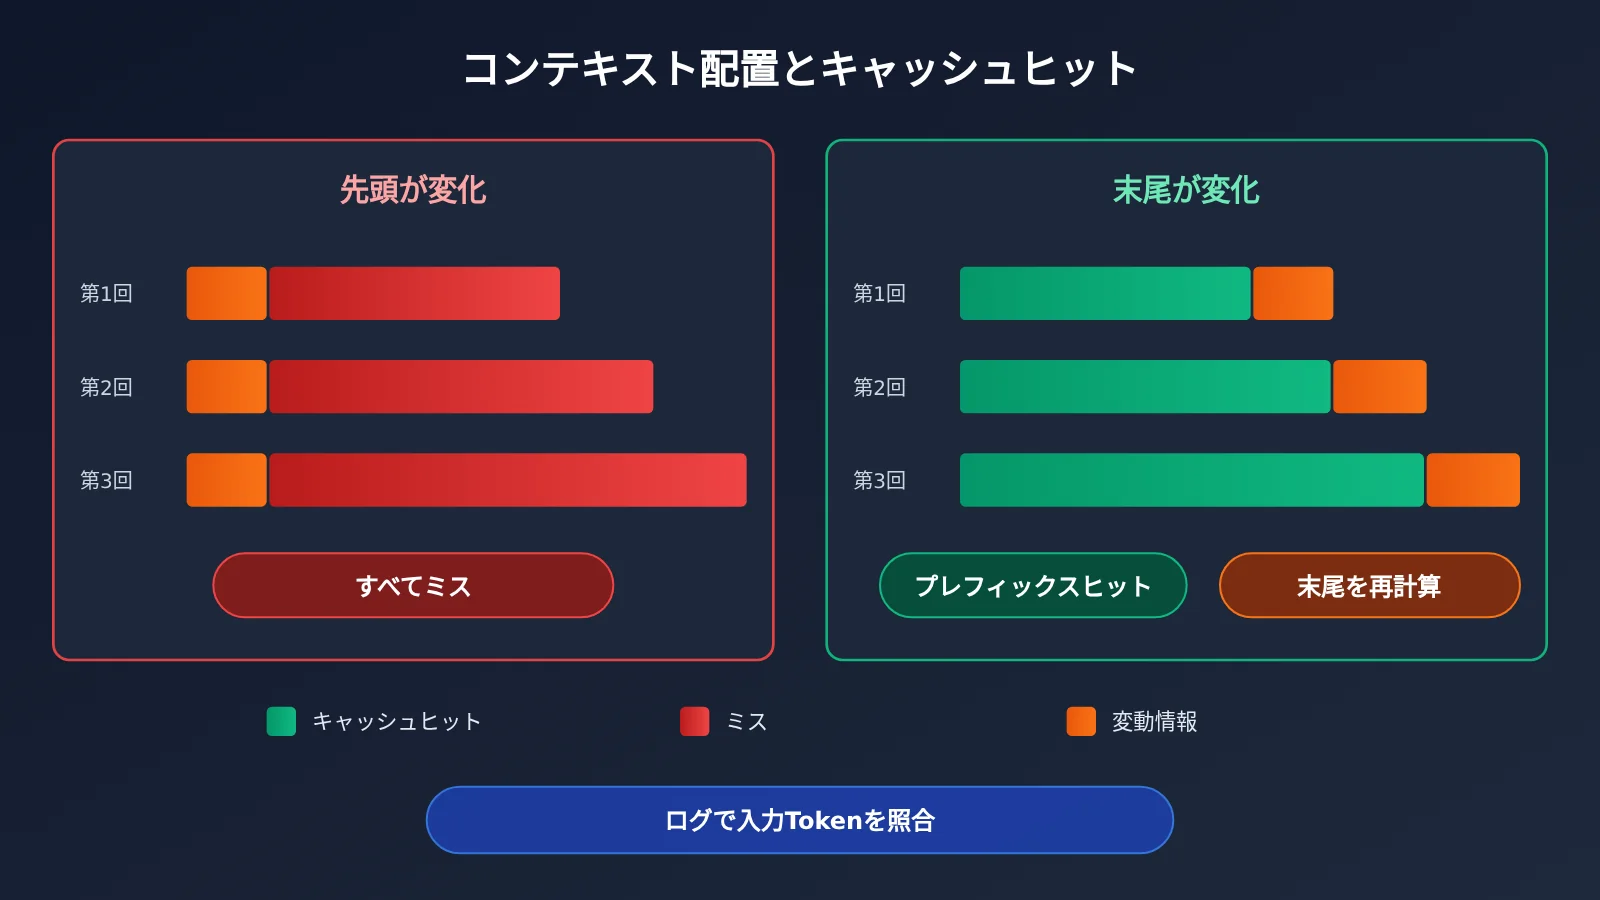
上図の2つの配置は、単発のリクエストだけを見るとほとんど違いがありません。しかし、数十ターンにわたる長時間タスクでは、請求額に明確な差が生じます。自分のアプリケーションがどちらに当たるかを確認するには、呼び出しログで各ターンの入力トークンの変化を見るのが最も直接的です。APIYI apiyi.com は統一請求、使用量の統計、呼び出しログを提供しており、複数のモデルのデータを一か所で比較できます。このような請求額の内訳を調べる際に役立ちます。
Agentの長時間タスクでTokenコストを最適化するためのクイックスタート
このセクションではコードを使わず、実践できる確認手順を紹介します。順番に進めてみましょう。
ステップ1:Token使用量をタスクごとに集計する
- ユーザーのタスクごとにタスクIDを生成し、そのタスク内のモデル呼び出しをすべてIDとともにログへ記録します。
- 各レスポンスの
usage情報から、入力・出力Token数を記録します。プロバイダーによっては、キャッシュにヒットしたToken数も別途返されます。具体的なフィールド名は公式ドキュメントを確認してください。 - タスクごとに、呼び出し回数、入力・出力の比率、キャッシュヒット率の3つを集計します。
複数のモデルを併用している場合、ログの記録基準が統一されていないことがよくあります。APIYIを通じて一元的に接続すれば、同じコンソールで各モデルの使用量の詳細や呼び出し履歴を確認できます。自分で記録したタスクIDと組み合わせることで、「各タスクにいくらかかり、どのステップでコストが発生したか」を全体的に把握できます。
ステップ2:プレフィックスが変わる箇所を特定する
- 同じタスクの連続する2回のリクエストを取り出し、システムプロンプト、ツール定義、過去のメッセージが一字一句同じかどうかを部分ごとに比較します。
- タイムスタンプ、乱数、ユーザーの状態といった動的なフィールドがどこに現れるかを重点的に確認します。
- ツール定義とメッセージのシリアライズ順序が、複数のリクエスト間で安定しているかを確認します。
ステップ3:5つの方法に沿って調整し、再テストする
- 動的な内容を末尾に移し、システムプロンプトとツール一覧を固定します。
- 履歴を圧縮するしきい値を設定し、毎ターンではなくチェックポイントで圧縮するように変更します。
- 同じテストタスク群を使って変更前後のバージョンを実行し、1タスクあたりの入力Token数とキャッシュヒット率を比較します。
🚀 実践のヒント:変更前後の比較は、必ず同じタスク群と同じモデルを使って行いましょう。条件が異なると、データを比較する意味がなくなります。APIYIの統一インターフェースを使えば、モデルを変えて再テストする際に個別のインターフェースへ対応する必要がありません。使用量の統計も一か所にまとまるため、「構造の最適化」と「モデルの違い」という2つの変数を分けて確認できます。
コスト試算の注意点
WorkBuddyは、自社のタスク規模とTokenHubのフラッグシッププランの定価に基づく試算を公表しています。それによると、キャッシュヒット率が90%に達した場合、1タスクあたりの推定コストは約21.06元から約3.36元に下がります。ただし、この数字は特定のコンテキスト長と料金条件に基づくものです。すべての条件は公開されておらず、再計算できないため、そのまま自分のアプリケーションに当てはめることはできません。
| 影響する要因 | 結果が変わる理由 | 確認すべきこと |
|---|---|---|
| コンテキスト長 | プレフィックスが長いほど、キャッシュの再利用による削減効果が大きい | 自分のタスクの平均プレフィックス長 |
| キャッシュの課金方式 | キャッシュヒット部分の割引率はプロバイダーによって異なる | 対象モデルの公式ドキュメントに記載されたキャッシュ料金 |
| キャッシュの適用条件 | 最小長や有効期間などのルールはそれぞれ異なる | 公式ドキュメントに記載された適用・期限切れのルール |
| 呼び出し間隔 | 2回の呼び出しの間隔が長すぎると、キャッシュが期限切れになっている可能性がある | ツールの実行時間とキャッシュの有効期間が合っているか |
| タスクのステップ数 | ステップ数が多いほど、繰り返されるプレフィックスの累積量が大きくなる | 実際のタスクにおけるステップ数の分布 |
Agentの長時間タスクでTokenコストを抑えるための併用策
コンテキストの構成に加えて、同じ共有資料では、プレフィックスキャッシュと併用できるアプリケーション側の施策が2つ紹介されています。
- ステップごとにモデルを選ぶ:WorkBuddyチームによると、単純なステップの約8割を軽量モデルに任せることで、タスクあたりのコストを約57%削減できたそうです。資料の整理や形式変換などには、必ずしも最上位モデルは必要ありません。
- 障害の原因に応じて対処する:タイムアウト、リクエストの拒否、プロバイダーの障害などが発生したら、原因に応じてリトライ回数を制限したり、コンテキストを調整したり、モデルを切り替えたりします。無制限にリトライすると、同じ長いプレフィックスに繰り返し課金されます。
なお、モデルを切り替えるとキャッシュも別になるため、プレフィックスの再利用は最初からやり直しになります。そのため、ルーティングを設計する際は、同じサブタスクの連続したステップをできるだけ同じモデルで処理し、モデルの切り替えはサブタスクの境界で行うのがおすすめです。
よくある質問 FAQ
Q1: Agentの長時間タスクにおけるプレフィックスキャッシュとは何ですか?
プレフィックスキャッシュとは、推論サービスが計算済みの入力プレフィックス(KV Cache)を保存し、後続のリクエストの先頭が同じ場合に再利用することで、その部分のprefill計算を省く仕組みです。Agentは各ラウンドで同じ長い履歴を送るため、特に再利用に適しています。
Q2: プレフィックスキャッシュと過去のコンテキストの圧縮はどう違いますか?
プレフィックスキャッシュは入力内容を減らさず、繰り返される部分の計算コストを抑えます。一方、履歴の圧縮は入力を直接短くしますが、プレフィックスが変わるため、そのラウンドではキャッシュが使えなくなります。両者を組み合わせ、通常は追記のみでキャッシュヒットを維持し、チェックポイントでまとめて圧縮するとよいでしょう。
Q3: 入力が99.4%を占めるという割合は、すべてのAgentに当てはまりますか?
必ずしもそうではありません。この数値は、50ステップの呼び出しチェーンに関する共有事例から得られたものです。ステップ数が少ないタスクや、1ラウンドあたりの出力が長いタスクでは、入力の割合は低くなります。ただし、「長いプレフィックス、短い出力、複数ラウンドの繰り返し」という構造であれば、通常は入力が大部分を占めます。ご自身のログで実測することをおすすめします。
Q4: プレフィックスキャッシュの最適化が特に効果的なAgentの用途は何ですか?
– **コーディングAgent**:リポジトリのコンテキストが長く、ファイルの読み取り、コードの変更、テストの実行を頻繁に繰り返す
– **文書やPPTの生成**:資料を読み込んだ後、ページごとに生成するため、プレフィックスの重複が多い
– **データ分析Agent**:テーブル構造や指標の説明が固定され、各ラウンドでクエリ結果だけが追加される
Q5: 自分のアプリケーションの入力・出力Tokenの内訳を手早く把握するにはどうすればよいですか?
最も簡単な方法は、タスクIDごとに各ラウンドのusageデータを集計することです。複数のモデルを利用している場合は、APIYI apiyi.comを通じて一元的に呼び出せます。プラットフォームには使用量の統計と呼び出しログが用意されているため、モデル別や期間別に入力・出力の内訳を確認できます。各モデルのプロンプトキャッシュへの対応状況や課金方式については、プラットフォームのドキュメントをご確認ください。
Q6: プレフィックスキャッシュにはどのような既知の制限がありますか?
– 最小長や有効期間などの適用条件はプロバイダーごとに異なるため、それぞれの公式ドキュメントを確認する必要がある
– ツールの実行に時間がかかりすぎると、次のラウンドが始まる前にキャッシュの有効期限が切れることがある
– モデルの切り替えやシステムプロンプトの変更によって、キャッシュ全体が使えなくなる
– キャッシュヒットした部分の割引率はモデルによって異なるため、削減幅は実測して確認する必要がある
Agentの長時間タスクにおけるToken請求の要点 Key Takeaways
- コストはタスク単位で考える:1回のリクエストで平均約7.2回の呼び出しが発生し、長時間タスクでは50ステップを超えることもある
- 主な課題は入力:50ステップの処理では入力が約99.4%を占め、出力を削減しても効果は限定的
- キャッシュは先頭から照合される:先頭付近で1 Tokenでも異なると、それ以降の内容は再利用できない
- モデルより構造が重要:プロンプトとツールの構造を固定し、変動する情報は末尾に置く
- 圧縮のタイミングを決める:チェックポイントで一度圧縮し、毎回プレフィックスを書き換えない
- 試算結果をそのまま外挿しない:公開されているコストは特定の長さと価格に基づくため、自分の環境で再測定する必要がある
- まず観測してから最適化する:APIYIの使用量統計と呼び出しログを使い、請求の内訳を把握する
まとめ
Agentの長時間タスクにおけるToken請求の結論は、次のとおりです。
- 請求の内訳:コストの大半は、各ラウンドで繰り返し渡される過去のコンテキストに由来し、入力Tokenがその大部分を占めます。
- コスト削減の仕組み:プレフィックスキャッシュにより、繰り返されるプレフィックスのprefill計算を省けます。キャッシュヒット率はコンテキストの構造によって決まります。
- 実践方法:プロンプトとツールを固定し、変動する情報は末尾に置き、履歴は追加のみにします。さらに、段階的な圧縮とステップごとのモデル選択を組み合わせます。
まずは1週間かけてログをタスク単位で分析し、入力の割合とキャッシュのヒット状況を確認することをおすすめします。そのうえで、本文の5つの方法を一つずつ実践してみてください。複数のモデルを利用する場合は、APIYI(apiyi.com)を通じて統一的にアクセスし、使用量と呼び出し記録をまとめて確認できます。同じデータを使って、各最適化の実際の効果を評価しましょう。
📚 参考資料
- Agentic推論に向けた次世代LLM推論エンジンの構築:AICon 2026深圳でのTokenSpeedの発表をまとめた記事
- リンク:
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
内容:Agentのワークロードに見られる「長いプレフィックス、短い出力」という特徴や、KV Cacheの再利用率、プレフィックスキャッシュの構造設計を紹介
-
モデル呼び出しからタスクの完遂へ:MaaSはいかにAgentの本番環境に入り込むのか:Tencent CloudのMaaS特集をまとめた記事
- リンク:
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - 内容:WorkBuddyが紹介した呼び出し回数、入力の割合、プレフィックスキャッシュ、モデルルーティングに関するデータを掲載
著者: APIYI 技術チーム
技術交流: 複数モデルの呼び出しや利用量の分析については、APIYI apiyi.com からお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。