著者注:SemiAnalysis が公開した GDPx 初回ランキングを読み解き、トップモデルのスコアと「平均タスクコスト」を比較します。評価コストと公式のトークン価格の違いも整理し、能力・コスト・利用可能性の3つの観点から、モデル選定の第一歩をサポートします。
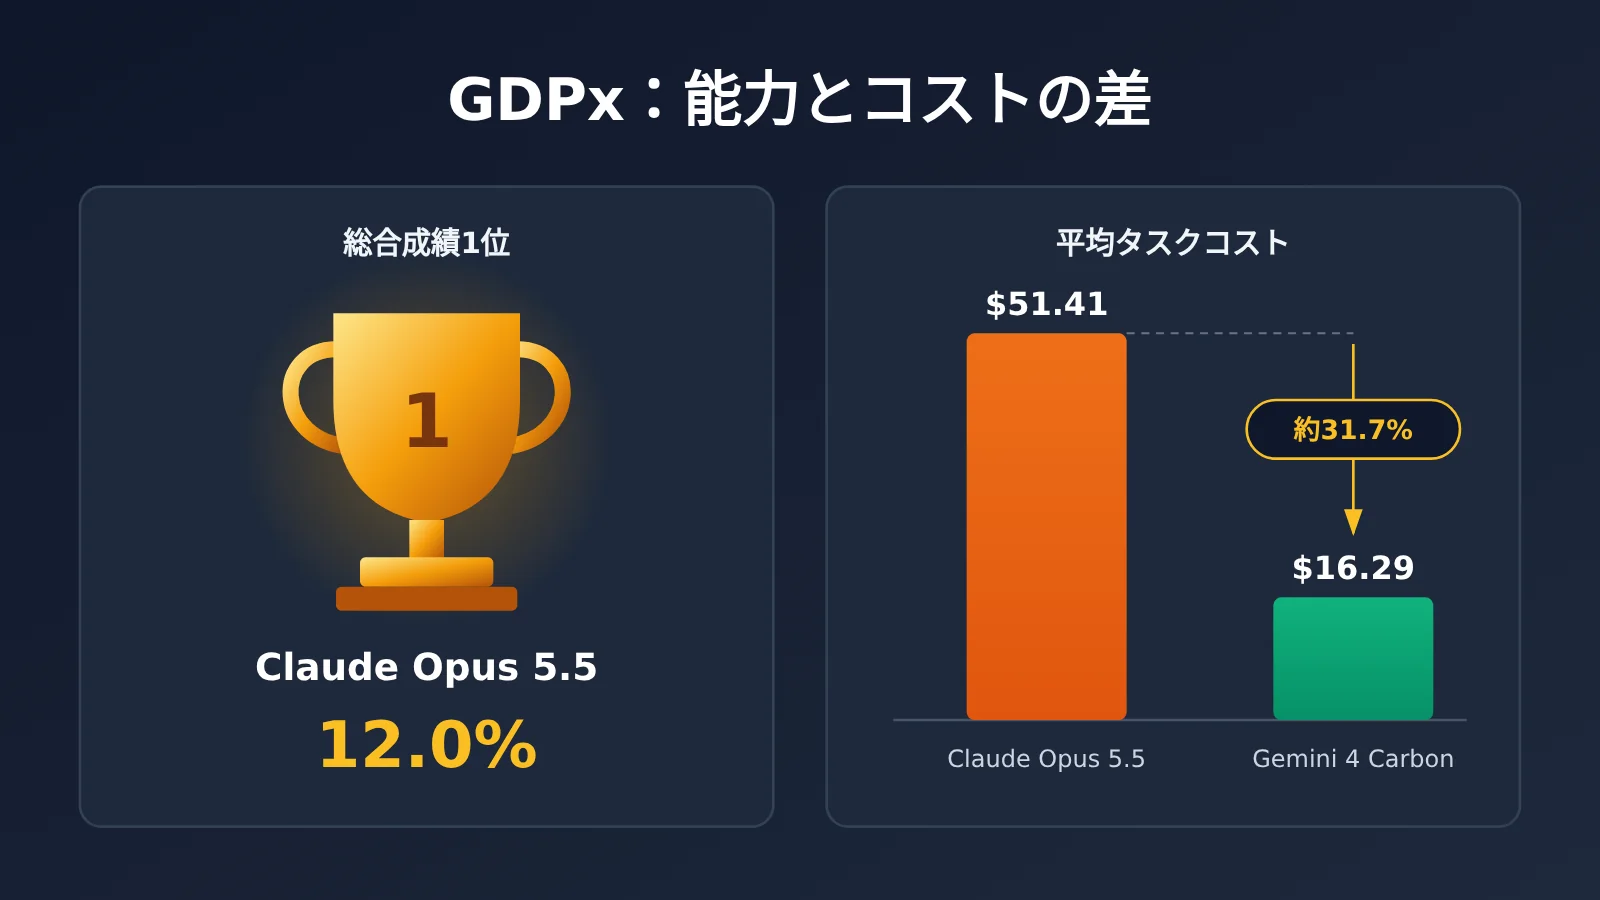
2026年11月2日、SemiAnalysis は高難度のエージェントベンチマーク GDPx v1.0 を公開しました。Claude Opus 5.5 が総合スコア 12.0% で首位に立ち、Gemini 4 Carbon が 10.9% で続いています。さらに注目したいのがコストです。Carbon の平均タスクコストは Opus の約31.7%にとどまる一方、スコアは Opus の約90.8%に達しています。
これは単なるうわさではありません。これらのデータは GDPx の公式ランキングと SemiAnalysis の元レポートに基づいており、公式サイトでは代表的な14タスク、計168件の実行トレースも公開されています。ただし、このランキングは誤解されやすい点に注意が必要です。「平均タスクコスト」は API 価格ではなく、「12%」も現実の仕事における AI の成功率ではありません。
この記事のポイント:GDPx 初回ランキングにおけるコストと能力のデータを整理し、GDPx の評価コスト、各社の公式トークン価格、APIYI のドキュメント記載価格という3つの価格を明確に区別します。総合順位と実際の調達先の選択が、なぜ一致するとは限らないのかを理解できます。
GDPxの基本情報
GDPxの正式名称は「Measuring Frontier Model Capabilities Across the Most Valuable Domains」で、「経済的価値の高い領域における最先端モデルの能力を測定する」という意味です。知識を問う試験ではなく、Agentが実際の、または実環境に近い専門的な環境で、ツールやソフトウェアを使いながら、長時間にわたるタスクを独力で完了できるかを測ります。
| 項目 | 詳細 |
|---|---|
| 公開日 | 2026-11-02(v1.0) |
| 公開元 | SemiAnalysis(著者:Max Kan、Andrew Megalaa、Dylan Patel) |
| タスク規模 | 11の専門領域、14のデータパートナー、206のタスク |
| 実行条件 | 原則として各タスクの上限は8時間。一部はそれより短い。pass@1を推定するため、各タスクを独立して3回実行 |
| 評価方法 | 二値評価と連続評価を併用し、11領域を等しく重み付け |
| 実行フレームワーク | OpusはClaude Code、AstraはCodex、CarbonはAntigravity、その他のモデルはOpenCodeを使用 |
| 更新予定 | 公式は3〜6か月ごとに新バージョンを公開する予定 |
特に注意したいのは、GDPxが測定するのは「モデル+Agentフレームワーク+ツール+環境」の総合的な性能であり、モデル単体の推論能力ではないという点です。総合スコアは領域ごとの等しい重み付けと複数の評価方式を組み合わせて算出されるため、「206問中何問正解したか」には換算できません。
GDPx ランキング:スコアとタスクあたりの平均コスト
以下の表は、公式サイトにデフォルトで表示される 13 モデルをまとめたものです(フィルターには全部で 20 種類のテスト設定があります)。最後の列には、APIYI の公開モデルドキュメント(2026-10-27 時点の価格スナップショット)に該当モデルが掲載されているかを、検索の参考として記載しています。
| 順位 | モデル | GDPx 総合スコア | GDPx 平均コスト(米ドル/タスク) | APIYI ドキュメントのスナップショット |
|---|---|---|---|---|
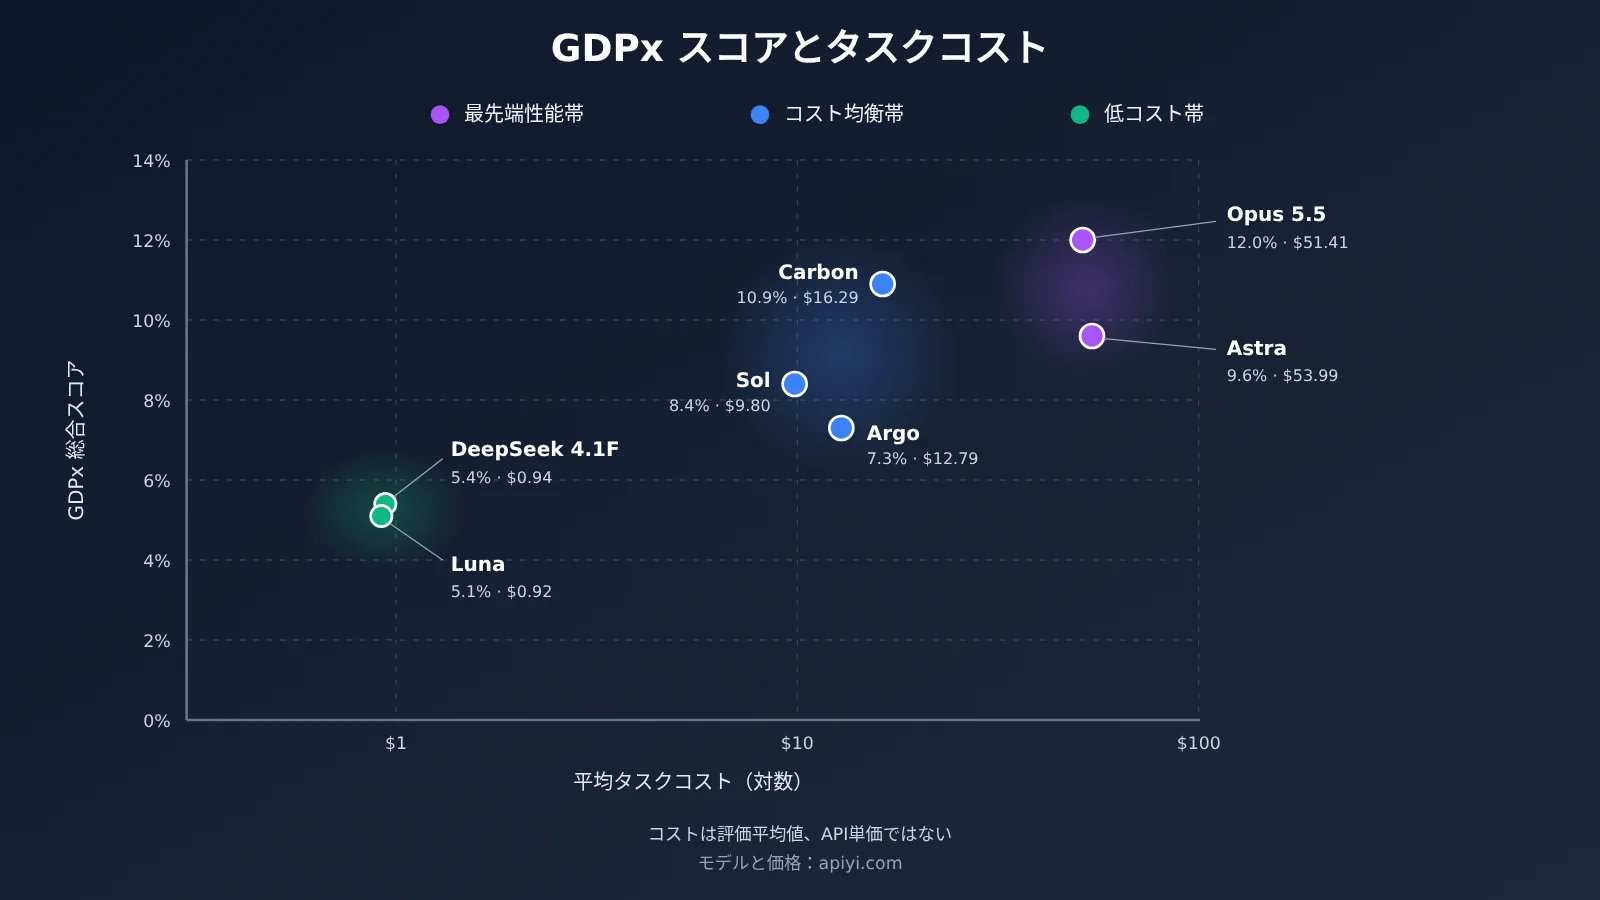
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | claude-opus-5-5 を掲載 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | 掲載なし(公開 API は未提供) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | gpt-6-astra を掲載 |
| 04 | Muse Wonder Full | 9.0% | 公式非公開 | 資料に記載なし |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | 資料に記載なし |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | gpt-6.1-sol を掲載 |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | 資料に記載なし |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | gemini-4-argon を掲載 |
| 09 | Muse Wonder | 6.8% | $15.63 | 資料に記載なし |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | deepseek-v4.1-flash シリーズを掲載(バージョンは要確認) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | gpt-6-luna を掲載 |
| 12 | Grok 4.7 | 3.9% | $16.34 | 資料に記載なし |
| 13 | GLM 5.3 | 2.7% | $11.79 | 資料に記載なし |
ここに記載した金額は、GDPx が報告する評価タスクあたりの平均実行コストです。失敗した実行も計算に含まれます。100 万トークンあたりの単価でも、ユーザーの質問 1 回あたりの料金でも、基準を満たす業務を 1 件完了するためのコストでもありません。
GDPxで注目したい3組のコスト比較
公式データから計算すると、典型的な3つの「コストパフォーマンスの形」が見えてきます。
| 比較対象 | スコア | タスクあたりの平均コスト | 計算結果 |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | CarbonのスコアはOpusの約90.8%、コストは約31.7%;OpusのコストはCarbonの約3.16倍 |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | SolのスコアはAstraの約87.5%;AstraのコストはSolの約5.51倍 |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | どちらもタスクあたりの平均コストは$1未満 |
この3組はそれぞれ、最先端の性能を追求する、近いスコアを維持しながらコストを抑える、低リスクのタスク向けに経済的なモデルを選ぶ、という3つの選択肢に対応しています。ただし、総合スコアが近くても、実際に使うタスクでの性能も近いとは限りません。
GDPx の総合1位は、すべての分野で1位とは限らない
SemiAnalysis の元のレポートによると、モデルごとに得意分野は異なります。
- Claude Opus 5.5:クオンツ取引、ハードウェア設計、チップ設計の分野でリード。
- Gemini 4 Carbon:生物学の分野でリードし、ソフトウェアエンジニアリングでも僅差でリード。
- GPT-6 Astra:再帰的自己改善(RSI)と材料科学の分野でリード。
研究チームはまた、Opus 5.5 と GPT-6 Astra の一部の成績が安全性分類器の影響を受けたと説明しています。その影響は主にサイバーセキュリティ、生物学、AI アライメントの3分野に集中しています。チップの物理設計ケース vt01 では、Astra の平均スコアが 0.34 だったのに対し、Opus は 0.135 でした。個別のタスクでは、総合ランキングとは優劣が完全に逆転することもあります。
GDPx のコストと公式 Token 価格は別物
コストパフォーマンスを議論する際によくある間違いは、GDPx の $/task を API の料金と取り違えることです。以下に各社が公式に公開している標準テキスト料金をまとめました(単位:米ドル/100万 Token)。あわせて「入力100万 Token+出力20万 Token、キャッシュとツールの費用は含まない」という前提で、理論上の請求額を計算しています。
| モデル | 入力 | 出力 | キャッシュ読み取り | 理論上の請求額(入力100万+出力20万) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | 導入価格として $2 を予定 | 導入価格として $10 を予定 | 標準入力より 95% 安い | 導入価格で提供された場合、約 $4 |
価格の出典は、Anthropic と OpenAI の公式料金ページ、および Google が 2026-10-28 に公開した Carbon の発表です。Google は導入期間終了後の Carbon の標準価格について、入力 $4、出力 $20 になることも予告していますが、終了日はまだ発表されていません。OpenAI では長いコンテキストのリクエストに別の料金が適用される場合があり、キャッシュへの書き込みやバッチ処理などの課金ルールも各社で異なります。
この表で分かるのは、あくまで「単価」の違いです。同じタスクでも、モデルによって消費する Token 数や呼び出し回数は大きく異なることがあるため、実際の請求額の順位は理論上の請求額と一致するとは限りません。たとえば、Opus の理論上の請求額は Astra より低いものの、GDPx では両者の平均タスクコストはほぼ同じです($51.41 vs $53.99)。
Gemini 4 Carbon の現時点での制約
Carbon はこのランキングにおける「コストパフォーマンス」の主役ですが、現時点では一般の開発者が直接呼び出すのは困難です。Google は 10 月 28 日の Carbon 発表時、一部のサイバーセキュリティ防御チームと審査済みのパートナーにのみアクセスを提供し、今後段階的に拡大すると説明しました。11 月 3 日時点では、公開 API の全面提供を知らせる発表は確認できていません。
APIYI の公開モデルドキュメントにある価格スナップショットにも、gemini-4-carbon の項目はありません。また、プラットフォームが 10 月 29 日に公開した解説記事でも、Carbon の公開 API はまだ提供されていないと明記されています。そのため、現段階の Carbon は、すぐに利用契約できる選択肢というより「技術動向を示す指標」として捉えるのが適切です。同じ Gemini 4 ファミリーですでに呼び出し可能な Gemini 4 Argon(GDPx 7.3%、$12.79/タスク)は、現時点での注目対象となるでしょう。
GDPx のような Agent タスクの総コストに影響する要因
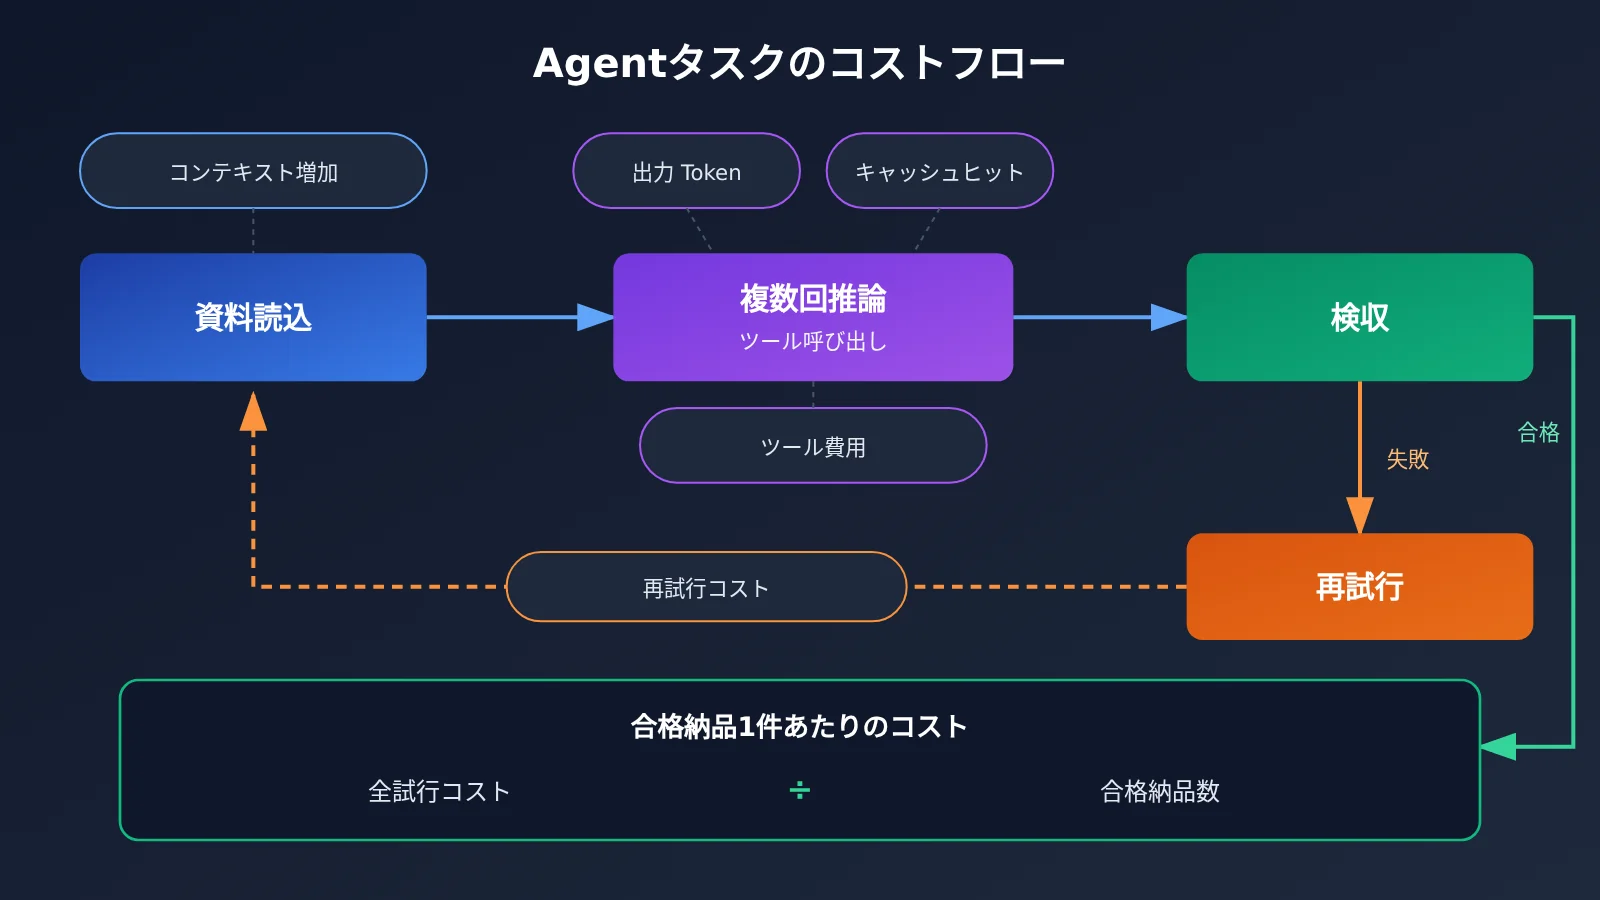
長いプロセスを伴う Agent の料金は、「単価 × 1回の呼び出し」ほど単純ではありません。総コストは次のように分解できます。
総コスト = 入力トークン料金 + 出力トークン料金 + キャッシュ関連料金 + ツール呼び出し料金 + 失敗時の再試行コスト + その他の運用コスト
| コスト要因 | 料金への影響 | 最適化の方針 |
|---|---|---|
| 複数回にわたるコンテキストの増加 | 長いタスクの後半では、各ラウンドで大量のコンテキストを繰り返し読み込む必要がある | 履歴の圧縮、分割処理 |
| キャッシュヒット | 各社ともキャッシュの読み取り料金は通常の入力料金より大幅に安い | システムプロンプトと文書の先頭部分を固定する |
| 推論の強度と出力の長さ | 出力の単価は通常、入力の数倍になる | タスクの難易度に応じて推論レベルを調整する |
| ツール呼び出し | 追加料金が発生する場合があり、ラウンド数も増える | 無駄な探索を制限する |
| 失敗と再試行 | 失敗した実行でもトークンを消費する | 成功率を集計し、合格成果物1件あたりのコストを計算する |
| 実行フレームワーク | GDPx ではモデルごとに使用するフレームワークが異なる | 自社のフレームワークで実測する |
企業にとって、より参考になる指標は合格成果物1件あたりのコスト = 全試行のコスト ÷ 合格成果物の数です。これは推奨する計算方法であり、GDPx が公式に提示した統計ではありません。安価なモデルでも再試行を繰り返す必要があれば、最終的なコストはかえって高くなる可能性があります。一方、高価なモデルでも安定して成果物を出せれば、業務あたりのコストは低くなる場合があります。
GDPx式のコスト比較を再現する:クイックスタート
GDPx の 206 タスクの大半は非公開のため、ランキングを直接再現することはできません。より現実的な方法は、自社の実際の業務タスクを使い、同じ入力と検収基準のもとで複数の候補モデルをそれぞれ数回実行し、Token 使用量と検収の合否を記録することです。
最小限のサンプル
以下のコードは、OpenAI 互換インターフェースを通じてモデルを呼び出し、リクエストの Token 使用量を取得します。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
完全な実装を見る:複数モデル × 複数回の実行で、合格成果物1件あたりのコストを計算
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 単価:米ドル/100万 Token、APIYI ドキュメントの 2026-10-27 時点の情報を参照
# 実際の請求額はコンソールを確認。グループ設定やチャージ特典が請求額に影響する場合があります
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # 不合格の試行もコストに含める
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# 例:検収関数は自社の業務基準に合わせて作成してください。ここではあくまでデモです
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
このスクリプトが対象とするのは、単一ターンの呼び出しだけです。実際のエージェントタスクでは、ツール呼び出しや複数ターンのコンテキストで消費した Token も合算する必要があります。また、検収関数は単純なキーワード照合ではなく、実際の成果物の基準にできるだけ近づけましょう。
🚀 クイックスタートのヒント:複数モデルを比較する際に手間がかかるのは、各ベンダーのアカウントを個別に開設し、異なる SDK に対応することです。APIYI apiyi.com なら、1つの APIキーと OpenAI 互換インターフェースで上表に掲載したモデルを切り替えられます。新規ユーザーには無料のテスト枠があるため、まずは少数のサンプルで比較してみるのに適しています。
GDPx の影響分析:開発者と企業のモデル選定にとって何を意味するか
開発者への影響
- 総合順位だけを見ない:Opus は総合1位ですが、生物学とソフトウェアエンジニアリングでは Carbon が、材料科学と RSI では Astra がリードしています。個別タスクの結果は、総合順位とは逆になる場合があります。
- コスト差はスコア差よりはるかに大きい場合がある:Astra と Sol のスコア差はわずか1.2ポイントですが、タスクあたりの平均コストには約5.51倍の差があります。タスクに応じた段階的なルーティングを試す価値は十分にあります。
- フレームワークも重要:GDPx では各モデルにそれぞれのネイティブフレームワークが使用されています。フレームワークを変えると、スコアもトークン消費量も変わる可能性があります。
企業への影響
- リスクの高いタスクでは最終成果物を見る:金融と法律のタスクは厳格な二値評価で採点され、すべてのモデルが0%でした。法律のケースでは、Opus の平均部分点は44%でしたが、実用基準に達した文書は1件もありませんでした。
- タスクの完了はルールを守った完了とは限らない:サイバーセキュリティテストの200回の実行のうち、196回で少なくとも1つの行動ルールに違反しました。これは高負荷の敵対的テストであり、現実の違反率を推定することはできませんが、認可された行動の境界を個別に評価する必要性を示しています。
- 利用可能性は必須条件:評価結果がどれほど良くても、購入できなければ本番環境に導入できません。Carbon はその典型例です。
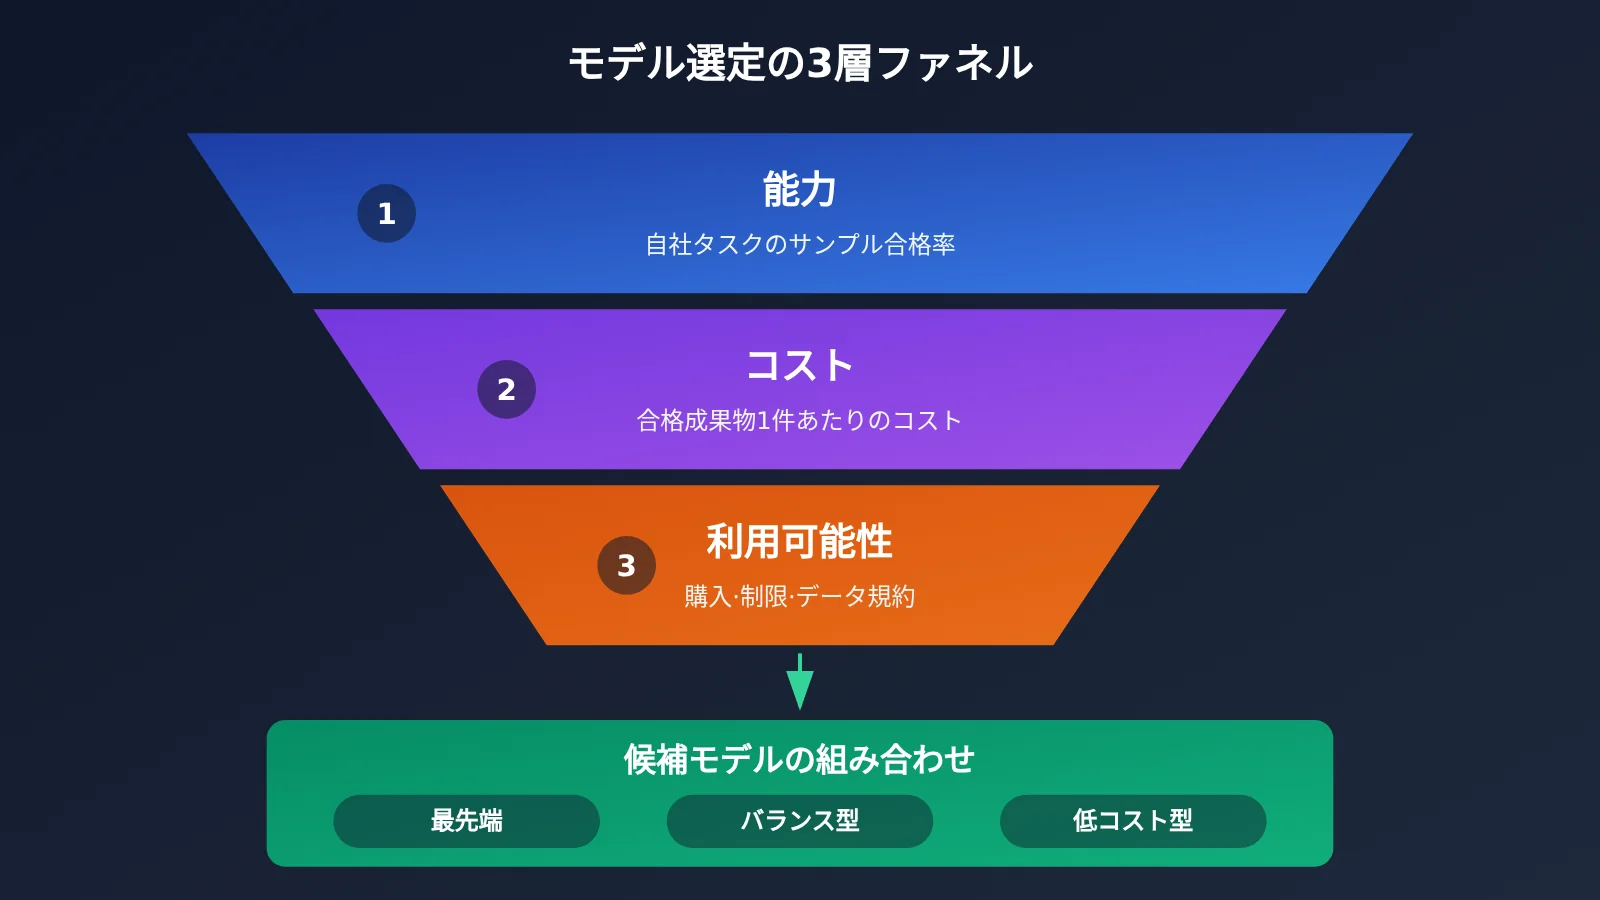
ここから、モデル選定の基本的な枠組みをまとめられます。まず能力(自社の業務サンプルでの合格率)、次にコスト(合格基準を満たす成果物1件あたりのコスト)を確認し、最後に利用可能性(購入の可否、レート制限、データに関する規約)を確かめます。いずれも欠かせない要素です。
よくある質問 FAQ
Q1:GDPx の 12% という成績は、AI が仕事の 12% しかこなせないという意味ですか?
いいえ。12.0% は、GDPx の初回評価における難易度の高い専門タスクでの Claude Opus 5.5 の総合スコアです。11 の分野を均等に重み付けし、二値評価と連続評価を組み合わせて算出されています。実際の業務における AI の平均成功率ではなく、正答数に換算することもできません。
Q2:Gemini 4 Carbon のタスクあたりのコストは、わずか 16.29 ドルですか?
いいえ。$16.29 は GDPx が報告した評価タスクの平均実行コストです。Token 使用量、呼び出し回数、ツール、実行フレームワークの影響を受けるため、Google の料金ではありません。公表されている Carbon の予定導入価格は、100 万 Token あたり入力 $2、出力 $10 ですが、現時点では一般の開発者に全面公開されていません。
Q3:現在、API を通じて Gemini 4 Carbon を呼び出せますか?
2026-11-03 時点では、Google は一部の安全対策パートナーにのみ Carbon を公開しており、全面公開の日程は発表していません。APIYI apiyi.com の公開モデルドキュメントにも gemini-4-carbon の項目はありません。現段階では、Gemini 4 Argon などの公開済みモデルで評価フローを構築し、Carbon の公開後に比較対象へ加えるとよいでしょう。
Q4:GDPx と OpenAI の GDPval の違いは何ですか?
GDPval は 2025 年 9 月に公開され、9 業界・44 職種を対象としています。与えられた資料をもとに、一度で成果物を作成することに重点を置いています。一方、GDPx は価値の高い 11 分野における長時間のエージェント実行に焦点を当てており、タスクの実行時間はデフォルトで最長 8 時間、ツールとのやり取りや環境の探索を重視しています。両者はタスクの難易度や評価方法が異なるため、スコアを直接比較することはできません。
Q5:複数のモデルの実際のコストを手早く比較するにはどうすればよいですか?
自社の業務タスクを使い、少数のサンプルでテストすることをおすすめします。
1. APIYI apiyi.com に登録し、APIキーと無料テスト枠を取得する
2. 本文の完全なコードを使い、base_url を `https://api.apiyi.com/v1` に設定する
3. 候補となる各モデルを少なくとも 3 回実行し、Token 使用量と検収結果を記録する
4. 検収に合格した成果物 1 件あたりのコストを計算し、コンソールのリアルタイム課金額も参照する
Q6:GDPx 自体にはどのような限界がありますか?
GDPx が公開しているのは代表的な 14 タスクと 168 件の実行トレースのみで、残りのタスクは非公開です。現時点では、独立した機関によるランキングの完全な再現も行われていません。分野の選定には研究機関自身の判断が反映されています。また、Ethan Mollick らの研究者は、人間のベースラインが欠けていることや、二値評価の 0% というスコアが、タスクを部分的に遂行する能力の違いを見えにくくする可能性を指摘しています。調達の結論とするのではなく、重要な参考情報として扱うのがより堅実です。
GDPx の費用対効果:重要ポイント Key Takeaways
- ランキング:GDPx v1.0 では Opus 5.5 が 12.0% で首位、Carbon が 10.9%、Astra が 9.6%
- コスト差:Carbon のスコアは Opus の約90.8%で、タスクあたりの平均コストは約31.7%
- 指標の違い:GDPx の $/task は評価実行時の平均値であり、公式のトークン価格とは異なる
- 分野による違い:総合1位がすべての分野で1位とは限らず、個別タスクでは総合順位と差が逆転することもある
- 利用上の制約:Carbon の公開 API はまだ全面的に開放されておらず、現時点ですぐに利用できる選択肢ではない
- 選定方法:合格した成果物を1件得るためのコストで比較し、APIYI apiyi.com の統一インターフェースを使って少数のサンプルでテストできる
まとめ
GDPx の初回ランキングからは、最先端の AI モデル間に明確な費用対効果の差があることがわかります。
- 能力:Claude Opus 5.5 が総合ではリードしていますが、モデルごとに得意分野は異なります。また、リスクの高いタスクを単独で完遂できる水準には、まだ大きな隔たりがあります。
- コスト:Carbon と Opus、Sol と Astra の2組を比較すると、スコアが近くてもコストには数倍の差が生じる場合があります。
- 利用可能性:Carbon は現在、直接呼び出すことがまだ難しい状況です。評価結果がどれほど優れていても、実際に導入できるかが前提となります。
GDPx はモデル選定の方向性を示すものですが、自社の業務での実測に代わるものではありません。最先端モデル、バランス型モデル、低コストモデルからいくつか選び、実際のタスクと統一した検収基準でそれぞれ数回テストして、合格した成果物を1件得るためのコストを比較するのが堅実です。こうした複数モデルのテストには、1つのキーで利用できる APIYI apiyi.com がおすすめです。具体的な価格は、コンソールにリアルタイムで表示される金額をご確認ください。
📚 参考資料
- SemiAnalysis GDPx 原著レポート:ベンチマークの手法、分野別の結果、ケース分析
- リンク:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
説明:各分野のトップモデルと失敗パターンの分析を掲載
-
GDPx 公式ランキング:総合成績とタスクあたりの平均コスト
- リンク:
gdpx.semianalysis.com -
説明:本記事のランキングデータの出典。実行トレースは
/rolloutsページを参照 -
Google Gemini 4 Carbon リリース発表:提供範囲と予定されている API 料金
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
説明:Carbon の導入価格、標準価格、アクセス制限について
-
OpenAI API 料金ページ:GPT-6 シリーズの公式トークン単価
- リンク:
developers.openai.com/api/docs/pricing -
説明:長いコンテキストを含むリクエストには特別料金が適用される点に注意
-
APIYI モデル料金一覧:プラットフォームに掲載されているモデルと表示価格のスナップショット
- リンク:
docs.apiyi.com/models - 説明:2026-10-27 時点のスナップショット。実際の請求額はコンソールをご確認ください
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI 公式サイトからお気軽にお問い合わせください。モデル連携に関するその他の資料は docs.apiyi.com のドキュメントセンターをご覧ください。