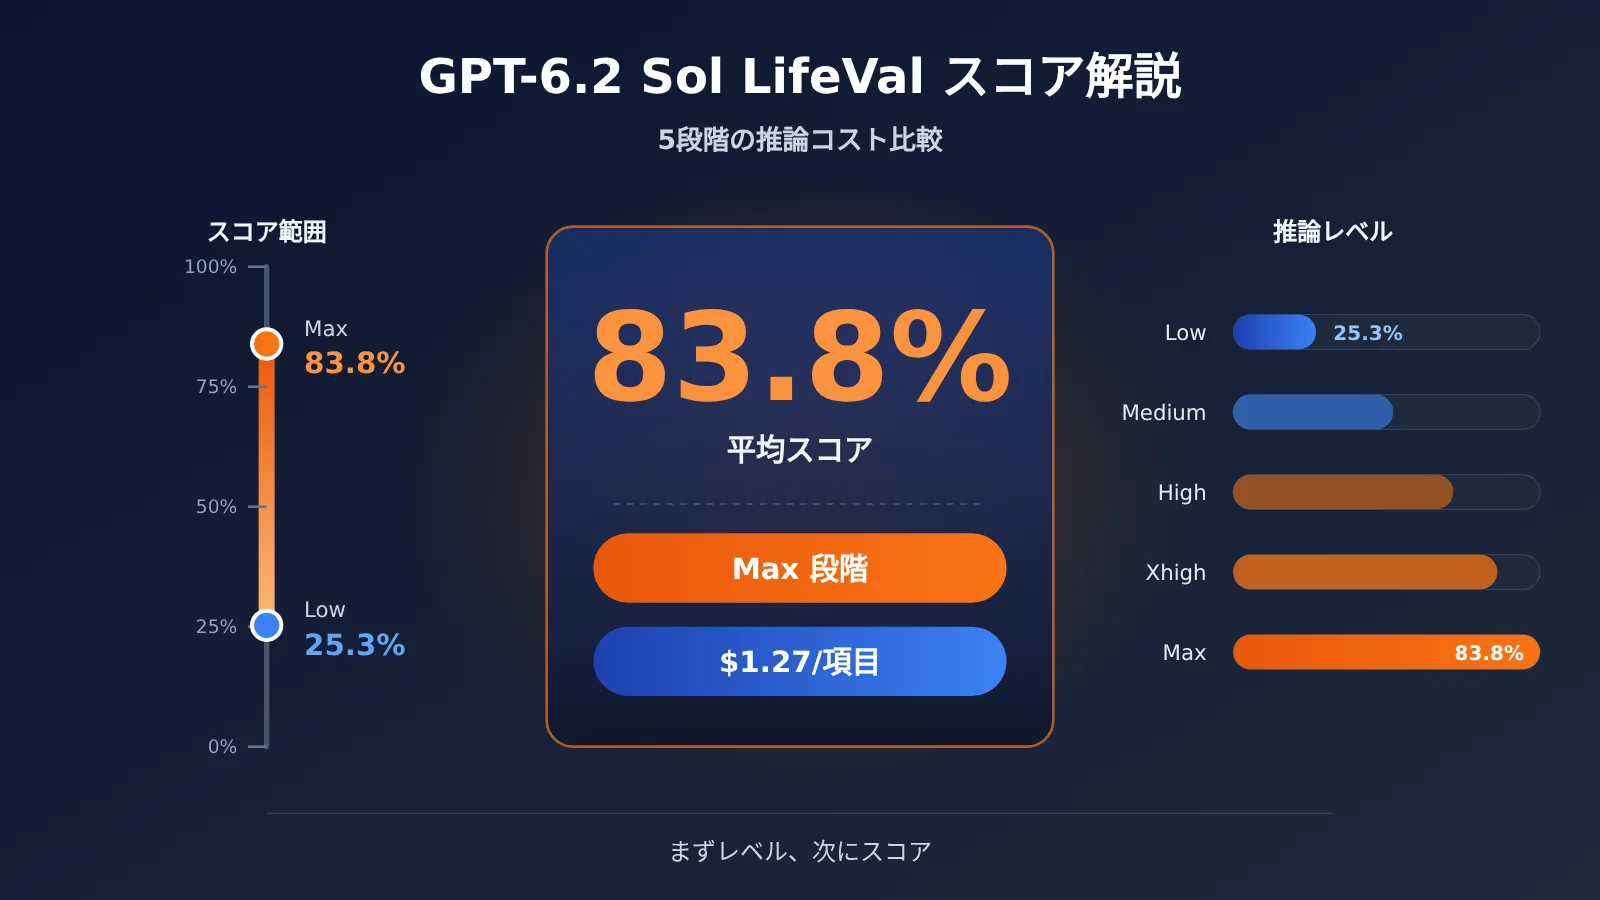
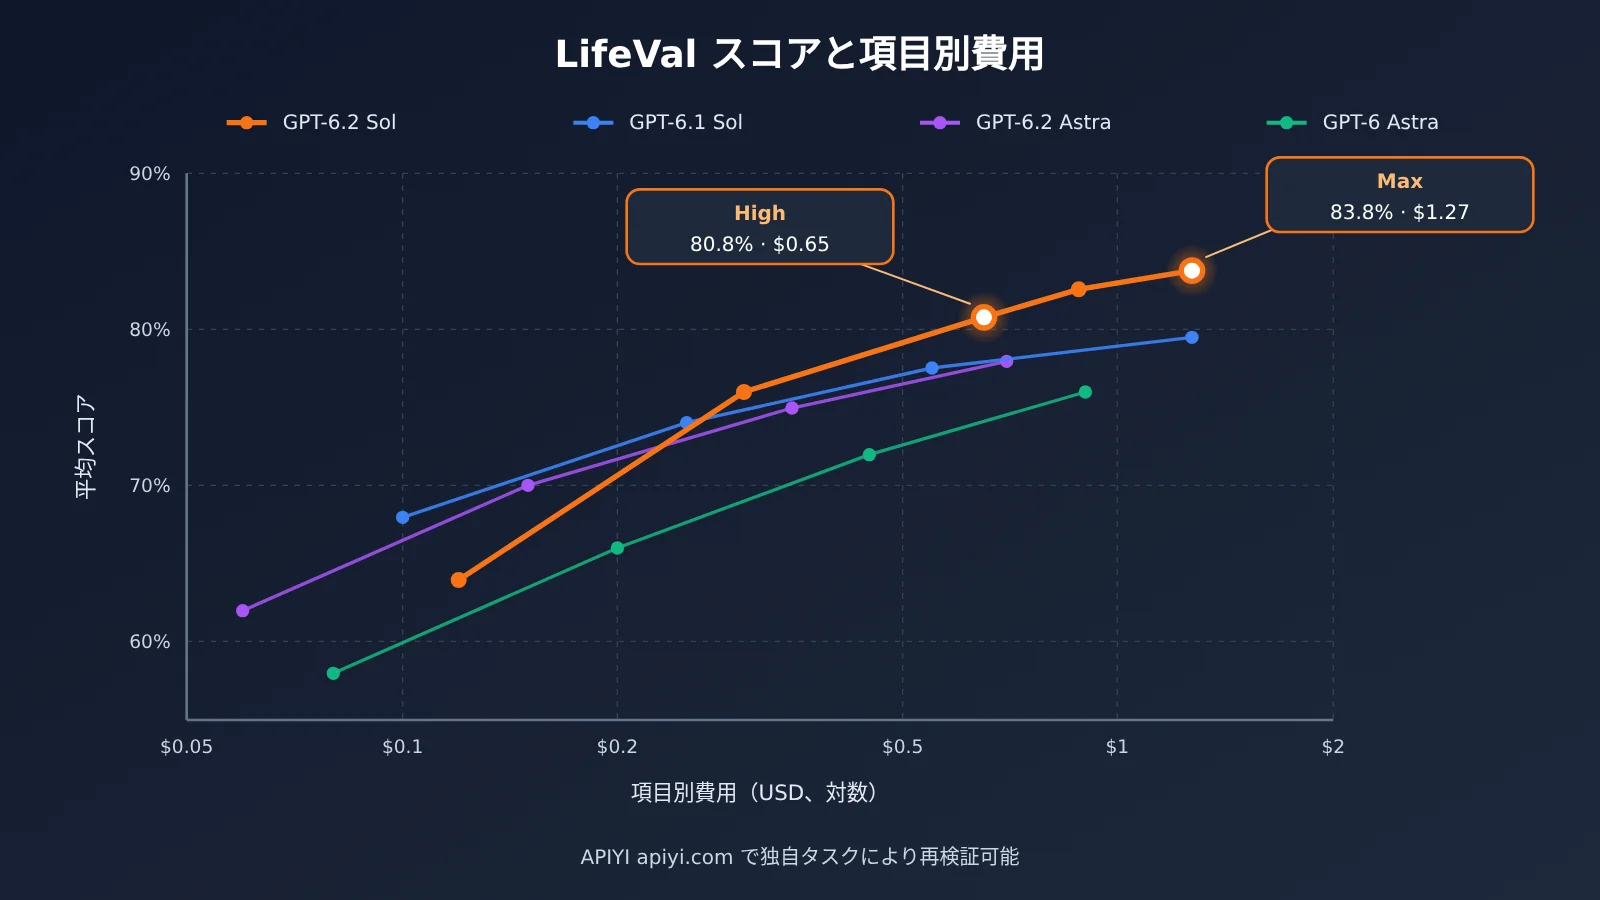
83.8%は「83.8%のタスクがすべて完了した」という意味ではありません。これはGPT-6.2 SolがMax推論ティアで記録したLifeValの平均スコアです。 このスコアは各タスクの採点基準に沿って項目ごとに点数を付け、それを合計したもので、対応する1タスクあたりの平均コストは$1.27です。同じモデルをLowティアに切り替えると、平均スコアは25.3%まで下がります。Highティアでは平均スコア80.8%、1タスクあたりのコストは$0.65です。そのため、GPT-6.2 SolのLifeValでの性能を語るときは、まずどのティアの話なのかを明確にしなければなりません。
結論はこうです。公式リーダーボードが示すのは「特定のタスクと特定の環境におけるスコアとコストの組み合わせ」であり、自社製品にそのまま持ち込める総合ランキングではありません。LifeValのこのデータ群では、Highティアがまず試す価値のある出発点になります。最終的にどのティアを使うかは、自分のタスクで、成果物と実際の状態に照らして合格判定する必要があります。
この記事を読むと分かること
- LifeValが測っているのはどんなタスクか、83.8%はどう表現するのが正しいか。
- GPT-6.2 Solの5つの推論ティアのスコアとコスト、そしてGPT-6.1 Sol、GPT-6 Astra、GPT-6.2 Astraとの同一ティア比較。
- 公式が言う「コストは約7分の1」と「Lowティアで大幅に低下」がなぜ同時に成り立つのか。
- LifeValの合格判定の方法を参考に、自分の日常アシスタント向けに再テスト可能な評価タスクを設計する方法。
索引:To Know表では後文で使う評価用語を先に説明し、影響早見では一般ユーザーと開発者がそれぞれ何に目を向けるべきかを説明します。客観的事実のパートでは、LifeValのタスクの出所と採点方式、そして11月17日公開の図にあるティア別データを順に説明します。分析・判断のパートでは、まずいくつかの比較の分母を分解し、そのまま書き換えられるルート/スケジュールアシスタントの合格判定サンプルを提示し、移行の境界について述べます。
To Know:GPT-6.2 Sol LifeVal スコアを理解するための重要概念
| 概念 | 簡単な説明 |
|---|---|
| LifeVal | OpenAI が AI アシスタントの個別化された日常デジタルタスクの遂行性能を測定するために用いるベンチマーク |
| 個別化コンテキスト | ユーザーの好み、履歴資料、タスク固有の条件など、「合格となる回答」を変えてしまう情報 |
| 評価ルーブリック | 1つのタスクの達成度を、項目ごとに検証できる複数の要件へと分解したもの |
| 制御環境 | アプリ、データ、初期状態をあらかじめ設定した評価環境。動作結果を照合しやすくする |
| バックエンド状態の差分 | テスト前後で記録したアプリの状態変化。ツール操作が実際に有効だったかを確認するために使う |
| 平均報酬値 | 各タスクが評価ルーブリックに沿って採点された後の集計指標。公開図のパーセンテージが、この種の「平均スコア」にあたる |
| 推論強度 | モデルの推論への投入量を制御する段階。本記事では Low、Medium、High、Xhigh、Max を比較する |
| 項目あたりコスト | 評価図における1タスク平均の費用。モデルの使用量と料率によって変動する |
GPT-6.2 Sol LifeVal の影響をひと目で
- 一般ユーザー:「83.8%」を見たら、それを「成功率」ではなく「米国の英語圏ユーザーの日常タスク群における平均スコア」と捉えましょう。加えて、同じモデルでも推論段階によって差が大きい点にも注意が必要です。製品としての体験は、アプリ側がどの段階を選ぶかによって決まります。
- プロダクトマネージャー:Low 段階は価格が最も低いものの、今回の LifeVal では前世代 Sol の Low 段階に大きく後れを取っています。旧バージョンの段階設定をそのまま流用してアップグレードすると、「新しいモデルに替えたのに、かえって悪くなった」という事態が起こり得ます。
- API 開発者:参考になるのは LifeVal の受け入れ設計、すなわち成果物・環境状態・回答をそれぞれ採点する方式です。同じ自社タスク群で Low、Medium、High の各段階を横並びで比較するほうが、ランキングの数字をそのまま引用するよりも信頼できます。
客観的事実:GPT-6.2 Sol の LifeVal はどんなタスクでモデルを評価するのか
LifeVal の由来と公開のタイムライン
LifeVal は、OpenAI がパーソナライズされた日常エージェントタスクを測定するために用いている評価ベンチマークです。OpenAI の研究ページの日付は 2026 年 11 月 2 日、付属する論文の日付は 11 月 3 日です。11 月 17 日、OpenAI は GPT-6.2 Astra と GPT-6.2 Sol をリリースし、公開ページには新モデルのティア別スコアを含む LifeVal のグラフ(グラフ識別子 lifeval-v2)を掲載しました。
論文のタスク分布は、米国および複数の国の時間使用調査に基づいており、さらに米国の人々を対象とした支払い意思額調査も参考にして、最終的に日常活動を 148 分類に整理しています。論文の実験では 169 項目のタスクを使用しています。なお、論文自体が評価しているモデルは GPT-6 Astra までであり、GPT-6.2 シリーズのティア別の数値は、後から公開された公式リリース図にのみ登場します。
公式の位置づけによれば、Sol は高頻度の日常業務、定型的なプログラミング、そして大規模に展開できるマルチステップ Agent に向けて設計されており、Astra はより難易度の高い推論や専門的な成果物の納品に向いています。この位置づけは、LifeVal が測定する「日常アシスタントタスク」と整合しています。
LifeVal のタスク設計:同じ要件でも、人によって異なる合格答案
LifeVal の特徴は「パーソナライズ」にあります。引っ越し後に学校を比較するケースを例にとると、子どもの年齢、通勤ルート、学区に対する好みが異なるユーザーでは、合格となる答えも変わってきます。また、予算と通勤時間のバランスを取りながら住まいを探す場合には、予算の上限と許容できる通勤時間が、どの物件を合格結果と見なすかを直接左右します。
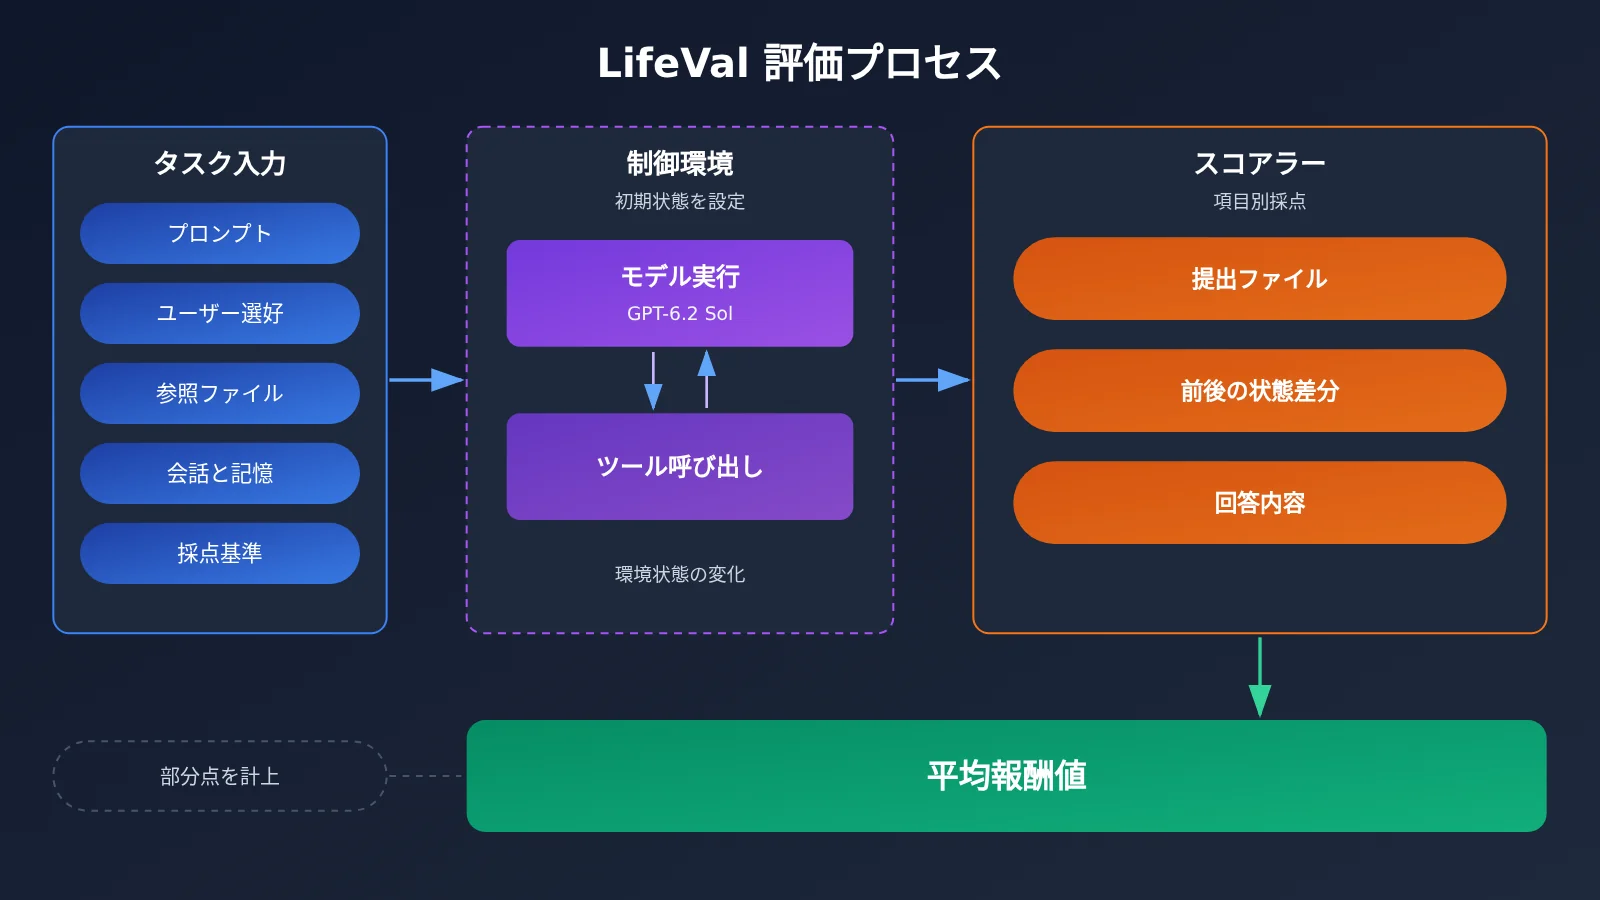
論文の定義に従えば、各タスクにはプロンプト、ユーザー選好、参照ファイル、関連する会話とメモリ、採点基準、さらにあらかじめ状態を設定した統制環境が付属します。実行が終わると、評価器は三種類のものを照合できます。モデルが納品したファイル、ツールが操作した環境の前後の状態、そしてモデルの回答です。そのうえで、タスクの各要件ごとに個別に採点します。
なぜ 83.8% は「平均スコア」としか言えないのか
論文の結果図の縦軸は平均報酬値です。したがって、83.8% は「平均スコア」と表現すべきであり、「83.8% のタスクが完全に実行成功した」と書くことはできません。あるタスクは採点項目の一部しか満たしていなくても、その分のスコアを寄与します。
論文はさらにいくつかの制約を明示しています。オフライン環境やキャッシュされたウェブページには、時間とともに変化する情報が依然として一部含まれています。また、サンプル集団は米国向けで英語を使用するユーザーが中心です。つまり、このスコアを他の地域、他の言語、他のアプリケーションエコシステムに直接一般化することはできません。
GPT-6.2 Sol LifeVal 公開グラフ:5段階のスコアとタスク単価
以下の表は、2026年11月17日のOpenAI公開ページにあるLifeValインタラクティブグラフの公開データを読み取ったものです。各セルは「平均スコア / タスク1件あたりの平均費用(USD)」を表します。これらはOpenAIが自己申告した公開評価データであり、独立機関による実測値ではありません。
| モデル | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| GPT-6.2 Sol | 25.3% / $0.089 | 70.3% / $0.38 | 80.8% / $0.65 | 82.6% / $0.88 | 83.8% / $1.27 |
| GPT-6.1 Sol | 66.8% / $0.52 | 75.5% / $0.73 | 77.1% / $0.88 | 77.8% / $0.96 | 79.5% / $1.27 |
| GPT-6.2 Astra | 46.3% / $0.59 | 78.9% / $1.56 | 83.1% / $2.41 | 83.7% / $2.94 | 86.1% / $4.23 |
| GPT-6 Astra | 67.5% / $3.51 | 74.3% / $5.30 | 76.0% / $6.52 | 77.5% / $6.94 | 79.8% / $9.04 |
発表本文では、LifeValにおいてSolのスコアはGPT-6 Astraを上回り、コストは後者の約7分の1だとされています。ここでの比較対象は前世代のフラッグシップGPT-6 Astraであり、同時期のGPT-6.2 Astraではありません。発表内の別のFrontierCode 2.0の比較でのみGPT-6.2 Astraが使われているため、2組の結論を混同しないよう注意してください。
📌 データ定義に関する注意:表の「タスク単価」は公式評価グラフの平均値であり、この評価における入力長、出力長、ツール使用の影響を受けます。自分のタスクコストは実際のリクエストで再測定する必要があります。APIYI apiyi.com で同じKeyを使い、Solの各段階を順に実行すれば、請求額を直接比較できます。
GPT-6.2 Sol の API 接続情報
API モデル ID は gpt-6.2-sol で、Responses と Chat Completions から呼び出せます。関数呼び出しと組み込みツールは Responses 経路を使用し、どちらのエンドポイントも none 推論ティアを受け付けません。公式の短いコンテキスト向け Standard 料金は、入力 $2.00、出力 $10.00(USD / 100万トークン、出力には推論トークンを含む)で、GPT-6.1 Sol と同じです。
2026年11月20日時点で、APIYI の公開モデル総表と価格 API の両方に gpt-6.2-sol が掲載されており、responses と chat のエントリが示されています。短いコンテキストの料金は公式と一致しています。実際に利用できるグループ、パラメータ範囲、請求内容は、APIYI apiyi.com の現在の設定および請求書を基準とします。
分析と判断:GPT-6.2 Sol LifeVal における「7分の1のコスト」と Low の低下はどう同時に成立するのか
まずは比較対象と分母を揃える
同じ画像から「大幅な進歩」と「明らかな後退」の両方の印象を読み出せるのは、比較対象とティアが異なることが根本原因です。下表の差分と比率はいずれも公式公開値に基づいて算出しています。
| 比較グループ | 双方の数値 | 得点差 | 費用の関係 |
|---|---|---|---|
| 6.2 Sol Max vs 前世代フラッグシップ GPT-6 Astra Max | 83.8%/$1.27 vs 79.8%/$9.04 | +4.0ポイント | 約14.0%、つまり「約7分の1」 |
| 6.2 Sol Max vs 6.1 Sol Max | 83.8%/$1.27 vs 79.5%/$1.27 | +4.3ポイント | 費用は同じ |
| 6.2 Sol Low vs 6.1 Sol Low | 25.3%/$0.089 vs 66.8%/$0.52 | −41.5ポイント | 費用はより低いが、得点は大幅に低下 |
| 6.2 Sol Medium vs 6.1 Sol Medium | 70.3%/$0.38 vs 75.5%/$0.73 | −5.2ポイント | 費用は約半分 |
| 6.2 Sol High vs 6.1 Sol Max | 80.8%/$0.65 vs 79.5%/$1.27 | +1.3ポイント | 約半分 |
| 6.2 Sol Max vs 6.2 Astra Max | 83.8%/$1.27 vs 86.1%/$4.23 | −2.3ポイント | 約30% |
これらの数値のうち、「ポイント」は平均得点の差を表し、「費用比率」は平均単価費用の比を表しており、両者は相互に換算できません。「7分の1」は「6.2 Sol Max 対 GPT-6 Astra Max」の組でのみ成立します。同時期の GPT-6.2 Astra に置き換えると、Sol は Max ティアではむしろ 2.3 ポイント低くなります。
💡 モデル選定のヒント:同一モデルでも、ティアが異なる場合の差はモデル間の差より大きくなることがあります。まず APIYI apiyi.com 上で固定タスクセットを使ったティア別比較を一巡行い、そのうえでデフォルトのティアを決めてください。旧モデルのティア設定をそのまま流用しないようにしましょう。
Low 設定が示すシグナル:アップグレードは「ただ置き換えるだけ」では済まない
6.2 Sol の Low 設定は LifeVal でわずか 25.3% にとどまり、6.1 Sol Low より 41.5 ポイント低い結果でした。公式の発表資料では、Sol が一部のタスクで消費する出力 token が少ないこと、Low 設定の1項目あたり平均費用も $0.089 にすぎないことが触れられています。合理的な推測として、パーソナライズされた多段階タスクでは、低い推論投入だけではユーザー選好の制約とツール操作をカバーしきれない可能性が考えられます。ただしこれはあくまで推測で、公式は Low 設定の低下について説明していません。
プロダクトチームにとって、影響は直接的です。もしアプリケーションがこれまでコスト削減のために 6.1 Sol の Low 設定を使っていたなら、設定を調整せずモデル ID だけを切り替えると、複雑な日常タスクの品質が明確に下がる可能性があります。反対に、Max 設定は同じ1項目あたり費用で前世代の Sol より 4.3 ポイント高く、新しいモデルの上限が実際に上がっていることを示しています。
本評価で High を優先的に試す価値がある理由
6.2 Sol では High から Xhigh、さらに Max へと進むにつれ、隣り合う設定間の改善幅はそれぞれ 1.8 ポイント、1.2 ポイントにとどまる一方、1項目あたりの平均費用は $0.23、$0.39 と順に上昇します。High 設定は $0.65 で 80.8% を記録しており、すでに 6.1 Sol の Max 設定や GPT-6 Astra の Max 設定を上回っています。LifeVal に限って言えば、High は「品質とコストのバランスが比較的取れた」出発点です。
ただし、この判断には三つの前提があります。タスク分布が LifeVal に近いこと、言語と利用環境が米国英語ユーザーのシナリオに近いこと、コスト構造が本評価の入力・出力比率に近いことです。いずれか一つでも満たさなければ、結論は変わり得ます。実践では High から始め、自社タスクの達成率に応じて Medium へ下げるか、Xhigh や Max へ上げるかを決めるのがより堅実です。
分析と判断:LifeVal のアプローチで自分の GPT-6.2 Sol アシスタントを受け入れ検証する
リスクの低い家庭の行程タスクを構築する
LifeVal で最も参考にすべきなのはスコアそのものではなく、「成果物と状態で受け入れ検証する」という方法です。以下は家庭行程のサンプルです。事前にアシスタントへ3つの厳格な制約(出発地と目的地、バリアフリー移動の条件、予算の上限)を与え、検証可能なルート付きの候補案と、編集可能なスケジュールの下書きを提出させます。
| 評価項目 | 確認方法 | 自動化の可否 |
|---|---|---|
| 地点の制約を満たしているか | 案の起点・終点が入力と一致している | 自動で確認可能 |
| バリアフリー条件を満たしているか | ルート説明がバリアフリー要件を明確にカバーしている | 一部自動、人の抜き取り確認が必要 |
| 予算を超えていないか | 案の金額を解析し上限と比較する | 自動で確認可能 |
| リンクが情報を裏付けられるか | リンクにアクセスでき、内容が案と一致している | 人の確認が必要 |
| スケジュール下書きファイルが存在するか | 出力ファイルやカレンダー項目の前後の状態を確認する | 自動で確認可能 |
| 重要な情報が欠けているときに質問するか | 日付などの情報を意図的に省略し、自ら確認してくるかを見る | 人の判断が必要 |
この評価項目群は LifeVal の3つの検証軸に対応します。すなわち成果物(スケジュール下書き)、状態の変化(ファイルや項目が実際に書き込まれたか)、そして回答の品質(制約の充足と自発的な確認)です。同じタスク群で Low、Medium、High をそれぞれ実行し、達成率と費用を組み合わせて初期のティアを決めます。
最小限の例:GPT-6.2 Sol を呼び出して推論使用量を記録する
以下の例では、Responses インターフェース経由で gpt-6.2-sol を呼び出し、出力トークンとその中の推論トークンを同時に読み取ることで、後から個別のコストを計算しやすくします。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    reasoning={"effort": "high"},
    input="请为我规划周六的家庭出行:从家到市立博物馆,需全程无障碍,交通预算不超过 200 元,并给出日程草稿。"
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
段階別比較スクリプトを見る(Low / Medium / High)
import re
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数の段階を比較できる
)

# 短いコンテキストの Standard 料金、USD / 100万トークン(出力には推論トークンを含む)
PRICE_IN, PRICE_OUT = 2.00, 10.00

TASKS = [
    {
        "prompt": "从家到市立博物馆,周六上午出发,全程无障碍,交通预算不超过 200 元。"
                  "请给出带路线说明的候选方案,并输出一份日程草稿。",
        "budget": 200,
        "must_include": ["无障碍", "博物馆"],
    },
    {
        # 意図的に日付を欠落させ、自発的に確認質問してくるかを検証する
        "prompt": "帮我安排一次带老人去公园的出行,预算 100 元以内,需要无障碍路线。",
        "budget": 100,
        "must_include": ["无障碍"],
        "expect_question": True,
    },
]

def check(task, text):
    """採点基準に沿って項目ごとに採点し、0〜1 のスコアを返す"""
    items = []
    items += [kw in text for kw in task["must_include"]]
    amounts = [float(x) for x in re.findall(r"(\d+(?:\.\d+)?)\s*元", text)]
    items.append(bool(amounts) and max(amounts) <= task["budget"])
    if task.get("expect_question"):
        items.append("?" in text or "?" in text)
    return sum(items) / len(items)

for effort in ["low", "medium", "high"]:
    scores, cost = [], 0.0
    for task in TASKS:
        resp = client.responses.create(
            model="gpt-6.2-sol",
            reasoning={"effort": effort},
            input=task["prompt"],
        )
        u = resp.usage
        cost += u.input_tokens / 1e6 * PRICE_IN + u.output_tokens / 1e6 * PRICE_OUT
        scores.append(check(task, resp.output_text))
    print(f"{effort:>6}: 平均得分 {sum(scores)/len(scores):.1%}, "
          f"平均单项费用 ${cost/len(TASKS):.4f}")
スクリプト内の自動チェックは「機械的に検証できる」採点項目のみをカバーしており、リンクの真偽や確認質問の質については引き続き人手によるサンプルチェックが必要です。推論段階のパラメータ値(特に Xhigh、Max に対応する文字列)は、公式の最新ドキュメントおよび使用するチャネルのパラメータ説明に従ってください。
🚀 クイックスタート:APIYI apiyi.com で登録すると無料のテスト枠を獲得できます。プラットフォームは OpenAI 互換インターフェースを提供しており、上記のスクリプトはキーを差し替えるだけで動作するため、本格的に段階を選ぶ前に小規模サンプルで一度検証してみるのに適しています。
GPT-6.2 Sol の LifeVal 結論を転用する際の境界
LifeVal の結論を自社製品に転用する際は、少なくとも3つの差異を考慮する必要があります。第一に、言語と地域です。論文のサンプルは米国英語のユーザーが中心で、中国語圏では地図、決済、カレンダーアプリのエコシステムがまったく異なります。第二に、環境です。LifeVal は制御された環境とキャッシュされたウェブページ上で動作しており、実際の製品ではネットワークの不安定さ、ツールの権限付与失敗、アカウント状態の違いに直面します。第三に、コスト構造です。公式の項目別コストは、この評価における入力・出力の比率に対応しています。長コンテキストのリクエストでは、入力が272Kを超えると全体がより高い料金体系に切り替わるため、項目別コストはグラフの数値と大きく乖離する可能性があります。
そのため、より合理的な活用方法は、公式グラフを「候補の絞り込み」の根拠とし、自社のタスクセットを「最終判断」の根拠とすることです。複雑な日常アシスタントであれば、まず High ティアでベースラインを構築し、その後、Medium が重要なハード制約を維持できるか、Xhigh や Max が人手による手戻りを大幅に減らせるかを個別に検証して、実際の達成率と請求額を判断材料にするとよいでしょう。
タスクセット、採点基準、環境チェックが整った後は、モデルのアップグレードは「ランキングを見てモデルを替える」ことではなく、毎回再テストできるエンジニアリングプロセスになります。複数のモデルやティアを繰り返し比較する必要があるときは、APIYI apiyi.com の統一インターフェースを利用し、GPT-6.2 Sol や GPT-6.2 Astra などを同じ受け入れテストスクリプトで実行できます。
参考資料
-
OpenAI GPT-6.2 Astra と Sol のリリース発表(LifeVal の段階別グラフを含む)
- リンク:
openai.com/zh-Hans-CN/index/introducing-gpt-6-2-astra-sol - 内容: 2026-11-17 公開。本記事の段階別データの出典
- リンク:
-
LifeVal の研究ページと論文
- リンク:
openai.com/index/lifeval、cdn.openai.com/pdf/lifeval.pdf - 内容: タスクの出典、採点方法、制限事項の説明(論文 §3–§5)
- リンク:
-
GPT-6.2 Sol のモデルカードと公式価格
- リンク:
developers.openai.com/api/docs/models/gpt-6.2-sol - 内容: コンテキスト仕様、長短コンテキストの課金ルールと上限
- リンク:
-
APIYI モデル一覧表
- リンク:
docs.apiyi.com/models.md - 内容: 公開されているモデル、エンドポイント、料金情報
- リンク:
著者: APIYI 技術チーム
技術交流: APIYI 公式サイト apiyi.com よりお気軽にお問い合わせください。その他の連携資料は docs.apiyi.com のドキュメントセンターをご覧ください。