著者注:本記事では Gemini 4 Neon のコンテキスト、4段階の思考強度、価格を紹介し、APIYI でネイティブと互換の2つのエントリポイントを設定する方法を説明します。さらに、同じ最小リクエストを使ってよくある接続エラーを切り分ける方法も解説します。
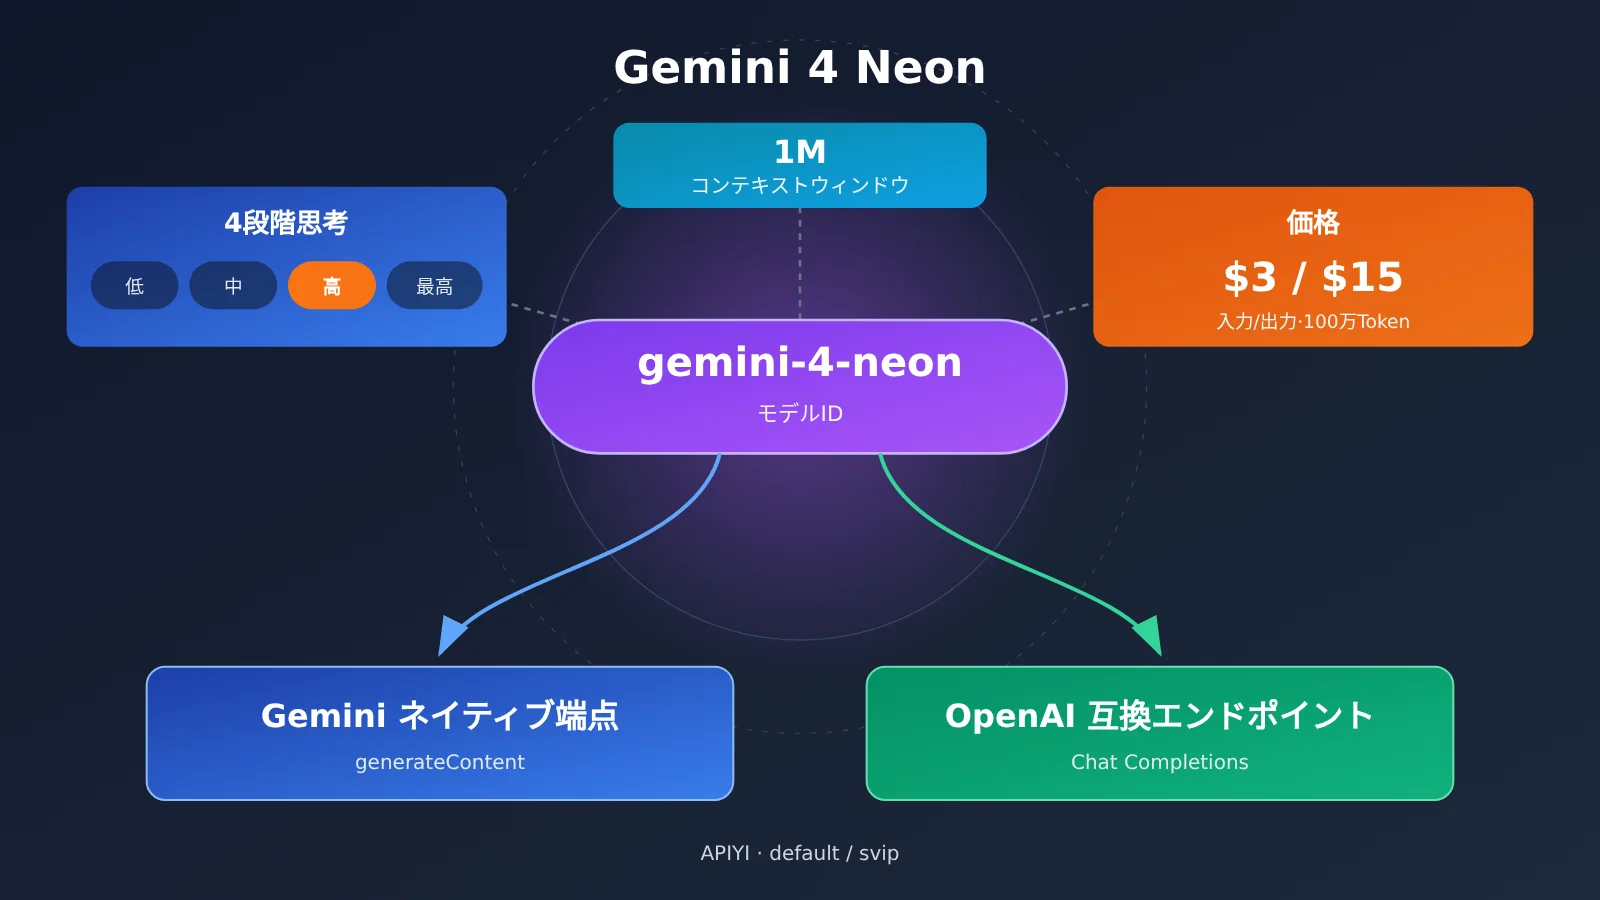
一言でまとめると:Gemini 4 Neon は Google が 2026年11月18日に発表し、APIYI は11月20日に default/svip グループで提供を開始しました。モデル ID は gemini-4-neon、料金は100万トークンあたり入力 $3、出力 $15、キャッシュ読み取り $0.15です。ネイティブの思考レベル制御が必要なら、Gemini ネイティブエンドポイントを優先してください。既存の OpenAI クライアントのモデルだけを差し替えたい場合は、互換エンドポイントのほうが手間が少なくて済みます。ただし、どちらのパスでもまず最短のリクエストで疎通確認し、その後ストリーミング、ツール呼び出し、より高い思考レベルを一つずつ有効にしてください。
これは発表稿を転述したニュースではありません。以下のパラメータ、価格、ベンチマークスコア、トラブルシューティング手順には、それぞれ出典と適用条件を明記しています。コード例は公式ドキュメントに基づいて構成しています。APIYI の提供開始案内によると、開始前に確認したのは料金エンドポイントのみで、実際の呼び出しは行っていないとのことです。そのため、本記事では2つのエンドポイントやツール呼び出しを「実際に検証して疎通確認済み」と表現することはありません。
本記事の価値:読み終えると、Neon の仕様と課金基準を確認でき、ネイティブと互換の2種類の最小リクエストを作成でき、テスト結果に応じて思考レベルを選択でき、エラー症状から問題をすばやく特定できるようになります。
Gemini 4 Neon を利用する前に押さえておきたい用語
ここで挙げる概念は、この後の説明で繰り返し登場します。まず言葉の定義を揃えておけば、トラブルシューティングの際に混乱しにくくなります。
- モデル ID:リクエストで指定するモデルの完全な文字列で、本記事では
gemini-4-neonです。大文字・小文字やハイフンもそのままコピーし、独自に省略しないようにしてください。 - ベース URL:クライアントがリクエストパスを組み立てる際のルートアドレスです。
/v1のようなバージョンプレフィックスを付けるかどうかは使用する SDK によって異なり、設定を誤ると 404 が発生しやすい原因になります。 - Gemini ネイティブエンドポイント:
generateContentプロトコルを受け付け、ネイティブの思考パラメータを使いたい場面に適しています。 - OpenAI 互換エンドポイント:Chat Completions 形式を使用するため、既存の OpenAI クライアントであれば基本メッセージ構造をそのまま再利用できます。
- 思考レベル:モデルの推論強度を表す列挙値です。Neon はネイティブで
low、medium、high、xhighをサポートしており、APIYI で公開されている動的指定のデフォルト値はhighです。 - 思考シグネチャ
thoughtSignature:モデルが返すコンテキストマーカーです。マルチターンのツール呼び出しでは、元のプロトコルに従って保持し、返送する必要があります。 - コンテキストウィンドウ:入力・思考・出力で共有される全体のバジェットです。1 回の同期生成でどれだけ出力できるかは、上限を個別に確認する必要があります。
- キャッシュ読み取り価格:条件を満たす既存の入力を再利用する際に適用される課金単価で、標準の入力価格よりはるかに安くなります。
Gemini 4 Neon の核心ポイント:パラメータ、価格、グループ
APIYI の提供開始情報によると、Neon は Gemini 4 シリーズの中間グレードで、Carbon(最も難しいタスク向け)と Hydrogen(日常的な実行向け)の間に位置します。Google は 11 月 18 日に発表し同日に GA、APIYI は 11 月 20 日に接続しました。
| ポイント | 内容 | 出典と条件 |
|---|---|---|
| モデル ID | gemini-4-neon |
APIYI モデルレジストリ(2026-11-20 生成) |
| 利用可能なグループ | default、svip |
APIYI 提供開始情報(2026-11-20) |
| 接続エンドポイント | Gemini ネイティブ + OpenAI 互換 | APIYI 提供開始情報;提供開始前は実呼び出し未実施 |
| コンテキストウィンドウ | 1M(入力/思考/出力で共有) | Google の発表および Artificial Analysis のいずれも 1M と表記 |
| 同期生成の上限 | 約 64K Token | APIYI 提供開始ドキュメント |
| 思考レベル | low/medium/high/xhigh、デフォルトは high | APIYI 提供開始情報 |
| 定価(100万 Token あたり) | 入力 $3、出力 $15、キャッシュ読み取り $0.15 | APIYI レジストリ。発表では公式サイトと項目ごとに一致、有効期限なしとされている |
Gemini 4 Neon におけるコンテキストと出力上限の関係
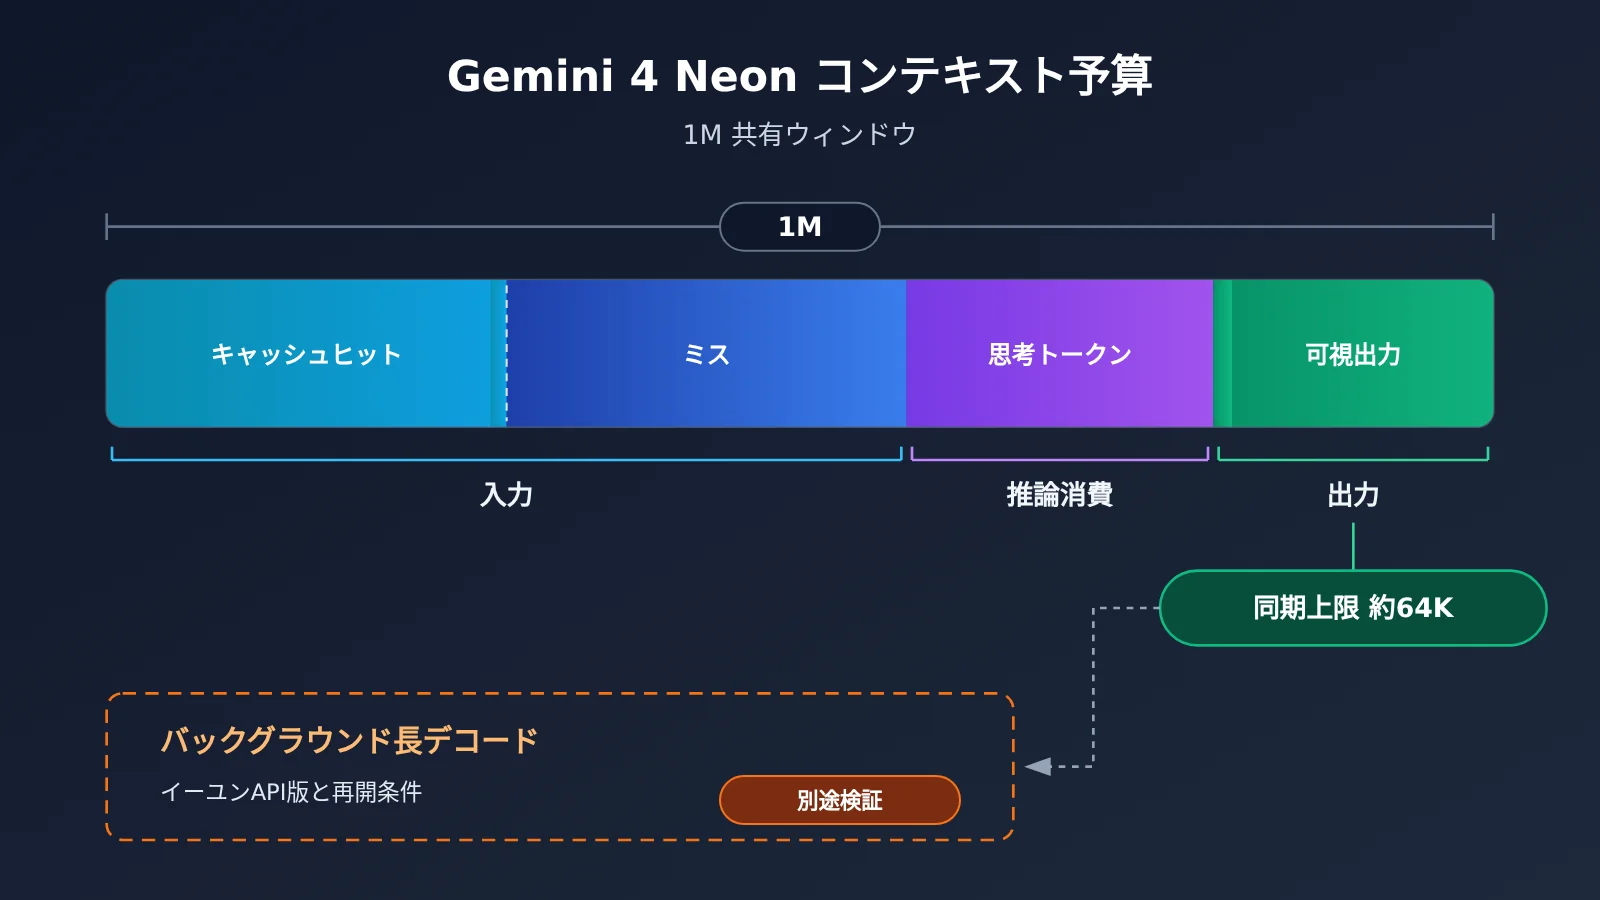
1M コンテキストは「1M を一度に出力できる」と誤解されがちです。実際にはこの 1M は入力・思考・出力が共有するウィンドウです。APIYI の提供開始ドキュメントによると、同期呼び出しの生成上限は約 64K Token です。つまり長い入力は問題ありませんが、1 回の同期リクエストでこれを超える出力を期待すべきではありません。
Google Cloud のドキュメントには、最高 1M までのバックグラウンド長デコード機能が言及されています。ただしこれは特定のクラウドインターフェースのバージョンと継続(レジューム)条件に依存し、通常の同期呼び出しとは別物です。APIYI が互換対応する Chat Completions エンドポイントについて、現時点で検証可能な長デコードの実呼び出し結果はありません。超長出力が必要な業務では、まず分割生成で設計し、長デコードは別途検証することをおすすめします。
Gemini 4 Neon の価格をどう見積もるか
以下は定価に基づく計算例で、実際の請求額ではありません。1 回のリクエストで入力 100K Token、可視出力 5K Token と仮定すると、入力費用は約 $0.30、出力は約 $0.075、合計で約 $0.375 になります。このうち 80K の入力がキャッシュにヒットした場合、その部分は $0.15 で計算して約 $0.012、残りの 20K は $3 で計算して約 $0.06 となり、入力コストは明確に下がります。
思考プロセスが消費する Token がどう計上されるか、キャッシュがどの条件で有効になるかは、実際の請求書に基づいて判断してください。APIYI の提供開始情報では、12 月 1 日から Carbon/Argon の期間限定価格が終了して $4/$20 に戻るとも述べられており、その時点で Neon の定価はそれらより 25% 低くなります。これはプラットフォーム発表における価格比較であり、性能比較ではありません。
Gemini 4 Neon クイックスタート:ネイティブと互換の2つの最小リクエスト
2つの経路それぞれに最短のリクエストを1つずつ送信し、モデルID、グループ、ルーティングが正しいことを確認したうえで、他の機能を追加することをおすすめします。以下の例は Google GenAI SDK と OpenAI SDK の公式ドキュメントに基づいて構成しており、Key はすべてプレースホルダーを使用しています。
| 比較項目 | Gemini ネイティブエンドポイント | OpenAI 互換エンドポイント |
|---|---|---|
| 推奨 SDK | Google GenAI SDK | OpenAI SDK |
| Base URL の記述方法 | プラットフォームのルートアドレス、別途 api_version="v1beta" を設定 |
ルートアドレスに /v1 を付ける |
| リクエスト構造 | contents[].parts[] |
messages[] |
| 思考レベル | generationConfig.thinkingConfig.thinkingLevel |
エンドポイント間のパラメータマッピングは個別に検証が必要 |
| 適したユースケース | 思考の詳細な制御やマルチターンのツール呼び出しが必要な場合 | 既存の OpenAI コードを素早く切り替えたい場合 |
Gemini 4 Neon ネイティブエンドポイントの例
ネイティブエンドポイントではプラットフォームのルートアドレスを使用し、バージョンプレフィックスは SDK の api_version に任せます。Base URL に v1beta を再度記述しないでください。重複したパスになってしまいます。
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # APIYI プラットフォームのルートアドレス、バージョンは api_version で指定
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
SDK のスネークケース表記は、最終的に REST リクエストボディのキャメルケースフィールドに対応します。HTTP リクエストを直接送信する場合、リクエストボディの構造はおおよそ次のとおりです。2つの階層に注目してください。
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
注意すべき点が2つあります。第一に、旧バージョンの thinkingBudget と minimal レベルは Gemini 4 には適用されないため、コードを移行する際に削除してください。第二に、Google のドキュメントには Gemini 4 が temperature と topP を無視すると記載されているため、これら2つのパラメータを調整しても効果が見えないのは想定どおりの動作です。
Gemini 4 Neon 互換エンドポイントの例
互換エンドポイントは、すでに OpenAI SDK を使っているプロジェクトに適しています。ここでは最も基本的な messages だけを使い、まずルーティングとグループが利用可能かどうかを確認します。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI の OpenAI 互換エントリ
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
レスポンスでは本文だけでなく、finish_reason も併せて記録することをおすすめします。本文が空の場合、これが最初の手がかりになります。ネイティブエンドポイントでは、候補結果内の終了理由と安全評価フィールドが対応するため、調査時には同様に保持してください。
診断情報付きのラッパーコードを見る
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # 上記の互換エンドポイントURLを入力
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """gemini-4-neon を呼び出し、終了理由と使用量を出力してトラブルシューティングを容易にする"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("正文为空:检查结束原因、安全状态与输出预算")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # レート制限と一時的な利用不可のみ再試行し、それ以外のエラーはそのまま送出する
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 クイックスタート:APIYI apiyi.com のコンソールでトークンを作成する際、トークングループが
defaultまたはsvipに属していることを確認してください。新規ユーザーは無料テスト枠で、上記2つの最小リクエストをそれぞれ一度実行できます。ネイティブと互換は同じキーを共有するため、エンドポイントを切り替える際は Base URL とリクエスト構造を調整するだけで済みます。
Gemini 4 Neon の思考ティアをどう選ぶか
ティアが高いほど推論はより充実しますが、所要時間とコストも増えます。Artificial Analysis(AA)は Intelligence Index v5.0.1 において Neon の4つのティアそれぞれを独立にテストし、結果は次のとおりです。
| 思考ティア | AA インテリジェンス指数 | タスクあたりの平均所要時間 | 説明 |
|---|---|---|---|
low |
44 | 約3.7分 | 速度優先 |
medium |
55 | 約8.3分 | lowより11ポイント高い |
high(デフォルト) |
60 | 約14.8分 | mediumより5ポイント高い |
xhigh |
61 | 約21.5分 | 加重コスト約$6.44/評価タスク |
このデータから見ると、medium から high へは依然として明確な向上が見られますが、high から xhigh へは指数がわずか1ポイントしか増えず、タスクあたり平均で約6.7分の追加時間がかかります。これらの数値は AA の評価パイプラインに由来し、タスクコストは9項目のテストの重みに基づいて計算されています。ドキュメントの読解や対話型Q&Aといったシナリオでの所要時間と請求額は自身で測定する必要があり、APIYI のエンドツーエンドの遅延、成功率、実際の請求額も別途測定が必要です。
ティアは次のように決めるとよいでしょう。遅延に敏感なQ&A系タスクでは low または medium から始めます。多段階の推論が必要な場合はデフォルトの high を維持します。xhigh が意味のある向上をもたらすことを自分の固定テストセットで確認できた場合にのみ、そのための追加の時間とコストを支払うようにしましょう。
Gemini 4 Neon と同カテゴリモデルの比較
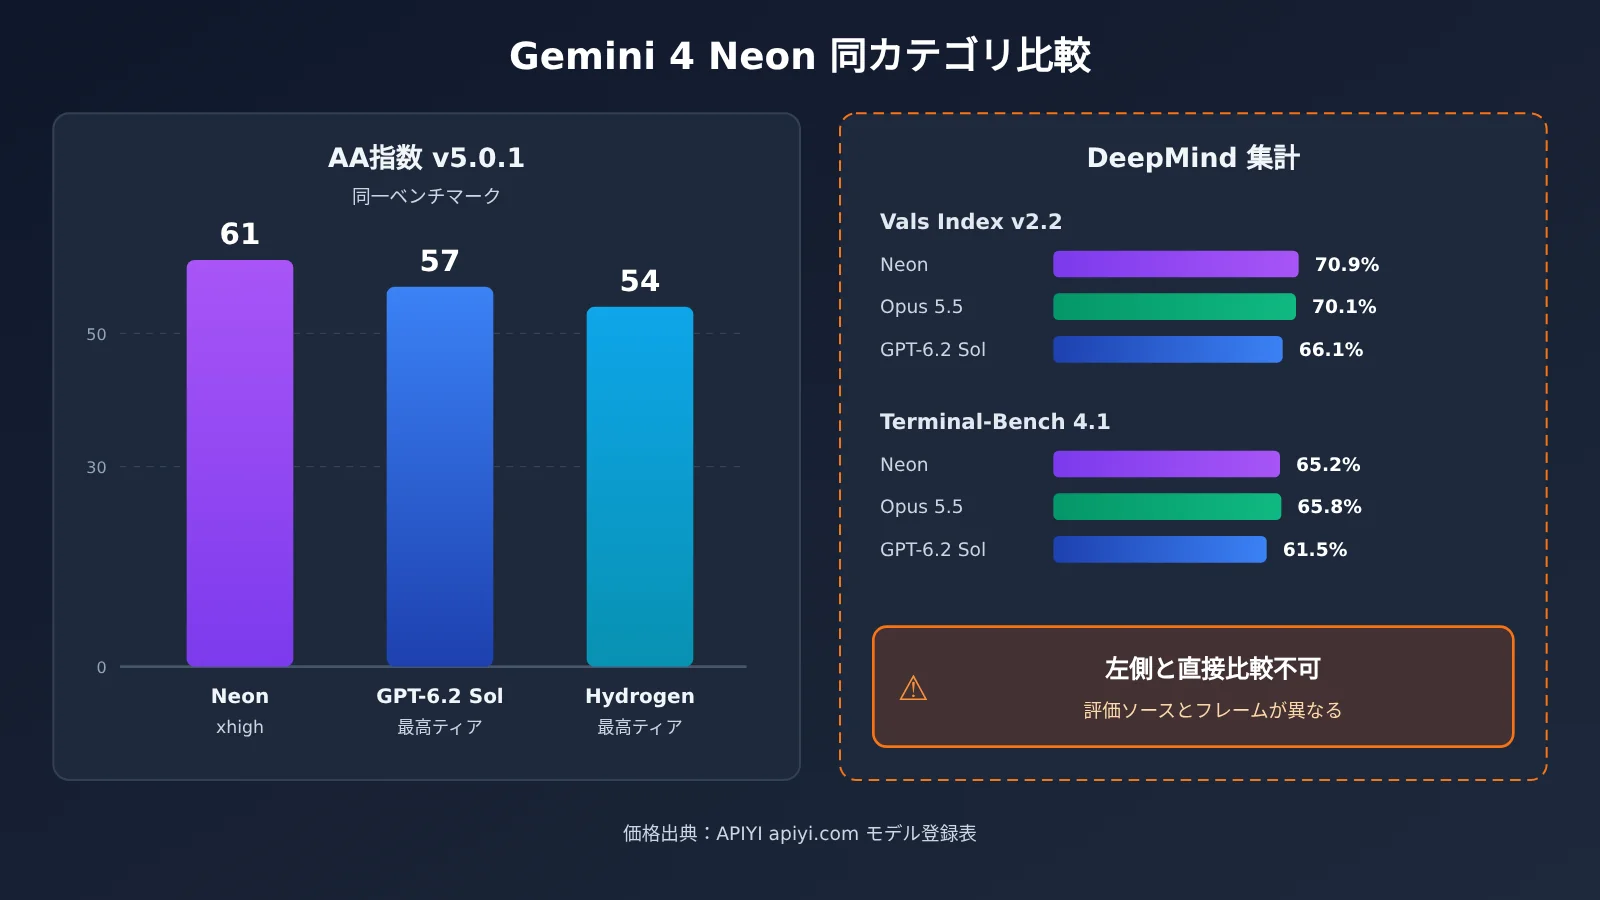
モデル間の比較では、できるだけ同一のベンチマークと比較可能な設定を用います。下表の最初の2列は AA の同一バージョンに基づくもので、価格は APIYI のレジストリに基づきます。
| モデル | AA 指数 v5.0.1(最上位設定) | 標準入力/出力(100万トークンあたり) | 利用可能なプラットフォーム |
|---|---|---|---|
| Gemini 4 Neon | 61(xhigh) | $3/$15 | APIYI apiyi.com など |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI など |
| Gemini 4 Hydrogen | 54 | レジストリの記載による | APIYI など |
GPT-6.2 Sol はリスト価格がより低く、入力・出力ともに Neon より3分の1安いです。ただし、AA の同一ベンチマークでは、Neon xhigh のスコアは Sol の最上位設定より4点高いです。注意すべきは、スコア差をそのまま業務上の精度差に換算できないことです。両者のレイテンシと実際のトークン消費量も個別に測定する必要があります。
もう一つの参考は Google DeepMind が公開した評価まとめです。Vals Index v2.2 では Neon が 70.9%、Claude Opus 5.5 が 70.1%、GPT-6.2 Sol が 66.1% でした。Terminal-Bench 4.1 の調整後正解率は順に 65.2%、65.8%、61.5% です。このまとめは明確に異なる評価ソースと実行フレームワークを使用しており、Terminal-Bench では Opus 5.5 が Neon をわずかに上回っています。方向性の参考にはできますが、モデル選定はご自身のツールチェーン上で同じタスク群の結果に基づいて行うべきです。
💡 選択のヒント:実際の業務を代表する固定テスト問題を20~50問用意し、APIYI apiyi.com 上で同じ APIキーを使い、Neon の各設定と候補モデルを順に呼び出し、正解率・所要時間・請求額を記録したうえで判断することをおすすめします。
Gemini 4 Neon のよくある接続エラーのトラブルシューティング
問題が発生したら、まず上記の最短リクエストに立ち戻って比較し、基本的な経路が正常であることを確認してから、追加した機能を一つずつ確認していきましょう。
| 現象 | 優先的に確認する項目 | 修正の方向性 |
|---|---|---|
| 404/モデルが利用不可 | モデル ID、トークングループ、ルーティング、バージョンプレフィックス | gemini-4-neon をそのままコピーする。OpenAI SDK は /v1 付きの互換エンドポイントを、GenAI SDK はルートアドレスに v1beta を付けて使用する。バージョンプレフィックスの二重連結を避ける |
| 400/レベルを切り替えた後に挙動が合わない | ネイティブの思考パラメータ、互換リクエストボディのフィールド | ネイティブエンドポイントで thinkingLevel を使い、レベルが有効になっているか確認する。thinkingBudget、minimal を削除する。2 つのプロトコルのフィールドを混在させない |
| 200 だが本文が空 | 終了理由、セーフティステータス、出力予算 | 出力予算が思考と可視出力の両方を収められるか確認する。セーフティフィルターの情報を確認する |
| ツール呼び出しの 2 回目が失敗する | thoughtSignature、ツール呼び出しとレスポンスの対応付け |
思考シグネチャをそのまま返し、各ツールレスポンスが正しい呼び出しに対応するようにする |
| 429/上流の一時的な 503 | エラーボディ、トークン上限、同時実行の制約 | 短時間のレート制限や利用不可の場合は、回数制限付きでジッターを加えた指数バックオフを使う。残高や権限の問題は設定を修正してから再送する |
Gemini 4 Neon における 404 と 400 の区別
404 は通常、リクエストがこのモデルにルーティングされていないことを示し、原因は「見つからない」ことにあります。ID のスペルミス、トークングループにそのモデルが含まれていない、あるいは URL が /v1/v1/... や /v1beta/v1beta/... のような重複パスになっているケースです。一方 400 は、リクエストは到達したものの、リクエストボディがプロトコルに適合していないことを示します。最も多いのは、ネイティブのフィールドを互換リクエストに詰め込んでしまった場合や、Gemini 2.x 時代の古いパラメータをそのまま使っている場合です。
エンドポイントをまたぐパラメータのマッピングは、個別に検証する必要があります。互換エンドポイントで思考の強度を制御しようとしても期待通りの効果が得られない場合は、まずネイティブエンドポイントに戻ってそのレベルが実際に効いているか確認し、それからパラメータの問題なのかマッピングの問題なのかを判断してください。
Gemini 4 Neon の空本文とツール呼び出しの失敗
HTTP 200 なのに本文が取得できないときは、まず終了理由を確認します。長さによる打ち切りであれば、思考プロセスがすでに出力予算を消費しており、可視テキストを出力する余地がなかったことを意味します。安全性上の理由であれば、入力内容を調整する必要があります。高い思考レベルのほうが、前者のケースが発生しやすくなります。
マルチターンのツール呼び出しの失敗は、そのほとんどが thoughtSignature に関係しています。Google の Thought signatures ドキュメントに従うと、モデルが返すシグネチャは後続のターンで元のプロトコルのまま持ち戻す必要があり、同時に各ツール呼び出しには 1 対 1 に対応するツール応答が求められます。調査の際はまずツールを外し、最短のツールなしリクエストで比較対照を行い、そこから徐々にツールを戻していくのが有効です。
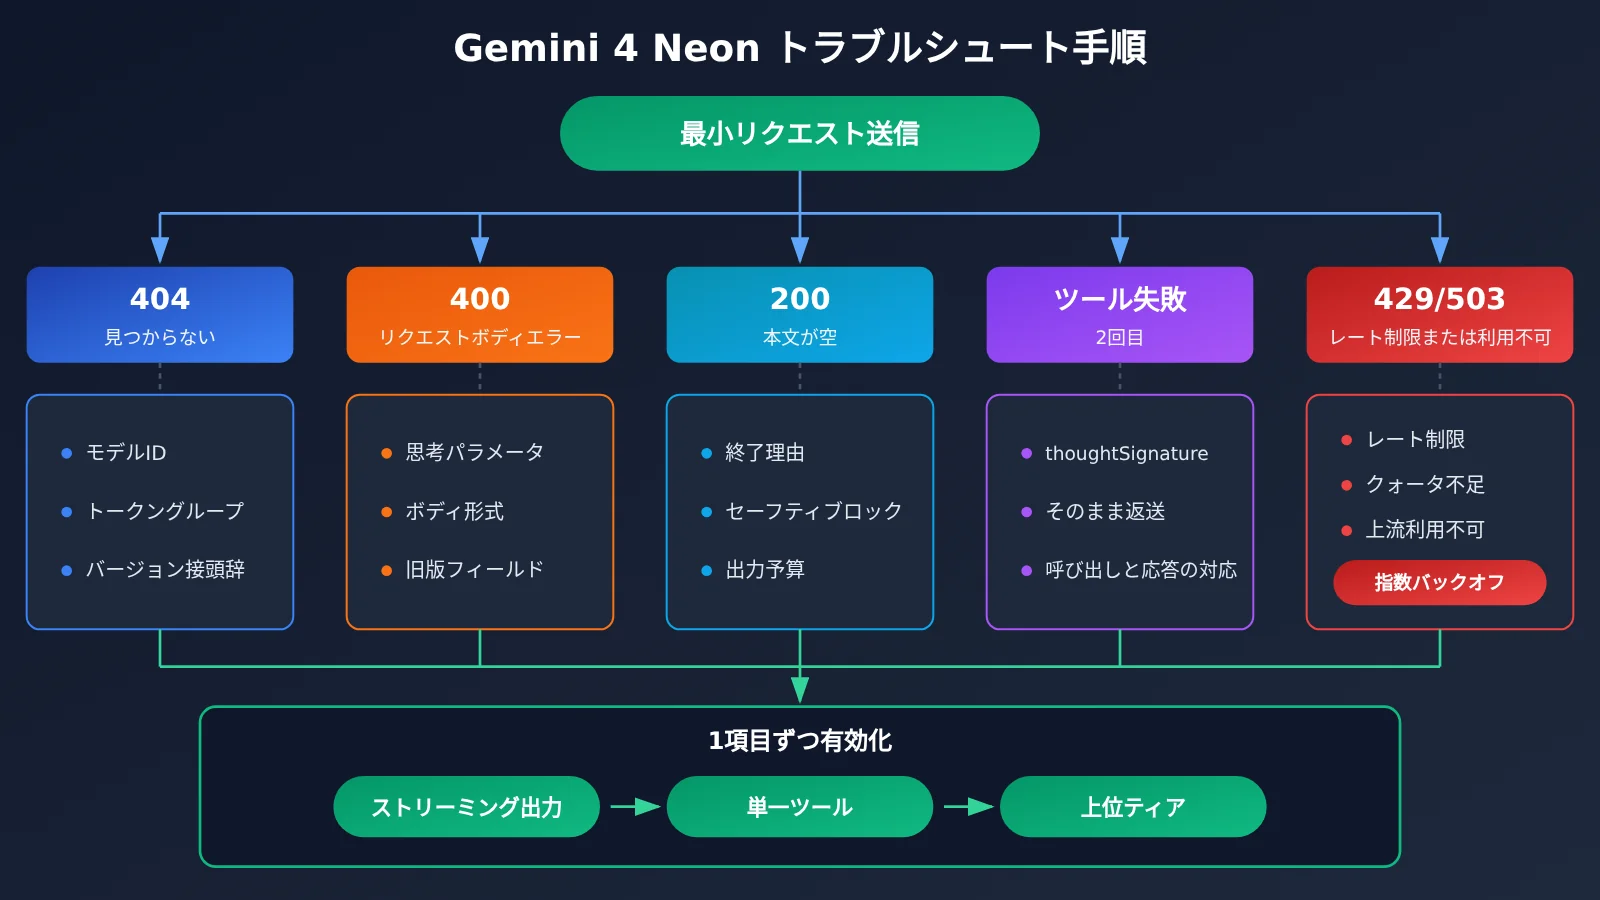
Gemini 4 Neon 推奨検証手順
最小リクエストが成功したら、以下の順序で機能を一つずつ有効化し、各ステップで個別に結果を確認することをおすすめします。
- 非ストリーミング・ツールなし・デフォルトティアのプレーンテキストリクエストで、ID、グループ、ルーティングが正常かを確認します。
- ストリーミング出力を有効にし、チャンクの結合と終了理由の読み取りが正しいかを確認します。
- 単一のツールを追加し、「呼び出し→結果の返送→最終回答」という完全な2ラウンドを実行して、
thoughtSignatureが保持されているかをチェックします。 - ネイティブエンドポイントで
low/medium/xhighを切り替え、固定テストセットで効果・所要時間・課金を比較します。 - 最後に、長い入力やキャッシュ再利用などコストに関わる最適化を追加します。
よくある質問 FAQ
Q1:Gemini 4 Neon とは何ですか?
Gemini 4 Neon は、Google が 2026 年 11 月 18 日に発表し同日 GA した Gemini 4 の中間ティアモデルで、Carbon と Hydrogen の間に位置づけられています。1M の共有コンテキストと4段階の思考強度を提供し、モデル ID は `gemini-4-neon` です。
Q2:Gemini 4 Neon と GPT-6.2 Sol はどう選べばよいですか?
AA Intelligence Index v5.0.1 の同一ベンチマークでは、Neon の `xhigh` は 61 点、Sol の最高ティアは 57 点です。ただし Sol の定価は $2/$10 で、Neon の $3/$15 より安価です。スコアの差はそのまま業務の正確性の差にはなりません。ご自身のテストセットで効果・レイテンシ・実際の Token 消費量を比較したうえで判断することをおすすめします。
Q3:Gemini 4 Neon はいつから APIYI で利用できますか?
APIYI は 2026 年 11 月 20 日に本モデルをリリースし、`default` と `svip` の2つのグループを開放しました。リリース告知によると、標準価格に有効期限はありません。
Q4:Gemini 4 Neon はどのようなシーンに適していますか?
– **長文書分析**:1M のウィンドウで大量の資料を一度に入れられますが、1回の同期出力の上限は約 64K です。
– **多段推論と Agent タスク**:デフォルトの `high` ティアは効果と所要時間のバランスが良く、ツール呼び出しにはネイティブエンドポイントの利用を推奨します。
– **コストを抑えたバッチ処理**:`low`/`medium` とキャッシュ再利用を組み合わせて、1回あたりのコストを下げられます。
Q5:API 経由で Gemini 4 Neon を素早く呼び出すには?
1. APIYI apiyi.com で登録し、無料のテスト枠を受け取ります。
2. `default` または `svip` グループに属するトークンを作成します。
3. 既存の OpenAI コードは互換エントリポイントを利用します。思考ティアの制御が必要な場合は Google GenAI SDK でネイティブエンドポイントに接続します。
どちらの経路でも、まず本記事の最小リクエストを実行し、リンクが正常であることを確認してから機能を追加することをおすすめします。
Q6:Gemini 4 Neon にはどのような既知の制限がありますか?
– **出力上限**:1M は共有ウィンドウであり、同期生成の上限は約 64K です。長いデコードは特定のクラウドインターフェースと継続受信の条件に依存します。
– **パラメータの変更**:`thinkingBudget`、`minimal` は適用されなくなり、`temperature`、`topP` は無視されます。
– **検証状況**:APIYI のリリース前に確認したのは価格設定 API のみです。両エンドポイントとツール呼び出しは、APIYI apiyi.com 上でご自身のリクエストを用いて事前に検証することをおすすめします。
Gemini 4 Neon の要点(Key Takeaways)
- モデルの位置づけ:
gemini-4-neonは Gemini 4 のミッドティアで、Google が 11 月 18 日に公開しました。 - 仕様の範囲:1M の共有コンテキストを持ち、同期生成の上限は約 64K です。長いデコードについては別途検証が必要です。
- 料金表示:100 万 Token あたり入力 $3、出力 $15、キャッシュ読み込み $0.15 です。実際の金額は請求額に準じます。
- ティアのトレードオフ:AA テストでは
highからxhighに上げてもスコアは 1 点しか増えませんが、タスクあたりの所要時間は約 6.7 分長くなります。 - エンドポイントの選択:思考ティアを制御したい場合はネイティブエンドポイントを、既存コードを再利用したい場合は互換エンドポイントを使います。
- トラブルシュートの順序:まず最小のリクエストから始め、続いてストリーミング、ツール、より高い思考ティアの順に有効にしていきます。
まとめ
Gemini 4 Neon の接続ポイントは、次の 3 つに集約できます。
- まず仕様を確認:1M は共有ウィンドウで、同期出力は約 64K、標準料金は $3/$15、キャッシュ読み込みは $0.15 です。
- 2 つのエンドポイントでそれぞれ実行:ネイティブエンドポイントはルート URL に
v1betaを付け、互換エンドポイントは/v1付きの URL を使います。フィールドは混在させないでください。 - データでティアを選ぶ:AA のスコアはあくまで参考で、最終的には自身の固定テストセットでの品質・所要時間・請求額で判断します。
接続方法を確認したら、APIYI apiyi.com 上で同じ API キーを使い、Neon の各ティアと他の候補モデルを比較したうえで、本番環境のデフォルト設定を決めることをおすすめします。
📚 参考資料
-
APIYI Gemini 4 Neon リリース情報:グループ、エンドポイント、価格と出力上限
- リンク:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - 説明:2026-11-20 公開。四段階の思考モードとデフォルト設定の情報を含みます
- リンク:
-
Google Gemini 4 Neon リリース告知:公式発表情報
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - 説明:2026-11-18 公開。コンテキストと位置づけに関する説明を含みます
- リンク:
-
Artificial Analysis Gemini 4 Neon モデルページ:四段階の独立評価
- リンク:
artificialanalysis.ai/models/gemini-4-neon - 説明:Intelligence Index v5.0.1 のスコアと所要時間。指標は動的に更新されます
- リンク:
-
Google Gemini API Troubleshooting と Thought signatures:トラブル対応と思考シグネチャのドキュメント
- リンク:
aistudio.google.com/docs/troubleshooting、aistudio.google.com/docs/thought-signatures - 説明:エラーコードの意味と、マルチターンのツール呼び出しにおけるシグネチャ返送ルール
- リンク:
-
Gemini 4 Neon Model Evaluation:DeepMind の評価まとめ
- リンク:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - 説明:複数ソース・複数フレームワークの評価結果。引用時には設定を明記する必要があります
- リンク:
著者:APIYI 技術チーム
技術交流:接続中に問題が発生した場合は、APIYI 公式サイトからお気軽にお問い合わせください。その他のインターフェースの説明は docs.apiyi.com のドキュメントセンターでご確認いただけます