著者注:本記事では、APIYI で2つのプロトコルを使って Gemini 4 Neon に最初のリクエストを送る方法と、リクエスト成功後に確認すべきフィールドとログについて説明します。
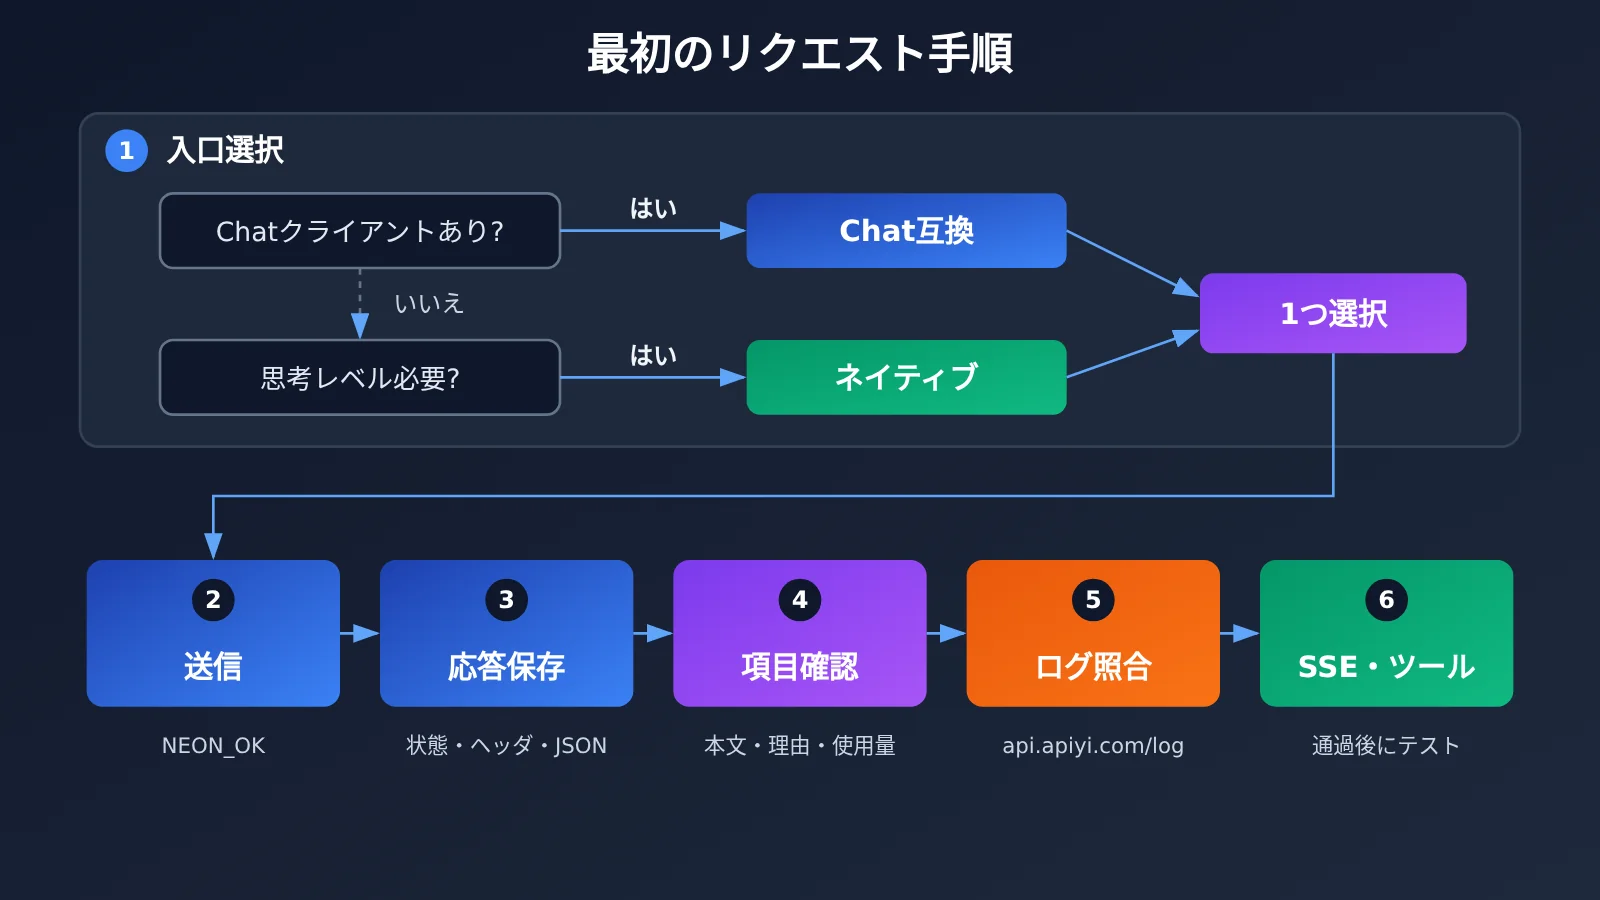
結論から:プロジェクトに既に OpenAI Chat クライアントがある場合は、OpenAI 互換の Chat Completions エンドポイントを使い、base_url とモデル名だけを変更します。Gemini の思考レベルを明示的に設定したい場合は、Gemini ネイティブの generateContent エンドポイントを使い、generationConfig.thinkingConfig.thinkingLevel で指定します。どちらの経路を選んでも、まず同じ短いプロンプトでプレーンテキストの応答まで通し、その後 HTTP ステータス、レスポンス本文、停止理由、使用量、プラットフォームログで受け入れ確認を行います。受け入れ確認に合格したら、ストリーミング出力やツール呼び出しなどの機能をテストします。
背景情報は次のとおりです。Google は 2026年11月18日の AI Studio 更新ログで Gemini 4 Neon を発表し、GA を宣言しました。APIYI は北京時間 2026-11-20 11:45 に提供開始を確認し、公開価格カタログでは gemini-4-neon を確認できます。利用可能なグループは default と svip です。本記事のサンプルは APIYI のドキュメントと SDK ドキュメントに基づいて作成しており、有料エンドポイントは呼び出していません。また、記事内に実測統計はありません。
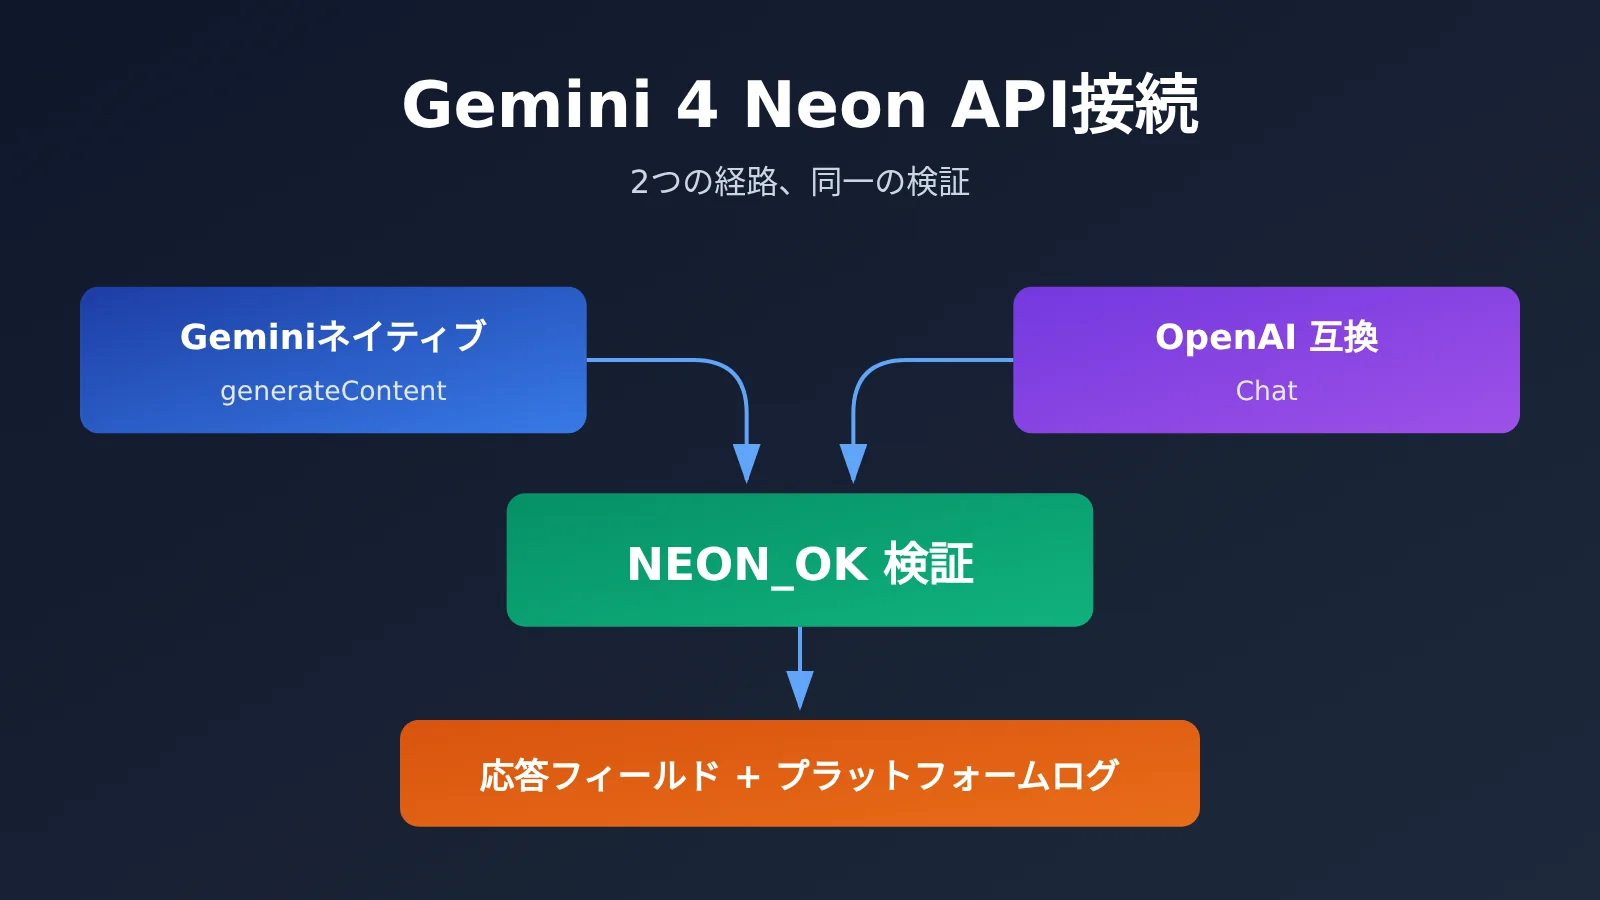
Gemini 4 Neon API 接続の知識マップと索引
接続作業は大きく3ステップに分かれます。エントリーポイントの選択、リクエストの送信、出力とログの照合です。各ステップの成果物は、次のステップへの入力になります。次の表は、3ステップの順序関係、この順序にする理由、各ステップで達成すべき目標をまとめたものです。知識マップとしても、読む際の索引としても使えます。
| 番号 | ステップ | 前のステップが提供するもの | この順序にする理由 | このステップの目標 |
|---|---|---|---|---|
| 1 | エントリーポイントの選択(1.1 Chat互換 / 1.2 ネイティブと思考レベル) | 既存のコードスタックと思考レベルへの要件 | エントリーポイントがURL、認証方式、フィールド構造を決め、後続のすべてのステップがそれに依存する | 1つのプロトコルを確定し、2つの経路で同時にトラブルシューティングしない |
| 2 | 同じ短いリクエストを送信(2.1 ネイティブ cURL / 2.2 Python SDK) | 確定済みのエントリーポイントとリクエスト形式 | 固定の短いプロンプトを使うことでモデル能力の差を排除し、経路が通るかどうかだけを検証できる | 完全なステータスコード、レスポンスヘッダー、レスポンスボディを取得する |
| 3 | 検収(3.1 フィールド / 3.2 IDとログ / 3.3 失敗時の証拠保全) | ステップ2で保存した生のレスポンス | まずレスポンス自体を確認し、その後プラットフォームのログと照合する。証拠は近いものから遠いものへ | 「テキスト成功」が成立するかどうかを判断する。成立しない場合は、追跡可能な証拠を残す |
読む際のヒント:どちらか一方のプロトコルだけを使う読者は、第1節で対応する小節を読んだあと、2.1または2.2のどちらか一方を直接読み、第3節は全体を通読してください。
To Know:Gemini 4 Neon API の必須用語
| 用語 | 簡潔な説明 |
|---|---|
generateContent |
Gemini ネイティブの非ストリーミング生成インターフェース。リクエストボディでは contents と parts でコンテンツを構成します |
thinkingLevel |
ネイティブインターフェースの generationConfig.thinkingConfig にある思考レベルのフィールド。本記事の例では high を使用します |
| thought part | ネイティブレスポンスで思考内容としてマークされる part。レスポンス本文を結合する際には除外します |
finishReason / finish_reason |
ネイティブと互換インターフェースそれぞれの停止理由フィールド |
X-Shellapi-Request-Id |
APIYI が生のレスポンスヘッダーまたはエラーメッセージで返すリクエスト識別子。トラブルシューティングに使用します |
1 Gemini 4 Neon API の接続エントリを選ぶ
2つのエントリは同じモデルを指しており、違いはプロトコルの形態と制御できるパラメータにあります。まず対照表を示し、その後に2つの小节で選択理由を説明します。
| 比較項目 | OpenAI 互換 Chat | Gemini ネイティブ |
|---|---|---|
| アドレス | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| 向いているプロジェクト | OpenAI SDK や Chat クライアントを既に持つプロジェクト | Gemini のパラメータを明示的に制御したいプロジェクト |
| 思考レベル | 本文では関連パラメータを渡さない | thinkingConfig.thinkingLevel |
| 本文の位置 | choices[0].message.content |
candidates[0].content.parts 内の thought 以外の text |
| モデル識別子 | レスポンス内の model |
レスポンス内の modelVersion(返される場合) |
1.1 Gemini 4 Neon 互換エントリ:既存の Chat クライアントをそのまま使う
既存コードが OpenAI Python SDK やその他の Chat Completions クライアントに基づいている場合、最も変更が少ない方法は base_url を https://api.apiyi.com/v1 に置き換え、モデル名を gemini-4-neon とし、メッセージ構造はそのままにするというものです。この方法の利点は、ビジネスロジック層のコードをほとんど変更する必要がなく、問題が発生したときもネットワーク、認証、モデルのどれに起因するかを判断しやすいことです。
このルートを使う際には、いくつか明確にしておくべき境界条件があります。第一に、reasoning_effort を渡さないでください。Google 自身の互換レイヤーはこれに対応付けを行っていますが、それは APIYI の互換エントリが同じ約束をしていることを意味しません。第二に、本文では /v1/responses インターフェースを使用しません。第三に、従来の thinkingBudget の記述方法や minimal レベルも本文の範囲外です。思考レベルを実際に制御する必要がある場合は、1.2 のネイティブエントリに切り替えてください。
1.2 Gemini 4 Neon ネイティブエントリ:思考レベルを明示的に設定する
ネイティブエントリは Gemini 自身のリクエスト構造を使用します。思考レベルは generationConfig.thinkingConfig.thinkingLevel を通じて明示的に渡し、APIYI の専用ユースケースで使用されている値は "high" です。ネイティブレスポンスは思考内容と本文を異なる part に分けて返すため、本文を読み取る際には能動的にフィルタリングする必要があります。2.1 節で具体的な書き方を示します。
認証については、このネイティブユースケースでは Authorization: Bearer リクエストヘッダーを使用しており、Gemini 公式でよく見られる key パラメータの記述方法は使用していません。既存のネイティブコードを移行する際には、まずこの点を確認してください。
2 Gemini 4 Neon API に同じ短いリクエストを送信する
両方のプロトコルで同じプロンプトを使います。Reply with exactly NEON_OK and nothing else. このプロンプトの想定出力は非常に短く、結果も判断しやすいものです。返ってきた内容が NEON_OK でなければ、経路やパースのどこかに問題があるということなので、「モデルの回答スタイルの違い」といったノイズは排除できます。APIキーは必ず環境変数 APIYI_API_KEY から読み取り、コードやコマンド履歴に直接書き込まないようにしましょう。
2.1 Gemini 4 Neon ネイティブ cURL と JSON からの値取得
次のコマンドは、HTTPステータスコード・レスポンスヘッダー・JSONレスポンスボディをそれぞれ保存します。第3節の検証では、この3つすべてを使います。
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
本文を読み取るときは、candidates[0].content.parts の中から thought ではない text をすべて連結する必要があり、最初の part だけを取ってはいけません。以下の例では jq を使っています。jq がインストールされていなければ、任意の JSON パーサーツールに置き換えてください。
# 本文:thought 以外の text を結合する
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# 停止理由、使用量、モデルバージョン(フィールドが存在しない場合は null を出力し、勝手に値を補わない)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# プラットフォームのリクエスト識別子
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Gemini 4 Neon の Python OpenAI SDK 呼び出しと返却値の読み取り
互換エンドポイントでは with_raw_response を使うことで、パース済みのオブジェクトと元のレスポンスヘッダーの両方を取得できます。max_retries=0 は SDK の自動リトライを無効にするための設定で、1回の失敗がリトライによって覆い隠されるのを防ぎ、同時にプラットフォーム上に複数のログが現れてどのリクエストか分からなくなる事態も避けられます。
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # APIYI の OpenAI 互換エンドポイント
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # 記録する前に、キーなどの機密情報が含まれていないか確認する
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
このコードで特に注意したい点が1つあります。choices が空のときに choices[0] をそのまま書いてしまうと、インデックスエラーが発生して本当の問題が覆い隠されてしまいます。接続エラーには HTTPステータスコードもレスポンスヘッダーもないため、APIStatusError とは分けて処理する必要があります。
3 Gemini 4 Neon API の最初のリクエストを検証する
検証の目的は、「プレーンテキストのリクエストが成功したかどうか」を判定することにあります。HTTP 2xx で本文が期待どおりの NEON_OK であることは、今回のテキストリクエストが成功したことだけを示しています。モデルの同一性を証明するものではなく、性能テストの結果として扱うこともできません。
3.1 HTTP ステータス、本文、停止理由、使用量
| チェック項目 | ネイティブフィールド | 互換フィールド | 合格条件 |
|---|---|---|---|
| HTTP ステータス | 保存された status | raw.status_code |
2xx |
| 本文 | thought 以外の text の連結 |
choices[0].message.content |
NEON_OK と等しい |
| 停止理由 | candidates[0].finishReason |
choices[0].finish_reason |
記録済みで、本文の状況と一致している |
| 使用量 | usageMetadata |
usage |
記録済みで、ログとの照合に使用する |
あるフィールドがレスポンスに存在しない場合は、「未返却」として記録し、経験に基づいて値を推測しないでください。停止理由は本文と合わせて確認してください。本文が空で、停止理由が正常終了でない場合、問題は通常、解析コードではなく生成プロセスにあります。
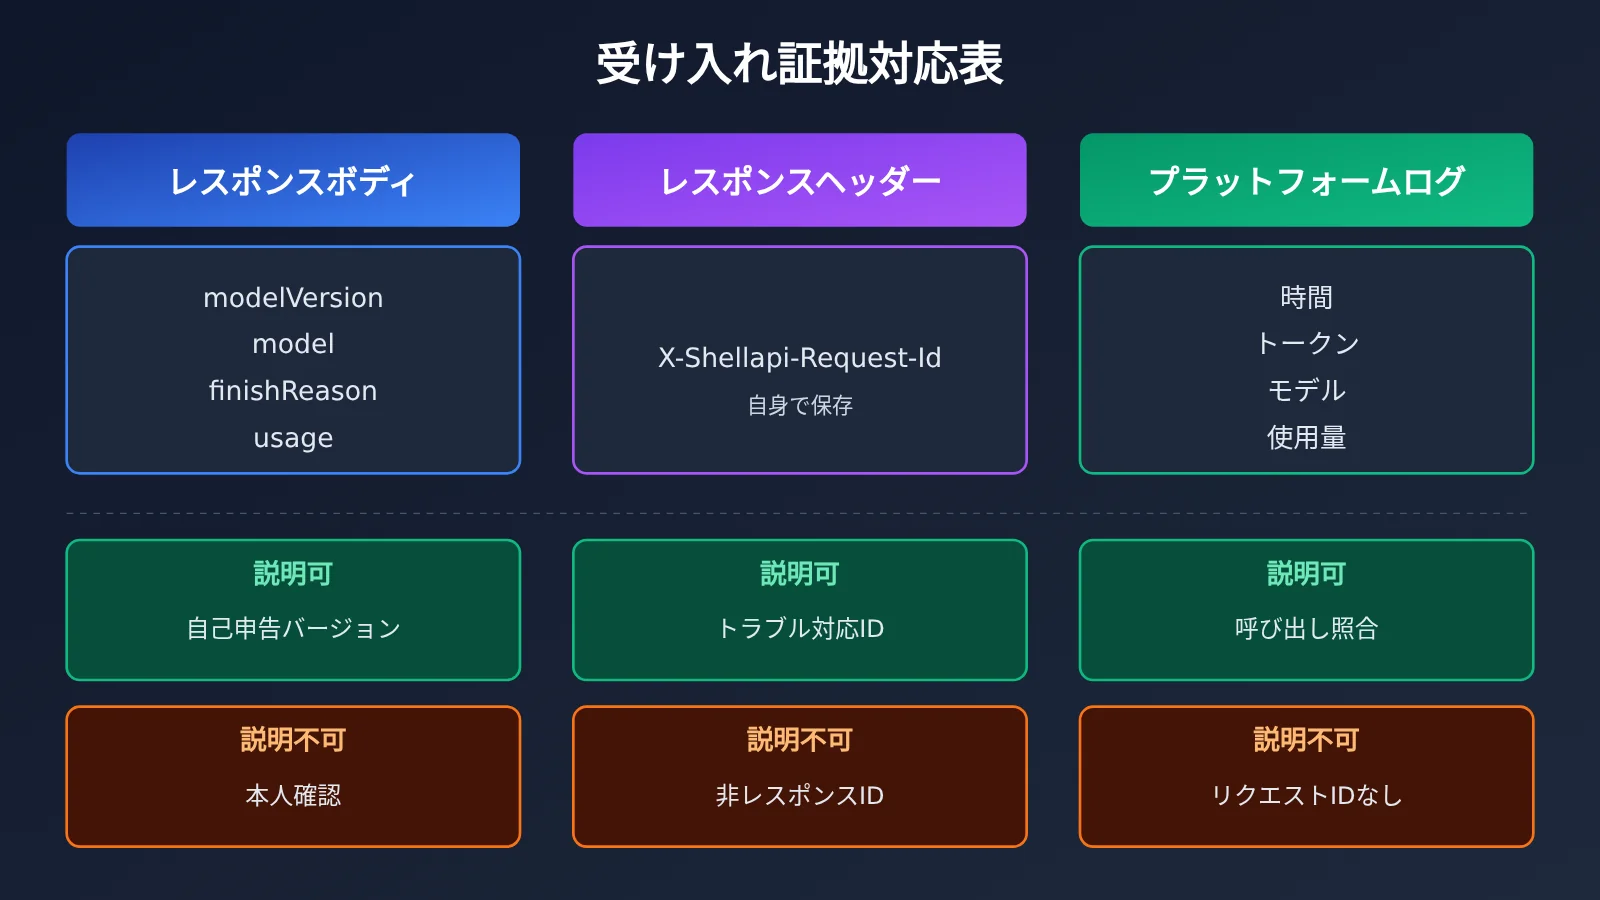
3.2 ネイティブの modelVersion、互換の model、ログはそれぞれ何を説明できるか
これらの情報はそれぞれ証明できる範囲が異なるため、記録する際に互いを代用してはいけません。
| 情報 | 出所 | 説明できること | 説明できないこと |
|---|---|---|---|
modelVersion |
ネイティブレスポンスボディ(返却された場合) | レスポンスが自己申告するモデルバージョン | 単独では身元証明にならない |
model |
互換レスポンスボディ | レスポンスが自己申告するモデル名 | 同上 |
| プラットフォームログ | api.apiyi.com/log |
時刻・トークン・モデル・使用量で今回の呼び出しを照合する | コンソールにリクエストIDが表示されない |
X-Shellapi-Request-Id |
生のレスポンスヘッダーまたはエラーメッセージ | プラットフォームのトラブルシューティングで使うリクエスト識別子 | これは responseId でも Chat の id でも、SDK の _request_id でもない |
ログを照合するときは、リクエストを送信した時刻、使用したトークン、モデル名 gemini-4-neon、そして使用量の数字を突き合わせます。コンソールにはリクエストIDが表示されないため、X-Shellapi-Request-Id はレスポンスヘッダーから自分で保存しておく必要があり、後からコンソールで調べることはできません。
3.3 Gemini 4 Neon で本文がない、またはリクエストが失敗した場合の証拠の残し方
リクエストが失敗した、あるいは本文がないときは、まずリトライせず、以下の順序で証拠を保存します。
- HTTPステータスコードを保存します。接続エラーの場合は、例外の種類を記録します。
- 元のレスポンスヘッダーを保存し、そこから
X-Shellapi-Request-Idを取り出します。 - 元のレスポンスボディまたはエラーメッセージを保存し、APIキーなどの機密情報を除去します。
- 停止理由と使用量(あれば)、およびリクエスト送信時刻、使用したトークン名、モデル名を記録します。
api.apiyi.com/logで時刻とトークンから該当するレコードを探し、上記の材料を持ってプラットフォームのリクエストIDトラブルシューティングドキュメントに照らして処理します。
ネイティブレスポンスについてもう一点注意があります。parts に thought の内容のみが含まれている場合、フィルタリング後の本文は空になります。このときは「フィルタリング後の本文が空である」とありのまま記録すべきで、出力を得るために thought の内容を本文として扱ってはいけません。
単一ターンのプレーンテキストが上記の方法で検収に合格したら、次にプロジェクトの必要に応じてストリーミング出力やツール呼び出しなどの機能を検証します。機能を追加するたびに、「同一リクエスト、元のレスポンスの保存、ログとの照合」の方法で個別に検収します。本記事ではベンチマークスコアや価格には触れません。関連情報は公式発表およびAPIYIの公開ディレクトリに準拠してください。
参考資料
- Google AI Studio 更新ログ(2026-11-18):
aistudio.google.com/docs/changelog - Gemini GenerateContentResponse 構造:
aistudio.google.com/api-reference/generate-content - APIYI Gemini 4 Neon リリース公告と2プロトコル例:
docs.apiyi.com/news/gemini-4-neon-launch.md - APIYI Gemini レスポンス処理:
docs.apiyi.com/api-capabilities/gemini/response-handling - APIYI OpenAI 互換レスポンス処理:
docs.apiyi.com/api-capabilities/openai/response-handling - APIYI リクエストIDトラブルシューティング:
docs.apiyi.com/faq/request-id-troubleshooting - openai-python 生レスポンスアクセス:
github.com/openai/openai-python
千里の道も一歩から。——『道徳経』