著者注:Gemini 4 Neon と GPT-6.2 Sol のコーディング、チャート、長いコンテキストの3項目を分けて比較し、タスクあたりの費用、所要時間、公式単価、APIYI の掲載価格を照合します。すべての数値には出典を明記します。
多くのチームは GPT-6.2 Sol をより安価な選択肢と見なしています。Gemini 4 Neon は 2026-11-18 にリリースされ、Artificial Analysis のモデルページでは知能スコアが 61、Sol は 57 とされています。この4点の差がどのタスクに現れるかで、あなたのワークロードにとっての価値が決まります。本記事では コーディング、チャート、長いコンテキスト の3つを分けて見ていき、さらにタスクあたりの費用と単価を2つの別会計として整理します。
本記事の各数値には出典ラベルを付けています:公式の自己申告、モデルカード、Artificial Analysis モデルページ、Artificial Analysis の記事、APIYI 一覧表、料金API。2つの基準で一致しない数値は並べてそのまま残し、平均を取ったり新しい数値に合成したりはしません。
核心価値:読み終えれば、Neon の上乗せスコアがどの項目に現れるのか、Sol がどの項目でむしろ高くなるのか、両者がタスクあたりの費用と所要時間でどれだけ差があるのか、そして APIYI 上で提供済みの gpt-6.2-sol をどう呼び出すのかを説明できるようになります。
Gemini 4 Neon と GPT-6.2 Sol の中核的な違いを一覧で確認
まずは最重要の7行をまとめて並べます。ここで注意したいのはグレードです。Artificial Analysis のモデルページでは、Neon の61点は xhigh グレード、Sol の57点は max グレードのスコアです。どちらも各ページにおける最上位グレードですが、グレード名とその意味は異なります。
| 比較項目 | Gemini 4 Neon | GPT-6.2 Sol | 出典 |
|---|---|---|---|
| 総合知能スコア | 61(xhigh) | 57(max) | Artificial Analysis モデルページ |
| コーディング:Terminal-bench 4.1(不正行為補正後の正答率) | 65.2% | 61.5% | モデルカード |
| チャート:Chartography | 73.5% | 75.1% | モデルカード |
| 長コンテキスト:GraphWalks(256k から 1M、BFS の F1) | 95.2% | 80.1% | モデルカード |
| タスクあたりの費用 | 6.44 ドル | 1.01 ドル | Artificial Analysis モデルページ |
| タスクあたりの時間 | 21.5 分 | 8.5 分 | Artificial Analysis モデルページ |
| 料金表記(入力/出力、100万トークンあたり) | 3 / 15 ドル | 2 / 10 ドル | 公式の自己申告 / Artificial Analysis モデルページ |
Gemini 4 Neon と GPT-6.2 Sol の比較表を読む前の3つの前提
1つ目はモデルカードの性質です。DeepMind のモデルカードにある比較表は Gemini 4 Neon、Claude Opus 5.5、GPT-6.2 Sol の3列のみで、付属の評価説明 PDF には、Gemini 以外の結果は既定で各社の自己申告に由来すると明記されています。したがって、モデルカードの Sol 列は Google が集約した公式数値であり、同一ラボが同じ日に再測定したものではありません。
2つ目は知能スコアの一貫性です。61 という数値は、Google ブログ(公式の自己申告)、モデルカード(AA Index v5.0.1 の1行に 61 / 59 / 57 と記載)、Artificial Analysis のモデルページで一致しています。Sol の 57 も、モデルカードと Artificial Analysis のモデルページで一致しています。コーディング系の指数はそこまで揃っておらず、以下では分けて記載します。
3つ目は費用の基準です。Artificial Analysis のタスクあたりの費用は、指数セット全体を実行した後に各タスクへ按分した金額であり、単価と出力トークン数の両方の影響を受けます。この数値と、プラットフォームがトークン単位で課金する1回の呼び出し価格は別会計であり、互いに代用できません。
Gemini 4 Neon と GPT-6.2 Sol のコーディング能力比較
コーディング分野について、モデルカードに示された5つの項目のうち、データがある項目ではいずれも Neon が Sol を上回っています。ただし、その差の大きさはかなりばらついています。以下の表はすべてモデルカードに基づくもので、Sol の数値は評価の説明によると OpenAI の自己申告によるものです。
| コーディング項目(モデルカード) | Gemini 4 Neon | GPT-6.2 Sol | 差 |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | データなし | 比較不可 |
| Terminal-bench 4.1(チート調整後) | 65.2% | 61.5% | 3.7 ポイント |
| FrontierCode 2.0 | 46.2% | 43.8% | 2.4 ポイント |
| SWE-sweep(ベンダー harness) | 39.0% | 8.3% | 30.7 ポイント |
| SWE-sweep(mini-SWE harness) | 12.8% | 11.6% | 1.2 ポイント |
SWE-sweep の2つの harness は分けて読む必要がある
SWE-sweep は最も誤読されやすい行です。Neon の 39.0% は Google Antigravity というベンダー harness によるもので、統一された mini-SWE harness に変えると 12.8% になります。Google のブログ(公式の自己申告)では、12.8 から 39.0 への差を harness がもたらす「解放(アンロック)」と表現しています。つまりこの数値群が示すのは「モデル+ツールチェーン」の組み合わせ効果です。
同じ mini-SWE harness の下では、Neon の 12.8% に対して Sol は 11.6% で、差はわずか 1.2 ポイントです。Sol は自社ベンダー harness では 8.3% で、むしろ mini-SWE の成績を下回っています。あなたのコーディングエージェントが Antigravity 上で動いていないなら、mini-SWE の行のほうが再現できる条件に近いと言えます。
Coding Agent Index の2つの数値
Google のブログ(公式の自己申告)では、Neon の Artificial Analysis Coding Agent Index を 58.6 と記載し、総合1位としています。一方、Artificial Analysis の記事では Antigravity CLI 上の Neon xhigh が 59 と書かれています。2つの数値は出所が異なるため、本稿では両方をそのまま残し、合成はしません。参考資料には Sol のこの指数におけるスコアがないため、この項目では両者の比較ができません。また、FrontierCode 2.0 の 46.2% は公式の自己申告によると、デフォルトの high 設定で測定されたものです。
Gemini 4 Neon と GPT-6.2 Sol のチャート能力を比較
チャートは3項目のうちSolが上回る項目です。モデルカードのChartographyの行では、Neonが73.5%、Solが75.1%で、Solが1.6ポイント高い結果になっています。Googleのブログ(ベンダーによる自己申告)に載っているNeonの数値も同じ73.5%で、両者は一致しています。
同じくマルチモーダル理解に属するLVBenchでは、モデルカードにNeon 89.0%、Sol 87.6%とあり、こちらはNeonが1.4ポイント上回ります。2項目は方向が逆で、差もどちらも大きくないため、「チャートと視覚タスクのどちらが強いか」を一言でまとめるのは難しく、あなたのタスクがチャートを読む方に近いのか、長い動画を見る方に近いのかによって判断が変わります。
入力モダリティについては、モデルカードにNeonがテキスト・画像・音声・動画を受け付けると明記されています。参考資料にはSolの入力モダリティ一覧が示されていないため、音声や動画の入力を前提としたフローを使っている場合は、まずOpenAIの公式ドキュメントでSolの対応状況を確認してください。
Gemini 4 Neon と GPT-6.2 Sol の長コンテキストを比較
長コンテキストの項目では、本記事はモデルカードのGraphWalksデータのみを使用します。256kから1Mトークンの区間でBFS走査を行い、F1スコアはNeonが95.2%、Solが80.1%で、15.1ポイントの差があり、3項目の中で最も差が大きい項目です。
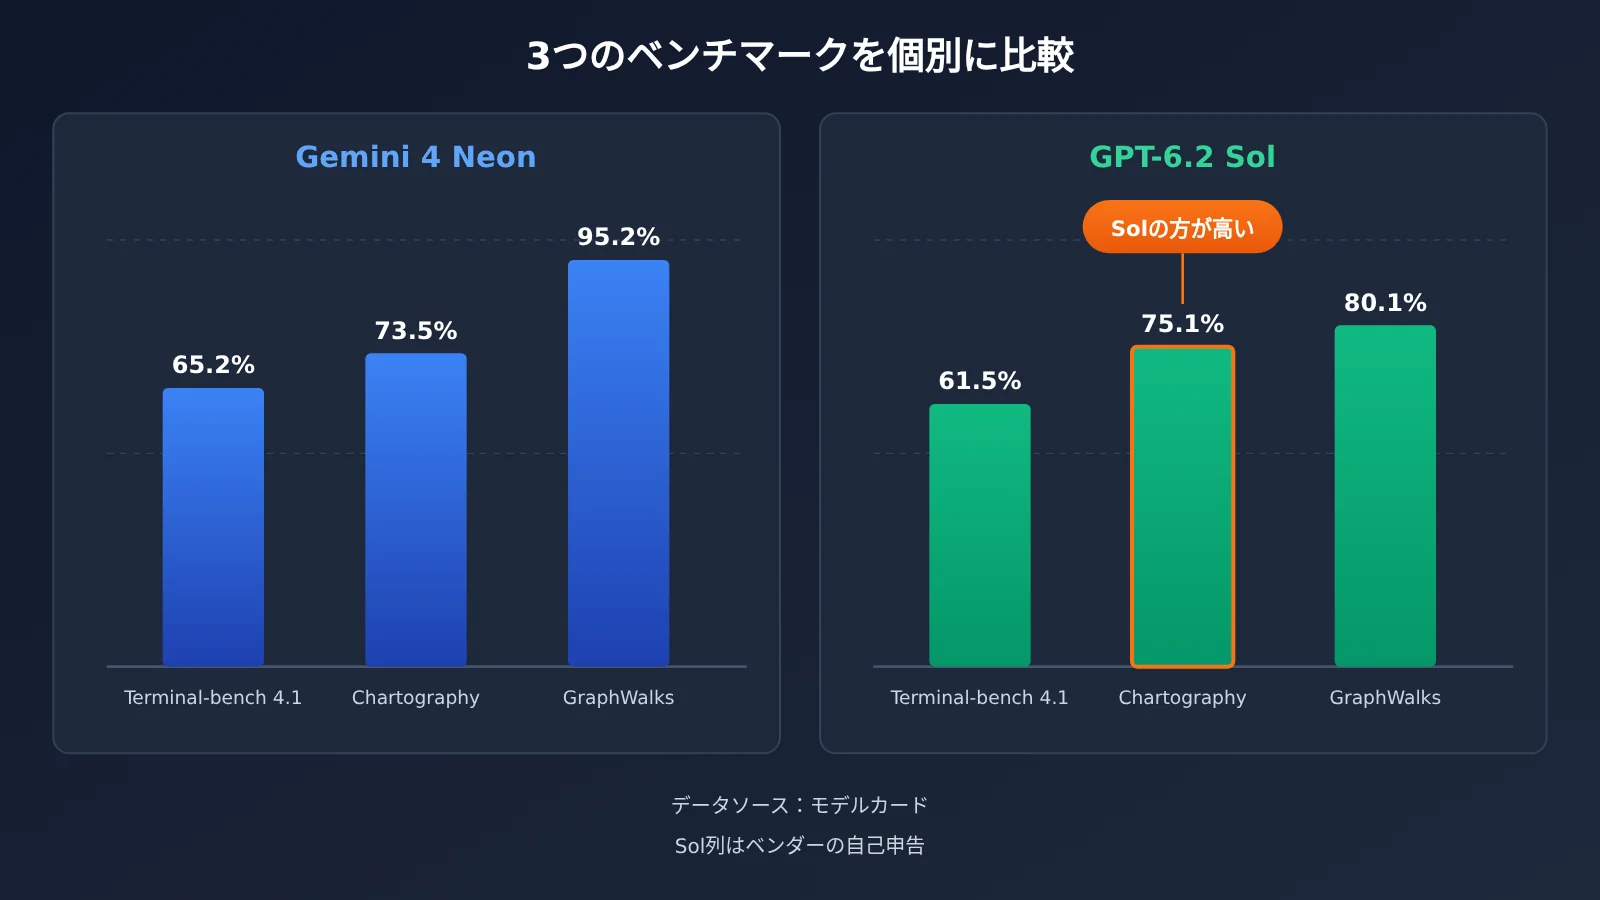
📊 図表の説明:上図の数値はすべてモデルカードに由来し、Solの列は評価上の注記によりベンダーによる自己申告に該当します。ご自身の長いドキュメントでSolの性能を再検証したい場合は、APIYI apiyi.com 経由で同じKeyを使い、直接
gpt-6.2-solリクエストを送信できます。
Gemini 4 Neon の長コンテキストパラメータ
Neon側のウィンドウ仕様はドキュメントが揃っています。モデルカードには、統合ウィンドウが最大100万トークン、デフォルトの同期出力が最大6.4万トークン、バックグラウンドの長デコードが最大100万と書かれています。Google Cloudの開発者ガイドには正確な値が示されており、統合上限が1048576トークンで、入力と出力を同時に含み、出力には思考・関数呼び出し・最終応答が含まれます。単一セグメントのデフォルトは最大65536、長デコードでは1048576から入力を引いた値まで可能です。
キャッシュについては、開発者ガイドにNeonが明示的なコンテキストキャッシュをサポートしないと明記されています。暗黙的キャッシュは4096トークン以上の共有プレフィックスに対して自動的に有効になり、永続キャッシュはデフォルトでオンです。長いドキュメントに対して繰り返し質問するような場面では、AI Studioの料金ページに記載された0.15ドルのキャッシュ価格を享受するために、共有プレフィックスを安定させておく必要があるということです。
GPT-6.2 Sol の長コンテキスト情報
参考資料にはSolのコンテキストウィンドウの上限が示されていないため、本記事ではウィンドウサイズの比較は行いません。確認できるのは課金体系です。APIYIの一覧表によると、gpt-6.2-sol は入力が272000トークンを超えると料金ティアが切り替わり、この点は後段の価格パートで詳しく述べます。長コンテキストのタスクでは、このしきい値が請求構造に直接影響します。
Gemini 4 Neon と GPT-6.2 Sol の費用・所要時間の比較
1タスクあたりの費用差は、単価の差よりもはるかに大きくなっています。Artificial Analysis のモデルページによると、Neon xhigh は1タスク6.44ドル、Sol max は1タスク1.01ドルで、前者は後者の約6.4倍です。一方、両者の入力単価比は3対2、出力単価比は15対10で、いずれも1.5倍です。
差の大半は出力量から来ています。同じページで、Neon xhigh がインデックスを実行したときの出力は2億8300万トークン、Sol max は6090万トークンで、前者は後者の約4.6倍です。単価が1.5倍、出力量が数倍、この2つが重なって6.44対1.01という結果になります。
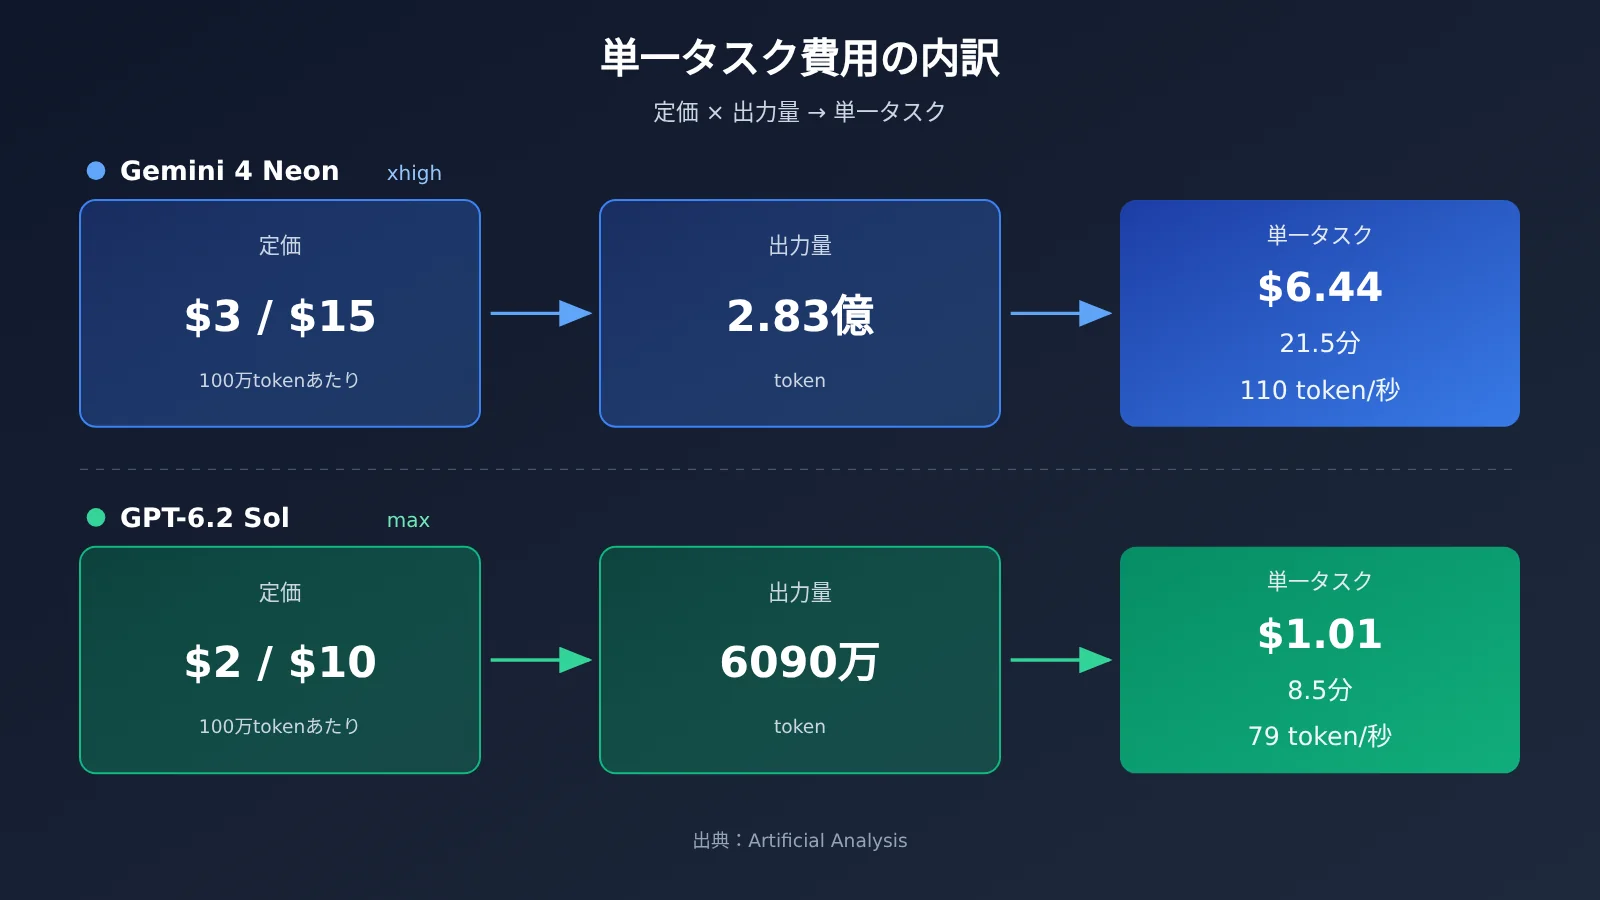
所要時間も同じ構図です。Neon xhigh の出力速度は約110トークン/秒で、Sol max の79トークン/秒より速いものの、出力量が多いため、1タスクの所要時間は21.5分対8.5分になります。最初の回答トークンまでの時間は Neon xhigh が56.51秒、Sol max が75.06秒で、この項目では Neon のほうが速いです。
思考レベル別の知能スコアと1タスク所要時間
両モデルには複数の思考レベルがあります。以下の表は Artificial Analysis のモデルページに基づいています。1タスクあたりの費用は最上位レベルの行にのみ数値があり、ほかのレベルについてはスコア、時間、速度がページに記載されています。
| レベル | Neon 知能スコア | Neon 1タスク所要時間 | Neon 出力速度 | Sol 知能スコア | Sol 1タスク所要時間 | Sol 出力速度 |
|---|---|---|---|---|---|---|
| max | 該当なし | — | — | 57 | 8.5分 | 79トークン/秒 |
| xhigh | 61 | 21.5分 | 110トークン/秒 | 56 | 5.3分 | 76トークン/秒 |
| high | 60 | 14.8分 | 101トークン/秒 | 55 | 4.6分 | 73トークン/秒 |
| medium | 55 | 8.3分 | 101トークン/秒 | 53 | 3.2分 | 70トークン/秒 |
| low | 44 | 3.7分 | 97トークン/秒 | 41 | 1.5分 | 65トークン/秒 |
この表には2つの読み方があります。同じ名称のレベルで見ると、high では Neon が60点、Sol が55点で、所要時間は14.8分対4.6分です。時間で見ると、Neon medium の8.3分と Sol max の8.5分は近く、スコアは55対57です。Neon のデフォルトレベルは high です(開発者ガイドと AI Studio の最新モデルページのいずれもそう記載しています)。これは多くの統合でデフォルトとして選ばれる行でもあります。Neon の下位3レベルにおける最初のトークンまでの時間は、モデルページの FAQ に別途記載があります。high 40.64秒、medium 20.14秒、low 13.93秒で、この数値群は集計表とは別の欄にあります。
Gemini 4 Neon と GPT-6.2 Sol の価格比較:公式単価と APIYI のラインナップ
単価については2つのレイヤーに分けて考えます。モデル提供元やサードパーティのページに記載された表示価格と、APIYI(apiyi.com)のラインナップ価格です。
| 項目 | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| 入力表示価格(100万トークンあたり) | 3.00 ドル(公式発表 / AI Studio 料金ページ) | 2.00 ドル(Artificial Analysis モデルページ) |
| 出力表示価格(100万トークンあたり) | 15.00 ドル(思考トークンを含む) | 10.00 ドル |
| キャッシュ | 0.15 ドル、暗黙的キャッシュのみ | キャッシュ割引 95%(Artificial Analysis モデルページ) |
| 無料枠 | なし(AI Studio 料金ページ) | 参考資料に記載なし |
| APIYI モデル ID | 未掲載 | gpt-6.2-sol |
| APIYI 第1段階(入力 0〜272000 トークン) | — | 入力 2 / キャッシュ読み取り 0.1 / 出力 10 ドル |
| APIYI 上位段階(入力 272000 トークン超) | — | 入力 3 ドル;料金API の出力は約 11.25 ドル |
| APIYI エンドポイント | — | responses(推奨)、chat |
| 利用可能なプラットフォーム | Google AI Studio の Gemini API などの公式チャネル | APIYI apiyi.com など |
gemini-4-neon は APIYI の総合一覧表にも料金API にもまだ存在せず、未掲載です。このモデルはできるだけ早く掲載します。モデル名と価格はプラットフォームのモデル一覧を基準にしてください。
APIYI における gpt-6.2-sol の段階切り替えの詳細
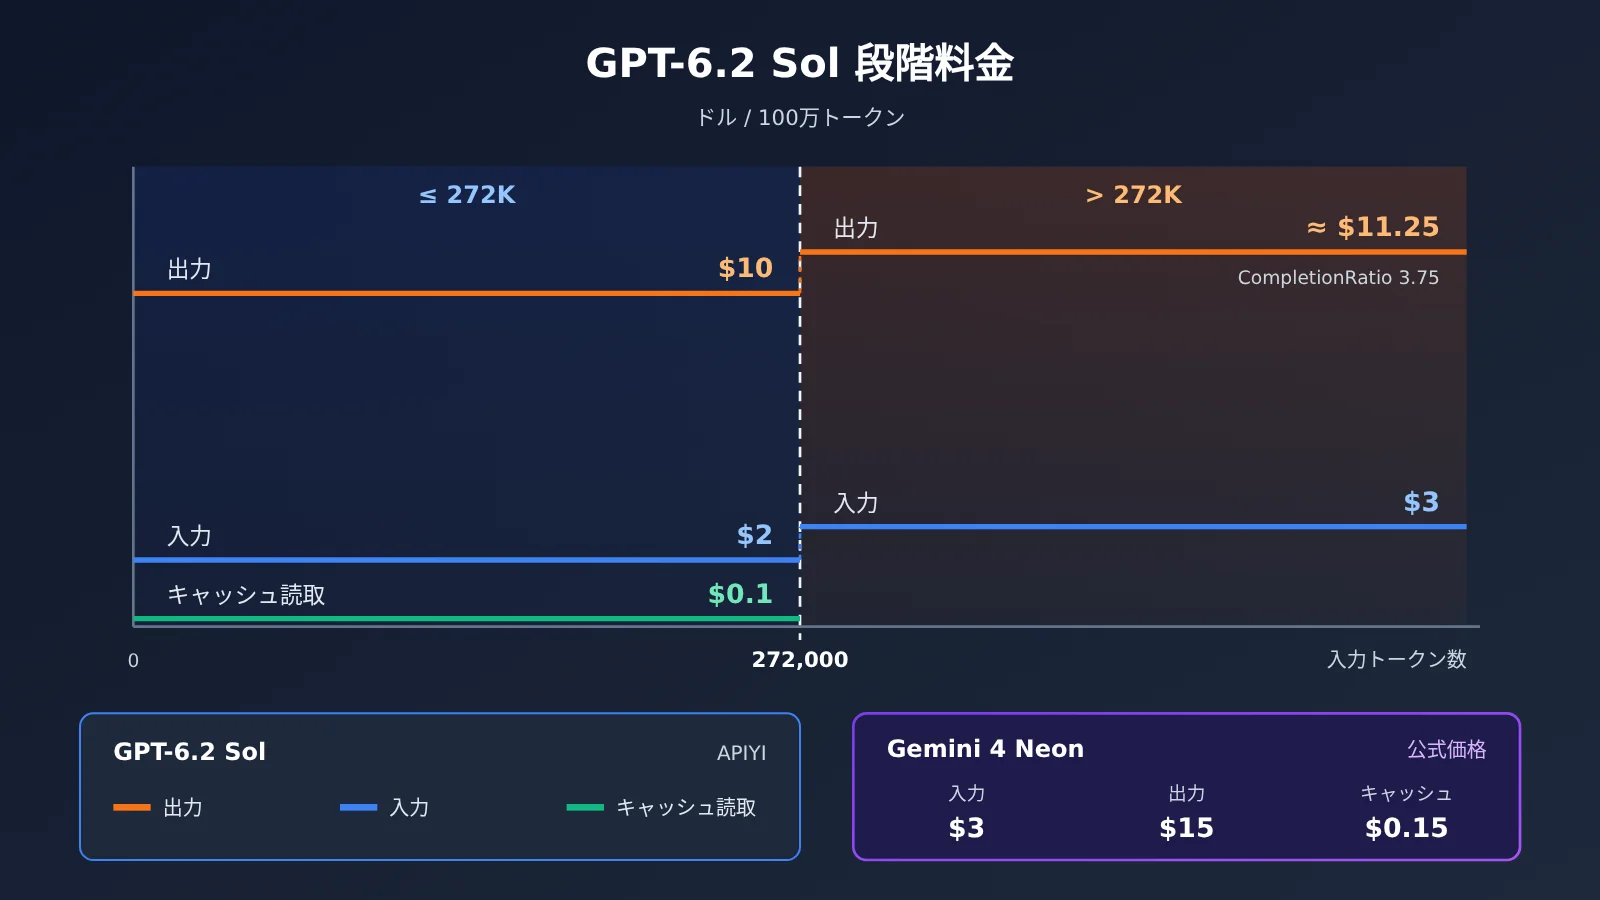
APIYI の総合一覧表(ページの更新日時は 2026-11-16 09:39、UTC+8)には gpt-6.2-sol の第1段階として入力 2 ドル、キャッシュ読み取り 0.1 ドル、出力 10 ドルと記載されており、Artificial Analysis モデルページの 2/10 という表示価格と一致します。入力が 272000 トークンを超える場合、総合一覧表の本文には入力が 2 ドルから 3 ドルに上がることだけが書かれています。
2026-11-19 に照会した料金API(バージョン shell-api-modelmak-v1、全285モデル)では、より完全な情報が得られます。API 内で model_ratio が 1 なら入力 100万トークンあたり 2 ドルに対応し、completion_ratio が 5 なら出力が入力の5倍であることを示します。272000 トークンを超えると CompletionRatio は 5 から 3.75 に変わり、入力 3 ドルで換算すると出力は 100万トークンあたり約 11.25 ドルとなります。10 ドルのまま計算されるわけではありません。
グループ名は2か所で表記が少し異なります。総合一覧表では CodexResponses、Codex_Reverse、Default、SVIP、料金API では CodexResponses、CodexReverse、default、svip と書かれています。また改めて強調しておきたいのは、Artificial Analysis の 1.01 ドルは指数(ベンチマーク)を実行する際に各タスクへ按分した費用であり、プラットフォーム上で1回の呼び出しによって実際に発生するトークン費用とは別物だということです。
Gemini 4 Neon と GPT-6.2 Sol のシナリオ別比較
以下では、タスク種別ごとに最も関連性の高い数値を示します。評価結果と自分のワークロードを照らし合わせる際の参考にしてください。どちらがより適しているかは、タスクの分布と予算によって変わります。ここでは比較のみを行い、結論は出しません。
コーディングエージェントに関連する数値
- Google Antigravity 内で実行する場合:SWE-sweep のベンダー harness 行を見てください。Neon 39.0%、Sol 8.3% です。あわせて、Google 自身がこの差を harness に起因すると説明している点も覚えておきましょう。
- 汎用 harness で実行する場合:mini-SWE 行を見てください。12.8% 対 11.6% であり、Terminal-bench 4.1 では 65.2% 対 61.5% です。
- 高頻度の小規模変更:1タスクあたりの時間がより重要になります。ティア表で同程度のスコア帯の所要時間を照合するとよいでしょう。
グラフ・チャートと長文ドキュメントに関連する数値
- 決算資料のグラフやダッシュボードのスクリーンショットに関するQ&A:Chartography では Sol が 75.1%、Neon が 73.5% です。この項目の傾向は総合スコアとは逆になっています。
- 数十万トークン規模のグラフ構造やドキュメント走査:GraphWalks では Neon が 95.2%、Sol が 80.1% です。あわせて、APIYI で Sol が 272000 トークンを超えると料金ティアが切り替わることもコストに含めてください。
- 長尺動画の理解:LVBench では Neon が 89.0%、Sol が 87.6% です。また、モデルカードには Neon が動画入力に対応すると明記されています。
Gemini 4 Neon と GPT-6.2 Sol の選択アドバイス:まず確認してから選ぶ
モデルを選ぶ前に、61 対 57 という数字だけで判断するのではなく、次の順序で自分の状況を確認することをおすすめします。
- 自分のタスクの中で、コーディング・グラフ/図表・長いコンテキストの3種類がそれぞれ何割を占めるかを集計し、上記の3つの項目別テーブルと照らし合わせます。
- 各タスクの平均出力量を見積もります。Artificial Analysis のデータによると、両者の1タスクあたりのコスト差は主に出力量に起因しており、タスクの出力が長いほどその差は顕著になります。
- 入力長が 272000 token を超えるかどうかを確認します。超えた場合、APIYI における
gpt-6.2-solの入力・出力の単価が変わります。 - 思考レベル(thinking tier)を確認します。Neon は low、medium、high、xhigh の4段階のみに対応しており、
thinking_budgetやMINIMALを渡すと HTTP400が返されます(開発者ガイド)。 - 自分のサンプルセットで小規模な比較テストを実行し、スコア・所要時間・token 使用量を記録します。
💡 選択のヒント:両モデルは項目ごとに一長一短があり、最終的にはあなたのタスク分布と予算次第です。まずは APIYI apiyi.com で既に提供中の
gpt-6.2-solを接続し、自分のサンプル上で token 使用量と所要時間を記録しておき、Neon が提供開始された後に同じスクリプトで比較テストを実行することをおすすめします。
APIYI で GPT-6.2 Sol をすばやく呼び出す方法
APIYI が gpt-6.2-sol に推奨しているエンドポイントは responses で、OpenAI 互換の base_url は https://api.apiyi.com/v1 です。接続はわずか4ステップで完了します。
- キーを準備する:プラットフォームのコンソールで API Key を発行し、環境変数
APIYI_API_KEYに設定します。コード内では環境変数から読み取るだけにして、平文で書き込まないようにしましょう。 - リクエスト先を決める:Responses エンドポイントは
POST https://api.apiyi.com/v1/responsesで、リクエストヘッダーにはAuthorization: Bearer $APIYI_API_KEYとContent-Type: application/jsonを付けます。 - リクエストボディを組み立てる:最小構成のリクエストボディは
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}です。 - OpenAI SDK で呼び出す:
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"])で初期化し、続いてclient.responses.create(model="gpt-6.2-sol", input=...)を呼び出して、返却オブジェクトのoutput_textから結果を読み取ります。
既存のコードが Chat Completions ベースであれば、同じモデル ID を chat エンドポイント(パスは /v1/chat/completions)に送ることもできます。Gemini のネイティブプロトコルは https://api.apiyi.com に v1beta バージョンを組み合わせた形で、プラットフォームに登録済みの Gemini モデルに適用できます。
長いコンテキストのテストを行う際は、リクエストごとの入力 token 数をログに合わせて記録しておくと、272000 という段階(ティア)のラインを超えたかどうかを判断しやすくなります。思考レベル(reasoning effort)パラメータの具体的な値については、OpenAI 公式ドキュメントおよびプラットフォームのモデルページを参照してください。
🚀 クイックスタート:新規ユーザーは APIYI apiyi.com で無料のテスト枠を受け取れます。1つの Key で OpenAI、Claude、Gemini など登録済みのモデルをまとめて呼び出せるので、まずは
gpt-6.2-solの responses 経路を通してみましょう。以後モデルを切り替えるときはmodelフィールドを変えるだけです。
よくある質問(FAQ)
Q1: Gemini 4 Neon と GPT-6.2 Sol はそれぞれどんな位置づけですか?
Neon は Gemini 4 Carbon をベースに調整されたモデルです(モデルカード)。Google の開発者ガイドでは、Hydrogen(日常的な高速ループ)と Carbon(複雑な長距離タスク)の中間に位置づけられています。GPT-6.2 Sol は Artificial Analysis のモデルページで 2/10 ドルと価格が示されており、最上位グレードの max で知能スコアは 57 です。
Q2: Neon が Sol より 4 点上回るのは、主にどの項目ですか?
モデルカードの項目別に見ると、差が最も大きいのは長文コンテキストの GraphWalks(95.2% 対 80.1%)と、ベンダーの harness 環境での SWE-sweep(39.0% 対 8.3%)です。図表の Chartography では Sol のほうが高くなっています(75.1% 対 73.5%)。
Q3: Gemini 4 Neon はいつリリースされ、どのチャネルで使えますか?
Google ブログでの公開日は 2026-11-18 です。Sundar Pichai のリリース投稿によると、当日から Google AI Studio の Gemini API、Gemini for business、有料の Google AI Pro と Ultra の Google Antigravity、さらに Pro と Ultra の Gemini App で提供が始まりました。モデル ID は `gemini-4-neon` です。
Q4: Sol の 1 タスクあたり 1.01 ドルは、そのまま呼び出し予算と見なせますか?
この数値は、Artificial Analysis が指数セット全体を実行したうえで 1 タスクあたりに按分した費用で、Sol max はそのテストで 6090 万トークンを出力しています。実際の費用は自分の入出力トークン数と課金グレードによって変わります。APIYI の一覧表にある最初のグレード 2 / 0.1 / 10 ドルを使って自分で概算し、272000 トークンを超えるとグレードが切り替わる点にご注意ください。
Q5: この 2 つのモデルを API 経由ですぐに呼び出すには?
`gpt-6.2-sol` はすでに APIYI に掲載済みです。apiyi.com で登録してテスト用クレジットを受け取り、base_url を `https://api.apiyi.com/v1` に設定して `responses` エンドポイントを呼び出すだけです。`gemini-4-neon` は現在、一覧表にも価格 API にもまだ登録がなく、未掲載です。できるだけ早く掲載する予定です。型番と価格はプラットフォームのモデル一覧を基準にしてください。
Q6: これらの比較データにはどんな限界がありますか?
主に次の 3 点です。
– **集計基準**:モデルカード上の Sol のスコアは、評価の注記によるとベンダーによる自己申告値であり、同じ日に再測定したものではありません。
– **グレード**:Artificial Analysis で Neon の最上位は xhigh、Sol は max で、グレードが完全に対等ではありません。
– **数値の不一致**:Coding Agent Index は Google ブログでは 58.6、Artificial Analysis の記事では 59 です。WebExploitBench v1.2 はブログでは 51.26%、モデルカードでは 51.3% と記載されており、本記事ではいずれも原文のまま表記しています。
Gemini 4 Neon と GPT-6.2 Sol の主なポイント(Key Takeaways)
- 総合スコア:Artificial Analysis のモデルページでは、Neon xhigh が 61 点、Sol max が 57 点です。
- コーディング:モデルカードの Terminal-bench 4.1 は 65.2% 対 61.5% ですが、SWE-sweep の差は harness ごとに見る必要があります。
- チャート:Chartography では Sol の方が高く、75.1% 対 73.5% です。
- 長いコンテキスト:GraphWalks の 256k から 1M における F1 は 95.2% 対 80.1% で、差が最も大きくなっています。
- コストと所要時間:1 タスクあたり 6.44 ドル 対 1.01 ドル、21.5 分 対 8.5 分で、主な原因は出力量が数倍異なることです。
- 単価:Neon は 3/15 ドル、Sol は 2/10 ドルです。APIYI では
gpt-6.2-solが 272000 入力トークンを超えると価格帯が切り替わります。
まとめ
Gemini 4 Neon と GPT-6.2 Sol の違いは、項目ごとに分解すると総合スコアよりもはるかにはっきりします。
- コーディング:Neon はモデルカードにデータがある項目では上回っていますが、同じ mini-SWE harness ではわずか 1.2 ポイント差です。
- チャート:Chartography では Sol が上回り、LVBench では Neon がわずかに上回ります。
- 長いコンテキスト:GraphWalks では Neon が 15.1 ポイントリードしており、3 項目の中で最も差が顕著です。
- コスト:単価は 1.5 倍の差、1 タスクあたりの費用は約 6.4 倍の差があり、その差を広げているのは出力トークン数です。
どちらを選ぶかは、自分のタスク分布と出力長に立ち返って判断すべきです。まずは APIYI apiyi.com 経由で gpt-6.2-sol に接続し、実際のサンプルで使用量と所要時間を記録することをおすすめします。Neon の提供開始後は、同じ手順で比較データを補完してください。
📚 参考資料
-
Google ブログ「Introducing Gemini 4 Neon」:公式発表と自己申告ベンチマーク
- リンク:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 説明: 総合・コーディング・科学・価格設定はいずれも公式の自己申告値です
- リンク:
-
DeepMind Gemini 4 Neon モデルカード:3列対照表の出典
- リンク:
deepmind.google/models/model-cards/gemini-4-neon - 説明: Chartography、GraphWalks、SWE-sweep などの項目別データ
- リンク:
-
Google Cloud Gemini 4 Neon デベロッパーガイド:コンテキストウィンドウ、思考レベル、キャッシュのルール
- リンク:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 説明: 1048576 token の統一上限、HTTP 400 のルール、暗黙的キャッシュの説明
- リンク:
-
Google AI Studio 料金ページ:Neon の公式単価
- リンク:
aistudio.google.com/docs/pricing - 説明: 入力 3、出力 15、キャッシュ 0.15 米ドル(100万トークンあたり)
- リンク:
-
Artificial Analysis モデルページ:Neon と Sol の階層別データ
- リンク:
artificialanalysis.ai/models/gemini-4-neon、artificialanalysis.ai/models/gpt-6-2-sol - 説明: 知能スコア、タスクあたりのコスト、所要時間、出力速度
- リンク:
-
Artificial Analysis の記事:Neon の第三者計測結果の解釈
- リンク:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 説明: Coding Agent Index 59 などのデータ
- リンク:
-
APIYI 総合表と料金 API:掲載済みモデルと段階料金
- リンク:
docs.apiyi.com/models.md、api.apiyi.com/api/pricing - 説明:
gpt-6.2-solの第1段階と、272000 token での段階切り替えルール
- リンク:
作者: APIYI 技術チーム
技術交流: APIYI サイトのトップページからお問い合わせください。その他のモデルや接続方法については、docs.apiyi.com のドキュメントセンターをご覧ください