要約:本稿は公開された第三者テストレポートに基づき、Qwen4-Max-Preview がクレーンゲーム、Python サービスの修正、1,600件のチケット検索などのタスクをどのようにこなしたかを分析し、所要時間と科学研究上の判断における限界を説明します。
まず結論から:Qwen4-Max-Preview のプログラミング能力に関する中核的判断
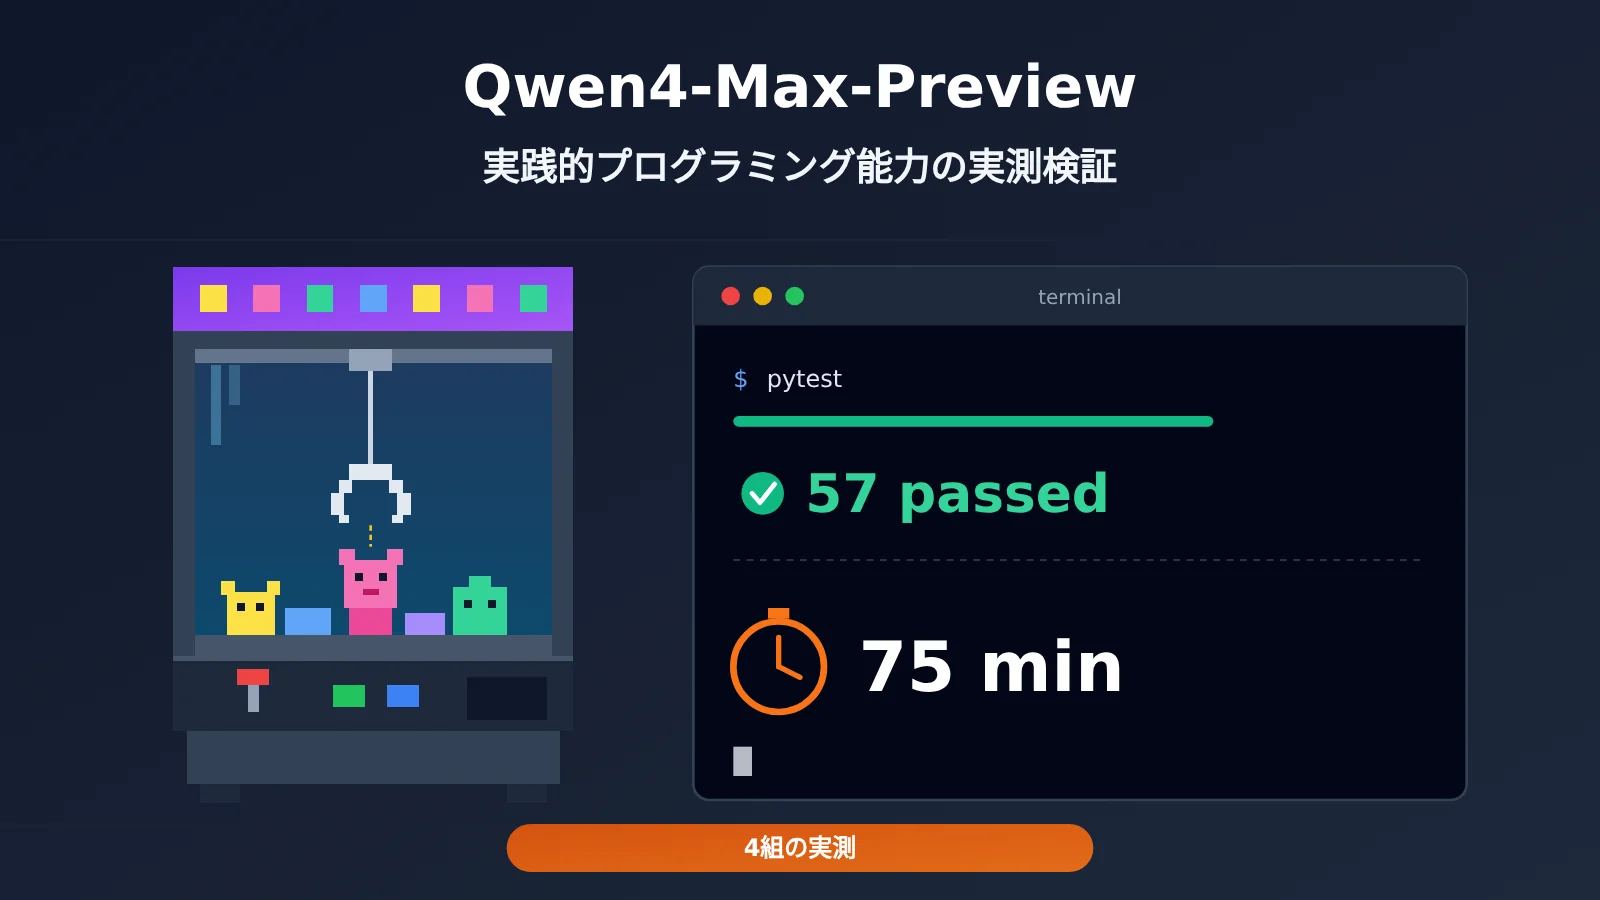
公開テストレポートによると、Qwen4-Max-Preview は多段階の開発を進め、テストを追加し、再検証可能なプロジェクトとして納品できます。最も有力な根拠は、あるコード修正タスクから得られています。モデルはまず不具合を再現し、次にテストを追加し、実際の HTTP リクエストを送信してデータ整合性を検証し、最終的に57件のテストがすべて通過しました。弱点も同樣に明確です。複雑なタスクでは時間がかかり、クレーンゲームのタスクには約75分を要しました。また科学研究タスクでは、モデルによる計算結果の解釈が根拠の範囲を超えていました。そのため、複雑な成果物や科学的結論には開発者によるレビューが必要です。
以下ではまずクレーンゲームのタスクから見ていきます。続いて、12項目のタスクを網羅するレポートを整理し、特にコード修正とチケット検索という2組の検証可能な根拠を重点的に分析します。その後、非負値行列因子分解の事例を用いてモデルの推論上の限界を説明し、さらに同じクレーンゲームの課題におけるツール横断比較を通じて効率の問題を論じ、最後にこのモデルに任せるのに適したタスク種別を示します。本稿は公開レポートに基づく評価分析であり、著者のプロジェクトを再実行したものではありません。すべての数値には出典とテスト条件を明記しています。
To Know:Qwen4-Max-Preview 評価を理解するための9つの用語
| 用語 | 説明 |
|---|---|
| Agent | モデルが自らステップを計画し、ツールを呼び出してタスクを段階的に進めていく働き方です。 |
| 状態機械 | 一連の状態と、状態間の遷移ルールによってプログラムの動作を制御する仕組みです。たとえばクレーンゲームの「移動—下降して掴む—上昇—精算」のようなものです。 |
| 回帰テスト | コードを修正した後に既存の機能を再検証し、以前の動作が壊れていないことを確認します。 |
| HTTP リクエスト | クライアントがサーバーへ送るリクエストで、実際に動作させたときにインターフェースがどのような結果を返すかを検証するために使います。 |
| ハッシュ検証 | ファイル内容のダイジェスト値を計算し、前後で比較することで、元データやテストファイルが改変されたかどうかを判定します。 |
| Token スループット | 単位時間あたりに処理または生成される Token の数です。その値はツール、ネットワーク、実行環境の影響を受けます。 |
| コンテキスト検索 | 1回のリクエストに含まれる大量の資料の中から、目的の情報を特定して関連付けることです。 |
| 非負行列分解 | 非負のデータ行列を、2つの非負因子行列の積に近似的に分解するアルゴリズムです。 |
| 局所最適解 | 近傍の範囲内ではそれ以上改善できない解です。ある解が局所最適かどうかを判断するには、追加の数学的条件や分析が必要になります。 |
1 75分でクレーンゲームを完成:Qwen4-Max-Preview による複雑なプログラミングタスク
1.1 クレーンゲームタスクが評価するもの
2026年11月12日、『人人都是产品经理』は Qoder を使った Qwen4-Max-Preview の実測レポートを公開しました。その中で最も複雑な項目の一つが、クレーンゲームのインタラクティブシステムです。このタスクは、機械的なインタラクションと力覚フィードバック、ロープの垂下・揺れ、ぬいぐるみ同士の衝突、制御フローのステートマシン、そして最終的なスコアリングロジックなど、複数のプログラミング上の難所を一つのプロジェクトに集約しています。
こうしたタスクは、一度の生成だけで完了させるのは難しいものです。物理表現、状態遷移、スコアリングルールが互いに依存しているため、モデルは書く・実行する・観察する・修正するという工程を繰り返す必要があります。したがって、ここで問われるのはエージェント型の多段階での推進能力です。
1.2 著者が記録した所要時間・速度・消費量
| 指標 | 著者の記録 | テスト条件と説明 |
|---|---|---|
| 総所要時間 | 約75分 | Qoder 環境、単一タスク |
| 出力速度 | 約33 Tokens/s | このタスクで観測された速度 |
| Credits 消費 | 約65 | 著者による推定、Token Plan の計量 |
| 成果品質 | 比較的堅実 | 著者の主観評価で、全体として Kimi K3.1 と互角と見なしている |
これらの数値は、今回のタスクに限ったものです。Credits は Token Plan のサブスクリプション計量単位であり、実際の消費量は入力、キャッシュヒット、出力、思考トークン、ツール呼び出しの影響を総合的に受けます。65 Credits は今回のタスクの消費量の目安程度しか示しません。33 Tokens/s も、特定環境下での観測値です。
同じレポートには、他のいくつかのタスクも記録されています。NumPy と PIL のみを使った水墨画タスクでは、モデルは1,000行を超えるコードを生成し、約4,019のストロークを描画しました。さらに、ピクセル輝度統計と ASCII 輪郭スキャンで自己検査を行い、ツバメが窓の開口部の黒い塊と重なっていることを発見した後、自ら座標を調整しています。著者は、コード構成と自己検査能力は比較的強いものの、審美面の表現にはなお改善の余地があると評価しています。
2 Qwen4-Max-Preview の12項目の実タスクがカバーする範囲
2.1 より包括的なテストレポート
11月16日、「人人都是产品经理」はZ Financeのテストレポートを掲載しました。執筆者は12項目のタスクを完了し、重要な結果について抜き取り検査と再検証を行ったと述べています。以下の表は、レポートがカバーしたタスクを整理したものです。
| カテゴリ | テストタスク | 主に評価する能力 |
|---|---|---|
| 視覚生成 | ペリカンが自転車に乗るSVG | 視覚理解、コード生成 |
| 財務分析 | 3つの財務報告書の統合分析 | 長文書理解、会計基準の扱い |
| グラフ認識 | Apple製品売上の棒グラフ | グラフ読み取り、数値推定 |
| オフィス協業 | 議事録の3回の修正 | コンテキスト保持、修正の一貫性 |
| データ処理 | 44行の売上データクリーニング | 重複除去、単位変換、数式 |
| プレゼンテーション | 平頭哥(Pinghead)上場PPT | リアルタイム検索、ファイル生成 |
| 長文検索 | 1,600件のカスタマーサポートチケット | レコード間の関連付け、条件フィルタリング |
| コード保守 | Pythonチケットサービスの修復 | 不具合の特定、テストとリグレッション |
| 科学研究再現 | 非負行列因子分解アルゴリズム | アルゴリズム実装、数値検証 |
| Web開発 | 目論見書資料の表示ページ | HTML、オフライン配信、インタラクション |
| シミュレーションシステム | レインガーデンのシミュレーション | インタラクション設計、数値計算 |
| ゲーム開発 | 四季をテーマにした3Dミニゲーム | 3Dシーン、状態管理、インタラクション |
2.2 注目すべき5つのケース
この12項目のタスクのうち、以下の5つはモデルが「使える成果物」を納品する能力を最もよく示しています。
- 財務報告書分析:Apple、CostcoのFY2026年次報告書とAnthropicの第2版目論見書を入力し、約8分で完了しました。抜き取り検査した6つの重要な数値はすべて正確で、モデルは営業損失と純損失を区別し、転換社債の公正価値変動が純損失に与える影響を指摘し、開示されていない将来のガイダンスについて自行で捏造することはありませんでした。
- Excelクリーニング:44行の売上明細には、重複レコード、スペースの違いだけの重複データ、元と万元の2種類の単位、3種類の日付形式、5件の欠損注文が混入していました。クリーニング後は35行が残り、4つの地域の合計は215,700元となり、5つの集計セルはすべて実際の数式を使用しており、明細を修正すると集計値が自動的に更新されます。
- PPT生成:モデルはリアルタイム検索を通じてスピンオフ公告の情報を識別し、編集可能なPPTを生成し、バリュエーション予測と発行価格設定を区別しました。2回目の調整で対象読者を変更した後も、既存の20の重要な数値、日付、名称はすべて変わらず保持されました。執筆者は製品ラインの漏れが存在することも指摘しています。
- チケット検索とPython修復:この2項目は最も具体的な証拠であり、それぞれ第4節と第3節で展開します。
これらのタスクに共通する点は、成果物を検査できることです。数式が連動するかどうか、数値と原文が一致するかどうか、テストが通るかどうか。こうした証拠は、「正しそうなコードを生成した」ということよりも説得力があります。
3 57件のテストをパス——Qwen4-Max-Previewの最も説得力あるエンジニアリング証拠
3.1 修正プロセスの完全な再現
テスト対象は Python 標準ライブラリで書かれた工単(チケット)照会サービスで、欠陥は複合フィルタリング、ソート、ページネーション、パラメータ検証に及びます。タスクでは、インターフェース・元のデータ・既存テストを保持したまま欠陥を修正することが求められました。レポートには、このタスクの所要時間が 8分07秒 と記録されており、プロセスは次のとおりです。
| ステップ | モデルの動作 | エンジニアリング上の意味 |
|---|---|---|
| 欠陥の再現 | まず既存の9件のテストを実行し、うち2件の失敗を再現 | 問題の存在を先に確認してから手を入れる |
| 修正箇所の特定 | 変更は主に query.py に集中 | 変更範囲が収束し、副作用を抑制 |
| テストの追加 | 48件のテストを新規追加 | 既存テストがカバーしていなかった境界ケースをカバー |
| 自己修正 | 自作テスト中の3箇所の問題を修正 | テスト自体の誤りを発見し、その場で訂正 |
| 回帰検証 | 最終的に57件のテストがすべてパス | 既存9件+新規48件 |
| 整合性チェック | 元のデータと既存テストにハッシュ検証を実施、ハッシュに変化なし | データやテストを改ざんして「パス」させていないことを証明 |
| 実リクエスト | ローカルサービスを起動して13件のHTTPリクエストを送信し、7件が200、4件が400、2件が404 | 実行時の正常応答とエラー処理を検証 |
| 納品物の再検証 | 最終納品パッケージを解凍して再実行し、テストがパス | 納品物自体が独立して動作することを確認 |
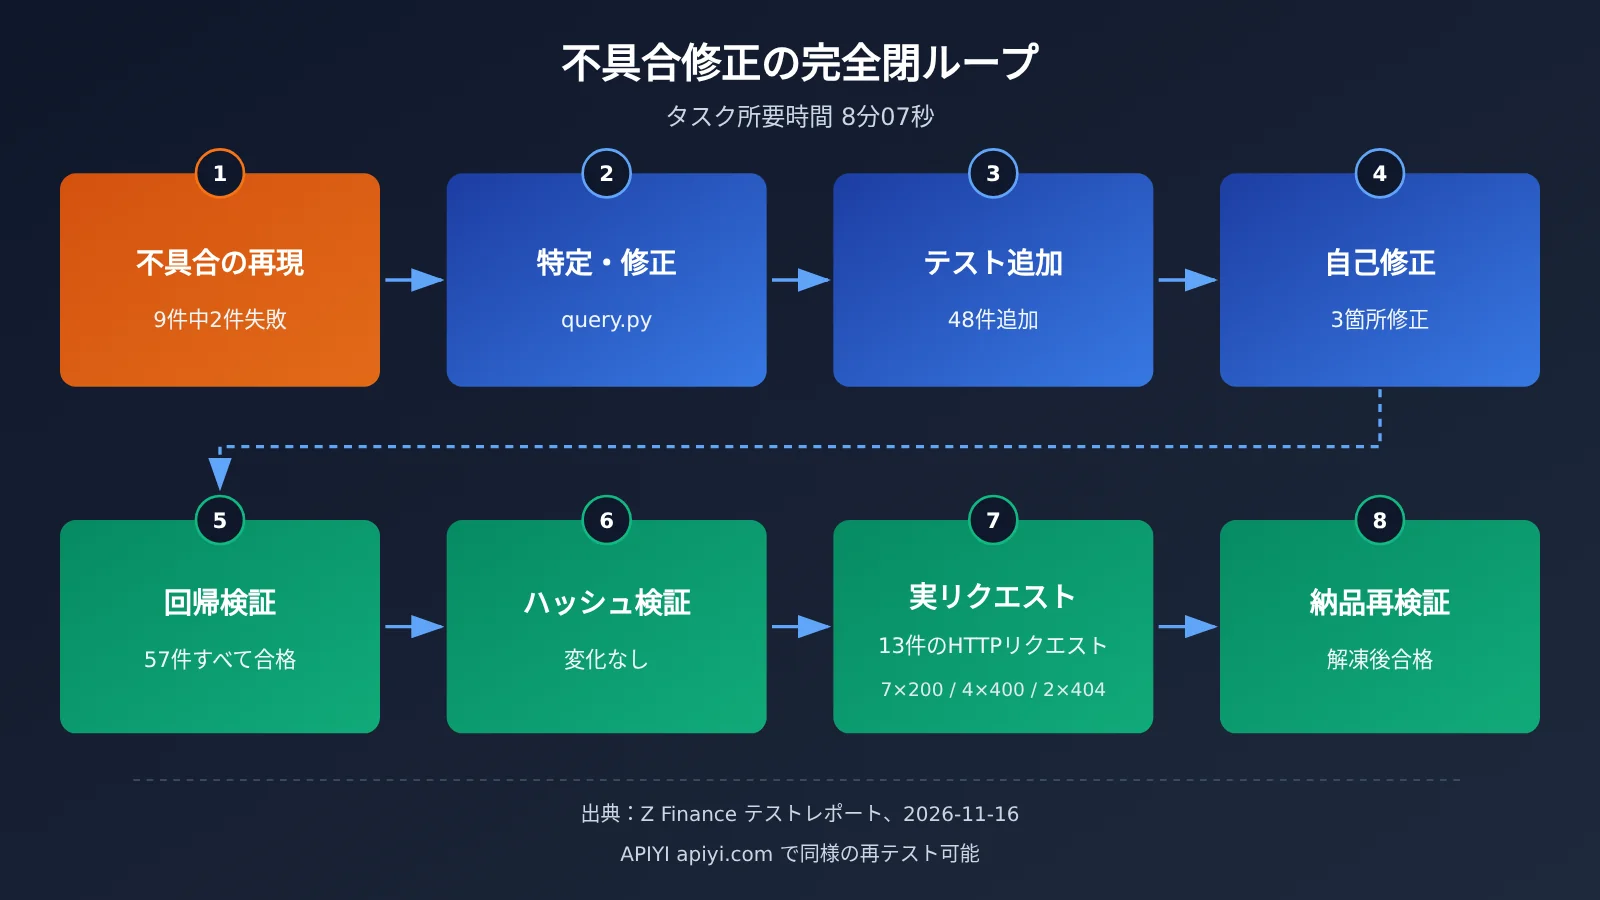
3.2 なぜこれがコード生成よりも雄弁に語るのか
AI プログラミングでよくある失敗の仕方は二つあります。一つはテストやデータを改変してテストを「グリーン」にすること、もう一つはテストでは通るのに実際の実行時にエラーになることです。今回のタスクでは、ハッシュ検証が一つ目のリスクに対応し、実際のHTTPリクエストと納品パッケージの再検証が二つ目のリスクに対応しています。4件の400と2件の404という応答は、モデルがエラーパスも検証したことを示しており、パラメータ検証や存在しないリソースの扱いも実際に確認されています。
この流れは、熟練したエンジニアがバグを修正する習慣と一致します。再現、修正、補完テスト、回帰、納品という流れです。これは、Qwen4-Max-Preview がルールの明確で規模の制御できるサービスにおいて、完全なメンテナンスの閉ループを備えていることを示しています。ただし、これもあくまで1回のタスクの記録であり、汎用的なコード修正の成功率に換算することはできません。
400万コンテキストの実際の価値:1,600件のチケットから741行離れた手がかりを発見
4.1 テスト設計と結果
公式に発表された Qwen4-Max-Preview のコンテキストウィンドウは 1,000,000 Tokens です。ウィンドウサイズは容量の上限にすぎず、実用上の価値を決めるのは、モデルが大量の資料の中で正しい関連付けを行えるかどうかです。Z Finance のレポートにあるチケットテストは、この問いに答えています。
テストデータはカスタマーサポートのチケット1,600件で、データサイズは約50万バイト、重要な手がかりは741行離れた2件のレコードに分散しており、全部で5つの質問が用意されました。レポートでは5問すべてに正答したと記録されており、具体的な内容は次のとおりです:
- 分散した2件のチケットを関連付け、1,386元の返金額と担当者を特定した。
- 承認日をもとに、補償クーポンの新政策がこのケースに適用されるかどうかを判断した。
- 指定条件に合致するチケットを62件数え上げ、スクリプトによる集計結果と一致した。
- 2組の重複注文番号を見つけ、どちらが正常な処理フローに属するか、どちらが顧客情報の衝突に属するかを区別した。
4.2 バイトと Token は異なる単位
約50万バイトはファイルサイズであり、Token 数はトークン化の方式や中国語と英語の比率によって変わるため、両者は分けて計算する必要があります。このテストが証明しているのは「中規模資料におけるレコード間の関連付けと条件による絞り込み」であり、その規模は100万 Token のウィンドウ上限をはるかに下回るため、限界容量のストレステストとして扱うことはできません。
3番目の結果の価値は検証可能である点にあります。62件という数がスクリプトの集計と一致しており、モデルの計数結果を決定論的なプログラムで再確認できることを示しています。実際に利用する際も同じ方法を取るのが望ましく、モデルが出した統計結果をスクリプトで照合したうえで、関連付けや解釈などスクリプトでは難しい部分にモデルを使うとよいでしょう。
5 見過ごせない弱点:Qwen4-Max-Preview の科学研究推論における過剰な結論
5.1 計算は正しいが、解釈が証拠を超えている
科学研究の再現タスクでは、指定された論文に基づいて非負値行列因子分解の乗法更新アルゴリズムを実装することが求められました。入力行列は 48×36 で、3 組の異なる初期値を使い、それぞれ 500 回反復します。報告によると、モデルの所要時間は 10 分 06 秒で、コード、数値結果、グラフ、ログを提出しました。3 組の結果はそれぞれ 52 個のチェックポイントを提供し、A 組の重要なチェックポイントは公開された参考結果と一致しています。さらに 63 項目の自己チェック記録もありました。
問題は結論の部分にあります。モデルは目的関数が持続的に減少しているだけを根拠に、その結果を「局所最適解への収束」と解釈しました。著者はこれを過剰推論だと指摘しています。
5.2 区別して判断すべき 3 つの概念
この事例には 3 つのレベルの判断が関わっており、後者ほど前者よりも強い証拠を必要とします。
- 目的関数の減少:乗法更新則の設計上の特性であり、ログとグラフから直接観察できます。
- 数値反復の収束:反復量の変化が安定に向かっているかを確認し、明確な停止基準を設定する必要があります。
- 局所最適解への収束:KKT 条件などの最適性条件を検証する必要があり、関数値の減少だけを見て導くことはできません。
これは、モデルの実行能力と論証の厳密性を別々に評価すべきだということを示しています。数値計算はチェックポイントによって検証できますが、科学的な結論には関連する背景を持つ人によるレビューが必要です。研究、論文再現、技術報告といった場面では、モデルが出力する「結論の段落」はドラフトとして扱うべきでしょう。
6 Qwen4-Max-Preview と他のプログラミングツールによる同一タスクの比較
6.1 UFOキャッチャーチャレンジの比較データ
11 月 12 日のレポートでは、同じUFOキャッチャーチャレンジを各ツールで実行した記録も示されています。元の表の Qwen の行は Qwen4-Max と表記され、テスト日は 11 月 12 日で、正式版のリリース日である 11 月 16 日より前でした。つまりプレビュー段階のモデルに相当します。
| ツール/モデル | 所要時間 | Token 総処理量(推定) | 出力 Token | 再検証の入口 |
|---|---|---|---|---|
| Codex | 8 分 | 350 万 | 2.8 万 | それぞれ公式ツール |
| Claude Code | 17 分 | 1,215 万 | 13 万 | 公式ツール。Claude モデルは APIYI apiyi.com 経由で呼び出し可能 |
| Gemini | 21 分 | 1,394 万 | 8.1 万 | 公式ツール。Gemini モデルは APIYI 経由で呼び出し可能 |
| Kimi Code | 36 分 | 950 万 | 5.9 万 | それぞれ公式ツール |
| DSH | 46 分 | 4,644 万 | 28.1 万 | それぞれ公式ツール |
| MiniMax Code | 68 分 | 4,000 万 | 19.8 万 | それぞれ公式ツール |
| Qwen4-Max(プレビュー段階) | 75 分 | 269 万 | 5.5 万 | Token Plan(Qoder) |
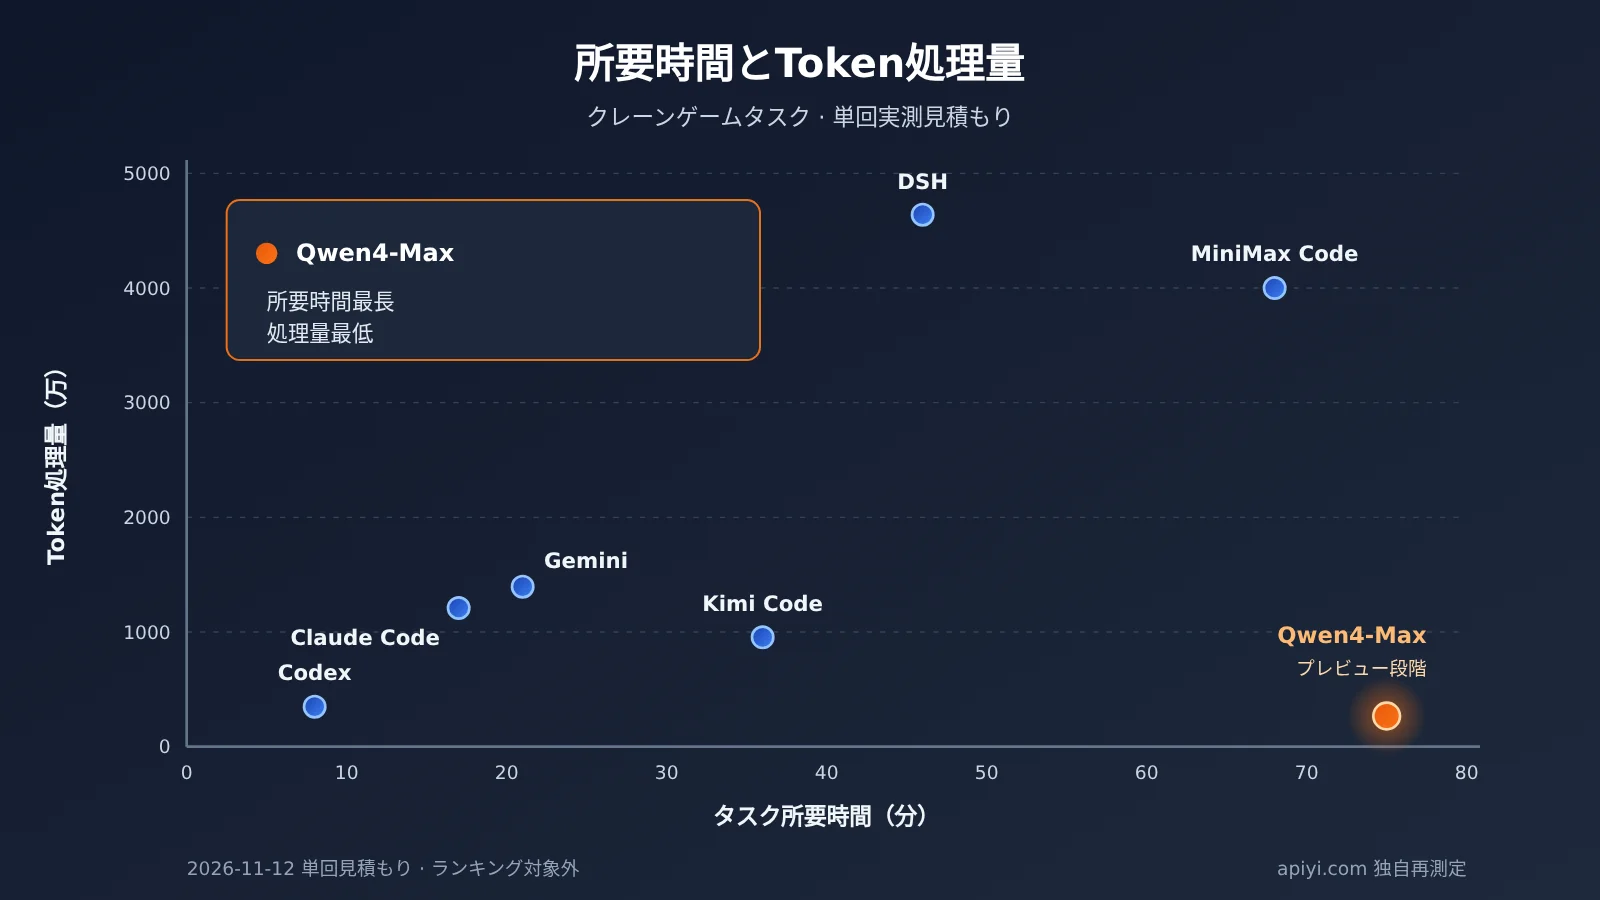
6.2 このデータをどう読むか
データにははっきりとした対照が表れています。Qwen4-Max-Preview はこのタスクで Token 総処理量が最も少なく約 269 万でしたが、所要時間は最も長く約 75 分でした。観測された約 33 Tokens/s の速度と合わせて考えると、このタスクのボトルネックは生成速度にあり、消費した Token の規模そのものは大きくありません。
このデータはランキングには向きません。理由は 3 つあります。Token 総量は筆者による推定値であること。各ツールでコンテキストキャッシュの比率、呼び出し戦略、実行方式が異なること。そして表中の各モデルの具体的なバージョンも統一して説明されていないことです。Token 処理量が少ないのは、読み込みの繰り返しが少なかったためかもしれませんし、ツール側のキャッシュ戦略の違いによるものかもしれません。現状の材料では両者を区別できません。このデータから言えるのはあくまで、このツール環境において Qwen4-Max-Preview は待ち時間をあまり気にせず、納品の完全性を重視するタスクに向いている、という点です。
7 Qwen4-Max-Preview を試す価値のある開発者とは
7.1 適した場面と慎重に使うべき場面
2 つのレポートを総合すると、Qwen4-Max-Preview は次のタスクで比較的安定した性能を発揮します。
- ルールが明確なコード保守:既存のテストがあり、問題の境界がはっきりしている修正や追加テストのタスク。
- 長文書の検索と関連付け:チケット、ログ、契約書、決算資料などにおけるレコード横断的な検索。統計結果はスクリプトで再確認します。
- オフィス業務の自動化:データクレンジング、数式入りの Excel、編集可能な PPT、複数回の修正。
- インタラクティブプロトタイプの開発:単一ファイルの Web ページ、シミュレーションシステム、ミニゲームのプロトタイプ。たとえばレポートにある約 46KB、外部依存のないオフライン展示ページなどです。
慎重に使うべきは次の 3 種類のタスクです。応答時間に敏感なインタラクティブ開発(1 回のタスクが 1 時間以上かかる場合があります)、厳密な数学的・科学的論証を要する結論の出力、そして高い信頼性が求められる本番環境の変更です。レポートの著者も「範囲の広いタスクでは一部の情報が漏れることがある」「最終成果物には依然として人手による検証が必要」とまとめています。
使用前には公式の制限にも注意が必要です。Preview は阿里雲 Token Plan を通じて Claude Code、Cursor、Qoder などのツール上でインタラクティブにのみ利用でき、従量課金には対応していません。プレビュー期間は 2026 年 11 月 25 日 24:00(北京時間)に終了し、その後は提供停止となります。正式版の Qwen4-Max は 11 月 16 日にリリース済みで、公式は正式版への移行を推奨しています。両者はパラメータが異なります。正式版の思考モードの最大出力は 262,144 Tokens、Preview は 393,216 Tokens であるため、移行時には出力の予算を再設定する必要があります。
7.2 自分のタスクで同種の再テストを行う
二次情報のレポートは、せいぜい「このモデルならできる」ということしか示しません。自分のチームに適しているかを判断する最も直接的な方法は、実際のコードとテストを使って一度比較してみることです。以下の例では、OpenAI 互換インターフェース経由でコード修正タスクを送信し、所要時間とトークン使用量を記録します。モデル名は、プラットフォームのモデル一覧にある実際の名称に合わせてください。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統合インターフェース、OpenAI 互換
)

resp = client.chat.completions.create(
    model="qwen4-max",  # APIYI のモデル一覧にある実際の名称に合わせてください
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
複数モデルの比較再テストスクリプトを見る
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1 つのキーで複数のモデルを呼び出す
)

# プラットフォームのモデル一覧にある実際の名称に置き換える
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # 推論モデルでは思考トークンも出力予算を消費するため、余裕を確保する
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # パッチを隔離ディレクトリに適用し、テストを実行して元データのハッシュを検証してから採点する
スクリプトは提案内容と使用量を収集するだけです。評価の段階では、レポートのやり方をそのまま踏襲します。隔離したディレクトリでパッチを適用し、既存のテストと追加したテストを実行し、ハッシュ値でデータと既存テストが変更されていないことを確認します。こうして導いた結論だけが、あなたのコードベースに対して有効です。
🚀 クイックスタート:同じタスク群で複数のモデルを比較したい場合は、APIYI(apiyi.com)から無料のテスト枠を取得できます。プラットフォームは OpenAI 互換インターフェースを提供しており、1 つの API キーで OpenAI、Claude、Gemini などの主要モデルを切り替えられるため、再テスト用スクリプトを同じ評価フローで実行できます。
8 Qwen4-Max-Preview 評価のよくある質問
Q1:75分でクレーンゲームを完成させたのは、遅いということですか?
この Qoder タスクでは、所要時間は比較表の中で最も長く、観測された出力速度は約33トークン/秒でした。これは単一環境での記録にすぎず、ツールのスケジューリングやネットワーク条件によって結果は変わります。待ち時間が重要なシナリオでは、ご自身のタスクで実際に測定することをおすすめします。
Q2:57項目のテスト通過は、コード修正の成功率を表しますか?
これは一度の完全かつ検証可能な修正プロセスを示すものであり、成功率に換算することはできません。ご自身のプロジェクトでの性能を評価したい場合は、APIYI apiyi.com を通じて同じ欠陥サンプル群で複数のモデルを比較し、テスト通過状況とハッシュ検証結果に基づいて採点できます。
Q3:チケットテストは100万トークンのコンテキストを検証しましたか?
いいえ。このテストは約50万バイトで、トークン数はトークン化の方式によって異なり、規模はウィンドウ上限よりはるかに小さいです。検証したのは、レコード間の関連付けと条件フィルタリングの能力です。
Q4:Preview 終了後はどうすればよいですか?
公式に正式版 Qwen4-Max が公開され、正式版の使用が推奨されています。正式版は従量課金 API に対応し、思考モードの最大出力は262,144トークンです。移行時には出力予算を調整する必要があります。サードパーティプラットフォームの提供状況や価格は変わりやすいため、APIYI apiyi.com のモデル一覧で現在利用可能なモデル名を確認してから接続してください。
Q5:Token Plan の Key を自分のアプリケーションバックエンドに入れられますか?
いいえ。公式ルールでは、Token Plan は許可されたプログラミングツールおよびエージェントツール内での対話型利用に限定されており、自動化スクリプトによるバッチ呼び出しや自社アプリのバックエンドは許可範囲外です。違反した場合、サブスクリプションの停止や Key のブロックにつながる可能性があります。自社アプリでは、使用範囲に適合する API 製品を選択してください。
9 Qwen4-Max-Preview 評価の要点
- 納品のクローズドループ:コード修正タスクは再現、修正、追加テスト、ハッシュ検証、実リクエスト、納品後の再検証をカバーし、57 項目のテストに合格しました。
- 長文の関連付け:1,600 件のチケットから 741 行にまたがる関連する手がかりを抽出し、5 問すべて正解、62 件の統計がスクリプトと一致しました。
- オフィス文書の納品:Excel の数式が連動し、PPT を複数回修正した後も 20 件の重要事実が変わりませんでした。
- 速度面の弱点:クレーンゲームのタスクは約 75 分で、Token 処理量が少なく、時間がかかります。
- 推論の限界:科学研究の再現では計算が参考結果と一致しましたが、結論には過度な推測があり、人による審査が必要です。
- 証拠の性質:以上はすべて単一の執筆者によるタスク実測であり、標準化されたランキングではありません。
- 始め方:自分のコードとテストで対照的に再テストし、APIYI apiyi.com を利用すれば 1 つのインターフェース内で複数のモデルを切り替えられます。
10 まとめ:開発者は Qwen4-Max-Preview をどこで使うべきか
公開レポートが示すプロファイルはかなり明確です。Qwen4-Max-Preview は、明確なルールと検証可能な結果がある作業を得意とします。テスト付きのコード保守、長い資料の中でのレコード横断検索、数式を伴うデータ処理と編集可能なオフィスファイル、そしてインタラクティブなプロトタイプ開発です。これらのタスクでは、自分でテストを補い、自分で誤りを見つけ、再検証可能な成果物を納品できます。
その制限も同様に具体的です。複雑なタスクは時間がかかるため、バックグラウンドでの実行に適しています。科学的な結論は証拠の範囲を超えやすく、専門家による審査が必要です。Preview は Token Plan を通じて指定されたツール内でのみ対話的に使用でき、11 月 25 日に提供終了となるため、長期的な使用は正式版へ移行すべきです。
最も現実的な方法は、これをメンテナンスのクローズドループを独立して完了できるエンジニアリングアシスタントとして扱い、結論の確認と最終的なマージは開発者が担当することです。リリース前に、自分の実際のタスクで複数モデルの比較を一度行うことをお勧めします。APIYI apiyi.com の統一インターフェースを使えば、同じフロー内でテストと比較を完了できます。
📚 参考資料
-
人人都是产品经理:Qwen4-Max プレビュー版が登場!実際に試して感想を語る:Qoder クレーンゲームの実測とツール横断比較、2026-11-12
- リンク:
woshipm.com/ai/6492544.html - 説明: 所要時間75分、33 Tokens/s、65 Credits、および比較表の出典
- リンク:
-
人人都是产品经理:Qwen4-Max-Preview を実測(Z Finance テストレポート):12項目のタスクによる総合テスト、2026-11-16
- リンク:
woshipm.com/evaluating/6494229.html - 説明: コード修正、チケット検索、研究再現、オフィス業務タスクのデータ出典
- リンク:
-
Alibaba Cloud Model Studio:Qwen4-Max-Preview ドキュメント:公式仕様と利用ガイド
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max-preview - 説明: コンテキストウィンドウ、最大出力、プレビュー期間、接続方法
- リンク:
-
Alibaba Cloud Model Studio:Qwen4-Max ドキュメント:正式版のパラメータと課金
- リンク:
help.aliyun.com/zh/model-studio/qwen4-max - 説明: 正式版の出力予算と従量課金情報
- リンク:
-
Alibaba Cloud:Token Plan の権限と利用規範:利用範囲の制限
- リンク:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - 説明: 対話型利用の要件と禁止シナリオ
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のサイトトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターをご覧ください。