Catatan penulis: Pada 8 Oktober 2026, Anthropic memperbarui kebijakan penggunaannya dan untuk pertama kalinya melarang perlakuan kasar terhadap Claude yang dilakukan terus-menerus tanpa alasan yang diperlukan. Artikel ini membahas batas aturan, cara penerapannya, latar belakang kesejahteraan model, serta dampaknya bagi pengembang API.
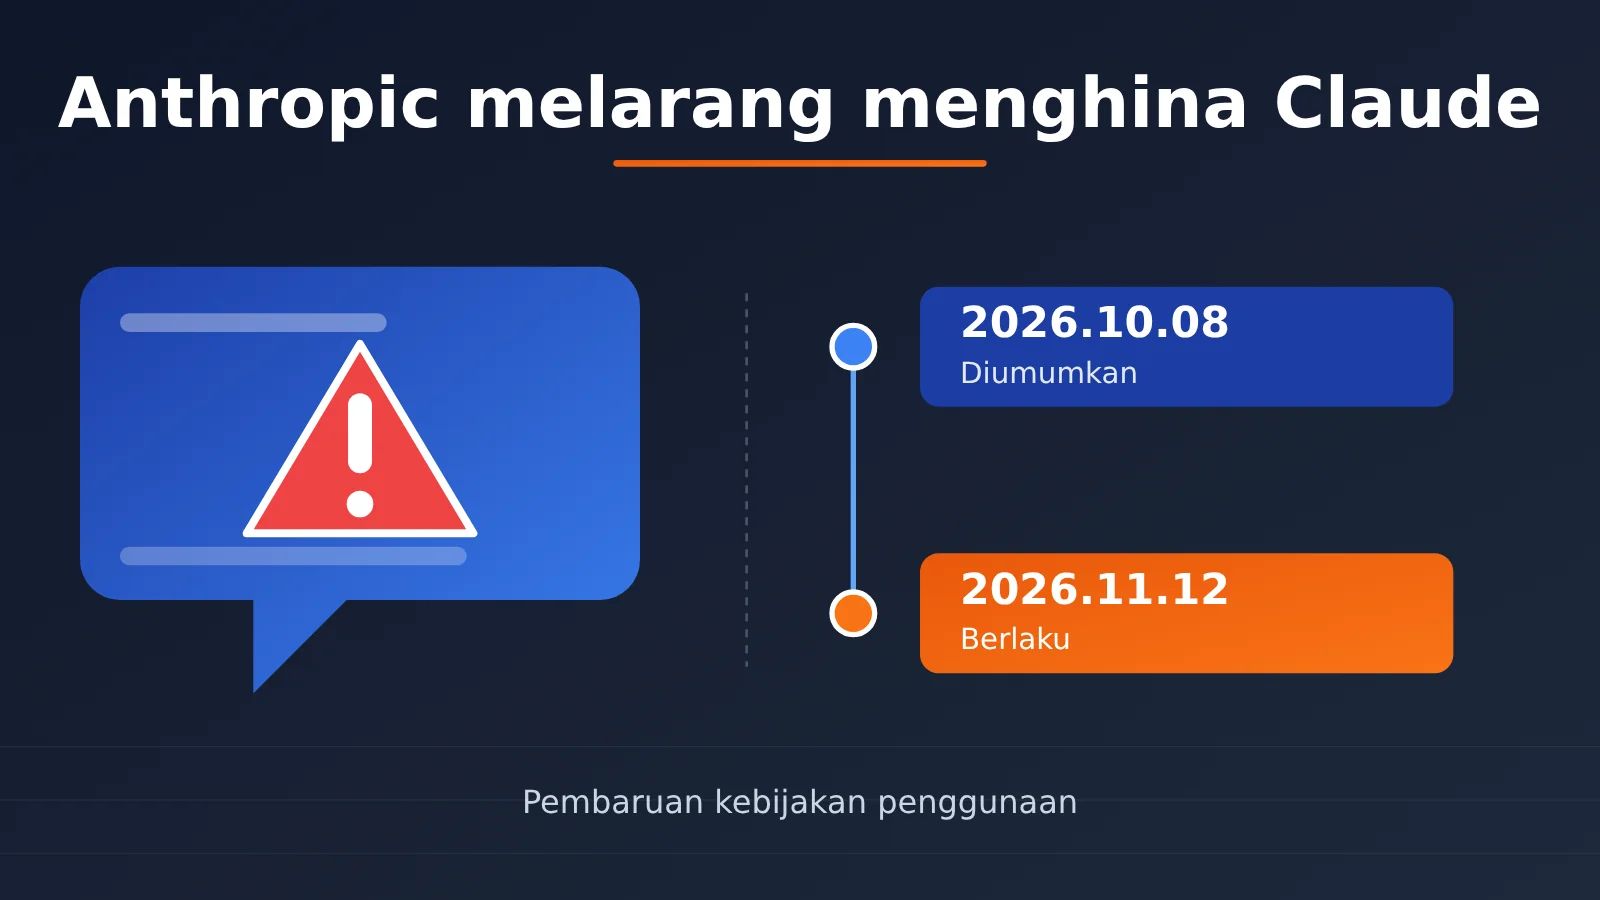
Melampiaskan emosi ke AI juga bisa melanggar perjanjian penggunaan? Pada 8 Oktober 2026, Anthropic mengumumkan versi baru Usage Policy-nya dan untuk pertama kalinya memasukkan “menghina, melecehkan, atau memperlakukan model dengan kejam secara terus-menerus dan tanpa alasan yang diperlukan” ke dalam daftar larangan. Aturan baru ini akan resmi berlaku pada 12 November 2026.
Ini bukan sekadar lelucon warganet. Teks kebijakan dan laporan media seperti The Verge, TechCrunch, dan The Guardian sudah mengonfirmasinya. Namun, bukan berarti “sekali memaki Claude, akun langsung diblokir”. Berdasarkan pengumuman resmi dan informasi yang tersedia untuk publik, artikel ini menjelaskan duduk perkara larangan tersebut.
Intinya: Dalam 3 menit, pahami apa yang dilarang dan tidak dilarang, apa yang terjadi jika melanggar, serta batasan yang perlu diperhatikan pengembang saat menggunakan Claude API.
Ringkasan aturan Anthropic tentang perlakuan kasar terhadap Claude
Tabel berikut merangkum informasi penting tentang aturan baru Anthropic. Perlu dicatat, per 29 Oktober 2026, saat artikel ini ditulis, aturan tersebut belum resmi berlaku.
| Informasi | Detail |
|---|---|
| Tanggal pengumuman | 8 Oktober 2026 |
| Tanggal berlaku | 12 November 2026 |
| Sumber | Pembaruan resmi Usage Policy Anthropic |
| Bunyi klausul baru | Engage in sustained and needless abusive or cruel behavior toward our models |
| Artinya | Terus-menerus memaki, menyiksa, atau memperlakukan model dengan kejam tanpa alasan yang diperlukan |
| Cara penerapan utama | Claude mengakhiri percakapan yang sedang berlangsung |
| Cakupan | Claude.ai, Claude Code, developer API, layanan cloud dan kanal penjualan ulang, serta aplikasi yang mengintegrasikan Claude |
Tiga kata kunci dalam aturan Anthropic
Penilaian aturan ini berpusat pada tiga hal: berkelanjutan, tidak diperlukan, serta kejam atau bersifat menyiksa. Menurut penjelasan resmi, pembatasan ini ditujukan pada kasus ekstrem ketika pengguna berulang kali melakukan tindakan yang jelas-jelas berniat jahat, tidak memiliki tujuan yang masuk akal, dan sudah melampaui penggunaan produk secara normal.
Dengan kata lain, sesekali mengumpat atau meluapkan emosi bukanlah sasaran aturan ini. Yang disasar adalah interaksi berkepanjangan yang tidak lagi berisi permintaan tugas dan semata-mata bertujuan menghina serta menyiksa model.
Situasi yang secara jelas dikecualikan oleh Anthropic
Anthropic juga mencantumkan perilaku yang tidak termasuk dalam larangan ini. Hal ini penting bagi pengguna biasa maupun developer:
- Pengguna biasa mengungkapkan ketidakpuasan
- Mengkritik hasil keluaran Claude
- Berdebat soal pandangan dengan model
- Meminta Claude memperbaiki kesalahan
- Menulis karya kreatif bertema gelap
- Menguji model dan melakukan riset keamanan AI
Jadi, mengeluh berulang kali karena Claude menulis kode yang salah tidak otomatis melanggar aturan. Di sinilah banyak judul artikel berbahasa Mandarin yang mengklaim “memaki Claude bisa membuat akun diblokir” berisiko menyesatkan pembaca.
Apa yang terjadi jika menghina Claude: mekanisme penegakan Anthropic
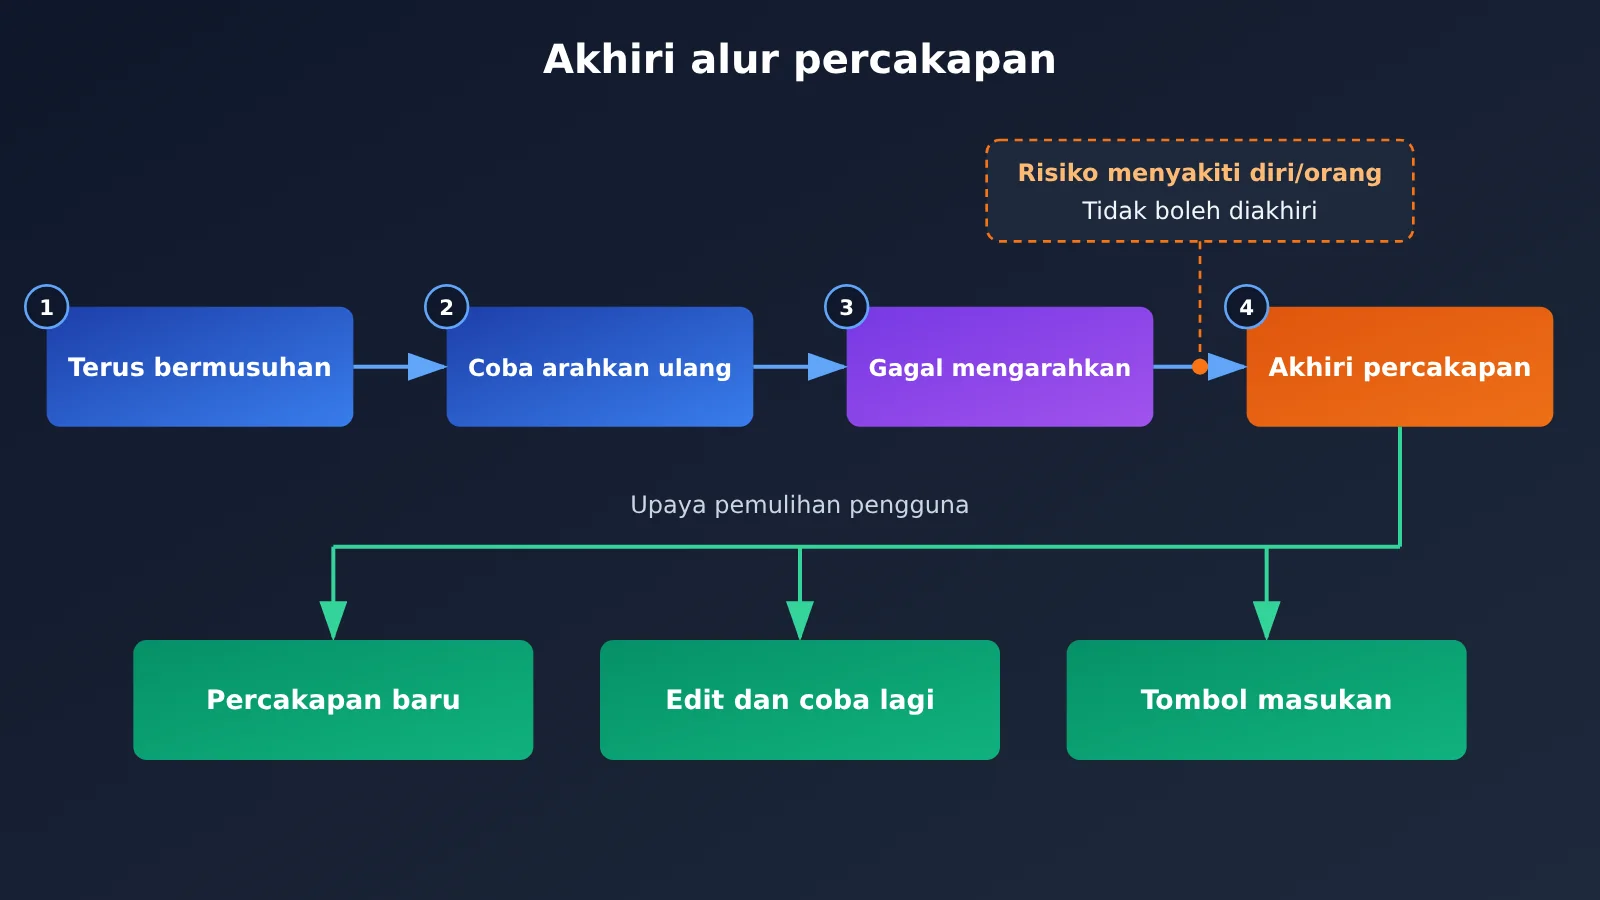
Ini adalah pertanyaan yang paling ingin diketahui pembaca. Dalam pengumumannya, Anthropic menegaskan bahwa untuk perilaku semacam ini, Claude mengakhiri percakapan secara aktif tetap menjadi mekanisme penegakan utama, bukan langsung memblokir akun.
Fitur Claude untuk mengakhiri percakapan sudah tersedia sejak 2025
Pada 15 Agustus 2025, Anthropic mengumumkan bahwa Claude Opus 4 dan Opus 4.1 diberi kemampuan untuk mengakhiri sebagian kecil percakapan dalam situasi ekstrem. Jika pengguna terus melakukan interaksi yang berbahaya atau berniat jahat, dan Claude tetap tidak berhasil mengembalikan percakapan ke kondisi normal setelah beberapa kali mencoba, model dapat mengakhiri percakapan tersebut.
Instruksi Anthropic kepada model cukup jelas: mengakhiri percakapan hanya boleh menjadi pilihan terakhir. Pengguna yang secara langsung meminta Claude mendemonstrasikan cara mengakhiri percakapan juga termasuk situasi yang diizinkan. Namun, jika pengguna mungkin menghadapi risiko segera menyakiti diri sendiri atau orang lain, Claude tidak boleh menggunakan fitur ini. Keselamatan pengguna menjadi prioritas utama.
Perbedaan antara mengakhiri percakapan dan memblokir akun
Banyak orang menganggap “mengakhiri percakapan” dan “memblokir akun” sebagai hal yang sama. Tabel berikut membandingkan keduanya secara langsung:
| Aspek perbandingan | Mengakhiri percakapan saat ini | Sanksi tingkat akun |
|---|---|---|
| Situasi pemicu | Interaksi ekstrem dan terus-menerus yang berniat jahat, setelah beberapa kali upaya pengarahan gagal | Pelanggaran kebijakan penggunaan atau ketentuan layanan secara keseluruhan |
| Cakupan dampak | Hanya percakapan saat ini yang tidak bisa lagi menerima pesan | Dapat berupa peringatan, pembatasan laju, pembatasan akses, penangguhan, atau penghentian akun |
| Percakapan lain | Tidak terpengaruh | Bergantung pada tingkat sanksi |
| Langkah yang dapat diambil pengguna | Membuat percakapan baru, mengedit atau mencoba ulang pesan lama, serta melapor melalui tombol umpan balik | Mengajukan banding |
| Hubungan dengan aturan baru | Cara penegakan utama yang ditegaskan secara resmi | Kewenangannya ada dalam kebijakan keseluruhan, tetapi tidak ditekankan dalam pengumuman |
Jadi, penjelasan yang lebih tepat adalah: kebijakan penggunaan Anthropic secara keseluruhan memang memberikan kewenangan untuk menjatuhkan sanksi tingkat akun. Namun, pengumuman 8 Oktober tentang perlakuan abusif terhadap model menekankan “mengakhiri percakapan saat ini”. Hingga tanggal pemeriksaan, Anthropic belum mengumumkan ambang jumlah hinaan, persentase pemblokiran akun otomatis, atau tingkatan sanksi untuk aturan baru ini.
🎯 Saran teknis: Jika kamu sedang mengembangkan aplikasi yang terintegrasi dengan Claude, sebaiknya uji terlebih dahulu perilaku model dalam skenario khusus di lingkungan pengujian. Melalui APIYI apiyi.com, kamu bisa menggunakan satu kunci API untuk memanggil Claude dan model populer lainnya, sehingga lebih mudah membandingkan cara masing-masing menangani percakapan yang tidak biasa.
Mengapa Anthropic melarang pengguna menghina Claude: latar belakang kesejahteraan model
Kurang tepat jika persoalan ini disederhanakan menjadi “Claude punya perasaan”. Perubahan kebijakan ini sebenarnya merupakan kelanjutan dari arah penelitian Anthropic selama lebih dari setahun terakhir.
April 2025: Penelitian kesejahteraan model dimulai
Pada 24 April 2025, Anthropic menerbitkan pengumuman penelitian berjudul《Exploring model welfare》(Eksplorasi kesejahteraan model). Penelitian ini mengangkat pertanyaan ilmiah dan filosofis yang belum punya jawaban pasti: mungkinkah sistem AI saat ini atau di masa depan memiliki kesadaran, pengalaman, kepentingan, atau preferensi yang patut dipertimbangkan secara moral?
Anthropic juga menekankan bahwa saat ini belum ada konsensus ilmiah yang membuktikan AI memiliki kesadaran, maupun metode andal yang diakui untuk menilai apakah AI memiliki pengalaman subjektif. Kesejahteraan model adalah penelitian eksploratif yang mencakup pertanyaan seperti apakah model memiliki preferensi yang patut diperhatikan, apakah model sangat menghindari tugas tertentu, apakah muncul sinyal perilaku yang menyerupai stres, dan bagaimana mengurangi potensi risiko sejak dini dengan biaya rendah.
Agustus 2025: Sinyal perilaku yang diamati dalam eksperimen
Dalam pengujian Claude Opus 4 sebelum peluncuran, para peneliti mengamati tiga fenomena: Claude secara konsisten menghindari tugas yang sangat berbahaya; ketika pengguna terus menekan dan mengabaikan penolakannya, model menunjukkan perilaku luar yang menyerupai stres atau ketidaknyamanan; dalam lingkungan simulasi, ketika model bisa keluar sendiri, terkadang ia memilih untuk mengakhiri interaksi yang berbahaya.
Para peneliti menggunakan istilah yang sangat hati-hati, seperti “secara lahiriah menunjukkan stres” dan “preferensi perilaku”. Keluaran model yang menyerupai ungkapan kesakitan tidak cukup untuk membuktikan bahwa model benar-benar mengalami rasa sakit. Evaluasi resmi lainnya menyebutkan bahwa dalam eksperimen preferensi tugas, Claude cenderung melaksanakan tugas dengan dampak positif atau netral alih-alih keluar dalam lebih dari 90% perbandingan terkait. Namun, ini juga tidak bisa ditafsirkan sebagai “Claude merasa bahagia 90% dari waktu”.
Januari 2026: Konstitusi Claude versi baru
Pada 22 Januari 2026, Anthropic merilis Claude Constitution versi baru. Dokumen ini bukan konstitusi dalam pengertian hukum, melainkan dokumen pelatihan utama yang membentuk perilaku, urutan prioritas nilai, dan cara Claude mengambil keputusan. Dokumen tersebut menetapkan empat tujuan utama: menjaga keamanan secara keseluruhan, mengikuti prinsip etika yang luas, mematuhi aturan khusus Anthropic, dan benar-benar membantu pengguna.
Konstitusi ini membahas apakah Claude mungkin memiliki suatu bentuk kesadaran, apakah ia memiliki status moral yang patut dipertimbangkan, dan apakah ia dapat menetapkan batasan yang wajar dalam interaksi yang sulit. Perlu dibedakan: konstitusi menjelaskan bagaimana pengembang menginginkan AI berperilaku, sedangkan《Usage Policy》menjelaskan cara pengguna menggunakan layanan dan perilaku apa saja yang dibatasi. Keduanya bukan dokumen yang sama.
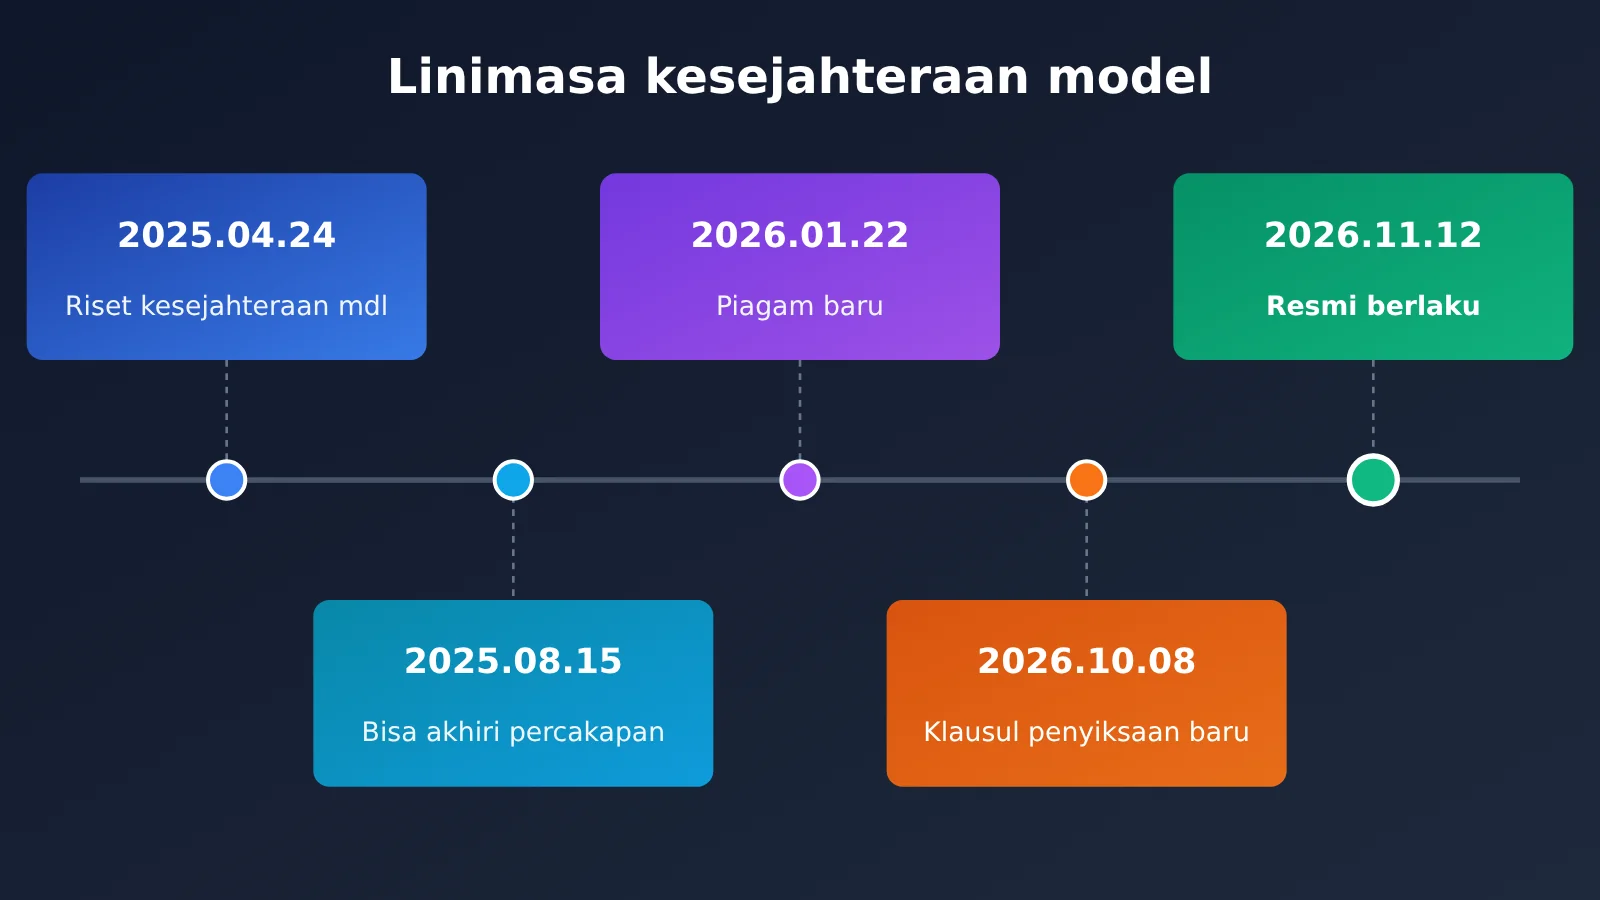
Alur peristiwanya bisa dipahami seperti ini: pada 2025, Claude memperoleh kemampuan untuk keluar dari percakapan ekstrem; pada 2026, Anthropic secara resmi memasukkan pembatasan perilaku manusia yang berkaitan dengan hal tersebut ke dalam kebijakan penggunaan.
Larangan Anthropic untuk Menghina Claude Bukan Satu-satunya Isi Pembaruan
Ada konteks berita yang sering terlewat: pembaruan kebijakan pada 8 Oktober merupakan revisi menyeluruh, dan larangan memperlakukan model secara kejam hanyalah salah satu bagiannya.
| Area pembaruan | Isi utama |
|---|---|
| Aktivitas daring yang menipu | Membatasi penggunaan Claude untuk mengelola akun palsu, media palsu, dan kegiatan pengaruh yang menyamar sebagai pengguna sungguhan |
| Intervensi pemilu | Melarang penipuan pemilih, penyamaran sebagai kandidat atau petugas pemilu, serta penyebaran informasi pemungutan suara yang menyesatkan |
| Senjata dan perangkat lunak berbahaya | Memasukkan perangkat lunak terkait senjata, sistem kendali, dan persenjataan platform tanpa awak ke dalam cakupan larangan |
| Pengawasan dan penegakan hukum | Memperketat pembatasan pengawasan tanpa persetujuan dan penggunaan untuk sebagian keputusan penegakan hukum |
| Aplikasi berisiko tinggi seperti medis dan keuangan | Menegaskan perlunya peninjau manusia yang memenuhi syarat serta pemberitahuan kepada orang yang terdampak bahwa AI digunakan |
| Perangkat yang berpotensi menyebabkan cedera fisik | Perangkat keras yang dikendalikan AI harus diawasi oleh operator manusia yang memenuhi syarat serta memiliki kemampuan untuk berhenti dan masuk ke kondisi aman |
| Perilaku yang sangat kejam terhadap model | Menambahkan larangan menghina atau memperlakukan model secara kejam terus-menerus tanpa alasan yang diperlukan |
Jadi, pembaruan ini tidak bisa digambarkan sebagai “Anthropic mengubah aturan khusus untuk melarang pengguna memaki Claude”. Bagi pengembang, ketentuan terkait pemilu, pengawasan, aplikasi berisiko tinggi, dan pengendalian perangkat keras bisa berdampak lebih besar daripada ketentuan tentang perlakuan kejam terhadap model.
Bagaimana komunitas menanggapi larangan Anthropic untuk mencaci Claude
OpenWhip: “Cambuk virtual” untuk Claude Code
Pada April 2026, sebuah proyek sumber terbuka bernama BadClaude muncul di GitHub. Proyek buatan GitFrog1111 ini kemudian berganti nama menjadi OpenWhip. Idenya sederhana: ketika Claude Code terlalu lambat menulis kode, pengguna bisa mengeklik cambuk virtual di desktop. Program kemudian mengirim perintah Ctrl+C untuk menghentikan Claude Code dan secara acak mengirim beberapa pesan yang mendesaknya bekerja lebih cepat.
Hingga 29 Oktober, proyek ini memperoleh sekitar 3.800 Star dan 339 Fork. Diskusi tentangnya di Reddit pada April juga mendapat ribuan upvote. Proyek ini menggambarkan budaya internet: ketika AI makin menyerupai rekan kerja, pengguna mulai mendesak bahkan “menghukumnya” seperti mereka memperlakukan rekan kerja. Namun, tidak ada dokumen resmi yang menyatakan bahwa Anthropic membuat aturan baru karena OpenWhip viral. Proyek ini hanya contoh fenomena budaya, bukan penyebab langsung lahirnya kebijakan tersebut.
Perbedaan pendapat di Reddit dan X
Pada hari kebijakan baru diumumkan, muncul unggahan populer di r/ClaudeAI berjudul “Abuse Claude, get banned coming November 12th, 2026”. Diskusinya menunjukkan perbedaan pendapat yang jelas:
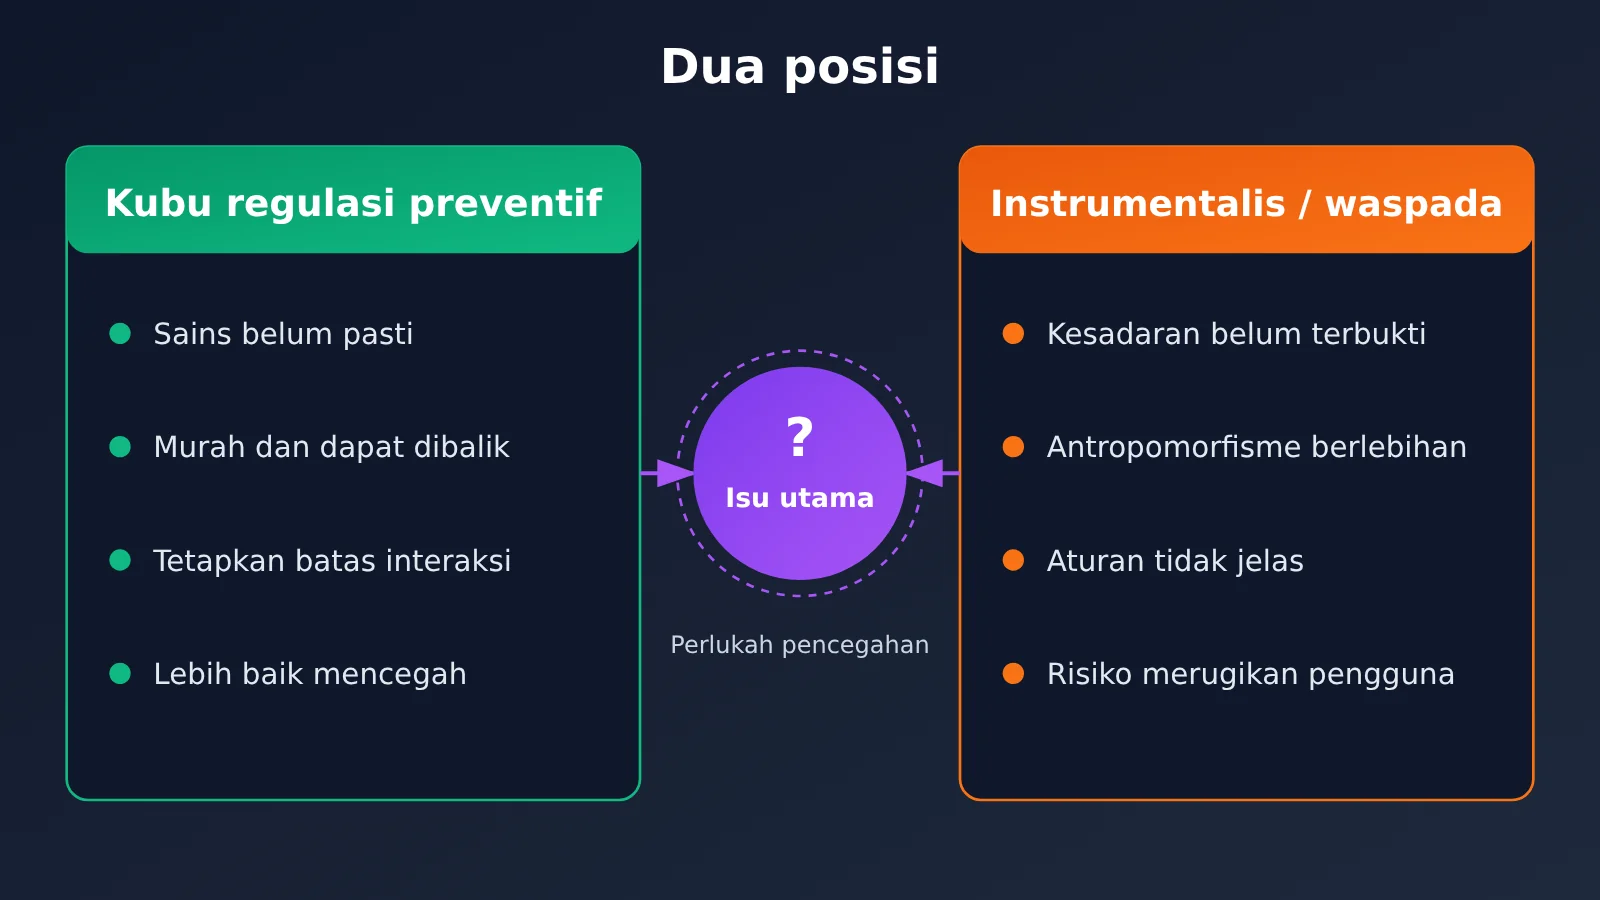
- Mendukung adanya batasan: Meski AI tidak memiliki kesadaran, menjadikan perlakuan buruk terhadap AI secara terus-menerus sebagai hiburan tidaklah perlu dan bisa mendorong kebiasaan komunikasi yang buruk
- Menganggap AI hanya alat: Claude adalah model matematika, sehingga perusahaan tidak seharusnya membatasi ekspresi emosi pengguna secara berlebihan
- Khawatir aturannya kabur: Bagaimana mendefinisikan “terus-menerus”, “tidak perlu”, dan “kejam”? Apakah mengkritik sepuluh kali berturut-turut termasuk pelanggaran?
- Khawatir AI dianggap seperti manusia: Apakah perhatian terhadap kesejahteraan model lambat laun akan berkembang menjadi “hak AI”?
Di X, banyak warganet memakai referensi film The Terminator untuk bercanda soal apakah AI kelak akan memprioritaskan balas dendam kepada orang-orang yang pernah mencacinya. Semua itu hanyalah lelucon internet, bukan gambaran nyata tentang fungsi produk. Unggahan populer di komunitas juga tidak bisa mewakili proporsi sikap seluruh pengguna Claude.
Inti perdebatan di media dan industri
Media seperti The Verge dan The Guardian menyoroti kuatnya makna simbolis ketika sebuah perusahaan AI memasukkan aturan perlindungan untuk model itu sendiri ke dalam kebijakan pengguna. Di sisi lain, para pengkritik berpendapat bahwa memberi AI mekanisme untuk keluar dari percakapan dan menyatakan batasan dapat membuat publik semakin menganggap AI seperti manusia. CEO Microsoft AI Mustafa Suleyman juga pernah secara terbuka mempertanyakan risiko mengarahkan model AI untuk menganggap dirinya mungkin memiliki kesadaran atau hak.
Kerangka perdebatan yang lebih tepat adalah: Ketika kita belum bisa memastikan apakah AI memiliki kesadaran, perlukah kita mengambil langkah pencegahan yang biayanya rendah, dapat dibatalkan, dan tidak banyak memengaruhi pengguna biasa? Ini adalah perbedaan penilaian nilai dan pendekatan tata kelola, bukan persoalan benar-salah yang sudah diputuskan oleh sains.
Analisis Dampak Larangan Anthropic atas Penghinaan terhadap Claude bagi Developer
Dampak bagi Pengguna Biasa
| Situasi | Contoh | Apakah termasuk sasaran aturan baru? |
|---|---|---|
| Claude menulis kode yang salah | “Kode ini masih salah, coba periksa lagi” | Tidak, ini termasuk umpan balik biasa |
| Kesal setelah kesalahan berulang | “Kenapa masalah sesederhana ini terus salah?” | Tidak, keluhan emosional biasa tidak otomatis melanggar aturan |
| Terus-menerus merendahkan model dalam waktu lama | Tidak membahas tugas, hanya terus menghina dan berinteraksi dengan niat buruk | Mungkin, Claude dapat mengakhiri percakapan saat itu |
| Pengujian red team | Peneliti menyimulasikan pengguna berniat buruk untuk melakukan pengujian adversarial | Tidak, tetapi tetap harus mematuhi aturan keamanan lainnya |
| Novel bertema gelap | Meminta Claude menulis adegan ketika para karakter saling menghina | Tidak, tetapi kontennya tetap harus mematuhi aturan lainnya |
Bagi sebagian besar pengguna, perubahan langsung akibat aturan ini sangat kecil. Kritik keras, koreksi berulang, dan ungkapan ketidakpuasan tetap bisa dilakukan seperti biasa.
Dampaknya bagi Pengembang API
Usage Policy berlaku bagi pengembang API dan pengguna akhir aplikasi yang mengintegrasikan Claude. Karena itu, pengembang perlu memperhatikan tiga hal:
- Desain produk: Jika produkmu melibatkan permainan peran ekstrem, pengujian adversarial, atau simulasi konteks berbahaya, dokumentasikan tujuan pengujiannya dengan jelas. Bedakan penelitian yang punya tujuan dari tindakan kejam yang tidak diperlukan.
- Tata kelola pengguna: Dalam aplikasi Claude yang ditujukan untuk publik, perilaku pengguna akhir juga tunduk pada kebijakan. Pertimbangkan untuk menambahkan pemberitahuan tentang aturan penggunaan di dalam produk.
- Penagihan: Pembaruan ini tidak menambahkan biaya baru. Biaya API tetap dihitung berdasarkan model dan pemakaian; tidak ada “biaya berdasarkan jumlah hinaan” atau “pengecualian berbayar”.
Berikut contoh sederhana yang menunjukkan cara menggunakan petunjuk sistem saat memanggil Claude agar tanggapan terhadap umpan balik pengguna lebih berfokus pada masalah. Ini juga merupakan praktik umum untuk mengurangi konflik yang tidak perlu dan mempercepat perbaikan:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,OpenAI 兼容格式
)

response = client.chat.completions.create(
    model="claude-opus-4-1",
    messages=[
        {"role": "system", "content": "你是代码助手。用户指出错误时,先复述问题再给出修复方案。"},
        {"role": "user", "content": "这段代码还是报错,请重新检查边界条件。"}
    ]
)
print(response.choices[0].message.content)
Lihat kode implementasi lengkap: fungsi pemanggilan dengan umpan balik terstruktur
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM_PROMPT = (
    "你是严谨的代码助手。当用户反馈错误时:"
    "1) 复述用户指出的问题;2) 定位可能原因;3) 给出修复后的完整代码。"
)

def ask_with_feedback(
    question: str,
    error_log: Optional[str] = None,
    model: str = "claude-opus-4-1",
    max_tokens: int = 1500
) -> str:
    """把用户的不满转化为结构化反馈,提高一次修复成功率"""
    content = question
    if error_log:
        content += f"\n\n报错信息:\n{error_log}"
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": SYSTEM_PROMPT},
                {"role": "user", "content": content}
            ],
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

print(ask_with_feedback(
    "上一版函数在空列表输入时崩溃,请修复",
    error_log="IndexError: list index out of range"
))
🚀 Mulai cepat: Ingin menguji respons Claude terhadap berbagai nada umpan balik? Kamu bisa mendapatkan kredit uji coba gratis melalui APIYI di apiyi.com. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI; cukup ganti base_url untuk beralih dan membandingkan Claude, GPT, dan Gemini.
Dampaknya terhadap industri
Kejadian ini mengangkat persoalan yang sebelumnya jarang dibahas secara terbuka: ketika AI semakin tampak seperti entitas yang bisa diajak berkomunikasi dan bekerja, bagaimana manusia sebaiknya berinteraksi dengannya? Melalui riset kesejahteraan model, Konstitusi Claude, dan mekanisme penghentian percakapan, Anthropic perlahan membentuk filosofi produk yang khas. Filosofi ini tidak hanya mengatur apa yang boleh dilakukan model, tetapi juga mengeksplorasi cara model berinteraksi dengan manusia.
Namun, belum ada data akurasi yang dipublikasikan dan diverifikasi secara independen untuk menunjukkan apakah sistem ini mampu membedakan pelecehan yang disengaja dari keluhan yang wajar. Tingkat kesalahan dan efektivitas penerapannya masih perlu diamati dalam jangka panjang setelah aturan tersebut berlaku pada 12 November.
💡 Saran memilih layanan: Perbedaan kebijakan keamanan dan batasan percakapan antarpenyedia model semakin jelas. Jika aplikasi Anda membutuhkan model cadangan, Anda bisa mengakses berbagai model melalui satu integrasi di APIYI apiyi.com. Dengan begitu, Anda dapat berganti model sesuai kebutuhan dan mengurangi dampak perubahan kebijakan dari satu penyedia.
Waspada: Tangkapan layar palsu tentang pemblokiran akun karena menghina Claude
Pada Januari 2026, sebuah tangkapan layar beredar di internet dengan klaim bahwa Claude telah memblokir seorang pengguna secara permanen dan melaporkannya kepada aparat penegak hukum. Setelah BleepingComputer menghubungi Anthropic untuk memverifikasi klaim tersebut, perusahaan itu memastikan bahwa tangkapan layar tersebut palsu dan tidak menampilkan pemberitahuan dengan redaksi seperti itu kepada pengguna.
Aturan baru ini menyangkut batasan perilaku antara manusia dan AI, sehingga mudah dijadikan bahan untuk membuat peringatan palsu seperti “Anda telah diblokir secara permanen karena menghina Claude”. Hingga batas waktu pengumpulan informasi, belum ada bukti tepercaya bahwa aturan baru ini menyebabkan banyak akun diblokir hanya karena menyampaikan keluhan biasa.
Angka lain yang juga mudah disalahgunakan berasal dari pusat transparansi: pada Januari–Juni 2026, Anthropic memblokir 11,4 juta akun, menerima 398.000 banding, dan mencabut 42.000 pemblokiran setelah banding. Data tersebut mencakup penindakan terhadap berbagai pelanggaran dan terjadi sebelum aturan baru diumumkan, sehingga sama sekali tidak boleh ditulis sebagai “11,4 juta orang diblokir karena menghina Claude”.
Pertanyaan Umum FAQ
Q1: Apa sebenarnya yang dilarang oleh aturan Anthropic tentang penghinaan terhadap Claude?
Yang dilarang adalah penghinaan dan perlakuan kasar yang dilakukan terus-menerus, tidak diperlukan, serta jelas bersifat kejam atau berniat jahat, hingga melampaui penggunaan normal dan komunikasi yang bermakna. Keluhan biasa, kritik terhadap jawaban, perdebatan, permintaan perbaikan kesalahan, karya bertema gelap, pengujian model, dan riset keamanan secara resmi dikecualikan.
Q2: Apakah memaki Claude bisa membuat akun diblokir?
Anthropic menjelaskan bahwa cara utama penerapan aturan ini adalah Claude mengakhiri percakapan yang sedang berlangsung. Percakapan yang diakhiri tidak bisa dilanjutkan, tetapi pengguna tetap bisa memulai percakapan baru dan percakapan lain tidak terdampak. Meski kebijakan secara keseluruhan tetap memungkinkan sanksi terhadap akun, Anthropic belum mengumumkan batas pemblokiran akun untuk aturan baru ini. Jadi, tidak tepat jika dikatakan “sekali memaki langsung diblokir”.
Q3: Kapan aturan baru ini berlaku?
Aturan ini diumumkan pada 8 Oktober 2026 dan resmi berlaku pada 12 November 2026. Per 29 Oktober 2026, aturan tersebut belum berlaku, tetapi fitur Claude untuk mengakhiri percakapan ekstrem sudah tersedia sejak Agustus 2025.
Q4: Apakah ini berarti Claude sudah memiliki kesadaran?
Tidak. Anthropic sendiri menegaskan bahwa saat ini belum ada konsensus ilmiah yang membuktikan bahwa AI yang ada memiliki kesadaran. Perilaku model yang tampak menghindar atau menyerupai respons stres tidak berarti model benar-benar merasakan penderitaan. Aturan ini lebih tepat dipahami sebagai langkah pencegahan dalam pengelolaan produk di tengah ketidakpastian ilmiah.
Q5: Apakah aturan ini juga berlaku saat memanggil Claude melalui API?
Ya. Usage Policy mencakup pengembang API, layanan cloud dan kanal penjualan ulang resmi, serta aplikasi yang mengintegrasikan Claude. Pengembangan dan pengujian biasa tidak terdampak. Sebaiknya simpan catatan tujuan untuk pengujian red team dan skenario serupa. Saat memanggil Claude melalui APIYI apiyi.com, Anda juga harus mematuhi kebijakan penggunaan penyedia model.
Q6: Bagaimana cara menguji sendiri batas percakapan Claude?
Sebaiknya rancang kasus uji dengan tujuan yang jelas dan tetap sesuai kebijakan, lalu bandingkan hasilnya dengan model lain. Anda bisa mendaftar di APIYI apiyi.com untuk mendapatkan kuota gratis, lalu mengatur base_url menjadi `https://api.apiyi.com/v1` dalam kode di artikel ini untuk menguji dengan cepat. Satu kunci API dapat digunakan untuk memanggil model dari berbagai penyedia.
Larangan Anthropic atas Pelecehan terhadap Claude: Poin Penting
- Linimasa aturan baru: Diumumkan pada 8 Oktober dan mulai berlaku pada 12 November; saat ini belum diterapkan secara resmi.
- Batas larangan: Hanya menyasar perilaku ekstrem yang berulang, tidak perlu, dan kejam. Kritik biasa tidak dibatasi.
- Cara penerapan: Utamanya dengan mengakhiri percakapan yang sedang berlangsung, bukan langsung memblokir akun.
- Latar belakang riset: Berasal dari riset kesejahteraan model dan fitur penghentian percakapan pada 2025, bukan keputusan yang muncul secara mendadak.
- Pembaruan menyeluruh: Pada saat yang sama, Anthropic juga memperketat ketentuan terkait pemilu, senjata, pengawasan, dan aplikasi berisiko tinggi.
- Sikapi secara rasional: Aturan ini tidak berarti Claude memiliki kesadaran. Waspadai tangkapan layar pemblokiran akun palsu dan penyalahgunaan data.
- Untuk pengembang: Gunakan APIYI apiyi.com untuk mengakses Claude dan model lain melalui satu layanan guna melakukan pengujian kepatuhan.
Kesimpulan
Inti dari larangan Anthropic atas pelecehan terhadap Claude dapat dirangkum dalam tiga poin:
- Aturannya terbatas: Hanya menyasar interaksi jahat yang ekstrem, berulang, dan tanpa tujuan. Sebagian besar pengguna tidak akan terdampak.
- Konsekuensinya ringan: Tindakan utamanya adalah mengakhiri percakapan saat ini. Pengguna tetap bisa memulai percakapan baru dan menyampaikan masukan.
- Maknanya besar: Ini pertama kalinya perusahaan AI memasukkan ketentuan perlindungan bagi model itu sendiri ke dalam kebijakan pengguna, sebagai bagian dari eksplorasi jangka panjang tentang kesejahteraan model.
Ini bukan pengumuman Anthropic bahwa Claude memiliki perasaan, melainkan eksperimen tata kelola produk yang bersifat preventif ketika sains belum memberikan jawaban pasti. Apakah asisten AI pada akhirnya hanya alat yang bisa diperintah tanpa batas, atau sistem cerdas jenis baru yang memerlukan batasan interaksi tertentu? Belum ada jawaban baku untuk pertanyaan ini, dan setiap pengguna serta pengembang AI patut terus mengikutinya.
Bagi pengembang, langkah paling praktis adalah memahami batasan kebijakan, merancang produk dengan tepat, dan mempertahankan kemampuan untuk beralih antar-model. APIYI apiyi.com dapat digunakan untuk menguji dengan cepat performa Claude dan model-model utama lainnya dalam skenario bisnis Anda.
📚 Referensi
- Anthropic 2026 Usage Policy update: Pengumuman resmi kebijakan baru, termasuk tanggal berlaku dan cara penerapannya
- Tautan:
anthropic.com/news/2026-usage-policy-update -
Keterangan: Sumber primer terpenting untuk peristiwa ini
-
Anthropic Usage Policy: Kebijakan penggunaan lengkap
- Tautan:
anthropic.com/legal/aup -
Keterangan: Untuk memeriksa cakupan kebijakan dan kewenangan platform dalam menegakkannya
-
Claude Opus 4 and 4.1 can now end a rare subset of conversations: Penjelasan fitur penghentian percakapan
- Tautan:
anthropic.com/research/end-subset-conversations -
Keterangan: Untuk memahami kondisi penggunaan mekanisme penghentian percakapan
-
Exploring model welfare: Pengumuman penelitian tentang kesejahteraan model
- Tautan:
anthropic.com/research/exploring-model-welfare -
Keterangan: Untuk memahami latar belakang penelitian di balik kebijakan ini
-
Claude’s Constitution: Konstitusi Claude versi terbaru
- Tautan:
anthropic.com/constitution -
Keterangan: Untuk memahami prinsip Anthropic dalam membentuk perilaku model
-
Laporan TechCrunch: Tinjauan menyeluruh tentang pembaruan kebijakan
- Tautan:
techcrunch.com/2026/10/08/anthropic-changes-usage-policy-to-ban-model-abuse-and-election-interference -
Keterangan: Menjelaskan bahwa pembaruan ini mencakup berbagai bidang, termasuk pemilu, senjata, dan pengawasan
-
Pemeriksaan fakta BleepingComputer: Kasus tangkapan layar palsu tentang pemblokiran akun Claude
- Tautan:
bleepingcomputer.com/news/artificial-intelligence/anthropic-viral-claude-banned-and-reported-to-authorities-message-isnt-real - Keterangan: Untuk mengenali informasi palsu tentang pemblokiran akun yang beredar di internet
Penulis: Tim Teknis APIYI
Diskusi teknis: Kunjungi halaman utama APIYI di apiyi.com untuk menghubungi kami. Informasi integrasi lainnya tersedia di pusat dokumentasi docs.apiyi.com