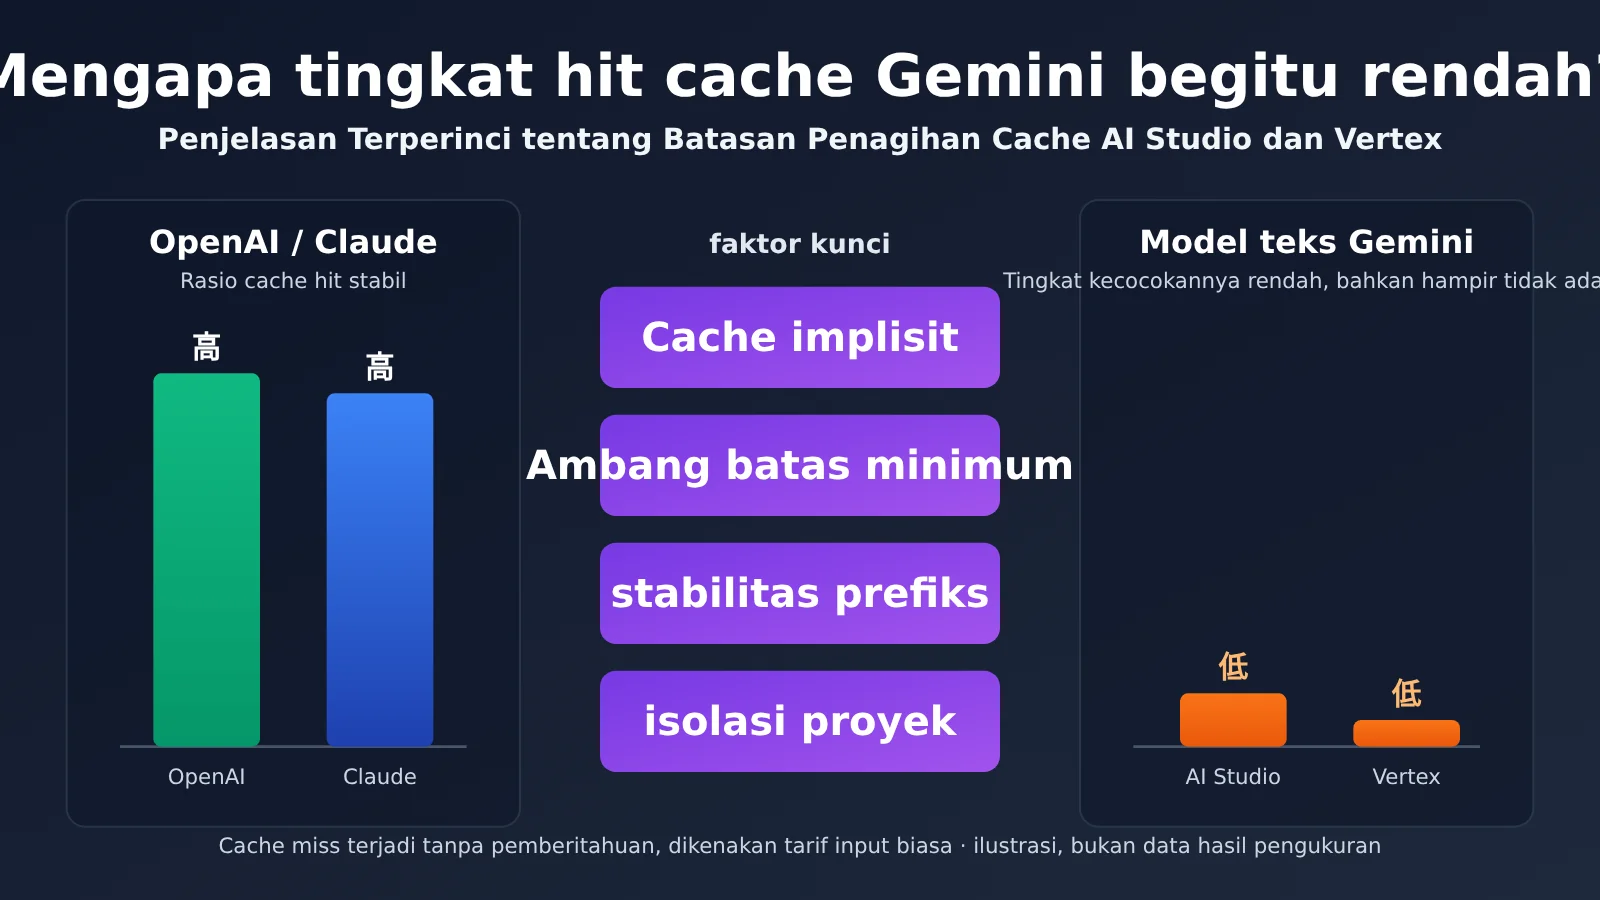
Dalam penggunaan nyata APIYI, penulisan dan hit cache pada seri OpenAI dan Claude berjalan normal, dengan tingkat hit yang juga tinggi. Namun, model teks Gemini berbeda: tingkat hit cache-nya rendah, bahkan nyaris tidak ada. Ini adalah fakta yang bisa direproduksi melalui tagihan dan perincian penggunaan, sekaligus menjadi salah satu hal yang paling membingungkan banyak developer saat mencocokkan tagihan.
Artikel ini mengacu pada dokumentasi resmi Google hingga 20 Oktober 2026 untuk menguraikan 5 jenis penyebab rendahnya tingkat hit cache Gemini, serta menjelaskan cara kerja penentuan biaya cache di AI Studio (Gemini Developer API) dan Vertex AI.
Ini bukan analisis yang sekadar “lempar tanggung jawab”. Google tidak memiliki aturan resmi yang menyatakan bahwa “penggunaan layanan proksi API menurunkan tingkat hit cache Gemini”. Tanpa catatan permintaan dari penyedia upstream, kami juga tidak bisa menyimpulkan bahwa satu penyebab tertentu pasti berlaku. Artikel ini akan menjelaskan aturan resminya terlebih dahulu, lalu membahas kondisi yang dapat membuat aturan tersebut “tidak berlaku”, dan terakhir memberikan langkah pemeriksaan serta pencocokan tagihan yang bisa Anda lakukan sendiri.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami kapan cache Gemini terkena hit dan kapan tidak, menguasai poin penting penagihan bahwa “total input mencakup bagian yang berasal dari cache”, serta dapat memeriksa tagihan secara mandiri menggunakan kolom respons resmi.
Poin utama tentang tingkat hit cache Gemini
Mari mulai dari kesimpulannya. Untuk memahami cache Gemini, kita perlu membedakan dua mekanisme: “cache implisit” dan “cache eksplisit”. Cara pemicu dan penagihan keduanya sangat berbeda.
| Jenis | Cara penggunaan | Cara mendapatkan tarif cache | Apakah ada biaya penyimpanan |
|---|---|---|---|
| Cache implisit (Implicit caching) | Otomatis aktif pada model yang didukung, tanpa perlu membuat objek cache | Setelah permintaan benar-benar terkena hit, bagian yang terkena hit dikenai tarif cache; hit tidak dijamin setiap kali | Tidak ada |
| Cache eksplisit (Explicit caching) | Membuat objek cache secara langsung, lalu merujuk objek tersebut dalam permintaan berikutnya | Input cache yang dirujuk secara valid mendapat tarif cache | Ada |
Dokumentasi resmi tentang cache implisit di Developer API memuat satu keterangan penting: mekanisme ini tidak menjamin penghematan biaya. Cache eksplisit memang lebih pasti, tetapi membutuhkan pekerjaan tambahan, seperti membuat objek cache, mengelola masa berlakunya, dan merujuk objek tersebut dalam permintaan berikutnya.
Mengapa pengalaman menggunakan Gemini berbeda dari OpenAI dan Claude?
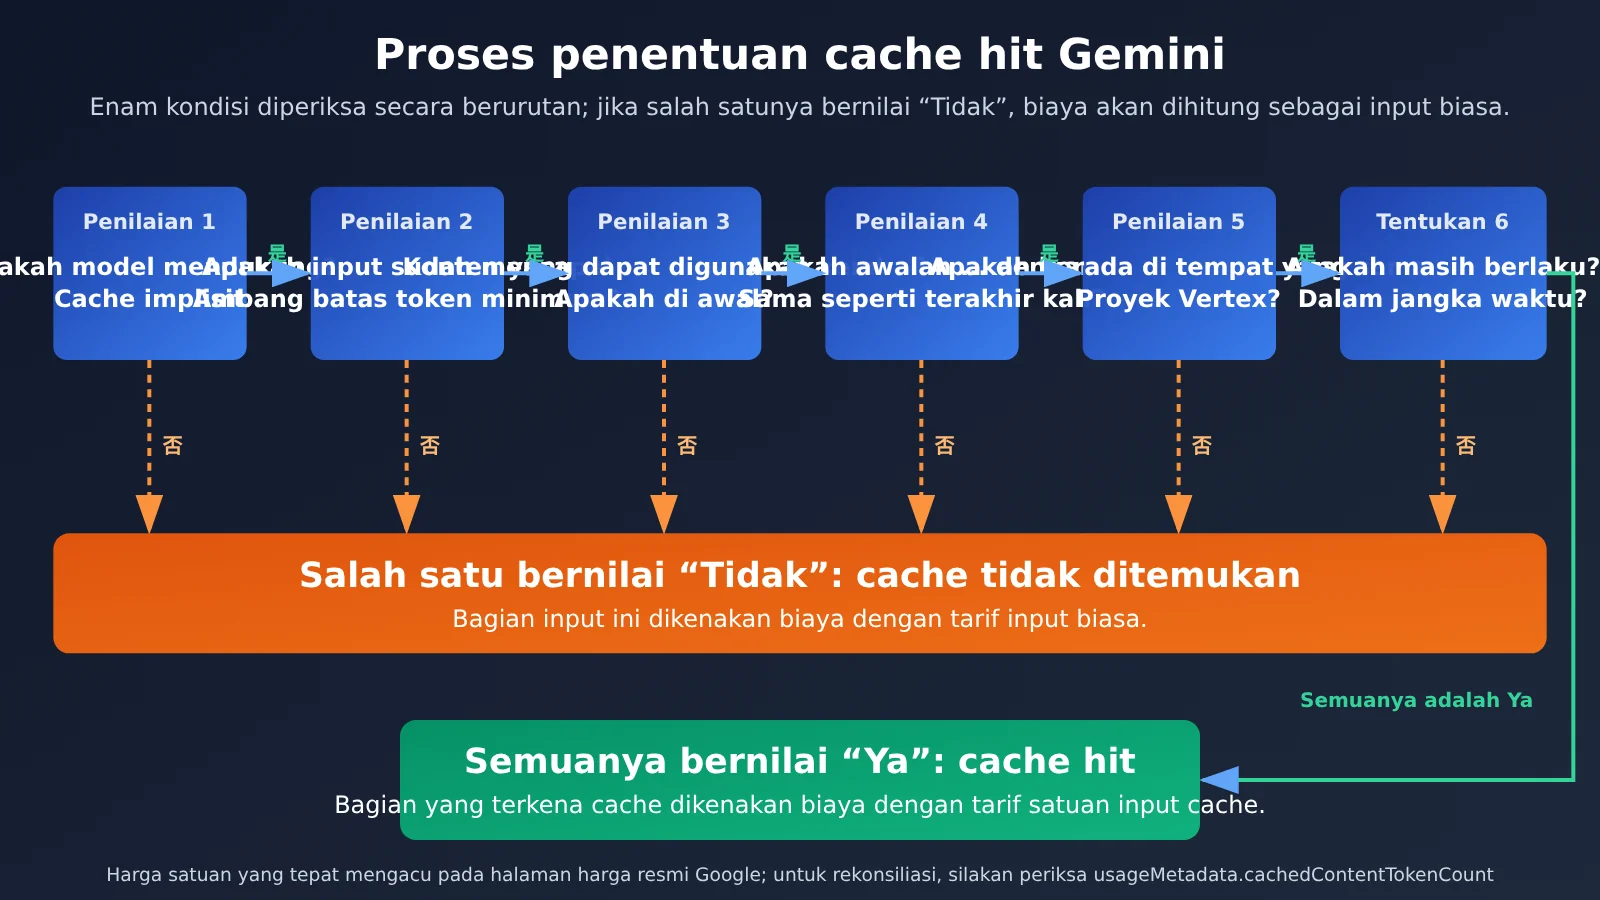
Dari sudut pandang pengguna, seri OpenAI dan Claude di APIYI terlihat “secara konsisten mencatat penulisan dan hit cache saat mengirim prefiks panjang yang sama”. Sementara itu, Gemini mengharuskan beberapa kondisi terpenuhi sekaligus: model mendukung cache implisit, permintaan mencapai ambang minimum token untuk model tersebut, konten yang bisa digunakan ulang berada di awal petunjuk, permintaan serupa dikirim dalam waktu yang berdekatan, dan—di Vertex—permintaan juga harus berada dalam proyek Google Cloud yang sama.
Jika salah satu kondisi tidak terpenuhi, permintaan akan dikenai tarif input biasa. Tidak akan ada error ataupun pemberitahuan. Inilah alasan “tingkat hit rendah” sering tidak disadari: cache bisa gagal terkena hit tanpa memberi tanda apa pun.
Menyamakan istilah: apa yang dimaksud dengan AI Studio?
Dalam artikel ini, istilah “kanal AI Studio” merujuk pada Gemini Developer API, yaitu jalur pemanggilan menggunakan API Key yang dibuat melalui AI Studio. Jalur ini dibandingkan dengan Vertex AI di Google Cloud. Keduanya memiliki konsep mekanisme cache yang serupa, tetapi berbeda dalam hal nilai ambang minimum, cakupan isolasi, dan aturan biaya penyimpanan. Semua perbedaan ini akan dibahas satu per satu di bagian berikutnya.
5 Penyebab Rendahnya Tingkat Cache Hit Gemini
Analisis berikut dibagi menjadi dua bagian: dua penyebab pertama merupakan aturan yang secara jelas tercantum dalam dokumentasi resmi, sedangkan tiga penyebab berikutnya adalah penjelasan bersyarat tentang situasi ketika aturan tersebut dilanggar oleh layanan proksi API atau praktik rekayasa. Kita tidak bisa memastikan penyebab spesifik hanya berdasarkan informasi bahwa Anda “menggunakan layanan proksi API”. Untuk mengetahuinya, kita perlu melihat proyek hulu dan catatan permintaan.
Penyebab 1: Permintaan tidak memenuhi ambang minimum token untuk cache
Cache implisit memiliki ambang minimum token. Permintaan dengan input yang terlalu pendek tidak akan masuk ke cache. Selain itu, ambangnya tidak sepenuhnya sama di kedua platform. Berikut beberapa nilai model yang tercantum dalam dokumentasi saat ini:
| Model | Ambang cache implisit Developer API | Ambang cache implisit Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4.096 | 6.144 |
| Gemini 3.1 Pro Preview | 4.096 | 6.144 |
| Gemini 2.5 Pro (generasi sebelumnya, sebagai pembanding) | 2.048 | 2.048 |
Ada dua hal yang mudah terlewat. Pertama, ambang model generasi baru, seperti Gemini 3.8 Flash, lebih tinggi daripada seri 2.5. Jika Anda menggunakan angka 2.048 dari versi sebelumnya sebagai perkiraan, hasilnya bisa keliru. Kedua, ambang untuk model yang sama mungkin lebih tinggi di Vertex. Permintaan dengan 5.000 token memenuhi syarat di Developer API, tetapi belum tentu di Vertex.
Permintaan percakapan sehari-hari biasanya hanya berisi beberapa ratus hingga satu atau dua ribu token, sehingga secara alami berada di bawah ambang tersebut. Ini salah satu alasan paling langsung mengapa tingkat cache hit Gemini sangat rendah dalam skenario percakapan. Perlu diingat, memenuhi ambang hanyalah syarat wajib, bukan jaminan bahwa cache akan digunakan.
Penyebab 2: Konten yang dapat digunakan kembali tidak berada di awal petunjuk
Google memberikan saran yang sama untuk kedua platform: letakkan konten panjang yang sering digunakan di awal petunjuk, lalu kirim permintaan dengan awalan yang mirip dalam rentang waktu yang relatif singkat. Cache bergantung pada awalan yang sama, bukan sekadar “permintaan memuat dokumen yang sama”.
Dengan kata lain, menyertakan dokumen yang sama dalam dua permintaan belum cukup untuk menjamin cache hit. Posisi dokumen di dalam permintaan dan kestabilan konten yang mendahuluinya juga berpengaruh. Susunan seperti berikut mudah merusak awalan:
# 反例:变化内容放在最前面
[当前时间:2026-10-20 10:31:07]
[请求 ID:a8f3...]
{system 指令}
{长文档}
{用户问题}
Jika satu karakter saja di bagian awal berubah, dokumen panjang setelahnya tidak akan membentuk awalan yang sama dengan permintaan sebelumnya. Kesimpulan ini didasarkan pada saran resmi, tetapi praktik seperti ini sangat umum dalam rekayasa.
Penyebab 3: Lapisan proksi mengubah awalan (bersyarat)
Jika lapisan proksi menyisipkan waktu, ID, atau kolom pelacakan yang berubah-ubah di awal petunjuk, atau menyusun ulang, meringkas, maupun memotong konteks percakapan, awalan yang sama akan berubah dan peluang cache hit menurun. Ini adalah analisis bersyarat; kita tidak bisa langsung menyimpulkan bahwa layanan tertentu melakukan hal-hal tersebut.
Saat melakukan pemeriksaan, bedakan dua hal: apakah awalan permintaan yang Anda kirim ke layanan proksi stabil, dan apakah awalan permintaan yang diteruskan layanan tersebut ke Google juga stabil. Hal pertama bisa Anda kendalikan sendiri, sedangkan hal kedua memerlukan catatan permintaan di sisi hulu.
Penyebab 4: Permintaan tersebar ke beberapa proyek Vertex (bersyarat)
Vertex secara jelas menetapkan bahwa cache diisolasi berdasarkan proyek Google Cloud dan tidak dibagikan lintas proyek. Jika beberapa permintaan dalam sesi yang sama diarahkan secara bergantian ke proyek Vertex yang berbeda, cache yang dibuat oleh Proyek A tidak dapat digunakan oleh Proyek B.
Perlu berhati-hati dalam menilai hal ini: apakah “mengganti kunci” menghilangkan cache bergantung pada apakah proyeknya juga berubah. Kita tidak bisa langsung menyimpulkan bahwa setiap pergantian kunci akan menghilangkan cache. Hubungan antara kunci dan proyek perlu dikonfirmasi lebih lanjut.
Penyebab 5: Hanya permintaan pembuatan konten yang diteruskan, tanpa menggunakan cache eksplisit
Jika alur pemanggilan hanya meneruskan permintaan generateContent, tanpa membuat objek cache atau merujuknya dalam permintaan berikutnya, seluruh alur hanya bergantung pada cache implisit. Cache implisit tidak menjamin hasil yang konsisten, sehingga manfaatnya tidak sestabil cache eksplisit yang “dibuat sekali, lalu dirujuk berulang kali”.
Tabel berikut menghubungkan beberapa situasi pada layanan proksi dengan aturan resmi:
| Perilaku aktual | Kemungkinan dampak | Aturan resmi terkait |
|---|---|---|
| Sesi yang sama diarahkan secara bergantian ke proyek Vertex yang berbeda | Tidak dapat menggunakan cache yang sudah tersedia di proyek lain | Cache diisolasi berdasarkan proyek |
| Menyisipkan waktu atau ID yang berubah di awal, atau menyusun ulang konteks | Awalan yang sama rusak dan peluang cache hit menurun | Letakkan konten panjang di awal; gunakan awalan yang mirip |
| Permintaan terlalu pendek dan konten tetap yang dapat digunakan kembali tidak mencukupi | Ambang minimum cache tidak tercapai | Ambang minimum token |
| Hanya meneruskan permintaan pembuatan konten tanpa membuat atau merujuk objek cache eksplisit | Hanya dapat mengandalkan cache implisit, tanpa jaminan hasil | Cache eksplisit harus dibuat dan dirujuk |
🎯 Saran teknis: Saat memeriksa masalah cache Gemini, coba kirim beberapa permintaan berturut-turut dengan awalan panjang yang sama melalui APIYI apiyi.com, lalu bandingkan kolom token cache pada setiap respons. Gunakan permintaan yang terkontrol untuk memastikan masalahnya bukan pada awalan atau ambang token, sebelum memeriksa kemungkinan masalah di jalur pemanggilan.
Tanpa proyek hulu dan catatan permintaan, penyebabnya tidak bisa dipastikan hanya berdasarkan informasi bahwa Anda “menggunakan layanan proksi API”. Tidak ada pula dasar resmi untuk menyimpulkan bahwa tingkat cache hit Vertex pasti lebih tinggi daripada Developer API.
Cara Memahami Penagihan Cache di AI Studio dan Vertex
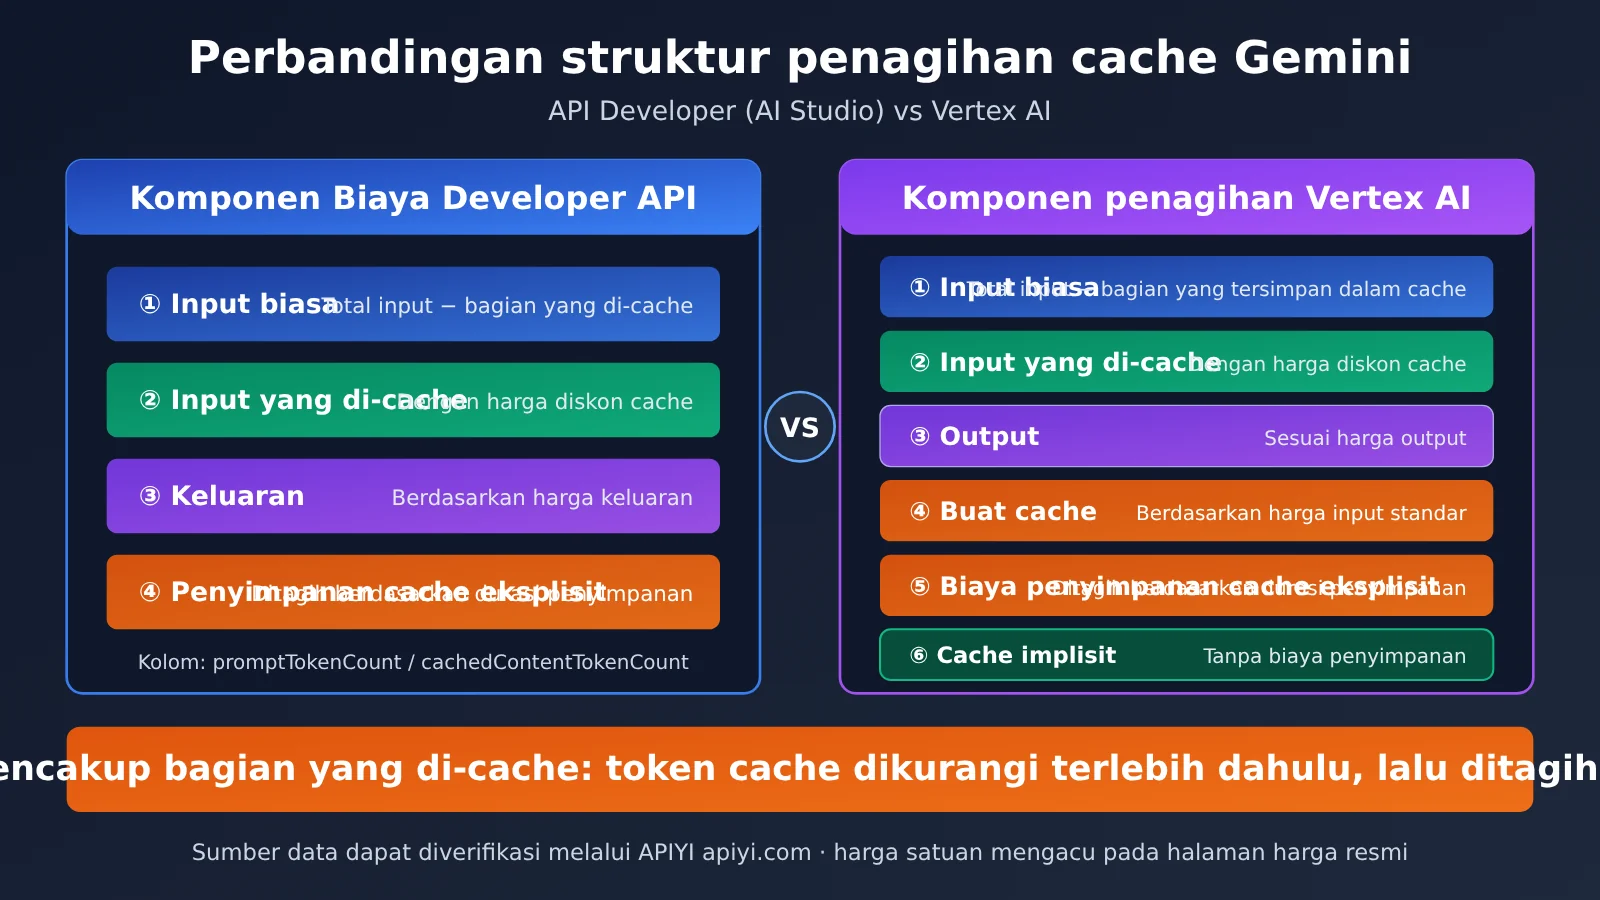
Banyak orang mengira “cache hit” berarti gratis atau seluruh permintaan mendapat diskon yang sama. Anggapan ini keliru. Penagihan di kedua platform perlu dibedakan menjadi empat komponen: input biasa, input cache, output, dan biaya penyimpanan cache eksplisit.
Perbandingan aturan penagihan di kedua platform
| Komponen biaya | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| Input biasa (bagian yang tidak terkena cache) | Mengikuti tarif input biasa | Mengikuti tarif input biasa |
| Input cache (bagian yang terkena cache) | Mengikuti tarif input cache, yang dicantumkan terpisah di halaman harga | Mengikuti tarif input cache, yang dicantumkan terpisah di halaman harga |
| Output | Dihitung terpisah | Dihitung terpisah |
| Input yang digunakan untuk membuat cache | Dihitung sebagai biaya penggunaan token cache | Dikenai harga input standar |
| Biaya penyimpanan cache implisit | Tidak ada | Tidak ada |
| Biaya penyimpanan cache eksplisit | Dihitung berdasarkan durasi penyimpanan | Ada biaya penyimpanan |
Dokumentasi Developer API mencantumkan biaya penggunaan token cache, durasi penyimpanan, input yang tidak di-cache, dan output sebagai faktor penagihan. Vertex juga menjelaskan dua hal secara khusus: input yang digunakan untuk membuat cache dikenai harga input standar, cache implisit tidak dikenai biaya penyimpanan, sedangkan cache eksplisit dikenai biaya penyimpanan. Untuk tarif spesifik, lihat halaman harga resmi terbaru masing-masing platform karena harganya dapat berubah tergantung model dan versinya.
Rumus menghitung biaya input
Untuk permintaan pembuatan teks biasa, biaya input dapat dipahami dengan rumus berikut:
Biaya input =
(total token input − token yang terkena cache) × tarif input biasa
+ token yang terkena cache × tarif input cache
Biaya output dihitung terpisah. Cache eksplisit juga dikenai biaya penyimpanan tambahan. Sebagai contoh, anggap sebuah permintaan memiliki total 10.000 token input, dengan 8.000 token terkena cache. Berarti, 2.000 token dikenai tarif biasa dan 8.000 token dikenai tarif cache.
Hal yang paling sering keliru dihitung: total input sudah mencakup bagian yang di-cache
Saat memeriksa tagihan, lihat respons asli dari Google, bukan hanya “rasio cache hit” yang ditampilkan di dasbor layanan proksi API. Dalam usageMetadata pada respons generateContent, ada dua kolom penting:
| Kolom | Arti | Hal yang perlu diperhatikan saat memeriksa tagihan |
|---|---|---|
usageMetadata.promptTokenCount |
Total token input | Termasuk bagian yang di-cache |
usageMetadata.cachedContentTokenCount |
Token pada bagian yang di-cache | Jumlah token yang terkena cache |
Jadi, jangan menghitung seluruh promptTokenCount dengan tarif biasa, lalu menambahkan biaya input cache secara terpisah. Cara itu akan menghitung biaya dua kali. Cara yang benar adalah mengurangi total input dengan bagian yang di-cache untuk mendapatkan jumlah token yang dikenai tarif biasa. Jika menggunakan Interactions API versi baru, kolom statistik cache resmi yang disediakan adalah usage.total_cached_tokens.
Dua hal yang harus dibedakan
Ada dua hal yang perlu dibedakan: jumlah cache yang benar-benar terkena cache di sisi Google dan cara layanan proksi API memasukkan potongan harga tersebut ke tagihan Anda. Hal pertama dapat diukur menggunakan kolom resmi. Hal kedua bergantung pada aturan penagihan layanan proksi API dan tidak dapat dibuktikan oleh dokumentasi resmi Google. Karena itu, saat mencocokkan tagihan, periksa kolom cache dari respons upstream sekaligus dasar penghitungan pada rincian tagihan.
💡 Saran: Saat memeriksa tagihan, lihat dulu kolom token cache pada tingkat permintaan, lalu periksa rekap tagihannya. Jika ingin membandingkan OpenAI, Claude, dan Gemini dengan dasar yang sama, Anda bisa menggunakan petunjuk yang sama untuk memanggil masing-masing model melalui APIYI apiyi.com agar dapat berpindah model dengan cepat.
Perbedaan penagihan cache Gemini, Claude, dan OpenAI
Ketiganya memiliki pendekatan cache yang berbeda, begitu pula cara menghitung biayanya. Tabel berikut membandingkan cara pemicuan dan penagihannya. Persentase diskon dan durasi dapat berubah mengikuti versi model. Tabel ini menunjukkan gambaran umum saat artikel ditulis; lihat halaman harga resmi masing-masing penyedia untuk angka terbaru:
| Aspek perbandingan | Gemini | Claude | OpenAI |
|---|---|---|---|
| Cara pemicuan | Dua mekanisme: implisit otomatis dan objek cache eksplisit | Eksplisit: tandai titik cache dengan cache_control di dalam permintaan |
Otomatis, tanpa perlu mengubah kode |
| Biaya penulisan cache | Tidak ada untuk cache implisit; pembuatan cache eksplisit dikenai biaya input dan biaya penyimpanan | Ada. Tarif penulisan lebih tinggi daripada input biasa; tarif berbeda untuk masa berlaku 5 menit dan 1 jam | Tidak ada biaya penulisan terpisah |
| Harga pembacaan cache (cache hit) | Lebih rendah daripada input biasa; diskonnya bergantung pada model | Sekitar 1/10 harga input biasa | Lebih rendah daripada input biasa; diskonnya bergantung pada model |
| Biaya penyimpanan | Hanya untuk cache eksplisit, dihitung berdasarkan durasi penyimpanan | Tidak ada; masa berlaku dipilih saat cache ditulis | Tidak ada |
| Ambang minimum | Berbeda menurut model dan kanal; di Vertex bisa lebih tinggi daripada di Developer API | Berbeda menurut model; umumnya 1.024 atau lebih | Biasanya mulai dari 1.024 token |
| Jaminan cache hit | Tidak dijamin untuk cache implisit; lebih pasti untuk cache eksplisit | Setelah titik cache ditandai, cache biasanya stabil terkena hit selama masa berlakunya | Pencocokan prefiks otomatis, tidak dijamin |
| Kolom penggunaan | cachedContentTokenCount (termasuk dalam promptTokenCount) |
cache_creation_input_tokens, cache_read_input_tokens, dicantumkan terpisah dari token input biasa |
prompt_tokens_details.cached_tokens (termasuk dalam prompt_tokens) |
Ada tiga hal dalam tabel ini yang paling mudah membingungkan:
- Biaya penulisan: Claude mengenakan biaya tambahan untuk menulis cache, sedangkan pembacaan cache lebih murah. Jadi, jika banyak menulis tetapi jarang membaca, biayanya bisa lebih tinggi daripada tidak menggunakan cache. OpenAI tidak mengenakan biaya penulisan, sehingga cache miss tidak menambah biaya. Cache implisit Gemini juga tidak dikenai biaya penulisan; hanya cache eksplisit yang menimbulkan biaya pembuatan dan penyimpanan.
- Siapa yang menentukan cache: Pada Claude, pihak yang mengirim permintaan menandai titik cache secara eksplisit sehingga hasil cache hit lebih mudah diprediksi. Cache implisit OpenAI dan Gemini ditentukan otomatis oleh platform. Pengembang hanya bisa meningkatkan peluangnya dengan menjaga prefiks tetap konsisten. Ini salah satu alasan pengguna merasa cache hit Claude dan OpenAI lebih stabil daripada Gemini: Gemini juga dipengaruhi ambang minimum, prefiks, dan pemisahan kanal.
- Dasar penghitungan total input: Total input Gemini dan OpenAI sudah mencakup bagian yang di-cache, jadi bagian itu harus dikurangi sebelum menghitung biaya.
input_tokensClaude tidak mencakup bagian yang dibaca atau ditulis ke cache; ketiga komponen harus dihitung terpisah lalu dijumlahkan. Jika rumus satu layanan diterapkan ke layanan lain, hasil perhitungannya akan keliru. Saat mencocokkan tagihan lintas model melalui APIYI apiyi.com, pastikan dulu dasar penghitungan pada kolom yang dikembalikan masing-masing layanan.
Panduan Singkat Menguji Tingkat Cache Hit Gemini
Setelah membahas teorinya, cara paling andal adalah mengujinya langsung. Caranya: buat awalan tetap yang panjangnya melebihi ambang minimum, letakkan pertanyaan yang berubah di bagian akhir, lalu kirim beberapa permintaan berturut-turut dan amati perubahan pada kolom token cache.
Contoh sederhana
Kode berikut menggunakan format yang kompatibel dengan OpenAI dan mencetak informasi penggunaan yang dikembalikan. Nama kolom mengikuti respons aktual karena penamaan kolom terkait cache bisa berbeda-beda bergantung pada metode integrasi:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Gunakan antarmuka terpadu APIYI
)

# Awalan panjang yang tetap: pastikan melebihi ambang cache minimum model target
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
Lihat kode lengkap untuk pengujian dan pemeriksaan tagihan
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Gunakan antarmuka terpadu APIYI
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """Coba baca jumlah token cache dari usage; nama kolom mengikuti respons aktual"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    Perkirakan biaya input berdasarkan metode perhitungan resmi:
    Total input sudah mencakup bagian yang di-cache, jadi bagian biasa = total input - bagian cache
    Masukkan harga saat ini dari halaman harga resmi (per satu juta token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 Mulai cepat: Sebaiknya gunakan APIYI apiyi.com untuk menjalankan pengujian perbandingan ini. Cukup ganti parameter
modeldalam skrip yang sama untuk menguji Gemini, OpenAI, dan Claude secara berurutan, lalu amati perbedaan performa cache setiap model.
Variabel yang perlu dikendalikan saat pengujian
Saat menjalankan pengujian, periksa satu per satu daftar berikut agar masalah pada konfigurasi Anda tidak keliru dianggap sebagai masalah pada jalur permintaan:
| Hal yang diperiksa | Cara | Tujuan |
|---|---|---|
| Panjang awalan | Pastikan melebihi ambang minimum model target saat ini | Menghindari masalah ambang minimum |
| Stabilitas awalan | Jangan letakkan stempel waktu atau ID permintaan di awal | Mencegah awalan berubah |
| Posisi konten yang berubah | Letakkan pertanyaan pengguna di bagian akhir | Memastikan awalan bersama sepanjang mungkin |
| Jeda antarpermintaan | Kirim permintaan berturut-turut dalam waktu singkat | Mengikuti saran resmi |
| Kelompok pembanding | Uji petunjuk yang sama pada OpenAI atau Claude | Menentukan apakah penyebabnya mekanisme model atau jalur permintaan |
Cara menafsirkan hasil pengujian
Jika awalan cukup panjang, strukturnya stabil, dan jeda antarpermintaan sangat singkat, tetapi Gemini tetap hampir tidak mencatat cache hit sementara petunjuk yang sama normalnya menghasilkan cache hit di OpenAI atau Claude, berarti perbedaannya berasal dari mekanisme cache Gemini dan kondisi jalur di sisi penyedia hulu, bukan dari cara Anda menulis petunjuk. Dalam situasi ini, pertimbangkan cache eksplisit: tetapkan konten panjang yang perlu digunakan kembali, buat objek cache secara langsung, lalu rujuk objek tersebut dalam permintaan.
Jika bisnis Anda hanya melibatkan percakapan singkat, daripada mengejar tingkat cache hit, lebih baik terima bahwa manfaat cache Gemini terbatas untuk skenario seperti ini. Fokuskan optimasi biaya pada pemilihan model dan pengendalian panjang output.
Pertanyaan umum
Q1: Mengapa tingkat cache hit Gemini jauh lebih rendah daripada OpenAI dan Claude?
Cache implisit Gemini mensyaratkan model yang mendukungnya, jumlah token yang memenuhi ambang minimum, awalan yang stabil, dan waktu permintaan yang berdekatan. Di sisi Vertex, cache juga dibatasi oleh isolasi proyek, dan Google secara resmi menyatakan bahwa cache hit tidak dijamin. Jika satu saja syarat tidak terpenuhi, biaya akan dihitung diam-diam sebagai input biasa. Untuk mengetahui penyebab pada jalur permintaan tertentu, periksa catatan permintaan di sisi penyedia hulu.
Q2: Apakah Google pernah menyatakan secara resmi bahwa penggunaan layanan proksi API menurunkan tingkat cache hit?
Tidak. Google hanya menjelaskan syarat yang memengaruhi cache: awalan yang dapat digunakan kembali, ambang minimum token, dan cakupan penerapan. Jika jalur permintaan mengubah syarat-syarat tersebut, tingkat cache hit bisa turun. Untuk membandingkan performa cache berbagai model, Anda bisa menguji petunjuk yang sama secara terkontrol melalui APIYI apiyi.com.
Q3: Apakah bagian yang terkena cache gratis?
Tidak. Bagian yang terkena cache dikenai harga input cache, yang lebih murah daripada input biasa tetapi tidak gratis. Halaman harga kedua penyedia mencantumkan harga input biasa dan input cache secara terpisah. Cache eksplisit juga dikenai biaya penyimpanan.
Q4: Apakah token cache perlu ditambahkan lagi secara terpisah ke jumlah token input di tagihan?
Tidak. `promptTokenCount` adalah total input dan sudah mencakup bagian yang terkena cache. Kurangi `cachedContentTokenCount` dari total input untuk mendapatkan bagian yang ditagih dengan harga biasa, lalu hitung biaya bagian cache secara terpisah.
Q5: Apakah ambang cache di AI Studio dan Vertex sama?
Tidak sepenuhnya. Berdasarkan dokumentasi saat ini, ambang Gemini 3.1 Pro Preview dan Gemini 3.8 Flash adalah 4.096 di Developer API dan 6.144 di Vertex. Untuk Gemini 2.5 Pro generasi sebelumnya, ambangnya 2.048 di kedua layanan. Ambang dapat berubah mengikuti versi model, jadi gunakan angka terbaru dalam dokumentasi resmi.
Q6: Apakah cache akan hilang jika saya mengganti kunci API?
Tergantung apakah Anda juga mengganti proyek. Cache Vertex diisolasi per proyek Google Cloud dan tidak dapat dibagikan lintas proyek. Jadi, jika kunci API yang baru berasal dari proyek lain, cache tidak akan tersedia. Namun, jangan langsung berasumsi bahwa cache hilang jika kunci yang berbeda masih berada di proyek yang sama.
Q7: Sebaiknya saya memakai cache implisit atau eksplisit?
Jika Anda perlu berulang kali menggunakan konten berukuran besar yang tetap—seperti dokumen panjang atau petunjuk sistem panjang—cache eksplisit lebih dapat diprediksi, tetapi memerlukan biaya pengembangan dan biaya penyimpanan. Jika konten hanya sesekali digunakan kembali, cache implisit tidak memerlukan biaya tambahan, tetapi manfaatnya tidak dapat dipastikan. Anda bisa mulai dengan uji perbandingan skala kecil melalui APIYI apiyi.com sebelum memutuskan apakah akan mengembangkan cache eksplisit.
Q8: Bisakah tingkat cache hit yang ditampilkan di dasbor layanan proksi API langsung digunakan untuk mencocokkan tagihan?
Sebaiknya jangan. Jadikan kolom cache pada respons asli dari penyedia resmi sebagai acuan. Selain itu, cache hit aktual di sisi Google dan cara layanan proksi API menghitung tagihan Anda adalah dua hal yang berbeda. Untuk hal terakhir, periksa aturan penagihan layanan proksi API tersebut.
Poin Penting tentang Tingkat Cache Hit
- Kondisi ini memang terjadi: Cache hit pada seri OpenAI dan Claude stabil, sedangkan tingkat cache hit Gemini rendah, bahkan nyaris tidak ada. Hal ini perlu dianalisis secara terpisah.
- Tidak ada jaminan dari pihak resmi: Cache implisit Gemini tidak menjamin penghematan biaya. Untuk menggunakan cache eksplisit, Anda perlu membuat dan merujuk objek cache secara manual.
- Ambang batas berbeda tiap model: Model generasi terbaru memiliki ambang batas yang lebih tinggi. Nilainya juga bisa berbeda antara Vertex dan Developer API.
- Prefiks menentukan cache hit: Letakkan konten panjang di bagian awal. Jangan sisipkan konten yang berubah-ubah, seperti waktu atau ID, di awal karena dapat merusak prefiks yang sama.
- Cache Vertex terisolasi per proyek: Cache tidak dibagikan lintas proyek. Jika permintaan tersebar ke beberapa proyek, cache bisa tidak terpakai.
- Total input sudah mencakup cache:
promptTokenCountsudah mencakup bagian yang berasal dari cache. Saat mencocokkan tagihan, kurangi bagian cache terlebih dahulu, lalu hitung biaya masing-masing. - Cocokkan berdasarkan kolom: Gunakan kolom cache pada respons resmi sebagai acuan, lalu bandingkan model dengan petunjuk yang sama melalui APIYI apiyi.com.
Kesimpulan
Rendahnya tingkat cache hit Gemini disebabkan oleh gabungan beberapa faktor: cache implisit tidak menjamin cache hit, ambang batas minimum token meningkat seiring model yang digunakan, prefiks harus konsisten, cache Vertex diisolasi per proyek, dan cache eksplisit harus dibuat secara manual. Jika beberapa kondisi terakhir berubah pada tingkat alur permintaan, tingkat cache hit bisa turun. Namun, penyebab pastinya perlu dipastikan dengan memeriksa proyek di sisi penyedia dan catatan permintaan.
Untuk biaya, ingat tiga hal: cache hit tidak berarti gratis; total input sudah mencakup bagian cache sehingga bagian tersebut tidak boleh dihitung dua kali; dan cache eksplisit memiliki biaya penyimpanan, sedangkan cache implisit tidak. Gunakan kolom pada respons resmi sebagai acuan saat mencocokkan tagihan, dan periksa secara terpisah metode penghitungan biaya layanan proksi API.
Langkah berikutnya: gunakan skrip pengujian dalam artikel ini untuk membandingkan Gemini dengan OpenAI dan Claude menggunakan prefiks panjang yang tetap, lalu tentukan apakah cache eksplisit perlu digunakan. Anda bisa memvalidasi hasilnya dengan cepat melalui APIYI apiyi.com. Berbagai model dapat digunakan melalui antarmuka yang sama sehingga perbandingan biayanya lebih mudah.
Referensi
- Dokumentasi caching Gemini API: Penjelasan resmi tentang caching implisit dan eksplisit
- Tautan:
ai.google.dev/gemini-api/docs/caching -
Keterangan: Mencakup batas minimum token dan faktor penagihan
-
Halaman harga Gemini API: Harga untuk input biasa, input yang di-cache, output, dan penyimpanan
- Tautan:
ai.google.dev/gemini-api/docs/pricing -
Keterangan: Acuan untuk memeriksa harga terbaru
-
Ringkasan caching konteks di Vertex AI: Isolasi proyek dan aturan penagihan untuk cache
- Tautan:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
Keterangan: Menjelaskan bahwa cache Vertex tidak dibagikan lintas proyek
-
Referensi Gemini API generateContent: Kolom
usageMetadatadalam respons - Tautan:
ai.google.dev/api/generate-content - Keterangan: Kolom token cache yang digunakan saat memeriksa tagihan
Penulis: APIYI Team
Diskusi teknis: Silakan bagikan pengalaman Anda dalam memecahkan masalah caching Gemini di kolom komentar. Informasi selengkapnya tersedia di pusat dokumentasi APIYI: docs.apiyi.com.