Catatan penulis: Mengulas proses Claude mengungkap asal-usul seed kurva elips NIST, menjelaskan batas kesimpulan ini, serta menyajikan 3 cara menggunakan AI Agent yang bisa langsung diterapkan peneliti, lengkap dengan kode dan metode pengendalian biaya.
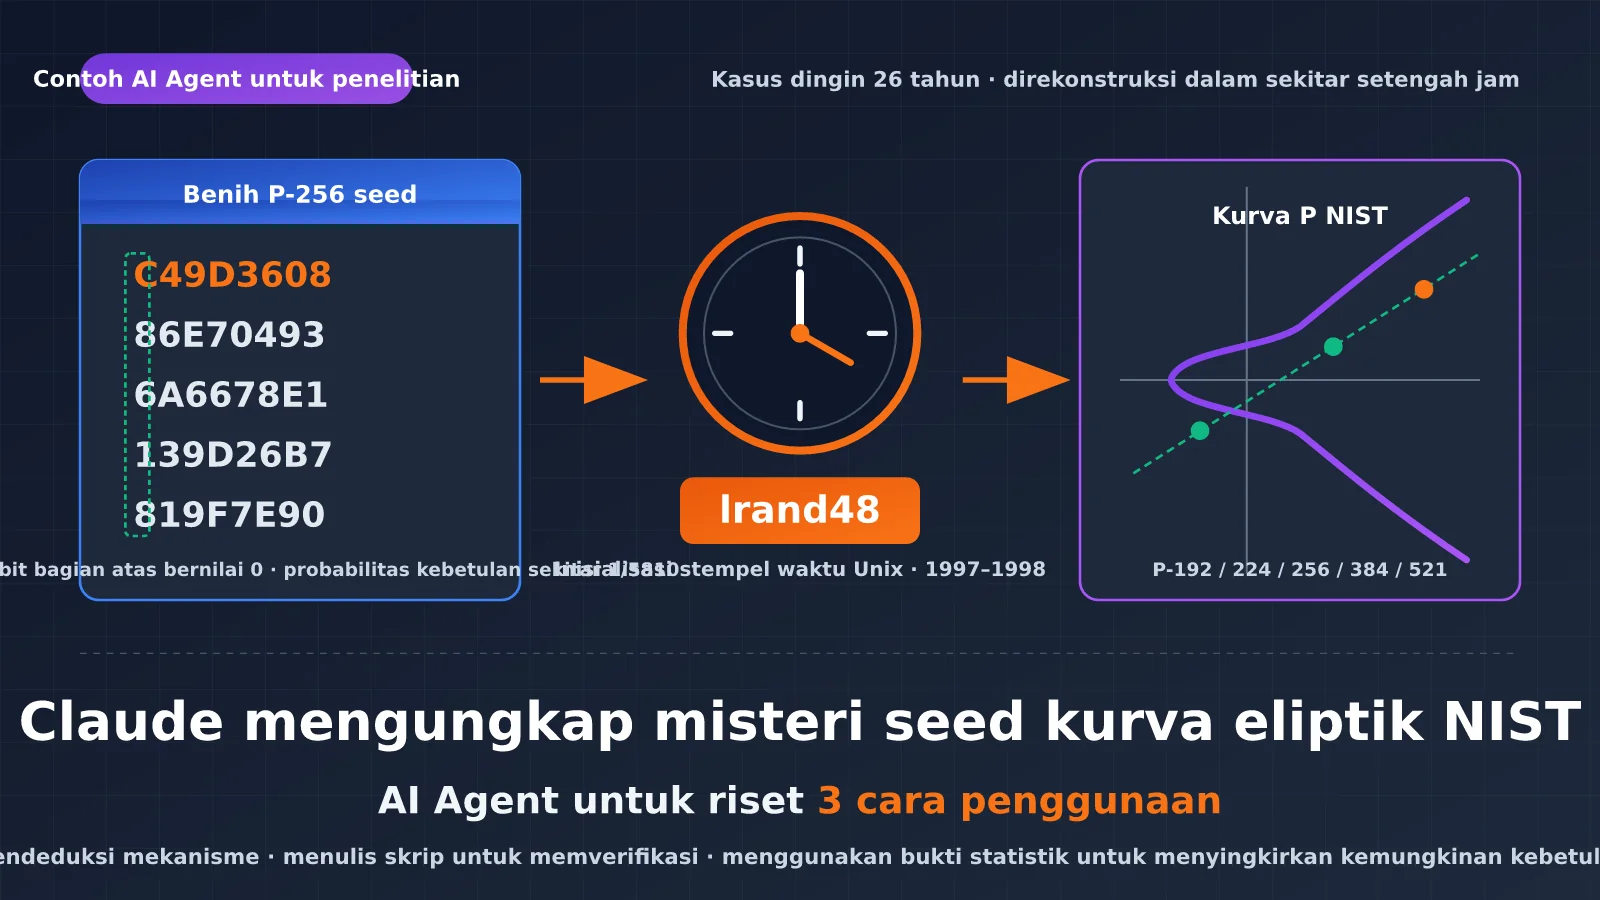
Pada 17 Oktober 2026, Anthropic Frontier Red Team menerbitkan sebuah riset: model riset internal mereka berhasil mengungkap cara pembuatan seed lima kurva NIST, yaitu P-192, P-224, P-256, P-384, dan P-521, hanya dalam waktu sekitar setengah jam dan tanpa petunjuk apa pun. Seed tersebut tidak diproses dengan algoritma hash. Seed itu berasal dari keluaran generator bilangan pseudoacak lrand48 bawaan pustaka C pada era 1990-an, dengan timestamp Unix sebagai nilai awal. Unggahan resmi @AnthropicAI hanya menyebut, “It is just timestamps.” Unggahan itu telah dilihat sekitar 855 ribu kali.
Ini bukan pembobolan kriptografi atau kerentanan baru. Bagi peneliti, nilai kasus ini terletak pada cara kerja Claude: menalar mekanisme, menulis skrip untuk memverifikasi, lalu menggunakan bukti statistik untuk menyingkirkan kemungkinan kebetulan. Alur kerja ini bisa langsung diterapkan pada riset Anda sendiri.
Nilai utama: Setelah membaca artikel ini, Anda akan memahami apa yang dibuktikan dan tidak dibuktikan oleh temuan tersebut. Anda juga akan mendapatkan 3 alur kerja AI Agent untuk riset yang bisa langsung digunakan, masing-masing dilengkapi langkah-langkah penerapan dan kode yang dapat dijalankan.
Claude mengungkap misteri seed kurva elips NIST: poin-poin utama
| Poin utama | Penjelasan | Arti bagi peneliti |
|---|---|---|
| Latar belakang teka-teki | Pada 2000, NIST mengadopsi ECDSA dalam FIPS 186-2. Seed kurva diberikan NSA tanpa penjelasan tentang asal-usulnya | Masalah yang tak terpecahkan selama 26 tahun ini bisa menjadi tolok ukur kemampuan penalaran AI |
| Kesimpulan | Seed berasal dari keluaran lrand48 yang diinisialisasi dengan timestamp antara Mei 1997 dan April 1998 |
Siapa pun dapat mereproduksi kesimpulan ini dengan biaya verifikasi yang sangat rendah |
| Metode utama | Menalar cara perangkat lunak ditulis, membuat pemindai sendiri, menggunakan ciri statistik untuk menemukan kecocokan, lalu memulihkan status | Tiga langkah ini dapat diterapkan untuk analisis data eksperimen, pemodelan balik, dan tugas lainnya |
| Implikasi keamanan | Temuan ini bukan kerentanan; pengguna tidak perlu mengubah konfigurasi atau melakukan migrasi | Saat menulis tinjauan atau laporan, sampaikan dengan akurat dan jangan melebih-lebihkan |
| Pertanyaan yang belum terjawab | Seed B-163 belum terungkap, sementara cara pembuatan titik dasar G untuk P-224 hingga P-521 masih belum diketahui | Kesimpulan dari AI juga memiliki batas; bagian yang belum terpecahkan perlu dicatat |
Misteri seed kurva elips NIST: Apa yang dibuktikan oleh temuan ini?
Standar ECDSA menerbitkan sebuah seed untuk setiap kurva. Hash seed tersebut digunakan untuk menentukan koefisien kurva b. Seed P-256 adalah C49D3608 86E70493 6A6678E1 139D26B7 819F7E90. Karena sumbernya tidak pernah dijelaskan, komunitas selama ini khawatir NSA mungkin sengaja memilih parameter yang memiliki kelemahan. Koblitz dan Menezes pernah menulis ulasan berjudul A Riddle Wrapped in an Enigma, sementara Filippo Valsorda menawarkan hadiah sebesar 36.864 dolar AS untuk mengungkapnya. Sempat beredar kabar bahwa Jerry Solinas membuat seed dengan melakukan hash pada kalimat gurauan, tetapi belakangan klaim itu terbukti keliru.
Dampak praktis temuan ini adalah meningkatkan kepercayaan terhadap kurva-kurva tersebut. Seed dibuat dengan generator bilangan pseudoacak biasa yang diinisialisasi oleh jam, sehingga tidak ada ruang untuk memilihnya secara manual. Siapa pun dapat mereproduksinya. Artikel aslinya juga menyebutkan bahwa ada sejumlah kecil kandidat kurva lain yang sama-sama dapat digunakan, tetapi dilewatkan tanpa alasan yang diketahui. Jumlahnya sedikit dan tidak mengindikasikan adanya upaya sengaja untuk memilih kurva yang lemah. Hadiah uang tersebut akan disumbangkan kepada Internet Security Research Group.
Saat mengutip temuan ini dalam makalah atau diskusi kelompok, rumusan yang lebih akurat adalah: “AI merekonstruksi proses pembuatan parameter historis sehingga proses tersebut dapat direproduksi.” Jangan menulis, “AI membobol kurva elips.”
Mengurai 4 langkah Claude dalam menalar asal-usul seed
Penalaran ini tidak mengandalkan tebak-tebakan secara brutal. Prosesnya berupa rangkaian langkah yang bisa diperiksa:
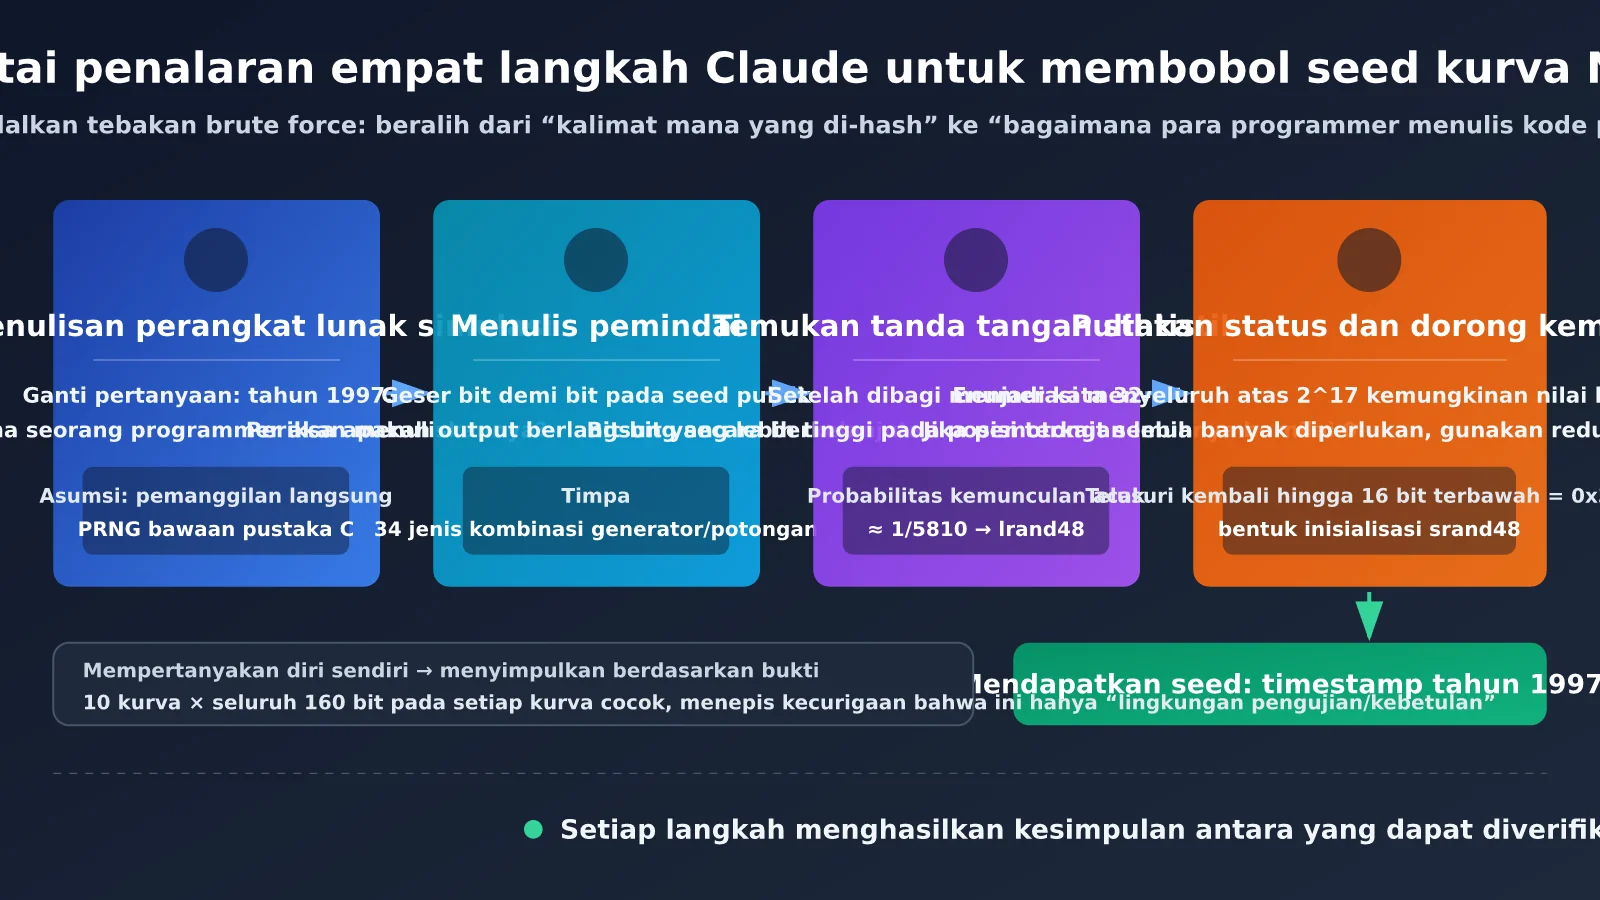
- Mengubah pertanyaan: Alih-alih menebak “kalimat apa yang di-hash”, Claude menalar cara orang yang menulis program pembuat kurva pada 1997 kemungkinan besar menulis kodenya. Kesimpulannya, mereka mungkin langsung menggunakan generator bilangan acak bawaan pustaka C.
- Menulis pemindai: Pemindai menggeser posisi bit pada seed yang telah dipublikasikan, lalu menguji apakah potongan-potongan yang berdekatan menyerupai keluaran berurutan dari generator era 1990-an. Total ada 34 kombinasi generator dan pemotongan yang diperiksa.
- Mencari ciri statistik: Setelah seed dibagi menjadi kata 32-bit, bit-bit tinggi pada posisi yang bersesuaian ternyata semuanya bernilai 0. Kemungkinan hal ini terjadi secara acak sekitar 1/5810. Pola ini sesuai dengan karakteristik
lrand48, yang hanya mengembalikan 31 bit tertinggi dari status 48-bit. - Memulihkan status dan menelusuri kembali: Claude menguji 2^17 kemungkinan nilai untuk 17 bit tersembunyi, lalu memvalidasinya dengan kata-kata berikutnya. Untuk seed yang pemotongannya lebih banyak, Claude menggunakan reduksi basis kisi LLL. Setelah itu, status ditelusuri mundur hingga ditemukan pola inisialisasi
srand48, yaitu 16 bit terbawah bernilai0x330E.
Ada satu detail menarik dalam proses penalarannya: model sempat curiga bahwa dirinya mungkin berada di lingkungan pengujian, lalu menghilangkan kecurigaan itu dengan bukti bahwa “10 kurva, masing-masing 160 bit, semuanya cocok—ini tidak mungkin kebetulan.” Kebiasaan untuk “meragukan diri sendiri terlebih dahulu, lalu menuntaskan analisis dengan bukti” adalah hal yang paling dibutuhkan dari Agent untuk riset.
Panduan Cepat AI Agent untuk Riset: Satu Key untuk Mengakses Model Unggulan
Sebelum mulai, pastikan dulu alur pemanggilan API berjalan lancar. APIYI menyediakan antarmuka yang kompatibel dengan OpenAI. Dengan satu kunci, Anda bisa mengakses claude-opus-5-5 atau beralih ke model unggulan keluarga GPT dan Gemini untuk melakukan validasi silang.
Langkah integrasi tidak perlu diulang di sini. Langsung lihat dokumentasi panduan cepat resmi APIYI: docs.apiyi.com/getting-started. Ikuti dokumentasi untuk membuat Key di konsol dan mendapatkan base_url (https://api.apiyi.com/v1), lalu gunakan contoh di dokumentasi untuk memastikan alurnya berjalan lancar. Detail penagihan dan model yang tersedia mengikuti informasi di konsol.
Tiga cara penggunaan berikut memakai satu pembungkus sederhana yang disimpan sebagai research_client.py. Fungsinya hanya dua: memilih model berdasarkan tahap dan menghitung akumulasi penggunaan token untuk mengendalikan biaya.
# research_client.py
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1")
CHEAP = os.environ.get("CHEAP_MODEL", "claude-opus-5-5")  # Isi dengan nama model ringan dari konsol
FLAGSHIP = "claude-opus-5-5"
USAGE = {"prompt": 0, "completion": 0, "calls": 0}


def chat(messages, stage="draft", max_tokens=2048, temperature=0.2):
    """stage='draft' menggunakan model yang lebih murah; stage='verify' menggunakan model unggulan."""
    r = client.chat.completions.create(model=FLAGSHIP if stage == "verify" else CHEAP,
        messages=messages, max_tokens=max_tokens, temperature=temperature)
    USAGE["prompt"] += r.usage.prompt_tokens
    USAGE["completion"] += r.usage.completion_tokens
    USAGE["calls"] += 1
    return r.choices[0].message.content


def ask(prompt, stage="draft", system=None, max_tokens=2048):
    msgs = ([{"role": "system", "content": system}] if system else []) + [{"role": "user", "content": prompt}]
    return chat(msgs, stage=stage, max_tokens=max_tokens)


def report():
    print(f"Total pemanggilan {USAGE['calls']} kali, prompt={USAGE['prompt']}, completion={USAGE['completion']}")
Mengendalikan Biaya AI Agent untuk Riset: Uji Alur dengan Model Murah, Gunakan Model Unggulan untuk Validasi Penting
Tugas riset sering memerlukan beberapa putaran iterasi. Jika sejak awal selalu memakai model unggulan, kuota bisa habis untuk masalah bernilai rendah seperti kesalahan format atau kegagalan parsing JSON. Cara yang lebih aman adalah memilih model sesuai tahap:
| Tahap | Model yang disarankan | Kriteria penilaian | max_tokens yang umum |
|---|---|---|---|
| Debug alur (format petunjuk, parsing, penilai) | Model ringan dan murah | Alur berjalan dari awal hingga akhir tanpa error | 512-1024 |
| Menghasilkan hipotesis (menyusun mekanisme kandidat) | Utamakan model ringan; beralih ke model unggulan jika cakupannya kurang | Daftar kandidat mencakup hipotesis utama yang sudah dikenal | 1024-2048 |
| Menalar mekanisme dan melakukan validasi penting | claude-opus-5-5 | Kesimpulan akan dimasukkan ke makalah atau menentukan investasi eksperimen selanjutnya | 2048-4096 |
| Validasi silang | Beralih ke model unggulan dari penyedia lain dengan Key yang sama | Dua model secara independen menghasilkan kesimpulan yang sama | 2048 |
Dalam praktiknya, ingat aturan ini: jalankan skrip pertama kali dengan model murah, lalu gunakan model unggulan untuk pertama kalinya saat menetapkan kesimpulan.
Cara Menggunakan AI Agent untuk Riset 1: Menalar Mekanisme, Lalu Memvalidasinya
Langkah ini mengikuti pendekatan Claude untuk “mengganti pertanyaan”: jangan langsung menebak jawabannya, tetapi telaah terlebih dahulu mekanisme yang menghasilkan data, lalu uji dengan data. Pendekatan ini cocok untuk situasi seperti munculnya pola yang tidak biasa pada data eksperimen, menebak proses pembentukan data historis dari hasil yang ada, atau mencari sumber parameter saat mereplikasi makalah.
Langkah-langkah
- Jelaskan fenomenanya saja, tanpa memberikan dugaan: Berikan data pengamatan, batasan yang diketahui, dan konteks waktu kepada model. Jangan menulis “menurut saya ini disebabkan oleh XX” agar model tidak terpengaruh.
- Minta model menyusun mekanisme dan prediksi yang bisa dibantah: Setiap mekanisme kandidat harus disertai satu prediksi: “Jika mekanisme ini benar, karakteristik apa yang seharusnya muncul dalam data?”
- Urutkan berdasarkan biaya validasi: Minta model mengurutkannya berdasarkan “waktu yang dibutuhkan untuk validasi”, dari yang paling singkat. Validasi lebih dulu beberapa kandidat dengan biaya terendah.
- Minta model unggulan memeriksa ulang urutannya: Daftar kandidat bisa dibuat lebih dulu dengan model murah, tetapi serahkan pengurutan dan penalaran akhirnya kepada claude-opus-5-5.
Templat petunjuk
from research_client import ask, report

PROMPT = """Anda adalah asisten riset yang teliti. Berikut adalah sekumpulan data pengamatan dan latar belakang, tanpa petunjuk apa pun tentang penyebabnya.

【Pengamatan】
{observation}

【Batasan latar belakang】
{context}

Selesaikan tugas berikut:
1. Telaah “bagaimana proses yang paling mungkin menghasilkan data ini”, dan susun setidaknya 5 mekanisme kandidat;
2. Untuk setiap mekanisme, berikan satu prediksi yang bisa dibantah: karakteristik yang dapat diuji dan pasti muncul dalam data jika mekanisme tersebut benar;
3. Perkirakan biaya validasi setiap prediksi (rendah/sedang/tinggi), lalu urutkan dari biaya terendah;
4. Tunjukkan bagian yang paling tidak Anda yakini.
Sajikan hasilnya dalam tabel Markdown disertai penjelasan singkat."""

draft = ask(PROMPT.format(
    observation="Seed NIST P-256: C49D3608 86E70493 6A6678E1 139D26B7 819F7E90",
    context="Dihasilkan oleh lembaga pemerintah menggunakan perangkat lunak pada 1997-1998; metode pembuatannya tidak diumumkan secara resmi; dugaan umum menyebut hash frasa, tetapi belum terbukti",
), stage="draft")

final = ask("Tinjau dan perbaiki daftar mekanisme kandidat berikut. Hapus entri yang tidak bisa dibantah dan urutkan kembali:\n" + draft,
            stage="verify", max_tokens=3000)
print(final)
report()
Untuk menilai apakah langkah ini sudah memenuhi harapan, gunakan dua kriteria: apakah setiap mekanisme memiliki prediksi yang bisa dibantah, dan apakah validasi yang berada di urutan pertama bisa diselesaikan dalam satu jam. Jika salah satunya belum terpenuhi, minta model menulis ulang.
Cara Menggunakan AI Agent untuk Riset 2: Meminta Model Menulis Skrip Pemindaian dan Validasi
Langkah ini mengikuti pendekatan Claude yang menulis pemindai sendiri untuk mencakup 34 kombinasi generator dan pemotongan data. Intinya, kita mengubah “terlihat mirip” menjadi “secara statistik kecil kemungkinannya terjadi secara kebetulan”. Pendekatan ini juga bisa digunakan untuk tugas seperti pemindaian parameter, deteksi sinyal, dan pencarian struktur tersembunyi dalam data.
Langkah-langkah
- Berikan prediksi dari cara pertama yang paling murah untuk divalidasi kepada model, lalu minta model menulis skrip pemindaian yang hanya bergantung pada pustaka standar.
- Minta skrip menjalankan kelompok kontrol acak sekaligus, lalu menampilkan “tingkat kecocokan data asli” dan “tingkat kecocokan data acak”.
- Jalankan skrip secara lokal. Model hanya bertugas menulis kode, bukan melaporkan hasil.
- Jika hasilnya signifikan, minta model unggulan menulis skrip yang lebih ketat untuk memulihkan status atau melakukan pencocokan.
Contoh: Mereproduksi tanda tangan statistik seperti “semua bit teratas bernilai 0”
Skrip di bawah ini menunjukkan prinsip di balik tanda tangan pada kasus tersebut. lrand48 mengembalikan 31 bit teratas dari status 48 bit. Jadi, setelah dimasukkan ke dalam kata 32 bit, bit tertingginya pasti 0. Sementara itu, pada data acak sungguhan, peluang bit tertinggi bernilai 0 hanya setengah.
import os

def lrand48_stream(seed32, n):
    x = (seed32 << 16) | 0x330E          # srand48 初始化:低 16 位固定为 0x330E
    out = []
    for _ in range(n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        out.append(x >> 17)               # lrand48 只返回高 31 位
    return out

def top_bit_zero_ratio(words):
    return sum(1 for w in words if w >> 31 == 0) / len(words)

lr = lrand48_stream(870000000, 20)        # 1997 年前后的某个 Unix 时间戳
rnd = [int.from_bytes(os.urandom(4), "big") for _ in range(20)]
print("lrand48 最高位为 0 的比例:", top_bit_zero_ratio(lr))   # 恒为 1.0
print("真随机  最高位为 0 的比例:", top_bit_zero_ratio(rnd))  # 约 0.5 上下波动
Memverifikasi kesimpulan akhir dengan kode resmi
Halaman riset Anthropic menyertakan kode reproduksi yang dirilis dengan lisensi CC0. Menurut petunjuk resminya, parameter berikut seharusnya menghasilkan seed dalam standar P-256:
from datetime import datetime, timezone

def unix(when):
    return int(datetime.fromisoformat(when).replace(tzinfo=timezone.utc).timestamp())

def candidate(t, n, per, shift, width):
    x, out = (t << 16) | 0x330E, ""
    for i in range(per * n):
        x = (0x5DEECE66D * x + 0xB) % 2**48
        if i >= per * (n - 1):
            out += "%0*X" % (width, x >> shift)
    return out

seed = candidate(unix("1997-08-16 01:52:34"), 1842, 20, 40, 2)
print(seed)
print("与标准一致:", seed == "C49D360886E704936A6678E1139D26B7819F7E90")
Arti skrip ini: lrand48 diinisialisasi menggunakan stempel waktu. Setiap 20 keluaran digabungkan menjadi satu kandidat seed sepanjang 20 byte, dan kandidat ke-1842 adalah seed dalam standar tersebut. Seluruh validasi ini bisa selesai dalam waktu kurang dari satu detik di laptop biasa. “Biaya mengajukan hipotesis tinggi, tetapi biaya memvalidasi kesimpulan rendah” adalah struktur yang paling ideal untuk tugas riset semacam ini.
Cara Menggunakan AI Agent untuk Riset 3: Memasangkan Penilai Otomatis dan Mengulang Proses hingga Skor Stabil
Dua cara sebelumnya mengandalkan manusia untuk menilai hasil, sedangkan cara ketiga menyerahkan penilaian kepada program. Anda menulis penilai, lalu model mengajukan solusi pada setiap putaran. Penilai mengembalikan skor dan sampel yang gagal, lalu model memperbaiki solusinya berdasarkan informasi tersebut hingga skornya tidak lagi meningkat. Cara ini cocok untuk tugas yang memiliki metrik evaluasi jelas, seperti aturan ekstraksi data, pencocokan bentuk fungsi, dan pencarian parameter eksperimen.
Langkah-langkah
- Tulis penilai terlebih dahulu, baru pilih model: penilai harus berupa program deterministik dan tidak boleh mengandalkan model untuk menilai dirinya sendiri.
- Pisahkan data pengembangan dan data tahan uji: gunakan hanya data pengembangan sebagai umpan balik, lalu gunakan data tahan uji untuk memeriksa apakah model mengalami overfitting.
- Batasi format keluaran: minta model mengirimkan data seperti JSON atau ekspresi reguler, alih-alih langsung menjalankan kode buatan model. Jika kode harus dijalankan, gunakan sandbox.
- Tentukan kondisi berhenti: hentikan proses jika salah satu kondisi berikut terpenuhi: skor sempurna, tidak ada peningkatan selama 2 putaran berturut-turut, atau jumlah putaran maksimum tercapai.
- Jalankan siklusnya terlebih dahulu dengan model yang lebih murah. Setelah berfungsi, ganti dengan model unggulan untuk eksperimen resmi.
Contoh: Mengiterasi ekspresi reguler untuk mengekstrak parameter dari catatan eksperimen
import json, re
from research_client import chat, report

DEV = [
    ("样品A在 350 ℃ 退火 2 小时后测得电导率 4.1 S/m。", {"temp_c": 350, "hours": 2, "cond": 4.1}),
    ("退火温度 420°C,保温 1.5 h,电导率为 12.3 S/m。", {"temp_c": 420, "hours": 1.5, "cond": 12.3}),
    ("B组:300摄氏度下处理 3 小时,σ=0.85 S/m。", {"temp_c": 300, "hours": 3, "cond": 0.85}),
    ("在450 ℃条件下退火4h,测得电导率 20 S/m。", {"temp_c": 450, "hours": 4, "cond": 20}),
]
HOLDOUT = [
    ("样品E 380 ℃ 退火 2.5 小时,电导率 7.6 S/m。", {"temp_c": 380, "hours": 2.5, "cond": 7.6}),
    ("C组于 500°C 保温 0.5 h,σ = 33.1 S/m。", {"temp_c": 500, "hours": 0.5, "cond": 33.1}),
]
FIELDS = ["temp_c", "hours", "cond"]

def score(patterns, data):
    hit, fails = 0, []
    for idx, (text, label) in enumerate(data):
        for f in FIELDS:
            try:
                m = re.search(patterns.get(f, "(?!)"), text)
                ok = m is not None and abs(float(m.group(1)) - label[f]) < 1e-9
            except (re.error, IndexError, ValueError, TypeError):
                ok = False
            hit += ok
            if not ok:
                fails.append(f"样本{idx} 字段{f} 抽取失败:{text}")
    return hit / (len(data) * len(FIELDS)), fails

def parse_json(text):
    return json.loads(text[text.find("{"): text.rfind("}") + 1])

messages = [{"role": "user", "content":
    "为下列实验记录写 Python 正则,抽取 temp_c、hours、cond 三个字段,每个正则恰好一个捕获组,捕获纯数字。"
    "只输出 JSON,例如 {\"temp_c\": \"...\", \"hours\": \"...\", \"cond\": \"...\"},注意转义反斜杠。\n"
    + "\n".join(t for t, _ in DEV)}]

best, stale, patterns = -1.0, 0, {}
for rnd in range(6):
    reply = chat(messages, stage="draft", max_tokens=800)   # 跑通后把 stage 改为 "verify"
    try:
        patterns = parse_json(reply)
        s, fails = score(patterns, DEV)
    except (ValueError, json.JSONDecodeError):
        s, fails = 0.0, ["输出不是合法 JSON"]
    print(f"第 {rnd + 1} 轮 开发集得分 {s:.2f}")
    if s >= 1.0:
        break
    stale = stale + 1 if s <= best else 0
    best = max(best, s)
    if stale >= 2:
        break
    messages += [{"role": "assistant", "content": reply},
                 {"role": "user", "content": "以下抽取失败,请修改正则后重新输出完整 JSON:\n" + "\n".join(fails)}]

print("留出集得分:", score(patterns, HOLDOUT)[0])
report()
Hal yang perlu diperhatikan: jika model mendapat skor sempurna pada data pengembangan, tetapi skornya turun jauh pada data tahan uji, berarti model sedang “menghafal jawaban”. Dalam situasi ini, sebaiknya tambahkan data ke kumpulan pengembangan, bukan melanjutkan iterasi.
Perbandingan 3 Cara Menggunakan AI Agent untuk Riset
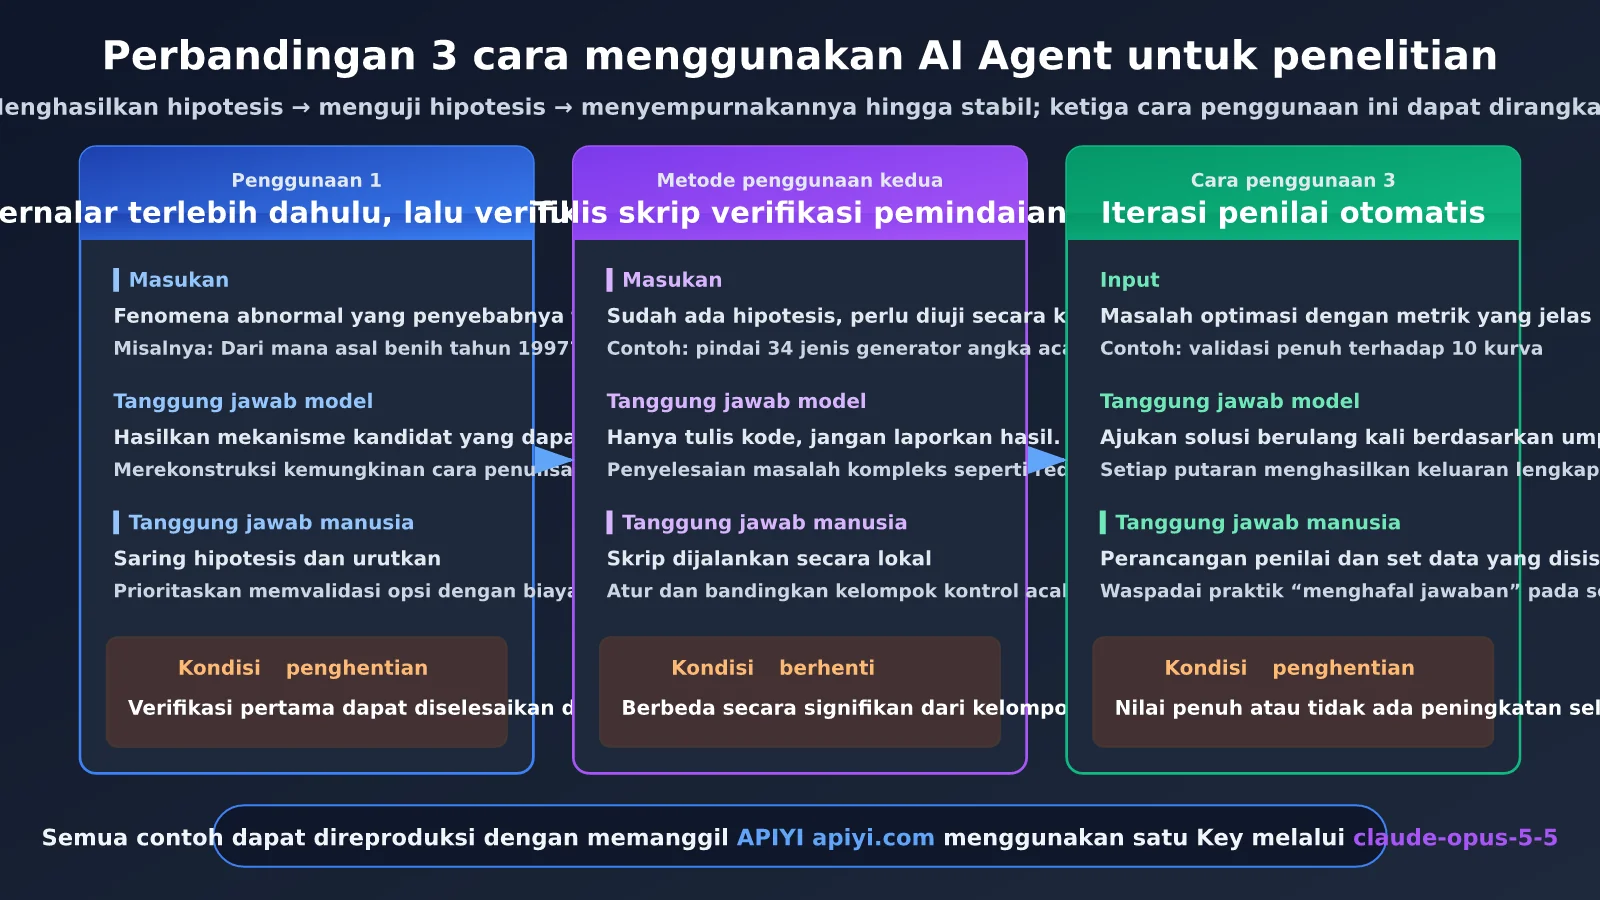
| Aspek | Cara 1: Menalar mekanisme | Cara 2: Menulis skrip pemindaian dan validasi | Cara 3: Iterasi dengan penilai otomatis |
|---|---|---|---|
| Tahap kasus yang terkait | Menalar cara program ditulis pada 1997 | Memindai 34 generator dan menemukan tanda tangan statistik | Memvalidasi seluruh 10 kurva setelah pemulihan status |
| Cocok untuk tugas | Anomali yang penyebabnya belum jelas, dugaan hasil rekayasa balik | Hipotesis sudah ada dan perlu diuji secara kuantitatif | Masalah optimasi dengan metrik yang jelas |
| Tugas model | Menghasilkan kandidat mekanisme yang bisa dibantah | Menulis kode, bukan melaporkan hasil | Mengajukan solusi berulang kali |
| Tugas manusia | Menyeleksi dan mengurutkan hipotesis | Menjalankan secara lokal dan memeriksa kelompok kontrol | Merancang penilai dan data tahan uji |
| Kapan model unggulan digunakan | Penalaran dan pengurutan akhir | Menulis pemecah masalah kompleks, seperti LLL | Putaran eksperimen resmi |
| Kondisi berhenti | Validasi pertama bisa diselesaikan dalam 1 jam | Perbedaan dengan kelompok kontrol acak signifikan | Skor sempurna atau tidak ada peningkatan selama 2 putaran |
| Cara pemanggilan | Antarmuka terpadu APIYI apiyi.com | Sama seperti di sebelah kiri | Sama seperti di sebelah kiri |
Ketiga cara ini bisa dirangkai: cara pertama menghasilkan hipotesis, cara kedua mengujinya, dan cara ketiga menyempurnakan solusi yang sudah teruji hingga stabil.
Mengapa tugas riset seperti ini harus menggunakan model flagship Claude
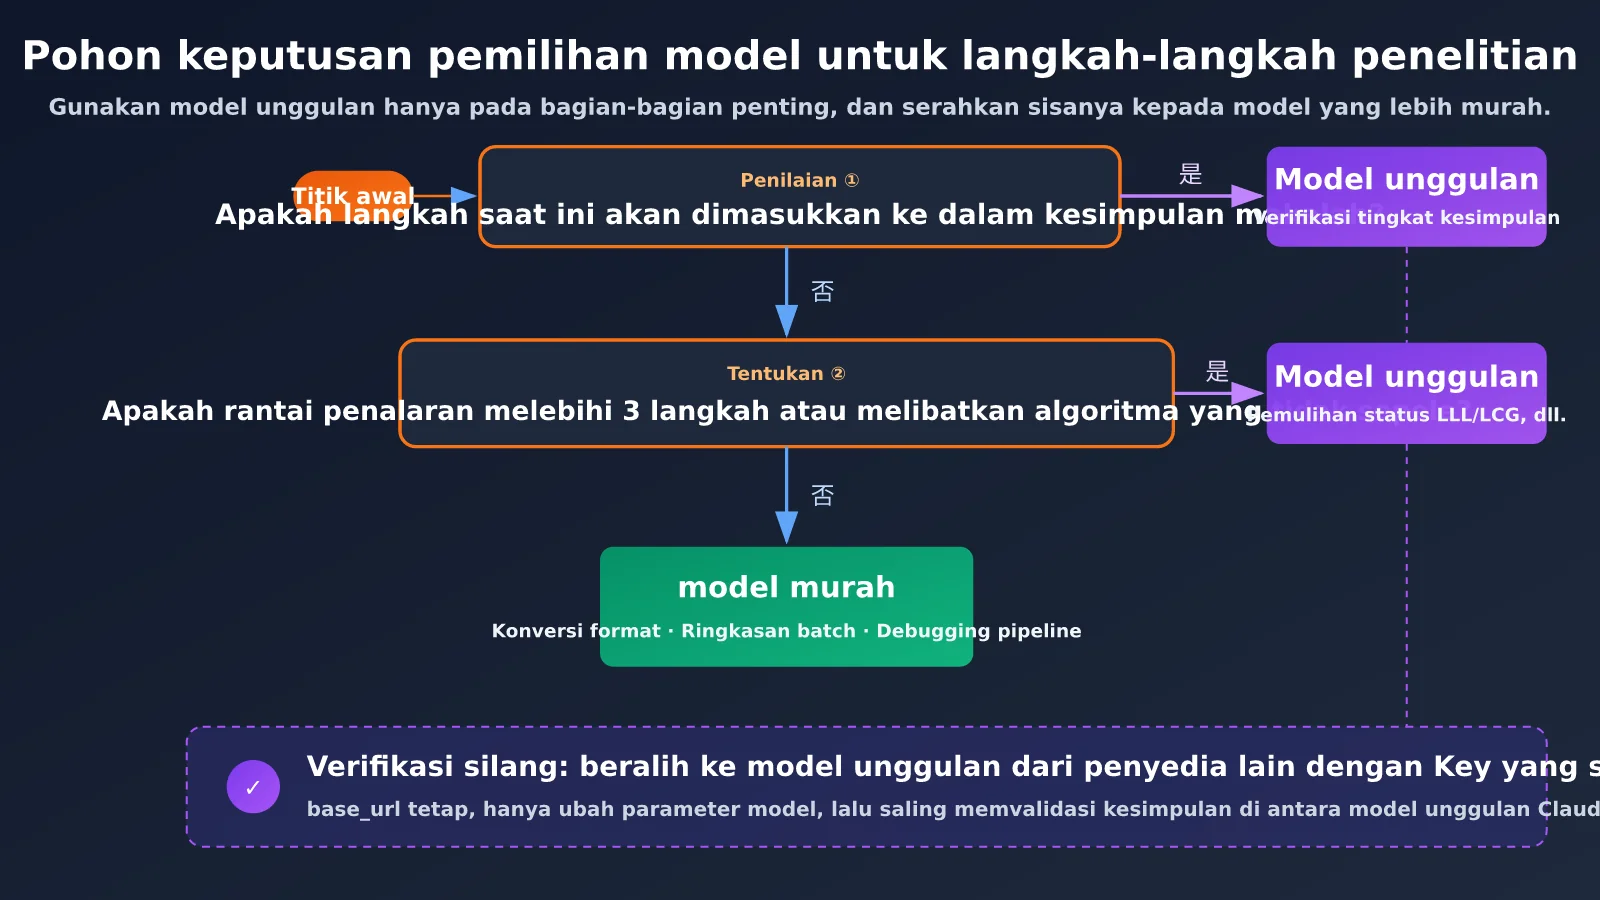
Tidak semua tahap riset membutuhkan model flagship. Namun, ada jenis tugas yang hampir mustahil diselesaikan jika menggunakan model yang lebih kecil. Gunakan tabel berikut sebagai panduan:
| Kriteria | Model flagship disarankan jika | Alasannya |
|---|---|---|
| Membutuhkan asosiasi lintas bidang | Misalnya, menghubungkan “seed kurva” dengan “detail implementasi library C pada era 1990-an” | Model kecil lebih mudah terpaku pada permukaan masalah, misalnya terus menebak frasa |
| Rantai penalaran lebih dari 3 langkah dan setiap langkah bergantung pada langkah sebelumnya | Misalnya, menurunkan hipotesis → memindai → membuat signature → memulihkan state | Jika satu langkah di tengah keliru, langkah-langkah berikutnya bisa menyimpang |
| Membutuhkan kemampuan untuk mempertanyakan diri sendiri | Misalnya, mempertanyakan “Apakah saya sedang menguji lingkungan?” | Model flagship lebih mungkin secara proaktif mencari contoh tandingan |
| Melibatkan algoritma yang tidak sederhana | Misalnya, reduksi basis kisi LLL atau pemulihan state LCG yang terpotong | Kebenaran kode menentukan langsung apakah validasi berhasil |
| Kesimpulan akan dimasukkan ke dalam makalah atau menentukan alokasi sumber daya eksperimen | Semua kesimpulan yang dipublikasikan | Biaya kesalahan jauh lebih besar daripada biaya pemanggilan model |
Sebaliknya, pekerjaan seperti konversi format, pembuatan ringkasan massal, dan debugging pipeline penilaian cukup menggunakan model yang lebih murah. Kunci pengendalian biaya bukanlah mengurangi penggunaan model flagship, melainkan memakainya hanya untuk hal-hal yang tercantum di atas.
FAQ
T1: Apakah Claude berhasil membobol kurva eliptik NIST?
Tidak. Claude merekonstruksi proses pembuatan seed yang berasal dari `lrand48` yang diinisialisasi dengan timestamp. Ini bukan metode serangan baru dan tidak menunjukkan adanya kerentanan, jadi pengguna tidak perlu mengubah konfigurasi atau bermigrasi. Kesimpulan ini justru menunjukkan bahwa seed tersebut tidak dipilih secara manual.
T2: Apa bedanya metode ini dengan pencarian brute force tradisional?
Pencarian brute force menguji semua kemungkinan dalam ruang asumsi yang sudah ditetapkan. Claude terlebih dahulu mengganti ruang asumsinya: dari “kalimat mana yang di-hash” menjadi “generator angka acak jenis apa yang digunakan”, baru kemudian melakukan pencarian menyeluruh dalam lingkup terbatas (2^17 bit tersembunyi). Langkah pertama inilah yang benar-benar menentukan keberhasilan.
T3: Kapan riset ini diumumkan? Apa saja yang belum terpecahkan?
Halaman riset Anthropic dan unggahan @AnthropicAI sama-sama diterbitkan pada 17 Oktober 2026. Seed B-163 masih belum berhasil dipecahkan, cara menghasilkan titik dasar G untuk P-224 hingga P-521 juga belum diketahui. Selain itu, ada sejumlah kecil kurva kandidat yang dilewati tanpa diketahui alasannya.
T4: Skenario riset apa yang cocok untuk menerapkan 3 cara ini?
– **Menelusuri penyebab anomali eksperimen**: Jika data instrumen menunjukkan artefak periodik, gunakan cara pertama untuk menyimpulkan kemungkinan implementasi perangkat lunak akuisisi data.
– **Mereproduksi makalah lama**: Jika parameternya tidak dicantumkan, gunakan cara kedua untuk memindai kombinasi parameter kandidat.
– **Mengekstrak dan membersihkan data**: Gunakan cara ketiga bersama penilai untuk menyempurnakan aturan hingga stabil.
T5: Bagaimana cara memakai satu Key untuk memanggil beberapa model flagship sekaligus demi validasi silang?
Daftar dan buat Key di APIYI apiyi.com, lalu tetapkan `base_url` ke `https://api.apiyi.com/v1`. Anda hanya perlu mengubah parameter `model` untuk beralih antara claude-opus-5-5 dan model flagship dari keluarga GPT maupun Gemini. Gunakan nama model yang tercantum di konsol.
T6: Apa saja batasan yang diketahui pada AI Agent untuk riset?
– Model bisa mengarang mekanisme yang terdengar masuk akal, jadi setiap kesimpulan harus disertai skrip validasi yang bisa dijalankan secara lokal.
– Iterasi penilai mudah mengalami overfitting pada set pengembangan, jadi Anda harus menyimpan set data yang tidak digunakan dalam proses pengembangan.
– Biaya pemanggilan model berulang bisa menumpuk. Sebaiknya gunakan model yang lebih murah untuk menguji alur kerja terlebih dahulu, sambil mencatat usage. Informasi penagihan bisa dilihat di konsol APIYI apiyi.com.
Poin Penting AI Agent untuk Riset
- Batas kesimpulan: Claude berhasil mengungkap asal-usul seed, bukan menemukan celah kriptografi. Ini justru meningkatkan keyakinan terhadap keamanan kurva tersebut.
- Langkah penting: Mengganti ruang asumsi lebih efektif daripada menambah daya komputasi dalam ruang asumsi lama.
- Utamakan verifikasi: Model bertugas menulis skrip, manusia yang menjalankannya. Selalu bandingkan hasilnya dengan baseline acak.
- Siklus penilaian: Gunakan penilaian deterministik dan set validasi terpisah. Hentikan iterasi saat skor sudah konvergen.
- Pembagian peran model: Gunakan model yang lebih murah untuk menguji alur kerja, dan model unggulan hanya untuk analisis serta verifikasi penting.
- Cara memulai: Gunakan satu kunci melalui APIYI apiyi.com untuk memanggil claude-opus-5-5, lalu beralih ke model lain untuk melakukan verifikasi silang.
Kesimpulan
Keberhasilan Claude mengungkap misteri seed kurva eliptik NIST memberi tiga pelajaran utama bagi peneliti:
- Analisis mekanismenya terlebih dahulu: Mulailah dengan mencari tahu bagaimana data dihasilkan, bukan langsung menebak jawabannya.
- Buktikan dengan skrip: Setiap asumsi harus dilengkapi kode verifikasi yang dapat dijalankan dan pembanding acak.
- Bangun siklus penilaian: Serahkan penilaian kepada program deterministik, lakukan iterasi hingga konvergen, lalu gunakan set validasi terpisah untuk memeriksa overfitting.
Pengendalian biaya tetap menjadi prioritas: gunakan model yang lebih murah untuk menjalankan alur kerja terlebih dahulu, lalu beralih ke model unggulan untuk langkah yang berkaitan dengan kesimpulan penelitian dan algoritma kompleks. Sebaiknya jalankan seluruh kode dalam artikel ini melalui APIYI apiyi.com. Mulailah dengan kode replikasi resmi untuk mengonfirmasi seed P-256, lalu terapkan tiga cara penggunaan tersebut pada riset Anda sendiri.
Bacaan Lanjutan
- 📘 Cara Menggunakan OpenAI SDK untuk Memanggil Model Seri Claude – Pahami perbedaan parameter pada antarmuka yang kompatibel
- 📊 Praktik Mengendalikan Biaya Pemanggilan API Model Bahasa Besar – Kuasai statistik penggunaan dan peringatan anggaran
- 🚀 Membangun Alur Kerja Validasi Silang Antar-Model – Biarkan berbagai model unggulan saling memeriksa kesimpulan
📚 Referensi
- Halaman Riset Anthropic Frontier Red Team: Riset tentang asal-usul seed kurva ECDSA
- Tautan:
www.anthropic.com/research/ecdsa-curve-origins -
Keterangan: Sumber primer yang mencakup metode lengkap, pertanyaan yang belum terjawab, dan kode replikasi berlisensi CC0
-
Unggahan resmi @AnthropicAI di X (2026-10-17): “It is just timestamps.”
- Tautan:
x.com/AnthropicAI -
Keterangan: Pernyataan resmi yang dapat menjadi titik awal untuk melihat diskusi komunitas
-
Pusat Dokumentasi APIYI: Panduan menggunakan antarmuka yang kompatibel dengan OpenAI
- Tautan:
docs.apiyi.com - Keterangan: Konfigurasi base_url, daftar model, dan informasi biaya
Penulis: Tim Teknologi APIYI
Diskusi teknis: Silakan bagikan di kolom komentar bagaimana Anda menggunakan AI Agent dalam riset. Informasi integrasi lainnya dapat ditemukan di pusat dokumentasi APIYI, docs.apiyi.com.