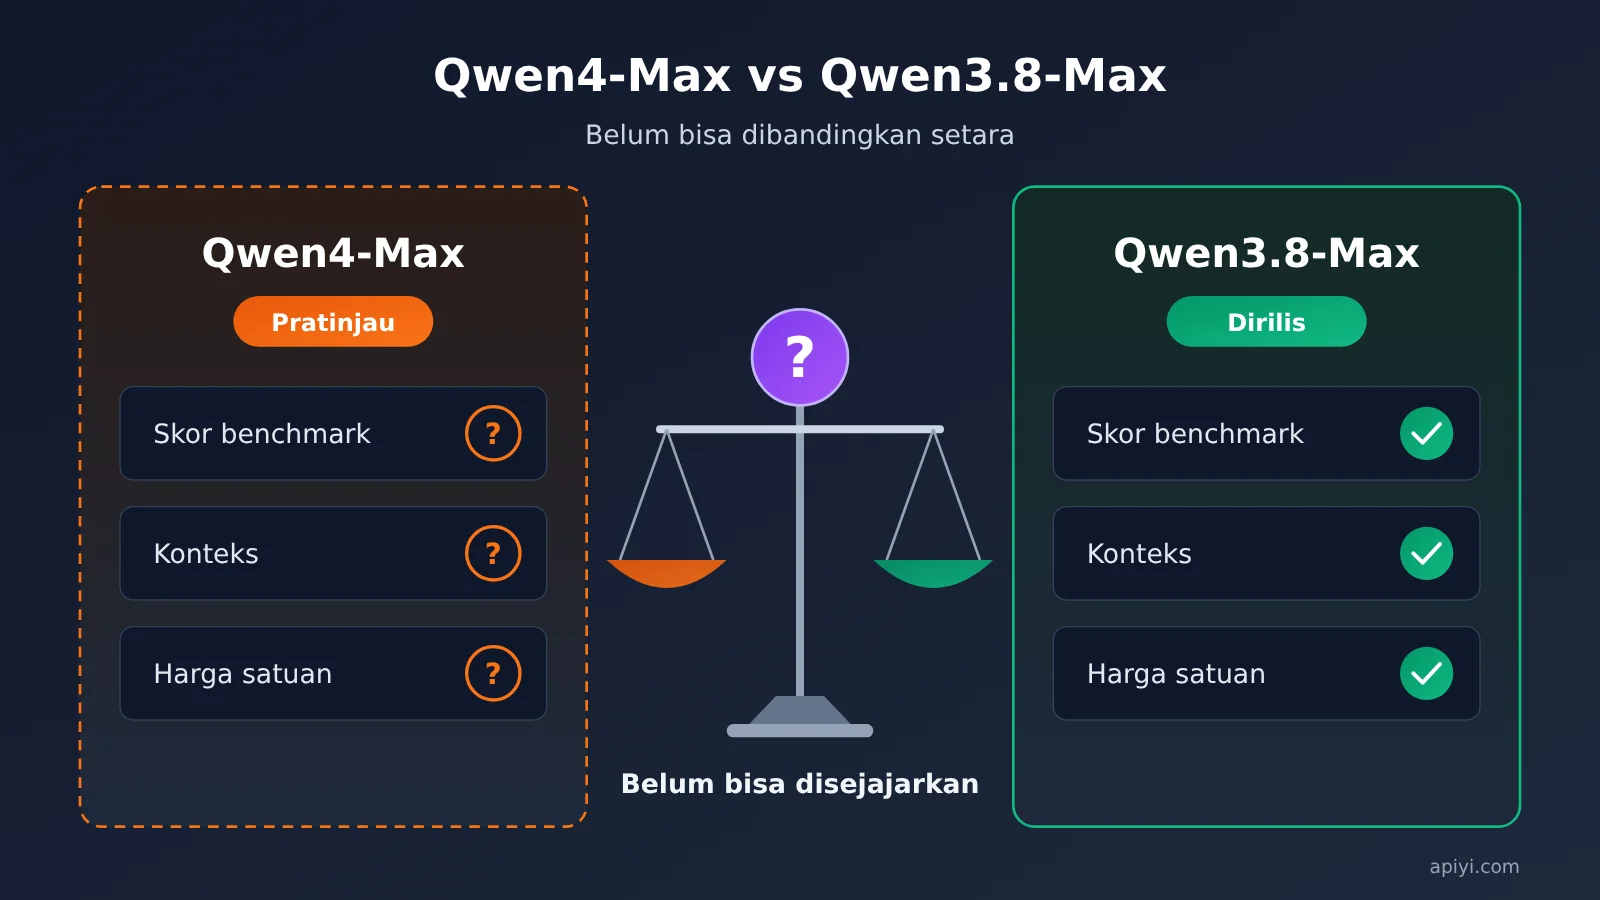
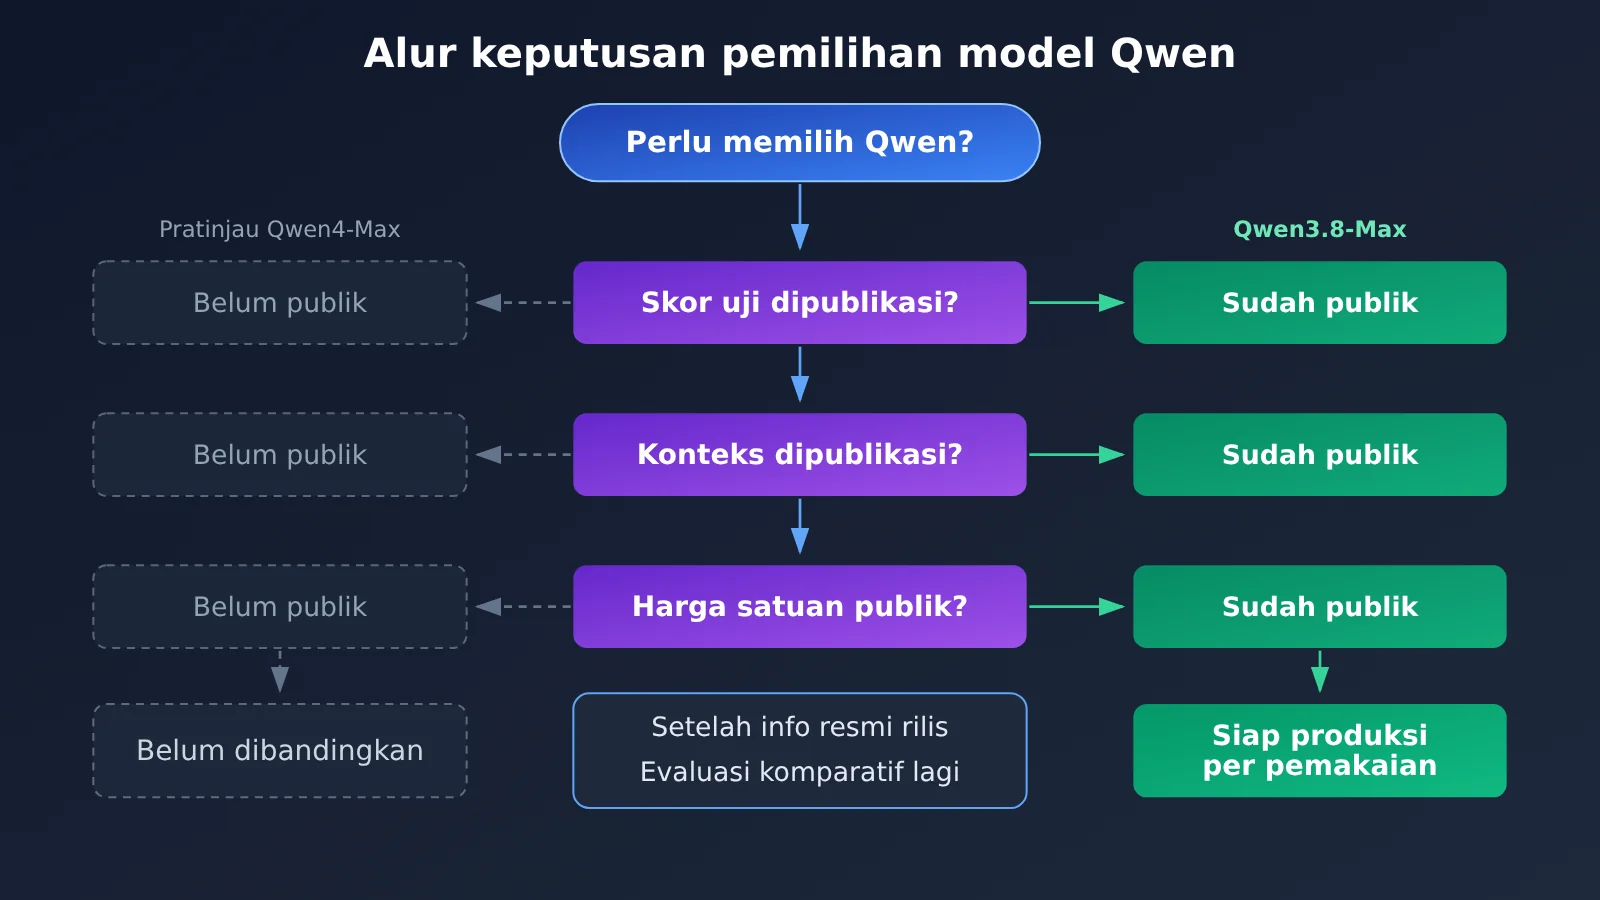
Catatan penulis: Qwen4-Max masih berstatus pratinjau dan belum punya skor benchmark publik, panjang jendela konteks, maupun harga per token. Ketiga hal ini belum bisa dibandingkan langsung dengan Qwen3.8-Max. Saat ini model yang bisa dipanggil dengan sistem bayar sesuai pemakaian tetaplah qwen3.8-max.
Begitu pratinjau Qwen4-Max muncul, pertanyaan pertama dari developer yang sedang memakai Qwen biasanya: perlu pindah atau tidak? Seberapa jauh lebih kuat dibanding Qwen3.8-Max? Seberapa lebih mahal? Untuk sekarang, pertanyaan-pertanyaan ini belum punya jawaban yang bisa dibandingkan secara setara, karena pada tahap pratinjau tiga informasi publik yang diperlukan untuk membandingkan belum tersedia.
Ini bukan untuk meremehkan Qwen4-Max. Kami tidak menilai kuat-lemahnya kemampuan model ini, hanya menyampaikan satu fakta: per 2026-11-12, pratinjau Qwen4-Max belum punya skor benchmark publik, panjang jendela konteks, maupun harga per token, sedangkan Qwen3.8-Max sudah dirilis dan bisa dipanggil dengan sistem bayar sesuai pemakaian. Menurut daftar model APIYI apiyi.com per 2026-11-12, model yang bisa langsung diintegrasikan saat ini adalah qwen3.8-max.
Inti pembahasan: dalam 3 menit, Anda akan tahu bagian mana dari pratinjau Qwen4-Max dan Qwen3.8-Max yang sekarang belum bisa dibandingkan, serta bagaimana sebaiknya mengatur proyek Anda sampai informasi resminya diumumkan.
Ringkasan Informasi Inti Qwen4-Max dan Qwen3.8
Pertama, mari kita kumpulkan informasi yang saat ini bisa dipastikan dari kedua model. Tabel di bawah hanya memuat hal-hal yang didukung oleh sumber rujukan. Item yang belum dipublikasikan langsung ditandai “Belum dipublikasikan”, tanpa tebak-tebakan.
| Item informasi | Qwen4-Max (pratinjau) | Qwen3.8-Max |
|---|---|---|
| Status rilis | Tahap pratinjau | Model yang sudah dirilis |
| Skor benchmark publik | Belum dipublikasikan | Model sudah dirilis, materi resmi bisa dirujuk |
| Panjang jendela konteks | Belum dipublikasikan | Mengacu pada dokumentasi resmi dan keterangan model |
| Harga per token | Belum dipublikasikan | Input $1,65 / output $4,95 / baca cache $0,20625 (per 1M token) |
| Pemanggilan berbasis pemakaian | Belum ada di daftar model per 2026-11-12 | Bisa dipanggil, ID model qwen3.8-max |
| Platform yang tersedia | Mengacu pada pengumuman resmi berikutnya | APIYI dan platform lainnya |
Dalam tabel, “Belum dipublikasikan” muncul tiga kali, yaitu pada skor benchmark, jendela konteks, dan harga. Ketiganya justru dimensi yang paling sering dipakai saat memilih model. Kalau salah satu saja hilang, perbandingan antarmodel kehilangan pijakan. Sudah ada artikel sebelumnya yang membahas soal pembukaan akses pratinjau, jadi artikel ini hanya membahas mengapa ketiga hal tersebut tidak bisa dibandingkan secara dipaksakan.
Dampak dari tiga informasi yang belum ada pada pratinjau Qwen4-Max
Skor benchmark menentukan penilaian kemampuan. Tanpa skor benchmark resmi yang dipublikasikan, tidak ada tolok ukur yang seragam untuk menilai apakah Qwen4-Max lebih maju atau mundur dibanding Qwen3.8-Max dalam tugas penalaran, kode, maupun teks panjang. Tangkapan layar komunitas yang berserakan atau kesan dari beberapa kali percobaan percakapan memakai set uji, petunjuk, dan parameter sampling yang berbeda-beda, sehingga tidak bisa menggantikan skor benchmark resmi.
Panjang jendela konteks menentukan rancangan arsitektur. Ukuran chunk pada RAG, strategi pemotongan riwayat percakapan, dan keputusan apakah dokumen panjang dimasukkan sekaligus atau diproses per bagian, semuanya bergantung pada batas konteks yang pasti. Selama angka ini belum jelas, kita tidak bisa menilai apakah setelah migrasi logika pemotongan yang ada sekarang bisa dihilangkan, dan tidak bisa memperkirakan apakah akan muncul error karena input terlalu panjang.
Harga per token menentukan model biaya. Anggaran, penetapan harga, dan strategi pembatasan laju semuanya dibangun di atas harga satuan. Meski di tahap pratinjau modelnya sudah bisa dicoba, itu belum berarti sudah ada harga yang layak dimasukkan ke tabel biaya. Membandingkan harga yang belum pasti dengan harga qwen3.8-max saat ini tidak akan menghasilkan kesimpulan yang bermakna.
Harga dan Cara Akses Qwen3.8-Max yang Bisa Dipakai Berbasis Pemakaian Saat Ini
Karena syarat untuk melakukan perbandingan belum terpenuhi, proyek yang sedang berjalan sebaiknya mengacu pada model yang sudah dirilis. Tabel berikut berisi harga qwen3.8-max dari daftar model per 2026-11-12, dengan satuan per 1M token.
| Komponen biaya | Harga satuan (per 1M token) | Keterangan |
|---|---|---|
| Input | $1,65 | Bagian petunjuk yang tidak kena cache |
| Output | $4,95 | Konten yang dihasilkan model, harganya 3 kali harga input |
| Baca cache | $0,20625 | Bagian input yang kena cache, harganya 1/8 dari harga input |
Dari strukturnya, harga output adalah 3 kali harga input, sedangkan baca cache hanya 12,5% dari harga input. Jadi, membatasi panjang output dan meningkatkan rasio cache hit adalah dua cara paling langsung untuk menekan biaya qwen3.8-max. Pada skenario dengan petunjuk sistem yang panjang atau awalan percakapan multi-giliran yang stabil, keuntungan dari cache akan terasa lebih besar.
Contoh Estimasi Biaya Qwen3.8-Max
Dengan harga satuan di atas, kita bisa menghitung biaya beberapa permintaan yang umum. Semua angka di bawah dihitung langsung dari harga publik, sehingga mudah diterapkan ke volume bisnis Anda sendiri.
| Skenario | Token input | Di antaranya kena cache | Token output | Biaya per permintaan |
|---|---|---|---|---|
| Satu permintaan biasa | 10.000 | 0 | 2.000 | $0,0264 |
| Permintaan yang sama, awalan kena cache | 10.000 | 8.000 | 2.000 | $0,01485 |
| Pemrosesan batch 1M input | 1.000.000 | 0 | 200.000 | $2,64 |
Baris kedua punya total input dan output yang sama dengan baris pertama. Bedanya, 8.000 token input kena cache, sehingga biaya per permintaan turun dari $0,0264 menjadi sekitar $0,0149, atau turun lebih dari empat puluh persen. Perhitungan seperti ini belum bisa dilakukan untuk pratinjau Qwen4-Max, karena harga satuannya belum diumumkan.
Cara Mengakses qwen3.8-max
APIYI menyediakan antarmuka yang kompatibel dengan OpenAI, jadi Anda bisa langsung terhubung memakai OpenAI SDK atau klien kompatibel lainnya. Anda hanya perlu mengubah tiga parameter:
base_url:https://api.apiyi.com/v1(memakai antarmuka terpadu APIYI)api_key: API Key yang dibuat di konsol APIYImodel:qwen3.8-max
Cara pemanggilannya sama dengan Chat Completions. Cukup susun array messages berdasarkan urutan peran system, user, dan assistant. Kalau proyek Anda sebelumnya sudah terhubung ke endpoint yang kompatibel dengan OpenAI, biasanya Anda hanya perlu mengganti base_url dan ID model, tanpa mengubah kode bisnisnya.
🚀 Mulai cepat: Daftar di APIYI (apiyi.com) untuk mendapatkan kuota uji coba gratis. Jalankan dulu petunjuk bisnis Anda dengan
qwen3.8-max, lalu catat input, output, dan rasio cache hit yang sebenarnya. Dengan begitu, saat Qwen4-Max dibuka secara resmi, Anda sudah punya data pembanding.
Dampak Pratinjau Qwen4-Max terhadap Proyek Qwen yang Sudah Ada
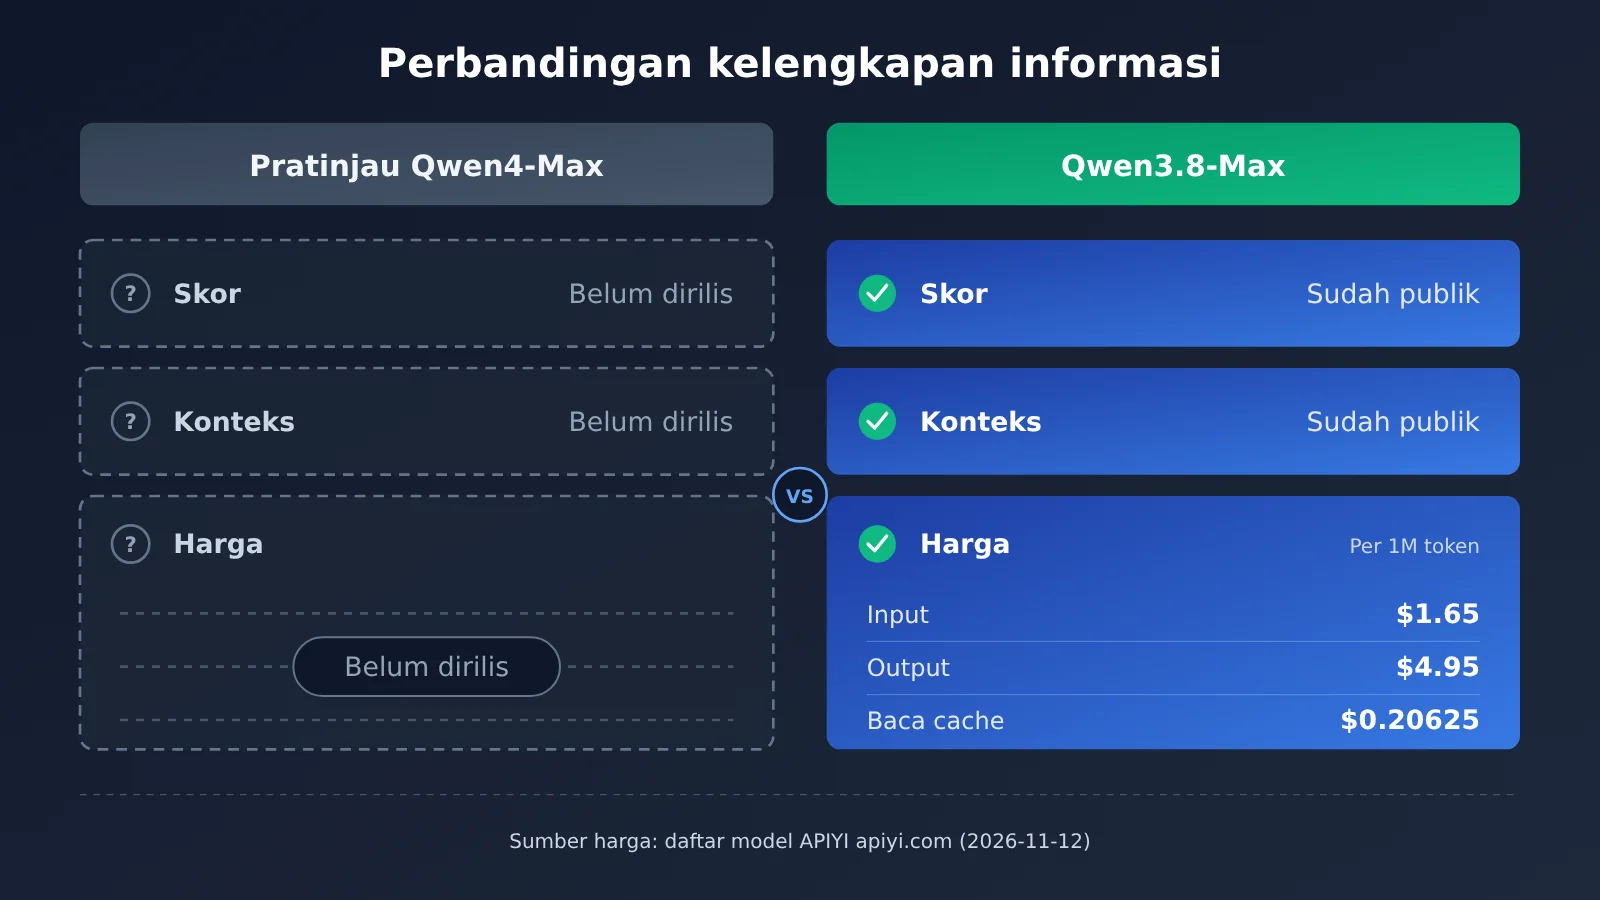
Gambar di atas menyandingkan kelengkapan informasi kedua sisi: di satu sisi ada tiga slot kosong yang belum diumumkan, di sisi lain ada data yang bisa langsung dicek. Dalam kondisi seperti ini, perbandingan apa pun soal “seberapa lebih kuat” atau “seberapa lebih mahal” tidak punya dasar. Data harga bisa Anda verifikasi di daftar model APIYI apiyi.com.
Dampak bagi Developer yang Sedang Memakai Qwen
- Lingkungan produksi tidak perlu diubah: Pratinjau Qwen4-Max tidak mengubah ketersediaan dan harga qwen3.8-max, jadi pemanggilan yang sudah berjalan tetap seperti biasa.
- Persiapan evaluasi bisa dimulai lebih dulu: Susun satu set petunjuk evaluasi yang mewakili kebutuhan bisnis Anda beserta standar penilaiannya, sehingga begitu informasi resmi keluar, Anda bisa langsung membandingkan kedua model.
- Anggaran biaya tetap mengacu pada qwen3.8-max: Di tahap pratinjau belum ada harga satuan, jadi sebaiknya jangan memasukkan Qwen4-Max ke anggaran atau penawaran tahap berikutnya.
- Tunda dulu perombakan yang terkait jendela konteks: Sebelum panjang konteks Qwen4-Max diumumkan, tidak disarankan mengubah logika chunking atau pemotongan teks demi model ini.
Saran Langkah untuk Tiap Peran
| Peran | Yang bisa dilakukan sekarang | Yang dilakukan setelah informasi resmi keluar |
|---|---|---|
| Developer aplikasi | Tetap pakai qwen3.8-max, kumpulkan set evaluasi bisnis |
Bandingkan kedua model dengan set evaluasi yang sama |
| Penanggung jawab arsitektur | Rancang strategi jendela konteks sesuai batas aktual qwen3.8-max | Nilai apakah chunking bisa disederhanakan berdasarkan panjang konteks Qwen4-Max |
| Penanggung jawab biaya | Susun anggaran dengan input $1,65 dan output $4,95 per 1M token | Hitung ulang biaya migrasi setelah harga satuan Qwen4-Max keluar |
| Product manager | Deskripsi ke publik tetap berpatokan pada kemampuan model yang sudah dirilis | Putuskan perlu tidaknya mengumumkan peningkatan berdasarkan skor benchmark publik |
Pelajaran untuk Proses Pemilihan Model
Masalah yang paling mudah muncul dari versi pratinjau adalah menganggap “terlihat lebih baru” sama dengan “sudah lebih baik”. Proses pemilihan yang rapi setidaknya butuh tiga jenis dasar publik: kemampuan (skor benchmark), kapasitas (jendela konteks), dan biaya (harga satuan). Sebelum ketiganya lengkap, model baru cocok masuk daftar pantauan, belum cocok masuk rencana produksi.
Mengelola pemanggilan model lewat antarmuka terpadu juga punya satu keuntungan lain: ketika Qwen4-Max nanti dibuka untuk pemakaian berbayar per penggunaan, Anda cukup mengganti parameter model untuk melakukan A/B testing, tanpa perlu mengintegrasikan SDK baru dari awal.
💡 Saran pemilihan: Sebelum tiga informasi kunci Qwen4-Max diumumkan, sebaiknya jadikan qwen3.8-max sebagai andalan produksi. Dengan akses lewat antarmuka terpadu APIYI apiyi.com, Anda bisa berpindah dan membandingkan model baru dengan cepat di kode yang sama setelah model tersebut rilis.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Apakah Qwen4-Max versi pratinjau sudah bisa dibandingkan dengan Qwen3.8-Max?
Belum, setidaknya untuk tiga hal: skor benchmark, panjang jendela konteks, dan harga per token. Qwen4-Max masih berstatus pratinjau, dan ketiga data itu belum dipublikasikan, jadi belum ada tolok ukur yang bisa dipakai bersama. Yang bisa dipastikan hanya status rilisnya: Qwen3.8-Max sudah dirilis dan bisa dipanggil dengan sistem bayar sesuai pemakaian, sedangkan Qwen4-Max masih dalam tahap pratinjau.
Q2: Apakah Qwen4-Max sudah mengungguli Qwen3.8-Max secara menyeluruh?
Sejauh ini belum ada data publik yang mendukung kesimpulan itu. Nomor versi yang lebih besar tidak otomatis berarti model lebih kuat di semua tugas, dan tidak berarti harganya lebih cocok juga. Soal apakah model ini benar-benar lebih unggul dan di tugas mana saja, sebaiknya tunggu sampai skor benchmark resmi dipublikasikan. Setelah itu, lebih baik lagi kalau Anda memverifikasinya dengan dataset evaluasi bisnis Anda sendiri.
Q3: Berapa harga pemanggilan Qwen3.8-Max saat ini?
Berdasarkan daftar model per 2026-11-12, qwen3.8-max dihargai per 1M token: input $1,65, output $4,95, dan baca cache $0,20625. Harga baca cache hanya 1/8 dari harga input, jadi untuk kasus yang awalan petunjuknya stabil, biayanya bisa turun cukup signifikan.
Q4: Bagaimana cara cepat memanggil Qwen3.8-Max lewat API?
Disarankan memakai platform agregator API yang mendukung banyak model:
1. Kunjungi APIYI (apiyi.com), daftar akun, lalu dapatkan kunci API beserta kuota uji coba gratis
2. Atur base_url ke `https://api.apiyi.com/v1`
3. Isi ID model dengan `qwen3.8-max`, lalu panggil dengan format Chat Completions yang kompatibel dengan OpenAI
Q5: Setelah Qwen4-Max dibuka secara resmi, apakah biaya migrasinya besar?
Dari sisi antarmuka, biaya migrasi tergantung cara integrasi Anda. Kalau Anda mengelola semuanya lewat antarmuka yang kompatibel dengan OpenAI, biasanya cukup mengganti ID model. Yang benar-benar perlu dinilai adalah selisih kualitas dan biayanya. Sebaiknya mulai sekarang Anda mengumpulkan data evaluasi dengan qwen3.8-max lewat APIYI (apiyi.com), sehingga nanti bisa langsung dibandingkan.
Q6: Apa saja batasan yang perlu diperhatikan selama masa pratinjau?
Parameter-parameter penting di masa pratinjau bisa berubah sewaktu-waktu. Skor benchmark belum dipublikasikan, jadi batas kemampuan model belum bisa dinilai. Panjang jendela konteks belum diumumkan, sehingga solusi untuk teks panjang belum bisa dipastikan. Harga satuan juga belum diumumkan, jadi belum bisa dimasukkan ke anggaran. Karena itu, model pratinjau tidak disarankan untuk layanan produksi yang menuntut stabilitas dan kepastian biaya.
Poin Penting Qwen4-Max dan Qwen3.8 (Key Takeaways)
- Status rilis berbeda: Qwen4-Max masih berstatus pratinjau, sedangkan Qwen3.8-Max sudah dirilis dan bisa dipanggil dengan sistem bayar sesuai pemakaian.
- Tiga hal tidak bisa dibandingkan langsung: skor benchmark, panjang konteks, dan harga per token Qwen4-Max belum dipublikasikan.
- Jangan buru-buru menyimpulkan: tanpa data publik, kita tidak bisa mengklaim Qwen4-Max mengungguli Qwen3.8-Max secara menyeluruh.
- Harga saat ini bisa dicek: qwen3.8-max dihargai $1,65 untuk input, $4,95 untuk output, dan $0,20625 untuk pembacaan cache per 1 juta token.
- Cache adalah kunci menekan biaya: harga baca cache hanya 1/8 dari harga input, sehingga manfaatnya terasa pada kasus penggunaan dengan prefiks yang stabil.
- Untuk produksi, andalkan qwen3.8-max: akses lewat antarmuka terpadu APIYI, dan ketika nanti ganti model, Anda cukup mengubah ID model.
Kesimpulan
Hubungan antara Qwen4-Max versi pratinjau dan Qwen3.8-Max bisa diringkas sebagai berikut:
- Syarat untuk membandingkan belum terpenuhi: Qwen4-Max versi pratinjau belum memiliki skor benchmark publik, panjang konteks, maupun harga per token, jadi ketiganya tidak bisa dibandingkan langsung dengan Qwen3.8-Max.
- Yang tersedia saat ini adalah qwen3.8-max: harganya jelas, yaitu input $1,65, output $4,95, dan pembacaan cache $0,20625 (per 1 juta token).
- Bersiap dari sekarang, bandingkan setelah rilis resmi: kumpulkan dulu set evaluasi bisnis dan data biaya, lalu ambil keputusan migrasi setelah informasinya lengkap.
Sebelum informasi resmi Qwen4-Max diumumkan, langkah yang paling aman adalah tetap memakai qwen3.8-max untuk menopang bisnis, sambil menyiapkan baseline evaluasi dan biaya. Kami menyarankan akses qwen3.8-max lewat APIYI (apiyi.com). Platform ini menyediakan antarmuka terpadu yang kompatibel dengan OpenAI serta kuota uji coba gratis, sehingga saat model baru rilis, Anda bisa langsung membandingkannya dengan kode yang sama.
📚 Referensi
- Daftar Model dan Harga APIYI: pengecekan model yang dapat dipanggil per 2026-11-12
- Tautan:
api.apiyi.com/api/pricing -
Keterangan: digunakan untuk memastikan model Qwen yang saat ini bisa dipanggil dengan tarif sesuai pemakaian
-
Dokumentasi Model APIYI: penjelasan tarif qwen3.8-max
- Tautan:
docs.apiyi.com/models - Keterangan: memuat harga satuan input, output, dan pembacaan cache untuk qwen3.8-max
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat beranda situs APIYI. Materi lengkap tentang integrasi model lainnya bisa dilihat di pusat dokumentasi APIYI.