Ringkasan: Artikel ini menggunakan OpenAI Python SDK untuk memanggil API Tencent Hunyuan Hy4 dengan mode non-streaming, menjalankan permintaan teks murni pertama sampai berhasil, serta menjelaskan cara memverifikasi hasil, memperkirakan biaya, memeriksa tagihan, dan menangani error umum.
Jawaban langsung: API Tencent Hunyuan Hy4 dapat diakses melalui antarmuka kompatibel OpenAI milik APIYI. Siapkan tiga konfigurasi berikut untuk mengirim permintaan pertama:
- Kunci API: Buat di
api.apiyi.com/token, lalu simpan di variabel lingkunganAPIYI_API_KEY. - Base URL SDK:
https://api.apiyi.com/v1. - ID model:
hy4.
Endpoint HTTP yang sesuai adalah POST https://api.apiyi.com/v1/chat/completions. Per 2026-11-21, harga Hy4 dalam tabel harga per satu juta token adalah: input tanpa cache (cache miss) $0.85, output $2.55, pembacaan cache $0.045. Penagihan aktual mengacu pada tabel harga APIYI di docs.apiyi.com/models (kategori Tencent).
Garis waktu: Tencent merilis versi resmi Hy4 pada 4 November, dan membuka bobot model pada 20 November. APIYI sudah menyediakan model ini sebelum bobot dibuka; pengumuman peluncurannya dapat dilihat di docs.apiyi.com/news/hy4-launch. Pengumuman itu sudah memuat contoh streaming, jadi artikel ini hanya membahas empat hal lainnya: pemanggilan non-streaming, verifikasi hasil, pemeriksaan tagihan, dan troubleshooting kegagalan. Pengumuman menyebutkan bahwa Hy4 mendukung input gambar; artikel ini hanya mendemonstrasikan teks murni. Video, antarmuka Responses, dan Computer Use tidak termasuk dalam cakupan artikel ini, dan tidak ada data pengujian aktual di dalam artikel.
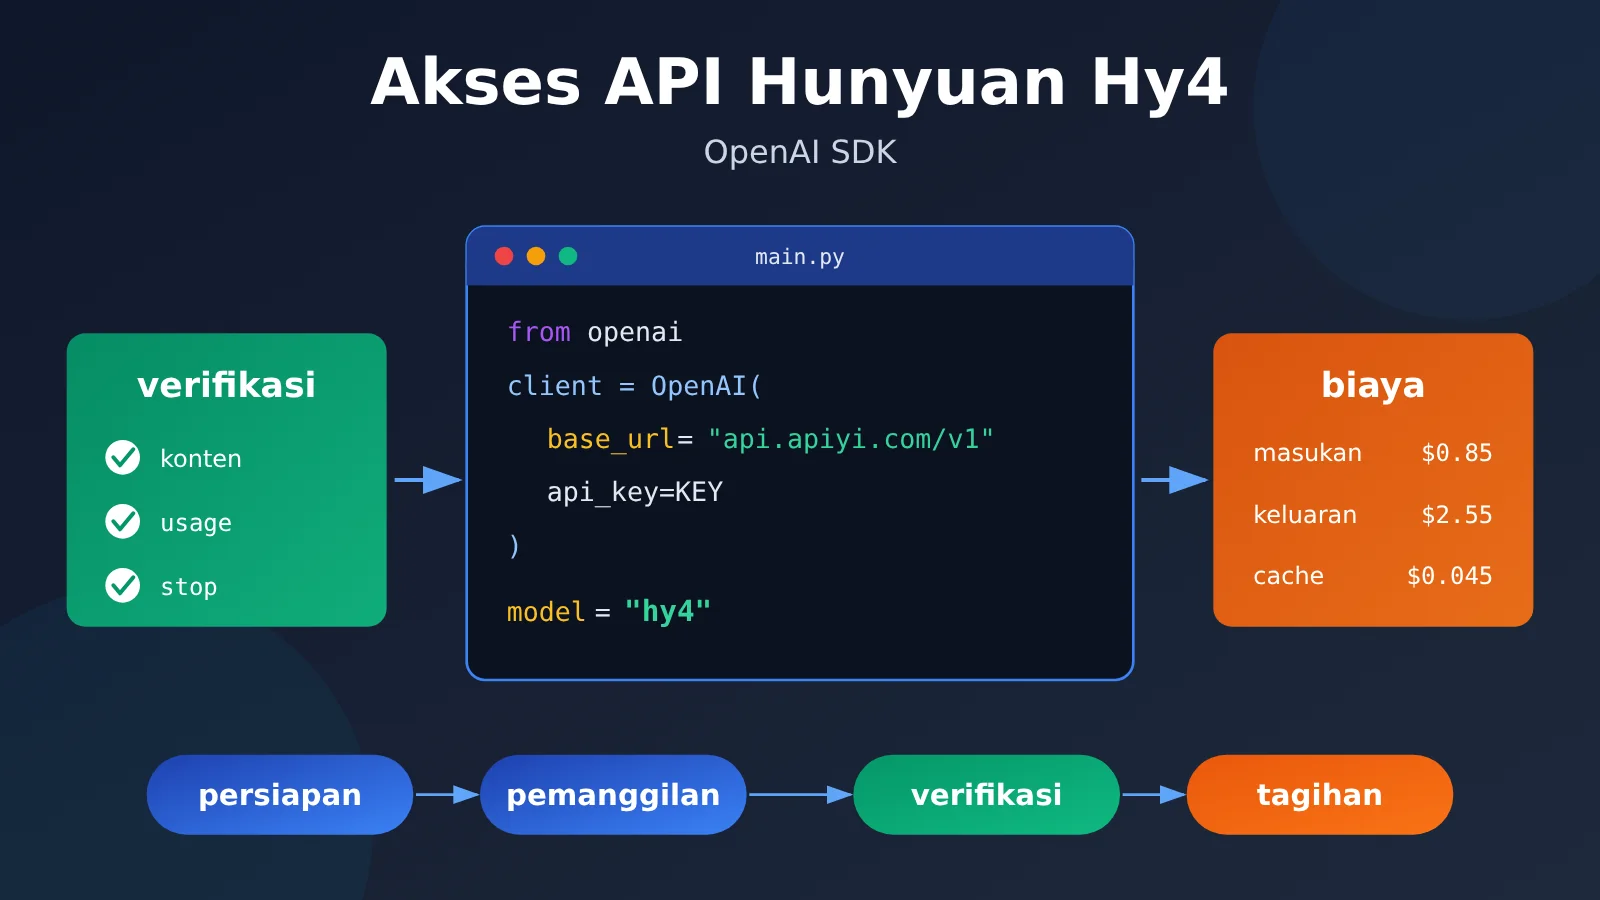
Peta Pengetahuan dan Urutan Membaca untuk Integrasi API Tencent Hunyuan Hy4
Seluruh proses terbagi dalam empat langkah; hasil dari langkah sebelumnya menjadi masukan untuk langkah berikutnya. Sebaiknya baca sesuai urutan nomor. Bagian 4 dapat dirujuk terpisah saat terjadi error.
| Langkah | Bagian terkait | Mengapa ditempatkan di sini | Kriteria penerimaan |
|---|---|---|---|
| Menyiapkan permintaan | 1.1, 1.2 | Jika endpoint, nama model, dan Key salah, langkah berikutnya akan gagal | SDK dapat diimpor, variabel environment dapat membaca Key, dan tidak ada Key plaintext di dalam kode |
| Panggilan pertama | 2.1, 2.2 | Gunakan dulu teks pendek tanpa data pelanggan untuk memastikan jalur sudah terhubung | Konten yang dikembalikan adalah “产品=混元、版本=Hy4”, tidak terpotong, serta usage dan request ID tersimpan |
| Mencocokkan tagihan | 3.1, 3.2 | Setelah jalur terhubung, perkirakan biaya untuk menilai apakah volume panggilan dapat diperbesar | Nilai perkiraan dapat dicocokkan item per item dengan log konsumsi di konsol |
| Troubleshooting kegagalan | 4 | Saat langkah mana pun gagal, tentukan penyebabnya berdasarkan kode error dan body error | Dapat membedakan kesalahan konfigurasi, masalah izin, rate limit, dan timeout, serta menentukan apakah dapat dicoba ulang |
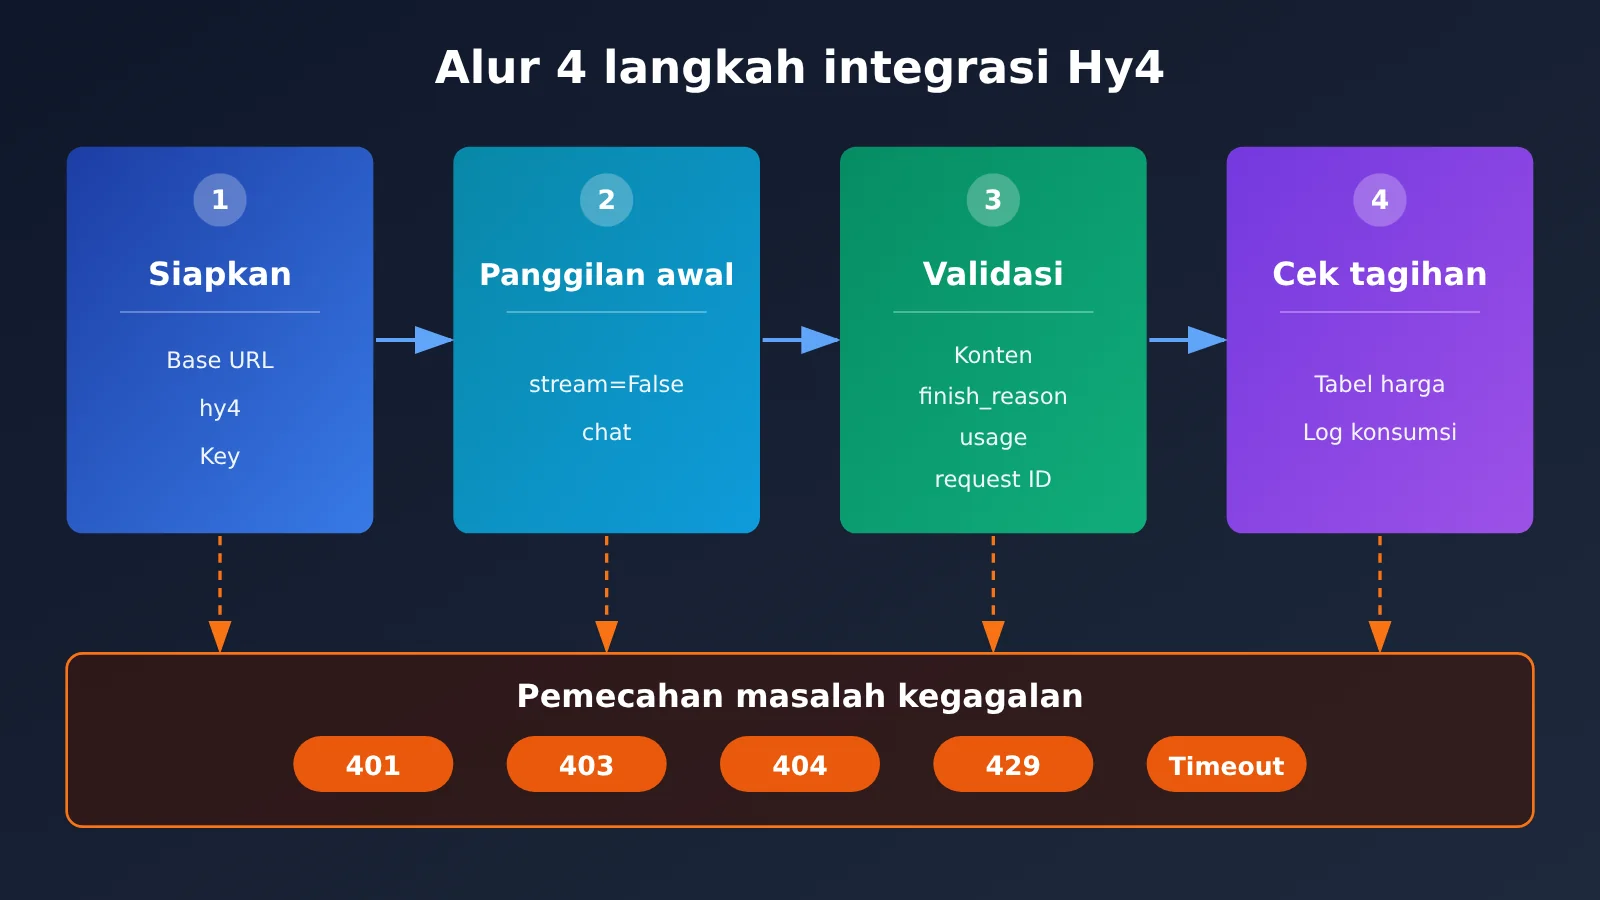
Perlu Diketahui: Istilah Terkait API Hy4
| Istilah | Penjelasan singkat |
|---|---|
Non-streaming (stream=False) |
Model mengembalikan hasil lengkap sekaligus setelah generasi selesai, sehingga lebih mudah memeriksa konten dan penggunaan secara keseluruhan |
finish_reason |
Alasan generasi kali ini berakhir. stop berarti selesai normal, length berarti mencapai batas panjang dan terpotong |
usage |
Field penggunaan token dalam respons; yang umum adalah prompt_tokens (input) dan completion_tokens (output) |
request ID |
Identitas satu permintaan, digunakan untuk menemukan panggilan ini di log. Tidak setiap respons selalu menyertakannya |
| Pembacaan cache | Bagian input yang mengenai cache, ditagih dengan harga pembacaan cache tersendiri |
Grup (Default/SVIP) |
Grup tempat token berada; menentukan model mana yang dapat dipanggil oleh token ini |
1. Menyiapkan Permintaan API Tencent Hunyuan Hy4
1.1 Mengonfigurasi Model Hy4 dan Endpoint
Cek dulu satu per satu setiap item konfigurasi. Sebagian besar kegagalan pada pemanggilan pertama justru terjadi di langkah ini.
| Item konfigurasi | Nilai | Keterangan |
|---|---|---|
| SDK base_url | https://api.apiyi.com/v1 |
Tulis hanya sampai /v1, SDK akan menambahkan /chat/completions secara otomatis |
| Endpoint HTTP | POST https://api.apiyi.com/v1/chat/completions |
Gunakan alamat ini kalau mengirim permintaan HTTP langsung tanpa SDK |
| Model ID | hy4 |
Nama model versi resmi, isi persis dalam huruf kecil |
| Grup yang tersedia | Default, SVIP | Grup tempat token berada harus mencakup Hy4 |
| Mode output | stream=False |
Sepanjang artikel ini memakai mode non-streaming |
Kesalahan yang paling umum adalah memasukkan endpoint lengkap ke dalam base_url. SDK akan menyambung /chat/completions sekali lagi di belakang alamat tersebut, sehingga path-nya jadi dobel dan akhirnya mengembalikan 404. Penjelasan lengkap antarmuka kompatibel bisa dilihat di docs.apiyi.com/api-capabilities/openai/compatible.
1.2 Memasang OpenAI SDK dan Menyimpan Key dengan Aman
Alamat proyek SDK Python resmi ada di github.com/openai/openai-python. Sebaiknya pasang di dalam virtual environment supaya tidak bentrok versi dengan paket yang sudah ada di sistem:
python -m venv .venv
source .venv/bin/activate          # Windows: .venv\Scripts\activate
python -m pip install openai
Key dibuat di api.apiyi.com/token. Saat membuatnya, pastikan grup tempat token berada bisa memanggil Hy4. Setelah Key didapat, tulis ke variabel lingkungan terminal yang sedang dipakai, jangan ditaruh di file kode:
export APIYI_API_KEY="token-anda" # Windows PowerShell: $env:APIYI_API_KEY="token-anda"
Perhatikan beberapa hal berikut saat mengelola Key:
- Kode hanya membaca Key dari
os.environ['APIYI_API_KEY']. Kalau variabel lingkungan belum diset, pakai input interaktifgetpass; teks yang diketik tidak akan tampil di layar. - Kalau menyimpan Key di file
.env, masukkan file itu ke.gitignoresupaya tidak ter-commit ke repo. - Kalau Key muncul di screenshot, log, atau tiket, ganti dulu dengan mask seperti
sk-***.
Verifikasi: jalankan di terminal python -c "import openai, os; print(openai.__version__, bool(os.environ.get('APIYI_API_KEY')))". Kalau muncul nomor versi dan True, berarti langkah ini selesai.
2. Mengirim permintaan Hy4 pertama dengan OpenAI SDK
2.1 Contoh Python non-streaming lengkap
Permintaan pertama ini hanya melakukan satu hal sederhana: mengekstrak nama produk dan nomor versi dari sebuah kalimat publik, tanpa menyertakan data pelanggan apa pun. Desain ini punya dua keuntungan. Pertama, outputnya sangat pendek sehingga biayanya rendah. Kedua, jawabannya unik sehingga mudah dinilai benar atau salah.
import os
import re
from getpass import getpass
from openai import OpenAI

key = os.environ.get("APIYI_API_KEY") or getpass("输入 APIYI_API_KEY:")

PROMPT = "仅从这句话提取产品和版本:腾讯混元 Hy4 正式版已上线。请只写一行:产品=…;版本=…"

with OpenAI(
    base_url="https://api.apiyi.com/v1",   # Antarmuka kompatibel OpenAI APIYI
    api_key=key,
    timeout=60.0,
    max_retries=0,                         # Matikan percobaan ulang otomatis; jika gagal, manusia yang memutuskan apakah akan mengirim ulang
) as client:
    result = client.chat.completions.create(
        model="hy4",
        messages=[{"role": "user", "content": PROMPT}],
        stream=False,
    )

request_id = getattr(result, "_request_id", None)
print("request_id:", request_id if request_id else "响应未提供")

if not result.choices:
    raise SystemExit("未通过:choices 为空,没有返回正文")

choice = result.choices[0]
content = (choice.message.content or "").strip()
print("finish_reason:", choice.finish_reason)
print("content:", content)

usage = getattr(result, "usage", None)
prompt_tokens = getattr(usage, "prompt_tokens", None) if usage else None
completion_tokens = getattr(usage, "completion_tokens", None) if usage else None
print("prompt_tokens:", prompt_tokens if prompt_tokens is not None else "缺失(不按 0 处理)")
print("completion_tokens:", completion_tokens if completion_tokens is not None else "缺失(不按 0 处理)")


def accept(text: str, finish_reason) -> tuple[bool, str]:
    if not text:
        return False, "正文为空"
    if finish_reason == "length":
        return False, "输出被截断"
    t = re.sub(r"\s+", "", text)
    t = t.replace(":", "=").replace(":", "=").replace(";", ";")
    prod = re.search(r"产品=([^;\n]+)", t)
    ver = re.search(r"版本=([^;\n]+)", t)
    if not prod or not ver:
        return False, "缺少产品或版本字段"
    strip_punct = lambda s: re.sub(r"[。..,,、!!??\"“”'‘’]", "", s)
    if "混元" not in strip_punct(prod.group(1)):
        return False, f"产品值错误:{prod.group(1)}"
    if strip_punct(ver.group(1)) != "Hy4":
        return False, f"版本值错误:{ver.group(1)}"
    return True, "通过"


ok, reason = accept(content, choice.finish_reason)
print("验收:", reason)
Beberapa pengaturan dalam contoh ini perlu dijelaskan:
max_retries=0mematikan percobaan ulang otomatis dari SDK. Bagian 4 akan membahas bahwa setelah timeout, server mungkin sudah menyelesaikan permintaan; pengiriman ulang otomatis dapat menyebabkan penagihan ganda, jadi keputusan untuk mencoba ulang harus diambil oleh manusia.- Pernyataan
withakan menutup koneksi setelah pemanggilan selesai. - Saat field usage tidak ada, kode secara eksplisit mencetak “缺失”, bukan memperlakukannya sebagai 0, agar biaya tidak terlewat saat penghitungan di kemudian hari.
Penjelasan lebih lanjut tentang struktur respons dapat dilihat di docs.apiyi.com/api-capabilities/openai/response-handling.
2.2 Kriteria penerimaan untuk permintaan Hy4 pertama
Saat penerimaan, hanya periksa dua field di dalam message.content: nilai field 产品 mengandung “混元”, dan nilai field 版本 adalah “Hy4”. Perbedaan titik dua, titik koma, serta tanda baca akhir kalimat dalam bentuk lebar penuh atau setengah lebar dapat diterima. Berikut satu baris output yang memenuhi persyaratan, ini adalah format ilustrasi, bukan respons aktual hasil pengujian:
产品=腾讯混元;版本=Hy4
Situasi berikut semuanya dinilai tidak lulus; jangan meloloskannya hanya karena “terlihat mirip”:
| Situasi | Hasil | Alasan |
|---|---|---|
| choices kosong, atau content berupa string kosong | Tidak lulus | Tidak memperoleh konten utama, berarti jalur pemrosesan belum benar-benar berjalan |
finish_reason bernilai length |
Tidak lulus | Output terpotong, hasil tidak lengkap |
| Versi ditulis sebagai Hy3, Hunyuan, atau nilai lain | Tidak lulus | Nilai field salah |
| Hanya berbeda pada tanda baca, spasi, atau titik dua lebar penuh/setengah lebar | Lulus | Termasuk perbedaan format yang diizinkan |
Setelah lulus penerimaan, catat request ID (jika ada dalam respons), waktu permintaan, nama model, prompt_tokens, dan completion_tokens. Informasi ini akan digunakan saat memeriksa tagihan di bagian 3.2.
3. Estimasi dan Verifikasi Biaya API Hy4
3.1 Estimasi Satu Tugas Batch Berdasarkan Tabel Harga
Input pada permintaan pertama sangat singkat, biayanya bisa diabaikan, sehingga tidak banyak gunanya untuk mengestimasikan biaya darinya. Berikut kita ganti dengan skenario hipotetis yang tidak berkaitan dengan permintaan singkat contoh: suatu tugas memasukkan 100 ribu token, semuanya tidak mengenai cache, dan mengeluarkan 20 ribu token. Input dan output dihitung masing-masing berdasarkan harga satuannya:
| Item Penagihan | Asumsi Penggunaan | Harga Satuan (per juta token) | Biaya |
|---|---|---|---|
| Input tidak mengenai cache | 100,000 | $0.85 | $0.085 |
| Output | 20,000 | $2.55 | $0.051 |
| Total | — | — | $0.136 |
Proses perhitungannya adalah 0.1 × 0.85 + 0.02 × 2.55 = 0.136. Ada dua hal yang perlu diperhatikan saat mengestimasikan:
- Harga satuan output adalah 3 kali harga satuan input yang tidak mengenai cache. Untuk tugas dengan volume output besar, biaya terutama ditentukan oleh output.
- Jika completion_tokens sudah mencakup bagian pemikiran model, jangan tambahkan biaya pemikiran secara terpisah, jika tidak akan terjadi penghitungan ganda.
3.2 Membedakan Bucket Cache dari Log Konsumsi Aktual
“Pembacaan cache” adalah bagian penagihan tersendiri, tetapi cara pemisahan field pada respons yang berbeda belum tentu sama, sehingga tidak ada nama field yang berlaku umum yang dapat menjamin hasilnya akurat. Cara yang andal adalah memastikan terlebih dahulu di tagihan: apakah token yang mengenai cache sudah dihitung dalam total input.
Jika tagihan memastikan bagian cache sudah termasuk dalam total input, kurangi satu kali bagian cache dari total input, lalu hitung masing-masing. Berikut melanjutkan asumsi 3.1, dan selanjutnya mengasumsikan bahwa dari 100 ribu input, 40 ribu mengenai cache:
| Item Penagihan | Asumsi Penggunaan | Harga Satuan (per juta token) | Biaya |
|---|---|---|---|
| Input tidak mengenai cache | 60,000 | $0.85 | $0.051 |
| Pembacaan cache | 40,000 | $0.045 | $0.0018 |
| Output | 20,000 | $2.55 | $0.051 |
| Total | — | — | $0.1038 |
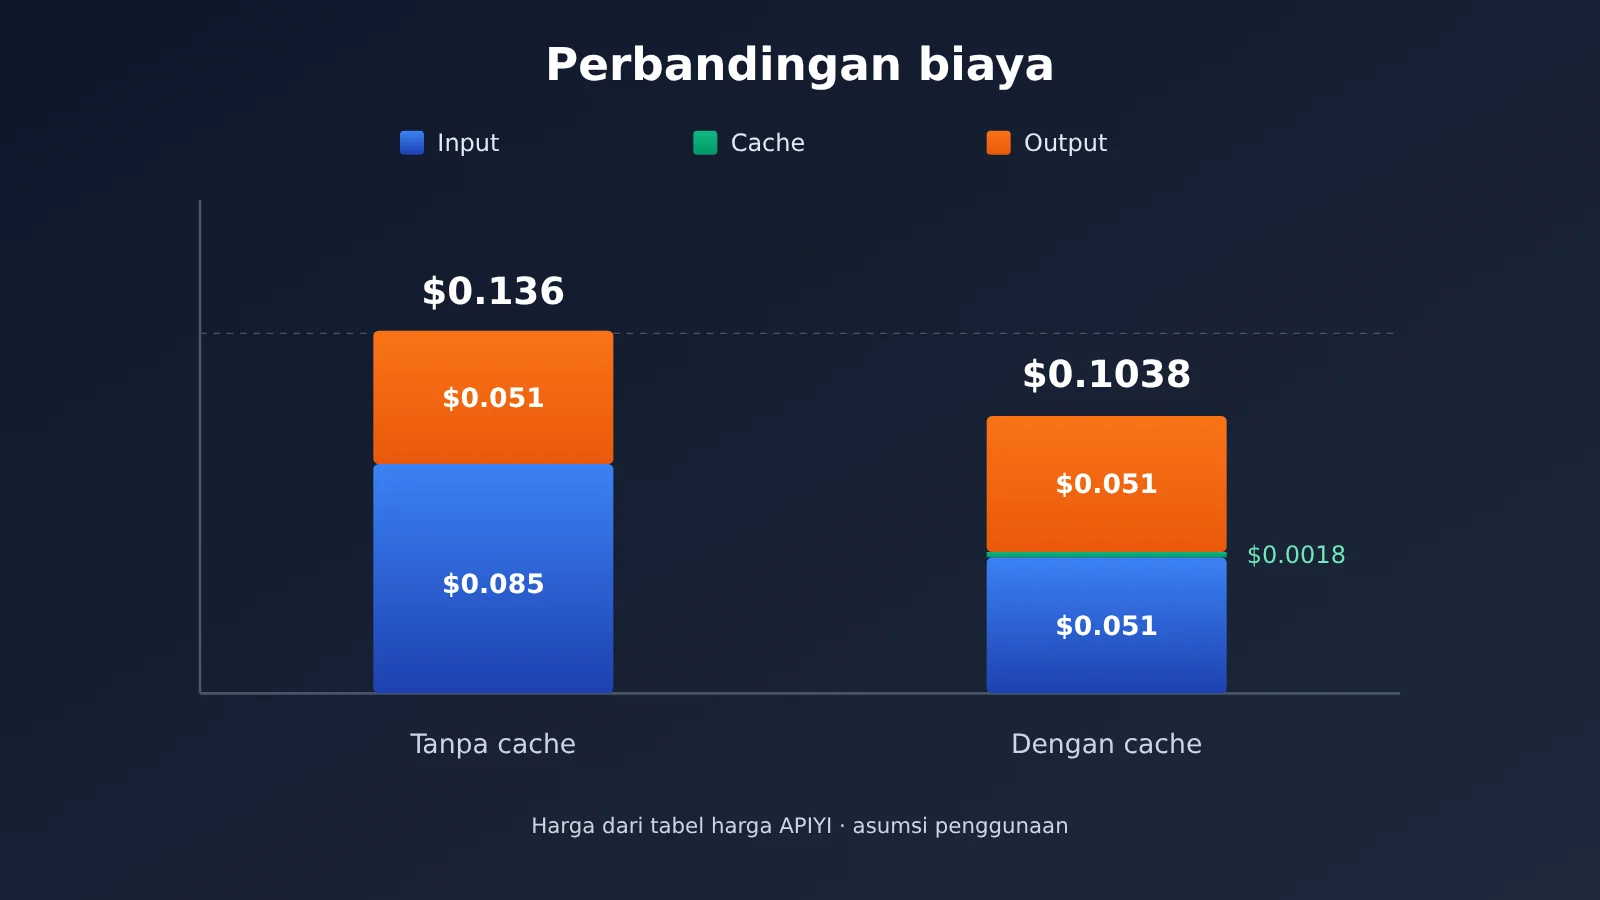
Nilai estimasi hanya dapat dijadikan referensi, yang final adalah log konsumsi. Cara memverifikasi adalah dengan menyaring catatan yang sesuai di konsol api.apiyi.com/log:
- Persempit rentang berdasarkan waktu permintaan.
- Jika respons menyediakan request ID, gunakan untuk menentukan secara tepat permintaan ini.
- Pastikan modelnya adalah
hy4, token sama dengan token yang benar-benar digunakan kode. - Bandingkan penggunaan input, cache, output dan jumlah pemotongan biaya dalam log, lihat apakah sesuai dengan nilai estimasi.
Arti spesifik dari field log dapat dilihat di docs.apiyi.com/faq/log-billing-explained.
4. Penanganan Kesalahan API Hy4
Saat melakukan troubleshooting, periksa dulu kode status HTTP, lalu baca informasi spesifik di dalam badan kesalahan. Hanya melihat kode status saja mudah menimbulkan kesalahan penilaian—misalnya, kode 429 yang sama bisa memiliki penyebab yang sangat berbeda. Pada permintaan asli di Bagian 2.1, tangkap exception SDK: untuk timeout koneksi lihat APITimeoutError, untuk kegagalan koneksi lainnya lihat APIConnectionError; saat menerima respons kesalahan, catat status_code, request_id, dan badan kesalahan dari APIStatusError. Nilailah dulu hasil permintaan yang ada, baru kemudian putuskan apakah perlu mencoba ulang; lakukan desensitisasi pada badan kesalahan sebelum memberikan umpan balik. Urutan penanganannya sebagai berikut:
| Kesalahan | Periksa terlebih dahulu | Apakah perlu mencoba ulang |
|---|---|---|
| 401 | Apakah Key benar, apakah sudah kedaluwarsa, dan apakah base_url adalah https://api.apiyi.com/v1 |
Jangan coba ulang sebelum konfigurasi diperbaiki |
| 403 | Tentukan dari badan kesalahan apakah ini masalah izin grup, pastikan grup tempat token berada mencakup Hy4 | Jangan coba ulang sebelum izin diperbaiki |
| 404 | Apakah path menggandakan /chat/completions, apakah nama model adalah hy4 |
Jangan coba ulang sebelum konfigurasi diperbaiki |
| 429 | Tentukan dari badan kesalahan apakah ini pembatasan laju sementara atau kuota tidak cukup | Pembatasan laju sementara dapat dicoba ulang dengan backoff terbatas; jika kuota tidak cukup, perlu isi ulang atau sesuaikan kuota |
| Kesalahan koneksi | Apakah jaringan, proxy, DNS normal, serta apakah protokol dan domain base_url benar | Dapat dicoba ulang setelah jaringan pulih |
| Timeout | Cari dulu berdasarkan waktu di api.apiyi.com/log untuk memastikan apakah permintaan sudah dieksekusi |
Jika sudah dieksekusi jangan kirim ulang; jika belum, coba lagi |
Perlu penjelasan khusus untuk dua kasus, 429 dan timeout:
- Backoff dan coba ulang untuk 429: hanya berlaku untuk pembatasan laju sementara. Jumlah percobaan ulang harus diberi batas atas, dan interval setiap kali diperpanjang secara bertahap. Jika kuota tidak cukup, berapa kali pun mencoba ulang tidak akan berhasil.
- Timeout: Klien tidak menerima respons dalam 60 detik bukan berarti server tidak memproses permintaan tersebut. Jika server sudah selesai memproses, mengirim ulang langsung akan mengeksekusi sekali lagi, dan biaya juga akan terpotong sekali lagi. Jadi sebaiknya periksa log terlebih dahulu, pastikan permintaan belum dieksekusi, baru kemudian kirim ulang.
Jika perlu menghubungi dukungan teknis, sebelum mengirim, lakukan desensitisasi dulu terhadap informasi sensitif seperti Key dan data pelanggan di badan kesalahan dan log, lalu lampirkan kode status, waktu permintaan, nama model, dan request ID. Cara penyimpanan dan pengiriman informasi kesalahan lihat di docs.apiyi.com/api-manual/error-reporting.
Setelah semua troubleshooting selesai, jalankan ulang dengan contoh pada 2.1; seluruh alur baru dianggap lulus jika memenuhi tiga syarat sekaligus:
- Fungsi penerimaan mengeluarkan “lulus”.
- finish_reason bukan
length. - Di log konsol dapat ditemukan catatan dengan waktu yang sama dan model
hy4, serta penggunaan (usage) sesuai dengan usage yang dicatat secara lokal.