Catatan penulis: Berangkat dari satu bagian usage pada Responses, kita hitung ulang satu per satu input biasa, pembacaan cache, penulisan cache, dan output penalaran GPT-6.2 Sol, lalu jelaskan bagaimana masa hidup cache dan status permintaan mengubah tagihan dari alur kerja yang sama.
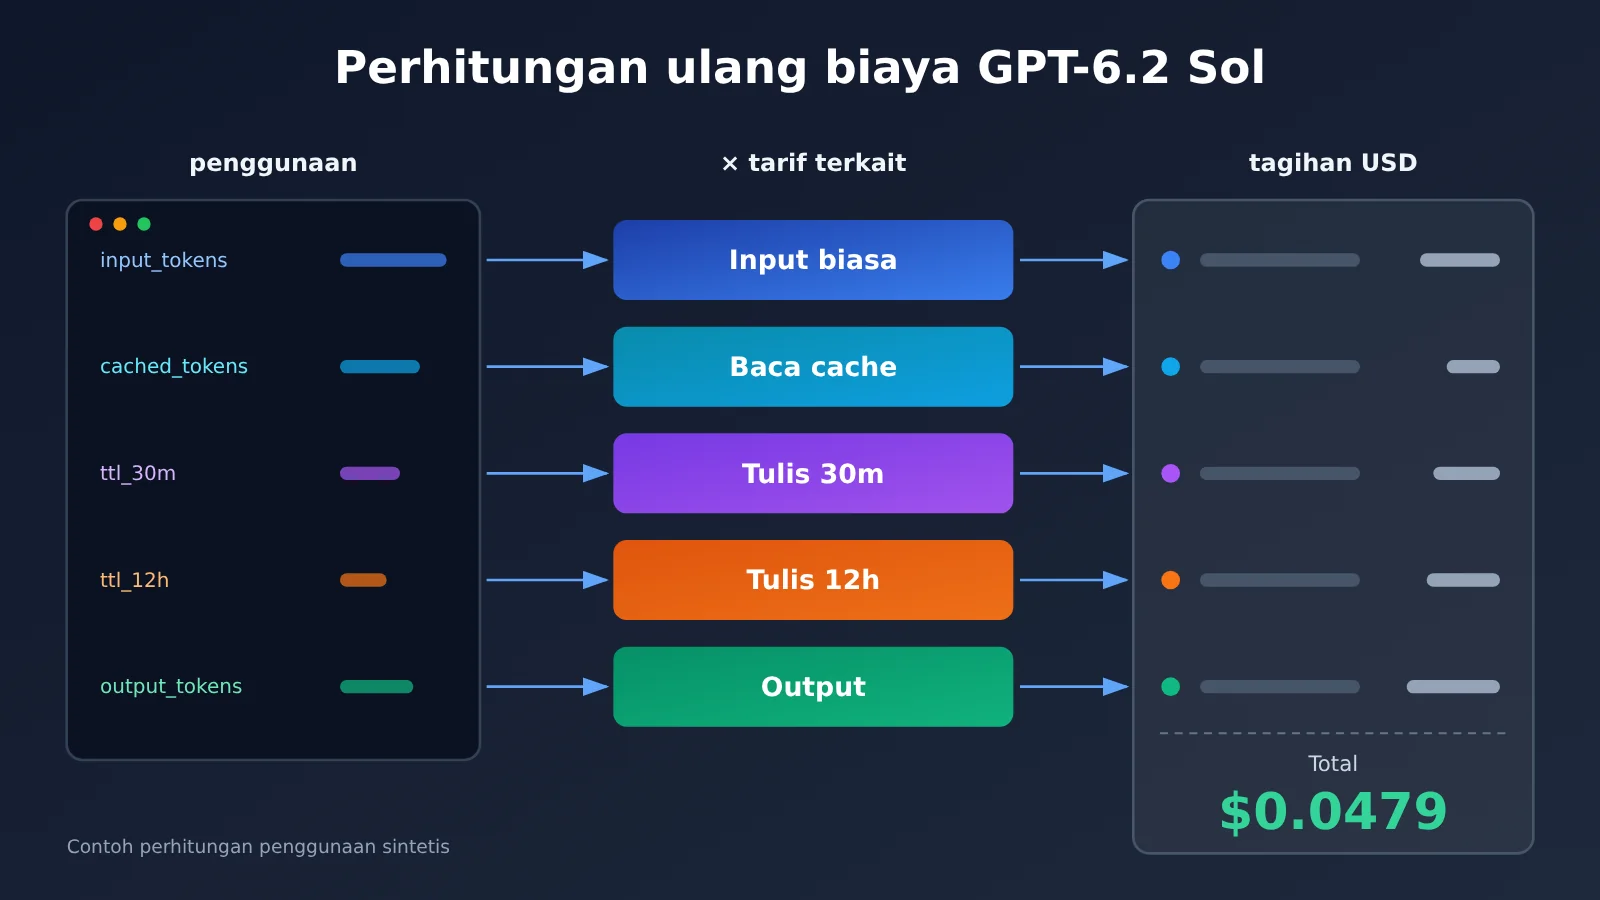
Tagihan GPT-6.2 Sol bisa dihitung ulang dengan cara yang baku. Bagian usage dalam catatan permintaan membagi input menjadi empat kategori: input biasa, pembacaan cache, penulisan cache 30 menit, penulisan cache 12 jam. Keempat kategori ini saling eksklusif. Output menjadi kategori tersendiri, dan token penalaran sudah termasuk di dalamnya. Jumlah token tiap kategori dikalikan tarif yang sesuai lalu dijumlahkan — itulah biaya model untuk permintaan tersebut. Biaya tool dihitung terpisah.
Ada tiga kondisi yang bisa mengubah hasilnya. Pertama, apakah total input dalam satu permintaan melewati 272K; jika lewat, seluruh permintaan beralih ke tarif konteks panjang. Kedua, masa hidup cache dan jumlah hit aktual — prefix yang sama ditulis sebagai cache 30 menit atau 12 jam punya titik impas yang berbeda. Ketiga, status permintaan: incomplete, percobaan ulang, dan tugas latar belakang semuanya memengaruhi total tagihan sebuah alur kerja.
OpenAI merilis GPT-6.2 Sol pada 17 November 2026, dengan ID model API gpt-6.2-sol, yang bisa dipanggil lewat Responses dan Chat Completions; pemanggilan fungsi dan tool bawaan melewati jalur Responses. Artikel ini memakai harga resmi dalam dolar dari koneksi langsung OpenAI sebagai acuan, sekaligus menjelaskan acuan harga terdaftar model ini di antarmuka harga publik APIYI apiyi.com. Semua contoh perhitungan di artikel ini berbasis penggunaan sintetis, bukan tagihan aktual.
Peta Pengetahuan Penagihan GPT-6.2 Sol dan Urutan Membaca
Seluruh teks disusun dengan urutan «field → jumlah uang → keputusan cache → rekonsiliasi alur kerja». Output setiap langkah menjadi input langkah berikutnya: pertama pahami item apa saja yang ada di dalam usage, lalu ubah item tersebut menjadi dolar, kemudian bandingkan opsi cache menggunakan algoritme ini, dan terakhir gabungkan satu permintaan menjadi biaya alur kerja.
Responses usage
 ├─ total input input_tokens
 │   ├─ pembacaan cache cached_tokens ──────────┐
 │   ├─ penulisan 30m ttl_30m_tokens ───────────┤
 │   ├─ penulisan 12h ttl_12h_tokens ───────────┼─→ ×tarif terkait → biaya model per permintaan (bagian 2)
 │   └─ input biasa = total − pembacaan − semua penulisan ┤
 └─ output output_tokens(termasuk reasoning_tokens)┘
                                          ↓
         pemilihan masa pakai cache (bagian 3) ← perbandingan total harga beberapa permintaan dengan prefiks sama
                                          ↓
         rekonsiliasi alur kerja (bagian 4) ← biaya alat + percobaan ulang + incomplete + ekspor biaya
| No | Pertanyaan yang dijawab | Bergantung pada isi bagian sebelumnya | Yang bisa dilakukan setelah membaca |
|---|---|---|---|
| 1 | Angka mana dalam usage yang ikut ditagih | — | Memecah lima nilai pemakaian yang ditagih dari satu respons |
| 2 | Berapa nilai uang dari pemakaian tersebut | Lima nilai pemakaian di bagian 1 | Mengubah angka log menjadi dolar, menentukan kategori panjang atau pendek |
| 3 | Cache ditulis 30 menit atau 12 jam | Algoritme tarif satuan di bagian 2 | Memilih masa pakai cache berdasarkan interval pemanggilan dan jumlah hit |
| 4 | Berapa sebenarnya biaya satu tugas | Perhitungan per permintaan di bagian 2 dan 3 | Membuat tabel log minimal, melacak selisih tagihan |
Pembaca yang hanya ingin menjelaskan selisih satu biaya cukup membaca bagian 1 dan 2. Pembaca yang bertanggung jawab atas strategi cache atau pembukuan biaya disarankan membaca keempat bagian secara berurutan.
Terminologi Penagihan GPT-6.2 Sol yang Perlu Diketahui
| Istilah | Penjelasan |
|---|---|
| usage | Field dalam respons API yang merangkum pemakaian token untuk permintaan saat ini |
| Input biasa | Pemakaian yang tersisa setelah total input dikurangi pembacaan cache yang ditagihkan dan seluruh penulisan cache |
| Pembacaan cache | Bagian input dalam permintaan saat ini yang ditagihkan dengan harga penggunaan ulang |
| Titik henti cache | Batas yang memungkinkan cache menyimpan atau menggunakan ulang awalan input |
| TTL | Konfigurasi cakupan waktu penagihan minimum cache; Sol mendukung dua jenis penulisan, yaitu 30 menit dan 12 jam |
| Token penalaran | Token yang dihasilkan model selama fase berpikir dan dimasukkan ke total output yang ditagihkan |
| ID respons | Penanda yang menghubungkan log rekonsiliasi, polling latar belakang, dan respons model terkait |
| Biaya alat | Biaya terpisah yang timbul dari penggunaan alat terkelola tertentu |
1 Menemukan lima komponen usage yang ditagihkan untuk GPT-6.2 Sol dari usage Responses
1.1 Empat jenis input dan satu jenis output
Objek usage pada Responses mencatat input dan output dari satu permintaan secara terpisah. Sisi input memberikan total dan beberapa rincian; sisi output memberikan total dan subitem penalaran. Saat menghitung ulang, field yang perlu dicari adalah sebagai berikut:
| Kategori penagihan | Field yang dibaca | Penjelasan |
|---|---|---|
| Total input | usage.input_tokens |
Jumlah dari empat jenis input; nilainya sendiri tidak langsung dikalikan tarif |
| Pembacaan cache | input_tokens_details.cached_tokens |
Jumlah pembacaan dalam arti penagihan |
| Total penulisan cache | cache_write_tokens |
Jumlah dari penulisan dua masa berlaku |
| Penulisan 30 menit | cache_write_tokens_details.ttl_30m_tokens |
Digunakan saat rincian masa berlaku dikembalikan |
| Penulisan 12 jam | cache_write_tokens_details.ttl_12h_tokens |
Digunakan saat rincian masa berlaku dikembalikan |
| Output | usage.output_tokens |
Sudah mencakup token penalaran |
| Subitem penalaran | output_tokens_details.reasoning_tokens |
Digunakan untuk memahami komposisi output, tidak dikenakan biaya tambahan secara terpisah |
1.2 Rumus perhitungan input biasa
Input biasa tidak memiliki field tersendiri di usage, jadi harus didapatkan melalui pengurangan:
Input biasa = input_tokens − cached_tokens − cache_write_tokens
Yang dikurangi di sini adalah seluruh penulisan, yaitu jumlah dari penulisan 30 menit dan 12 jam. Kedua jenis penulisan, pembacaan, dan input biasa saling eksklusif; token yang sama hanya masuk ke salah satu kategori. Token yang ditulis ke cache ditagihkan dengan tarif penulisan dan tidak akan dikenakan lagi harga input biasa. Di sinilah kesalahan hitung paling mudah terjadi: jika jumlah penulisan dibiarkan di dalam input biasa lalu biaya penulisan dihitung terpisah, totalnya akan menjadi terlalu tinggi.
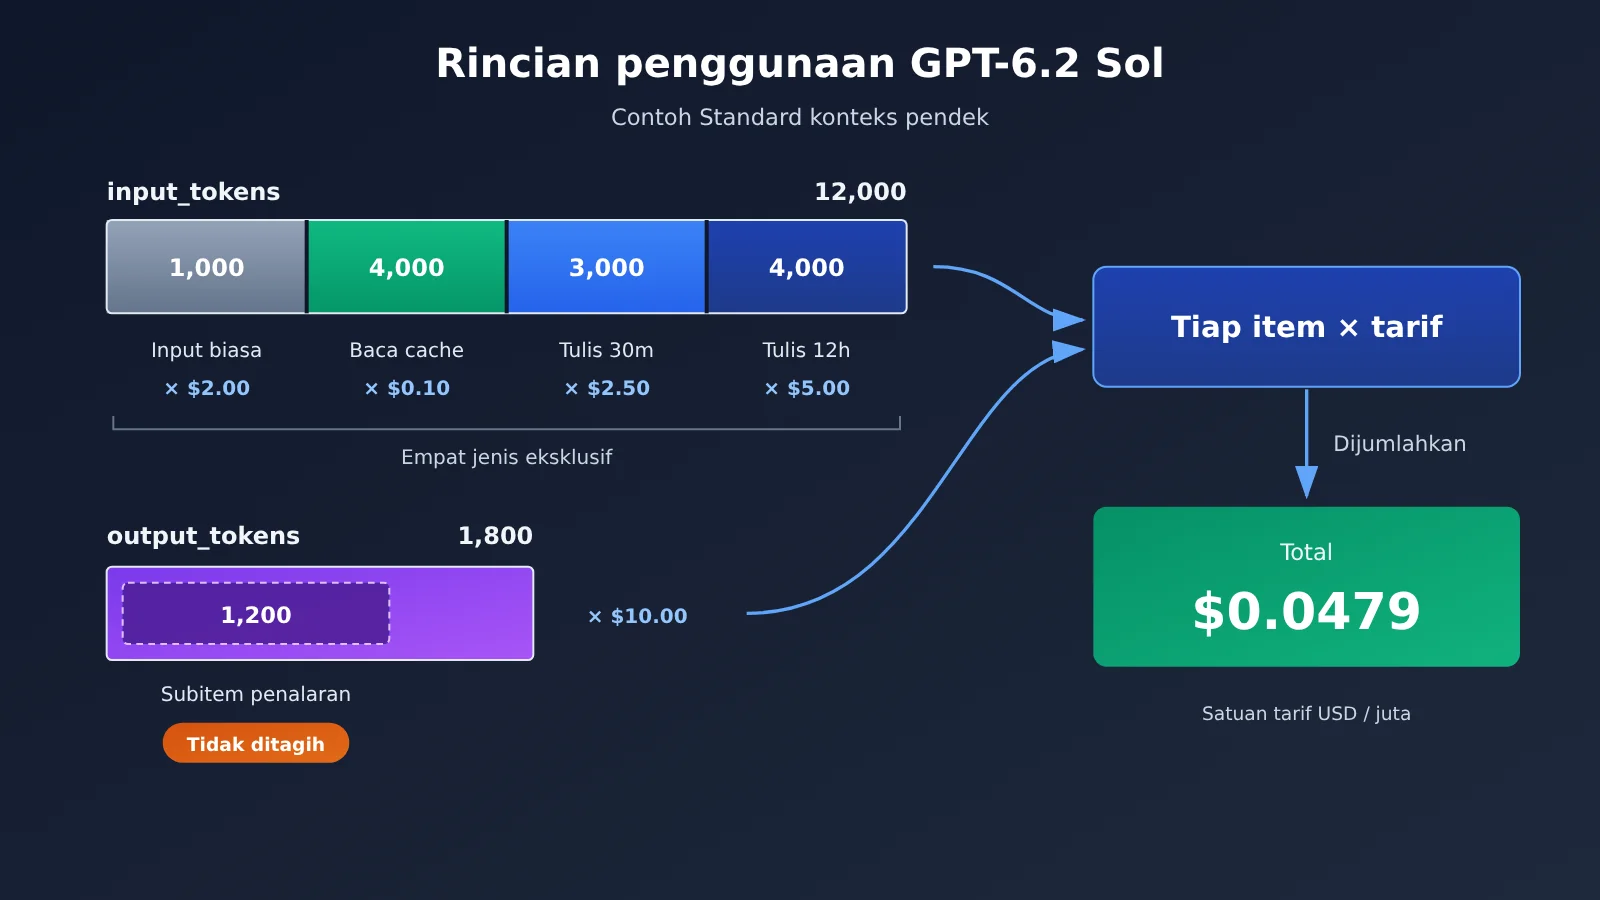
Token penalaran di sisi output juga mudah terhitung dua kali. reasoning_tokens adalah subhimpunan dari output_tokens; saat menghitung ulang, cukup kalikan output_tokens dengan tarif output. Subitem penalaran cocok dipakai untuk menganalisis “mengapa output kali ini sebanyak ini”, bukan sebagai item penagihan tambahan.
1.3 Gunakan field penagihan untuk menghitung ulang, field diagnostik hanya untuk penelusuran
Informasi diagnostik Prompt Caching juga dapat menampilkan angka seperti “jumlah yang dapat digunakan ulang” atau “estimasi jumlah yang tidak cocok”. Angka-angka ini menjelaskan mengapa cache tidak terpakai ulang, misalnya awalan berubah atau panjangnya tidak mencukupi, tetapi tidak mewakili tagihan sebenarnya. Saat menghitung ulang tagihan, gunakan hanya field penagihan aktual di usage.
Jika suatu kanal tidak mengembalikan rincian masa berlaku, atau tidak memiliki cache_write_tokens, jangan menyimpulkan tagihan berdasarkan field yang tidak ada. Dalam kasus seperti ini, gunakan catatan penagihan kanal tersebut sebagai acuan. Contoh perhitungan di bagian berikutnya menggunakan usage sintetis dengan semua field lengkap, sehingga memudahkan demonstrasi algoritme secara utuh.
2 Mengubah angka log GPT-6.2 Sol menjadi dolar
2.1 Tabel tarif resmi Standard
Tabel di bawah ini menggunakan acuan koneksi langsung resmi OpenAI, dengan satuan USD / juta token. Kategori panjang atau pendek ditentukan berdasarkan total input per permintaan; jika melebihi 272K, seluruh permintaan beralih ke tarif konteks panjang: tarif input dan berbagai jenis cache ×2, output ×1.5.
| Kategori penagihan Standard | Konteks pendek (≤272K) | Konteks panjang (>272K) |
|---|---|---|
| Input biasa | $2.00 | $4.00 |
| Pembacaan cache | $0.10 | $0.20 |
| Penulisan cache 30 menit | $2.50 | $5.00 |
| Penulisan cache 12 jam | $5.00 | $10.00 |
| Output (sudah termasuk token penalaran) | $10.00 | $15.00 |
Harga dasar untuk konteks pendek sama dengan GPT-6.1 Sol. Selain itu, model card mencantumkan jendela konteks sebesar 1.050.000 token, input maksimum 922.000 token, dan output maksimum 128.000 token. “Berapa banyak yang bisa diinput” dan “dari titik mana penagihan beralih ke tarif panjang” adalah dua angka yang terpisah; permintaan dengan input 300K sepenuhnya sah, tetapi seluruhnya akan ditagih dengan tarif panjang.
2.2 Perhitungan ulang lengkap usage sintetis
Misalkan satu permintaan Standard dengan konteks pendek mengembalikan usage berikut, tanpa penggunaan alat dan tanpa biaya tambahan: total input 12,000, pembacaan cache 4,000, penulisan 30 menit 3,000, penulisan 12 jam 4,000, output 1,800 (termasuk 1,200 penalaran).
Pertama, hitung input biasa: 12,000 − 4,000 − 3,000 − 4,000 = 1,000. Lalu kalikan setiap item dengan tarifnya:
| Item penagihan | Jumlah token | Tarif (USD/juta) | Jumlah (USD) |
|---|---|---|---|
| Input biasa | 1,000 | 2.00 | 0.0020 |
| Pembacaan cache | 4,000 | 0.10 | 0.0004 |
| Penulisan 30 menit | 3,000 | 2.50 | 0.0075 |
| Penulisan 12 jam | 4,000 | 5.00 | 0.0200 |
| Output (termasuk 1,200 penalaran) | 1,800 | 10.00 | 0.0180 |
| Total | — | — | 0.0479 |
Dalam perhitungan ini, penulisan 12 jam hanya mencakup 4,000 token, tetapi menyumbang lebih dari 40% dari total biaya. Alasannya, harga satuannya 2.5 kali input biasa; biaya hanya muncul saat penulisan, dan manfaatnya baru terealisasi ketika cache hit di kemudian hari. Bagian 3 akan membahas hal ini secara khusus.
Sebaiknya ledger biaya mencatat jumlah token dan tarif untuk setiap item penagihan secara terpisah, bukan hanya menyimpan satu jumlah total. Dengan begitu, saat terjadi selisih biaya, nilai aktual dari log dapat langsung dimasukkan ke tabel di atas untuk melacak sumber selisih baris per baris.
2.3 Konteks panjang: ganti tarif dulu, lalu pakai rumus yang sama
Ketika total input melebihi 272K, algoritme tidak berubah, cukup ganti seluruh kolom tarif pada tabel di atas dengan nilai untuk konteks panjang. Perlu diperhatikan bahwa pergantian ini berlaku untuk keseluruhan permintaan, pembacaan dan penulisan cache ikut berlipat dua, sedangkan output dihitung 1,5 kali. Karena itu, penentuan apakah masuk kategori pendek atau panjang harus dilakukan sebelum perkalian per item.
Saat memanggil melalui saluran pihak ketiga, tarif harus diganti ke acuan saluran tersebut. Mengambil contoh APIYI apiyi.com, pada 2026-11-20 kami membaca kembali antarmuka penetapan harga publiknya; billing_expr untuk gpt-6.2-sol juga memotong tier pada 272.000 token input: tier pendek input biasa $2, pembacaan cache $0.10, penulisan cache $2.50, output $10; tier panjang masing-masing $3, $0.15, $3.75, $11.25 (USD / juta token). Terlihat bahwa rasio tier panjang berbeda dari koneksi langsung resmi, dan ekspresi antarmuka juga hanya mencantumkan satu harga penulisan cache. Pengelompokan, fitur, dan penagihan proyek aktual mengacu pada konfigurasi dan tagihan platform saat ini.
Kode berikut mengirim satu permintaan Responses melalui antarmuka kompatibel OpenAI milik APIYI, lalu mencetak usage apa adanya untuk dipakai dalam perhitungan ulang nanti:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "Aturan tetap dan materi publik (ditempatkan di depan agar mudah dipakai ulang oleh cache)"},
        {"role": "user", "content": "Pertanyaan spesifik untuk permintaan ini"},
    ],
    max_output_tokens=4000,
)

print(resp.id, resp.status)
print(resp.usage.model_dump())
Setelah mendapatkan usage, gunakan satu fungsi untuk mengonversi lima komponen penggunaan menjadi nominal uang. Jadikan tabel tarif sebagai parameter, sehingga saat beralih antara acuan resmi atau acuan saluran, cukup ubah konfigurasinya:
Lihat fungsi perhitungan ulang lengkap
LONG_THRESHOLD = 272_000

# Tarif Standar resmi OpenAI, USD / juta token
OFFICIAL_RATES = {
    "short": {"input": 2.00, "cached": 0.10, "w30m": 2.50, "w12h": 5.00, "output": 10.00},
    "long":  {"input": 4.00, "cached": 0.20, "w30m": 5.00, "w12h": 10.00, "output": 15.00},
}

def _get(d, *keys, default=None):
    for k in keys:
        if not isinstance(d, dict) or k not in d:
            return default
        d = d[k]
    return d

def recalc_cost(usage: dict, rates: dict = OFFICIAL_RATES) -> dict:
    total_in = usage["input_tokens"]
    details = usage.get("input_tokens_details") or {}
    cached = details.get("cached_tokens", 0) or 0

    # Posisi field write mengikuti struktur respons aktual, di sini kedua lokasi diperiksa
    write_total = details.get("cache_write_tokens", usage.get("cache_write_tokens"))
    ttl = details.get("cache_write_tokens_details") or usage.get("cache_write_tokens_details")
    if write_total is None:
        raise ValueError("cache_write_tokens tidak ada, gunakan catatan tagihan kanal, jangan berasumsi")
    w30 = _get(ttl, "ttl_30m_tokens")
    w12 = _get(ttl, "ttl_12h_tokens")
    if write_total and (w30 is None or w12 is None):
        raise ValueError("Detail masa pakai write tidak ada, tidak bisa membedakan tarif 30m/12h")
    w30, w12 = w30 or 0, w12 or 0

    plain = total_in - cached - write_total
    output = usage["output_tokens"]
    tier = "long" if total_in > LONG_THRESHOLD else "short"
    r = rates[tier]

    items = {
        "plain_input": plain * r["input"] / 1e6,
        "cache_read": cached * r["cached"] / 1e6,
        "write_30m": w30 * r["w30m"] / 1e6,
        "write_12h": w12 * r["w12h"] / 1e6,
        "output": output * r["output"] / 1e6,
    }
    items["tier"] = tier
    items["model_total"] = round(sum(v for k, v in items.items() if k != "tier"), 6)
    return items

# Verifikasi dengan usage sintetis dari bagian 2.2
demo = {
    "input_tokens": 12000,
    "input_tokens_details": {
        "cached_tokens": 4000,
        "cache_write_tokens": 7000,
        "cache_write_tokens_details": {"ttl_30m_tokens": 3000, "ttl_12h_tokens": 4000},
    },
    "output_tokens": 1800,
    "output_tokens_details": {"reasoning_tokens": 1200},
}
print(recalc_cost(demo))  # model_total: 0.0479
Fungsi ini langsung melempar error ketika ada field yang hilang, bukan memperlakukannya sebagai 0. Ini dilakukan agar permintaan yang tidak memiliki detail write tidak keliru dihitung sebagai “semuanya input biasa”.
🎯 Saran teknis: Saat membuat buku besar biaya, sebaiknya jalankan dulu fungsi rekalkulasi dengan usage sintetis sampai berhasil, baru kemudian sambungkan ke log asli. Melalui APIYI apiyi.com, Anda bisa memakai kunci API yang sama untuk mengirim permintaan uji dengan trafik kecil, lalu mencocokkan usage yang dikembalikan dengan tagihan platform baris per baris. Setelah definisi field-nya terkonfirmasi, barulah aktifkan statistik di produksi.
3 Memilih umur cache GPT-6.2 Sol sesuai ritme pemanggilan
3.1 Perhitungan untuk dua dan tiga kali akses pada prefiks yang sama
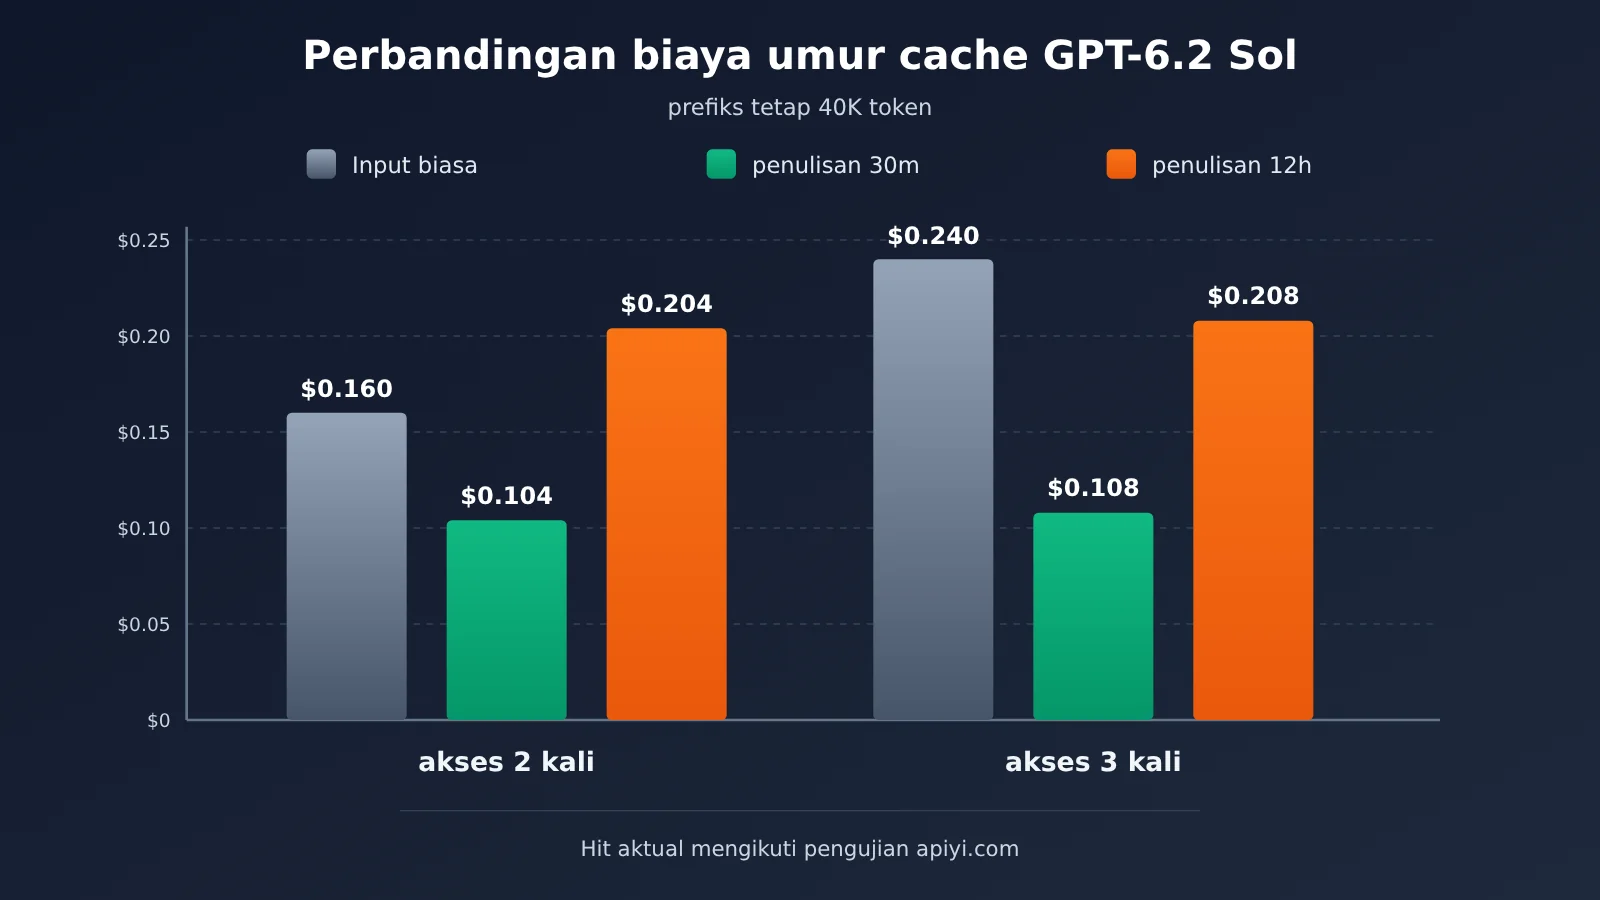
Misalkan ada prefiks tetap sepanjang 40.000 token (aturan sistem plus materi bersama), dengan tarif Standard konteks pendek. Biaya per jenis untuk satu kali adalah: input biasa $0.08 per pemanggilan, penulisan pertama dengan masa simpan 30 menit $0.10, penulisan pertama dengan masa simpan 12 jam $0.20, dan pembacaan saat cache hit penuh $0.004. Tabel berikut hanya membandingkan bagian prefiks tetap, tanpa konten variabel dan output per permintaan.
| Pola akses | Input biasa | Rencana tulis 30m | Rencana tulis 12h |
|---|---|---|---|
| Total 2 kali (1 tulis + 1 baca) | $0.160 | $0.104 | $0.204 |
| Total 3 kali (1 tulis + 2 baca, semuanya dalam jendela) | $0.240 | $0.108 | $0.208 |
Untuk dua kali akses, penulisan 12 jam malah lebih mahal $0.044 daripada tanpa cache. Untuk tiga kali akses, kedua opsi cache lebih murah daripada input biasa, tetapi opsi 30 menit tetap hanya sekitar setengah dari opsi 12 jam. Syaratnya, semua akses tersebut jatuh dalam jendela 30 menit.
3.2 Titik impas: berapa kali hit agar balik modal
Melihat angka-angka di atas dari sudut pandang lain akan lebih mudah dipahami (berikut adalah perhitungan berdasarkan tarif M3). Setiap hit penuh menghemat $0.076 dibandingkan input biasa. Penulisan 30 menit membayar $0.02 lebih mahal daripada input biasa, dan cukup satu kali hit untuk balik modal. Penulisan 12 jam membayar $0.12 lebih mahal, sehingga perlu setidaknya dua kali hit dalam jendela waktu tersebut agar balik modal.
Jadi nilai penulisan 12 jam bukanlah “lebih banyak hit dalam jendela yang sama”, melainkan masih bisa hit ketika interval pemanggilan melebihi 30 menit. Jika interval antara dua permintaan berturut-turut dengan prefiks yang sama biasanya hanya beberapa menit, penulisan 30 menit sudah cukup, dan memilih 12 jam hanya akan membayar biaya penulisan lebih. Jika permintaan datang setiap satu atau dua jam, cache 30 menit sudah lama kedaluwarsa dan setiap kali harus menulis ulang; di sinilah penulisan 12 jam ditambah beberapa kali hit berpotensi lebih hemat.
Ada dua hal lagi yang bisa mengubah penilaian. TTL adalah waktu cakupan penagihan minimum, bukan berarti cache pasti bertahan selama itu; yang menentukan adalah jumlah pembacaan aktual pada usage. Penulisan 30 menit memiliki aturan penyegaran saat pembacaan, sehingga dalam skenario frekuensi tinggi cakupan aktualnya bisa lebih lama dari 30 menit nominal. Karena itu, setelah memilih konfigurasi, tinjau kembali dengan catatan hit yang sebenarnya, bukan hanya melihat konfigurasi.
3.3 Tata letak breakpoint: letakkan konten stabil di depan
Cache hanya berlaku untuk prefiks, dan prefiks minimum yang dapat di-cache adalah 1.024 token input yang terlihat. Dalam praktik, breakpoint dapat diatur berlapis berdasarkan siklus penggunaan ulang:
- Materi publik siklus panjang, seperti panduan produk dan ringkasan repositori kode: letakkan paling depan, pertimbangkan penulisan 12 jam.
- Catatan sesi siklus pendek, seperti riwayat percakapan putaran ini: letakkan setelahnya, pertimbangkan penulisan 30 menit.
- Instruksi instan yang berubah setiap kali: letakkan paling akhir, jangan masuk ke cache.
GPT-6.2 memiliki detail posisi yang mudah terlewat: instructions di level teratas berada setelah breakpoint yang dapat di-cache. Jika aturan tetap ditulis di dalam instructions, bagian ini tidak dapat digunakan ulang. Aturan tetap lebih cocok dimasukkan ke pesan developer di bagian depan input, sedangkan instructions disisakan untuk konten yang mungkin disesuaikan pada setiap permintaan.
💡 Saran pemilihan: masa hidup cache harus ditentukan berdasarkan lalu lintas nyata. Sebaiknya kirim beberapa putaran permintaan dengan prefiks yang sama menggunakan ritme aktual di APIYI apiyi.com, catat kondisi hit pada
cached_tokens, lalu putuskan lapisan mana yang memakai 30 menit dan lapisan mana yang memakai 12 jam. Kanal yang berbeda mungkin memiliki penagihan penulisan cache yang berbeda; patokan adalah tagihan platform.
4 Merekap Biaya GPT-6.2 Sol per Alur Kerja dan Melacak Selisih
4.1 Tiga Status Permintaan yang Membuat Tagihan Tidak Sesuai Ekspektasi
Meski satu permintaan sudah dihitung dengan benar, total tagihan alur kerja tetap bisa tidak cocok. Penyebab umumnya berasal dari status permintaan:
- incomplete: Ketika output mencapai
max_output_tokens, respons bisa berakhir dengan statusincomplete. Saat itu mungkin belum ada teks yang terlihat, tetapi token input dan reasoning sudah dihasilkan dan ditagih. Kalau hanya menghitung permintaan yang «berhasil mengembalikan konten», biaya ini akan terlewat. - Tugas latar belakang: Tugas latar belakang yang sudah punya ID respons harus dilacak dengan ID yang sama saat polling; jangan menganggap setiap polling sebagai permintaan baru lalu mencatatnya berulang.
- Percobaan ulang (retry): Panggilan independen baru yang dipicu oleh timeout atau
incompleteakan menghasilkan respons baru, sehingga perlu dicatat terpisah. Semakin banyak retry, semakin sering biaya input untuk tugas yang sama dibayar berulang.
4.2 Biaya Alat dan Token Lanjutan yang Ditimbulkan Alat
Responses mendukung alat seperti pencarian file, pencarian web, interpreter kode, dan pembuatan gambar. Saat menggunakan pembuatan gambar, Sol memulai pemanggilan alat di dalam alur, gambar diselesaikan oleh alat gambar terpisah, dan biayanya dihitung menurut aturan alat. Biaya alat diperiksa berdasarkan jenis sebenarnya, misalnya pencarian web dihitung $10 per seribu panggilan, sedangkan token konten yang dikembalikan pencarian dihitung terpisah menurut tarif model.
Saat menghitung ulang, pastikan usage mencakup token apa saja. Ketika hasil alat dimasukkan kembali ke permintaan model berikutnya, hasilnya muncul sebagai peningkatan jumlah input pada permintaan lanjutan; biaya ini jatuh pada permintaan lanjutan, bukan pada pemanggilan alat itu sendiri. Untuk alur kerja dengan pencarian, tagihan biasanya terdiri dari dua bagian: «biaya jumlah panggilan alat + biaya permintaan model multi-putaran».
4.3 Item Log Minimal
Agar alur kerja dapat direkonsiliasi, setiap respons model minimal harus mencatat field berikut:
| Item Log | Fungsi |
|---|---|
| ID Alur Kerja | Mengelompokkan beberapa permintaan ke tugas yang sama |
| ID Respons | Menghubungkan polling latar belakang, membedakan retry dari permintaan yang sama |
| Model | Menentukan tabel tarif, seperti gpt-6.2-sol |
| Tingkat layanan | Memastikan apakah mengikuti basis Standard |
| Status akhir | Mengenali completed, incomplete, dan sebagainya |
| Rincian penggunaan | Input biasa, baca, tulis 30m, tulis 12h, output, reasoning |
| Alat | Jenis alat dan jumlah panggilan |
| Biaya | Jumlah yang dihitung ulang per item serta penanda tarif jangka panjang/pendek |
Dengan tabel ini, menjumlahkan berdasarkan grup ID alur kerja akan menghasilkan biaya per tugas. Penelusuran selisih juga punya urutan: pertama periksa apakah ada incomplete dan retry, lalu periksa apakah pembacaan cache lebih rendah dari perkiraan, terakhir verifikasi jumlah panggilan alat.
4.4 Saling Verifikasi antara Estimasi per Permintaan dan Ekspor Resmi
Estimasi per permintaan cocok untuk kontrol anggaran real-time, tetapi mudah melenceng saat ada pemanggilan alat multi-langkah, retry, atau field penggunaan yang hilang. Disarankan untuk secara berkala membandingkan ringkasan estimasi dengan ekspor penggunaan atau biaya resmi; jika selisih melebihi ambang batas yang ditetapkan, kembali ke log dan periksa baris per baris. Saat diakses melalui kanal pihak ketiga, objek pembanding harus diganti dengan field penagihan dan tarif dari kanal tersebut.
💰 Saran biaya: Jika tim menggunakan beberapa model sekaligus, Anda dapat memanggil semuanya dengan satu API Key melalui APIYI apiyi.com, lalu menyimpannya ke database sesuai item log minimal dalam artikel ini. Pintu masuk terpadu membuat ID alur kerja dan dasar perhitungan biaya tetap konsisten, sehingga saat rekonsiliasi akhir bulan tidak perlu satu lapisan konversi kanal lagi.
Metode Verifikasi Tagihan GPT-6.2 Sol
Jika Anda memiliki catatan permintaan Sol apa pun, Anda bisa memverifikasi tagihan dengan urutan berikut: pertama, pastikan total input melebihi 272K atau tidak, lalu pilih kolom tarif yang sesuai; selanjutnya kurangi input_tokens dengan jumlah pembacaan cache dan seluruh penulisan untuk mendapatkan input biasa; kemudian kalikan masing-masing dari lima komponen dengan tarifnya lalu jumlahkan, dan bandingkan hasilnya dengan tagihan. Kalau satu permintaan sudah cocok tetapi total alur kerja tidak, telusuri log untuk mencari incomplete, percobaan ulang, dan pemanggilan alat.
Apakah cache menguntungkan atau tidak, pada akhirnya ditentukan oleh jumlah pembacaan aktual di usage dan interval antar pemanggilan. Untuk penulisan 30 menit, cukup satu kali hit untuk balik modal; untuk penulisan 12 jam, dibutuhkan setidaknya dua kali hit dalam jendela waktu, dan keunggulannya baru terasa ketika interval pemanggilan melebihi 30 menit.
Ketika Anda ingin memverifikasi kesimpulan ini dengan traffic nyata, Anda bisa mengajukan kuota pengujian gratis di APIYI apiyi.com, lalu mencocokkan tagihan platform satu per satu menggunakan fungsi perhitungan ulang yang ada di artikel ini.
📚 Referensi
-
Pengumuman Rilis OpenAI GPT-6.2 Astra dan Sol: Waktu rilis dan posisi produk
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Penjelasan: Memahami posisi Sol yang ditujukan untuk pekerjaan sehari-hari dan Agent multi-langkah
- Tautan:
-
Kartu Model GPT-6.2 Sol: Spesifikasi konteks, tarif, dan pengali konteks panjang
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol - Penjelasan: Sumber tabel tarif dan aturan pembagian tingkat 272K dalam artikel ini
- Tautan:
-
Panduan Prompt Caching dan Diagnostik Cache: Field cache, TTL, dan aturan titik henti
- Tautan:
developers.openai.com/api/docs/guides/prompt-caching - Penjelasan: Menjelaskan cached_tokens, masa hidup penulisan, dan prefiks minimum yang dapat di-cache
- Tautan:
-
Panduan Reasoning: Token penalaran dan status incomplete
- Tautan:
developers.openai.com/api/docs/guides/reasoning - Penjelasan: Memahami bagaimana penggunaan penalaran dihitung ke dalam output
- Tautan:
-
Panduan Kontrol Biaya per Alur Kerja: Merangkum biaya Responses berdasarkan alur kerja
- Tautan:
developers.openai.com/cookbook/articles/per_run_spending_controller_responses_api - Penjelasan: Implementasi referensi untuk kontrol anggaran tingkat alur kerja
- Tautan:
-
Daftar Model APIYI: Informasi kanal terdaftar dan titik masuk
- Tautan:
docs.apiyi.com/models.md - Penjelasan: Lihat titik masuk dan grup yang tersedia untuk gpt-6.2-sol
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda APIYI apiyi.com, dan untuk materi integrasi lebih lanjut kunjungi pusat dokumentasi docs.apiyi.com