Catatan penulis: Membandingkan Qwen4-Max dan Kimi K3.1 Pro dari lima dimensi—keterbukaan bobot, tugas terminal, pengiriman tugas panjang, visual-video, dan biaya per juta token—serta menjelaskan mengapa skor Terminal-Bench resmi dari kedua pihak tidak konsisten.
Kesimpulan di awal: Jika Anda perlu mendapatkan bobot untuk fine-tuning, kuantisasi, atau deployment privat, pilih Kimi K3.1 Pro; jika Anda membutuhkan API terkelola, sekaligus mementingkan kemampuan visual, video, pengiriman tugas panjang, dan ingin menekan biaya per juta token serendah mungkin, pilih Qwen4-Max. Jika beban inti Anda adalah agent baris perintah di terminal, Kimi K3.1 Pro saat ini memiliki keunggulan yang jelas.
Ini bukan analisis kompromi yang mengatakan “masing-masing punya kelebihan”. Semua angka di bawah ini mencantumkan sumbernya: angka Qwen berasal dari blog resmi Alibaba dan perbandingan gambar yang sama dari laporan resmi mereka sendiri, angka Kimi berasal dari dokumentasi resmi Moonshot, data pihak ketiga berasal dari snapshot publik papan peringkat arena (2026-11-14). Mengapa benchmark yang sama yang dilaporkan kedua pihak tidak cocok, akan dibahas secara terpisah di artikel ini.
Nilai inti: Setelah membaca artikel ini, Anda akan mendapatkan garis pemisah pemilihan yang jelas, dan mengetahui cara mengonversi dua keunggulan “lebih murah” dan “bisa mendapatkan bobot” ke tugas Anda sendiri.
Perbedaan Inti Qwen4-Max vs Kimi K3.1 Pro
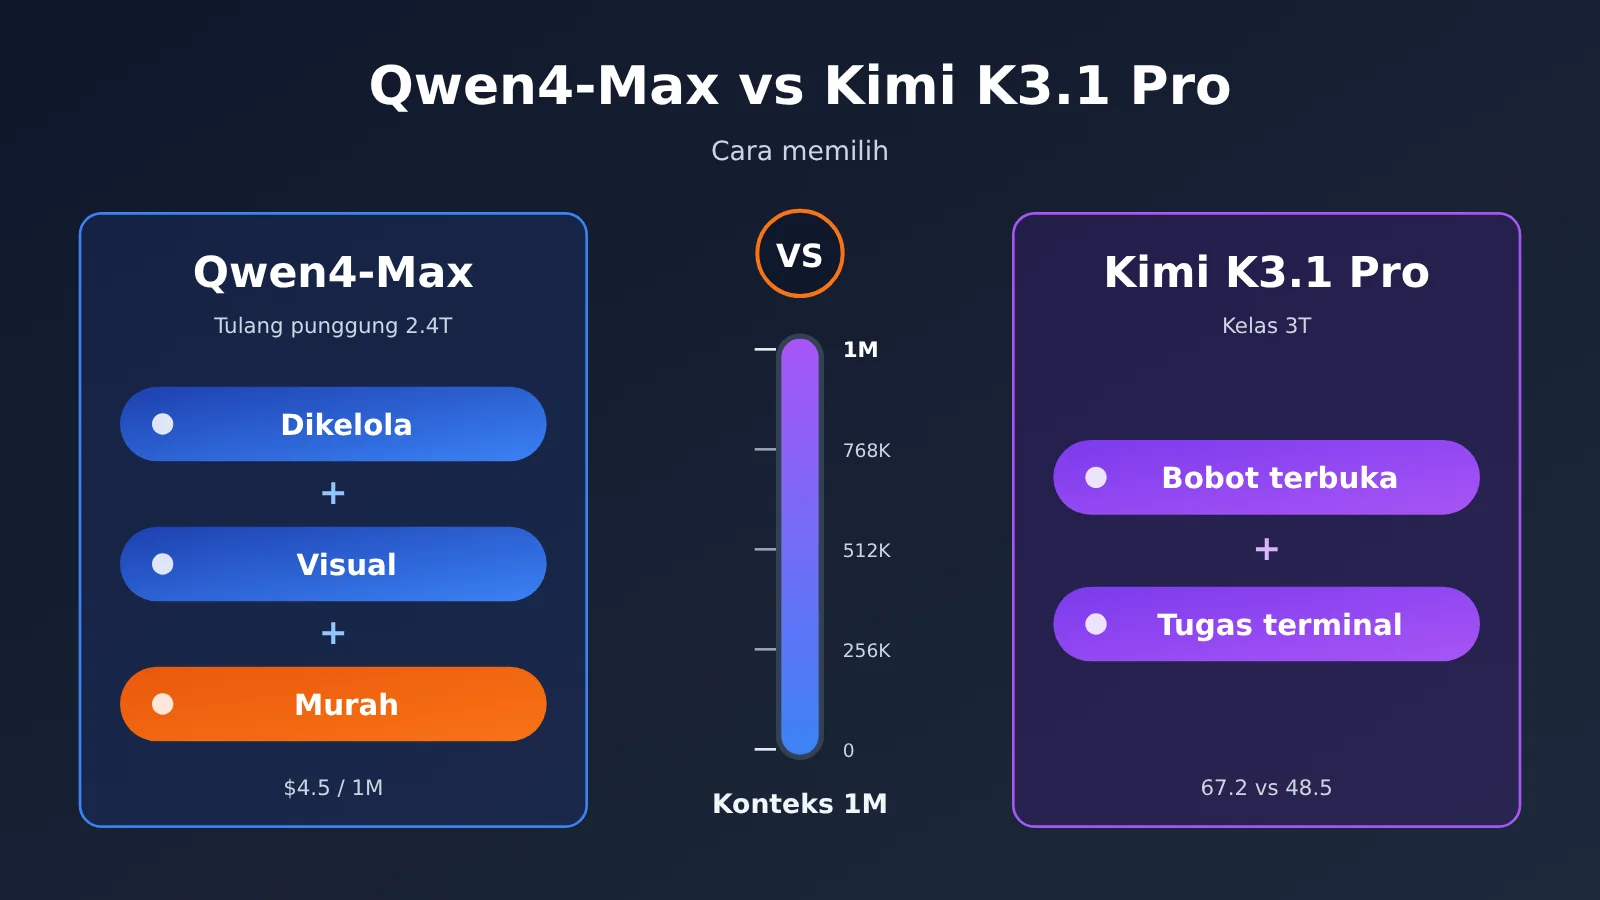
Kedua model ini adalah jagoan kelas atas asal Tiongkok pada paruh kedua 2026. Jendela konteks keduanya berada di level 1M, parameter permukaannya mirip, tetapi positioning-nya sangat berbeda. Qwen4-Max memakai tulang punggung 2.4T dengan 71B parameter aktif, ditambah 328B N-gram Embedding, mendukung visual secara native, output maksimum 393K, rantai berpikir maksimum 262K, dan reasoning_effort bawaannya adalah high. Kimi K3.1 Pro adalah model pertama dari seri K3.1, masuk kelas 3T, dan menurut pihak resmi merupakan model berbobot terbuka kelas 3T dengan kemampuan terkuat; konteksnya 1.048.576 token.
| Dimensi perbandingan | Qwen4-Max | Kimi K3.1 Pro | Kecenderungan |
|---|---|---|---|
| Skala | Tulang punggung 2.4T / 71B aktif + 328B N-gram Embedding | Kelas 3T | — |
| Bobot | Materi publik hanya menyebut API terkelola QwenCloud | Bobot terbuka | Kimi |
| Konteks | 1M, output maksimum 393K | 1.048.576 token | Seimbang |
| Tugas terminal (grafik yang sama dengan Alibaba) | 48.5 | 67.2 | Kimi |
| Tugas panjang dan pengiriman industri | Unggul di banyak hal | AutomationBench sedikit lebih tinggi | Qwen4 |
| Visual dan video | Visual native, unggul pada metrik grafik dan video | Metrik tertinggal | Qwen4 |
| Harga per 1M output | $4.5 | $10 | Qwen4 |
Ringkasnya: keunggulan Kimi terletak pada “bisa dimodifikasi” dan “bisa menjalankan terminal”, sedangkan keunggulan Qwen4 terletak pada “cakupan pengiriman yang luas” dan “lebih murah”. Berikut pembahasan per lima dimensi.
Kimi K3.1 Pro dan Qwen4-Max: Bisakah Bobotnya Diubah?
Inilah garis pemisah paling tegas antara keduanya. Kimi K3.1 Pro adalah model dengan bobot terbuka (open-weight), sehingga tim bisa menariknya ke klaster sendiri untuk melakukan fine-tuning domain, kompresi kuantisasi, distilasi, atau deploy secara offline di lingkungan dengan persyaratan kepatuhan yang ketat. Bagi tim yang memang perlu “mengubah modelnya sendiri”, tidak ada alternatif untuk poin ini — skor benchmark setinggi apa pun tidak bisa menggantikannya.
Untuk Qwen4-Max, materi publik yang ada saat ini hanya menyebutkan penyediaan lewat QwenCloud sebagai API terkelola, dan tidak disebutkan adanya bobot terbuka. Keuntungan layanan terkelola adalah Anda tidak perlu mengurus GPU, framework inferensi, dan penskalaan; kerugiannya, Anda hanya bisa menyesuaikan model dengan bisnis Anda melalui petunjuk, konteks, dan pemanggilan tool. Perlu ditegaskan bahwa bobot terbuka sendiri tidak otomatis berarti lebih aman — keamanan tetap bergantung pada proses deployment, kontrol akses, dan audit Anda.
Cara menimbangnya: jika Anda hanya “memanggil model”, nilai bobot terbuka bagi Anda kira-kira nol; jika Anda jelas-jelas ingin melakukan fine-tuning atau privatisasi, Kimi adalah satu-satunya pilihan dalam perbandingan ini, dan beberapa dimensi berikutnya hanya dipakai untuk menilai apakah ia “cukup memadai”.
Qwen4-Max vs Kimi K3.1 Pro: siapa yang lebih kuat dalam tugas terminal
Tugas terminal adalah skenario ketika model membaca dan menulis file, menjalankan perintah, serta memperbaiki kesalahan secara iteratif berdasarkan pesan error di lingkungan command line. Ini adalah skenario yang paling mendekati pekerjaan nyata bagi agent coding. Dalam hal ini, Kimi K3.1 Pro jelas lebih kuat: dalam perbandingan pada grafik yang sama yang dilaporkan resmi Alibaba, Qwen4-Max memperoleh skor Terminal-Bench 4.0 sebesar 48.5, sedangkan Kimi K3.1 memperoleh 67.2. Selisihnya 18.7 poin, dan ini adalah item dengan ketertinggalan terbesar bagi Qwen4 di seluruh grafik.
Mengapa skor Terminal-Bench kedua pihak berbeda
Ada detail yang mudah terlewat: Kimi K3.1 Pro yang sama memiliki skor Terminal-Bench 4.0 yang berbeda di materi resmi kedua pihak.
| Sumber | Kimi K3.1 Pro | Referensi lain |
|---|---|---|
| Dokumentasi resmi Moonshot | 65.7% | Claude Opus 5.5 sebesar 66.4%, GPT-6 Astra sebesar 58.2% |
| Perbandingan pada grafik yang sama, laporan resmi Qwen | 67.2 | Qwen4-Max sebesar 48.5 |
Di materi Kimi sendiri tertulis 65.7%, sedangkan di grafik Alibaba, Kimi ditandai 67.2. Selisihnya 1.5 poin. Perbedaan ini berasal dari harness evaluasi (framework agen, definisi tool, strategi timeout dan retry), pengaturan reasoning effort, serta versi kumpulan soal yang berbeda. Ini tidak bisa ditafsirkan sebagai salah satu pihak memalsukan data, dan kedua angka juga tidak boleh digabung menjadi satu “skor tugas terminal Kimi” untuk dikutip. Demikian pula, Claude Opus 5.5 di dokumentasi Moonshot adalah 66.4%, tetapi jika ditempatkan dalam kerangka evaluasi Alibaba, angkanya juga akan berbeda. Menyusun peringkat dengan mencampur data antar-dokumen tidak valid.
Cara membacanya yang tepat: bandingkan posisi relatif hanya dalam grafik yang sama dan harness yang sama. Dalam skala Moonshot, Kimi sedikit di bawah Opus 5.5 dan jelas di atas GPT-6 Astra; dalam skala Alibaba, Kimi jauh unggul atas Qwen4-Max. Kedua kesimpulan valid dan arahnya konsisten—kemampuan terminal Kimi K3.1 Pro berada di kelas teratas.
🎯 Saran teknis: Skor benchmark dapat bervariasi tergantung harness dan effort. Cara paling andal adalah menjalankan satu kali pengujian dengan framework agen dan tugas nyata Anda sendiri. Melalui APIYI (apiyi.com), Anda dapat memanggil model seperti
kimi-k3.1-prodengan kunci API yang sama, tanpa mengubah framework dan hanya mengganti parametermodel; perbandingan yang dihasilkan baru akan bermakna.
Hal terkait lainnya adalah metrik lain untuk tugas coding. Pada grafik yang sama dari Alibaba, DeepSWE v1.1 membuat keduanya hampir imbang (75.7 vs 75.5), sedangkan pada ProgramBench, Qwen4-Max lebih tinggi 6.5 poin (31.5 vs 25.0). Dokumentasi resmi Moonshot juga mencantumkan Kimi Code Bench 3.0 Long-horizon sebesar 61.2%, meningkat signifikan dibandingkan generasi sebelumnya K3 sebesar 55.95%. Jadi, pernyataan yang akurat adalah: Kimi unggul dalam interaksi terminal, sementara Qwen4 tidak kalah pada sebagian tugas coding non-terminal.
Qwen4-Max dan Kimi K3.1 Pro: Tugas Panjang dan Penyampaian Industri
Jika agent Anda bertugas “menyelesaikan suatu pekerjaan secara utuh”—merapikan laporan, menuntaskan alur bisnis, menangani masalah di bidang profesional—Qwen4-Max tampil lebih baik dalam grafik yang sama dari Alibaba. Tabel berikut mengutip metrik terkait tugas panjang dan skenario industri dari perbandingan pada grafik yang sama yang dilaporkan sendiri secara resmi oleh Qwen.
| Benchmark (grafik yang sama, dilaporkan sendiri oleh Qwen) | Qwen4-Max | Kimi K3.1 | Selisih |
|---|---|---|---|
| JobBench | 68.5 | 61.2 | Qwen4 lebih tinggi 7.3 |
| APEX-Agents v1.1 | 72.1 | 65.5 | Qwen4 lebih tinggi 6.6 |
| HLAB-Vals-1.1 | 21.3 | 11.7 | Qwen4 lebih tinggi 9.6 |
| AA-Briefcase v1.1 Elo | 1686 | 1674 | Qwen4 lebih tinggi 12 |
| AgentArena Net Improvement | 7.5 | 3.9 | Qwen4 lebih tinggi 3.6 |
| AutomationBench-AA | 72.5 | 73.3 | Kimi lebih tinggi 0.8 |
| BioMysteryBench | 85.0 | 80.6 | Qwen4 lebih tinggi 4.4 |
| HealthBench Professional | 60.0 | 57.2 | Qwen4 lebih tinggi 2.8 |
| Humanity’s Last Exam | 51.7 | 51.1 | Hampir imbang |
Pola data ini sangat jelas: Qwen4-Max unggul di sebagian besar tugas profesional, penyampaian hasil oleh agent, dan bidang profesional seperti biomedis, dengan margin 3 hingga 10 poin; Kimi hanya unggul tipis 0.8 poin pada AutomationBench-AA, sedangkan HLE keduanya hampir sama. Perlu diingat bahwa ini adalah kerangka evaluasi dari pihak Alibaba, sehingga angka Kimi di harness miliknya sendiri bisa berbeda.
Output maksimum 393K dan rantai pemikiran maksimum 262K milik Qwen4-Max juga sangat praktis untuk tugas panjang. Artinya, dalam satu pemanggilan dapat dihasilkan laporan atau file kode yang sangat panjang tanpa perlu sering memecah dan menggabungkan, sehingga mengurangi titik kesalahan dalam orkestrasi agent.
Kemampuan visual dan video Qwen4-Max serta Kimi K3.1 Pro
Qwen4-Max mendukung input visual secara native, dan hal ini juga tercermin pada Alibaba Tongyi: pada benchmark pemahaman diagram Chartography, Qwen4 memperoleh 54.2 dan Kimi 50.0; pada benchmark pemahaman video Video-Index, Qwen4 memperoleh 68.1 dan Kimi 63.2, masing-masing unggul 4.2 dan 4.9 poin.
Bagi bisnis yang perlu membaca screenshot, menganalisis diagram laporan, memahami rekaman layar produk, atau melakukan analisis konten video, Qwen4-Max adalah pilihan yang lebih praktis. Kimi juga memiliki skor pada kedua bidang ini, tetapi jika visual menjadi beban utama, selisihnya akan semakin terasa saat diskalakan.
Untuk pembuatan front-end, kita bisa melihat data pihak ketiga. Dalam snapshot papan publik arena (2026-11-14) pada Code Arena WebDev, Qwen4-Max (xHigh) berada di peringkat 6 dengan 1750 poin, tetapi masih ditandai sebagai Preliminary dengan 1,814 suara; Kimi K3.1 Pro (Max) berada di peringkat 13 dengan 1686 poin dan 5,215 suara, serta tidak lagi berstatus preliminary. Skor Qwen4 lebih tinggi, tetapi sampelnya lebih sedikit, sehingga peringkatnya masih mungkin berubah di kemudian hari.
Bagaimana cara menghitung biaya Qwen4-Max vs Kimi K3.1 Pro
Harga resmi terdaftar (per 1 juta token, tanggal pengambilan data 2026-11-16)
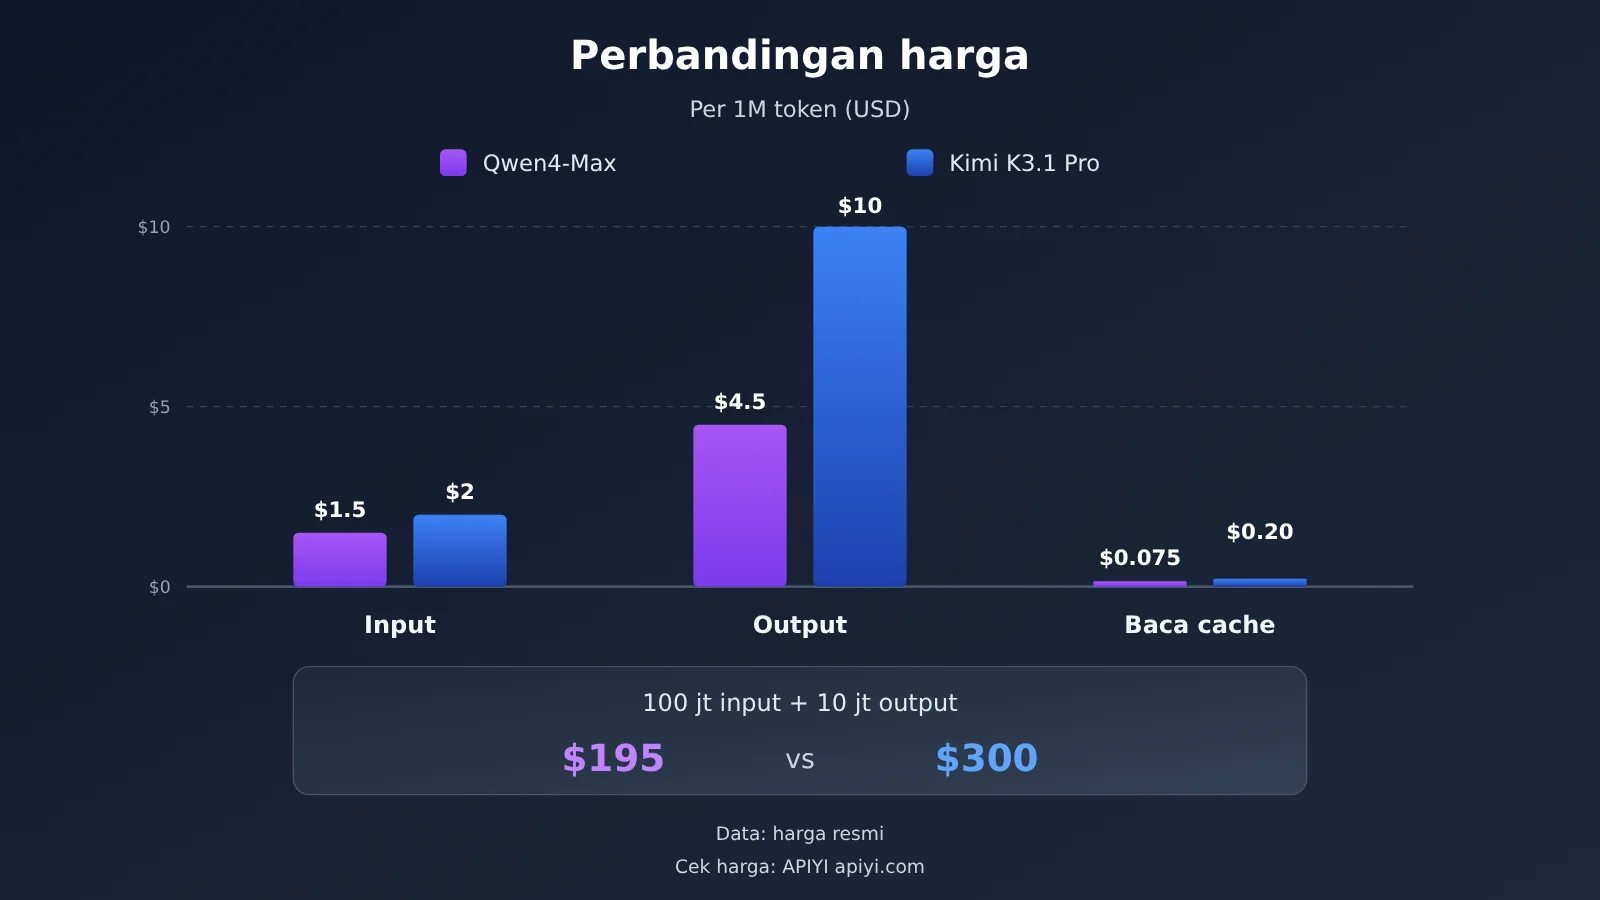
| Item penagihan | Qwen4-Max(QwenCloud) | Kimi K3.1 Pro(Moonshot) | Kimi K3.1 Pro Highspeed |
|---|---|---|---|
| Input | $1.5 | $2 | $4 |
| Output | $4.5 | $10 | $20 |
| Pembacaan cache / cache hit | $0.075 | $0.20 | $0.20 |
| Penulisan cache 5 menit | $1.875 | $2 | — |
| Penulisan cache 1 jam | $3 | $4 | — |
Dikonversi berdasarkan harga resmi, harga input Qwen4-Max adalah 75% dari Kimi, harga output 45%, dan pembacaan cache hanya 37,5%. Dengan estimasi beban kerja agent tipikal “100 juta input + 10 juta output”, Qwen4-Max sekitar $195, sedangkan Kimi K3.1 Pro sekitar $300. Kimi juga memiliki mode Batch dengan harga 60% dari harga standar, cocok untuk tugas batch offline; versi Highspeed berharga dua kali lipat sebagai imbalan kecepatan sekitar 2 hingga 3 kali.
Token satuan murah bukan berarti tugas satuan murah
Ini adalah hal yang paling berlawanan dengan intuisi dalam dimensi biaya. Snapshot arena menunjukkan biaya per tugas Qwen4-Max (xHigh) sebesar $4.18, sedangkan Kimi K3.1 Pro (Max) hanya $0.89. Qwen4 lebih murah per token, tetapi biaya per tugasnya beberapa kali lebih mahal. Penyebabnya adalah pada tingkat effort tinggi, model menghasilkan banyak token rantai pemikiran, dengan volume output yang jauh melebihi Kimi.
Karena itu, saat menghitung biaya sebenarnya, lihatlah “harga × konsumsi token aktual”. reasoning_effort default Qwen4-Max adalah high; jika tugas tidak memerlukan penalaran mendalam, turunkan effort secara aktif agar keunggulan harga satuan dapat diwujudkan menjadi keunggulan biaya total.
Harga saat ini APIYI (2026-11-16)
| ID model | Input | Output | Pembacaan cache | Status |
|---|---|---|---|---|
kimi-k3.1-pro |
$2 | $10 | $0.2 | Telah tersedia |
kimi-k3.1-pro-highspeed |
$4 | $20 | $0.2 | Telah tersedia |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Telah tersedia |
qwen4-max |
— | — | — | Belum tersedia, kami akan segera menyediakannya |
Di atas adalah harga per 1 juta token. qwen4-max saat ini belum muncul dalam daftar model APIYI; kami akan segera menghadirkan model ini. Sementara itu, Anda dapat menggunakan qwen3.8-max untuk menyiapkan jalur pemanggilan. Semua nama model dan harga mengacu pada daftar model platform APIYI apiyi.com; sebelum mengganti model, disarankan untuk memeriksa model, mencocokkan harga, lalu mengonfirmasi protokol pemanggilan.
Cara Memanggil Kimi K3.1 Pro dan Seri Qwen melalui APIYI
APIYI menyediakan antarmuka yang kompatibel dengan OpenAI, jadi saat mengintegrasikan hanya perlu tiga perubahan dan tidak perlu mengganti SDK:
- Setel base_url klien ke
https://api.apiyi.com/v1, dengan jalur permintaan/chat/completions; - Isi API Key yang didapatkan dari konsol APIYI;
- Setel parameter
modelkekimi-k3.1-pro,kimi-k3.1-pro-highspeed, atauqwen3.8-max; begituqwen4-maxtersedia, cukup ganti nama modelnya.
Saat melakukan perbandingan A/B, sebaiknya pertahankan petunjuk, definisi tool, dan tingkat effort tetap sama, lalu hanya ubah kolom model, serta catat input, output, dan jumlah token cache dari setiap pemanggilan. Dengan begitu, kamu tidak hanya bisa mereproduksi fenomena “harness mengubah skor” yang dibahas sebelumnya, tetapi juga menghitung biaya nyata per tugas di bisnismu untuk kedua model.
🚀 Mulai cepat: Pengguna baru yang mendaftar di APIYI apiyi.com akan mendapatkan kuota uji coba gratis. Kamu bisa menggunakan Key yang sama untuk berpindah antara seri Kimi dan Qwen, validasi hasilnya dengan trafik kecil terlebih dahulu, lalu memutuskan model utama untuk lingkungan produksi.
Rekomendasi Skenario untuk Qwen4-Max dan Kimi K3.1 Pro
Kapan Memilih Kimi K3.1 Pro
- Privatisasi dan fine-tuning: Membutuhkan bobot terbuka untuk fine-tuning domain, kuantisasi, atau deployment offline;
- Agent coding di terminal: Beban utama berupa siklus baca, tulis, eksekusi, dan perbaikan di baris perintah;
- Pemrosesan batch offline: Bisa menerima hasil asinkron dan memanfaatkan Batch dengan diskon 40% untuk menekan biaya;
- Interaksi latensi rendah: Jika sensitif terhadap kecepatan, pilih versi Highspeed untuk menukar harga dengan kecepatan 2 hingga 3 kali lipat.
Kapan Memilih Qwen4-Max
- Prioritas layanan terkelola: Tidak ingin memelihara klaster inferensi, hanya butuh API yang stabil;
- Visual dan video: Pemahaman tangkapan layar, parsing grafik, dan analisis video menjadi input utama;
- Penyelesaian tugas panjang: Pembuatan laporan, agent proses bisnis, serta tanya jawab profesional seperti medis dan biologi;
- Sensitif terhadap biaya per token: Dengan effort yang terkontrol, biaya per juta token menjadi yang terendah.
Saran Keputusan: Qwen4-Max vs Kimi K3.1 Pro
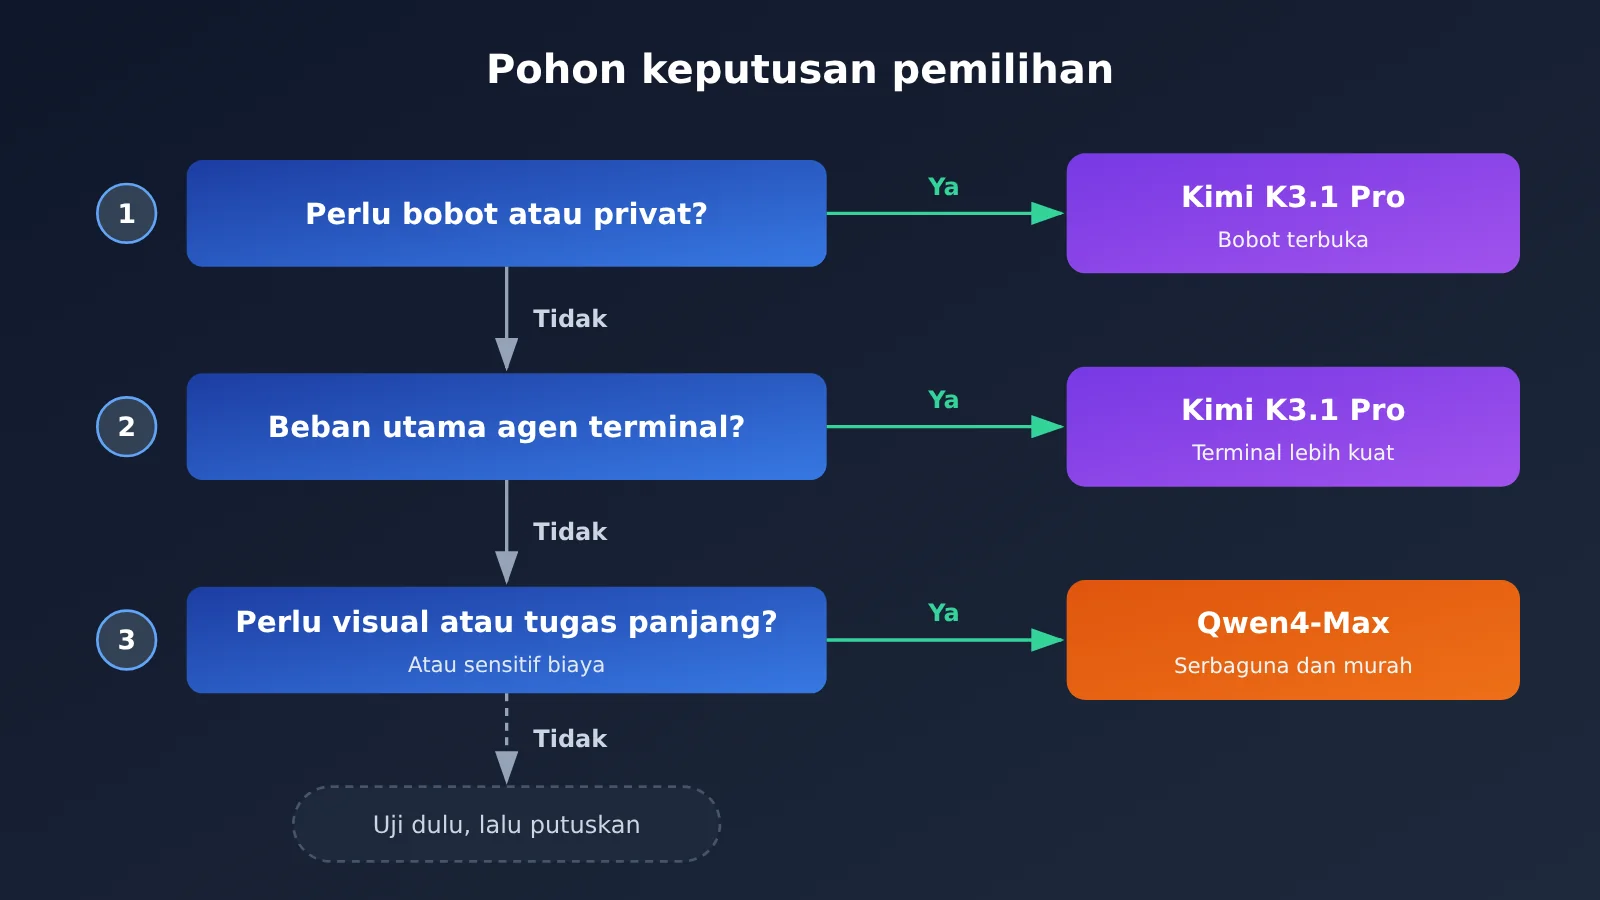
Lima dimensi diringkas menjadi tiga pertanyaan: Pertama, apakah kamu wajib mendapatkan bobot (weight) modelnya? Jika ya, langsung pilih Kimi K3.1 Pro. Kedua, apakah beban kerja utamamu adalah agen baris perintah terminal? Jika ya, Kimi lebih stabil. Ketiga, jika keduanya bukan, maka Qwen4-Max unggul dalam hal visual, penyelesaian tugas panjang, dan harga satuan.
Pemakaian campuran juga merupakan praktik umum: pakai Kimi K3.1 Pro untuk eksekusi terminal, dan pakai seri Qwen untuk pemahaman visual serta penyelesaian laporan. Orkestrasi seperti ini menuntut kedua model berjalan di antarmuka yang sama, dan gateway terpadu bisa menghemat banyak pekerjaan adaptasi.
💡 Saran pemilihan: Pemilihan model akhirnya bergantung pada distribusi tugasmu. Kami menyarankan menjalankan satu putaran perbandingan dengan tugas nyata di APIYI apiyi.com, mencatat tingkat keberhasilan dan konsumsi token kedua sisi menggunakan
base_urlyang sama, lalu memutuskan model utama.
FAQ Umum
Q1: Apa perbedaan terbesar antara Qwen4-Max dan Kimi K3.1 Pro?
Kimi K3.1 Pro adalah model berbobot terbuka kelas 3T yang bisa kamu deploy dan fine-tune sendiri; Qwen4-Max disediakan dalam bentuk API terkelola, visual native, dan harga terdaftar lebih rendah. Yang pertama unggul pada tugas terminal, yang kedua unggul pada visual dan penyelesaian tugas panjang.
Q2: Terminal-Bench Kimi K3.1 Pro sebenarnya 65,7 atau 67,2?
Keduanya benar, tapi metriknya berbeda. 65,7% berasal dari dokumen resmi Moonshot, sedangkan 67,2 berasal dari perbandingan gambar yang sama yang dilaporkan sendiri oleh pihak Qwen; perbedaannya berasal dari harness, effort, dan versi kumpulan soal. Saat mengutip wajib mencantumkan sumbernya, tidak boleh dicampur, dan tidak boleh menyambung peringkat dari dokumen berbeda.
Q3: Apakah panjang konteks keduanya sama?
Pada dasarnya sama. Kimi K3.1 Pro adalah 1.048.576 token, Qwen4-Max 1M. Qwen4-Max juga mempublikasikan output maksimum 393K dan rantai pemikiran (chain of thought) maksimum 262K, yang lebih ramah untuk output panjang sekali jalan.
Q4: Kenapa harga satuan Qwen4-Max lebih rendah, tapi biaya per tugas di arena justru lebih tinggi?
Dalam snapshot arena, Qwen4-Max memakai tingkat xHigh, konsumsi token rantai pemikirannya besar, sehingga biaya per tugas $4,18, sedangkan Kimi K3.1 Pro (Max) $0,89. Biaya nyata sama dengan harga satuan dikalikan konsumsi token; hanya dengan menurunkan `reasoning_effort` keunggulan harga satuan itu bisa terwujud.
Q5: Apakah sekarang Qwen4-Max sudah bisa dipanggil lewat APIYI?
`qwen4-max` belum tersedia di platform, kami akan segera menambahkannya. Saat ini di APIYI apiyi.com kamu bisa memanggil `kimi-k3.1-pro`, `kimi-k3.1-pro-highspeed`, dan `qwen3.8-max`, dengan base_url `https://api.apiyi.com/v1`; model dan harga mengacu pada daftar model platform.
Q6: Apa saja kekurangan yang sudah diketahui dari masing-masing model?
Qwen4-Max tertinggal jelas pada tugas terminal (48,5 vs 67,2 pada gambar yang sama dari Alibaba), peringkat arena-nya masih Preliminary, dan effort tinggi bawaan bisa mendorong biaya per tugas naik. Harga output Kimi K3.1 Pro lebih dari dua kali lipat Qwen4, dan ia tertinggal pada visual, video, serta sebagian besar metrik penyelesaian industri.
Poin Penting Perbandingan Qwen4-Max vs Kimi K3.1 Pro
- Bobot model adalah pembeda utama: Untuk fine-tuning atau deployment privat, hanya Kimi K3.1 Pro yang menjadi opsi.
- Kimi unggul di tugas terminal: Pada grafik yang sama dari Alibaba, Kimi memimpin Qwen4-Max dengan selisih 18.7 poin.
- Skor benchmark tergantung metodologi: 65.7 dan 67.2 berasal dari harness yang berbeda, tidak bisa dicampur.
- Qwen4 unggul dalam delivery dan visi: JobBench, APEX-Agents, Video-Index, dan beberapa lainnya memimpin.
- Harga satuan Qwen4 lebih rendah: Harga output hanya 45% dari Kimi, tetapi tetap perlu mengontrol effort.
- Cara memulai: Di APIYI, gunakan Key yang sama untuk beralih antara
kimi-k3.1-prodan seri Qwen sebagai pembanding.
Ringkasan
Kesimpulan inti dari perbandingan Qwen4-Max vs Kimi K3.1 Pro:
- Apakah model bisa diubah: Bobot terbuka adalah keunggulan eksklusif Kimi K3.1 Pro;
- Terminal dan delivery: Kimi unggul pada agent command line, Qwen4-Max unggul pada delivery tugas panjang, visi, dan video;
- Biaya: Qwen4-Max paling murah per juta token, tetapi tagihan nyata bergantung pada konsumsi token yang timbul dari effort.
Skor benchmark hanya bisa menunjukkan arah; jawaban akhir harus Anda dapatkan pada tugas Anda sendiri. Disarankan menjalankan satu ronde perbandingan dengan trafik kecil melalui antarmuka terpadu APIYI apiyi.com. Setelah qwen4-max tersedia, Anda juga bisa langsung mengganti model untuk melanjutkan verifikasi.
📚 Referensi
-
Blog Resmi Qwen4-Max: spesifikasi model, jendela konteks, dan harga QwenCloud
- Tautan:
qwen.ai/blog?id=qwen4-max - Keterangan: berisi data perbandingan gambar yang sama (same-image comparison) sesuai laporan resmi Qwen sendiri
- Tautan:
-
Panduan Cepat Kimi K3.1 Pro: dokumentasi resmi Moonshot
- Tautan:
platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart.md - Keterangan: berisi skor Terminal-Bench 4.0 dan Kimi Code Bench 3.0 sesuai laporan resmi Moonshot sendiri
- Tautan:
-
Harga Model Percakapan Kimi: halaman harga resmi Moonshot
- Tautan:
platform.kimi.ai/docs/pricing/chat.md - Keterangan: aturan penagihan versi Standar, versi Highspeed, dan Batch
- Tautan:
-
Arena Code Arena WebDev: cuplikan papan peringkat publik, 2026-11-14
- Tautan:
arena.ai - Keterangan: peringkat berdasarkan voting pihak ketiga serta biaya per tugas
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami lewat halaman utama situs APIYI; materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com