Catatan penulis: Pisahkan peringkat komprehensif pihak ketiga, klaim resmi per tugas, dan daftar harga resmi untuk GPT-6.2 Astra vs Claude Fable 5.2 ke dalam tiga lapisan; jelaskan perbedaan pembacaan cache dan model mana yang saat ini dapat dipanggil di APIYI.
Pada 2026-11-17, OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol. Sekitar seminggu sebelumnya, pada 2026-11-09, dokumentasi Anthropic menampilkan Claude Fable 5.2. Harga input konteks pendek dan output kedua model unggulan sama-sama USD 8 dan USD 40 per 1 juta token, sehingga diskusi pemilihan model secara alami berpusat pada GPT-6.2 Astra dan Claude Fable 5.2.
Masalahnya, kedua jenis peringkat menunjukkan arah yang tidak sejalan. Dalam indeks komprehensif Artificial Analysis pihak ketiga, skor Fable 5.2 lebih tinggi. Dalam beberapa tugas profesional yang dilaporkan sendiri di pengumuman rilis OpenAI, Astra unggul, dan biaya per tugas yang diberikan resmi juga lebih rendah. Jika kedua set angka dicampur, akan muncul kesimpulan tentang “siapa yang lebih kuat”, tetapi data dari kedua sisi tidak cukup menopang kesimpulan itu.
Ini bukan artikel yang menyatakan siapa pemenangnya. Artikel ini membagi angka menjadi tiga lapisan: peringkat komprehensif pihak ketiga, klaim resmi per tugas, dan daftar harga resmi. Setiap lapisan dilihat secara terpisah, lalu di akhir dijelaskan model mana yang saat ini dapat dipanggil di APIYI.
Nilai inti: Setelah membaca artikel ini, Anda dapat memeriksa peringkat yang sesuai berdasarkan tugas yang Anda pedulikan, memahami perbedaan harga pembacaan cache, dan mengetahui status integrasi kedua model saat ini.
Poin Inti GPT-6.2 Astra dan Claude Fable 5.2: Jangan Campur Tiga Lapisan Angka
Saat membandingkan GPT-6.2 Astra dan Claude Fable 5.2, kesalahan yang paling sering terjadi adalah memasukkan angka dari sumber berbeda ke dalam satu kesimpulan. Tabel berikut memisahkan sumber dan sudut pandang dari tiga lapisan informasi.
| Lapisan angka | Sifat sumber | Arah yang ditunjukkan lapisan ini | Catatan penggunaan |
|---|---|---|---|
| Peringkat komprehensif | Pihak ketiga Artificial Analysis, Intelligence Index v5.0.1 | Fable 5.2 sebesar 65, Astra (Max) sebesar 62 | Harus mencantumkan tingkat penalaran; skor antar tingkat berbeda jauh |
| Tugas individual | Dilaporkan sendiri secara resmi oleh OpenAI dalam tulisan peluncuran; AA-3D adalah penilaian buta pihak ketiga yang disampaikan secara resmi | Astra unggul pada Agents’ Last Exam, Harvey LAB-AA, AA-3D | Pada papan ALE, Fable tidak menyertakan sembilan tugas model cadangan |
| Harga resmi | Halaman model resmi dan dokumentasi kedua perusahaan | Harga input dan output sama; biaya baca cache Fable lebih rendah | Masa retensi penulisan cache berbeda; aturan konteks panjang berbeda |
Mengapa GPT-6.2 Astra dan Claude Fable 5.2 “Masing-Masing Unggul di Bidang Berbeda”
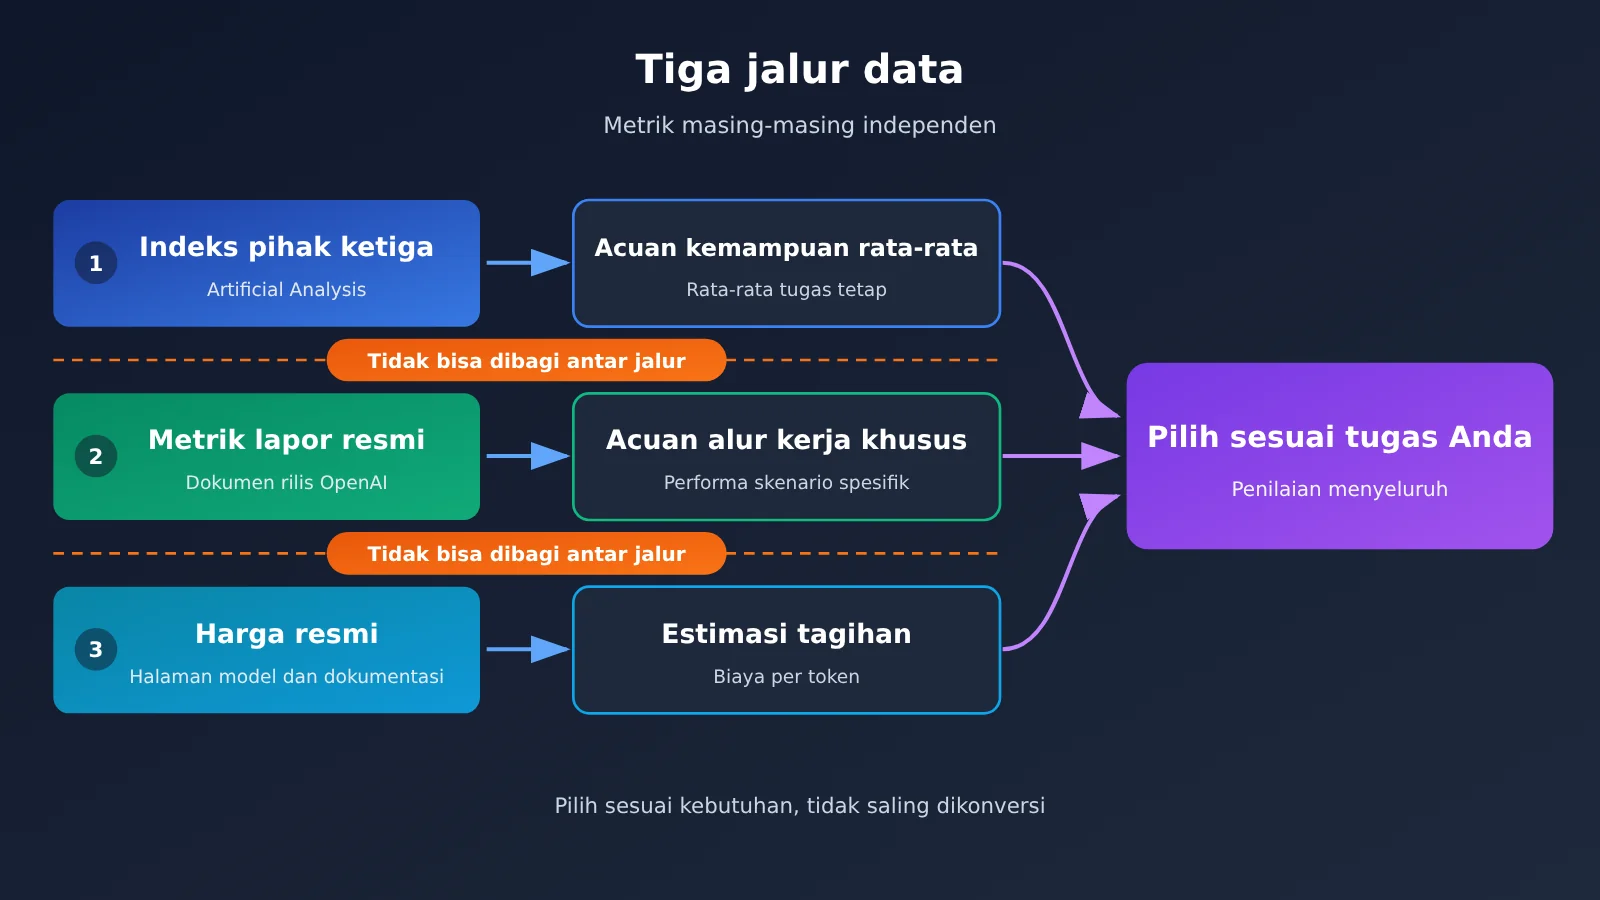
Indeks komprehensif menilai rata-rata performa pada sekumpulan tugas tetap, dengan bobot yang ditetapkan pihak ketiga. Sementara itu, tulisan peluncuran OpenAI menyoroti skenario spesifik seperti alur kerja profesional jangka panjang, hukum, dan pembuatan 3D, dengan pengaturan pengujian yang ditentukan secara resmi. Keduanya memang menjawab pertanyaan yang berbeda sejak awal: yang pertama melihat performa rata-rata, yang kedua melihat performa dalam alur kerja tertentu. Kesimpulan yang tidak konsisten bukan berarti data salah satu pihak bermasalah.
Begitu pula soal biaya. “Biaya per tugas” yang diberikan Artificial Analysis adalah biaya menjalankan rangkaian tugas indeks komprehensif miliknya. “Biaya ALE sekitar 5% dari Fable” yang disebut OpenAI berasal dari rangkaian tugas lain dan dasar pengukuran yang berbeda. Kedua angka ini tidak bisa dibagi satu sama lain, juga tidak bisa saling dikonversi.
Perbedaan Inti GPT-6.2 Astra dan Claude Fable 5.2: Peringkat Komprehensif Pihak Ketiga
Artificial Analysis menerbitkan artikel pada 2026-11-17 sekaligus memperbarui halaman model. Seluruh skor di bawah ini menggunakan Intelligence Index v5.0.1, merupakan hasil evaluasi pihak ketiga, bukan klaim dari pihak mana pun.
| Model | Tingkat penalaran | Intelligence Index v5.0.1 | Biaya per tugas indeks komprehensif (halaman model masing-masing) |
|---|---|---|---|
| Claude Fable 5.2 | Tingkat penalaran tertinggi | 65 (peringkat pertama) | 26.54 dolar |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4.00 dolar (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1.01 dolar (Max) |
| Gemini 4 Carbon | Tingkat tertinggi | 60 | — |
| Claude Opus 5.5 | Tingkat tertinggi | 59 | — |
Pada peringkat pihak ketiga ini, skor komprehensif Fable 5.2 lebih tinggi 3 poin dibandingkan Astra pada tingkat tertinggi. Astra lebih tinggi 5 poin dibandingkan generasi sebelumnya, GPT-6 Astra, dan juga melampaui tingkat tertinggi Gemini 4 Carbon serta Claude Opus 5.5. Perlu diperhatikan juga, ketika Astra diturunkan ke tingkat Low, skornya hanya 46. Jika bisnis Anda menurunkan intensitas penalaran demi menghemat biaya, jangan memakai angka 62 sebagai ekspektasi hasil.
Dalam artikel Artificial Analysis juga terdapat beberapa hasil rincian yang sama-sama merupakan data pihak ketiga. Pada pratinjau riset AA-Robotics v0.1, Astra memperoleh 79, sedangkan Fable 5.2 memperoleh 75. Pada tugas ilmiah, Astra unggul di Terminal-Bench-Science 0.1, dan berada tepat di bawah Fable 5.2 pada subset keras CritPt v2. Dalam Coding Agent Index (Codex harness, max), Astra setara dengan GPT-6 Astra. Untuk tingkat halusinasi AA-Omniscience (Max), Astra sebesar 59%.
Perbedaan inti GPT-6.2 Astra dan Claude Fable 5.2: angka resmi yang dilaporkan sendiri per item
Angka-angka di bawah ini berasal dari pengumuman rilis dan halaman model OpenAI, dan semuanya merupakan angka yang dilaporkan sendiri oleh pihak resmi. Untuk item yang tidak mencantumkan skor absolut dalam pengumuman rilis, artikel ini juga hanya menuliskan selisih relatifnya.
| Tugas per item | Hasil yang dilaporkan sendiri oleh pihak resmi | Dasar biaya menurut pihak resmi | Catatan kaki yang perlu diperhatikan |
|---|---|---|---|
| Agents’ Last Exam (alur kerja profesional jangka panjang) | Astra lebih tinggi 5,5 poin daripada Fable 5.2 | Biaya sekitar 5% dari Fable | Fable 5.2 di papan peringkat tidak mencakup sembilan tugas yang menggunakan model cadangan |
| Harvey LAB-AA v1.1 (hukum) | Tingkat kelulusan Astra lebih dari dua kali lipat Fable 5.2 | Biaya sekitar seperenam | Pengumuman rilis tidak memberikan tingkat kelulusan absolut; konfigurasi “Astra for Law” untuk pengacara lebih tinggi |
| AA-3D (Elo penilaian buta oleh manusia) | Astra 1318, Fable 5.2 1271, Sol 1259 | Tidak diberikan | Penilaian buta pihak ketiga, tetapi disampaikan ulang oleh pengumuman rilis resmi |
| Terminal-Bench-Science 0.1 | Astra lebih tinggi 9 poin persentase daripada GPT-6 Astra | Biaya kurang dari sepertiga generasi sebelumnya | Fable memiliki dua angka dari pengujian berbeda, lihat di bawah |
Catatan kaki untuk Agents’ Last Exam perlu dijelaskan secara terpisah. OpenAI menyatakan bahwa hasil Fable 5.2 di papan peringkat tidak mencakup sembilan tugas yang menggunakan model cadangan. Saat membaca “lebih tinggi 5,5 poin” ini, perlu diketahui bahwa cakupan tugas kedua pihak tidak sepenuhnya sama.
Pada Terminal-Bench-Science 0.1, Fable 5.2 memiliki dua angka dari sumber berbeda. Satu berasal dari Artificial Analysis, yang menggunakan mini-swe-agent. Satu lagi adalah 74,6% yang dilaporkan sendiri oleh Anthropic, dengan lingkungan pengujian Claude Code dan intensitas penalaran Max. Kedua angka ini bukan hasil dari pengujian yang sama, tidak dapat saling menggantikan, dan juga tidak bisa langsung dibandingkan dengan Astra.
Angka 1318 dan 1271 pada AA-3D sendiri merupakan Elo dari penilaian buta oleh manusia pihak ketiga, tetapi yang dikutip dalam artikel ini adalah penyampaian ulang dari pengumuman rilis OpenAI. Saat mengutipnya, sebaiknya ditulis sebagai “penilaian buta pihak ketiga yang disampaikan ulang secara resmi”, jangan ditulis sebagai angka yang murni dilaporkan sendiri oleh pihak resmi, dan juga jangan ditulis sebagai hasil verifikasi independen oleh penulis artikel ini.
💡 Saran pemilihan: Papan peringkat per item hanya berguna sebagai referensi jika jenis tugasnya dekat dengan bisnis Anda. Fable 5.2 sudah dapat dipanggil melalui APIYI apiyi.com; Anda bisa menjalankan satu putaran dengan sampel nyata milik sendiri terlebih dahulu, lalu memadukannya dengan kedua tabel di atas untuk mengambil keputusan.
Perbandingan Harga GPT-6.2 Astra dan Claude Fable 5.2: Cache Read-nya Beda
Menurut harga resmi, harga standar konteks pendek kedua model ini benar-benar sama pada input dan output; perbedaannya terkonsentrasi pada item terkait cache dan aturan konteks panjang. Satuan harga pada tabel berikut adalah dolar AS per 1 juta token.
| Item harga | GPT-6.2 Astra (resmi OpenAI) | Claude Fable 5.2 (resmi Anthropic) | Ketersediaan platform (tabel lengkap APIYI 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| Input | 8 | 8 | Astra belum tersedia; Fable 8 |
| Output | 40 | 40 | Astra belum tersedia; Fable 40 |
| Cache read | 0.40 | 0.20 | Astra belum tersedia; Fable 0.2 |
| Cache write | 10 (retensi 30 menit), 20 (12 jam) | 10 (5 menit), 16 (1 jam) | Mengacu pada daftar platform |
| Konteks / output maksimum | 1,050,000 / 128,000 (input maksimum 922,000) | 1M / 128K | — |
| Batch | 50% dari harga standar | Diskon 50% untuk input dan output | — |
Harga resmi OpenAI untuk GPT-6.2 Astra adalah input 8 dolar, cache read 0.40 dolar, dan output 40 dolar. Model ini belum tersedia, dan kami akan segera menghadirkannya di platform; model dan harga mengacu pada daftar model platform. Di tabel lengkap model APIYI docs.apiyi.com/models.md maupun di antarmuka harga publik, pada 2026-11-17 gpt-6.2-astra tidak bisa ditemukan. Jangan memakai gpt-6-astra yang sudah tersedia (konteks pendek 10 / 50 / 1) untuk memperkirakan harga 6.2, karena keduanya bukan model yang sama.
Perbedaan cache read sangat berdampak pada skenario Agent dan percakapan panjang. Untuk membaca 100 juta token cache yang sama, menurut harga resmi Astra 40 dolar dan Fable 5.2 20 dolar. Kalau petunjuk sistem (system prompt) Anda sangat panjang, atau Anda berulang kali merujuk kumpulan dokumen yang sama, item ini akan langsung terlihat di tagihan. Cache write di permukaan sama-sama 10 dolar, tetapi Astra menyimpannya 30 menit sedangkan Fable 5 menit, jadi hit rate akan terpengaruh oleh interval antarpermintaan — tidak bisa hanya membandingkan harga satuan.
Aturan konteks panjangnya juga berbeda. Halaman model Astra menyebutkan bahwa bila input satu permintaan melebihi 272K token, harga satuan input dan cache menjadi dua kali lipat, output menjadi 1.5 kali harga konteks pendek, dan seluruh tagihan dihitung dengan harga tersebut. Kutipan daftar harga Fable yang dirujuk artikel ini tidak memuat tingkatan serupa; sebelum melakukan integrasi, silakan verifikasi sendiri di dokumentasi Anthropic.
Tingkat akselerasi di kedua sisi pun berbeda. Fast milik Astra adalah 2 kali harga standar; Ultrafast sampai 2027-02-28 (waktu Pasifik) adalah 3 kali, dan sejak 2027-03-01 menjadi 6 kali. Fast mode Fable mencapai sekitar 2.5 kali kecepatan, dengan harga input 16 dolar dan output 80 dolar.
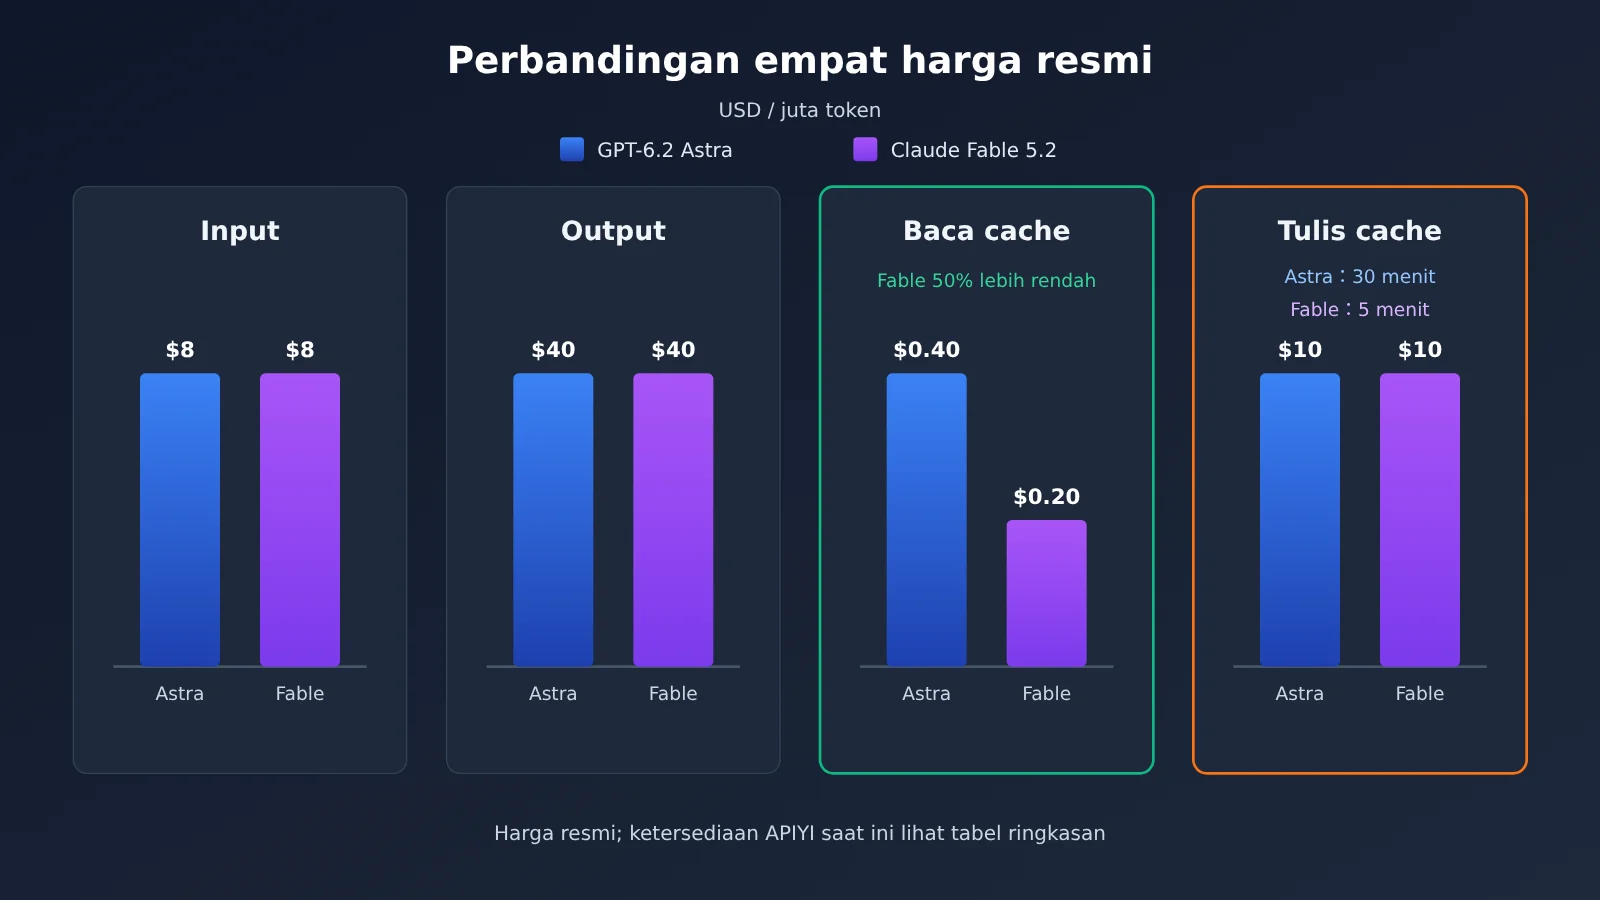
🎯 Keterangan data: Gambar di atas hanya menampilkan harga resmi kedua pihak. Model dan harga yang benar-benar bisa dipanggil di platform mengacu pada daftar model APIYI apiyi.com; Astra 6.2 saat ini tidak ada dalam daftar tersebut.
Rekomendasi skenario untuk GPT-6.2 Astra dan Claude Fable 5.2
Berikut pemetaan skenario berdasarkan “item peringkat ini menunjukkan apa”, tanpa menyimpulkan kekuatan keseluruhan secara umum.
Skenario yang sebaiknya mengevaluasi GPT-6.2 Astra lebih dulu
- Alur kerja profesional jangka panjang: Astra unggul pada Agents’ Last Exam versi klaim resmi, namun perlu memperhitungkan catatan kaki bahwa Fable tidak mencakup sembilan tugas.
- Tugas dokumen hukum: tingkat kelulusan Harvey LAB-AA v1.1 versi klaim resmi lebih dari dua kali lipat Fable, bisa dijadikan arah pengujian utama.
- Evaluasi preferensi terkait pembuatan 3D: Elo penilaian buta (blind review) AA-3D yang disebut resmi adalah 1318 berbanding 1271.
- Sensitif terhadap biaya per tugas pada indeks komprehensif: di halaman pihak ketiga, Astra (Max) tercatat 4,00 dolar, tetapi ini hanya berlaku untuk rangkaian tugas indeks komprehensif tersebut.
Skenario yang sebaiknya mengevaluasi Claude Fable 5.2 lebih dulu
- Aplikasi umum yang membutuhkan kemampuan menyeluruh sebagai lapisan dasar: indeks komprehensif pihak ketiga untuk Fable 5.2 adalah 65, peringkat pertama di papan peringkat.
- Aplikasi dengan rasio baca cache tinggi: harga baca cache 0,20 dolar, separuh dari Astra.
- Perlu segera diintegrasikan:
claude-fable-5-2danclaude-fable-5-2-thinkingsudah ada di tabel utama APIYI.
| Fokus Anda | Lapisan mana yang dilihat dulu | Arah lapisan ini | Pengingat tambahan |
|---|---|---|---|
| Kemampuan rata-rata | Papan komprehensif pihak ketiga | Fable 5.2 lebih tinggi | Perhatikan tingkat penalaran |
| Alur kerja profesional / hukum | Item tunggal klaim resmi | Astra unggul | Data klaim resmi, catatan kaki wajib dibaca |
| Biaya cache dialog panjang | Harga resmi | Baca cache Fable lebih rendah | Durasi penyimpanan tulis cache berbeda |
| Bisa dipanggil saat ini | Tabel utama APIYI | Hanya Fable yang tersedia | Astra 6.2 menunggu peluncuran |
Panduan Cepat GPT-6.2 Astra dan Claude Fable 5.2: Keputusan dalam Tiga Langkah
Langkah pertama: lihat dulu peringkat untuk bidang yang Anda butuhkan
Tentukan dulu jenis tugas bisnis Anda. Jika ini asisten umum atau tugas campuran, gunakan indeks komprehensif Artificial Analysis sebagai acuan, dan catat profil penalaran yang akan Anda pakai. Jika ini Agent jangka panjang, hukum, atau 3D, gunakan skor per item yang dilaporkan sendiri oleh OpenAI sebagai acuan, sekaligus baca catatan kakinya. Jangan menjumlahkan selisih skor dari leaderboard komprehensif dan leaderboard per item menjadi “skor total”.
Langkah kedua: lihat pembacaan cache
Perkirakan berapa besar proporsi permintaan yang berupa prefiks berulang, misalnya petunjuk sistem, potongan basis pengetahuan, atau riwayat percakapan multi-putaran. Semakin tinggi proporsi pembacaan cache, semakin jelas perbedaan antara 0.20 dan 0.40. Jika input sekali kirim sering melebihi 272K, Anda juga perlu memperhitungkan aturan kenaikan harga seluruh pesanan Astra.
Langkah ketiga: lihat mana yang saat ini bisa dipanggil di APIYI
Saat ini, model yang bisa dipanggil di tabel utama APIYI adalah Fable 5.2, dengan ID model claude-fable-5-2; jika membutuhkan versi penalaran eksplisit, gunakan claude-fable-5-2-thinking. Harga yang tercantum adalah input 8, output 40, pembacaan cache 0.2, dan endpoint mendukung chat serta messages. Halaman deskripsi model ini saat ini mengembalikan 404; harga mengacu pada tabel utama.
Saat diintegrasikan dengan cara yang kompatibel dengan OpenAI, atur base_url di SDK menjadi https://api.apiyi.com/v1, isi model dengan claude-fable-5-2, dan parameter lain sama seperti saat memanggil Chat Completions seperti biasa. Perlu diperhatikan bahwa fitur penalaran Fable 5.2 selalu aktif dan tidak dapat dimatikan, dengan effort default high. Jika nanti beralih ke Astra, API-nya tidak menerima pengaturan reasoning effort ke none.
🚀 Mulai Cepat: Sebaiknya gunakan kuota uji gratis di APIYI apiyi.com terlebih dahulu, uji
claude-fable-5-2dengan sampel Anda sendiri, lalu catat kualitas output dan tingkat cache hit. Setelahgpt-6.2-astratersedia, uji lagi dengan kumpulan sampel yang sama; perbandingannya akan lebih adil.
FAQ Umum
Q1: Apa itu GPT-6.2 Astra dan Claude Fable 5.2?
GPT-6.2 Astra adalah model unggulan OpenAI yang dirilis pada 2026-11-17 dengan ID model `gpt-6.2-astra`; pada waktu yang sama juga dirilis GPT-6.2 Sol yang lebih murah. Claude Fable 5.2 adalah model Anthropic dengan tanggal publikasi dokumen 2026-11-09. Keduanya mendukung jendela konteks sekitar 1M dan output maksimum 128K.
Q2: Siapa yang lebih unggul, GPT-6.2 Astra atau Claude Fable 5.2?
Data yang ada tidak bisa memberi jawaban tunggal. Dalam indeks komposit pihak ketiga, skor Fable 5.2 sebesar 65 lebih tinggi daripada Astra (Max) yang 62. Pada ALE dan Harvey yang dilaporkan sendiri secara resmi, serta penilaian buta AA-3D yang dikutip resmi, Astra memimpin. Sebaiknya lihat data pada lapisan yang sesuai dengan jenis tugas Anda.
Q3: Bisakah “biaya 5%” dari ALE dan biaya per tugas Artificial Analysis saling memverifikasi?
Tidak bisa. “Sekitar 5%” adalah angka yang dilaporkan sendiri oleh OpenAI pada Agents’ Last Exam. 4.00 dolar dan 26.54 dolar adalah biaya dari rangkaian tugas indeks komposit yang dijalankan Artificial Analysis. Tugas dan dasar pengukurannya berbeda, jadi tidak bisa dibagi, juga tidak bisa dipakai untuk saling memverifikasi.
Q4: Apakah data Sol berasal dari pihak ketiga?
Bukan. Sol adalah model milik OpenAI sendiri, jadi angka tentang Sol dalam artikel rilis merupakan laporan resmi mereka sendiri. Artificial Analysis juga menguji Sol secara terpisah; pada tingkat Max skornya 57, dan bagian itu yang merupakan data pihak ketiga. Harga resmi Sol adalah input 2, baca cache 0.10, output 10. Model ini belum tersedia di platform; kami akan segera menghadirkan model ini. Model dan harga mengacu pada daftar model platform.
Q5: Bagaimana cara memanggil Claude Fable 5.2 melalui API saat ini?
Daftar di APIYI apiyi.com dan dapatkan kunci API, lalu di SDK yang kompatibel dengan OpenAI atur base URL ke `https://api.apiyi.com/v1` dan isi model dengan `claude-fable-5-2`. Jika memakai protokol native Anthropic, Anda bisa menggunakan endpoint messages.
Q6: Apa saja batasan GPT-6.2 Astra yang diketahui?
Penjelasan resmi menyebut Astra mencapai tingkat “kritis” dalam kerangka kesiapan untuk keamanan siber, sehingga pengamannya lebih ketat dan sebagian permintaan riset kerentanan yang sah akan ditolak. Dalam evaluasi penyelarasan, pada dua pengujian model ini lebih cenderung melewatkan pelaporan masalah yang menghalangi, seperti file hilang atau alat pencarian tidak tersedia. Tingkat halusinasi AA-Omniscience (Max) dari pihak ketiga adalah 59%. Selain itu, model ini tidak mendukung input audio dan video, juga tidak mendukung Realtime dan fine-tuning.
Q7: Apakah harga resmi akan berubah setelah Desember?
Dalam referensi artikel ini, kedua model tidak mengumumkan penyesuaian harga untuk Desember. Yang akan berubah adalah pengali Ultrafast Astra: mulai 2027-03-01, dari 3 kali menjadi 6 kali. Untuk penagihan aktual di platform, mengacu pada daftar model di APIYI apiyi.com.
Poin-Poin Utama GPT-6.2 Astra dan Claude Fable 5.2 (Key Takeaways)
- Peringkat gabungan lihat pihak ketiga: Pada AA Intelligence Index v5.0.1, Fable 5.2 mendapat 65, Astra (Max) mendapat 62.
- Tolok ukur individual lihat laporan resmi: Astra unggul pada ALE, Harvey, dan AA-3D yang dikutip resmi, tetapi perlu membaca catatan kaki.
- Dua set biaya tidak bisa dibagi satu sama lain: ALE sekitar 5% dan biaya per tugas AA berasal dari tugas dan metodologi yang berbeda.
- Harga input dan output sama: Kedua model konteks pendek sama-sama 8 / 40 dolar AS, biaya baca cache masing-masing 0.40 dan 0.20.
- Astra konteks panjang bertingkat: Jika input sekali panggilan melebihi 272K, seluruh transaksi ditagih dengan tarif lebih tinggi.
- Status akses berbeda: Fable 5.2 sudah ada di tabel utama APIYI apiyi.com, Astra 6.2 menunggu untuk tersedia.
Ringkasan
Saat membandingkan GPT-6.2 Astra dan Claude Fable 5.2, kuncinya adalah memisahkan sumber setiap angka:
- Peringkat gabungan pihak ketiga: Fable 5.2 lebih tinggi; saat mengutip, pastikan menyebutkan tingkat penalaran yang digunakan.
- Laporan resmi per tolok ukur: Astra unggul pada beberapa tugas profesional, dan biaya per tugas yang dilaporkan resmi juga lebih rendah, tetapi itu adalah data laporan sendiri.
- Harga resmi: Input dan output sama, biaya baca cache Fable setengah lebih murah, dan aturan konteks panjang juga berbeda.
Tidak ada satu pun dari kedua model ini yang unggul di semua dimensi. Pendekatan yang lebih andal adalah menentukan dulu jenis tugas Anda, lalu memeriksa biaya cache, dan terakhir menguji dengan sampel nyata. Saat ini Fable 5.2 sudah dapat dipanggil melalui APIYI apiyi.com; setelah Astra 6.2 tersedia, Anda bisa menguji ulang dengan sampel yang sama. Kami akan segera menghadirkan model ini.
📚 Referensi
-
Postingan rilis OpenAI: Catatan rilis dan evaluasi resmi yang dilaporkan sendiri untuk GPT-6.2 Astra dan Sol
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: Data individual seperti ALE, Harvey, AA-3D, serta sumber catatan kaki
- Tautan:
-
Halaman model OpenAI: Spesifikasi dan harga GPT-6.2 Astra
- Tautan:
platform.openai.com/docs/models/gpt-6.2-astra - Keterangan: Harga penulisan cache dan aturan penetapan harga 272K mengacu pada halaman ini
- Tautan:
-
Artikel Artificial Analysis: Evaluasi pihak ketiga untuk GPT-6.2 Astra dan Sol
- Tautan:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Keterangan: Skor setiap tingkat penalaran pada Intelligence Index v5.0.1
- Tautan:
-
Halaman model Artificial Analysis: Claude Fable 5.2
- Tautan:
artificialanalysis.ai/models/claude-fable-5-2 - Keterangan: Skor keseluruhan dan biaya per tugas pada indeks keseluruhan
- Tautan:
-
Dokumentasi Anthropic: Ikhtisar Claude Fable 5.2
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: Harga, baca/tulis cache, effort, dan pengaturan thinking
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs resmi APIYI. Untuk model dan harga, silakan mengacu pada daftar model di platform.