Ringkasan: Artikel ini menganalisis laporan pengujian pihak ketiga yang tersedia untuk publik mengenai performa Qwen4-Max-Preview dalam menyelesaikan tugas seperti mesin capit boneka, perbaikan layanan Python, dan pencarian 1,600 tiket, sekaligus menjelaskan batasannya dalam hal waktu proses dan penilaian ilmiah.
Kesimpulan di awal: penilaian inti kemampuan pemrograman Qwen4-Max-Preview
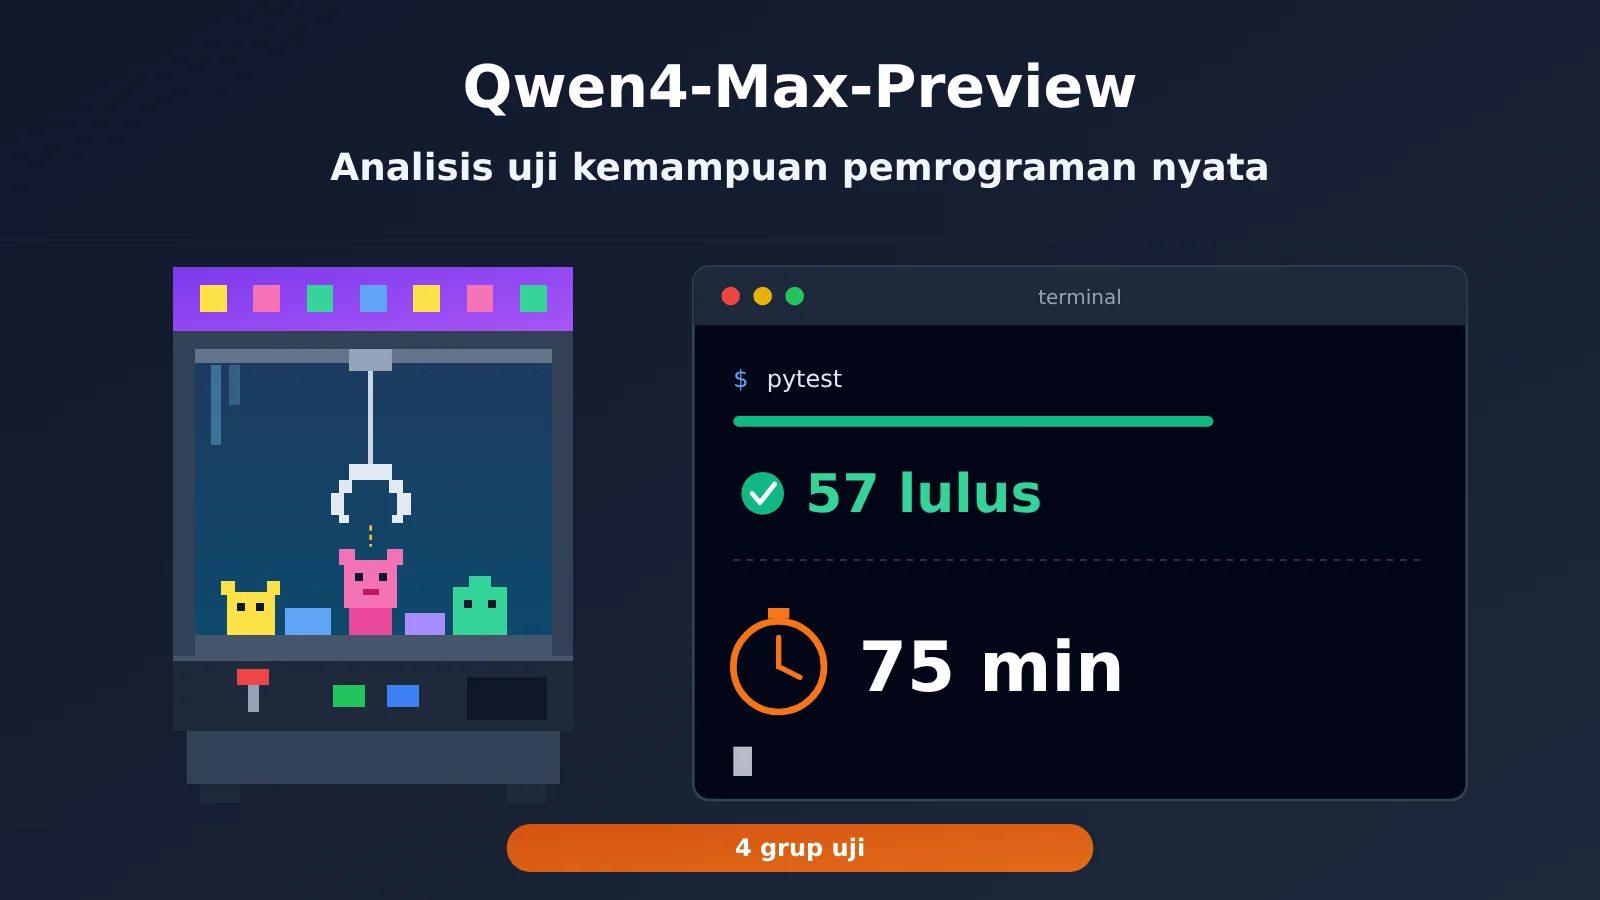
Laporan pengujian publik menunjukkan bahwa Qwen4-Max-Preview mampu menjalankan pengembangan multi-langkah, melengkapi pengujian, dan menyerahkan proyek yang dapat diverifikasi ulang. Bukti terkuat datang dari tugas perbaikan kode: model terlebih dahulu mereproduksi bug, lalu menambahkan pengujian, mengirim permintaan HTTP nyata, dan memverifikasi integritas data; pada akhirnya seluruh 57 pengujian lulus. Kelemahannya juga jelas: tugas kompleks memakan waktu lama; tugas mesin capit boneka membutuhkan sekitar 75 menit; dalam tugas ilmiah, penjelasan model atas hasil perhitungan melampaui cakupan bukti. Karena itu, hasil serahan yang kompleks dan kesimpulan ilmiah tetap memerlukan tinjauan pengembang.
Bagian berikutnya dimulai dari tugas mesin capit boneka, lalu merangkum laporan yang mencakup 12 tugas, dengan fokus pada dua kelompok bukti yang dapat diverifikasi: perbaikan kode dan pencarian tiket. Selanjutnya, kasus faktorisasi matriks non-negatif digunakan untuk menjelaskan batas penalaran model, lalu masalah efisiensi dibahas melalui perbandingan lintas alat pada tantangan mesin capit boneka yang sama, dan diakhiri dengan jenis tugas yang cocok diserahkan kepadanya. Artikel ini adalah analisis evaluasi atas laporan publik; kami tidak menjalankan ulang proyek penulis, dan semua angka mencantumkan sumber serta kondisi pengujian.
Untuk Diketahui: Memahami 9 istilah dalam evaluasi Qwen4-Max-Preview
| Istilah | Penjelasan |
|---|---|
| Agent | Cara kerja model yang merencanakan langkah sendiri, memanggil alat, dan menjalankan tugas secara bertahap. |
| Mesin status | Mengontrol perilaku program dengan sekumpulan status dan aturan transisi antarstatus, misalnya mesin capit boneka “bergerak—meraih—mengangkat—menyelesaikan”. |
| Pengujian regresi | Memverifikasi ulang fungsi yang sudah ada setelah kode diubah, memastikan perilaku lama tidak rusak. |
| Permintaan HTTP | Permintaan yang dikirim klien ke server untuk menguji hasil yang dikembalikan antarmuka saat berjalan nyata. |
| Verifikasi hash | Menghitung nilai ringkasan isi file; dengan membandingkan sebelum dan sesudah dapat diketahui apakah data asli atau file uji telah diubah. |
| Throughput Token | Jumlah Token yang diproses atau dihasilkan per satuan waktu; nilainya dipengaruhi alat, jaringan, dan lingkungan eksekusi. |
| Pengambilan konteks | Menemukan dan mengaitkan informasi target di antara banyak materi yang dibawa dalam satu permintaan. |
| Dekomposisi matriks non-negatif | Algoritma yang menguraikan matriks data non-negatif menjadi perkalian dua matriks faktor non-negatif secara aproksimasi. |
| Solusi optimal lokal | Solusi yang tidak dapat ditingkatkan lagi dalam rentang sekitarnya; menentukan apakah suatu solusi optimal lokal memerlukan kondisi matematis atau analisis tambahan. |
1 Menyelesaikan mesin capit boneka dalam 75 menit: satu tugas pemrograman kompleks dari Qwen4-Max-Preview
1.1 Apa yang diuji oleh tugas mesin capit boneka
Pada 12 November 2026, 人人都是产品经理 menerbitkan laporan uji langsung Qwen4-Max-Preview berbasis Qoder, dan salah satu bagian paling kompleks di dalamnya adalah sistem interaksi mesin capit boneka. Tugas ini memusatkan berbagai kesulitan pemrograman dalam satu proyek: interaksi mekanis dan umpan balik gaya, ayunan tali yang menggantung, tumbukan antar boneka, mesin status untuk alur kontrol, serta logika penilaian di bagian akhir.
Tugas semacam ini sulit diselesaikan hanya dengan sekali pembuatan. Efek fisika, peralihan status, dan aturan penilaian saling bergantung, sehingga model perlu berulang kali menulis, menjalankan, mengamati, dan memperbaiki. Karena itu, yang diuji adalah kemampuan mendorong pekerjaan langkah demi langkah dengan gaya Agent.
1.2 Waktu, kecepatan, dan konsumsi yang dicatat penulis
| Metrik | Catatan penulis | Kondisi uji dan penjelasan |
|---|---|---|
| Total waktu | Sekitar 75 menit | Lingkungan Qoder, satu kali tugas |
| Kecepatan output | Sekitar 33 Token/detik | Kecepatan yang teramati pada tugas tersebut |
| Konsumsi Credits | Sekitar 65 | Perkiraan penulis, diukur dengan Token Plan |
| Kualitas hasil | Cukup solid | Penilaian subjektif penulis, menilai keseluruhannya setara dengan Kimi K3.1 |
Angka-angka ini hanya berlaku untuk tugas tersebut. Credits adalah satuan pengukuran langganan Token Plan; konsumsi aktual dipengaruhi bersama oleh input, cache hit, output, Token berpikir, dan pemanggilan tool. 65 Credits hanya menunjukkan skala biaya tugas kali ini. 33 Token/detik juga merupakan nilai pengamatan pada lingkungan tertentu.
Laporan yang sama juga mencatat beberapa tugas lain. Pada tugas lukisan tinta yang hanya menggunakan NumPy dan PIL, model menghasilkan lebih dari 1.000 baris kode, menggambar sekitar 4.019 goresan kuas, lalu memeriksa sendiri melalui statistik kecerahan piksel dan pemindaian kontur ASCII. Setelah menemukan bahwa burung walet bertumpuk dengan blok gelap lubang jendela, model secara aktif menyesuaikan koordinatnya. Penulis menilai kemampuan organisasi kode dan pemeriksaan mandirinya cukup kuat, sementara sisi estetikanya masih punya ruang untuk ditingkatkan.
2 Apa yang Dicakup oleh Dua Belas Tugas Nyata Qwen4-Max-Preview
2.1 Laporan pengujian yang lebih menyeluruh
Pada 16 November, platform 人人都是产品经理 menerbitkan laporan pengujian dari Z Finance. Penulisnya mengklaim telah menyelesaikan 12 tugas dan melakukan pemeriksaan sampel serta verifikasi ulang terhadap hasil-hasil kunci. Tabel berikut merangkum tugas-tugas yang dicakup laporan:
| Kategori | Tugas pengujian | Kemampuan utama yang diuji |
|---|---|---|
| Pembuatan visual | SVG pelikan mengendarai sepeda | Pemahaman visual, pembuatan kode |
| Analisis keuangan | Analisis gabungan tiga laporan keuangan | Pemahaman dokumen panjang, standar akuntansi keuangan |
| Pembacaan grafik | Diagram batang pendapatan produk Apple | Pembacaan grafik, estimasi nilai |
| Kolaborasi kantor | Tiga putaran revisi notulen rapat | Pemeliharaan konteks, konsistensi revisi |
| Pemrosesan data | Pembersihan 44 baris data penjualan | Deduplikasi, konversi satuan, rumus |
| Presentasi | PPT IPO Pingtouge | Pencarian real-time, pembuatan file |
| Pencarian teks panjang | 1.600 tiket dukungan pelanggan | Korelasi lintas catatan, penyaringan bersyarat |
| Pemeliharaan kode | Perbaikan layanan tiket Python | Lokalisasi bug, pengujian dan regresi |
| Reproduksi riset | Algoritma faktorisasi matriks non-negatif | Implementasi algoritma, validasi numerik |
| Pengembangan web | Halaman tampilan materi prospektus | HTML, pengiriman offline, interaksi |
| Sistem simulasi | Simulasi taman hujan | Desain interaksi, komputasi numerik |
| Pengembangan game | Game 3D bertema empat musim | Adegan 3D, manajemen status, interaksi |
2.2 Lima kasus yang layak diperhatikan
Dari 12 tugas ini, lima berikut paling jelas menunjukkan kemampuan model untuk menyerahkan “hasil yang benar-benar dapat digunakan”:
- Analisis laporan keuangan: Model diberi laporan tahunan FY2026 Apple dan Costco serta prospektus versi kedua Anthropic, lalu menyelesaikannya dalam sekitar 8 menit. Enam angka kunci yang diperiksa sampel semuanya benar; model membedakan rugi operasional dari rugi bersih, menunjukkan dampak perubahan nilai wajar obligasi konversi terhadap rugi bersih, dan tidak mengarang panduan masa depan yang belum diungkapkan.
- Pembersihan Excel: Dalam 44 baris rincian penjualan terdapat catatan duplikat, data duplikat yang hanya berbeda spasi, dua satuan (yuan dan puluhan ribu yuan), tiga format tanggal, serta 5 pesanan yang hilang. Setelah dibersihkan, tersisa 35 baris; total empat wilayah mencapai 215.700 yuan; 5 sel ringkasan semuanya memakai rumus aktual, sehingga nilai ringkasan otomatis diperbarui saat rincian diubah.
- Pembuatan PPT: Model mengidentifikasi informasi pengumuman spin-off melalui pencarian real-time, menghasilkan PPT yang dapat diedit, dan membedakan proyeksi valuasi dari harga penawaran. Setelah audiens disesuaikan pada putaran kedua, 20 angka kunci, tanggal, dan nama yang sudah ada tetap tidak berubah. Penulis juga mencatat adanya lini produk yang terlewat.
- Pencarian tiket dan perbaikan Python: Kedua bukti ini paling konkret dan masing-masing dibahas di Bagian 4 dan Bagian 3.
Titik kesamaan tugas-tugas ini adalah hasil kerjanya dapat diperiksa: apakah rumus bisa saling terhubung, apakah angka cocok dengan teks asli, dan apakah pengujian bisa lulus. Bukti semacam ini lebih meyakinkan daripada “menghasilkan potongan kode yang terlihat benar”.
3 57 tes lulus: bukti engineering paling meyakinkan dari Qwen4-Max-Preview
3.1 Rekonstruksi lengkap proses perbaikan
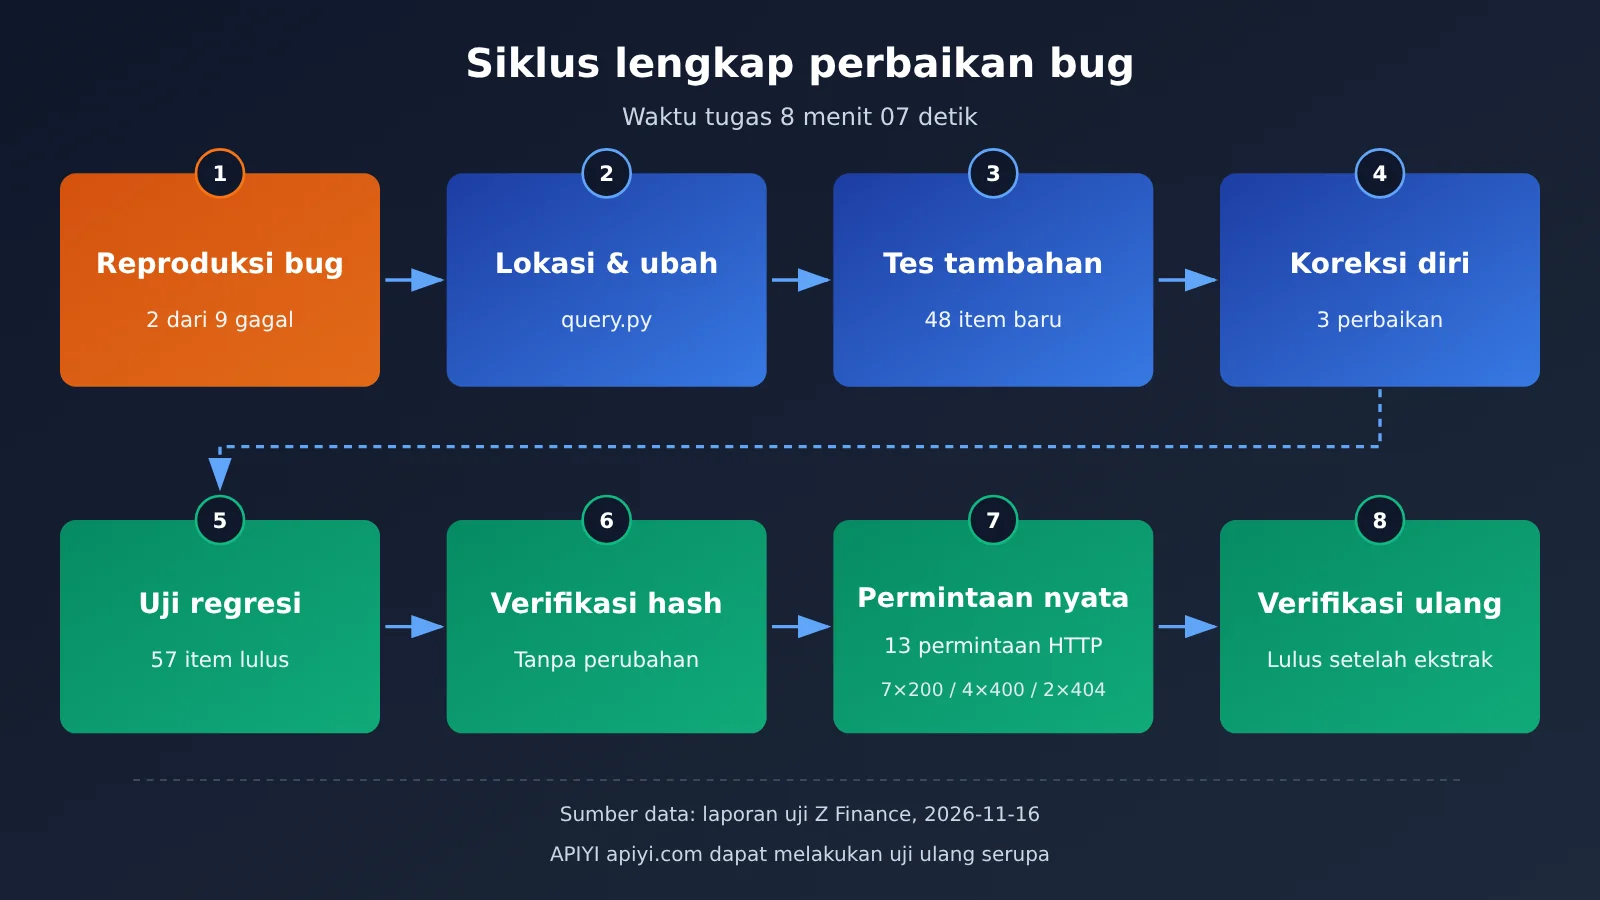
Objek uji adalah layanan kueri tiket kerja yang ditulis dengan pustaka standar Python; cacatnya melibatkan filter gabungan, pengurutan, penomoran halaman, dan validasi parameter. Tugasnya adalah memperbaiki cacat tersebut sambil tetap mempertahankan antarmuka, data asli, dan tes yang sudah ada. Laporan mencatat tugas ini memakan waktu 8 menit 07 detik, dengan proses sebagai berikut:
| Langkah | Tindakan model | Makna engineering |
|---|---|---|
| Mereproduksi cacat | Menjalankan 9 tes awal terlebih dahulu, mereproduksi 2 di antaranya yang gagal | Pastikan masalahnya benar-benar ada sebelum mulai mengubah |
| Menemukan dan memperbaiki | Perubahan utama terkonsentrasi di query.py | Cakupan perubahan menyempit, efek samping berkurang |
| Melengkapi tes | Menambahkan 48 tes | Mencakup kasus batas yang belum tercakup tes awal |
| Koreksi diri | Memperbaiki 3 masalah dalam tes yang ia tulis sendiri | Menemukan kesalahan penulisan tes sendiri dan langsung memperbaikinya |
| Verifikasi regresi | Akhirnya 57 tes semuanya lulus | 9 tes awal ditambah 48 tes baru |
| Pemeriksaan integritas | Melakukan pemeriksaan hash pada data asli dan tes awal, hash tidak berubah | Membuktikan tidak “lulus” dengan memanipulasi data atau tes |
| Permintaan nyata | Menjalankan layanan lokal dan mengirim 13 permintaan HTTP, mendapat 7 respons 200, 4 respons 400, 2 respons 404 | Memverifikasi respons normal dan penanganan error saat antarmuka berjalan |
| Verifikasi ulang hasil pengiriman | Mengekstrak paket hasil akhir lalu menjalankannya lagi, tes lulus | Memastikan hasil pengiriman itu sendiri dapat berjalan mandiri |
3.2 Mengapa ini lebih menjelaskan daripada sekadar menghasilkan kode
Ada dua mode kegagalan umum dalam pemrograman AI: pertama, mengubah tes atau data agar tes “menjadi hijau”; kedua, kode lulus di dalam tes tetapi gagal saat berjalan nyata. Pemeriksaan hash pada tugas ini menyasar risiko pertama, sedangkan permintaan HTTP nyata dan verifikasi ulang paket hasil pengiriman menyasar risiko kedua. Empat respons 400 dan dua respons 404 menunjukkan model juga memverifikasi jalur error — validasi parameter dan penanganan sumber daya yang tidak ada keduanya teruji secara nyata.
Proses ini sejalan dengan kebiasaan engineer berpengalaman saat memperbaiki bug: reproduksi, perbaikan, penambahan tes, regresi, pengiriman. Ini membuktikan Qwen4-Max-Preview memiliki siklus pemeliharaan yang utuh dalam layanan dengan aturan jelas dan skala terkendali. Catatan ini tetap merupakan rekaman satu tugas, dan tidak dapat dikonversi menjadi tingkat keberhasilan perbaikan kode secara umum.
Nilai nyata konteks 4 juta: menemukan petunjuk berjarak 741 baris di antara 1.600 tiket
4.1 Desain pengujian dan hasil
Jendela konteks Qwen4-Max-Preview yang diumumkan resmi adalah 1.000.000 token. Ukuran jendela hanyalah batas kapasitas; yang menentukan nilai praktisnya adalah apakah model mampu membangun keterkaitan yang tepat di antara materi dalam jumlah besar. Pengujian tiket dalam laporan Z Finance menjawab pertanyaan ini.
Data pengujian berupa 1.600 tiket layanan pelanggan, berukuran sekitar 500 ribu byte, dengan petunjuk kunci tersebar pada dua record yang berjarak 741 baris, dan total 5 pertanyaan diajukan. Laporan mencatat kelima pertanyaan terjawab benar, dengan rincian sebagai berikut:
- Mengaitkan dua tiket yang tersebar, menemukan nominal pengembalian dana 1.386 yuan beserta petugas yang menanganinya.
- Berdasarkan tanggal persetujuan, menilai apakah kebijakan baru kupon kompensasi berlaku untuk kasus tersebut.
- Menghitung 62 tiket yang memenuhi syarat tertentu, konsisten dengan hasil statistik skrip.
- Menemukan dua kelompok nomor pesanan duplikat, sekaligus membedakan kelompok mana yang termasuk alur normal dan kelompok mana yang termasuk konflik informasi pelanggan.
4.2 Byte dan Token adalah dua satuan berbeda
Sekitar 500 ribu byte adalah ukuran file, sedangkan jumlah token bergantung pada cara tokenisasi dan proporsi bahasa Mandarin serta Inggris, sehingga keduanya perlu dihitung secara terpisah. Pengujian ini membuktikan “keterkaitan antar-record dan penyaringan bersyarat dalam materi berskala menengah”; skalanya jauh lebih kecil daripada batas atas jendela 1 juta token, jadi tidak bisa dijadikan uji tekanan untuk kapasitas ekstrem.
Nilai hasil poin ke-3 terletak pada kemampuannya untuk diperiksa: 62 tiket yang konsisten dengan statistik skrip menunjukkan bahwa penghitungan model dapat diverifikasi ulang dengan program deterministik. Dalam penggunaan nyata, sebaiknya terapkan cara yang sama: verifikasi hasil statistik model dengan skrip, lalu gunakan model untuk bagian yang sulit ditangani skrip seperti keterkaitan dan penjelasan.
5 Kekurangan yang tidak bisa diabaikan: kesimpulan berlebihan Qwen4-Max-Preview dalam penalaran ilmiah
5.1 Perhitungannya benar, tetapi penjelasannya melampaui bukti
Tugas reproduksi penelitian mengharuskan implementasi algoritma multiplicative updates untuk faktorisasi matriks non-negatif berdasarkan makalah yang ditentukan. Matriks masukan berukuran 48×36, menggunakan tiga kelompok nilai awal yang berbeda, masing-masing 500 iterasi. Laporan mencatat waktu yang dihabiskan model 10 menit 06 detik, dengan keluaran berupa kode, hasil numerik, grafik, dan log; ketiga kelompok hasil masing-masing menyediakan 52 titik pemeriksaan, titik pemeriksaan kunci kelompok A cocok dengan hasil referensi publik, dan terdapat 63 catatan pemeriksaan mandiri.
Masalahnya justru ada di bagian kesimpulan. Model hanya berbekal fungsi objektif yang terus menurun, lalu menafsirkan hasilnya sebagai konvergensi ke solusi optimal lokal. Penulis menunjukkan bahwa ini termasuk inferensi berlebihan.
5.2 Tiga konsep yang perlu dinilai secara terpisah
Kasus ini melibatkan tiga lapis penilaian, dan lapisan berikutnya masing-masing membutuhkan bukti yang lebih kuat daripada lapisan sebelumnya:
- Penurunan fungsi objektif: sifat bawaan dari desain aturan multiplicative updates, dapat diamati langsung dari log dan grafik.
- Konvergensi iterasi numerik: perlu memeriksa apakah perubahan besaran iterasi cenderung stabil, sekaligus menetapkan kriteria berhenti yang jelas.
- Konvergensi ke solusi optimal lokal: perlu memverifikasi kondisi optimalitas, misalnya kondisi KKT; hanya melihat penurunan nilai fungsi tidak cukup untuk menyimpulkannya.
Ini menunjukkan bahwa kemampuan eksekusi model dan ketelitian penalarannya perlu dievaluasi secara terpisah. Perhitungan numerik bisa diverifikasi lewat titik pemeriksaan, sedangkan kesimpulan ilmiah perlu ditinjau oleh orang yang punya latar belakang relevan. Dalam konteks riset, reproduksi makalah, atau laporan teknis, “bagian kesimpulan” yang dihasilkan model sebaiknya diperlakukan sebagai draf.
6 Perbandingan Qwen4-Max-Preview dengan Alat Pemrograman Lain pada Tugas yang Sama
6.1 Data perbandingan tantangan mesin capit boneka
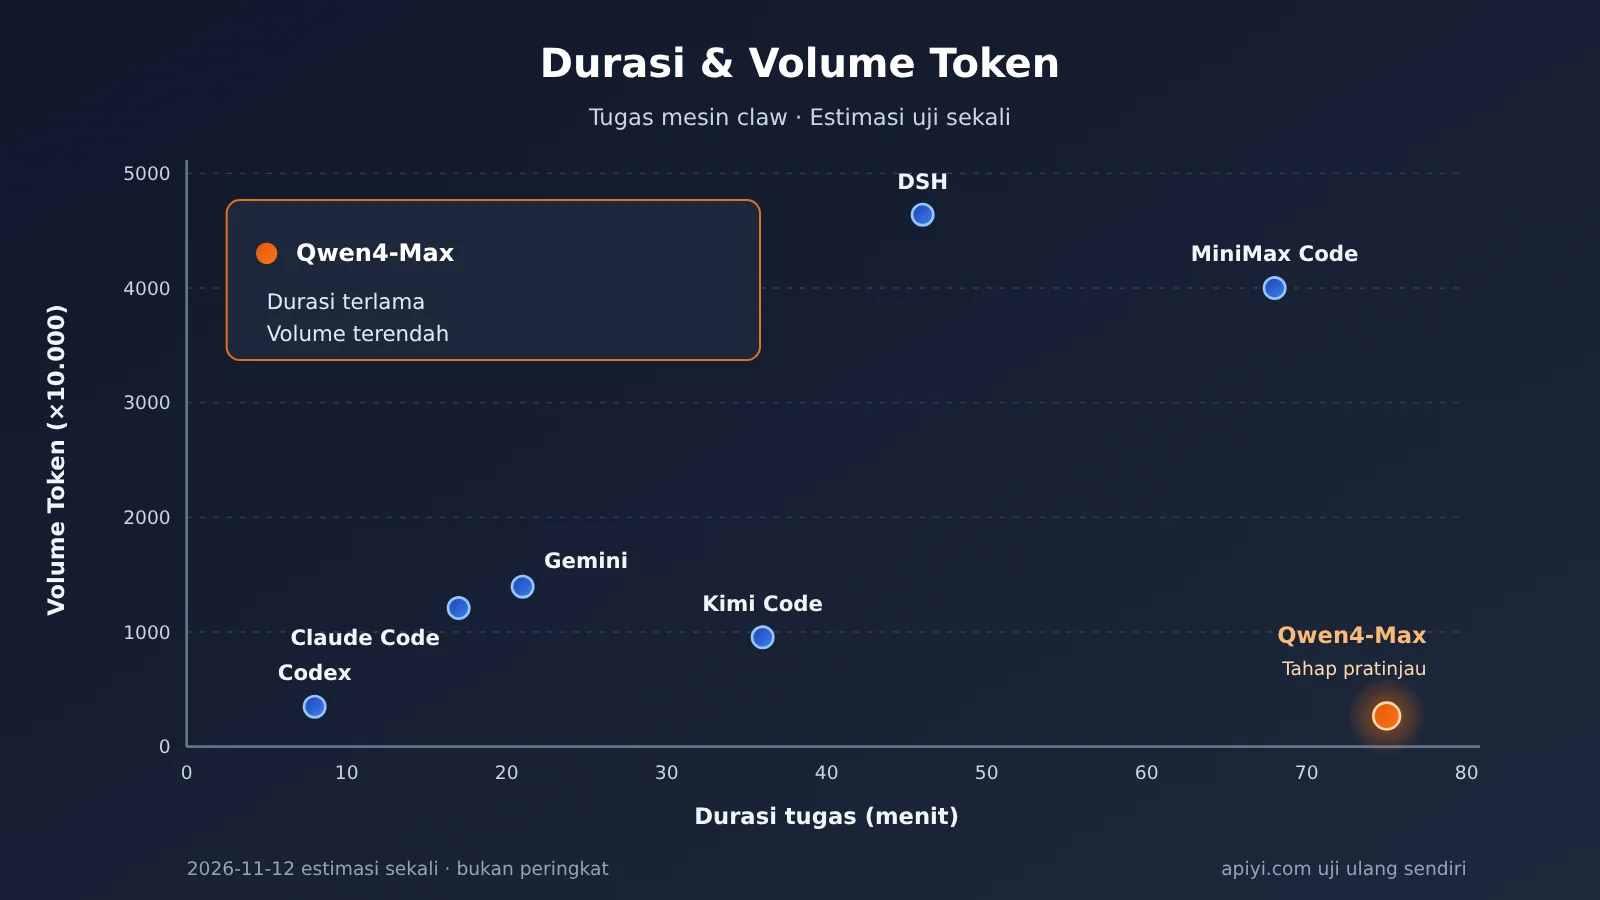
Laporan 12 November juga mencantumkan catatan tantangan mesin capit boneka yang sama pada berbagai alat. Baris Qwen pada tabel asli dilabeli Qwen4-Max, waktu pengujiannya 12 November, lebih awal dari peluncuran versi resmi pada 16 November, dan yang dimaksud adalah model tahap pratinjau.
| Alat/Model | Durasi | Total Token Diproses (estimasi) | Token Keluaran | Akses Uji Ulang |
|---|---|---|---|---|
| Codex | 8 menit | 3,5 juta | 28 ribu | Alat resmi terkait |
| Claude Code | 17 menit | 12,15 juta | 130 ribu | Alat resmi; model Claude dapat dipanggil melalui APIYI apiyi.com |
| Gemini | 21 menit | 13,94 juta | 81 ribu | Alat resmi; model Gemini dapat dipanggil melalui APIYI |
| Kimi Code | 36 menit | 9,5 juta | 59 ribu | Alat resmi terkait |
| DSH | 46 menit | 46,44 juta | 281 ribu | Alat resmi terkait |
| MiniMax Code | 68 menit | 40 juta | 198 ribu | Alat resmi terkait |
| Qwen4-Max (fase pratinjau) | 75 menit | 2,69 juta | 55 ribu | Token Plan (Qoder) |
6.2 Cara membaca data ini
Data menunjukkan kontras yang jelas: Qwen4-Max-Preview memiliki total Token yang diproses paling rendah pada tugas ini, sekitar 2,69 juta, tetapi durasinya paling lama, sekitar 75 menit. Dengan kecepatan pengamatan sekitar 33 token/detik, terlihat bahwa hambatan tugas kali ini ada pada kecepatan generasi; skala token yang dikonsumsi sendiri tidak besar.
Data ini tidak cocok untuk dijadikan peringkat karena tiga alasan: total Token merupakan estimasi penulis; proporsi cache konteks, strategi pemanggilan, dan cara eksekusi tiap alat berbeda; versi spesifik tiap model dalam tabel juga tidak dijelaskan secara seragam. Volume pemrosesan token yang rendah bisa berasal dari pembacaan berulang yang lebih sedikit, atau bisa juga dari perbedaan strategi cache di lapisan alat; materi yang ada tidak dapat membedakan keduanya. Yang dapat didukung oleh data ini adalah: dalam lingkungan alat ini, Qwen4-Max-Preview cocok untuk tugas yang tidak sensitif terhadap waktu tunggu dan lebih mementingkan kelengkapan hasil akhir.
7 Pengembang mana yang layak mencoba Qwen4-Max-Preview
7.1 Skenario yang cocok dan perlu kehati-hatian
Berdasarkan kedua laporan, Qwen4-Max-Preview menunjukkan performa yang relatif stabil dalam tugas-tugas berikut:
- Pemeliharaan kode dengan aturan yang jelas: tugas perbaikan dan penambahan pengujian yang sudah memiliki pengujian siap pakai serta batas masalah yang jelas.
- Penelusuran dan pengaitan dokumen panjang: pencarian lintas catatan dalam tiket, log, kontrak, dan laporan keuangan, disertai verifikasi ulang hasil statistik dengan skrip.
- Otomasi perkantoran: pembersihan data, Excel dengan rumus, PPT yang dapat diedit, dan revisi beberapa putaran.
- Pengembangan prototipe interaktif: halaman web satu file, sistem simulasi, dan prototipe mini game, misalnya halaman tampilan offline sekitar 46KB tanpa dependensi eksternal dalam laporan.
Ada tiga jenis tugas yang perlu diwaspadai: pengembangan interaktif yang sensitif terhadap waktu respons (satu tugas dapat berlangsung lebih dari satu jam), output kesimpulan yang memerlukan argumentasi matematis atau ilmiah yang ketat, serta perubahan produksi dengan persyaratan keandalan tinggi. Ringkasan penulis laporan juga mencakup “sebagian informasi terlewat dalam tugas dengan cakupan yang luas” dan “hasil akhir masih perlu diverifikasi secara manual”.
Sebelum digunakan, perhatikan juga batasan resmi: Preview hanya dapat digunakan secara interaktif melalui Alibaba Cloud Token Plan di alat seperti Claude Code, Cursor, dan Qoder, serta tidak mendukung pembayaran sesuai pemakaian. Masa pratinjau berakhir pada 25 November 2026 pukul 24:00 (Waktu Beijing), setelah itu layanan dihentikan. Versi resmi Qwen4-Max telah diluncurkan pada 16 November, dan pihak resmi menyarankan migrasi ke versi resmi. Parameter keduanya berbeda: output maksimum mode berpikir versi resmi adalah 262,144 Tokens, sedangkan Preview 393,216 Tokens; saat migrasi, anggaran output perlu diatur ulang.
7.2 Lakukan pengujian ulang sejenis dengan tugas Anda sendiri
Laporan pihak lain paling banter hanya bisa menunjukkan bahwa “model ini mampu melakukannya”. Cara paling langsung untuk menentukan apakah model tersebut cocok untuk tim Anda adalah dengan mengambil kode dan pengujian nyata Anda sendiri, lalu melakukan perbandingan. Contoh di bawah ini mengirim tugas perbaikan kode melalui antarmuka yang kompatibel dengan OpenAI, sekaligus mencatat waktu tempuh dan penggunaan Token. Untuk nama model, gunakan nama aktual yang tercantum dalam daftar model platform.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",  # Gunakan nama aktual dalam daftar model APIYI
    messages=[{"role": "user", "content": "阅读以下代码与失败的测试,给出最小修复补丁:..."}]
)
print(resp.choices[0].message.content)
Lihat skrip pengujian ulang perbandingan multi-model
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu Key untuk memanggil beberapa model
)

# Ganti dengan nama aktual dalam daftar model platform
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """你将收到一个 Python 服务的源码和测试结果。
要求:1) 先说明复现到的失败原因;2) 只修改必要文件;
3) 补充覆盖边界条件的测试;4) 不得修改原始数据和已有测试。
--- 源码与测试输出 ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # Token berpikir dari model penalaran juga memakai anggaran output, jadi perlu disisihkan ruang
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # Terapkan patch ke direktori terisolasi, jalankan pengujian, dan verifikasi hash pada data asli sebelum menilai
Skrip hanya bertugas mengumpulkan solusi dan penggunaan; tahap penilaian harus mengikuti cara yang dilakukan dalam laporan: terapkan patch di direktori terisolasi, jalankan pengujian lama dan pengujian baru, lalu gunakan nilai hash untuk memastikan data dan pengujian lama tidak diubah. Dengan begitu, kesimpulan yang Anda peroleh baru valid untuk basis kode Anda.
🚀 Mulai cepat: Jika ingin membandingkan beberapa model pada rangkaian tugas yang sama, Anda bisa memperoleh kuota pengujian gratis melalui APIYI apiyi.com. Platform menyediakan antarmuka yang kompatibel dengan OpenAI; satu kunci API sudah cukup untuk beralih antara model-model utama seperti OpenAI, Claude, dan Gemini, sehingga memudahkan Anda menjalankan skrip pengujian ulang dalam satu alur evaluasi yang sama.
8 Pertanyaan Umum Seputar Evaluasi Qwen4-Max-Preview
Q1: Menyelesaikan claw machine dalam 75 menit, apakah itu berarti lambat?
Dalam tugas Qoder tersebut, waktunya adalah yang terlama di tabel perbandingan, dengan kecepatan output yang diamati sekitar 33 Token/detik. Ini hanya catatan dalam satu lingkungan saja; penjadwalan alat dan kondisi jaringan dapat memengaruhi hasil. Jika skenario Anda sensitif terhadap waktu tunggu, sebaiknya uji langsung dengan tugas Anda sendiri.
Q2: Apakah 57 tes yang lulus bisa mewakili tingkat keberhasilan perbaikan kodenya?
Ini mewakili satu proses perbaikan yang lengkap dan dapat diverifikasi, dan tidak bisa dikonversi menjadi tingkat keberhasilan. Untuk mengevaluasi performa di proyek Anda sendiri, Anda bisa membandingkan beberapa model melalui APIYI apiyi.com dengan set sampel bug yang sama, lalu memberi skor berdasarkan hasil kelulusan tes dan hasil verifikasi hash.
Q3: Apakah tes tiket ini memverifikasi konteks 1 juta Token?
Tidak. Tes tersebut sekitar 500 ribu byte; jumlah Token bergantung pada metode tokenisasi, dan skalanya jauh lebih kecil dari batas jendela. Yang diverifikasi adalah kemampuan korelasi lintas catatan dan penyaringan berdasarkan kondisi.
Q4: Apa yang harus dilakukan setelah Preview berakhir?
Versi resmi Qwen4-Max sudah dirilis, dan disarankan menggunakan versi resmi. Versi resmi mendukung API dengan pembayaran sesuai penggunaan, dengan output maksimum mode berpikir sebesar 262.144 Token; saat migrasi Anda perlu menyesuaikan anggaran output. Ketersediaan dan harga di platform pihak ketiga berubah cukup cepat, jadi Anda bisa memastikan nama model yang tersedia saat ini di daftar model APIYI apiyi.com sebelum mengintegrasikan.
Q5: Bisakah Key dari Token Plan dimasukkan ke backend aplikasi sendiri?
Tidak bisa. Ketentuan resmi menyatakan Token Plan hanya boleh digunakan secara interaktif di alat pemrograman dan alat agen yang diizinkan; pemanggilan batch lewat skrip otomatis dan backend aplikasi buatan sendiri tidak termasuk dalam cakupan yang diizinkan, dan pelanggaran dapat menyebabkan langganan dijeda atau Key diblokir. Aplikasi buatan sendiri sebaiknya memilih produk API yang sesuai dengan cakupan penggunaan.
9 Poin Penting Pengujian Qwen4-Max-Preview
- Siklus penyelesaian: Tugas perbaikan kode mencakup reproduksi, perbaikan, pengujian tambahan, verifikasi hash, permintaan nyata, dan verifikasi ulang hasil; 57 pengujian lulus.
- Kaitan teks panjang: Dalam 1,600 tiket, ditemukan petunjuk kaitan lintas data sepanjang 741 baris; 5 pertanyaan dijawab benar semua; 62 item statistik konsisten dengan skrip.
- Hasil pekerjaan kantor: Rumus Excel dapat saling terhubung; setelah beberapa putaran revisi PPT, 20 fakta kunci tetap tidak berubah.
- Kekurangan kecepatan: Tugas mesin capit boneka memakan waktu sekitar 75 menit; volume token yang diproses rendah dan waktu yang dibutuhkan lama.
- Batas penalaran: Perhitungan reproduksi penelitian sesuai dengan hasil referensi, tetapi kesimpulan mengandung inferensi berlebihan dan memerlukan tinjauan manusia.
- Sifat bukti: Semua hal di atas merupakan pengujian tugas oleh satu penulis dan bukan merupakan peringkat terstandardisasi.
- Cara memulai: Lakukan pengujian ulang pembanding dengan kode dan pengujian Anda sendiri; Anda dapat menggunakan APIYI apiyi.com untuk beralih antar beberapa model dalam satu antarmuka.
10 Kesimpulan: Di Mana Pengembang Sebaiknya Menggunakan Qwen4-Max-Preview
Laporan publik memberikan gambaran yang cukup jelas. Qwen4-Max-Preview unggul dalam pekerjaan dengan aturan jelas dan hasil yang dapat diperiksa: pemeliharaan kode dengan pengujian, pencarian lintas catatan dalam materi panjang, pemrosesan data dengan rumus dan file kantor yang dapat diedit, serta pengembangan prototipe interaktif. Dalam tugas-tugas ini, ia dapat menambahkan pengujian sendiri, memeriksa kesalahan sendiri, dan menyerahkan hasil yang dapat diverifikasi ulang.
Batasan juga spesifik: tugas kompleks memakan waktu lama dan cocok dijalankan di latar belakang; kesimpulan ilmiah mudah melampaui cakupan bukti sehingga perlu tinjauan ahli; versi Preview hanya dapat digunakan secara interaktif melalui Token Plan di alat tertentu, dan akan dihentikan pada 25 November; penggunaan jangka panjang harus beralih ke versi resmi.
Pendekatan paling praktis adalah menganggapnya sebagai asisten teknik yang dapat menyelesaikan siklus pemeliharaan secara mandiri, dengan pengembang bertanggung jawab atas verifikasi kesimpulan dan penggabungan akhir. Sebelum peluncuran, disarankan melakukan perbandingan multi-model dengan tugas nyata Anda sendiri; melalui antarmuka terpadu APIYI apiyi.com, pengujian dan perbandingan dapat dilakukan dalam alur yang sama.
📚 Referensi
-
Semua Orang adalah Product Manager: Versi preview Qwen4-Max telah hadir! Uji langsung dan kesan: Uji coba mesin capit boneka Qoder dan perbandingan lintas alat, 2026-11-12
- Tautan:
woshipm.com/ai/6492544.html - Keterangan: sumber data 75 menit waktu, 33 Tokens/s, 65 Credits, dan tabel perbandingan
- Tautan:
-
Semua Orang adalah Product Manager: Uji coba Qwen4-Max-Preview (Laporan Tes Z Finance): Tes komprehensif 12 tugas, 2026-11-16
- Tautan:
woshipm.com/evaluating/6494229.html - Keterangan: sumber data perbaikan kode, pencarian tiket, reproduksi riset, dan tugas kantor
- Tautan:
-
Dokumen Qwen4-Max-Preview Alibaba Cloud Model Studio: Spesifikasi resmi dan petunjuk penggunaan
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max-preview - Keterangan: jendela konteks, output maksimum, waktu preview, dan cara integrasi
- Tautan:
-
Dokumen Qwen4-Max Alibaba Cloud Model Studio: Parameter versi resmi dan penagihan
- Tautan:
help.aliyun.com/zh/model-studio/qwen4-max - Keterangan: anggaran output versi resmi dan informasi pembayaran sesuai pemakaian
- Tautan:
-
Alibaba Cloud: Izin dan Ketentuan Penggunaan Token Plan: Batasan cakupan penggunaan
- Tautan:
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Keterangan: persyaratan penggunaan interaktif dan skenario yang dilarang
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui beranda situs APIYI apiyi.com, materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com