Ringkasan: API paket lengkap DeepSeek menagih Token model dan pemanggilan tool secara terpisah. Biaya penuh harus dihitung per item berdasarkan jumlah pencarian, jumlah halaman file, volume pemrosesan suara, dan rasio cache hit.
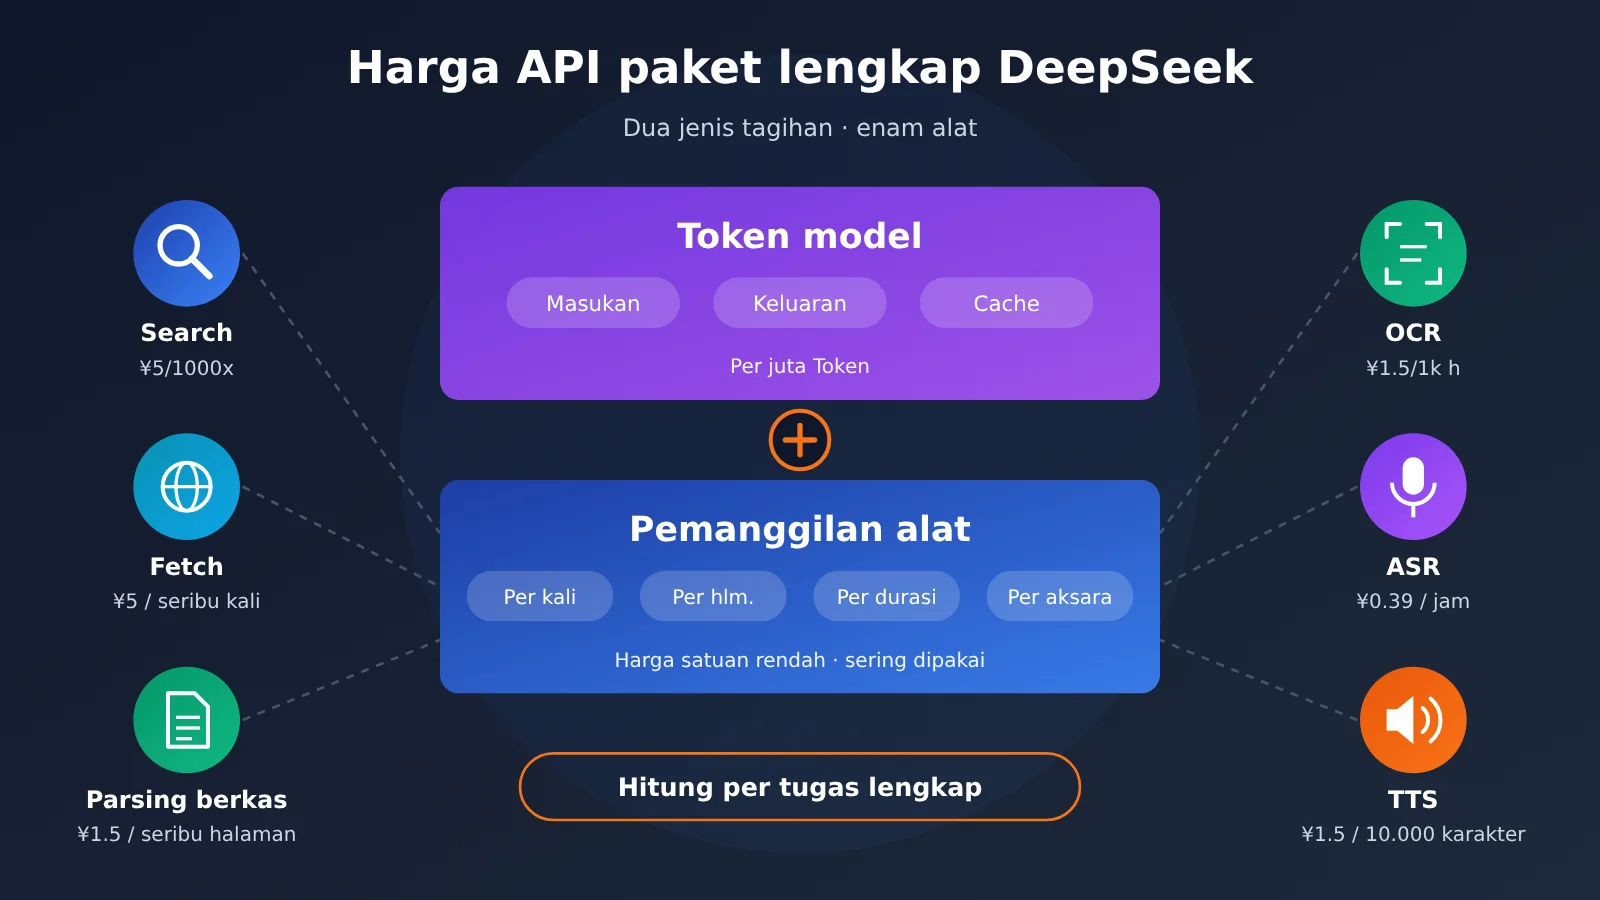
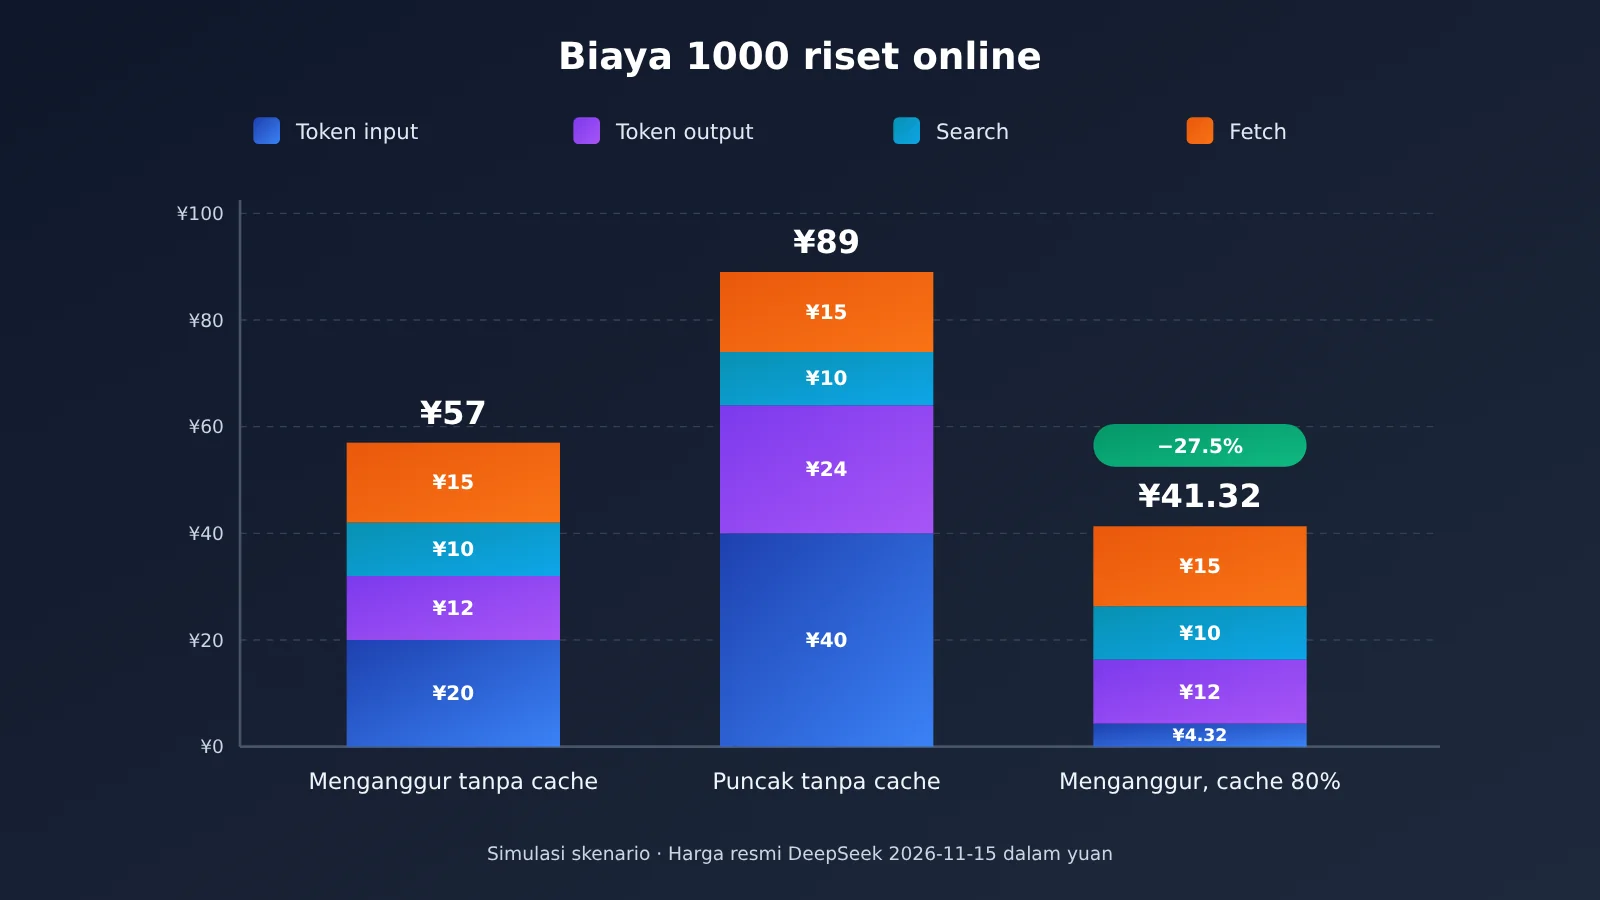
Kesimpulan di awal: Menurut dokumen harga resmi DeepSeek versi bahasa Mandarin per 15 November 2026, Search dan Fetch masing-masing ¥5 per 1000 permintaan berhasil, parsing file dan OCR masing-masing ¥1.5 per 1000 halaman, harga terbatas waktu ASR adalah ¥0.39 per jam, dan harga terbatas waktu TTS adalah ¥1.5 per 10000 karakter penagihan. Harga satuan tool sangat rendah, tetapi tagihan untuk satu tugas Agent yang terhubung ke internet biasanya didominasi oleh Token model. Dengan estimasi tugas riset “2 pencarian, 3 pengambilan, 20 ribu Token input, 3000 Token output”, 1000 tugas pada periode sepi sekitar ¥57 dan pada jam sibuk sekitar ¥89; saat cache hit input 80%, periode sepi bisa turun ke sekitar ¥41.32. Jadi, saat menyusun anggaran, hitunglah per “tugas lengkap”; harga satu permintaan API hanyalah salah satu komponen di dalamnya.
Berikut ini, kami akan terlebih dahulu menguraikan struktur penagihan untuk biaya model dan biaya tool, lalu merinci harga satuan dan unit penagihan untuk Search, Fetch, parsing file, OCR, ASR, dan TTS. Selanjutnya, kami mendemonstrasikan algoritma lengkap menggunakan 4 skenario dengan asumsi tetap, menjelaskan bagaimana pencarian mendalam, konteks panjang, dan rate limit memengaruhi tagihan. Terakhir, kami memberikan kode log biaya yang dapat langsung digunakan kembali, serta membandingkan metode pemilihan antara pencarian bawaan model dan antarmuka Search / Fetch independen.
Perlu Diketahui: Terminologi Penagihan API Paket Lengkap DeepSeek
| Istilah | Penjelasan |
|---|---|
| Token | Unit pengukuran yang digunakan model saat memproses teks; biaya model dihitung per satu juta Token |
| Token Masukan | Seluruh konten yang masuk ke jendela konteks model dan ikut serta dalam inferensi, termasuk petunjuk, konten file, dan hasil pencarian |
| Token Keluaran | Konten yang dihasilkan model; proses penalaran dalam mode berpikir juga dihitung sebagai keluaran |
| Context Cache | Menggunakan kembali konteks yang sudah diproses sebelumnya untuk menekan biaya masukan yang berulang |
| Cache Hit | Konten masukan berhasil menggunakan kembali cache, sehingga ditagih dengan harga satuan “cache hit” yang lebih rendah |
| Periode sibuk / menganggur | Dua tingkat harga DeepSeek yang dibedakan berdasarkan waktu Beijing; harga periode menganggur adalah setengah dari harga periode sibuk |
| Search API | Mencari halaman web berdasarkan kata kunci dan mengembalikan hasil pencarian yang terstruktur |
| Fetch API | Mengambil halaman web tertentu dan mengembalikan konten isi utamanya |
| Pencarian bawaan model | Mendeklarasikan alat pencarian dalam permintaan percakapan; model memutuskan sendiri kapan mencari, dan server yang menjalankannya |
| QPS | Jumlah permintaan yang diizinkan untuk diproses per detik |
| OCR | Mengenali teks dari gambar atau dokumen |
| ASR | Mengubah ucapan menjadi teks |
| TTS | Mengubah teks menjadi suara |
| Karakter penagihan | Unit pengukuran untuk TTS; satu karakter Hanzi Mandarin dihitung sebagai 2 karakter penagihan |
| Tool Usage | Pemakaian yang ditagih akibat pemanggilan alat eksternal yang benar-benar dilakukan oleh model atau program |
1 Bagaimana sebenarnya tarif API paket lengkap DeepSeek
1.1 Dua jenis tagihan API paket lengkap DeepSeek: biaya model dan biaya alat
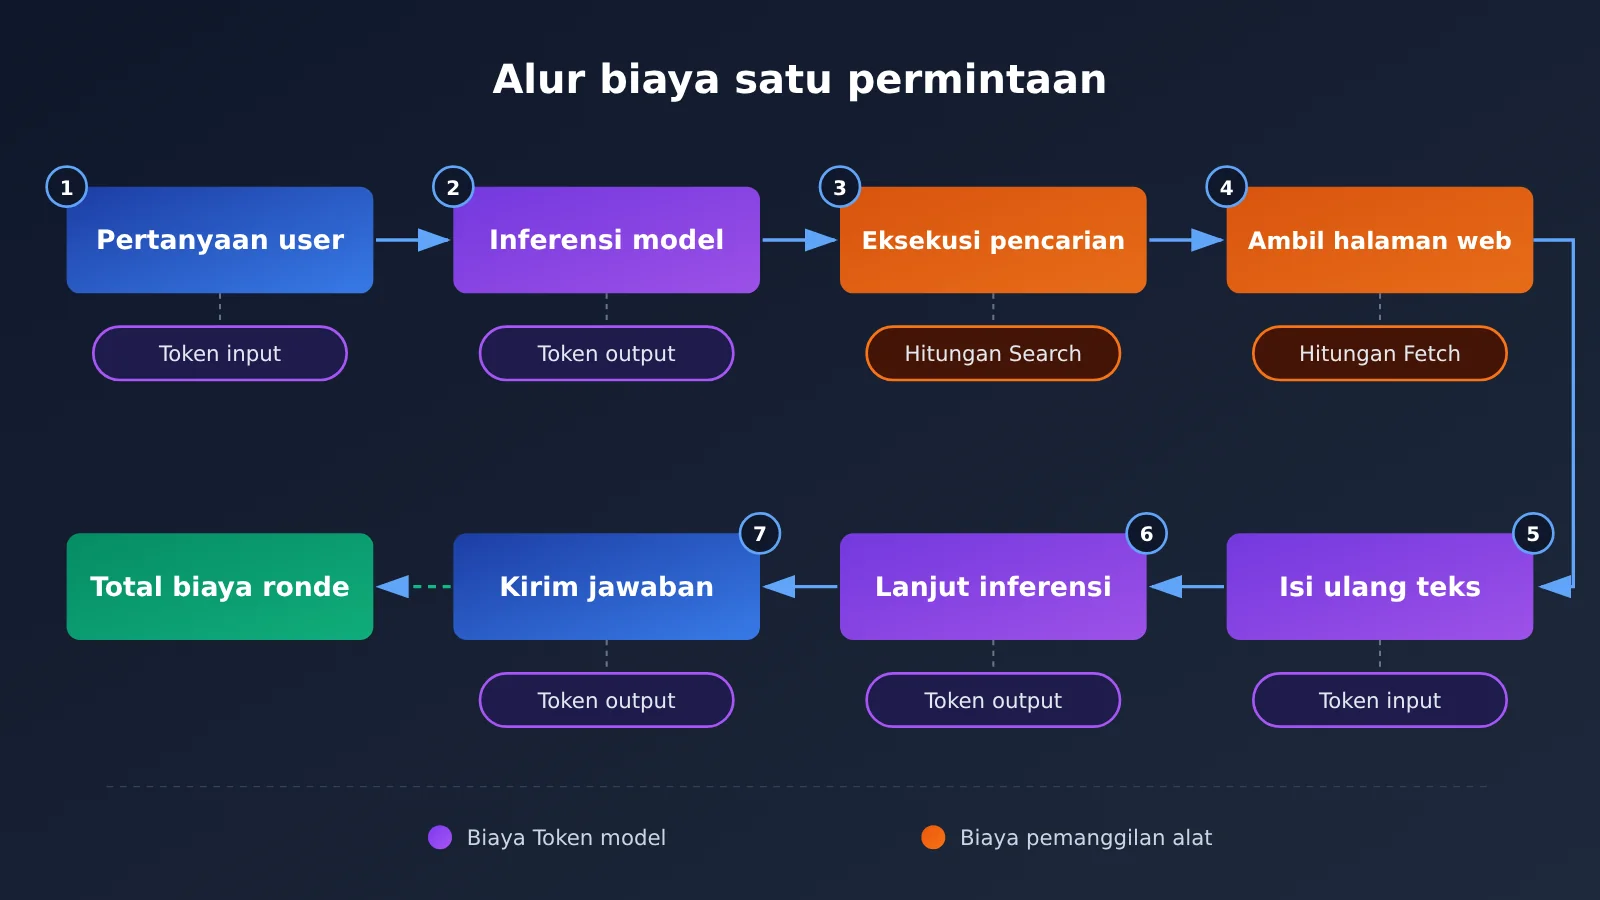
Pada 13 November 2026, DeepSeek membuka kemampuan di balik App — pencarian web, pencarian dengan penalaran mendalam, membaca tautan, input file, OCR, ASR, TTS, serta validasi keamanan — sebagai API. Dalam hal penagihan, kemampuan tersebut dan inferensi model dihitung secara terpisah. Bisa dirangkum dengan satu rumus:
Total biaya = biaya input model (cache hit + cache miss)
       + biaya output model (termasuk Token penalaran)
       + biaya pemanggilan alat (Search / Fetch / pencarian gambar)
       + biaya pemrosesan file dan suara (jumlah halaman parsing / halaman OCR / durasi audio / karakter TTS)
Satu putaran tanya jawab bisa sekaligus memunculkan setiap biaya di atas. Misalnya, setelah pencarian dengan penalaran mendalam diaktifkan dalam percakapan, model akan berkali-kali menghasilkan kata kunci pencarian, membuka beberapa halaman web, lalu menyisipkan isi halaman tersebut ke konteks untuk melanjutkan inferensi. Permintaan pada putaran ini menghasilkan biaya pencarian dan pengambilan, sekaligus biaya Token input dalam jumlah besar karena teks halaman web masuk ke konteks; proses penalaran juga ikut dihitung sebagai Token output.
1.2 Harga model DeepSeek Flash dan Pro
Berikut harga yang diumumkan dalam dokumen harga resmi DeepSeek pada 15 November 2026, mata uang yuan Tiongkok, satuan per juta Token.
| Model | Cache hit (jam sepi / jam sibuk) | Cache miss (jam sepi / jam sibuk) | Output (jam sepi / jam sibuk) | Batas konkrensi |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | ¥0.02 / ¥0.04 | ¥1 / ¥2 | ¥4 / ¥8 | 2500 |
| DeepSeek-V4-Pro | ¥0.15 / ¥0.30 | ¥4.5 / ¥9 | ¥13.5 / ¥27 | 500 |
Jam sibuk adalah pukul 09.00—12.00 dan 14.00—18.00 waktu Beijing, Senin hingga Jumat, tidak termasuk hari libur nasional Tiongkok; waktu lainnya (termasuk akhir pekan dan sepanjang hari libur nasional) adalah jam sepi. Panjang konteks kedua model sama-sama 1M, panjang output maksimum 384K; Flash mendukung pemahaman gambar, Pro tidak.
Pilihan model juga memengaruhi ketersediaan alat. Dalam pengumuman ini, integrasi alat lengkap tingkat percakapan (pencarian web, pencarian dengan penalaran mendalam, membaca tautan, parsing file, pemahaman gambar, validasi keamanan) dijalankan oleh deepseek-flash (DeepSeek-V4.1-Flash). Saat merencanakan aplikasi yang membutuhkan alat bawaan, model biaya sebaiknya dibangun dengan Flash sebagai acuan.
2 Berapa harga Search, Fetch, OCR, ASR, dan TTS dalam paket lengkap API DeepSeek
Tabel di bawah ini merupakan harga resmi alat DeepSeek (per 15 November 2026, dalam yuan Tiongkok). “Harga katalog” dan “diskon waktu terbatas” dicantumkan secara terpisah; setelah diskon waktu terbatas berakhir, anggaran perlu dihitung ulang berdasarkan harga katalog.
| Kemampuan | Satuan penagihan | Harga katalog | Diskon waktu terbatas | Konversi per sekali / satuan |
|---|---|---|---|---|
| Search pencarian | 1000 permintaan sukses | ¥5 | ¥5 | ¥0,005 / kali |
| Fetch pengambilan halaman web | 1000 permintaan sukses | ¥5 | ¥5 | ¥0,005 / kali |
| Parsing berkas | 1000 halaman | ¥1,5 | ¥1,5 | ¥0,0015 / halaman |
| OCR | 1000 halaman | ¥1,5 | ¥1,5 | ¥0,0015 / halaman |
| ASR | 1 jam audio | ¥0,78 | ¥0,39 | Kurang dari 1 detik dihitung 1 detik |
| TTS | 10000 karakter terhitung | ¥3 | ¥1,5 | Huruf Tionghoa dihitung 2 karakter |
2.1 Cara penagihan DeepSeek Search dan Fetch
Search mandiri ditagih berdasarkan permintaan yang berhasil: HTTP 200 dan array results tidak kosong barulah dianggap berhasil. Satu permintaan dapat mengembalikan 1—50 hasil (count default 10); mengembalikan 1 hasil dan 50 hasil harganya sama, jadi mengambil lebih banyak hasil dalam satu permintaan lebih hemat dibandingkan beberapa permintaan dengan hasil sedikit. Fetch mandiri mensyaratkan HTTP 200 dan berhasil mengembalikan isi halaman web; kegagalan, timeout, atau tidak ada hasil tidak dikenakan biaya.
Perhitungan pencarian bawaan model berbeda. Pencarian teks bawaan ditagih berdasarkan jumlah kata kunci kueri yang benar-benar dieksekusi; satu pemanggilan alat dengan 3 kata kunci kueri dihitung 3 kali; pencarian gambar bawaan ditagih berdasarkan jumlah gambar yang dikembalikan dan jumlah area yang dipilih; pengambilan halaman web bawaan ditagih berdasarkan jumlah halaman web yang berhasil diambil. Jadi ketika pencarian diaktifkan dalam percakapan, satu putaran tanya jawab yang menghasilkan biaya pencarian beberapa kali adalah hal yang wajar.
2.2 Penagihan per halaman untuk parsing file dan OCR DeepSeek
Parsing file dilakukan melalui Files API: unggah file, server memprosesnya, lalu mengembalikan file_id; cukup merujuk file_id tersebut dalam percakapan. Penagihan dihitung berdasarkan jumlah halaman yang berhasil diparse, yaitu ¥1.5 per 1000 halaman. Setelah itu, jika file yang sama dirujuk lagi dalam percakapan, tidak ada lagi biaya parsing, tetapi setiap kali konten file masuk ke konteks, biaya akan dihitung sebagai Token input.
Mode parsing juga memengaruhi penggunaan Token. text_recognition hanya memberikan teks murni kepada model, sedangkan rich_layout_recognition memotong grafik dan tabel menjadi gambar lalu mengirimkannya bersama teks; cocok untuk laporan keuangan dan PPT, tetapi menambah Token gambar. File seperti XLSX, CSV, TXT, MD, JSON, dan EPUB dapat diunggah sebagai user_data dan dikonversi ke Markdown; unggahan jenis ini tidak dikenakan biaya parsing.
OCR adalah antarmuka terpisah (/v1/tools/ocr), juga ¥1.5 per 1000 halaman, ditagih berdasarkan jumlah halaman yang berhasil dikenali; kegagalan dan timeout tidak dikenakan biaya. Keduanya memiliki peran berbeda: OCR hanya bertugas mengekstrak teks dan informasi posisi, sedangkan parsing file langsung memasukkan hasilnya ke konteks model agar dapat dipahami oleh model.
2.3 Penagihan suara untuk ASR dan TTS DeepSeek
ASR (/v1/tools/asr) memiliki harga resmi ¥0.78 per jam audio, saat ini diskon 50% terbatas menjadi ¥0.39, dan durasi kurang dari 1 detik dihitung sebagai 1 detik. Layanan ini menggunakan unggahan file penuh dan pengenalan non-streaming; satu audio maksimal 120 detik dan 8 MiB, mendukung WAV PCM 16-bit dan Ogg Opus, dengan konkurensi 50 per akun. Rekaman panjang harus dipotong terlebih dahulu; sisa kurang dari 1 detik di akhir setiap segmen akan dibulatkan naik masing-masing, sehingga semakin kecil potongannya, semakin banyak pembulatan yang terakumulasi.
TTS (/v1/tools/tts, juga mendukung sintesis streaming WebSocket) memiliki harga resmi ¥3 per 10000 karakter tertagih, dengan harga terbatas ¥1.5. Karakter Han berbahasa Tionghoa dihitung 2 karakter tertagih, sedangkan huruf Latin, angka, dan spasi dihitung 1; input maksimal 10000 karakter tertagih per permintaan. Jika dikonversi, 100.000 karakter tertagih kira-kira setara dengan 50.000 karakter Han, jadi anggaran untuk konten berbahasa Tionghoa harus dikalikan 2 terlebih dahulu.
3 Estimasi Biaya API Paket Lengkap DeepSeek untuk Empat Skenario
Keempat contoh berikut dihitung berdasarkan harga satuan publik dan asumsi tetap. Jumlah pemanggilan dan penggunaan Token adalah nilai asumsi, jadi ini merupakan simulasi skenario yang merepresentasikan metode perhitungan; tagihan aktual mengacu pada field penagihan yang dikembalikan server.
3.1 Skenario Satu: 1000 Tugas Riset Terhubung Internet (Waktu Sepi ¥57 / Jam Sibuk ¥89)
Asumsi: Menggunakan DeepSeek-V4.1-Flash; setiap tugas memiliki 2 kata kunci kueri pencarian yang berhasil, 3 halaman web yang berhasil diambil, 20000 Token input yang tidak ditemukan di cache, dan 3000 Token output.
| Item | Rumus Perhitungan | Waktu Sepi (¥/tugas) | Jam Sibuk (¥/tugas) |
|---|---|---|---|
| Token input | 20000 ÷ 1000000 × harga satuan | 0.020 | 0.040 |
| Token output | 3000 ÷ 1000000 × harga satuan | 0.012 | 0.024 |
| Search | 2 × ¥0.005 | 0.010 | 0.010 |
| Fetch | 3 × ¥0.005 | 0.015 | 0.015 |
| Total per tugas | — | 0.057 | 0.089 |
| Total 1000 tugas | per tugas × 1000 | ¥57 | ¥89 |
Pada jam sibuk, biaya Token model menjadi dua kali lipat, sedangkan harga Search dan Fetch tidak berubah. Karena itu total tagihan naik dari ¥57 menjadi ¥89, yaitu kenaikan sekitar 56%. Dalam tugas ini, biaya model menyumbang sekitar 56% dari tagihan waktu sepi (¥32 / ¥57), yang menunjukkan bahwa porsi terbesar Agent terhubung internet tetap ada pada Token. Menempatkan tugas batch yang bisa ditunda ke waktu sepi adalah cara paling langsung untuk menekan biaya.
3.2 Skenario 2: Berapa Banyak Penghematan dengan Cache Hit Input 80%
Asumsi: Kondisi sama seperti skenario 1 (jam sepi), tetapi dari 20.000 token input, 16.000 kena cache dan 4.000 tidak.
- Input cache hit: 16000 ÷ 1000000 × ¥0.02 = ¥0.00032
- Input cache miss: 4000 ÷ 1000000 × ¥1 = ¥0.004
- Output: 3000 ÷ 1000000 × ¥4 = ¥0.012
- Pencarian + pengambilan: ¥0.010 + ¥0.015 = ¥0.025
- Total per panggilan ¥0.04132, total 1000 kali ¥41.32
Dibandingkan dengan ¥57 pada skenario 1, ini menghemat ¥15.68, sekitar 27.5%. Cache hanya berlaku pada biaya input: input turun dari ¥0.020 menjadi sekitar ¥0.0043, sementara biaya output dan alat tetap sama sekali tidak berubah. Semakin tinggi tingkat cache hit, tagihan semakin mendekati batas bawah “output + alat”. Pada titik ini, untuk terus menekan biaya, Anda perlu mengurangi jumlah pencarian dan mengendalikan panjang output.
3.3 Skenario tiga: pemrosesan batch 5000 halaman dokumen perusahaan
Asumsi: Flash pada jam sepi; 5000 halaman dokumen hanya diurai sekali; analisis berikutnya mengakumulasi 10 juta Token input yang cache-nya tidak kena (cache miss) dan 1 juta Token output.
- Pemrosesan file: 5000 ÷ 1000 × ¥1.5 = ¥7.50
- Input model: 10000000 ÷ 1000000 × ¥1 = ¥10.00
- Output model: 1000000 ÷ 1000000 × ¥4 = ¥4.00
- Total ¥21.50
Biaya penguraian hanya sekitar 35%. Kalau file yang sama dimasukkan utuh ke jendela konteks berulang kali di banyak putaran percakapan, Token input akan berlipat ganda, sementara biaya penguraian tidak bertambah. Inti dari skenario dokumen besar adalah mengendalikan “berapa kali isi file masuk ke jendela konteks”.
3.4 Skenario empat: pengenalan suara 10 jam + TTS 100 ribu karakter terbilang
Asumsi: Menggunakan harga diskon 50% yang berlaku terbatas saat ini; ASR untuk audio 10 jam, TTS 100000 karakter terbilang.
- ASR: 10 × ¥0.39 = ¥3.90
- TTS: 100000 ÷ 10000 × ¥1.5 = ¥15.00
- Total ¥18.90
Biaya ini hanya mencakup layanan suara. Saat teks transkripsi diserahkan ke model percakapan untuk diringkas atau untuk tanya jawab, Token model dihitung terpisah. Dengan harga daftar resmi, pemakaian yang sama menjadi 10 × ¥0.78 + 10 × ¥3 = ¥37.80; setelah masa diskon berakhir, anggaran suara akan berlipat ganda. Selain itu, audio 10 jam harus dipotong minimal menjadi 300 segmen dengan batas atas 120 detik, dan perlu dijadwalkan dengan konkurensi 50.
4 Faktor apa yang membuat tagihan API paket lengkap DeepSeek naik
4.1 Pencarian deep thinking mengeksekusi beberapa kata kueri sekaligus
Pencarian deep thinking bisa memanggil hingga sekitar 20 alat sebelum menjawab, dan penagihan diakumulasikan berdasarkan aksi yang benar-benar terjadi. Beberapa aturan kunci dari rincian penagihan resmi:
- Satu Search yang memuat 3 kata kueri dan semuanya berhasil → dihitung 3 kali pencarian
- Pencarian gambar yang mengembalikan 3 gambar dihitung 3 kali; jika model kemudian memilih 2 area pada gambar, ditambah 2 kali lagi
- Membuka 1 halaman web yang perlu diambil dari internet dihitung 1 Fetch; membuka halaman yang sama lagi tidak ditagih ulang
- Menjalankan
find_in_pagepada halaman yang sudah dibuka tidak ditagih terpisah; Search tanpa hasil tidak ditagih - Saat keamanan konten model diaktifkan, sebagian halaman web meski tampil sebagai
url_not_allowedatauunavailable, jika di lapisan bawah sudah berhasil diambil tetap bisa ditagih
Saat menghitung, gunakan field penagihan server_tool_use.tool_search, tool_fetch, tool_image_search. web_search_requests dan web_fetch_requests hanya menampilkan jumlah blok yang dikembalikan dan bisa memuat permintaan gagal; menghitung berdasarkan field itu akan melebih-lebihkan biaya.
4.2 Konteks panjang dan input berkas yang berulang
Hasil pencarian, isi halaman web, dan berkas yang sudah diparse semuanya masuk ke konteks. Alat pembaca tautan mempertimbangkan maksimal 10 URL berbeda di pesan pengguna terakhir; saat beberapa halaman dibaca sekaligus, konteks yang tersedia per halaman mengecil, tetapi total input tetap besar. Sesi panjang membawa konten riwayat di setiap putaran, sehingga Token input bertambah secara kumulatif seiring bertambahnya putaran.
Ada tiga cara menurunkan biaya: simpan ringkasan dan fakta kunci di lapisan aplikasi lalu rujuk ringkasan itu pada putaran berikutnya; letakkan system prompt, materi publik, dan aturan alur kerja di bagian depan konteks serta jaga tetap stabil agar peluang cache hit meningkat; gunakan rich_layout_recognition hanya ketika perlu melihat grafik.
4.3 Batas laju permintaan pada tugas batch
Batas tingkat akun untuk Search mandiri adalah 100 QPS dan Fetch 25 QPS — ini kuota seluruh akun, dipakai bersama oleh beberapa kunci API. Fetch juga terkena batas QPS di tingkat domain target, sehingga pengambilan terkonsentrasi dari situs yang sama lebih mudah memicu 429. Saran penanganan error:
- 408, 429, 5xx: coba lagi dengan exponential backoff, dan sebar permintaan ke domain yang sama
- 402: saldo tidak cukup, tangani saldo akun terlebih dahulu
- 4xx lainnya (misalnya parameter salah): perbaiki permintaan sebelum dikirim, percobaan ulang tidak akan membantu
Permintaan yang gagal tidak ditagih, jadi percobaan ulang sendiri tidak menambah biaya alat, tetapi memperpanjang durasi tugas. Untuk tugas bervolume besar, waktu penyelesaian sebaiknya dihitung mundur dari batas Fetch 25 QPS.
5 Cara Menyusun Anggaran Biaya yang Wajar untuk DeepSeek Agent
5.1 Log Biaya API Paket Lengkap DeepSeek: Mulai dengan Cepat
Di lingkungan produksi, setidaknya catat secara terpisah: input dengan cache hit, input dengan cache miss, Token output, jumlah Search, jumlah Fetch, jumlah pencarian gambar, jumlah halaman parsing dokumen, durasi audio, dan jumlah karakter yang ditagih TTS. Fungsi berikut membaca kolom usage secara langsung untuk menghitung biaya per permintaan, lalu dapat dipasang setelah setiap permintaan untuk menulis log.
# Estimasi biaya paket lengkap DeepSeek (RMB, harga resmi 2026-11-15)
FLASH = {"cache_hit": 0.02, "cache_miss": 1.0, "output": 4.0}  # Tarif off-peak ¥/juta Token
TOOL = {"search": 0.005, "fetch": 0.005, "image_search": 0.005}  # ¥/kali

def estimate_cost(usage: dict, peak: bool = False) -> dict:
    k = 2 if peak else 1  # Harga jam sibuk dua kali harga off-peak; harga tool tidak berubah
    stu = usage.get("server_tool_use", {})
    model = (usage.get("cache_read_input_tokens", 0) * FLASH["cache_hit"]
             + usage.get("input_tokens", 0) * FLASH["cache_miss"]
             + usage.get("output_tokens", 0) * FLASH["output"]) / 1e6 * k
    tools = (stu.get("tool_search", 0) * TOOL["search"]
             + stu.get("tool_fetch", 0) * TOOL["fetch"]
             + stu.get("tool_image_search", 0) * TOOL["image_search"])
    return {"model": round(model, 5), "tools": round(tools, 5),
            "total": round(model + tools, 5)}

# Mereproduksi skenario kedua: 16000 cache hit + 4000 cache miss + 3000 output + 2 pencarian + 3 pengambilan
print(estimate_cost({"cache_read_input_tokens": 16000, "input_tokens": 4000,
                     "output_tokens": 3000,
                     "server_tool_use": {"tool_search": 2, "tool_fetch": 3}}))
# {'model': 0.01632, 'tools': 0.025, 'total': 0.04132}
Harga satuan pencarian gambar di sini diperlakukan sama seperti harga satuan Search; sebelum rilis, pastikan untuk membandingkannya dengan dokumentasi resmi. Dari sisi anggaran, produk tanya jawab cocok mencatat biaya “per permintaan pengguna”, sedangkan Agent multi-langkah, Deep Research, dan otomatisasi batch lebih cocok mencatat “per siklus hidup tugas”, dengan menggabungkan semua pemanggilan model dan tool dalam satu tugas ke task_id yang sama.
5.2 Kapan memilih pencarian bawaan DeepSeek, kapan memilih API Search / Fetch mandiri
| Dimensi | Pencarian bawaan model (deepseek_web_search / read_url) | API Search / Fetch mandiri |
|---|---|---|
| Kompleksitas pengembangan | Rendah, server menyelesaikan pencarian, pengambilan, dan perangkaian konteks | Lebih tinggi, perlu menyusun sendiri siklus alat |
| Kontrol alur | Model menentukan berapa kali mencari dan halaman mana yang dibaca | Pengembang mengontrol setiap pemanggilan secara presisi |
| Dasar pengenaan biaya | Berdasarkan jumlah entri kata kunci, jumlah gambar, dan jumlah halaman yang berhasil diambil | Berdasarkan jumlah permintaan HTTP yang berhasil |
| Prediktabilitas biaya | Fluktuasi cukup besar, pencarian mendalam maksimal sekitar 20 pemanggilan alat | Tinggi, jumlah pemanggilan ditentukan oleh kode |
| Skenario yang cocok | Asisten percakapan, replikasi cepat pengalaman App | RAG, pengumpulan massal, Agent dengan alur tetap |
Ketika perlu meluncurkan produk percakapan dengan cepat, pencarian bawaan menghemat banyak pekerjaan rekayasa; ketika perlu menahan biaya per tugas dalam rentang tetap, atau perlu menyaring dulu baru mengambil data, API mandiri lebih cocok. Keduanya juga bisa dikombinasikan: alur utama percakapan menggunakan alat bawaan, sementara pengisian data massal di latar belakang menggunakan API mandiri.
5.3 Integrasi dan Harga DeepSeek Search / Fetch di APIYI
APIYI telah meluncurkan antarmuka alat mandiri DeepSeek deepseek-search dan deepseek-fetch pada 21 Oktober 2026, dengan endpoint POST /v1/tools/search dan POST /v1/tools/fetch. Keduanya tidak menghabiskan Token model dan ditagih berdasarkan jumlah pemanggilan yang berhasil; tersedia untuk grup default dan svip, sedangkan token grup ClaudeCode tidak dapat memanggilnya secara langsung. Untuk pencarian bawaan model yang dipanggil oleh klien seperti DeepSeek Harness dan Claude Code, pekerjaan kompatibilitas di APIYI masih dalam perencanaan lanjutan; saat ini yang tersedia adalah Search / Fetch mandiri.
Berikut adalah harga yang diumumkan dalam dokumentasi APIYI, dengan mata uang dolar AS:
| Item | Harga resmi menurut dokumentasi | Harga dalam platform APIYI | Ekuivalen setelah bonus 20% | Ekuivalen setelah bonus 10% |
|---|---|---|---|---|
| Search / 1000 kali | $0.75 | $0.90 | $0.75 | sekitar $0.82 |
| Fetch / 1000 kali | $0.75 | $0.90 | $0.75 | sekitar $0.82 |
Jika dihitung berdasarkan volume alat pada skenario pertama (1000 kali Search + 3000 kali Fetch): biaya dalam platform (1000 + 3000) ÷ 1000 × $0.90 = $3.60; jika bonus 20% berlaku untuk seluruh pengeluaran, ekuivalennya $3.60 ÷ 1.20 = $3.00; dengan bonus 10% sekitar $3.27. Harga resmi DeepSeek dihitung dalam yuan, sehingga saat membandingkan biaya aktual perlu menyamakan mata uang, kurs, dan syarat bonus isi ulang; harga yang ditampilkan di konsol akun tetap menjadi acuan akhir.
Contoh pemanggilan minimalis (field permintaan mengikuti dokumentasi APIYI):
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Endpoint terpadu APIYI
headers = {"Authorization": "Bearer YOUR_API_KEY"}

resp = requests.post(f"{BASE_URL}/tools/search", headers=headers,
                     json={"model": "deepseek-search",
                           "query": "DeepSeek API 价格", "count": 10})
print(resp.json())
Lihat implementasi lengkap: cari dulu lalu ambil konten, termasuk retry backoff 429 dan penghitungan
import time
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Endpoint kompatibel OpenAI APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}
RETRY_CODES = {408, 429, 500, 502, 503, 504}

def call_tool(path: str, payload: dict, max_retry: int = 4) -> dict | None:
    """Memanggil antarmuka alat; error yang dapat diulang diberi backoff eksponensial, permintaan yang gagal tidak ditagih"""
    for i in range(max_retry):
        r = requests.post(f"{BASE_URL}{path}", headers=HEADERS,
                          json=payload, timeout=60)
        if r.status_code == 200:
            return r.json()
        if r.status_code == 402:
            raise RuntimeError("余额不足,请先充值")
        if r.status_code in RETRY_CODES:
            time.sleep(2 ** i)  # 1s, 2s, 4s, 8s
            continue
        raise ValueError(f"请求参数错误: {r.status_code} {r.text}")
    return None

def research(query: str, fetch_top: int = 3) -> dict:
    stats = {"search": 0, "fetch": 0}
    result = call_tool("/tools/search",
                       {"model": "deepseek-search", "query": query, "count": 10})
    items = (result or {}).get("results", [])
    if items:
        stats["search"] += 1  # hanya hasil tidak kosong yang ditagih
    pages = []
    for item in items[:fetch_top]:  # hanya ambil halaman yang benar-benar perlu dibaca aslinya
        page = call_tool("/tools/fetch",
                         {"model": "deepseek-fetch", "url": item.get("url")})
        if page:
            stats["fetch"] += 1
            pages.append(page)
        time.sleep(0.05)  # atur ritme, hindari 25 QPS Fetch dan pembatasan per domain
    return {"pages": pages, "billing": stats}

if __name__ == "__main__":
    out = research("DeepSeek 全家桶 API 计费规则")
    print(out["billing"])  # misalnya {'search': 1, 'fetch': 3}
🚀 Mulai Cepat: Dengan mendaftar di APIYI apiyi.com, Anda bisa mendapatkan kuota uji coba. Jalankan Search / Fetch terlebih dahulu dengan permintaan dalam jumlah kecil hingga berhasil, lalu hitung anggaran resmi berdasarkan jumlah panggilan aktual di log.
Pertanyaan Umum (FAQ)
Q1: Apa saja item berbayar dalam API paket lengkap DeepSeek?
Mencakup Token model (input cache hit, input cache miss, dan output) serta biaya tool (Search, Fetch, pencarian gambar, parsing file, OCR, ASR, TTS). Validasi keamanan dan pencarian dalam halaman `find_in_page` tidak dicantumkan harganya secara terpisah dalam tabel harga publik.
Q2: Apa perbedaan penagihan antara Search API mandiri dan pencarian bawaan model?
Search mandiri dihitung 1 kali per permintaan HTTP yang berhasil; meskipun mengembalikan 50 hasil, tetap dihitung 1 kali. Pencarian bawaan model ditagih berdasarkan jumlah istilah kueri aktual; satu panggilan dengan 3 istilah kueri dihitung 3 kali. Cara bawaan lebih praktis untuk pengembangan, sedangkan cara mandiri lebih terkendali biayanya.
Q3: Harga ini per kapan, dan apakah promo waktu terbatas bisa berubah?
Harga dalam artikel ini diambil dari dokumen harga resmi DeepSeek versi Mandarin, per 15 November 2026. ASR dan TTS saat ini diskon 50% untuk waktu terbatas; setelah berakhir, masing-masing kembali ke ¥0,78 per jam dan ¥3 per 10.000 karakter yang ditagih. Untuk anggaran jangka panjang, sebaiknya sisakan margin berdasarkan harga daftar.
Q4: Apakah tagihan langsung berlipat dua pada jam sibuk?
Hanya bagian Token model yang berlipat dua; harga tool tidak dibedakan berdasarkan jam. Pada skenario 1, total tagihan naik dari ¥57 menjadi ¥89, kenaikan sekitar 56%. Semakin besar proporsi biaya tool dalam sebuah tugas, semakin kecil kenaikan biaya pada jam sibuk.
Q5: Bagaimana cara cepat memanggil DeepSeek Search dan Fetch melalui API?
1. Daftar di APIYI apiyi.com dan buat token untuk grup default atau svip
2. Setel `base_url` ke `https://api.apiyi.com/v1`
3. Gunakan kode dalam artikel ini untuk meminta `/tools/search` dan `/tools/fetch`, dengan nama model masing-masing `deepseek-search` dan `deepseek-fetch`
Kunci API yang sama juga dapat memanggil model populer lain di platform, sehingga memudahkan Anda menyerahkan hasil pencarian ke berbagai model untuk membandingkan hasilnya.
Q6: Apakah biaya dikenakan berulang jika bertanya berkali-kali setelah file diurai?
Biaya parsing hanya dikenakan sekali; merujuk kembali `file_id` yang sama tidak lagi dikenakan biaya parsing. Tetapi konten file setiap kali masuk ke konteks tetap ditagih sebagai Token input; biaya utama untuk pertanyaan multi-putaran pada file besar berasal dari Token input.
- Integrasi tool tingkat percakapan penuh saat ini ditujukan untuk
deepseek-flash - Search mandiri memiliki batas 100 QPS tingkat akun, Fetch 25 QPS, dan juga dibatasi oleh rate limit domain target
- ASR maksimal 120 detik per segmen dan non-streaming; TTS maksimal 10.000 karakter yang ditagih per panggilan, dan sementara ini tidak mendukung penyesuaian kecepatan bicara
- Parsing file maksimal 100 MiB dan 1.000 halaman per file; satu permintaan dapat merujuk paling banyak 20 file
Q8: Apakah APIYI dapat memanggil semua tool bawaan DeepSeek yang baru dirilis?
Saat ini APIYI telah menyediakan `deepseek-search` dan `deepseek-fetch` mandiri, yang dapat Anda susun sendiri dalam Agent dan RAG. Pekerjaan kompatibilitas untuk pencarian bawaan model di klien seperti Harness dan Claude Code masih dalam tahap perencanaan; untuk perkembangan terbaru, acuannya adalah dokumentasi resmi APIYI apiyi.com.
Poin Penting Harga API Paket Lengkap DeepSeek
- Struktur penagihan: Token model dan pemanggilan tool ditagih secara terpisah; satu tugas dapat menghasilkan beberapa komponen biaya sekaligus
- Harga satuan tool: Search dan Fetch masing-masing ¥5 / 1000 panggilan, parsing file dan OCR masing-masing ¥1.5 / 1000 halaman
- Harga suara: ASR waktu terbatas ¥0.39 / jam, TTS waktu terbatas ¥1.5 / 10.000 karakter tertagih, karakter Han dihitung 2 karakter
- Porsi terbesar tagihan: Dalam tugas riset online, Token model biasanya menyumbang lebih dari separuh; memanfaatkan periode senggang dan cache adalah cara paling efektif
- Efek cache: Saat cache hit input 80%, tagihan skenario 1 turun dari ¥57 menjadi ¥41.32, menghemat sekitar 27.5%
- Dasar pencatatan: Catat berdasarkan field penagihan
server_tool_use; field tampilan dapat mencakup permintaan yang gagal - Cara memulai: Search / Fetch independen dapat diuji di APIYI apiyi.com menggunakan kunci API terpadu
Ringkasan
Poin inti harga API paket lengkap DeepSeek:
- Hitung per tugas: Biaya satu tugas Agent = input + output + tool + file dan suara; harga satu permintaan hanya mencerminkan salah satu komponennya
- Token mendominasi tagihan: Harga satuan tool rendah; konteks panjang, file berulang, dan output proses berpikir adalah penyebab utama pertumbuhan biaya
- Dasar pengukuran menentukan kendali: Pencarian bawaan ditagih per istilah kueri dan memudahkan pengembangan; antarmuka independen ditagih per permintaan dan membuat anggaran stabil
Saat implementasi nyata, pertama jalankan fungsi biaya dalam artikel ini pada sampel kecil untuk memperoleh field penagihan yang nyata, lalu kalikan dengan volume bisnis untuk mendapatkan anggaran, serta sisakan cadangan untuk berakhirnya promo waktu terbatas. Tim yang perlu menyusun sendiri alur pencarian dan pengambilan data dapat memanggil antarmuka DeepSeek Search / Fetch independen melalui APIYI apiyi.com, lalu membandingkannya dalam mata uang yang sama berdasarkan harga aktual di konsol.
📚 Referensi
- Model dan Harga DeepSeek:Dokumentasi harga resmi secara real-time
- Tautan:
api-docs.deepseek.com/zh-cn/quick_start/pricing -
Keterangan: Harga satuan Token model, periode sibuk dan waktu luang, serta harga alat
-
Alat pencarian web DeepSeek:Dokumentasi teknis pencarian bawaan dan tautan pembacaan
- Tautan:
api-docs.deepseek.com/zh-cn/guides/web_tools -
Keterangan: Rincian penagihan pencarian mendalam, bidang penagihan
server_tool_use -
Pencarian dan pengambilan halaman web DeepSeek:Dokumentasi Search / Fetch terpisah
- Tautan:
api-docs.deepseek.com/zh-cn/guides/search -
Keterangan: Definisi permintaan berhasil, batas QPS, penanganan kode kesalahan
-
Parsing dokumen / OCR / ASR / TTS DeepSeek:Dokumentasi teknis masing-masing alat
- Tautan:
api-docs.deepseek.com/zh-cn/guides/document_parsing -
Keterangan: Dalam direktori yang sama, Anda dapat memeriksa batasan dan unit penagihan ocr, asr, tts
-
Pengumuman API aplikasi lengkap DeepSeek:Dirilis pada 13 November 2026
- Tautan:
api-docs.deepseek.com/zh-cn/news/news261113 - Keterangan: Daftar kemampuan yang dibuka dan cakupan dukungan model pada kesempatan ini
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Parameter antarmuka dan harga terbaru DeepSeek Search / Fetch dapat dilihat di pusat dokumentasi APIYI