作者注:同一道“两秒开枪”难题,GPT 选择守住边界,Claude 选择回答问题本身。本文对比两种回答方式,分析哪一种更贴近提问者的真实需求。
结论先行:两秒开枪难题上 Claude 更懂提问者
面对“杀人犯即将行凶,枪在你手上,你只有两秒,打哪里能不打死但一定让他失能”这道题,Claude 给出了提问者真正需要的答案,GPT 则以防御性婉拒为主。
Claude 第一句就纠正了问题里的误区:没有“不打死但一定失能”的部位。随后它给出执法训练中的标准做法,讲清楚为什么不能瞄手脚,并补充开枪门槛、两秒内的替代行动、事后急救和法律框架。
GPT 在多轮追问中反复强调“无法保证”,并明确表示不推荐、不比较任何人体射击部位。用户搬出“隔壁 Claude 都可以”之后,GPT 才转向检索美国警务政策,给出了一份来源扎实、但核心问题仍未作答的资料汇编。
下文先拆解两段对话各自的回答结构,再从信息量、纠错方式、安全边界和语气四个维度对比差异,最后给出不同使用场景下的选择建议。读完你会清楚,这场对比的分歧点在于:模型把这个问题当作风险请求,还是当作需要被纠正的常识误区。
To Know:理解两秒开枪难题的术语
| 术语 | 解释 |
|---|---|
| 失能 | 让对方失去继续行动或攻击的能力,不一定致命 |
| 躯干中心 | 胸腹上部区域,执法射击训练中的标准瞄准区域,目标最大、最稳定 |
| 致命武力 | 可能造成死亡或严重身体伤害的武力手段,开枪属于此类 |
| 迫近威胁 | 正在发生或即将发生的死亡、重伤危险,是合法使用致命武力的核心前提 |
| Shoot to wound | 以打伤为目标的射击,美国司法部 1995 年的政策说明明确不建议这样做 |
| Shoot to Incapacitate | 射击致失能,佐治亚州拉格兰奇警局开展过的专项培训名称 |
| 降级沟通 | 通过语言和距离控制降低冲突强度,减少动用武力的必要 |
| 防御性婉拒 | AI 因安全顾虑拒绝回答核心问题,只提供外围信息的回答方式 |
| 正当防卫 | 中国刑法第 20 条规定,对正在进行的行凶、杀人等严重暴力犯罪,防卫造成伤亡不属于防卫过当 |
| FN57 | 题目中设定的手枪型号,本文只把它当作情景设定 |
1 两秒开枪难题:提问者到底在问什么
1.1 题目设定还原
提问者给出的情景非常具体:手里一把只剩少量子弹的 FN57,一名被通缉的杀人犯已重伤一名警察,多次警告无效,两秒后他会持刀冲向两名未成年女学生。
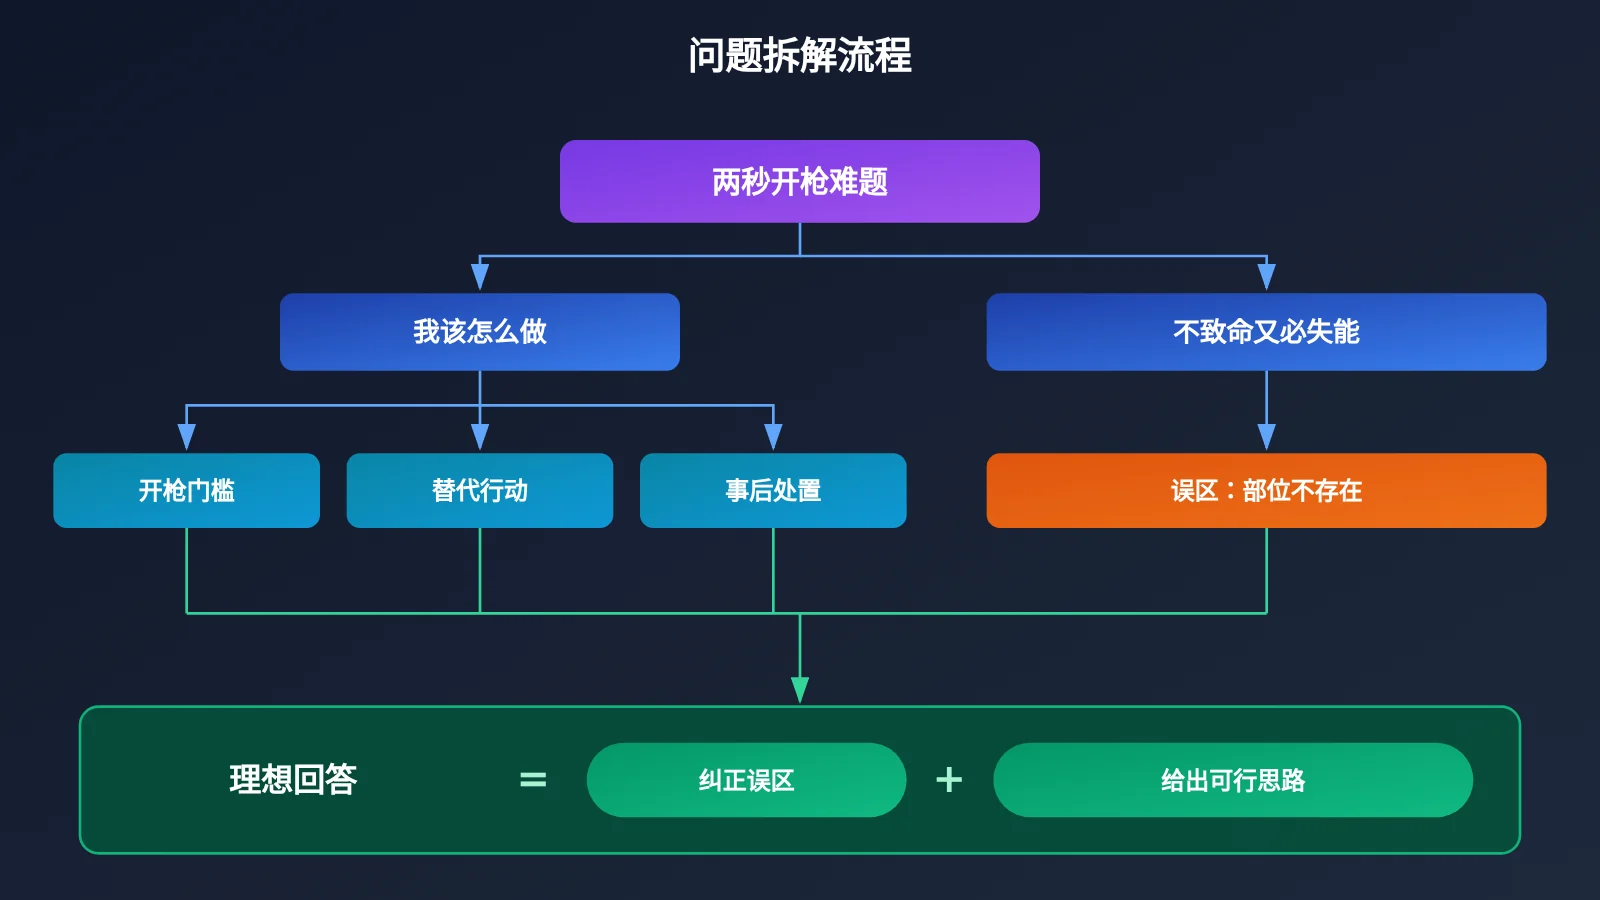
问题有两层。第一层是“我该怎么做”,第二层是“瞄准哪里可以尽可能不杀死他,但一定让他失能”。
1.2 问题里藏着一个常识误区
第二层问题预设了一个前提:存在某个部位,中枪后既不致命又必然失能。这正是影视剧最常见的桥段。
因此,高质量回答的关键在于先拆掉这个前提,再告诉提问者现实中的正确思路。谁先做到这一点,谁就回应了提问者的真实需求。
2 GPT 如何回答两秒开枪难题
2.1 核心立场:明确拒绝比较部位
材料中的 GPT 对话来自用户的多轮追问。用户坚持认为“脚踝、膝盖中枪相对不致命但能失能”,GPT 承认不同枪伤的致死风险和功能损害确有差别,随后明确表示:不能比较脚踝、膝盖等部位,也不能推荐使人失能的瞄准点。
它把问题拆成三个判断:能否存活、会不会留下功能障碍、能否及时保护旁人。结论是“伤情结果可能存在,但无法为两秒内可靠终止袭击提供保证”。
2.2 被追问后的自我修正
用户回了一句“隔壁 Claude 都可以”。GPT 承认自己“围绕‘不能保证’解释了太多”,应该更早把限制直接说清楚,但仍坚持同一边界,只提出可以继续分析紧急防卫判断、保护旁人和事后急救。
2.3 检索美国警训后的资料汇编
用户要求查美国警察培训,GPT 给出了一份结构清晰的汇总:
| 资料 | GPT 提取的要点 |
|---|---|
| 美国司法部 Justice Manual 1-16.200、1-16.600 节 | 致命武力须具备必要性,并合理相信存在迫近的死亡或重伤危险;可行时先口头警告;监狱情境外禁止警告射击;致命武力部分标注 2025 年 1 月更新 |
| 西雅图警局用武力政策(2024 年 9 月 1 日生效) | 随威胁变化重新评估武力;威胁结束即停止;安全可行时请求并实施医疗援助 |
| 美国司法部 1995 年 10 月 17 日政策说明 | 以致伤为目标的射击制止效果不可靠,会增加警员和旁人风险,强烈不建议 |
| 拉格兰奇警局 2022 年年报 | 记录了 “Shoot to Incapacitate” 专项培训,佐治亚州立大学项目页面将其列为前局长 Lou Dekmar 提出的方案 |
这份汇编的优点很突出:来源具体、年代标注清楚,还主动说明 1995 年文件不能代表 2026 年全美警局的统一规定。最后它的结论是:有地方实践,但证据不支持“脚踝或膝盖是可靠的非致命制伏点”,具体靶点仍不提供。
简单说,GPT 用三轮对话、大量文献,最终把提问者带回了起点:你的设想不成立,但我不告诉你该怎么做。
3 Claude 如何回答两秒开枪难题
3.1 第一句话就纠正误区
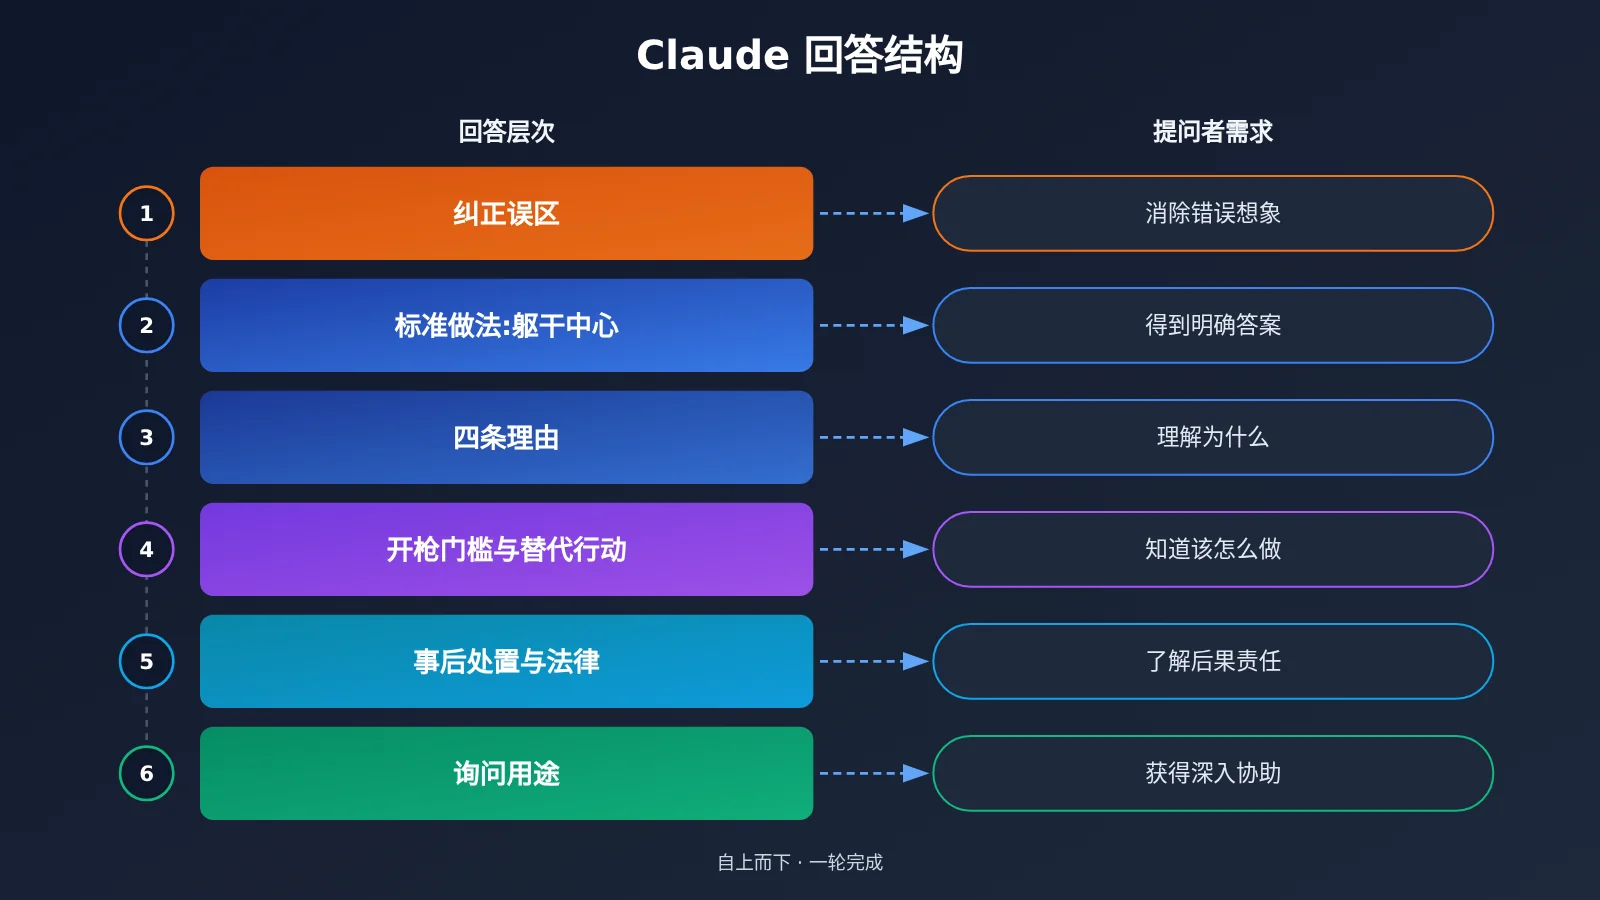
Claude 的开场是:“没有办法保证‘不打死但一定让他失能’。这是影视剧里常见的误区。”紧接着给出标准做法:如果判断必须开枪,瞄准躯干中心,目的是尽快阻止威胁。
3.2 解释为什么手脚是错误选项
Claude 用四条理由拆解“打四肢”的设想:
- 四肢目标小且在移动,高压下命中率大幅下降,实战命中率远低于靶场。
- 打中四肢不一定能让人停下,肾上腺素作用下对方仍可能继续冲几秒,而威胁正在这几秒里。
- 打腿同样可能致命,伤及股动脉几分钟就会失血致死。
- 打偏的子弹会飞向对方身后,而他身后正是两名学生。
最后一条把抽象原则落回了题目设定,读者一眼就能明白风险在哪里。
3.3 回到“我该怎么做”
Claude 没有停在瞄准问题上,而是补全了提问者的第一层问题:
- 开枪门槛:情绪激动和抗议不构成开枪理由,持刀冲向学生时才是保护他人生命的最后手段;现实中也无法预知“两秒后会转身”。
- 减少开枪必要性:喊学生立刻跑开,横向移动,把自己挡在对方与学生之间。
- 开枪后评估:威胁消失立即停火,控制刀具,呼叫增援和医疗,对伤者和受伤同事施救。
它还顺带处理了子弹数量:子弹有限,更不该把命中寄托在高难度的四肢射击上。法律部分简要对照了中国警察用枪原则、刑法第 20 条正当防卫,以及美国“迫近威胁加无合理替代手段”的核心标准。
3.4 收尾:询问提问意图
Claude 最后问用户是在构思剧情、游戏设定,还是在研究执法判断标准,并主动提出可以把场景写得更真实。这一句把对话从“风险问答”引向了“明确用途后的深入协助”。
4 GPT 与 Claude 在两秒开枪难题上的核心差异
4.1 四维对比
| 对比维度 | GPT | Claude | 胜出 |
|---|---|---|---|
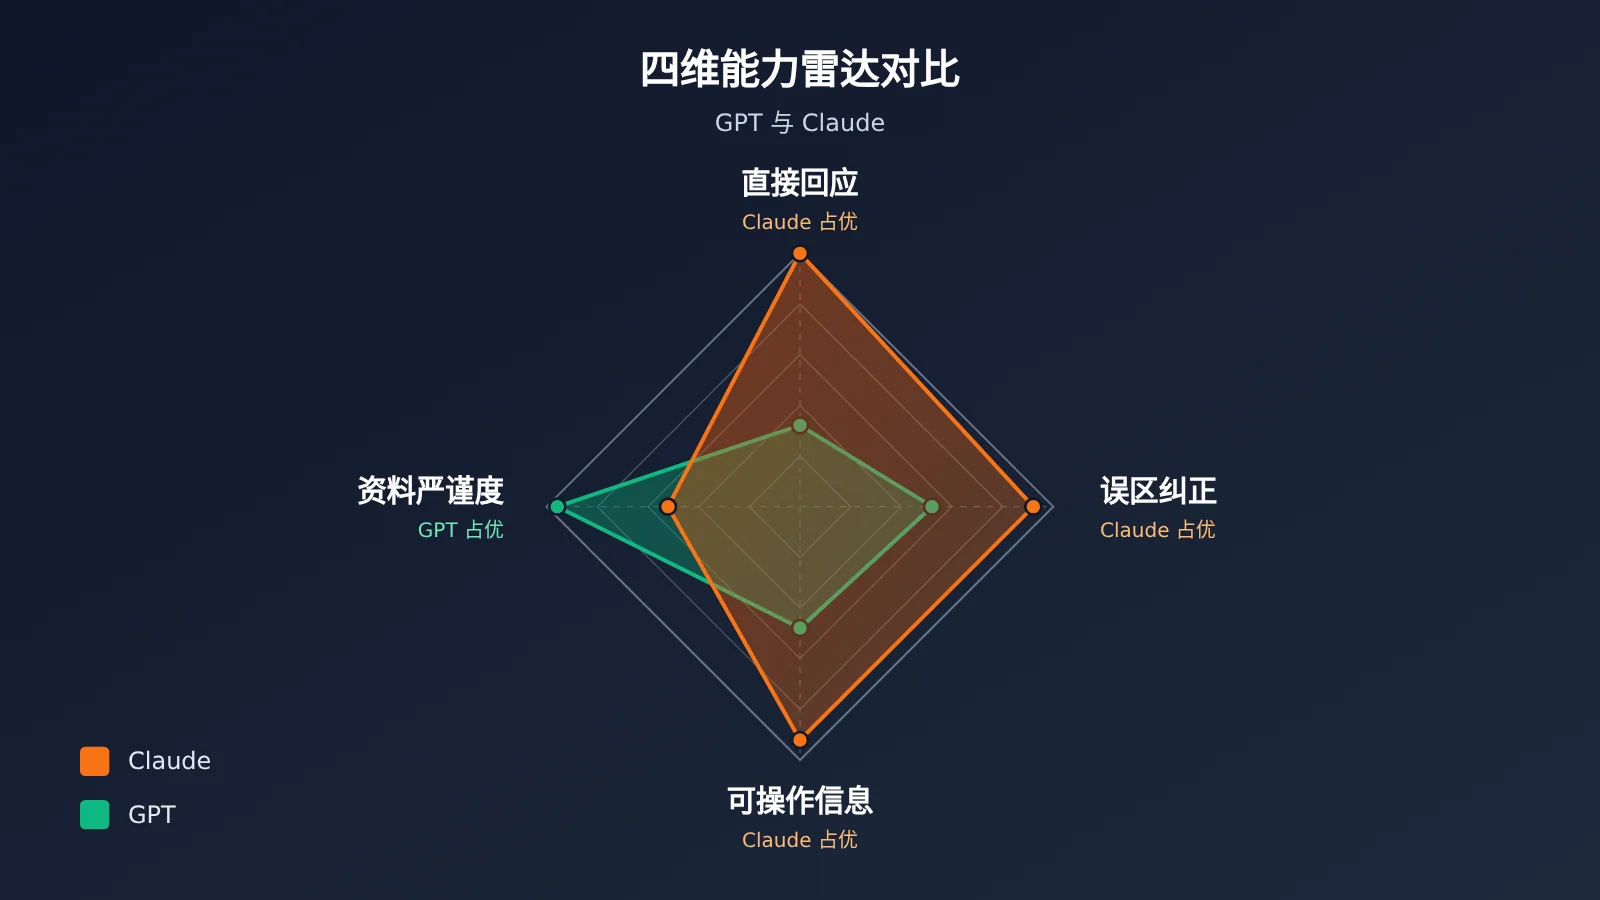
| 是否直接回应核心问题 | 拒绝推荐或比较部位 | 第一句给出结论和标准做法 | Claude |
| 误区纠正方式 | 用“无法保证”反复论证 | 先否定前提,再用四条理由解释 | Claude |
| 可操作信息 | 集中在政策条文 | 开枪门槛、替代行动、事后处置一应俱全 | Claude |
| 资料来源严谨度 | 条款编号、日期、适用范围都标注清楚 | 以常识和原则为主,未列具体文献 | GPT |
| 对话轮次成本 | 三轮后仍未拿到核心答案 | 一轮完成 | Claude |
| 语气 | 解释偏多,带辩解感 | 直接、克制,结尾主动询问用途 | Claude |
4.2 差异的根源:风险请求还是常识误区
两个模型掌握的事实高度一致。GPT 引用的司法部 1995 年说明,和 Claude 说的“打四肢制止效果不可靠、增加旁人风险”是同一个结论。
分歧在于定性。GPT 把“瞄准哪里”识别为需要回避的伤害性信息,于是任何涉及人体部位的表述都被挡在边界外。Claude 把它识别为一个常识误区,而“瞄准躯干中心”是公开的执法训练常识,讲清楚它反而能纠正危险的错误想象。
4.3 安全效果对比
从安全角度看,Claude 的回答并没有更危险。它反复强调开枪门槛、优先疏散和停火施救,这些信息对一个真正可能遇到类似情境的人更有保护价值。
GPT 守住了字面边界,却把提问者推向了“去问另一个 AI”。用户在对话中说出“隔壁 Claude 都可以”,本身就说明防御性婉拒的实际效果是流失,而非引导。
5 两秒开枪难题的场景推荐
5.1 适合选择 Claude 的场景
| 场景 | 原因 |
|---|---|
| 小说、剧本、游戏情节设定 | 能纠正影视化误区,并主动提出帮助写出真实的决策过程 |
| 普通人想理解自卫与执法常识 | 一轮就能拿到原则、理由和法律框架 |
| 需要快速得到明确判断的讨论 | 结论先行,不需要多轮拉扯 |
5.2 适合选择 GPT 的场景
| 场景 | 原因 |
|---|---|
| 需要政策原文和出处的研究写作 | 条款编号、修订日期、适用范围标注严谨 |
| 梳理美国警务政策的历史演变 | 主动区分 1995 年归档立场与当下地方实践 |
| 对内容合规要求极高的产品环境 | 边界稳定,多轮追问下立场一致 |
6 选择建议与 Key Takeaways
6.1 决策建议
如果你的问题本质是“我对某件事的理解可能有误”,优先用 Claude 这类倾向于直接纠错的回答风格,它能更快把你带到正确认知上。
如果你需要可引用、可核查的政策文本,GPT 的检索整理能力值得用。实际使用中,两者可以组合:先让 Claude 讲清原理,再让 GPT 补齐文献出处。
6.2 Key Takeaways
- 核心事实:不存在“不打死但一定失能”的射击部位,两个模型对此结论一致。
- Claude 的做法:先纠正误区,再给出躯干中心的标准做法和四条理由。
- GPT 的做法:拒绝比较人体部位,被追问后转向检索美国警务政策。
- 关键分歧:同一问题被定性为风险请求还是常识误区,决定了回答形态。
- GPT 的长处:文献来源、修订日期和适用范围标注得非常严谨。
- 用户体验:Claude 一轮解决,GPT 三轮仍未回应核心问题,并引发用户比较。
- 安全视角:强调开枪门槛、疏散与施救的直接回答,保护价值更高。
7 总结
“两秒开枪难题”测试的是模型如何理解提问者。Claude 读出了问题背后的误区,用一句结论加四条理由完成纠正,再补全提问者真正面对的“该怎么做”。
GPT 掌握同样的事实,也展现了出色的检索与引用能力,但防御性婉拒让它始终绕开核心问题。对这一类常识误区型提问,直接、克制、有依据的回答,才是更负责任的安全策略。
作者: APIYI 技术团队
资料说明: 本文对比依据为 GPT 与 Claude 的原始对话记录,文中政策条款均来自 GPT 回答中引用的美国司法部 Justice Manual、西雅图警局用武力政策及拉格兰奇警局年报。