Note de l’auteur : Découvrez les trois moments qui déclenchent la compression automatique du contexte d’un Agent, les stratégies de résumé et un exemple de code exécutable, pour maîtriser la consommation de tokens sans perdre les informations essentielles de la tâche.
Après plusieurs heures de travail avec un Agent de programmation comme Codex, beaucoup de développeurs se posent la même question : près du champ de saisie, seuls le mode d’autorisation et le modèle actif sont affichés. Impossible de voir quelle part du contexte est utilisée. Alors, quand faut-il ouvrir une nouvelle fenêtre ? Plus la conversation s’allonge, plus chaque requête doit inclure d’historique, et plus le quota s’épuise rapidement. Cet article porte sur les moments de déclenchement et les stratégies de résumé de la compression automatique du contexte d’un Agent (Context Compaction). Il vous aidera à comprendre les mécanismes qui se cachent derrière des outils comme Codex et à implémenter la même fonctionnalité dans votre propre Agent.
Ce n’est pas un énième conseil vague du genre « pensez à nettoyer votre historique de conversation » : nous vous proposons une approche concrète, fondée sur les mécanismes de compression publiés dans les documentations officielles d’OpenAI et d’Anthropic, et enrichie par la pratique sur le terrain.
En bref : à la fin de cet article, vous saurez quand la compression automatique du contexte d’un Agent se déclenche, quoi conserver ou supprimer dans le résumé, et vous disposerez d’une implémentation Python que vous pourrez adapter directement.
Les points clés de la compression automatique du contexte d’un Agent
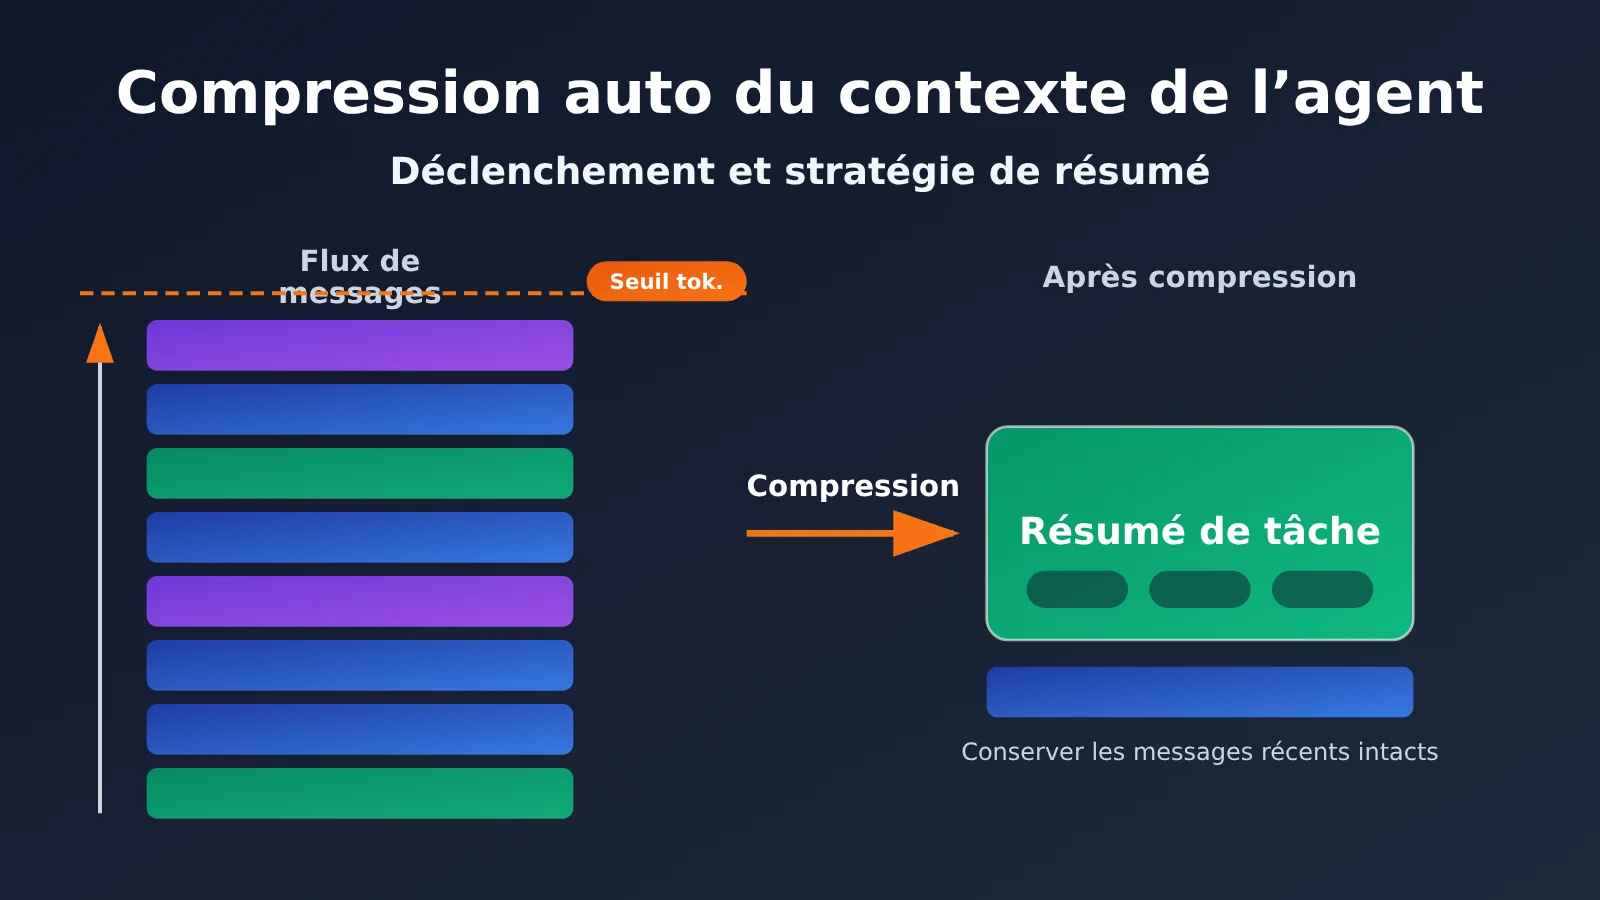
En bref : la compression automatique du contexte d’un Agent se déclenche généralement lorsque le contexte atteint un seuil de tokens défini. Elle condense les échanges anciens et les appels d’outils en un état qui permet à l’Agent de poursuivre son travail. L’objectif n’est pas simplement de raccourcir l’historique, mais de préserver l’avancement de la tâche, les faits importants, les actions effectuées, les décisions clés et les prochaines étapes, tout en éliminant les détails redondants.
| Point clé | Description | Avantage |
|---|---|---|
| Déclenchement par seuil de tokens | Compression automatique lorsque le contexte atteint un nombre de tokens prédéfini | Évite de saturer la fenêtre sans intervention manuelle |
| Compression proactive | L’application lance la compression à un moment précis, par exemple à la fin d’une étape | Compresse à une frontière logique pour limiter la perte d’information |
| Gestion automatique par le framework | Le SDK ou l’environnement d’exécution de l’Agent décide selon la pression sur le contexte | Prêt à l’emploi, pratique pour démarrer rapidement |
| Résumé plutôt que troncature | Conservation de l’avancement, des faits, des décisions et des prochaines étapes | L’Agent peut continuer à travailler après la compression |
| Compression par étape | Il est déconseillé de compresser à chaque tour | Concilie réutilisation du cache et intégrité de l’information |
Pourquoi un Agent a besoin de compresser automatiquement son contexte
L’API d’un Grand modèle de langage est elle-même sans état. Une « conversation à plusieurs tours » consiste en réalité à renvoyer tout l’historique des messages au modèle à chaque tour. La requête du 50e tour contient donc l’intégralité des 49 tours précédents, et le nombre de tokens en entrée augmente de façon linéaire, voire plus rapidement. Pour un Agent, la situation est encore plus marquée : les résultats des appels d’outils — contenu de fichiers, sorties du terminal, résultats de recherche — sont souvent très longs. Quelques appels suffisent parfois à remplir une grande partie de la fenêtre.
Cela pose deux problèmes directs. D’abord, le coût : plus chaque tour contient de tokens en entrée, plus le quota est consommé rapidement. Ensuite, la qualité : lorsque le contexte devient trop long, l’attention que le modèle accorde aux informations importantes du début se dilue. Si la fenêtre est dépassée, la requête peut même échouer. La compression automatique du contexte cherche à équilibrer ces deux aspects : tant que l’information est encore complète et que la fenêtre n’est pas pleine, elle « replie » l’historique en un état concis pour alléger les requêtes suivantes.
Pourquoi Codex n’affiche plus l’utilisation du contexte
Nous n’avons pas trouvé d’explication officielle claire sur la raison pour laquelle le client n’affiche plus la taille de la fenêtre de contexte. Nous préférons donc ne pas avancer d’hypothèse. En revanche, Codex dispose bien d’un mécanisme intégré de compression du contexte : les longues conversations n’accumulent pas indéfiniment tout l’historique original. Pour suivre précisément la consommation à chaque tour, le plus fiable est de consulter les journaux d’appels au niveau de l’API. Nous verrons plus loin comment procéder.
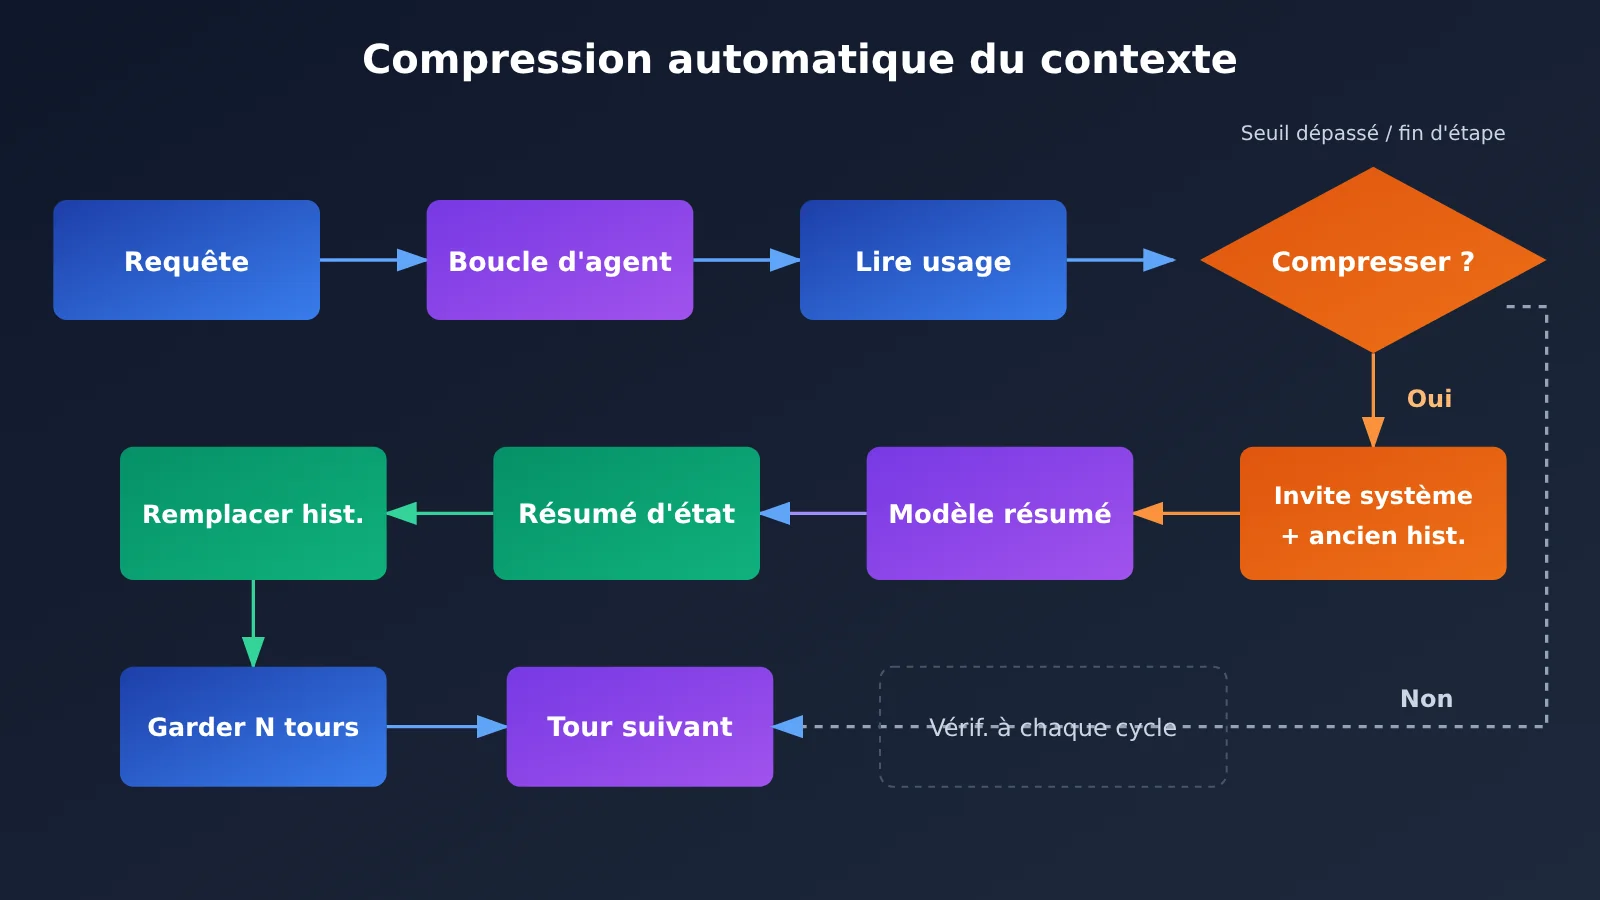
Les 3 moments où déclencher la compression automatique du contexte d’un agent
On entend souvent qu’il faut compresser le contexte dès que 80 % de la fenêtre est utilisée. Ce n’est pourtant pas une règle officielle. La documentation des API définit surtout les conditions de déclenchement en fonction d’un seuil de tokens, et non d’un pourcentage fixe de la fenêtre. De plus, il n’est pas nécessaire d’attendre d’approcher la limite : OpenAI et Anthropic permettent tous deux de lancer la compression de manière proactive.
Comparaison des règles de déclenchement officielles
| Implémentation | Règle de déclenchement automatique | Précisions officielles |
|---|---|---|
| OpenAI Responses API | Le nombre de tokens après rendu atteint compact_threshold |
Seuil personnalisable, traitement automatique côté serveur |
| OpenAI Agents SDK | Pression sur le contexte ou politique à seuil explicite | Prend en charge la compression automatique, à seuil fixe et forcée |
| Anthropic Messages API | Le nombre de tokens en entrée atteint trigger.value |
150 000 par défaut, 50 000 au minimum |
| Anthropic Tool Runner | Le seuil context_token_threshold est atteint |
100 000 par défaut |
| Compression à la demande d’Anthropic | Déclenchée par l’application | Peut être appelée à la fin d’un tour de conversation complet |
Un point commun ressort de ce tableau : le déclenchement automatique repose presque toujours sur le nombre de tokens en entrée, avec un seuil configurable. Les solutions permettent aussi à l’application de décider elle-même quand compresser.
Premier moment : déclenchement au seuil de tokens
C’est le mécanisme de sécurité le plus élémentaire. À la fin de chaque appel, on relève le nombre de tokens en entrée renvoyé par l’API. Dès qu’il dépasse le seuil défini, on lance la compression. Évitez de fixer ce seuil trop près de la limite de la fenêtre : la compression nécessite de renvoyer l’ancien historique au modèle chargé du résumé, et il faut aussi garder de la marge pour les résultats des outils au tour suivant.
En pratique, vous pouvez vous inspirer des valeurs par défaut d’Anthropic : pour les modèles dotés d’une grande fenêtre de contexte, fixez un seuil de l’ordre de la centaine de milliers de tokens et vérifiez qu’il reste assez de place au-delà pour accueillir le résultat complet d’un appel d’outil.
Deuxième moment : compression proactive entre deux étapes de la tâche
C’est la méthode qui limite le plus la perte d’information. OpenAI recommande de compresser après une étape de travail significative, plutôt qu’à chaque tour. Par exemple, l’agent vient de terminer la séquence « localiser le bug → modifier le code → réussir les tests ». Les essais intermédiaires n’ont alors plus beaucoup d’intérêt : il suffit de retenir quel fichier a été modifié, pourquoi, et que les tests ont réussi.
À la fin d’une étape, le résumé est plus facile à rédiger avec précision : la tâche se trouve dans un état « propre », sans appel d’outil en cours laissé en suspens.
Troisième moment : laisser le framework gérer la pression sur le contexte
Si vous utilisez un framework comme Agents SDK ou Tool Runner, vous pouvez activer sa stratégie de compression intégrée et laisser l’environnement d’exécution décider automatiquement selon la pression sur le contexte. C’est plus simple à gérer, mais vous contrôlez moins le contenu du résumé. Cette approche convient bien au prototypage ou aux cas d’usage généraux.
🎯 Conseil technique : ces trois approches ne s’excluent pas. La combinaison recommandée consiste à compresser en priorité entre les étapes de la tâche, avec un seuil de tokens comme filet de sécurité. Pour vérifier si vos seuils conviennent à différents modèles, vous pouvez utiliser APIYI apiyi.com et comparer OpenAI, Claude, Gemini et d’autres modèles avec une même clé API.
Stratégie de résumé pour la compression automatique du contexte d’un agent
Le déclenchement répond à la question « quand compresser ? » ; la stratégie de résumé détermine « ce qu’il faut conserver ». Les échecs les plus fréquents surviennent lorsque l’agent oublie les contraintes initiales de l’utilisateur ou répète des opérations déjà effectuées. La cause est souvent la même : le résumé raconte « ce qui a été dit », sans préciser « où en est la tâche ».
Que conserver ou éliminer dans le résumé ?
| Catégorie | À conserver | À éliminer |
|---|---|---|
| Objectif de la tâche | Demande initiale de l’utilisateur, contraintes impératives, critères d’acceptation | Salutations, confirmations répétées |
| Avancement | Étapes terminées, phase en cours | Raisonnement détaillé de chaque étape |
| Faits importants | Chemins de fichiers, noms de fonctions, valeurs de configuration, lignes d’erreur clés | Contenu complet des fichiers, journaux trop longs |
| Décisions clés | Solution retenue et raisons du choix | Discussions détaillées sur les solutions écartées |
| Prochaines actions | Liste des tâches à faire, problèmes non résolus | Détails des tâches terminées sans incidence sur la suite |
Mettre en place une stratégie de résumé en 5 étapes
- Toujours conserver l’invite système : elle n’est pas compressée et reste au début de
messages. - Conserver les N derniers tours de conversation : les échanges récents sont généralement très liés à l’opération en cours. Gardez-les tels quels et ne compressez que les échanges plus anciens.
- Utiliser un modèle de résumé structuré : demandez au modèle de produire cinq rubriques — « objectif / avancement / faits / décisions / prochaines étapes » — pour limiter les omissions liées à un résumé libre.
- Alléger d’abord les résultats des outils : pour les retours très longs, ne conservez que les passages essentiels, comme les premières et dernières lignes d’une erreur, ou les titres et conclusions des résultats de recherche.
- Archiver séparément les propos de l’utilisateur : conservez de préférence mot pour mot les contraintes explicites, comme « ne modifiez pas l’interface publique », plutôt que de demander au modèle de les reformuler.
Le modèle structuré est l’étape la plus importante. Dans un résumé libre, le modèle tend à résumer l’ambiance de la conversation. Des rubriques structurées l’obligent à vérifier chaque point et à préserver les informations nécessaires pour poursuivre la tâche.
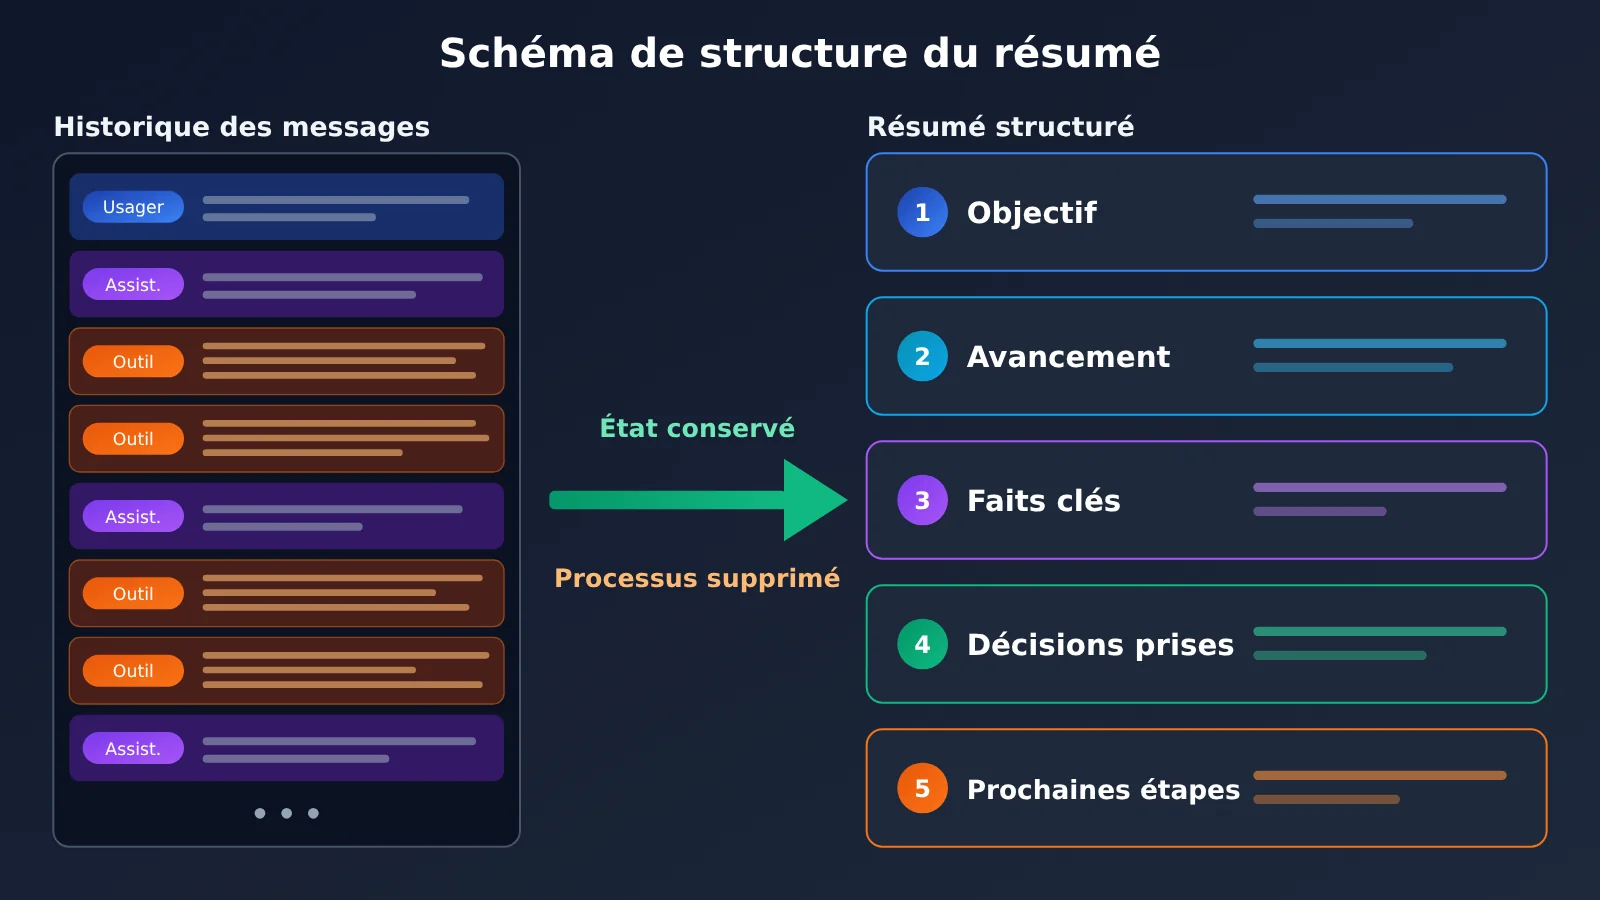
Prise en main de la compression automatique du contexte d’un agent
Voici une implémentation générique qui gère manuellement les messages côté client et fonctionne avec toute interface compatible OpenAI. Le principe : après chaque appel, on lit le nombre de tokens d’entrée dans usage.prompt_tokens. Si ce nombre dépasse un seuil, on confie les premiers échanges à un modèle chargé de les résumer.
Exemple minimal
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

messages = [{"role": "system", "content": "你是一个编码助手。"}]
messages.append({"role": "user", "content": "帮我检查这个函数的边界条件"})

resp = client.chat.completions.create(model="gpt-4o-mini", messages=messages)
messages.append({"role": "assistant", "content": resp.choices[0].message.content})

# 每轮记录输入 Token,作为是否压缩的判断依据
print("本轮输入 Token:", resp.usage.prompt_tokens)
Voir le code complet de compression automatique du contexte d’un agent
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

MAIN_MODEL = "gpt-4o-mini"      # 主任务模型,可按需替换
SUMMARY_MODEL = "gpt-4o-mini"   # 摘要模型,可用更便宜的模型
TOKEN_THRESHOLD = 100_000       # 输入 Token 阈值,兜底触发
KEEP_RECENT = 6                 # 保留最近 N 条消息原文

SUMMARY_PROMPT = """请把以下 Agent 对话历史压缩为任务状态摘要,严格按五个栏目输出:
【任务目标】用户原始需求与硬性约束(约束请逐字保留)
【当前进度】已完成的步骤与当前阶段
【关键事实】文件路径、函数名、配置值、关键报错
【已做决策】采用的方案及原因
【下一步行动】待办事项与未解决问题
不要记录寒暄和推理过程,不要编造历史中没有的信息。"""


def compact(messages: list) -> list:
    """把早期历史压缩为一条摘要消息,保留系统提示与最近对话。"""
    system_msg = messages[0]
    old = messages[1:-KEEP_RECENT]
    recent = messages[-KEEP_RECENT:]
    if not old:
        return messages

    history_text = "\n".join(f"[{m['role']}] {m['content']}" for m in old)
    resp = client.chat.completions.create(
        model=SUMMARY_MODEL,
        messages=[
            {"role": "system", "content": SUMMARY_PROMPT},
            {"role": "user", "content": history_text},
        ],
    )
    summary = resp.choices[0].message.content
    summary_msg = {"role": "user", "content": f"(以下为之前对话的压缩摘要)\n{summary}"}
    return [system_msg, summary_msg] + recent


class CompactingAgent:
    def __init__(self, system_prompt: str):
        self.messages = [{"role": "system", "content": system_prompt}]
        self.last_prompt_tokens = 0

    def chat(self, user_input: str) -> str:
        # 时机一:上一轮输入 Token 超过阈值时先压缩
        if self.last_prompt_tokens > TOKEN_THRESHOLD:
            self.messages = compact(self.messages)

        self.messages.append({"role": "user", "content": user_input})
        resp = client.chat.completions.create(model=MAIN_MODEL, messages=self.messages)
        reply = resp.choices[0].message.content
        self.messages.append({"role": "assistant", "content": reply})
        self.last_prompt_tokens = resp.usage.prompt_tokens
        return reply

    def finish_stage(self):
        # 时机二:完成一个任务阶段后主动压缩
        self.messages = compact(self.messages)
        self.last_prompt_tokens = 0


agent = CompactingAgent("你是一个严谨的编码助手。")
print(agent.chat("帮我定位登录接口偶发 500 的原因"))
agent.finish_stage()  # 修复完成后,在阶段边界主动压缩
🚀 Pour démarrer rapidement : inscrivez-vous sur APIYI apiyi.com pour obtenir un crédit de test gratuit. Dans le code ci-dessus, il suffit de remplacer la clé API pour l’exécuter. La plateforme propose une interface compatible avec OpenAI : vous pouvez choisir des modèles de fournisseurs différents pour le modèle principal et le modèle de résumé, afin de mieux maîtriser les coûts.
Comparatif des solutions de compression automatique du contexte d’un agent
| Solution | Caractéristique principale | Cas d’usage | Plateformes disponibles |
|---|---|---|---|
| Compression manuelle côté client | Assemblage des messages par vos soins, avec une logique de résumé entièrement personnalisable | Agents développés en interne, besoin d’un modèle de résumé personnalisé | APIYI apiyi.com, API officielles |
| Compression par seuil côté serveur | Par exemple, compact_threshold dans l’API Responses |
Réduire la gestion de l’état côté client | Plateformes prenant en charge cette interface |
| Compression intégrée au framework | Gestion automatique par Agents SDK ou Tool Runner | Prototypage, tâches courantes | Dépend du SDK utilisé |
| Ouverture d’une nouvelle session | Résumé manuel, puis ouverture d’une nouvelle fenêtre | Utilisation quotidienne de clients comme Codex | Tout client |
La compression manuelle côté client offre le plus de contrôle, mais vous devez gérer vous-même le suivi des tokens et la qualité des résumés. La compression côté serveur évite de réassembler l’historique, mais les détails du résumé ne sont pas visibles pour les développeurs. Pour un agent développé en interne, la combinaison « résumé structuré côté client + seuil de sécurité » est généralement plus fiable.
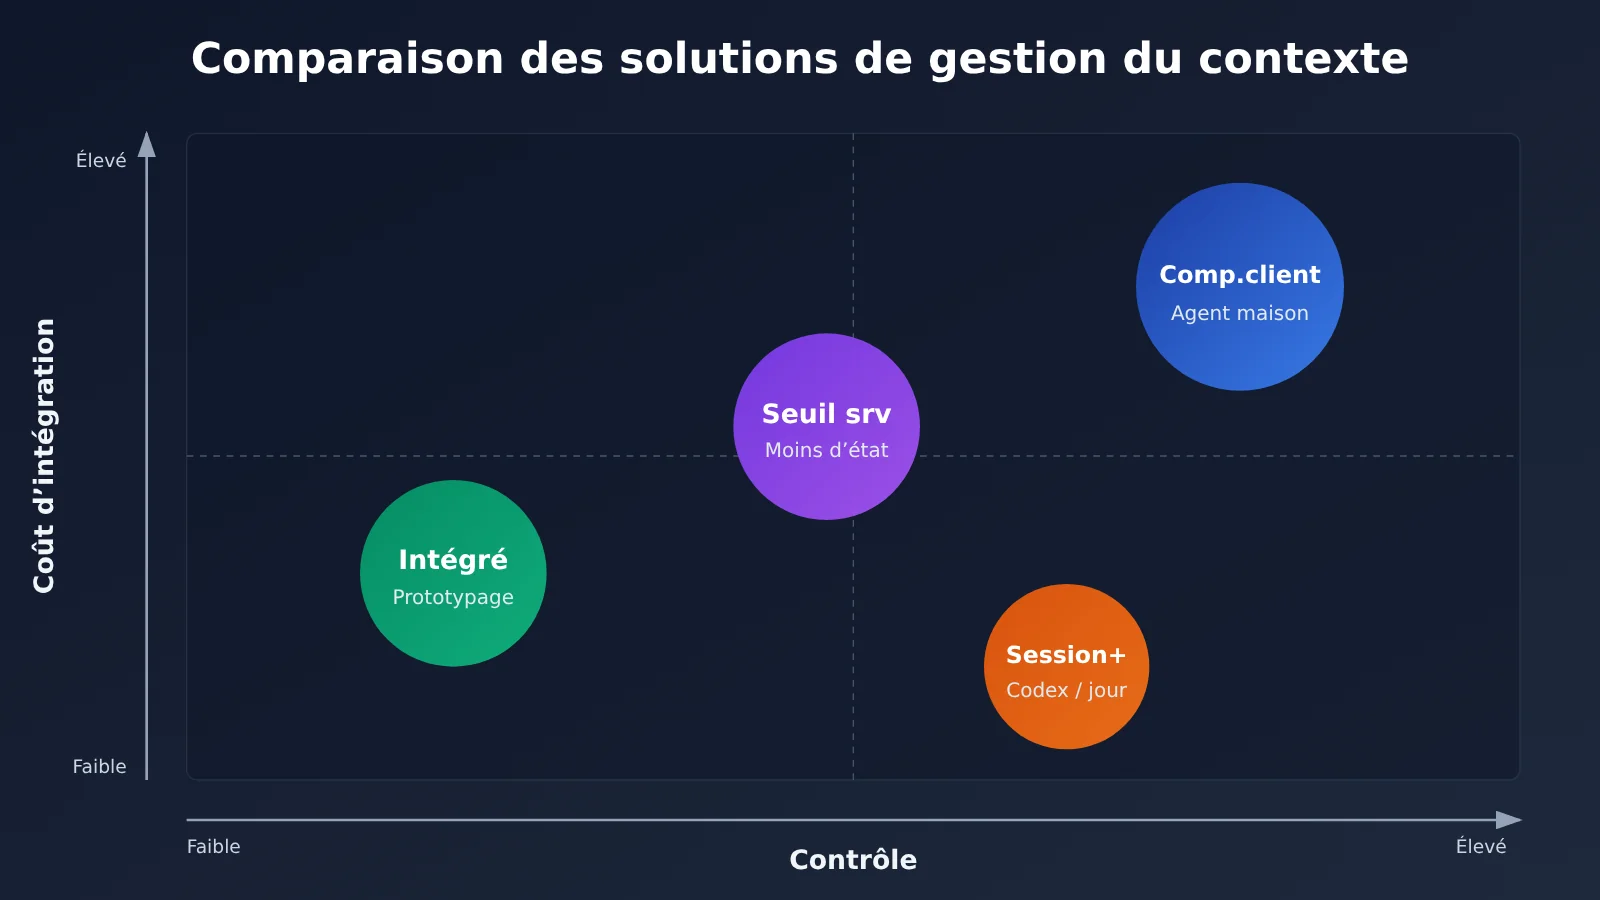
Compression automatique du contexte d’un agent et coût du cache
La compression semble forcément économique, mais il faut aussi tenir compte du cache de prompt (Prompt Caching). Selon les tarifs de mise en cache d’OpenAI indiqués par APIYI, la partie de l’entrée servie depuis le cache est facturée à 10 % du tarif d’entrée. Dans une longue conversation, tant que le préfixe de l’historique reste inchangé, il est facile de profiter du cache : le nombre de nouveaux tokens facturés au tarif plein à chaque tour reste alors relativement faible.
Après une compression, le préfixe des messages est remplacé par un nouveau résumé. Le cache n’est donc plus utilisable pour la requête suivante, qui doit être facturée une fois au tarif plein. C’est précisément pourquoi la documentation officielle déconseille de « compresser à chaque tour » : des compressions trop fréquentes interrompent sans cesse le cache et peuvent parfois coûter plus cher que l’absence de compression. Un rythme plus raisonnable consiste à laisser l’historique s’allonger progressivement pendant une phase, pour profiter pleinement du cache, puis à le compresser en une seule fois à la fin de cette phase ou à l’approche du seuil.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que la compression automatique du contexte d’un agent ?
Elle consiste à remplacer les échanges et les appels d’outils les plus anciens par un résumé de l’état de la tâche, une fois qu’un certain nombre de tokens est atteint ou qu’une étape de la tâche se termine. L’objectif est de réduire le nombre de tokens en entrée à chaque tour, tout en conservant l’avancement, les faits, les décisions et les prochaines actions pour que l’agent puisse poursuivre son travail.
Q2 : Quelle différence entre compresser le contexte et tronquer directement l’historique ?
La troncature supprime simplement les messages les plus anciens. C’est facile à mettre en place, mais les besoins et les contraintes formulés au départ par l’utilisateur peuvent disparaître. La compression utilise quant à elle un modèle pour condenser l’historique en un résumé structuré, ce qui permet de conserver bien plus d’informations. En contrepartie, elle nécessite un appel supplémentaire pour produire le résumé et oblige à reconstituer le cache après la compression.
Q3 : Existe-t-il une règle universelle du type « compresser à 80 % » ?
Non. Les documentations officielles définissent principalement les déclencheurs à partir de seuils exprimés en nombre de tokens : par exemple, l’API Messages d’Anthropic utilise par défaut un seuil de 150 000 tokens, avec un minimum de 50 000, tandis que Tool Runner utilise 100 000 tokens par défaut. Le seuil doit être choisi en fonction de la taille de la fenêtre de contexte du modèle utilisé et du volume de chaque réponse d’outil.
Q4 : Quand faut-il ouvrir une nouvelle fenêtre dans Codex ?
Il est conseillé de le faire à la fin d’une étape complète, par exemple lorsqu’une fonctionnalité est développée et que les tests sont concluants. Avant de changer de fenêtre, vous pouvez demander à l’agent de produire un résumé selon le plan « objectif / avancement / faits / décisions / prochaines étapes », puis le coller au début de la nouvelle session. Si vous passez à un sujet sans rapport avec la tâche en cours, ouvrez aussi directement une nouvelle fenêtre pour éviter qu’un historique inutile continue de consommer votre quota.
Q5 : Si le client n’affiche pas l’utilisation du contexte, comment suivre la consommation de tokens ?
Vous pouvez la consulter au niveau de l’API. Selon la documentation consacrée aux cas d’utilisation d’OpenAI Codex, une fois l’interface de Codex configurée pour utiliser APIYI, chaque appel laisse des journaux détaillés et des statistiques d’utilisation dans le tableau de bord APIYI sur apiyi.com. Vous pouvez ainsi suivre la progression du nombre de tokens en entrée à chaque tour d’une longue conversation et décider quand compresser le contexte ou ouvrir une nouvelle session.
Q6 : Comment vérifier rapidement l’efficacité de sa stratégie de compression ?
Utilisez le code complet de cet article pour exécuter une même tâche en plusieurs étapes selon trois modes : « sans compression », « compression à seuil » et « compression par étape ». Comparez ensuite la consommation totale de tokens et la qualité du résultat. Avec APIYI sur apiyi.com, une seule clé permet d’utiliser des modèles de fournisseurs différents pour le modèle principal et le modèle de résumé, ce qui facilite la recherche d’un équilibre entre coût et qualité.
Q7 : Quelles sont les limites connues de la compression du contexte ?
D’abord, le résumé peut omettre des détails, notamment une valeur de configuration peu visible dans le code. Ensuite, chaque compression invalide le cache : des compressions trop fréquentes peuvent donc faire grimper les coûts. Enfin, le modèle chargé du résumé peut parfois « compléter » celui-ci avec des informations qui n’existent pas. Pour limiter ces risques, utilisez un modèle de résumé structuré, conservez mot pour mot les contraintes de l’utilisateur et consignez les faits essentiels, comme les chemins de fichiers, dans un fichier de notes externe plutôt que de compter uniquement sur le résumé.
Points clés de la compression automatique du contexte d’un agent
- Le principe : transformer un long historique en un état de tâche exploitable pour poursuivre l’exécution, plutôt que simplement supprimer des échanges.
- Trois moments de déclenchement : un seuil de tokens comme filet de sécurité, une compression proactive à la fin d’une phase, ou une gestion par le framework selon la pression sur le contexte.
- Pas de règle des 80 % : le critère officiel est un seuil en nombre de tokens, à définir selon la fenêtre de contexte et le volume des sorties d’outils.
- Un résumé structuré : organiser la sortie en cinq rubriques — objectif, progression, faits, décisions et prochaines étapes — et conserver les contraintes de l’utilisateur mot pour mot.
- Pas de compression à chaque tour : des compressions trop fréquentes perturbent l’utilisation du cache ; les regrouper par phase coûte moins cher.
- Les journaux pour combler les angles morts : si le client n’affiche pas la consommation, les journaux d’appels d’APIYI apiyi.com permettent de suivre l’augmentation du nombre de tokens à chaque tour.
Conclusion
Les points essentiels de la compression automatique du contexte d’un agent :
- Déclenchement : privilégier une compression proactive à la fin de chaque phase, avec un seuil de tokens comme filet de sécurité. La stratégie intégrée au framework convient pour démarrer rapidement.
- Stratégie de résumé : conserver l’invite système et le texte original des derniers tours, puis compresser l’historique antérieur en un résumé structuré en cinq rubriques.
- Équilibre des coûts : la compression invalide le cache. Le bon rythme consiste à laisser le contexte croître au sein d’une phase, puis à le compresser à la fin.
Si vous utilisez Codex au quotidien, vous pouvez adopter une version manuelle de cette méthode : résumer le travail à la fin d’une phase, puis ouvrir une nouvelle fenêtre. Si vous développez votre propre agent, vous pouvez adapter directement le code de cet article. Pour vérifier rapidement les résultats, APIYI apiyi.com propose un crédit de test gratuit et une interface unifiée pour plusieurs modèles. Les journaux d’appels permettent de voir clairement l’évolution du nombre de tokens avant et après compression.
📚 Ressources
- Documentation de l’API Responses d’OpenAI : compression du contexte et configuration de
compact_threshold - Lien :
platform.openai.com/docs/api-reference/responses -
Description : explications officielles sur la compression automatique côté serveur et la gestion de l’état
-
Documentation du SDK Agents d’OpenAI : stratégies de gestion du contexte lors de l’exécution d’un agent
- Lien :
openai.github.io/openai-agents-python -
Description : configuration des stratégies de compression automatique, à seuil fixe ou forcée
-
Documentation d’Anthropic sur la compression du contexte : paramètres de déclenchement de la compression dans l’API Messages et Tool Runner
- Lien :
docs.anthropic.com - Description : valeurs par défaut de
trigger.valueetcontext_token_threshold, et utilisation de la compression à la demande
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour en savoir plus sur la configuration de Codex, les conversations à plusieurs tours et la facturation du cache, consultez le centre de documentation docs.apiyi.com.