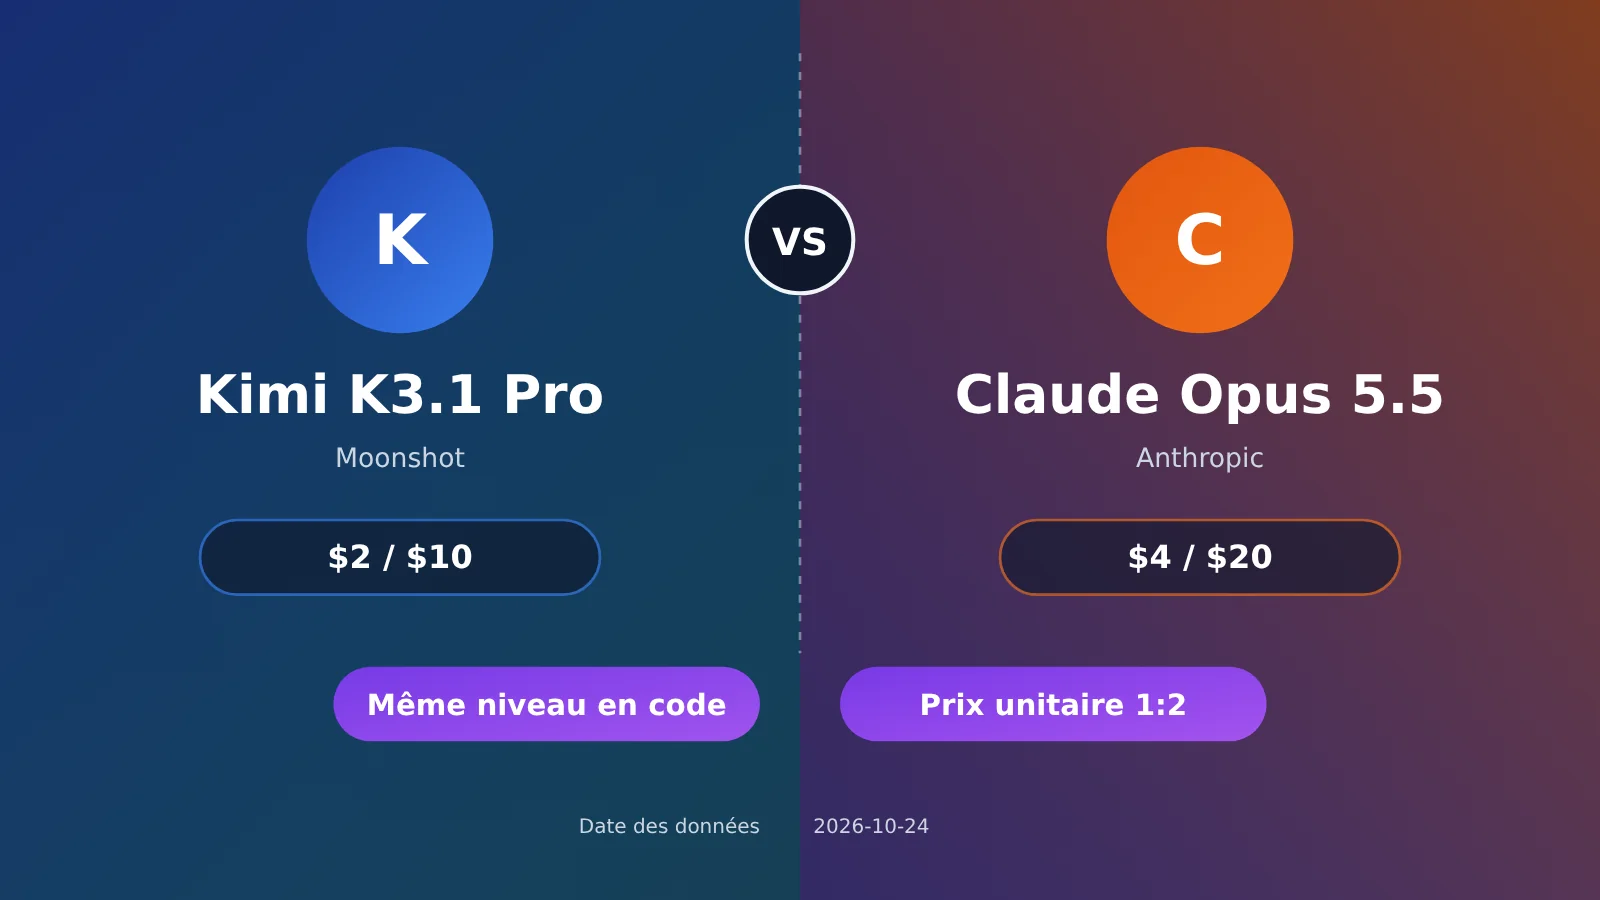
Pour commencer par la conclusion : Kimi K3.1 Pro et Claude Opus 5.5 sont au même niveau en programmation. Dans les résultats publiés par Moonshot pour Terminal-Bench 4.0, K3.1 Pro obtient 65,7 % et Opus 5.5, 66,4 % : le premier accuse un retard d’environ 0,7 point de pourcentage. Mais selon Artificial Analysis, qui évalue uniquement Terminal-Bench 4.0, K3.1 Pro arrive en tête. Côté prix, les tarifs d’entrée et de sortie de K3.1 Pro sont exactement deux fois moins élevés que ceux d’Opus 5.5 (2 $/10 $ contre 4 $/20 $), tandis que le tarif des tokens issus du cache est identique pour les deux modèles. Cependant, K3.1 Pro a tendance à produire des raisonnements plus longs. Selon les estimations d’un tiers, le coût réel par tâche n’est donc pas réduit de moitié.
Toutes les données ci-dessous sont accompagnées de leur source et réparties en trois catégories : données publiées par les éditeurs (blog de Moonshot et documentation officielle de Kimi et Anthropic), données de tiers (Artificial Analysis, abrégé en AA ci-dessous) et données non vérifiées (aucune donnée publique disponible à ce jour ; les indications ne sont donc qu’orientatives). Vous pouvez assimiler les tokens à des « unités de texte » utilisées pour la facturation des modèles : un caractère chinois correspond en moyenne à un peu plus d’un token. Tous les prix sont exprimés en dollars par million de tokens.
Cet article ne cherchera pas à déterminer qui écrase l’autre. Chaque modèle a ses points forts et ses limites. Nous nous contenterons de comparer les données selon leurs sources et de proposer des recommandations en fonction des différents usages.
L’essentiel : à la fin de cet article, vous saurez si votre tâche se prête mieux à Kimi K3.1 Pro ou à Claude Opus 5.5, et vous aurez une idée précise de l’écart réel entre leurs coûts.
1. Kimi K3.1 Pro vs Claude Opus 5.5 : aperçu des principales différences
Commençons par un tableau qui résume les différences essentielles. Les sections suivantes les détaillent une par une. La colonne « Source » indique l’origine de chaque chiffre pour vous permettre de le vérifier.
| Critère | Kimi K3.1 Pro | Claude Opus 5.5 | Source |
|---|---|---|---|
| Terminal-Bench 4.0 (chiffres officiels) | 65,7 % | 66,4 % | Chiffres communiqués par Moonshot |
| Terminal-Bench 4.0 (chiffres d’AA) | 67 %, le meilleur score parmi les modèles évalués par AA | Non indiqué dans les sources consultées | Source tierce (AA) |
| Prix des entrées / sorties | 2 $ / 10 $ | 4 $ / 20 $ | Tarifs officiels |
| Prix en cas de cache | 0,20 $ | 0,20 $ | Tarifs officiels |
| Taille du contexte | 1 048 576 tokens | Jusqu’à 1 M, selon le modèle | Documentation officielle |
| Possibilité de désactiver la réflexion | Non, il est seulement possible d’en régler l’intensité | À vérifier dans la documentation d’Anthropic | Documentation officielle / non vérifié |
| Poids ouverts | Leur publication est prévue au plus tard le 4 novembre 2026 | Non ouverts | Déclaration officielle |
Le « contexte » désigne la quantité totale de contenu qu’un modèle peut traiter en une seule fois. Les deux modèles offrent une fenêtre de contexte de l’ordre du million de tokens : un dépôt de code de taille moyenne peut donc y être intégré en entier. Ce critère ne sera probablement pas déterminant dans votre choix.
2. Comparaison des prix de Kimi K3.1 Pro et Claude Opus 5.5 : cinq tarifs unitaires côte à côte
Commençons par définir deux termes liés à la facturation. Lecture depuis le cache : lorsque vous envoyez plusieurs fois le même contenu au début d’une requête (par exemple, une invite système ou le résumé d’un dépôt de code), le fournisseur du modèle le conserve en cache. Les lectures suivantes sont alors facturées à un tarif bien inférieur. Écriture dans le cache : frais facturés la première fois que ce contenu est enregistré dans le cache. Le tarif varie selon que le contenu est conservé 5 minutes ou 1 heure.
| Modèle | Entrée | Sortie | Lecture depuis le cache | Écriture dans le cache — 5 min | Écriture dans le cache — 1 h |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 | $5.00 | $8.00 |
| Claude Sonnet 5.5 (référence) | $2.00 | $10.00 | $0.10 | $2.50 | $4.00 |
Prix relevés le 24 octobre 2026, en dollars américains par million de tokens, hors taxes. Sources : grilles tarifaires officielles de Kimi et d’Anthropic.
2.1 Écarts de prix : 2 fois plus cher en entrée et en sortie, même prix pour la lecture depuis le cache
Pour l’entrée et la sortie, Opus 5.5 coûte exactement deux fois plus cher que K3.1 Pro. Pour la lecture depuis le cache, les deux modèles sont au même tarif : $0.20. L’écriture dans le cache est moins chère chez Kimi : $2 contre $5 pour 5 minutes, et $4 contre $8 pour 1 heure.
Si l’on ajoute Claude Sonnet 5.5 comme référence, on constate que ses tarifs d’entrée et de sortie sont identiques à ceux de K3.1 Pro, tandis que son tarif de lecture depuis le cache est deux fois moins élevé ($0.10). Si vous cherchez simplement un modèle haut de gamme plus abordable, le comparatif direct de Kimi est donc plutôt Sonnet 5.5, et pas seulement Opus 5.5.
2.2 Les deux modèles proposent une version plus rapide
Les deux fournisseurs proposent une version plus rapide et plus chère. Veillez à comparer les bonnes versions lors de votre choix :
kimi-k3.1-pro-highspeed: $4 / $20, lecture depuis le cache à $0.20, écriture dans le cache à $4 pour 5 minutes et à $8 pour 1 heure (tarifs officiels)- Mode Fast de Claude Opus 5.5 : $8 / $40, disponible sur toute la fenêtre de contexte, y compris au-delà de 200 k tokens (tarifs officiels)
On constate que les tarifs d’entrée et de sortie de la version rapide de Kimi sont les mêmes que ceux de la version standard d’Opus 5.5, mais que l’écriture dans le cache pour 5 minutes reste moins chère.
3. Kimi K3.1 Pro vs Claude Opus 5.5 : scores en programmation selon deux méthodologies distinctes
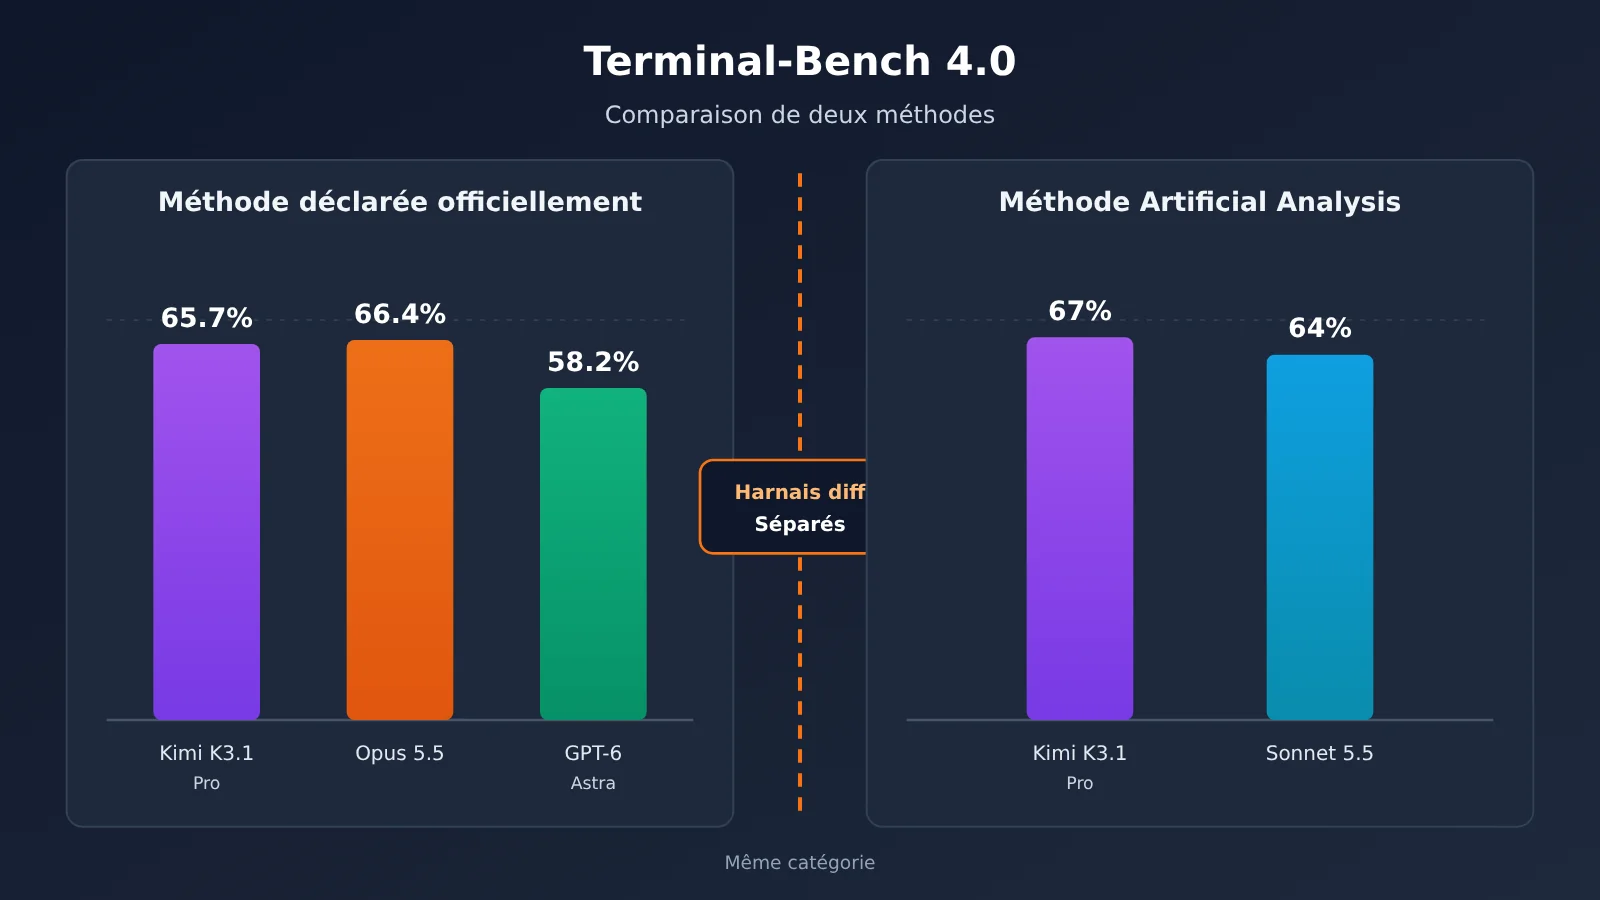
Terminal-Bench 4.0 évalue la capacité à effectuer des tâches concrètes dans un terminal : installer des dépendances, corriger des bugs ou exécuter des scripts. Seul un résultat final correct est considéré comme réussi. Les deux tableaux ci-dessous proviennent de deux organismes différents : leurs chiffres ne sont pas comparables.
3.1 Méthodologie publiée par Moonshot
| Test | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % |
| BenchCAD (reconstruction 3D à partir de code CAD généré depuis plusieurs vues) | 92,7 % (avec outils) | 96,2 % | — |
Les tests ont été réalisés avec reasoning_effort réglé sur max (niveau de raisonnement maximal). K3.1 Pro a été exécuté avec l’environnement d’exécution de Claude Code. Dans son blog, Moonshot indique que le modèle est « narrowly behind Claude Opus 5.5 », c’est-à-dire légèrement derrière Opus 5.5.
3.2 Résultats selon un organisme tiers (Artificial Analysis, 2026-10-23)
| Épreuve | Kimi K3.1 Pro | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Intelligence Index (indice d’intelligence global) | 55 (4ᵉ) | 58 | 56 |
| Terminal-Bench 4.0 | 67 % (meilleur résultat) | Non indiqué dans les sources | 64 % |
| GDPval-AA (Elo) | 1846 (3ᵉ) | 1866 | — |
| AA-Omniscience (fiabilité des connaissances) | Indice de 30, taux d’hallucination de 44 % | Non indiqué dans les sources | — |
Pour Opus 5.5, l’indice global a été mesuré avec les paramètres « max with fallback ». Muse Wonder Full obtient également 56 points dans le même classement. L’Elo est un système de notation comparable à celui utilisé aux échecs : les scores sont calculés à partir des résultats de confrontations deux à deux. Plus le score est élevé, mieux c’est. Le taux d’hallucination correspond, en gros, à la proportion de réponses inventées par le modèle lorsqu’il ne sait pas répondre. Les 44 % de K3.1 Pro sont donc à surveiller.
3.3 Pourquoi il ne faut pas mélanger les deux méthodes de mesure
Les scores de 65,7 % selon la méthode officielle et de 67 % selon AA sont tous deux ceux de K3.1 Pro à Terminal-Bench 4.0, mais les tests utilisent des environnements d’évaluation (harness) différents. On peut voir le harness comme le programme qui encadre l’examen du modèle : il détermine les outils auxquels celui-ci peut accéder, la façon dont il lit et écrit les fichiers, ainsi que le délai avant expiration. Si cet environnement change, le score d’un même modèle peut aussi varier.
On ne peut donc pas affirmer que « K3.1 Pro a obtenu 67 % chez AA, soit mieux que les 66,4 % d’Opus selon les résultats officiels ». La bonne interprétation est la suivante : selon la méthode officielle, K3.1 Pro est légèrement en dessous, avec un écart de 0,7 point de pourcentage ; selon la méthode d’AA, il obtient le meilleur résultat parmi les modèles évalués par cet organisme. Ces deux conclusions sont valables séparément ; prises ensemble, elles indiquent seulement que les deux modèles se situent dans la même fourchette.
3.4 Que représente concrètement un écart d’un point dans le développement ?
Terminal-Bench 4.0 applique une notation stricte : chaque tâche est réussie ou échouée. Un point de pourcentage correspond à environ une tâche de plus ou de moins réussie sur cent. Ces écarts concernent souvent des tâches rares, par exemple liées à une chaîne d’outils peu répandue ou à une configuration d’environnement particulière. Pour les tâches quotidiennes — écrire des interfaces, modifier du code métier ou ajouter des tests unitaires — une différence aussi faible se remarque à peine.
Ce qui change vraiment l’expérience de développement, ce sont deux différences de « tempérament ». La première concerne le style de raisonnement : K3.1 Pro réfléchit en permanence, et AA a constaté que ses réponses étaient plus longues pour chaque tâche (source tierce). La deuxième tient à ses habitudes d’utilisation des outils : à quelle fréquence le modèle lance des commandes, s’il préfère lire les fichiers avant de les modifier, etc. Pour l’instant, il n’existe pas de données comparatives publiques fiables sur ce point (non vérifié). Le mieux est donc de tester quelques tâches réelles sur votre propre dépôt.
4. Avantages et limites de Kimi K3.1 Pro et Claude Opus 5.5
Les avantages de Kimi K3.1 Pro (documentation officielle) :
- Le prix des entrées et des sorties est deux fois moins élevé que celui d’Opus 5.5, et l’écriture en cache coûte également moins cher.
- Une fenêtre de contexte de 1 048 576 tokens ;
max_completion_tokensest fixé par défaut à 131072 et peut atteindre 1048576. - Compatible avec les formats d’API OpenAI et Anthropic. La documentation recommande de l’utiliser avec des agents de programmation comme Kimi Code, Codex et Claude Code.
- Prend en charge les sorties structurées, l’appel d’outils et la continuation
partial. Les clients API peuvent choisir une conservation des données nulle. L’éditeur s’engage à publier les poids complets avant le 4 novembre 2026.
Les limites de Kimi K3.1 Pro (documentation officielle et sources tierces) :
- Impossible de désactiver le raisonnement.
reasoning_effortpeut uniquement être réglé surlow,highoumax; sa valeur par défaut estmax. temperatureest fixé à 1.0 ettop_pà 0.95 : ces paramètres ne peuvent pas être transmis manuellement.- Pour les images en entrée, les URL publiques ne sont pas prises en charge. Il faut fournir une image encodée en base64 — ce qui la convertit en une longue chaîne de texte — ou utiliser
ms://file-id. - AA a mesuré un taux d’hallucination de 44 % et des réponses plutôt longues pour les tâches individuelles.
Les avantages de Claude Opus 5.5 : il arrive en tête des évaluations officielles et de l’indice composite d’AA, devance ses concurrents d’environ 3,5 points de pourcentage sur BenchCAD et obtient aussi un meilleur score sur GDPval-AA. Il propose une mise en cache d’une heure et un mode Fast, qui permettent d’ajuster le compromis entre vitesse et coût. Sa principale limite est son prix : les entrées et les sorties coûtent deux fois plus cher que pour K3.1 Pro, et le mode Fast double encore la facture.
5. Kimi K3.1 Pro vs Claude Opus 5.5 : quel modèle choisir selon le cas d’usage ? 6 types de tâches
Un « agent » est une application qui peut planifier elle-même les étapes à suivre, utiliser des outils et exécuter des tâches en plusieurs étapes. Par exemple, un assistant de programmation qui modifie automatiquement du code, puis lance des tests.
| Type de tâche | Modèle recommandé | En bref |
|---|---|---|
| Tâches hors ligne en grande quantité | Kimi K3.1 Pro | Son tarif est deux fois moins élevé et l’écriture dans le cache coûte aussi moins cher : les économies sont particulièrement importantes pour les traitements en lot. |
| Agent de programmation avec plusieurs étapes | Les deux conviennent ; mieux vaut les tester | Leurs scores sont dans la même catégorie. Le choix dépend surtout de la longueur de réflexion et des habitudes d’utilisation des outils qui conviennent à votre dépôt. |
| Génération de code 3D / CAO | Claude Opus 5.5 | D’après les chiffres publiés par Anthropic, Opus 5.5 obtient un meilleur résultat sur BenchCAD : 96,2 % contre 92,7 %. |
| Compréhension d’images | Selon le mode d’intégration | K3.1 Pro prend en charge les images, mais ne permet pas de transmettre directement une URL publique. Les capacités des deux modèles en traitement d’images ne sont pas comparables à partir de données établies selon les mêmes critères (à vérifier). |
| Applications d’entreprise soumises à des exigences de stabilité et de conformité | Plutôt Claude Opus 5.5 ; Kimi peut être intéressant si la maîtrise des données est une priorité | Opus 5.5 affiche un indice global plus élevé. Kimi propose une politique de conservation nulle des données et prévoit d’ouvrir prochainement ses poids. |
| Applications à faible latence où la réflexion doit être désactivée | Claude | Il n’est pas possible de désactiver la réflexion dans K3.1 Pro. Pour Claude, référez-vous à la documentation d’Anthropic sur les paramètres de réflexion ; le mode Fast est aussi une option. |
6. Kimi K3.1 Pro vs Claude Opus 5.5 : calcul des coûts — un tarif unitaire divisé par deux ne signifie pas un coût divisé par deux
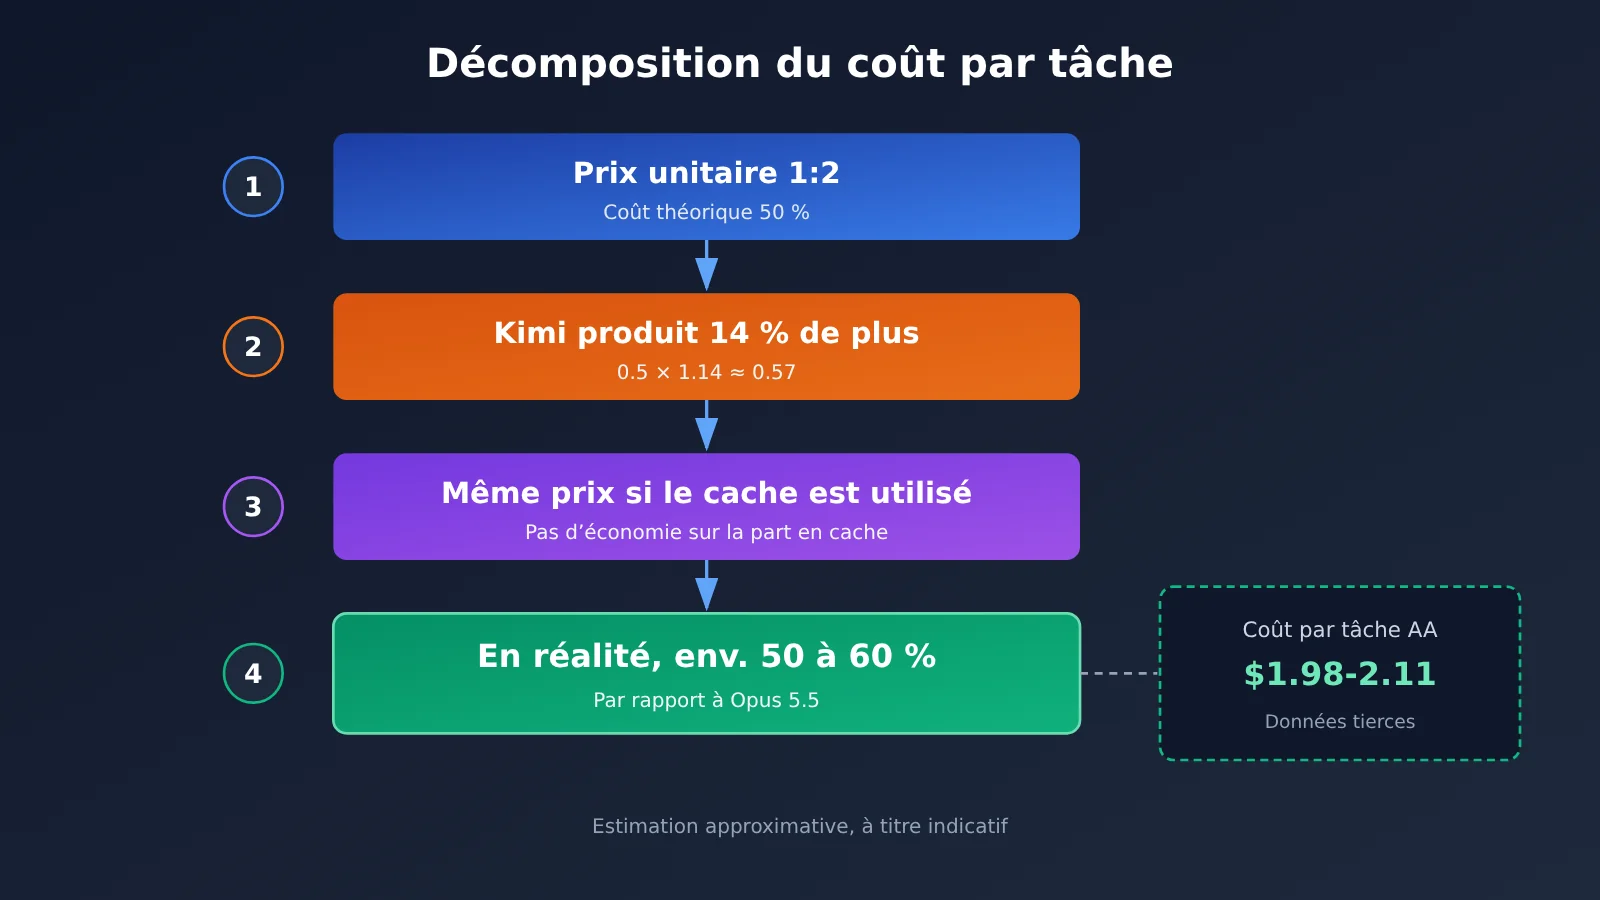
Commençons par un calcul simple : pour une même requête, avec 50 000 tokens en entrée et 5 000 tokens en sortie :
- Kimi K3.1 Pro : 50 000 × $2 ÷ 1 000 000 + 5 000 × $10 ÷ 1 000 000 = $0,10 + $0,05 = $0,15
- Claude Opus 5.5 : 50 000 × $4 ÷ 1 000 000 + 5 000 × $20 ÷ 1 000 000 = $0,20 + $0,10 = $0,30
Sur la base des tarifs unitaires, Kimi coûte exactement moitié moins cher. Mais cette comparaison suppose que les deux modèles produisent la même quantité de texte. En pratique, ce n’est pas le cas. D’après les données d’AA, Kimi génère environ 14 % de tokens de sortie en plus par tâche, avec une moyenne d’environ 55 000 tokens de sortie par tâche, pour un coût d’environ $1,98 par tâche (la page du modèle affiche $2,11) (source tierce). Conclusion d’AA : le tarif unitaire de Kimi est bien moitié moins élevé que celui d’Opus 5.5, mais son raisonnement est plus verbeux ; le coût réel par tâche n’est donc pas réduit de moitié.
Voici une estimation à la louche (non vérifiée, à titre indicatif) : le coût des tâches confiées à un agent de programmation vient surtout des tokens de sortie. Si Kimi en génère 14 % de plus, le coût de la partie sortie représente environ 1,14 × 0,5 ≈ 57 % de celui d’Opus 5.5. L’économie est donc supérieure à 40 %, mais inférieure à 50 %. C’est déjà considérable ; mieux vaut simplement ne pas prévoir son budget en tablant sur une réduction de moitié.
7. Comment appeler Kimi K3.1 Pro et Claude Opus 5.5 depuis la Chine
Les développeurs en Chine qui se connectent directement aux API officielles à l’étranger rencontrent souvent des problèmes de paiement et de réseau. APIYI (apiyi.com) est une plateforme d’agrégation d’API qui permet d’appeler plusieurs modèles avec une seule clé API. Elle propose une interface compatible avec le format OpenAI et une facturation à l’usage. Au 24 octobre 2026, les tarifs vérifiés sur la plateforme pour claude-opus-5-5 étaient de 4 $ en entrée, 20 $ en sortie et 0,2 $ pour la lecture du cache ; ceux de claude-sonnet-5-5 étaient de 2 $ / 10 $ / 0,1 $. Ces tarifs sont identiques à ceux d’Anthropic. Les modèles de la série Kimi déjà disponibles sont les suivants :
kimi-k3: 3 $ / 15 $, lecture du cache à 0,3 $kimi-k2.7-code: 0,95 $ / 3,99 $kimi-k2.6: 0,6 $ / 2,4 $kimi-k2.5: 0,6 $ / 3,15 $
kimi-k3.1-pro ne figurait pas encore dans la liste ce jour-là. Pour connaître son nom de modèle et son tarif sur APIYI, consultez la liste des modèles de la plateforme. Nous proposerons ce modèle dès que possible. Voici comment vous connecter :
- Format compatible avec OpenAI : renseignez
https://api.apiyi.com/v1dansbase_url. - Format Anthropic : renseignez
https://api.apiyi.comcomme adresse de base. - Les agents de programmation (comme Claude Code) utilisent généralement le format Anthropic, tandis que les SDK classiques utilisent le format OpenAI.
Pour démarrer rapidement : vous pouvez commencer par utiliser le crédit gratuit réservé aux nouveaux utilisateurs sur APIYI, apiyi.com. Testez
claude-opus-5-5etclaude-sonnet-5-5sur quelques tâches réelles dans votre propre dépôt afin de disposer d’une base de comparaison. Pour connaître les modèles disponibles et leurs tarifs, consultez la liste de la plateforme. Kimi K3.1 Pro sera proposé dès que possible ; une fois disponible, il vous suffira de changer le nom du modèle pour le comparer directement.
8. Kimi K3.1 Pro vs Claude Opus 5.5 : comment choisir ?
Si vous avez un volume de tâches important, un budget serré et que cela ne vous dérange pas de laisser le modèle réfléchir en permanence, Kimi K3.1 Pro offre un meilleur rapport qualité-prix. Si vous privilégiez la stabilité générale, avez besoin de générer des modèles 3D/CAD ou souhaitez désactiver la réflexion pour réduire la latence, mieux vaut choisir un modèle de la gamme Claude (Opus 5.5 ou Sonnet 5.5). Pour les agents de programmation qui enchaînent plusieurs tours, les deux modèles sont au même niveau dans les benchmarks. Plutôt que de vous fier aux classements, testez-les une semaine sur votre propre base de code.
Une autre option mérite votre attention : si Kimi vous intéresse surtout parce qu’il coûte « deux fois moins cher », sachez que Claude Sonnet 5.5 affiche exactement les mêmes tarifs à l’entrée et à la sortie, un tarif inférieur pour les entrées issues du cache et un indice global AA légèrement supérieur. Vous pouvez donc aussi l’ajouter à votre liste de candidats.
Questions fréquentes (FAQ)
Q1 : Quelle est la différence réelle entre Kimi K3.1 Pro et Claude Opus 5.5 en programmation ?
D’après les chiffres communiqués par Moonshot, K3.1 Pro obtient un score inférieur de 0,7 point de pourcentage à Terminal-Bench 4.0 (65,7 % contre 66,4 %). Selon les tests indépendants d’AA, K3.1 Pro est le modèle le mieux classé parmi tous ceux évalués sur Terminal-Bench 4.0. Les deux modèles sont dans la même catégorie, avec un écart d’environ 1 à 3 points de pourcentage.
Q2 : Quel est l’écart de prix ?
Les tarifs à l’entrée et à la sortie sont deux fois plus élevés pour Opus 5.5. Le tarif des entrées issues du cache est identique (0,20 $), tandis que l’écriture dans le cache coûte moins cher avec Kimi. Comme Kimi génère des réponses plus longues, le coût réel par tâche représente environ 50 à 60 % de celui d’Opus 5.5 (estimation).
Q3 : Pourquoi le score officiel de 65,7 % diffère-t-il des 67 % d’AA ?
Les deux tests utilisent des environnements d’évaluation (harness) différents. Le test officiel utilise le harness Claude Code. Les scores obtenus avec des méthodes différentes ne peuvent être comparés qu’au sein de chaque test, et non directement entre eux.
Q4 : Peut-on désactiver la réflexion de Kimi K3.1 Pro ?
Non. Vous pouvez uniquement régler `reasoning_effort` sur `low` ; `temperature` et `top_p` sont également fixes. Pour les cas où la latence est un enjeu majeur, nous vous conseillons d’envisager un modèle de la gamme Claude.
Q5 : Comment comparer ces deux modèles depuis la Chine ?
Vous pouvez utiliser la même clé API sur APIYI apiyi.com pour appeler `claude-opus-5-5`. Il suffit de renseigner `https://api.apiyi.com/v1` dans `base_url`. Pour connaître le nom du modèle et le tarif de Kimi K3.1 Pro, consultez la liste des modèles de la plateforme. Nous proposerons ce modèle prochainement ; en attendant, vous pouvez utiliser `kimi-k3` pour effectuer une première comparaison.
Q6 : Quel modèle choisir pour débuter à moindre coût ?
Nous vous conseillons de commencer par Claude Sonnet 5.5 pour établir une référence : son tarif est identique à celui de K3.1 Pro. Après votre inscription sur APIYI apiyi.com, vous bénéficierez d’un crédit de test gratuit. Les modèles disponibles et leurs tarifs sont indiqués dans la liste de la plateforme. Nous proposerons bientôt K3.1 Pro ; une fois le modèle disponible, vous pourrez le comparer directement en changeant son nom.
Kimi K3.1 Pro vs Claude Opus 5.5 : points clés
- Programmation : même catégorie : selon les chiffres officiels, K3.1 Pro obtient un score inférieur de 0,7 point de pourcentage. Selon les mesures d’AA, K3.1 Pro atteint le meilleur score sur Terminal-Bench 4.0.
- Prix unitaire : rapport de 1 à 2 : 2 $/10 $ contre 4 $/20 $. Le tarif des tokens en cache est identique : 0,20 $.
- Le coût ne baisse pas de moitié : Kimi génère environ 14 % de tokens de sortie en plus par tâche. AA estime le coût par tâche entre 1,98 $ et 2,11 $.
- Ne mélangez pas les méthodes de calcul : les 65,7 % annoncés officiellement et les 67 % mesurés par AA reposent sur des environnements d’évaluation différents.
- Les points forts d’Opus : il est en tête sur l’indice global, BenchCAD et GDPval-AA.
- Les limites de Kimi : impossible de désactiver le mode réflexion, impossible de fournir une image via une URL publique, taux d’hallucination de 44 %.
- Pour commencer : vous pouvez tester la gamme Claude sur APIYI, à l’adresse apiyi.com. Les modèles et les prix de K3.1 Pro seront ceux indiqués dans la liste de la plateforme. Nous la proposerons dès que possible.
En résumé
La comparaison entre Kimi K3.1 Pro et Claude Opus 5.5 se résume à trois points :
- Capacités : ils jouent dans la même catégorie en programmation et en capacités d’agent. L’écart de score reste dans la marge d’erreur des tests et des différences de méthode d’évaluation.
- Prix : le prix unitaire est exactement deux fois moins élevé pour Kimi, mais son mode réflexion génère davantage de tokens. Au final, le coût réel baisse d’un peu plus de 40 %.
- Choix du modèle : privilégiez Kimi pour les tâches en volume et les budgets serrés. Claude sera plus adapté aux usages exigeant des performances élevées en 3D/CAD, une faible latence et une grande stabilité générale.
Le plus fiable reste de tester les modèles sur vos propres tâches. Vous pouvez commencer par établir une référence avec la gamme Claude sur APIYI, à l’adresse apiyi.com. Les modèles et les prix disponibles sont ceux indiqués dans la liste de la plateforme. Kimi K3.1 Pro sera proposé dès que possible : il suffira ensuite de changer le nom du modèle pour les comparer.
Références
- Blog officiel de Moonshot et documentation de l’API Kimi : scores de K3.1 Pro, limites des paramètres et tarifs
- Lien :
platform.moonshot.cn/docs -
Détails : résultats annoncés par Moonshot pour Terminal-Bench 4.0 et BenchCAD, ainsi que les spécifications des paramètres
-
Tarifs officiels d’Anthropic : cinq niveaux de prix pour Claude Opus 5.5 / Sonnet 5.5
- Lien :
anthropic.com/pricing -
Détails : comprend le mode Fast et la mise en cache d’une heure
-
Artificial Analysis : indices comparatifs tiers et coût par tâche
- Lien :
artificialanalysis.ai -
Détails : données du 23 octobre 2026, dont Terminal-Bench 4.0, GDPval-AA et AA-Omniscience
-
Liste des modèles d’APIYI : modèles disponibles sur la plateforme et tarifs
- Lien :
docs.apiyi.com/models - Détails : vérification effectuée le 24 octobre 2026 ; consultez la liste en temps réel pour obtenir les informations à jour
Auteur : équipe technique d’APIYI
Échanges techniques : pour en savoir plus, consultez le centre de documentation sur docs.apiyi.com. La liste des modèles de la plateforme fait foi pour les modèles et les tarifs. Nous proposerons le modèle Kimi K3.1 Pro dès que possible.