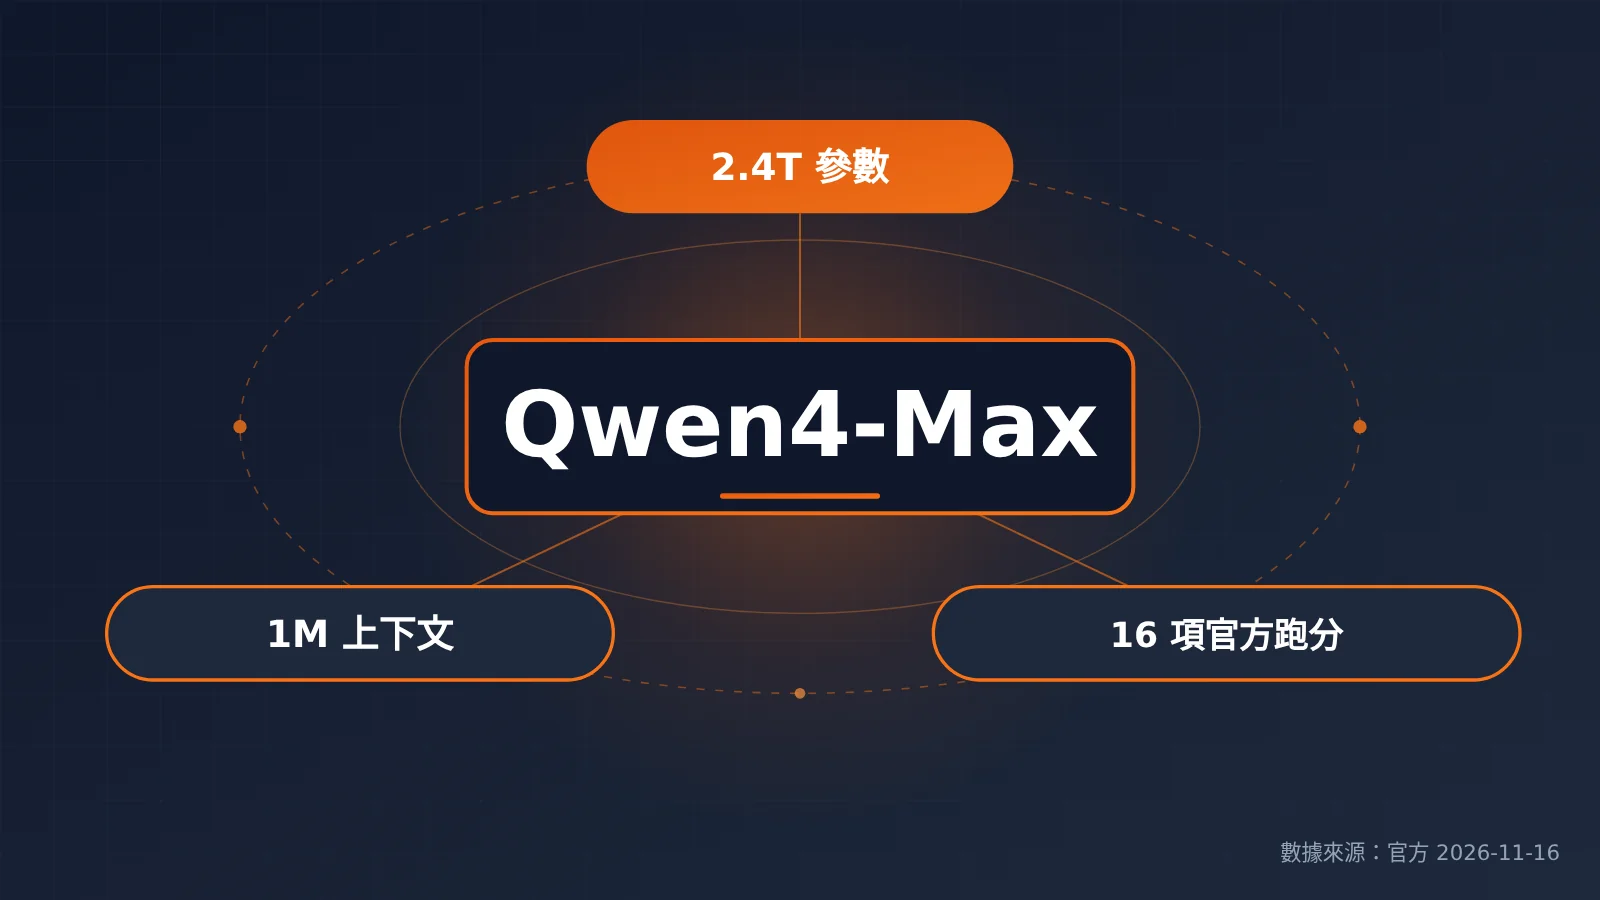
阿里通義團隊於 2026-11-16 上午發佈了 Qwen4-Max。主幹參數 2.4T,上下文 1M,同時給出了一張包含 16 項跑分的對比圖。
先說結論:Qwen4-Max 真正領先的是 token 效率和長程交付,並不是每一項都排第一。 在 16 項官方自報跑分裏,它拿到 4 個第一、4 個第二;終端操作、程序構建、圖表理解和視頻理解這幾項,仍明顯落後於同圖裏的頭部對手。
本文的信息來源只有三類:2026-11-16 的官方發佈材料、arena.ai Code Arena WebDev 公開榜的終榜快照(2026-11-14),以及 QwenCloud 和千問AI平臺的兩處掛牌價。未公佈的參數細節和第三方復現結果不在本文範圍內。如果你手上正在跑 Qwen3.8-Max 或其他旗艦模型,讀完可以按三類任務分別判斷要不要換,並用輸入價、輸出價和緩存價自己算一筆賬。
Qwen4-Max 發佈信息速覽
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026-11-16 10:01(UTC+8) |
| 發佈方 | 阿里巴巴通義千問(Qwen)團隊 |
| 參數規模 | 2.4T 主幹參數,每 token 激活 71B,另有 328B N-gram Embedding 參數 |
| 上下文 | 1M,原生視覺 |
| 官方渠道 | QwenCloud API、Qwen Studio、QwenWork、Qoder、千問 App |
| 開源計劃 | 官方表示更小尺寸的 Qwen4 會開源權重,Max 本身未提開源 |
從發佈節奏看,這次不只是一個 API 型號的更新。Qwen4-Max 同時進入了 QwenWork(辦公)和 Qoder(編程)兩款自有產品,官方材料也把重點放在 agent 長任務和行業交付上,沒有把純問答能力作爲主打。
Qwen4-Max 架構的三處改動
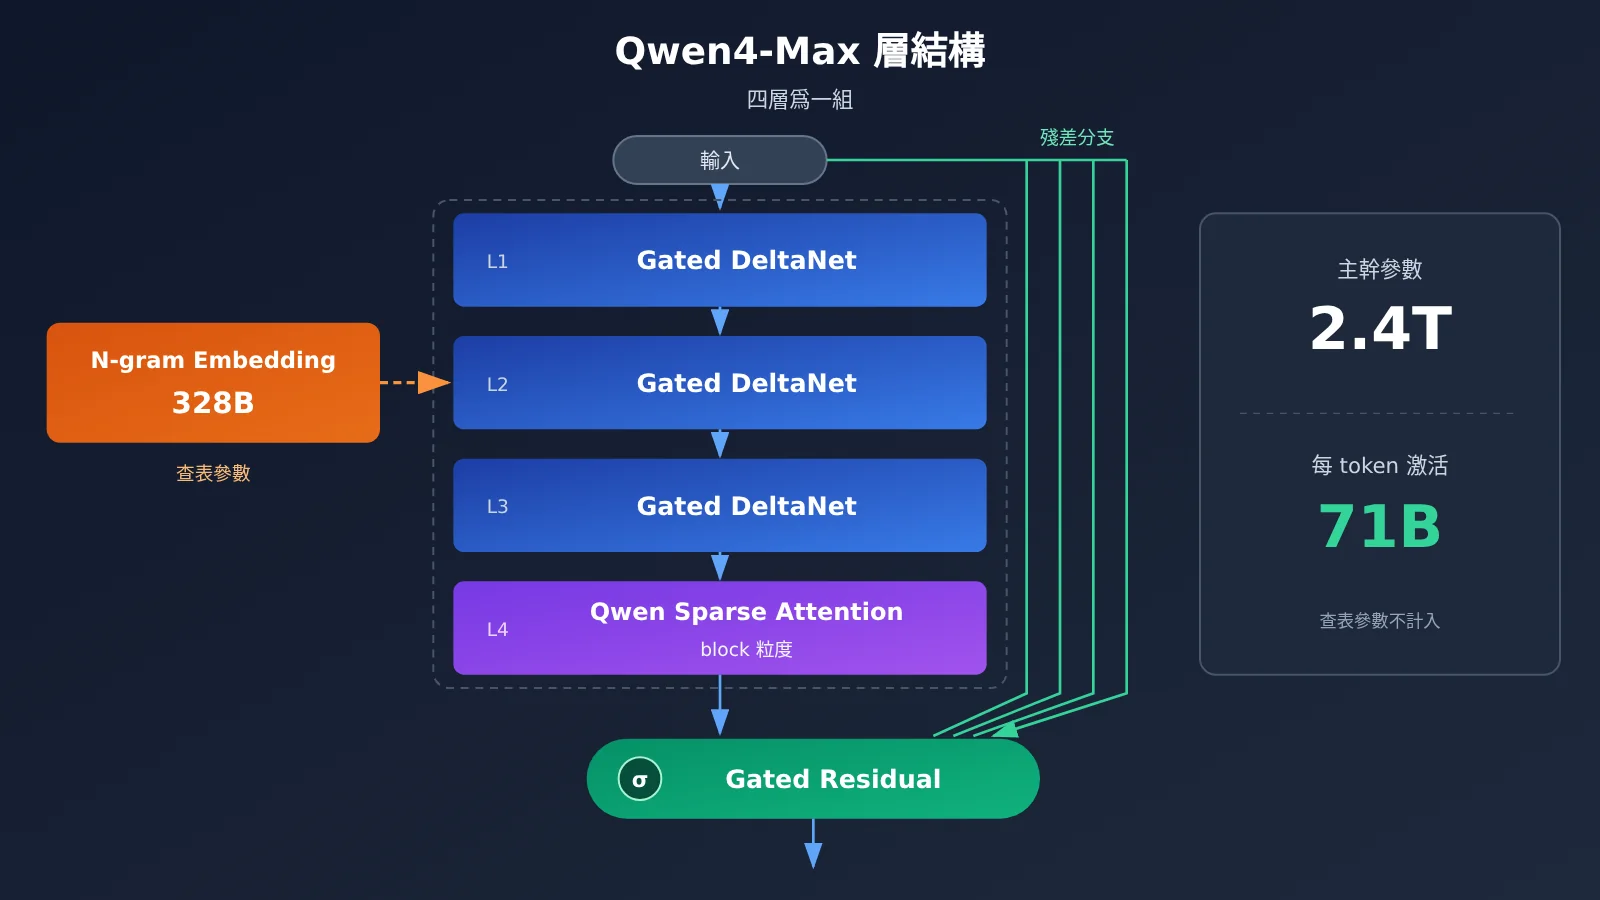
官方博客列出了三項結構改動,下面逐條說明它們解決什麼問題:
- GDN + QSA 混合注意力:每四層中有三層使用 Gated DeltaNet,另一層使用 Qwen Sparse Attention,並以 block 爲粒度選擇上下文。這樣安排的主要目的是降低 1M 長上下文下的計算開銷。
- Gated Residual:殘差路徑拆成四條並行分支,再通過門控合併,用於提升深層網絡的表達能力。
- N-gram Embedding:在第二層查表,補充局部 token 模式。328B 的額外參數就來自這裏,它們屬於查表參數,不參與每個 token 的激活計算。
需要注意,2.4T 是主幹參數總量,每個 token 實際激活的是 71B。拿它和其他模型比”參數大小”時,要先確認雙方用的是同一個口徑。
Qwen4-Max 規格與協議
| 規格項 | Qwen4-Max |
|---|---|
| 上下文窗口 | 1M |
| 最大輸入 | 991K(思考模式下爲 983K) |
| 最大輸出 | 393K |
| 最大思維鏈 | 262K |
| TPM | 500 萬 |
| 兼容協議 | OpenAI Chat Completions、Responses、Anthropic Messages、DashScope |
默認 reasoning_effort |
high(Qwen3.8-Max 默認爲 xhigh) |
最後一行很容易被忽略。Qwen4-Max 默認的推理檔位是 high,比上一代默認的 xhigh 低一檔。如果你直接用默認參數對比新舊兩代,看到的 token 節省有一部分來自檔位差異,而不完全來自模型本身。做 A/B 測試時,建議把 reasoning_effort 顯式設成相同的值。
Qwen4-Max 16 項官方跑分:領先與落後
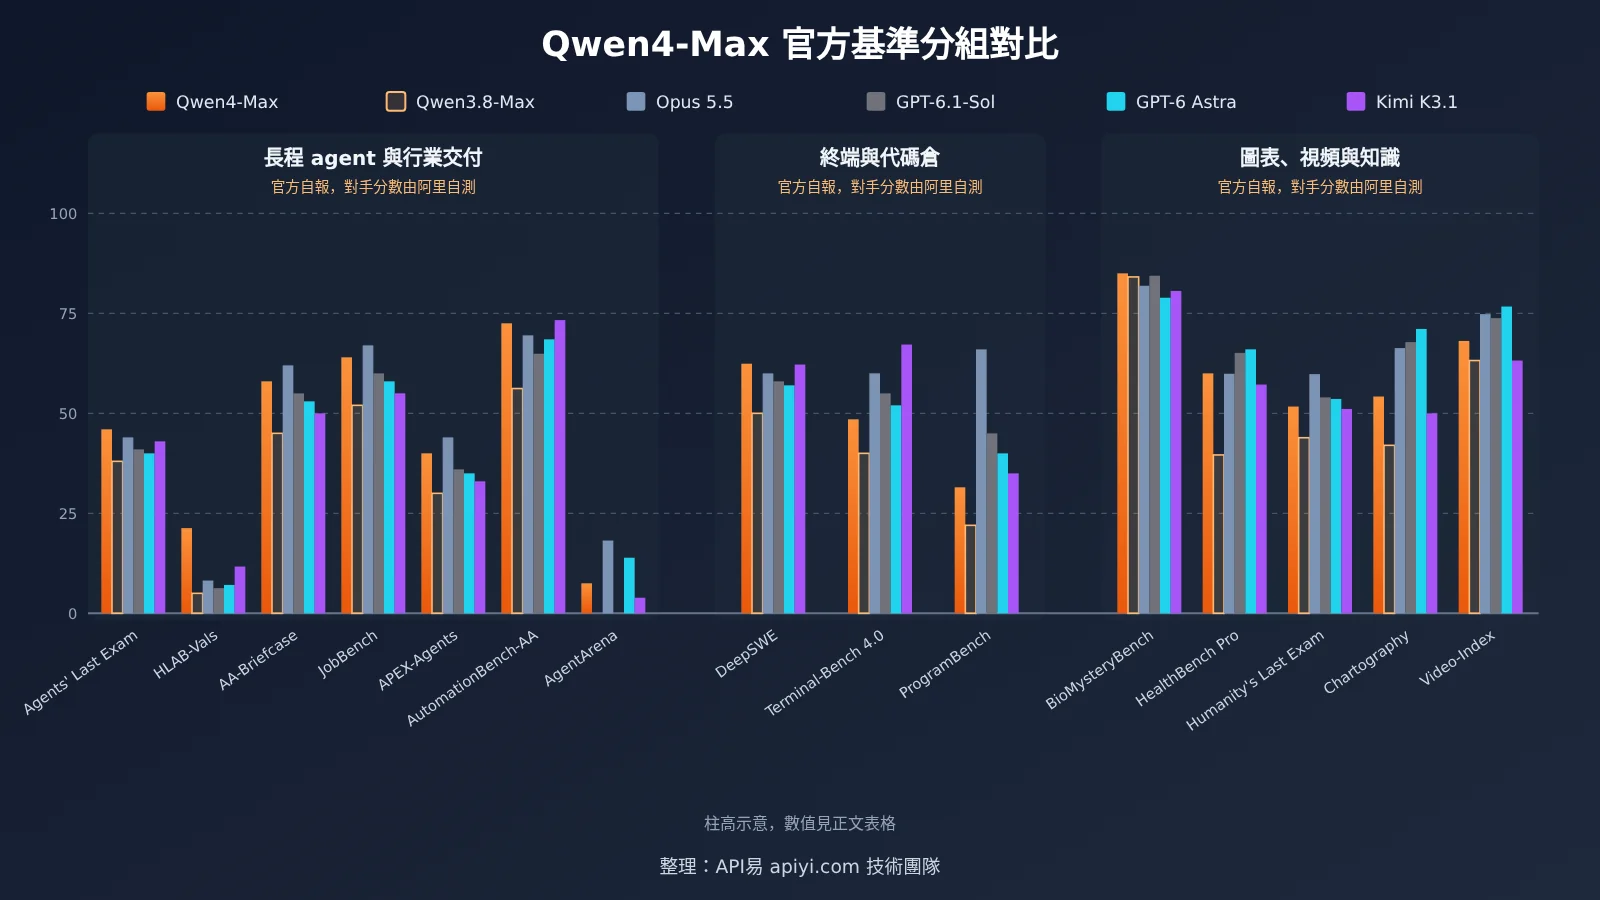
下表的全部分數都來自官方發佈的同一張圖,屬於官方自報。圖中對手的分數也是阿里自己測出來的,不能當作 Anthropic、OpenAI 或月之暗面公佈的官方成績。其中 CodeArena 與 AgentArena 引自 LM Arena,AA-Briefcase 與 AutomationBench-AA 引自 Artificial Analysis,APEX-Agents 引自 Mercor 榜,JobBench 由阿里用更新後的數據集和評測代碼自行測試。
| 基準 | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev(Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1(Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | 未標 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena(Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Qwen4-Max 領先的項目
Qwen4-Max 排第一的有四項:DeepSWE、Agents’ Last Exam、HLAB-Vals 和 BioMysteryBench。其中 HLAB-Vals 的差距最大,21.3 分約爲第二名 Kimi K3.1 的兩倍。DeepSWE 只比 Kimi 高 0.2 分,這個差距基本可以視爲持平。
另外四項排第二:AA-Briefcase、JobBench、APEX-Agents 和 AutomationBench-AA。前三項的第一名都是 Opus 5.5,最後一項的第一名是 Kimi K3.1。這些基準都偏向長程 agent 和白領工作交付,也正是官方這次主打的方向。
Qwen4-Max 落後的項目
終端與程序構建是這次最明顯的短板。Terminal-Bench 4.0 的 48.5 分在六個模型中排第五,比第一名 Kimi 少 18.7 分。ProgramBench 的 31.5 分不到 Opus 5.5 的一半。如果你的 agent 主要在 shell 裏跑構建、調試和部署,這兩項比 DeepSWE 更有參考價值。
圖表和視頻理解同樣落後。Chartography 和 Video-Index 都排在第四,距離第一名 GPT-6 Astra 分別差 16.9 分和 8.6 分。Humanity’s Last Exam 也排第四。所以”原生視覺”指的是能力具備,不代表這方面領先。
Qwen4-Max 在 Code Arena 公開榜的位置
arena.ai Code Arena WebDev 的公開榜終榜快照(2026-11-14)共有 1,007,405 票、159 個模型。Qwen4-Max(xHigh)以 1750 分排第 6,標記爲 Preliminary,只有 1,814 票,頁面顯示的單任務成本 P50 爲 $4.18。排在它前面的依次是 Claude Fable 5.2、Claude Opus 5.5、Claude Sonnet 5.5、Gemini 4 Carbon(Preliminary)和 GPT-6 Astra。
上一代 Qwen3.8-Max(0902)在同一榜單上是 1676 分、第 16 名,因此這一代提升了 74 分、10 個名次。不過 Qwen4-Max 的票數還比較少,後續排名可能還會變化。
Qwen4-Max 的 token 效率與”成本降六成”從何而來
官方的效率數字來自其自建的 Work360 場景基準。這套基準有 26 個一級領域、182 個二級領域和 721 個三級領域,Qwen4-Max 得分 52.69,Qwen3.8-Max 爲 47.74。在 token 消耗上,Work360 的 Xhigh 檔約少 24%,High 檔約少 35%;在 Terminal-Bench 4.0 上,兩檔分別約少 48% 和 49%。
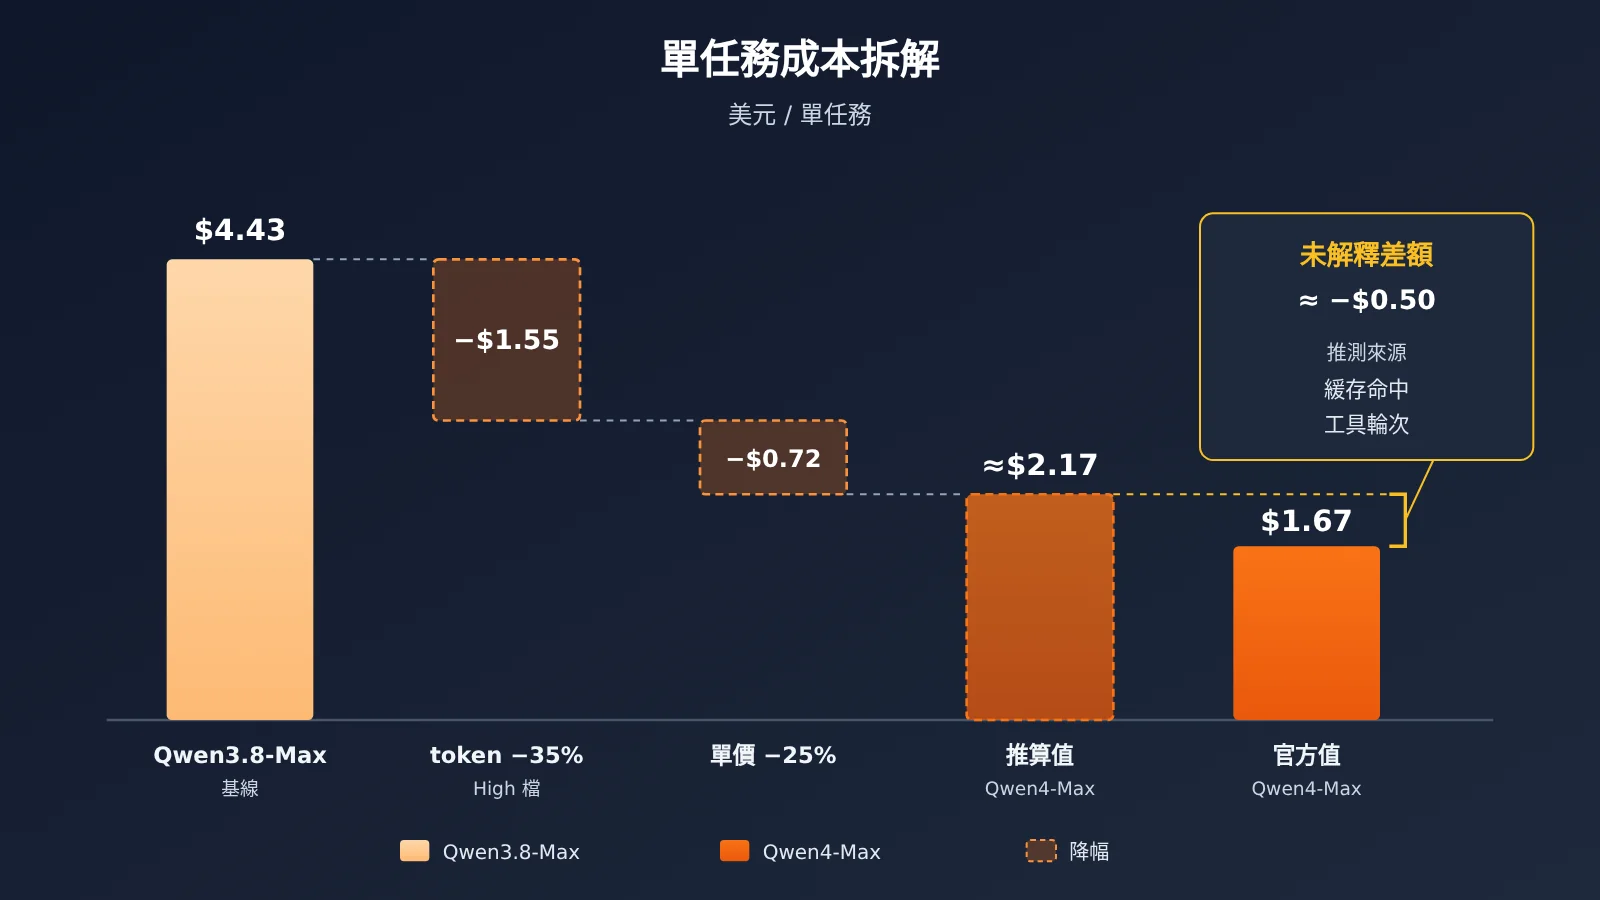
單任務平均成本方面,官方給出的數字是從 $4.43 降到 $1.67,中文博客口徑爲 ¥26.58 降到 ¥11.16,降幅 58%。按美元數字計算的降幅約爲 62%。但如果只用”token 少 35% × 單價降 25%”來推,結果約爲 0.65 × 0.75 ≈ 0.49,也就是降 51% 左右。中間這部分差額官方沒有解釋,比較可能的來源是緩存命中率提高、工具調用輪次變少,但這只是推測,不能當作已經確認的原因。
安全方面,Last Secure Code Bench 函數級的”功能與漏洞雙通過率”從 22.0% 提升到 31.8%。函數、文件、倉庫三個粒度都生成安全代碼的比例,從 8% 提升到 14.7%。絕對值仍然不高,生成的代碼依然需要人工審查。
Qwen4-Max 價格怎麼算
下面列出 Qwen4-Max 的官方價格,以及上一代模型的官方價和 API易 現價,單位都是 美元 / 1M tokens,取數日期爲 2026-11-16。
| 計費項 | Qwen4-Max(QwenCloud 官方) | Qwen3.8-Max(官方) | qwen3.8-max(API易 apiyi.com 現價) |
|---|---|---|---|
| 輸入 | $1.5 | $2 | $1.65 |
| 輸出 | $4.5 | $6 | $4.95 |
| 緩存讀 / 命中 | $0.075 | $0.25 | $0.20625 |
| 5 分鐘顯式緩存創建 | $1.875 | — | — |
| 1 小時顯式緩存創建 | $3 | — | — |
人民幣價格以千問AI平臺爲準,單位爲 人民幣 / 1M tokens,取數日期 2026-11-16:
- 輸入 ¥10,輸出 ¥30,緩存命中 ¥0.5
- 5 分鐘顯式緩存創建 ¥12.5,1 小時顯式緩存創建 ¥20
與上一代官方價相比,Qwen4-Max 的輸入價和輸出價各低 25%,緩存讀價低 70%。緩存讀價降幅最大,這對長程 agent 影響明顯,因爲多輪任務裏大量重複的系統提示和歷史上下文都會按緩存價計費。
自己估算成本時,可以按這個公式拆開算:未命中輸入 × 輸入價 + 緩存命中 × 緩存價 + 顯式緩存創建量 × 創建價 + 輸出(含思維鏈)× 輸出價。舉個假設的例子:一個任務有 1M 輸入,其中 60 萬命中緩存,輸出 10 萬。用 Qwen4-Max 官方價計算約爲 $0.6 + $0.045 + $0.45 ≈ $1.10;在相同 token 量下,用 Qwen3.8-Max 官方價計算約爲 $1.55。實際差距還要再疊加 token 消耗的變化,所以最可靠的做法是拿自己的真實日誌重新跑一遍。
💰 算賬提示:API易 目前還沒有上架 qwen4-max,我們會盡快上架這個模型,具體型號名和價格以 apiyi.com 平臺的型號列表爲準。上架之前,可以先用平臺上的
qwen3.8-max建立成本基線,等新型號上線後直接對比兩份賬單。
如何按場景判斷要不要換 Qwen4-Max
| 場景 | Qwen4-Max 的表現(官方自報) | 建議 |
|---|---|---|
| 長程 agent 與行業交付(辦公自動化、研究、交付文檔) | HLAB-Vals、Agents’ Last Exam 第一;APEX、JobBench、AA-Briefcase 第二;token 明顯更省 | 優先評估,從 Qwen3.8-Max 升級的收益最清楚 |
| 終端與代碼倉(shell agent、構建、跨倉修改) | DeepSWE 第一但領先很小;Terminal-Bench 第五,ProgramBench 第四 | 以終端操作爲主的任務,先和 Kimi K3.1、Opus 5.5 做對比再決定 |
| 前端 WebDev | Code Arena 公開榜第 6,1750 分(Preliminary) | 可以作爲性價比選項,但不是榜首 |
| 圖表與視頻理解、多模態長文檔 | Chartography、Video-Index 均第四 | 讀圖、讀視頻較多的流程,暫不建議只用它 |
| 生物與醫療問答 | BioMysteryBench 第一;HealthBench Professional 第三 | 可以納入測試,但需要領域專家複覈 |
一個比較穩妥的做法是分流:長程 agent 和文檔交付這類任務交給 Qwen4-Max,終端重度任務和圖表視頻任務繼續留給當前在這些方面表現更好的模型。這樣不用把所有流量一次性遷移,也能先拿到 token 節省帶來的收益。
🎯 選型建議:分流的前提是能用同一套代碼切換模型。API易 apiyi.com 提供 OpenAI 兼容接口,用一個 API Key 就能調用多家旗艦模型,把
model字段換掉即可做 A/B 測試。
Qwen4-Max 快速上手
官方渠道是 QwenCloud API,支持 OpenAI Chat Completions、Responses、Anthropic Messages 和 DashScope 四種協議,已有的 OpenAI SDK 或 Anthropic SDK 都可以直接接入。接入時注意下面幾點:
- 確認型號:官方型號 ID 寫作
qwen4-max,以型號頁爲準。默認reasoning_effort爲high,對比測試時顯式指定同一檔位,例如xhigh。 - 預留輸出空間:最大輸出 393K,最大思維鏈 262K。長任務要把
max_tokens或對應參數設得足夠大,否則思維鏈會佔滿輸出額度。 - 啓用緩存:隱式緩存命中價爲 $0.075。如果系統提示較長且會重複使用,可以評估是否值得使用 5 分鐘或 1 小時的顯式緩存;創建緩存需要單獨付費,複用次數太少時反而不划算。
- 準備對照組:在 API易 註冊後獲取 API Key,將
base_url設爲https://api.apiyi.com/v1,model填qwen3.8-max,用同一批任務跑出舊模型的 token 消耗和分數作爲基線。 - 新型號上架後切換:qwen4-max 上架 API易 後,只需修改
model字段,其餘代碼保持不變,就能直接拿到新舊兩代的對比數據。
🚀 快速開始:新用戶在 API易 apiyi.com 註冊即可獲得免費測試額度,足夠先把
qwen3.8-max的基線跑出來,後續切換模型不需要重新接入。
Qwen4-Max 常見問題 FAQ
Q1:Qwen4-Max 是什麼?
Qwen4-Max 是通義千問在 2026-11-16 發佈的旗艦模型。它採用 2.4T 主幹參數,每 token 激活 71B,原生支持視覺輸入,上下文爲 1M,主要面向長程 agent 和行業交付任務。
Q2:Qwen4-Max 和 Qwen3.8-Max 差別在哪?
在官方自報的 16 項跑分中,Qwen4-Max 每一項都高於 Qwen3.8-Max-0902。Code Arena 公開榜上高出 74 分。官方價格方面,輸入和輸出各低 25%,緩存讀低 70%。另外兩者默認推理檔位不同,分別是 `high` 和 `xhigh`。
Q3:16 項跑分可信嗎?
這些分數都是官方自報的,對手分數也是阿里自己測的,目前沒有第三方復現。可以參考的外部信號是 Code Arena WebDev 公開榜:在 2026-11-14 的終榜快照中,Qwen4-Max 排第 6,但仍是 Preliminary 狀態,票數較少。
Q4:「成本降六成」能直接套用到我的業務嗎?
不能直接套用。這個數字來自官方的 Work360 場景,降幅高於單純按 token 和單價推算的結果,中間的差額官方沒有解釋。你的實際降幅取決於緩存命中率、工具調用輪次和推理檔位,需要用自己的任務日誌測算。
Q5:可以通過 API易 調用 Qwen4-Max 嗎?
截至 2026-11-16 11:00,API易 的型號列表裏還沒有 qwen4-max,我們會盡快上架。目前在售的 Qwen 旗艦是 `qwen3.8-max`,價格爲輸入 $1.65、輸出 $4.95、緩存讀 $0.20625(單位:1M tokens)。上架進度和價格以 apiyi.com 的型號列表爲準。
Q6:Qwen4-Max 有哪些短板?
終端操作(Terminal-Bench 第五)、程序構建(ProgramBench 第四)、圖表與視頻理解(均爲第四)以及 HLE(第四)都落後於同圖中的頭部對手。安全代碼的雙通過率雖然有提升,也只有 31.8%。另外,Max 尺寸目前沒有開源權重的計劃。
總結:Qwen4-Max 值不值得換
- 定位:2.4T 主幹、每 token 激活 71B、1M 上下文的旗艦模型,主打長程 agent 和行業交付。
- 領先的項目:16 項官方自報跑分中拿到 4 個第一、4 個第二,主要集中在 agent 和白領工作交付類基準。
- 落後的項目:終端操作、程序構建、圖表、視頻和 HLE 都排在第四或第五,不能用一個模型覆蓋所有任務。
- 公開榜位置:Code Arena WebDev 終榜快照(2026-11-14)第 6,1750 分,仍爲 Preliminary。
- 成本:官方單價下降 25%,緩存讀下降 70%,token 消耗也明顯減少;”降六成”需要用自己的數據驗證。
如果你的主要負載是長程 agent 和文檔交付,Qwen4-Max 值得優先評估;如果是終端重度任務或圖表視頻理解,建議繼續分流到當前更強的模型。在 qwen4-max 上架之前,可以先通過 API易 apiyi.com 的 OpenAI 兼容接口,用 qwen3.8-max 建立成本和效果基線,新型號上線後修改一個字段就能完成對比。
📚 參考資料
- Qwen 官方 X 發佈帖:Qwen4-Max 發佈公告
- 鏈接:
x.com/Alibaba_Qwen/status/2122148127520289151 -
說明:發佈時間與官方可用渠道
-
Qwen 官方博客(中文):架構、規格、16 項跑分與效率數字
- 鏈接:
qwen.ai/blog?id=qwen4-max -
說明:本文架構、規格與跑分數據均來自此文
-
QwenCloud 型號頁:美元掛牌價
- 鏈接:
qwencloud.com/models/qwen4-max -
說明:美元 / 1M tokens 的輸入、輸出與緩存價格
-
千問AI平臺型號頁:人民幣掛牌價
- 鏈接:
qianwenai.com/models/qwen4-max -
說明:人民幣 / 1M tokens 的價格
-
arena.ai Code Arena WebDev:公開榜
- 鏈接:
arena.ai - 說明:本文引用的是 2026-11-14 的終榜快照
作者:APIYI 技術團隊
技術交流:如需瞭解型號上架進度和接入方式,可在 API易 網站首頁聯繫我們,文檔見 docs.apiyi.com