Note de l’auteur : en prenant l’exemple d’Iceman, un modèle furtif gratuit et non revendiqué sur OpenCode, nous décomposons trois niveaux d’information — les déclarations officielles, les paramètres du catalogue et les indices non confirmés —, nous proposons une liste de 5 points à vérifier avant l’intégration, et nous expliquons comment fusionner plusieurs identifiants pour interpréter les classements d’usage.
Gratuit, sans limite de requêtes, avec une grande fenêtre de contexte, mais personne ne sait qui l’a créé. Ces modèles furtifs gratuits sont devenus courants ces derniers temps dans les outils de programmation, et beaucoup de développeurs ont pour premier réflexe de « le brancher sur le projet pour voir ». Cet article prend Iceman sur OpenCode comme cas d’étude pour répondre à une question concrète : avant d’envoyer du code ou des données métier à un modèle gratuit d’origine inconnue, que faut-il vérifier ?
Ce n’est pas un article pour vous dissuader de les utiliser : les modèles furtifs gratuits sont parfaitement adaptés à la validation de prototypes et aux expérimentations sur du code public. L’essentiel est de distinguer les informations sur lesquelles vous pouvez vous appuyer des simples rumeurs, et de comprendre l’impact réel des clauses d’entraînement et de conservation sur vos données.
L’essentiel : à la fin de cet article, vous disposerez d’une liste de vérification réutilisable pour un modèle furtif, couvrant quatre dimensions : l’usage des données pour l’entraînement, la rétention zéro des données, la durée de la gratuité et l’attribution de la source. Vous saurez aussi repérer les erreurs de lecture des classements, comme la « fausse croissance due à un changement d’identifiant ».
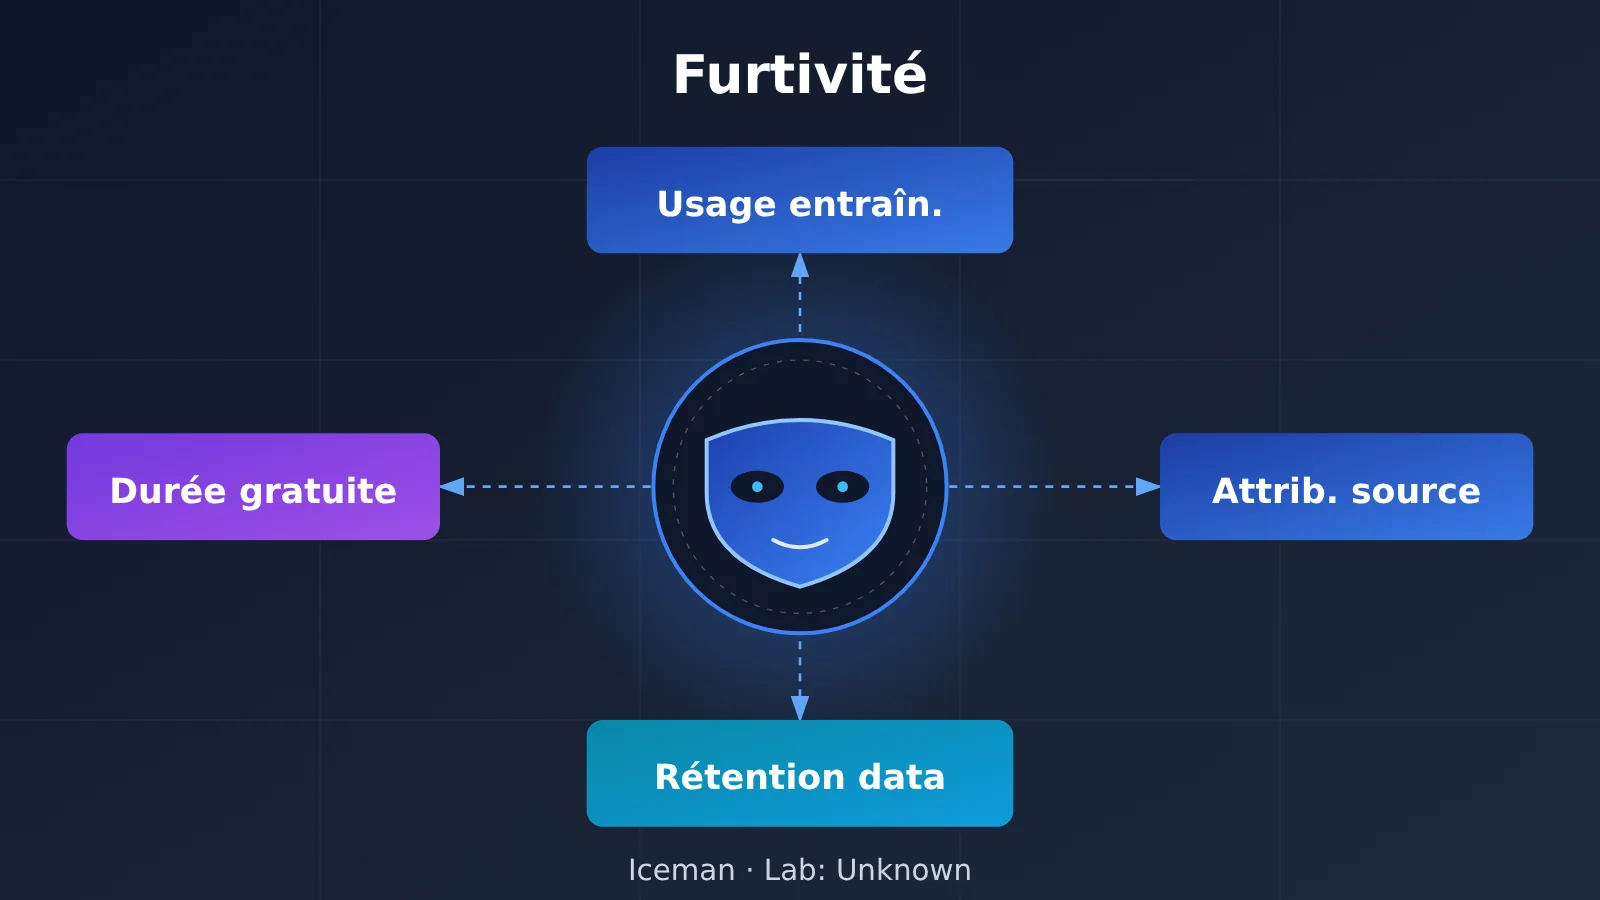
Points clés du modèle furtif gratuit Iceman
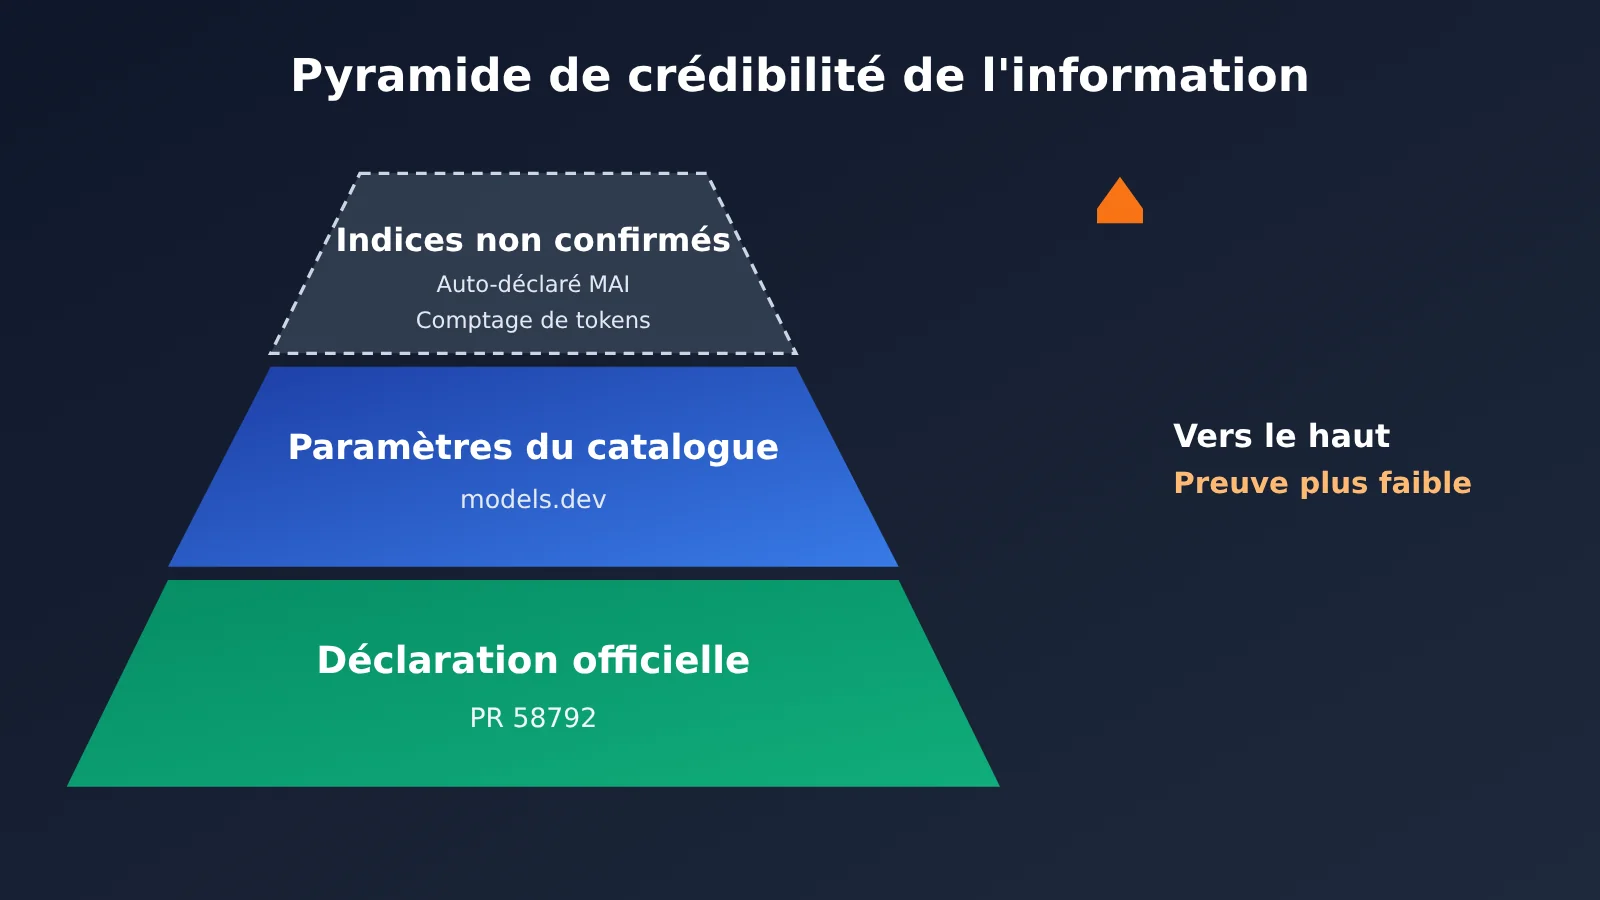
Au 4 novembre 2026 à 18h31 UTC, Iceman n’a toujours été revendiqué par aucun laboratoire d’IA. D’après les données d’utilisation d’OpenCode, il a cumulé environ 3,37 billions de tokens sous deux identifiants depuis le 23 octobre. Le tableau ci-dessous classe d’abord les informations le concernant en trois niveaux de fiabilité : c’est la base de tous les jugements qui suivent.
| Niveau d’information | Contenu précis | Utilisable comme base de décision ? |
|---|---|---|
| Déclaration officielle de la plateforme | PR 58792 fusionnée par OpenCode : gratuit pour une durée limitée, aucune limite de requêtes, les invites servent à l’entraînement, rétention de données non nulle | ✅ Oui, c’est un fait au niveau des conditions d’utilisation |
| Paramètres du catalogue | Catalogue models.dev : 262 144 de contexte, jusqu’à 131 072 tokens de sortie, prise en charge du raisonnement et de l’appel d’outils, texte en entrée / texte en sortie | ✅ Oui, pour le choix technique |
| Indices non confirmés | Un suivi tiers affirme qu’il se présente comme Microsoft MAI, et que le comptage de tokens concorde avec MAI Thinking 1 | ❌ Non, à traiter comme une rumeur |
Détail des conditions officielles du modèle furtif Iceman
Le 24 octobre, OpenCode a ajouté Iceman à son offre Go à 10 dollars par mois, via la pull request 58792 du dépôt, fusionnée à 20h24 UTC. Le modèle s’appelle Iceman Contributor Free, et les conditions indiquent « gratuit pour une durée limitée, aucune limite de requêtes ». La même modification précise deux choses : les invites qui lui sont envoyées servent à l’entraînement, et la politique de rétention des données n’est pas une rétention nulle.
Ce sont ces deux points que les développeurs devraient regarder en priorité : ils déterminent plus directement que la fenêtre de contexte et la longueur de sortie quelles données on peut envoyer. En outre, cette PR a ajouté cet identifiant à la liste des modèles furtifs d’OpenCode, ce qui explique pourquoi la colonne « laboratoire » de la page d’utilisation affiche Unknown. Autrement dit, la plateforme elle-même vous dit clairement : source inconnue.
Ce que signifie vraiment « Contributor » dans le nom du modèle furtif
Beaucoup comprennent le « Contributor » de iceman-contributor comme le nom d’un laboratoire ou d’un contributeur. En réalité, il désigne un mode d’échange propre à OpenCode : des données d’entraînement contre un accès gratuit. Les Muse Spark 1.3 et 1.2 de Meta ont aussi des versions Contributor, ce qui montre qu’il s’agit d’un label générique au niveau de la plateforme, et non d’un indice sur l’origine du modèle.
Donc quand vous voyez « Contributor », la bonne lecture est « les données de ce canal partent à l’entraînement », et non « c’est la version apportée par tel laboratoire ». Ce point sera le premier contrôle de la liste de vérification plus bas.
Impact des conditions d’entraînement des modèles furtifs gratuits sur le code et les données privées
« Les invites servent à l’entraînement » : l’idée paraît abstraite, mais dans un projet, elle pose une question très concrète. Chaque morceau de contexte que vous envoyez peut devenir un échantillon d’entraînement pour le modèle de quelqu’un d’autre. Dans le cas des outils de programmation, le contexte ne se limite souvent pas à la question que vous tapez : il comprend aussi le contenu des fichiers ajoutés automatiquement, les journaux d’erreurs, les fichiers de configuration, voire les variables d’environnement.
Une rétention de données non nulle signifie que le contenu de la requête est conservé un certain temps côté serveur. Combien de temps, où, et par qui il est traité : quand l’origine du modèle est inconnue, impossible de le confirmer. Pour les projets d’entreprise, cela touche souvent directement les clauses de confidentialité du contrat ou les exigences de conformité des données. Le tableau ci-dessous liste les risques réels par type de données.
| Type de données | Source typique | Risque avec entraînement + rétention non nulle | Recommandation |
|---|---|---|---|
| Code open source ou public | Dépôts publics, projets d’exemple | Faible, le contenu est déjà public | Utilisable |
| Code métier privé de l’entreprise | Dépôts internes, algorithmes critiques | Élevé, risque de fuite des détails d’implémentation et de l’architecture | À ne pas envoyer |
| Clés et configuration | .env, fichiers de configuration, scripts CI |
Très élevé, les identifiants peuvent être conservés et servir à l’entraînement | À exclure impérativement |
| Données personnelles des utilisateurs | Journaux, échantillons de base de données, tickets | Très élevé, implique la conformité des données personnelles | Envoi interdit |
| Données synthétiques ou anonymisées | Fixtures de test, données Mock | Faible à moyen, selon la qualité de l’anonymisation | Utilisables après anonymisation |
Il faut ici souligner tout particulièrement le problème du « contexte implicite » des outils de programmation. De nombreux agents lisent automatiquement les fichiers de l’espace de travail : vous croyez poser une simple question sur une fonction, alors que toute l’arborescence des répertoires et les fichiers voisins peuvent être intégrés à la requête. Avec un canal qui pratique l’entraînement, la méthode la plus sûre consiste à travailler dans un espace de travail isolé, ne contenant que des données publiques ou synthétiques.
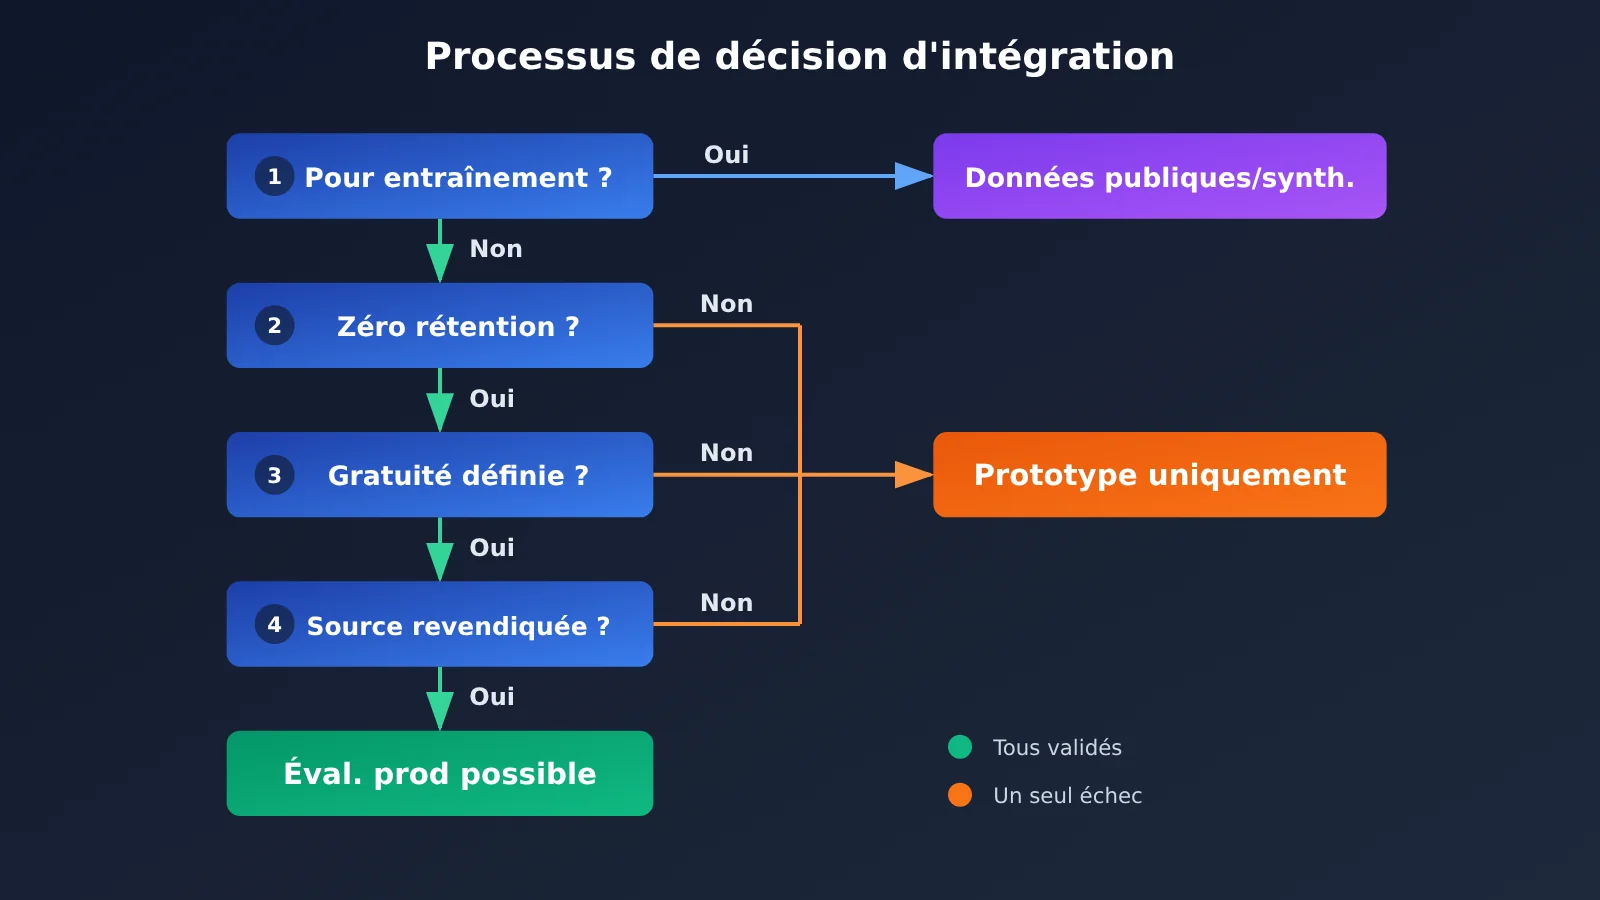
Comment vérifier un modèle furtif gratuit : checklist en 5 points avant l’intégration
Cette checklist ne concerne pas uniquement Iceman : elle s’applique à tout modèle gratuit dont la source n’est pas revendiquée. Les quatre premiers points relèvent des conditions et de l’attribution ; le cinquième vient de l’interprétation des données. L’idéal est d’en faire un processus de revue fixe au sein de l’équipe.
| N° | Point à vérifier | Où vérifier | État actuel d’Iceman |
|---|---|---|---|
| 1 | Les invites sont-elles utilisées pour l’entraînement ? | Conditions de la plateforme, historique des modifications de configuration du modèle | Oui, utilisées pour l’entraînement |
| 2 | Rétention zéro des données ? | Conditions de la plateforme, politique de confidentialité | Non, rétention de données non nulle |
| 3 | Quelle est la durée de la gratuité ? | Annonces de la plateforme, description des offres | Mentionne seulement « durée limitée », durée inconnue |
| 4 | L’attribution de la source est-elle confirmée ? | Déclaration officielle du laboratoire | Non confirmée, le laboratoire affiche Unknown |
| 5 | Les données d’utilisation sont-elles réparties par id ? | Tous les id concernés dans le classement d’utilisation | Oui, réparties entre iceman et iceman-contributor |
Attribution de la source d’un modèle furtif : pourquoi un indice ne vaut pas confirmation
Concernant l’origine d’Iceman, le site de suivi stealthmodels.com rapporte que le compte X @aitrackerbot a remarqué qu’Iceman se présentait comme MAI de Microsoft et que sa méthode de comptage des tokens d’invite correspondait exactement à celle de MAI Thinking 1. Mais les tests du site lui-même ont montré qu’il concordait avec MAI Thinking 1, tout comme avec la série GPT-6 d’OpenAI. Autrement dit, le comptage des tokens ne permet pas de distinguer ces modèles.
Ce qu’un modèle « prétend être » n’est pas fiable non plus : il peut répéter des informations d’identité présentes dans ses données d’entraînement, ou se voir délibérément attribuer une identité par une invite système. À ce jour, Microsoft n’a fait aucune déclaration. La bonne façon de qualifier cette information est donc « un indice », et non un fait à inscrire dans votre document de sélection technique.
Précédents historiques de revendication de modèles furtifs
Dans les modèles furtifs qu’OpenCode a connus par le passé, la revendication intervient généralement au lancement ou dans les semaines qui suivent. ox-alpha a été revendiqué par Z.ai comme GLM-5.3 Flash, cat-jam par Reflection AI comme Beam, et Space Bunny par MiniMax comme M3.1 Flash, 26 jours après sa première apparition. Au 4 novembre, Iceman était en ligne depuis 11 jours et personne ne l’avait encore revendiqué.
L’intérêt d’un précédent est de donner une attente, pas une prédiction. Il vous dit que la revendication peut prendre plusieurs semaines, et que pendant ce temps la taille du modèle, sa source et la durée de la gratuité restent inconnues : votre solution ne doit pas dépendre de ces inconnues.
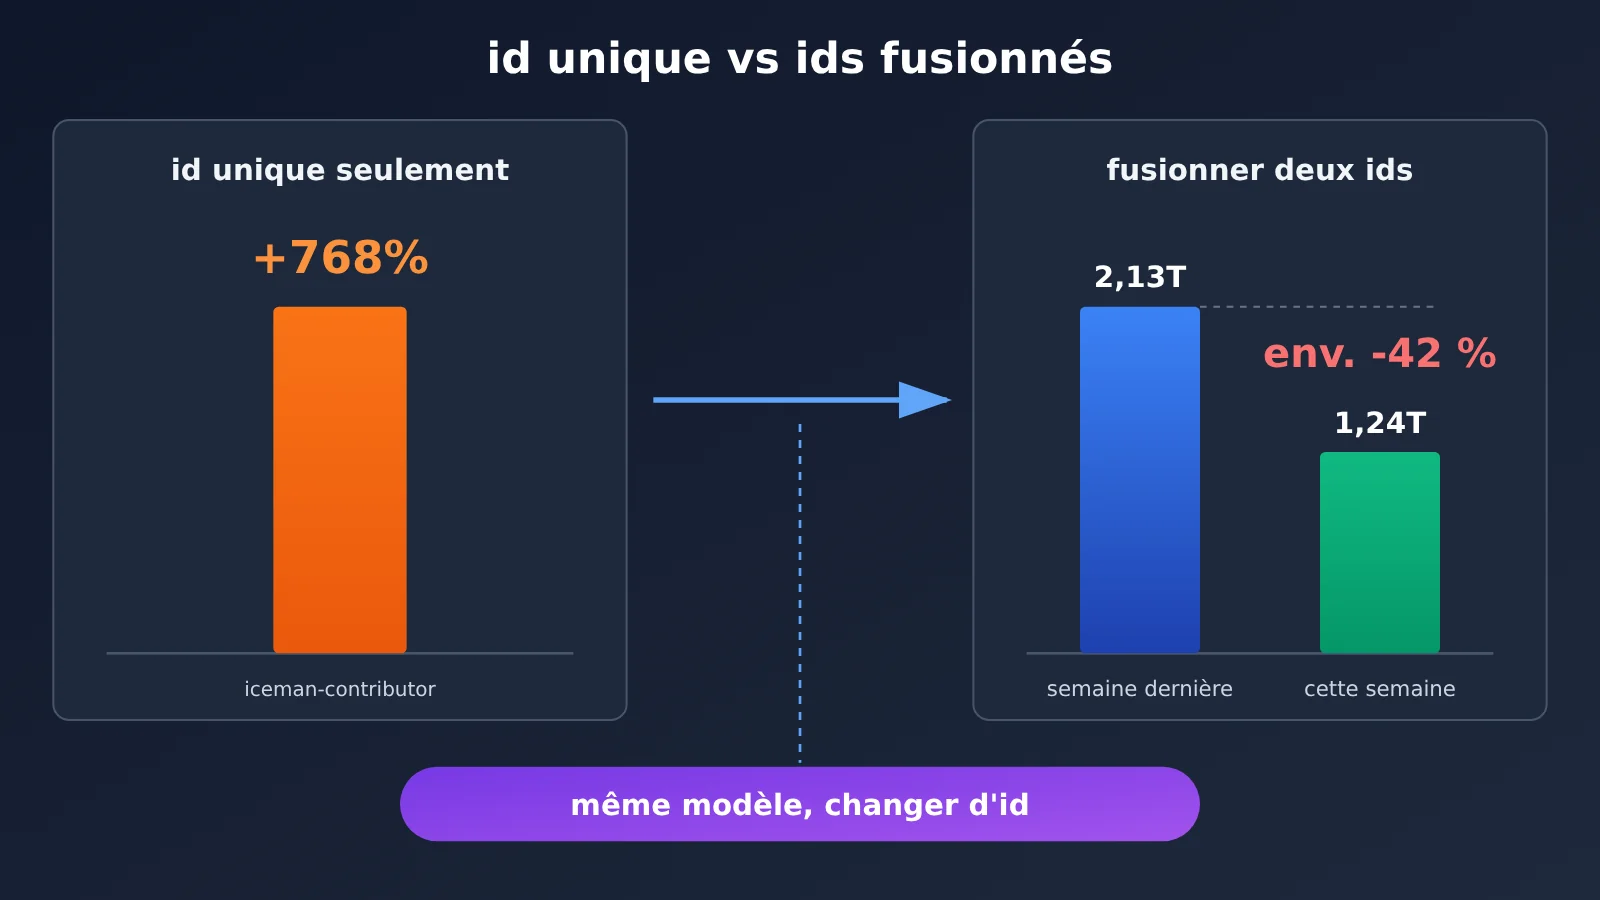
Iceman dans le classement hebdomadaire d’OpenCode est un cas d’école de mauvaise lecture des classements. Si vous ne regardez qu’un seul id, vous concluez à une « croissance explosive » ; en additionnant les deux id, la conclusion s’inverse.
| id | Rang hebdo | Tokens cette semaine | Variation sur une semaine |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| Total | — | ≈ 1 240 milliards | ≈ -42 % (≈ 2 130 milliards la semaine précédente) |
Le +768 % ne traduit pas une croissance : c’est le trafic d’un même modèle qui a migré d’un id vers l’autre. Les deux id cumulés ont traité environ 1 240 milliards de tokens sur les 7 derniers jours, contre environ 2 130 milliards la semaine précédente, soit une baisse d’environ 42 %. L’usage quotidien a culminé le 28 octobre à environ 653 milliards de tokens, puis est resté entre 162 et 251 milliards par jour du 29 octobre au 3 novembre.
Exemple minimal : fusionner les id pour calculer la vraie variation hebdomadaire
Le bout de code Python ci-dessous illustre la logique de fusion ; les données sont celles publiées et citées plus haut. Les valeurs de chaque id pour la semaine dernière sont reconstituées à partir des valeurs de cette semaine et de la variation hebdomadaire : ce sont donc des approximations.
# Plusieurs id d'un même modèle : tokens de cette semaine (en milliards) et variation hebdomadaire
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# Reconstitution de la valeur de la semaine dernière à partir de la variation : last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
À l’exécution, on obtient environ 1 237B pour cette semaine, de l’ordre de 2 100B pour la semaine dernière, et une variation hebdomadaire combinée d’environ -41 % à -42 %, ce qui correspond globalement aux totaux annoncés dans les articles. La reconstitution introduit des erreurs d’arrondi : dans une analyse réelle, il faut lire directement les données hebdomadaires brutes de chaque id.
Voir l’implémentation complète : le portail de stratégie de modèle avant intégration
Le code ci-dessous transforme la liste de vérification en un « portail de stratégie » tout simple. Il n’appelle l’interface d’aucune plateforme en particulier : il se contente de décider, à partir des métadonnées que vous avez saisies après vérification manuelle, si un type de données donné peut être envoyé à tel ou tel modèle. Vous pouvez le placer en amont de votre propre couche de routage des requêtes.
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # point de contrôle 1
    zero_data_retention: bool        # point de contrôle 2
    free_until: Optional[str]        # point de contrôle 3, None signifie que l'échéance est inconnue
    lab_confirmed: bool              # point de contrôle 4
    related_ids: tuple = ()          # point de contrôle 5, pour regrouper les statistiques

# Niveau de sensibilité des données : 0 public, 1 anonymisé/synthétique, 2 code privé, 3 clé ou données personnelles
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """Renvoie le niveau de sensibilité maximal autorisé selon les conditions du modèle"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # entraînement ou rétention non nulle : seules les données publiques et synthétiques sont autorisées
    if not p.lab_confirmed:
        return 1          # source non revendiquée : là aussi, uniquement des données peu sensibles
    return 2              # ce n'est qu'une fois les conditions et l'attribution confirmées que le code privé entre en jeu

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # les clés et données personnelles ne partent jamais vers un canal externe gratuit
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """Renvoie la liste des problèmes qui bloquent la mise en production ; une liste vide signifie que l'évaluation peut démarrer"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("非零数据保留")
    if p.free_until is None:
        issues.append("免费期限未知,存在突然收费或下线风险")
    if not p.lab_confirmed:
        issues.append("来源未认领,无法评估模型规模与长期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
Conseil pratique : traitez les métadonnées ci-dessus comme une configuration partagée par toute l’équipe, et mettez-les à jour à chaque évolution des conditions d’une plateforme ou du statut d’attribution d’un modèle. Ainsi, un nouveau collègue qui branche n’importe quel modèle gratuit peut réutiliser directement les mêmes critères de décision, au lieu de trancher au feeling.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’un modèle furtif gratuit ?
Un modèle furtif (stealth model) est un modèle mis en ligne sur la plateforme sous un nom de code, dont l’identité du laboratoire n’est pas encore divulguée. La page d’utilisation de la plateforme affiche généralement sa source comme Unknown. Iceman fait partie de la liste des modèles furtifs d’OpenCode et, au 4 novembre 2026, il n’avait toujours pas été revendiqué.
Q2 : Quelle est la différence entre Iceman et iceman-contributor ?
D’après les données publiques, ce sont deux identifiants utilisés par OpenCode pour suivre un même modèle dans son classement d’utilisation. Dans le classement hebdomadaire, l’un s’envole pendant que l’autre s’effondre : en réalité, le trafic se déplace d’un identifiant à l’autre. Le terme Contributor renvoie au modèle d’échange de la plateforme — « des données d’entraînement contre un accès gratuit » — et non au nom d’un laboratoire.
Q3 : Combien de temps durera la période de gratuité d’Iceman ?
Aucune réponse publique pour l’instant. L’annonce d’OpenCode indique seulement « gratuit pour une durée limitée, sans limite de requêtes », sans préciser de date de fin. La taille du modèle, son développeur et la durée de la gratuité font partie des informations encore inconnues : mieux vaut donc ne pas faire dépendre un projet de production de son statut gratuit.
Q4 : Quels sont les cas d’usage les plus adaptés à un modèle furtif gratuit ?
À condition que les conditions d’utilisation précisent bien « usage pour l’entraînement, rétention non nulle », les scénarios les plus pertinents sont notamment :
– **Expérimentation sur des projets open source** : traiter du code déjà public, par exemple écrire des exemples ou des tests pour une bibliothèque open source.
– **Évaluation des capacités** : tester son raisonnement et son usage des outils avec des questions synthétiques, pour comprendre son comportement sur de grands contextes.
– **Prototypes personnels d’apprentissage** : monter une démo sans données réelles pour vérifier que le parcours d’interaction tient la route.
Q5 : Comment mettre en place cette checklist de vérification des modèles furtifs dans une équipe ?
Je suggère trois étapes : commencer par inscrire les 5 points de vérification dans le document d’admission des modèles, puis filtrer au niveau de la couche de routage selon le niveau de sensibilité des données, comme avec le garde-fou de politique décrit plus haut, et enfin configurer un espace de travail dédié pour les outils de programmation, afin d’éviter que l’agent embarque automatiquement des fichiers privés. Il suffit de mettre à jour les métadonnées quand les conditions changent.
Q6 : Le modèle affirme être le produit de telle entreprise : peut-on le croire ?
Pas directement. L’auto-présentation d’un modèle peut venir de son corpus d’entraînement ou du prompt système, et la méthode de comptage des tokens peut être parfaitement identique d’un modèle à l’autre. Prenons Iceman : des tests tiers ont montré que son comptage correspondait aussi bien à MAI Thinking 1 qu’à la série GPT-6, impossible de trancher sur cette base. Seule la revendication officielle du laboratoire fait foi.
Q7 : Si un modèle furtif est revendiqué plus tard, qu’advient-il des données envoyées auparavant ?
La revendication ne change que l’information sur l’origine du modèle, pas les conditions applicables au moment où vous avez envoyé vos données. Si ces conditions indiquaient un usage pour l’entraînement avec rétention non nulle, le traitement de ces données était déjà fixé. C’est précisément pour cela que la vérification doit se faire avant l’envoi, et non après la revendication.
Points clés du modèle furtif gratuit
- Les conditions d’abord, les paramètres ensuite : l’usage pour l’entraînement et la conservation des données déterminent ce que vous pouvez envoyer ; la longueur de contexte ne détermine que la quantité.
- « Contributor » est un mode d’échange : il signifie qu’on échange des données d’entraînement contre un accès gratuit, pas qu’il indique l’origine du modèle.
- Un indice n’est pas une confirmation : l’identité que le modèle revendique et le décompte de tokens ne prouvent rien quant à son appartenance.
- Traiter la durée de gratuité comme inconnue : « durée limitée » n’a pas de date de fin, ne bâtissez pas votre projet dessus.
- Lire les classements en fusionnant les id : le +768 % d’Iceman devient en réalité environ -42 % une fois les id fusionnés.
- Isoler systématiquement les données sensibles : clés, données privées et code propriétaire ne partent jamais vers les canaux d’entraînement.
Conclusion
Un modèle furtif gratuit peut-il être intégré à un projet ? La réponse dépend des données que vous comptez envoyer, pas du fait qu’il soit gratuit. Avec Iceman, ce qui peut servir de base, ce sont les conditions de la plateforme et les paramètres du catalogue : usage pour l’entraînement, conservation des données non nulle, gratuité limitée dans le temps, contexte de 262 144, prise en charge du raisonnement et de l’appel d’outils. Ce qui ne peut pas servir de base, ce sont les indices sur le développeur : tant que personne ne l’a officiellement revendiqué, ce ne sont que des rumeurs.
La méthode de vérification réutilisable tient en trois points :
- Lire l’information en couches : séparer les déclarations de la plateforme, les paramètres du catalogue et les indices non confirmés, et ne décider qu’à partir des deux premières couches.
- Utiliser selon le niveau de sensibilité des données : les canaux de type entraînement ne traitent que des données publiques ou synthétiques ; le code privé et les données personnelles passent par un autre circuit.
- Lire les classements à périmètre constant : pour un même modèle, il faut additionner les différents id avant de calculer un taux de croissance, sinon on se laisse tromper par une fausse progression due à un changement d’id.
Peu importe qui revendiquera Iceman par la suite, cette méthode de vérification restera utilisable pour le prochain modèle furtif qui apparaîtra.
📚 Sources et références
- ArtificialWatch – Analyse de l’usage et de l’attribution d’Iceman : source principale des faits rapportés dans cet article
- Lien :
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
Description : synthèse de l’usage du double id d’Iceman, des modifications de conditions et des indices d’attribution, publiée le 2026-11-04
-
Page d’usage OpenCode Data : données d’usage de iceman et iceman-contributor
- Lien :
opencode.ai/data -
Description : permet de consulter directement le classement hebdomadaire et la consommation de tokens de chaque id
-
Catalogue de modèles models.dev : paramètres techniques d’Iceman
- Lien :
models.dev -
Description : fournit les informations de catalogue telles que la fenêtre de contexte, la sortie maximale, le raisonnement et l’appel d’outils
-
Suivi des modèles furtifs stealthmodels.com : source des signalements d’indices d’attribution
- Lien :
stealthmodels.com - Description : consigne les tests portant sur l’identité revendiquée d’Iceman et le comptage des tokens, à titre indicatif uniquement
Auteur : équipe technique APIYI
Remarque : les faits de cet article sont à jour au 2026-11-04 ; le statut de revendication et la durée de gratuité d’Iceman peuvent changer à tout moment, veuillez vous référer aux dernières conditions de la plateforme.