Réponse directe : avec GPT-6.2 Astra, les pages web sont peut-être plus belles, mais les supports de lancement officiels et les cas de démonstration ne font qu’envoyer des signaux positifs. Ils ne remplacent pas encore la validation sur votre propre projet. OpenAI a publié GPT-6.2 Astra/Sol le 17 novembre 2026. La page de lancement affirme que le modèle est plus intentionnel dans la mise en page et la sélection des images. Le cas officiel Paris Atlas montre aussi sa capacité à transformer un repère Blender en scène interactive Three.js. Ce sont autant de signaux d’amélioration des capacités visuelles et interactives. Cela dit, une démonstration officielle ne garantit pas qu’à besoin identique le nouveau modèle battra l’ancien, ni qu’une seule invite suffira à produire un site web prêt à livrer. Précisons-le : cet article ne rapporte pas nos propres tests, et il ne contient aucune donnée de benchmark, de temps d’exécution ou de score provenant de notre équipe.
Que vous apportera la lecture de cet article ?
- Ce que disent la page de lancement de GPT-6.2 Astra et la démonstration officielle Paris Atlas, et ce qui relève de la communication officielle.
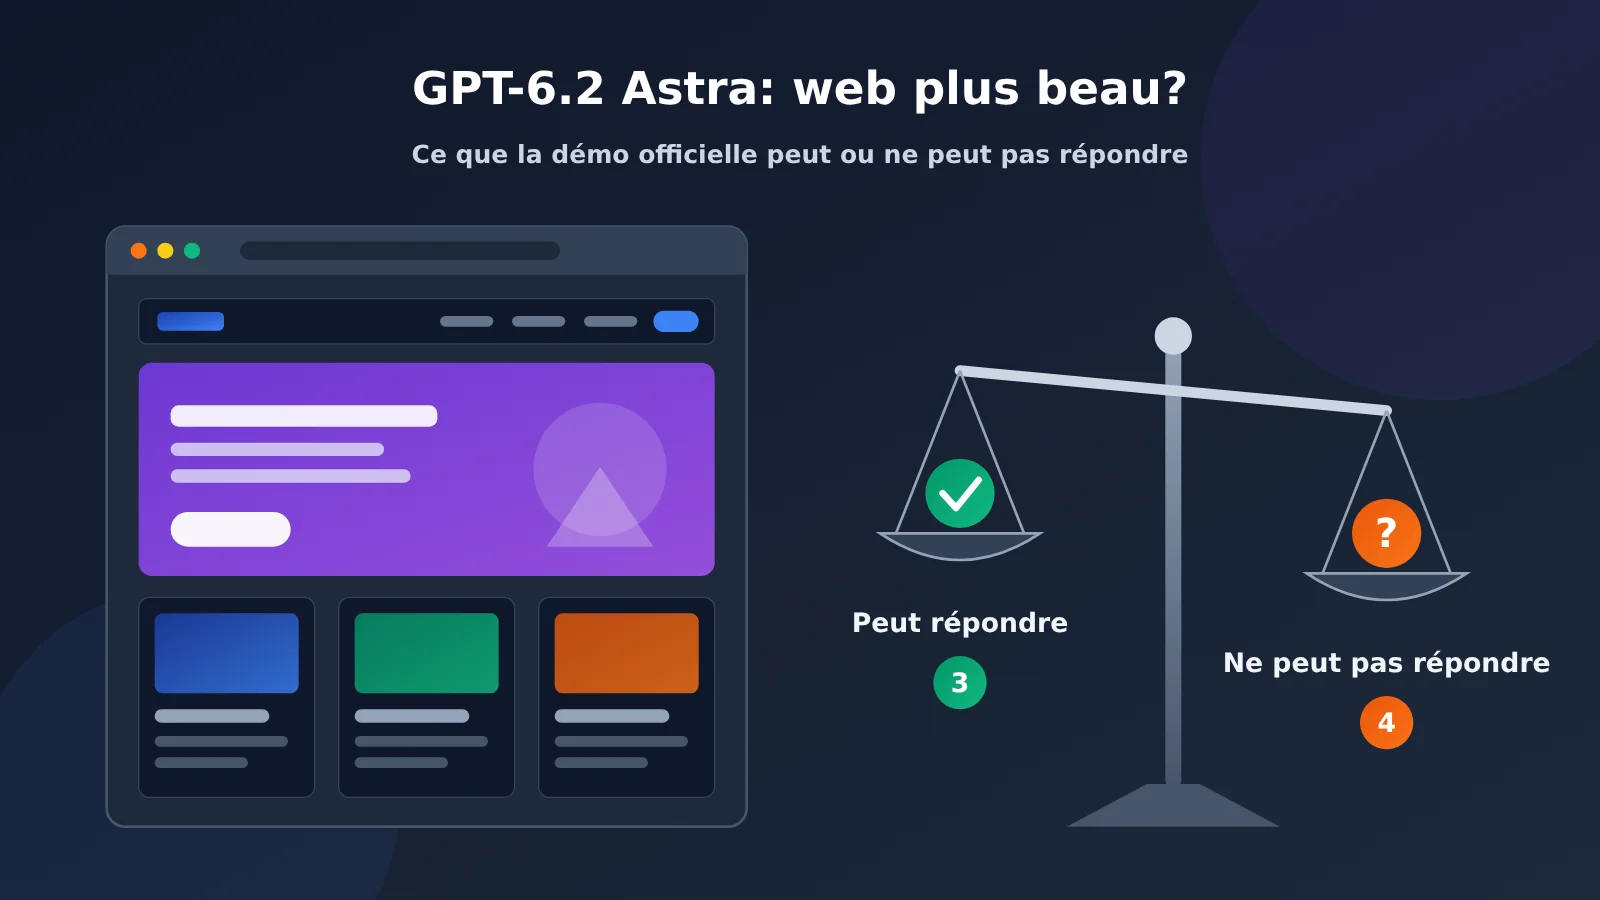
- Les 3 choses auxquelles une démonstration officielle peut répondre, et les 4 auxquelles elle ne peut pas répondre.
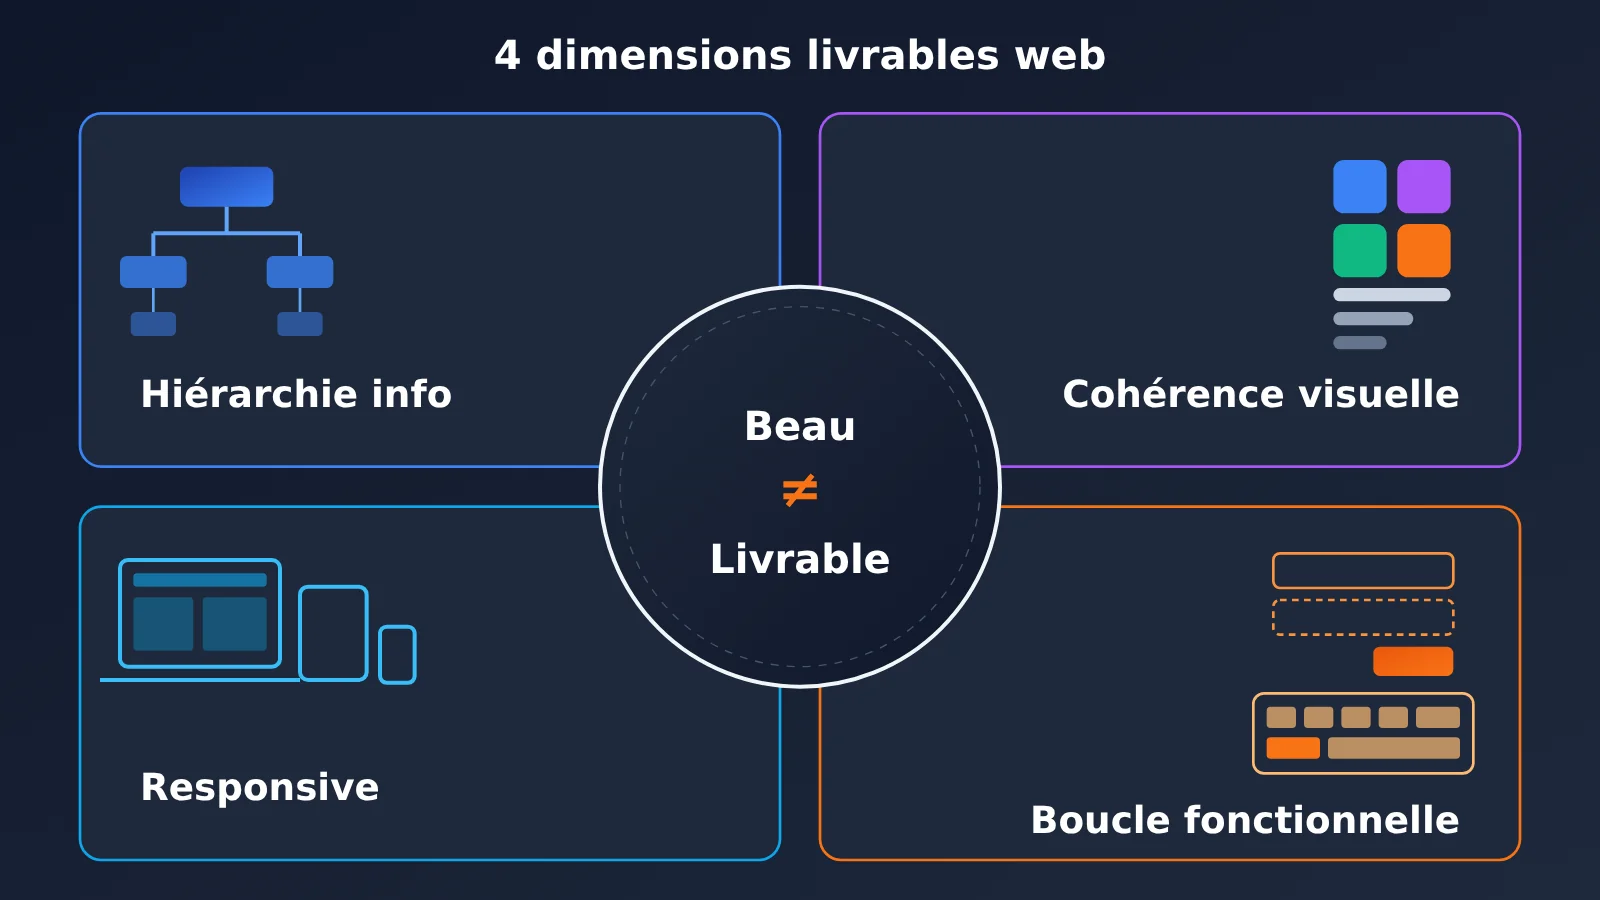
- Comment considérer la question « la page web est-elle plus jolie ? » selon quatre dimensions : hiérarchie de l’information, cohérence visuelle, responsive et boucle fonctionnelle complète.
- Un protocole de comparaison entre ancien et nouveau modèle, directement applicable, ainsi qu’un modèle d’invite pour « d’abord l’architecture de l’information, ensuite l’implémentation », afin de juger si les résultats peuvent servir à une livraison réelle.
Sommaire : La première partie rassemble les faits objectifs : informations de lancement, modalités d’entrée et de sortie du modèle, et contenu de la démonstration Paris Atlas. La deuxième partie relève du jugement éditorial : nous y décomposons d’abord une à une les limites de preuve des présentations officielles, puis nous analysons la qualité des pages web selon quatre dimensions, avant de proposer un protocole de comparaison à conditions égales et un modèle de compte rendu pour vous aider à déterminer si les résultats peuvent être utilisés pour une livraison réelle. Si vous voulez seulement passer à la vérification pratique, allez directement en 2.4.
Concepts à connaître autour de GPT-6.2 Astra
| Concept | Brève explication |
|---|---|
| GPT-6.2 Astra / Sol | Nom du modèle publié par OpenAI le 17 novembre 2026 ; cet article se concentre sur les signaux de performance d’Astra dans les cas d’usage web |
| Showcase (démonstration officielle) | Cas choisis et publiés par l’éditeur pour mettre en avant certains résultats ; cela ne vaut pas une évaluation indépendante |
| Paris Atlas | Cas de démonstration officiel du site développeur d’OpenAI : un repère Blender converti en Three.js pour créer une expérience de marche et de conduite à Paris |
| Blender | Logiciel de modélisation 3D open source, souvent utilisé pour produire des assets de modèles |
| Three.js | Bibliothèque JavaScript de rendu 3D dans le navigateur, basée sur WebGL |
| Architecture de l’information (IA) | La façon dont le contenu du site est organisé : quelles pages, quels modules, quelle hiérarchie et quels chemins de navigation |
| Responsive | La page reste correctement mise en page et utilisable sur différentes largeurs d’écran : mobile, tablette, bureau |
| Boucle fonctionnelle complète | Les boutons, formulaires, redirections, raccourcis clavier et autres interactions fonctionnent vraiment, et pas seulement « pour de faux » |
| Évaluation à l’aveugle | Les évaluateurs notent les résultats sans savoir d’où ils viennent, afin de limiter les biais de marque |
GPT-6.2 Astra : aperçu des impacts
- Développeurs front-end : les signaux officiels méritent l’attention, mais comparez à conditions égales avec les besoins de votre propre projet avant de décider de changer de modèle par défaut.
- Concepteurs web : si les gains sur la mise en page et la sélection des images se confirment, la qualité des premières ébauches pourrait se rapprocher davantage de l’intention de design, mais la cohérence de marque demande toujours une validation humaine.
- Responsables techniques / décideurs d’achat : cet article n’a pas fait l’objet d’une reproduction indépendante ; il ne faut pas modifier les workflows de l’équipe ou le budget sur la seule base de cas sélectionnés.
- Utilisateurs grand public de Chat : les sources de référence rappellent qu’il faut distinguer les environnements d’usage Work, Codex, API et Chat classique ; le workflow montré dans les démos officielles ne revient pas à obtenir un site web en une seule phrase dans la fenêtre de discussion.
1. GPT-6.2 Astra : les faits objectifs, ce qui a été officiellement publié
1.1 Aperçu des informations clés sur GPT-6.2 Astra
| Élément d’information | Détails | Nature de l’information |
|---|---|---|
| Date de publication | 2026-11-17 | Publication officielle |
| Émetteur | OpenAI | Publication officielle |
| Contenu de la publication | GPT-6.2 Astra et GPT-6.2 Sol | Publication officielle |
| Description liée à la page web | Une mise en page et un choix d’images plus intentionnels | Formulation promotionnelle officielle |
| Entrées et sorties | Entrée texte/image, sortie texte ; peut produire du code, avec des outils pour l’exécuter et le valider | Information officielle |
| Environnement d’utilisation | Déployé cette fois-ci dans Work, Codex et l’API, mais pas dans le Chat standard | Information officielle |
| Cas représentatif | Paris Atlas (Showcase du site développeur) | Démonstration officielle |
| Date de vérification de cet article | 2026-11-18 | Vérification éditoriale |
Dans le tableau ci-dessus, deux catégories d’informations méritent une attention particulière : les « formulations promotionnelles officielles » et les « démonstrations officielles ». Elles proviennent d’OpenAI lui-même et reflètent la direction des capacités que le fournisseur souhaite mettre en avant, et non des conclusions obtenues par un tiers dans des conditions uniformes.
La page de publication officielle rapporte également une évaluation à l’aveugle de l’expérience interactive AA-3D : Astra obtient 1318 Elo, Sol 1259 Elo. Cela apporte un signal d’évaluation qui va au-delà d’un simple cas de démonstration, mais ne garantit en rien la qualité d’un site d’entreprise, le taux de réussite en une seule génération ni la fiabilité en production. Cet article cite le rapport officiel sans reproduire cette évaluation. Source : notes de publication OpenAI
1.2 Les modes d’entrée et de sortie de GPT-6.2 Astra
D’après les informations officielles, GPT-6.2 Astra accepte du texte et des images en entrée, et produit du texte en sortie. Le code d’une page web n’est lui aussi, au fond, que du texte : c’est via une chaîne d’outils qu’il est écrit dans des fichiers, exécuté puis prévisualisé. Autrement dit, l’expérience complète « le modèle fabrique une page web » dépend de l’environnement : celui-ci fournit-il ou non des outils de lecture/écriture de fichiers, d’exécution de code et de prévisualisation ?
Ce point est essentiel pour comprendre les démos officielles. Dans un environnement Work, Codex, ou API accompagnée d’outils, le modèle peut produire en plusieurs étapes, modifier et assembler un projet ; la mise en ligne de cette vague ne couvre pas le Chat standard, et l’on ne peut donc pas en déduire que la conversation classique dispose du même modèle. Quand on discute de « la beauté d’une page web générée », il faut donc d’abord préciser dans quel environnement la conclusion a été tirée.
1.3 Ce que montre la démo officielle Paris Atlas
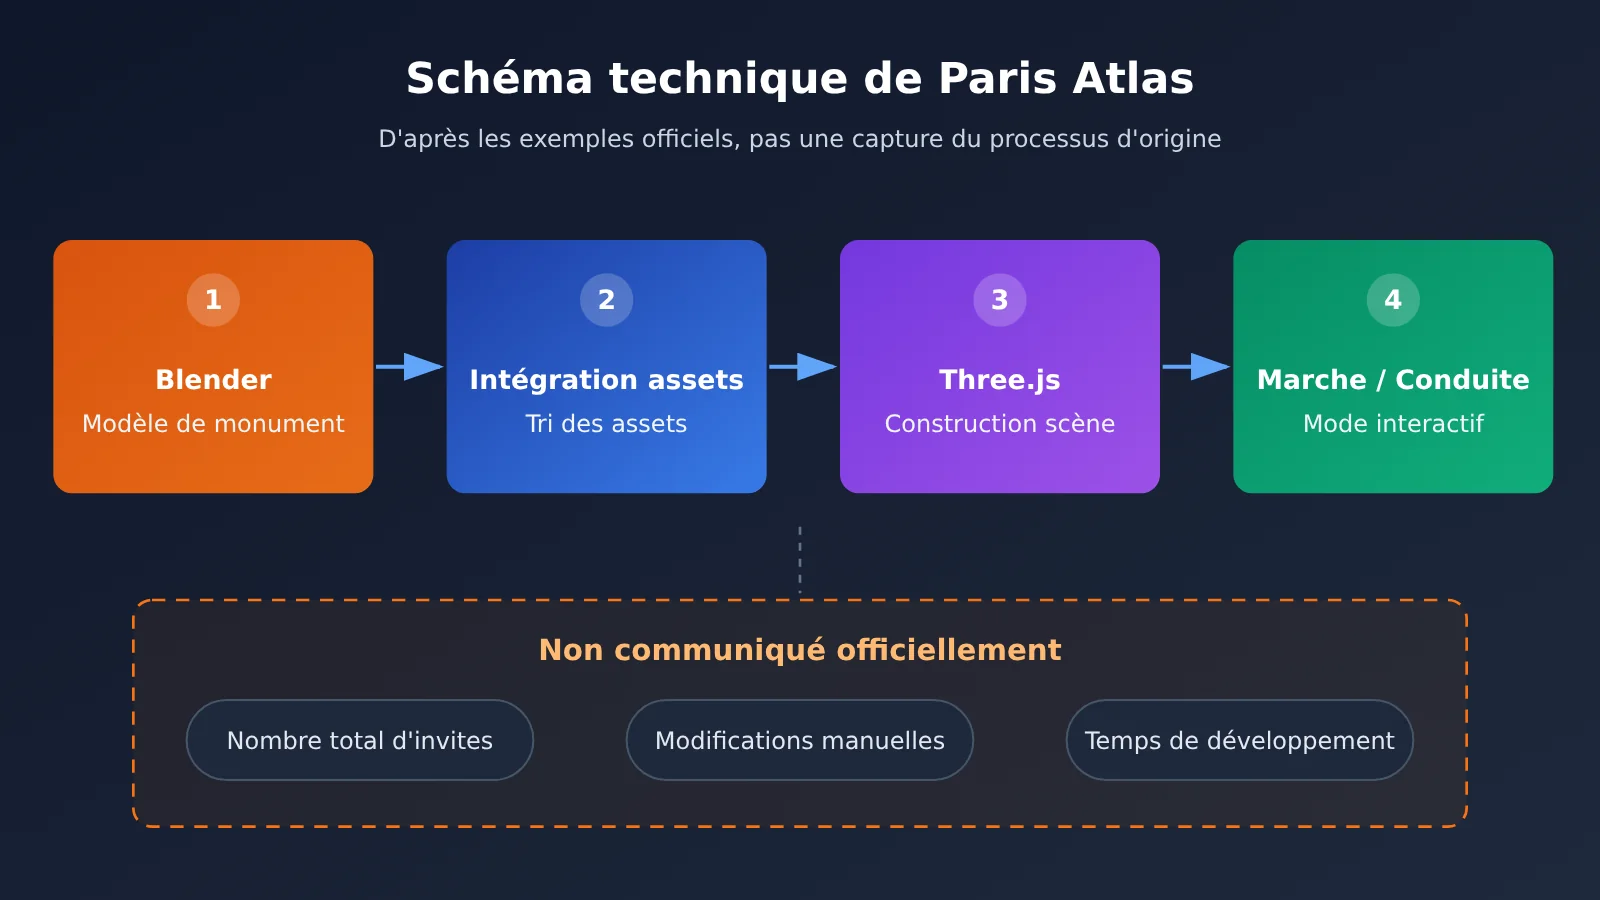
Paris Atlas est un cas de démonstration officiel publié sur le site développeur d’OpenAI. D’après la description officielle, il convertit des modèles de monuments parisiens réalisés dans Blender en une scène Three.js, et construit une expérience interactive permettant de se promener et de conduire dans Paris.
Du point de vue technique, ce cas implique la conversion de formats d’assets 3D, le rendu côté navigateur, le contrôle de caméra et la logique d’interaction — une complexité nettement supérieure à celle d’une page vitrine classique. Il montre que, avec les bons outils et le bon processus, le modèle peut participer à la réalisation de ce type de projet d’interaction visuelle. Le cas officiel Paris Atlas liste plusieurs étapes de construction, de la première version de la ville jusqu’aux corrections des monuments et des devantures, ce qui confirme qu’il s’agit d’un processus itératif ; la page ne donne ni le nombre total de tours d’invite, ni le volume total de retouches humaines, ni le temps de développement total, et cet article ne fabrique pas ces données.
2. Analyse et jugement : la valeur et la méthode de vérification de la démonstration officielle de GPT-6.2 Astra
Nous entrons maintenant dans la partie consacrée au jugement éditorial. Chaque jugement correspond aux faits exposés plus haut ; les éléments qui vont au-delà des faits seront clairement indiqués.
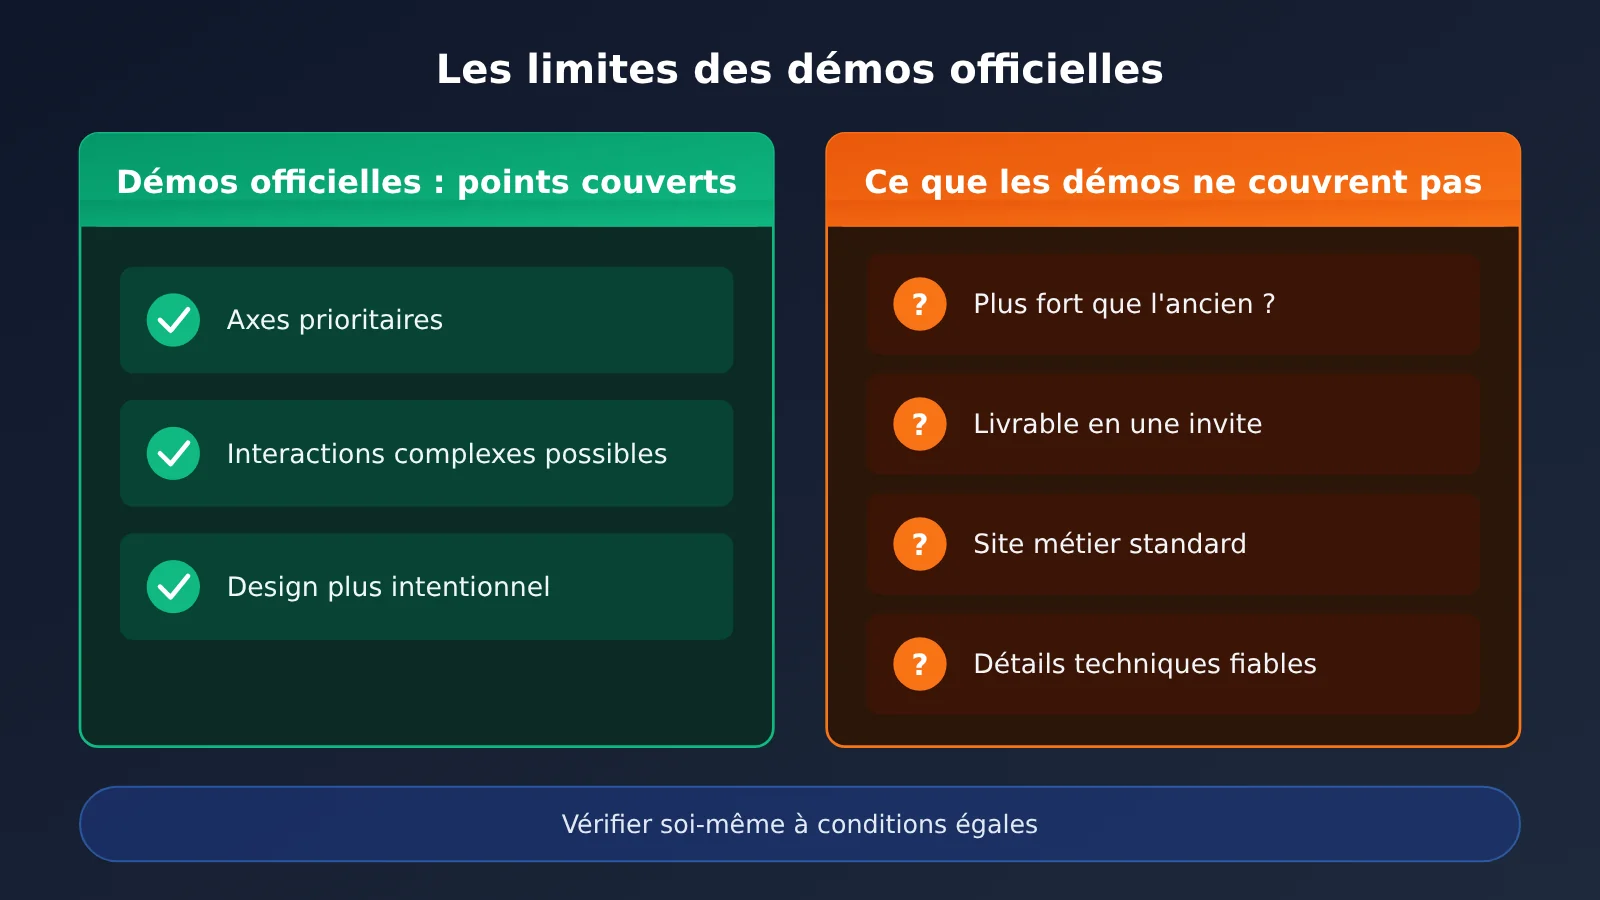
2.1 Les 3 points sur lesquels la démonstration officielle apporte des réponses
- OpenAI place le visuel et l’interaction web parmi ses priorités. La page de lancement mentionne spécifiquement la mise en page et le choix des images, ce qui montre que l’équipe officielle considère qu’il s’agit là d’un progrès qui mérite d’être mis en avant.
- Grâce à la chaîne d’outils, le modèle peut participer à des projets web 3D interactifs complexes. Paris Atlas implique une conversion de Blender vers Three.js ainsi que la construction d’interactions, et un cas concret de réalisation finalisée est déjà fourni.
- « Des choix de conception plus intentionnels » constituent la direction d’amélioration indiquée par l’équipe officielle. Cela nous rappelle que, lors de l’évaluation, il ne faut pas se limiter à la palette de couleurs : il faut regarder si la mise en page et les images servent les objectifs du contenu.
2.2 Les 4 choses auxquelles la démo officielle ne peut pas répondre
| Question | La démo officielle peut-elle y répondre ? | Raison |
|---|---|---|
| À besoin identique, Astra bat-il forcément l’ancienne version ? | Non | Ce cas sélectionné ne propose pas de comparaison contrôlée entre l’ancien et le nouveau modèle sur un même besoin |
| Une seule invite suffit-elle à produire un site livrable ? | Non | La démo montre une itération en plusieurs étapes, mais ne précise ni le nombre total de tours d’invite ni le volume global d’intervention humaine |
| Les sites d’entreprise ordinaires et les sites e-commerce sont-ils eux aussi meilleurs ? | Non | Les besoins d’une démo d’interaction 3D et ceux d’un site métier classique sont très différents |
| Le responsive, l’accessibilité, les formulaires, etc. sont-ils fiables ? | Non | La démo met l’accent sur l’expérience visuelle et ne montre pas la validation de ce type de détails d’ingénierie |
Ces quatre questions sont justement ce qui pèse le plus au moment de la livraison réelle. La démo officielle est un « échantillon de résultats triés sur le volet », alors qu’en projet, on fait face à « la performance moyenne et le taux d’échec » : entre les deux, il y a une comparaison indépendante à mener.
2.3 Les quatre dimensions d’analyse de la qualité des pages web de GPT-6.2 Astra
« Beau » est un mot flou. Pour rendre le jugement vérifiable, nous le décomposons en quatre dimensions. Ces dimensions constituent le cadre d’analyse proposé dans cet article, et non des indicateurs officiels.
2.3.1 Hiérarchie de l’information : le contenu est-il bien organisé ?
Une belle page web est d’abord une page « facile à lire ». La capacité de l’utilisateur à comprendre en quelques secondes ce dont il s’agit, ce qu’il peut faire et où cliquer ensuite dépend de la relation hiérarchique entre le titre, le corps du texte et les boutons d’action. La « mise en page plus intentionnelle » évoquée officiellement, si elle se vérifie, devrait avant tout se manifester ici.
Paris Atlas, en tant qu’expérience 3D immersive, n’a pas les mêmes exigences de hiérarchie de l’information qu’un site classique. Il peut montrer la puissance visuelle, mais il est difficile de juger, à partir de là, comment le modèle organise la hiérarchie sur des pages riches en contenu.
2.3.2 Cohérence visuelle : plusieurs pages ressemblent-elles à une même marque ?
Une page unique qui impressionne, ce n’est pas difficile ; le difficile, c’est que plusieurs pages restent cohérentes en taille de police, espacement, couleurs et styles de composants. Dans un projet réel, la stabilité du design system pèse souvent davantage sur la qualité de livraison que l’effet d’un seul écran. Pour évaluer, il faut générer au moins deux ou trois pages liées entre elles et observer si elles partagent le même ensemble de règles.
2.3.3 Responsive : l’interface reste-t-elle utilisable sur écran étroit ?
Beaucoup de pages générées sont correctes sur une largeur bureau, mais dès qu’on passe au mobile, le texte déborde, les boutons se chevauchent ou un défilement horizontal apparaît. Les instructions de construction de Paris Atlas consultées dans cet article ne suffisent pas à vérifier l’adaptation à vos appareils cibles ; il faut encore faire ses propres vérifications. Je recommande de couvrir au moins trois largeurs : mobile, tablette et bureau.
2.3.4 Boucle fonctionnelle : « ça a l’air de marcher » ou « ça marche vraiment »
Les boutons déclenchent-ils réellement des actions, les formulaires ont-ils une validation et des messages d’erreur, la touche Tab du clavier permet-elle de parcourir les éléments dans l’ordre, l’état de focus est-il visible ? Tout cela relève de la boucle fonctionnelle, et c’est précisément ce qu’une capture d’écran ne pourra jamais prouver. Pour les équipes qui conçoivent des sites, cette dimension détermine souvent le volume de reprises ultérieures.
| Dimension | Points de contrôle | Méthode de test adaptée | Couverture dans la démo officielle |
|---|---|---|---|
| Hiérarchie de l’information | Priorité entre titre, corps de texte et boutons d’action | Évaluation à l’aveugle de captures + test de compréhension en cinq secondes | Indirecte (description textuelle sur la page de lancement) |
| Cohérence visuelle | Tailles de police, espacements, composants d’une page à l’autre | Évaluation à l’aveugle de plusieurs pages côte à côte | Non montrée directement |
| Responsive | Mise en page mobile/tablette/bureau | Captures aux trois largeurs | Non montrée directement |
| Boucle fonctionnelle | Boutons, formulaires, navigation au clavier | Test manuel point par point | Partielle (interactions 3D opérationnelles) |
2.4 Protocole de comparaison web pour GPT-6.2 Astra : comment vérifier par vous-même
Pour savoir si votre propre projet en tire profit, la méthode la plus fiable consiste à réaliser une comparaison contrôlée sur vos propres besoins. Le protocole ci-dessous est une méthode originale mise au point pour cet article, que vous pouvez réutiliser directement. Nous ne l’avons pas utilisé pour obtenir des résultats : les colonnes de données du tableau sont à remplir par vous-même.
2.4.1 Les trois conditions de contrôle d’une comparaison GPT-6.2 Astra
- Même besoin, mêmes ressources, même budget. Les deux modèles reçoivent exactement le même document de besoins, les mêmes images et la même charte de marque ; on uniformise les permissions d’outils, l’environnement d’exécution et une intensité de raisonnement comparable, et on convient à l’avance d’un nombre maximal d’itérations ou d’un plafond de coût. Un même nombre de tokens ne signifie pas un même coût.
- Enregistrer le coût du processus. Notez fidèlement combien de révisions chaque modèle a nécessitées entre la première version et le statut « livrable », et combien de minutes d’intervention humaine ont été nécessaires.
- Évaluation à l’aveugle et tests réels. Retirez l’identification du modèle sur les captures d’écran avant de les soumettre à l’évaluation ; en parallèle, testez manuellement, élément par élément, les boutons, les formulaires et la navigation au clavier.
Ces trois conditions sont indispensables. Comparer uniquement la capture d’écran du premier écran conduit à surestimer une version esthétique mais dépourvue de fonctionnalités ; comparer uniquement le nombre de révisions fait ignorer l’écart de qualité du résultat final.
2.4.2 Modèle d’invite : d’abord l’architecture de l’information, ensuite l’implémentation
Pour rendre la comparaison plus équitable, il est conseillé de diviser l’invite en deux phases. La première phase demande au modèle de produire uniquement l’architecture de l’information ; la deuxième phase génère le code à partir de l’architecture validée. Cela permet d’observer si le modèle organise réellement le contenu « dans un but précis », plutôt que d’empiler directement de beaux composants.
【Phase 1 : architecture de l'information】
Vous êtes architecte de l'information d'un site web. À partir du besoin ci-dessous, produisez uniquement l'architecture de l'information, sans écrire de code :
1. Liste des pages et objectif de chaque page
2. Ordre des modules et hiérarchie de l'information sur chaque page (H1/H2/corps/bouton d'action)
3. Parcours de navigation et interactions clés
4. Contenus nécessaires mais absents des ressources, à signaler par 【à fournir】, sans inventer de données, d'avis ou de cas clients

Besoin : {coller le document de besoins}
Ressources : {lister les images et les textes}

【Phase 2 : implémentation】
Générez le code de la page web à partir de l'architecture de l'information validée, avec les exigences suivantes :
- règles de conception uniformes (taille de police, espacements, variables de couleur)
- prise en charge de trois largeurs : 375px / 768px / 1440px
- tous les boutons et formulaires fonctionnels, formulaires avec validation et messages d'erreur, navigation au clavier Tab prise en charge
- conserver le placeholder 【à fournir】 pour les contenus manquants, ne pas insérer de résultats inventés
Dans le modèle, la consigne « ne pas inventer de données, d’avis ou de cas clients » est importante. Lors de la génération d’une page web, le modèle a tendance à ajouter de faux avis d’utilisateurs ou des chiffres de performance ; une fois mis en ligne, c’est une erreur factuelle.
2.4.3 Appeler les anciens et nouveaux modèles via une interface unifiée
Lors d’une comparaison, appeler les deux modèles avec le même code réduit le nombre de variables. Voici l’exemple d’appel le plus simple ; le nom du modèle doit être pris dans la liste réelle du tableau de bord de la plateforme utilisée. Cet article ne présume pas qu’un modèle donné soit déjà disponible sur une plateforme.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI - interface unifiée, compatible OpenAI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_ID",  # se référer à la liste des modèles du tableau de bord
    messages=[{"role": "user", "content": "按阶段一输出信息架构:……"}]
)
print(resp.choices[0].message.content)
Afficher le script de comparaison complet (deux phases + archivage des résultats)
import json, time, pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Passer d'un modèle à l'autre avec le même code via APIYI
)

MODELS = ["OLD_MODEL_ID", "NEW_MODEL_ID"]  # Se baser sur les noms réellement disponibles dans la console
STAGE1 = open("prompt_stage1.txt", encoding="utf-8").read()
STAGE2 = open("prompt_stage2.txt", encoding="utf-8").read()
OUT = pathlib.Path("compare_runs")
OUT.mkdir(exist_ok=True)

def ask(model, messages):
    r = client.chat.completions.create(model=model, messages=messages)
    return r.choices[0].message.content

for i, model in enumerate(MODELS):
    tag = f"sample_{chr(65 + i)}"  # Utiliser des codes A/B pour faciliter l'évaluation à l'aveugle
    msgs = [{"role": "user", "content": STAGE1}]
    ia = ask(model, msgs)
    msgs += [{"role": "assistant", "content": ia},
             {"role": "user", "content": STAGE2}]
    code = ask(model, msgs)
    (OUT / f"{tag}_ia.md").write_text(ia, encoding="utf-8")
    (OUT / f"{tag}_code.md").write_text(code, encoding="utf-8")
    # Enregistrer uniquement les métadonnées ; le nombre de modifications et le temps manuel sont complétés par le testeur
    meta = {"tag": tag, "model": model, "time": time.strftime("%F %T"),
            "revisions": None, "manual_minutes": None}
    (OUT / f"{tag}_meta.json").write_text(json.dumps(meta, ensure_ascii=False))
Le script laisse volontairement `revisions` et `manual_minutes` vides, pour que le testeur les remplisse après de vraies modifications. Les modèles sont désignés par des codes A/B plutôt que par leur nom, et il ne faut pas non plus révéler leur origine dans les captures d’écran : c’est ce qui rend l’évaluation à l’aveugle pertinente.
> **Note de test** : le code ci-dessus ne sert que de référence de processus et n’a pas été exécuté dans cet article. Il ne fixe pas l’intensité de raisonnement et n’implémente pas de validation dans le navigateur ; il ne peut donc pas être utilisé directement comme outil d’évaluation complet. Avant de tester, il faut vérifier la disponibilité des modèles, la compatibilité des paramètres et la tarification réelle du fournisseur ; utiliser le même canal ne supprime pas automatiquement les différences d’outils, de configuration ou de routage.
#### 2.4.4 Modèle de fiche de comparaison GPT-6.2 Astra
| Élément à consigner | Échantillon A | Échantillon B | Instructions de remplissage |
|——–|——-|——-|———|
| Canal d’appel | API officielle / APIYI apiyi.com | Idem à gauche, doit être identique | Les deux échantillons utilisent le même canal |
| Nombre de modifications | À remplir | À remplir | Nombre d’instructions ajoutées entre la première version et la version livrable |
| Temps manuel (minutes) | À remplir | À remplir | Temps passé à modifier le code et ajuster le style |
| Score d’évaluation à l’aveugle (quatre dimensions) | À remplir | À remplir | Au moins 3 évaluateurs, prendre la médiane |
| Boutons/formulaires/clavier | À remplir | À remplir | Consigner chaque élément en réussite ou échec |
| Comportement aux trois largeurs | À remplir | À remplir | Captures à 375 / 768 / 1440 px |
Ce n’est qu’une fois ce tableau rempli que l’on peut tirer une conclusion propre à son propre projet sur la question de savoir si « GPT-6.2 Astra fait des pages web plus belles et plus utilisables ».
Transformez un besoin réel en résultats vérifiables, puis décidez s’il faut changer de modèle par défaut. Le tableau de comparaison de cet article reste un modèle vierge, et non une évaluation déjà réalisée.
Ce que l’on apprend dans les livres paraît bien superficiel ; pour vraiment maîtriser une chose, il faut la pratiquer soi-même. — Lu You, *Lecture de nuit montrant à mon fils Ziyu*
—
## 📚 Références
1. **Page de publication officielle OpenAI : Introducing GPT-6.2 Astra & Sol**
– Lien : [Annonce officielle](https://openai.com/index/introducing-gpt-6-2-astra-sol/)
– Description : source d’information officielle de cette publication, incluant des précisions sur la mise en page et la sélection des images
2. **Showcase développeur OpenAI : Paris Atlas**
– Lien : [Le processus de construction de Paris Atlas](https://developers.openai.com/showcase/paris-atlas)
– Description : cas de démonstration officiel présentant une expérience de marche et de conduite à Paris, avec conversion de repères Blender vers Three.js
3. [Documentation du modèle GPT-6.2 Astra](https://developers.openai.com/api/docs/models/gpt-6.2-astra) : capacités d’entrée et de sortie.
4. [Documentation officielle de ChatGPT Work et Codex](https://help.openai.com/en/articles/20001275-chatgpt-work-and-codex) : périmètre de déploiement.
5. [Journal des modifications de l’API OpenAI](https://developers.openai.com/api/docs/changelog) : entrée de publication du 2026-11-17.
> **Auteur** : équipe technique APIYI
> **Échanges techniques** : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com