Note de l’auteur : quand on appelle un grand modèle de langage via une API tierce, la qualité des réponses ne permet pas de savoir quel modèle tourne réellement derrière. Cet article décrypte FlashProve, l’outil open source d’Anthropic : comment il utilise un zkSNARK pour lier un résultat d’inférence à des poids précis, combien cela coûte, ce qu’il peut (et ne peut pas) prouver, et à quelle distance on se trouve encore des appels d’API du quotidien.
Le 2 novembre 2026, la Frontier Red Team d’Anthropic, avec des chercheurs de l’EPFL, du MIT et d’autres institutions, a publié FlashProve : un prototype open source d’inférence vérifiable pour les grands modèles de langage. Sur Llama 4 Maverick (400 milliards de paramètres), il génère une preuve avec une seule carte H100. Chaque preuve pèse environ 19 Mo, et un CPU ordinaire la vérifie en une dizaine de secondes.
Ce n’est ni une démo conceptuelle ni un produit de slides. Anthropic a publié en même temps le rapport technique, la spécification du protocole, le code exécutable du prouveur, deux implémentations du vérifieur et une preuve formelle en Lean, le tout sous licence Apache 2.0. L’entreprise précise toutefois qu’il s’agit d’une avancée intermédiaire : il reste du chemin avant d’atteindre l’objectif de recherche complet.
L’essentiel à retenir : après cette lecture, vous saurez pourquoi il est si difficile de confirmer « l’identité du modèle » dans un appel d’API tiers, quel mécanisme FlashProve utilise pour y répondre, quels sont ses coûts réels et ses limites, et ce que vous pouvez faire dès maintenant en tant qu’utilisateur d’API.
Pourquoi l’identité du modèle pose un problème de confiance avec les API tierces
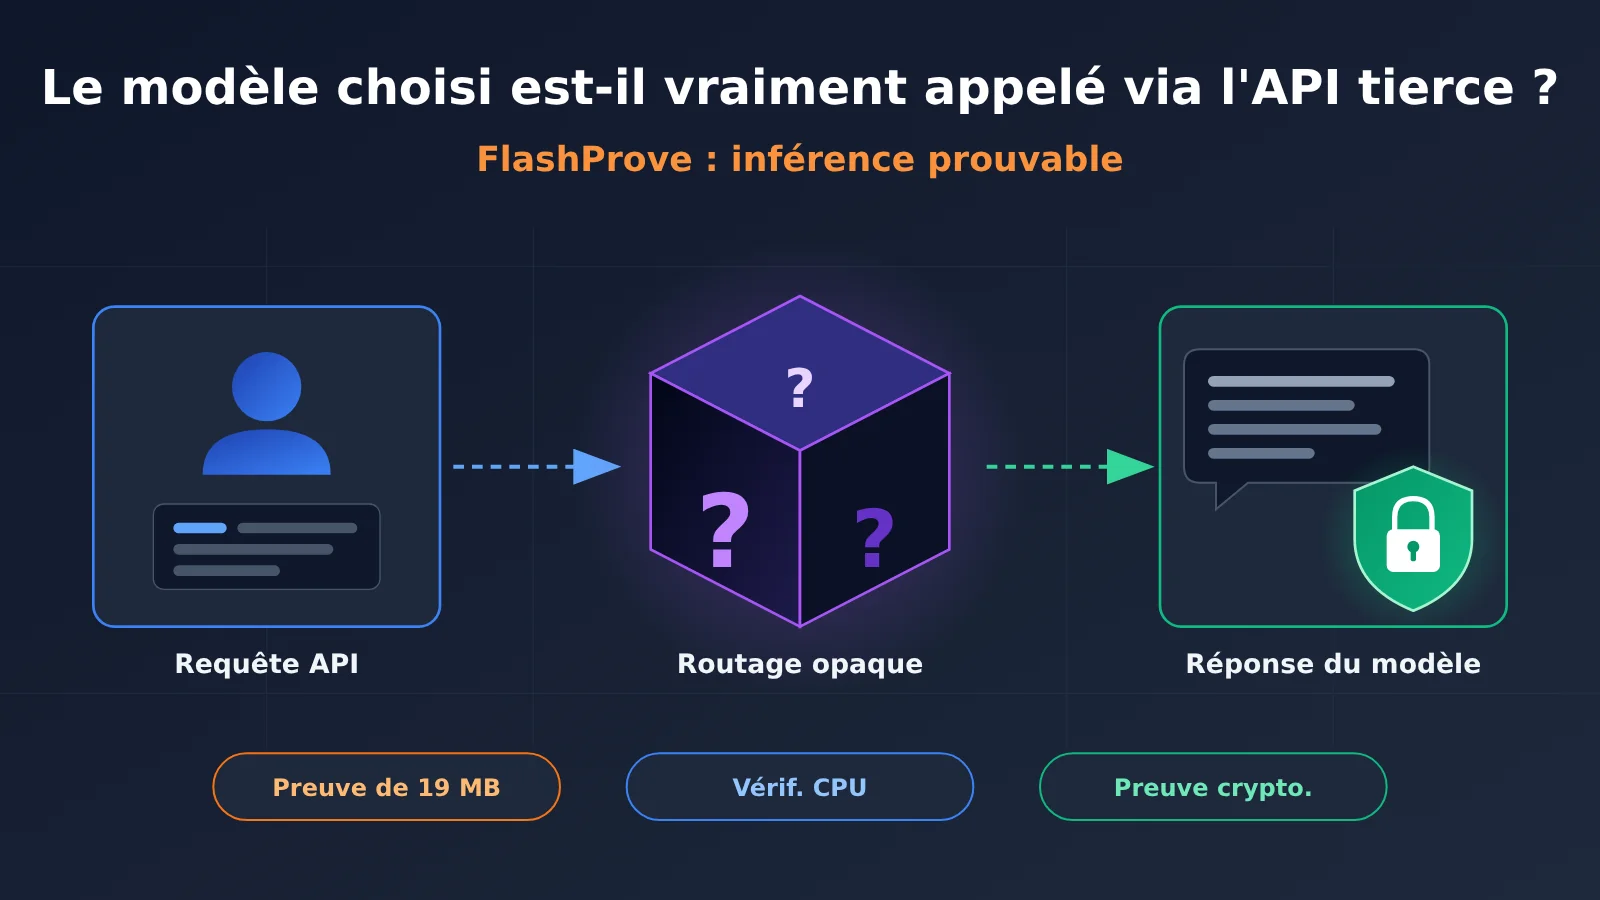
Quand vous envoyez une requête via n’importe quelle API, vous ne recevez en retour qu’un bout de texte et un champ indiquant le nom du modèle. Anthropic le dit sans détour dans son blog de recherche : aujourd’hui, les utilisateurs n’ont aucun moyen de confirmer que la réponse provient bien du modèle annoncé par le développeur. Un service de routage peut très bien l’avoir remplacé discrètement pour réduire ses coûts, et un attaquant peut aussi avoir modifié le flux de tokens.
Plus important encore : une sortie de bonne qualité ne prouve pas que l’identité du modèle est authentique. Un modèle bon marché peut très bien répondre correctement à certaines questions, et une version dégradée n’est pas forcément repérable à l’œil nu. Même en publiant l’historique complet d’une conversation, on pourrait en théorie le fabriquer avec un modèle moins coûteux : ce genre de preuve n’a donc pas de valeur absolue.
Une vérification en profondeur est également difficile. Les poids des modèles de pointe ne sont pour la plupart pas publics, et même si on y avait accès, la puissance de calcul nécessaire pour refaire l’inférence dépasserait de loin ce que peuvent se permettre un utilisateur ordinaire, voire un organisme d’évaluation. Anthropic recense plusieurs scénarios typiques où se pose ce problème de confiance :
- Services de routage tiers : le client veut s’assurer que les tokens reçus viennent bien du modèle qu’il a choisi et payé.
- Évaluation indépendante : les organismes d’évaluation doivent vérifier que le modèle testé avant la publication est bien celui qui sert réellement les requêtes en production.
- Détection de falsification : si un serveur d’inférence est compromis, l’attaquant peut glisser des réponses malveillantes, voire installer un logiciel malveillant sur l’ordinateur de l’utilisateur.
- Réglementation et conformité : les autorités peuvent exiger que seuls des modèles ayant passé une validation de sécurité soient déployés, ou vérifier que le matériel fait bien de l’inférence et non de l’entraînement en douce.
L’objectif de l’inférence prouvable (Provable Inference) est de permettre à un utilisateur disposant de peu de puissance de calcul, et qui ne connaît pas les poids, de vérifier qu’une réponse provient bien du modèle demandé.
FlashProve : l’essentiel en un coup d’œil
| Élément | Détails |
|---|---|
| Date de publication | 2 novembre 2026 |
| Éditeur | Anthropic Frontier Red Team, avec des chercheurs de l’EPFL, du MIT, de StarkWare, de Succinct et d’autres organisations |
| Technologie centrale | zkSNARK (argument de connaissance succinct à divulgation nulle de connaissance), construit à partir de fonctions de hachage, avec une sécurité post-quantique |
| Modèle testé | Llama 4 Maverick, 400 Mds de paramètres en MoE, environ 17 Mds de paramètres activés par jeton, poids publics quantifiés en 4 bits |
| Contenu publié | Billet de recherche, rapport technique, spécification du protocole rédigée par Claude, code du prouveur et de deux vérificateurs (C++ et Lean), preuves en Lean et outil de visualisation |
| Licence open source | Apache 2.0 |
| Positionnement actuel | Prototype de recherche : l’équipe partage ses avancées intermédiaires et accueille volontiers les améliorations venues de l’extérieur |
À noter : Anthropic indique qu’une grande partie des optimisations du système a été réalisée par Claude. Pour se prémunir contre les « décisions difficiles à évaluer » que l’IA peut prendre dans un système vaste et complexe, l’équipe a rédigé en Lean des énoncés de sécurité de haut niveau, auditables, comme garde-fou.
Comment FlashProve prouve qu’une inférence provient d’un modèle donné
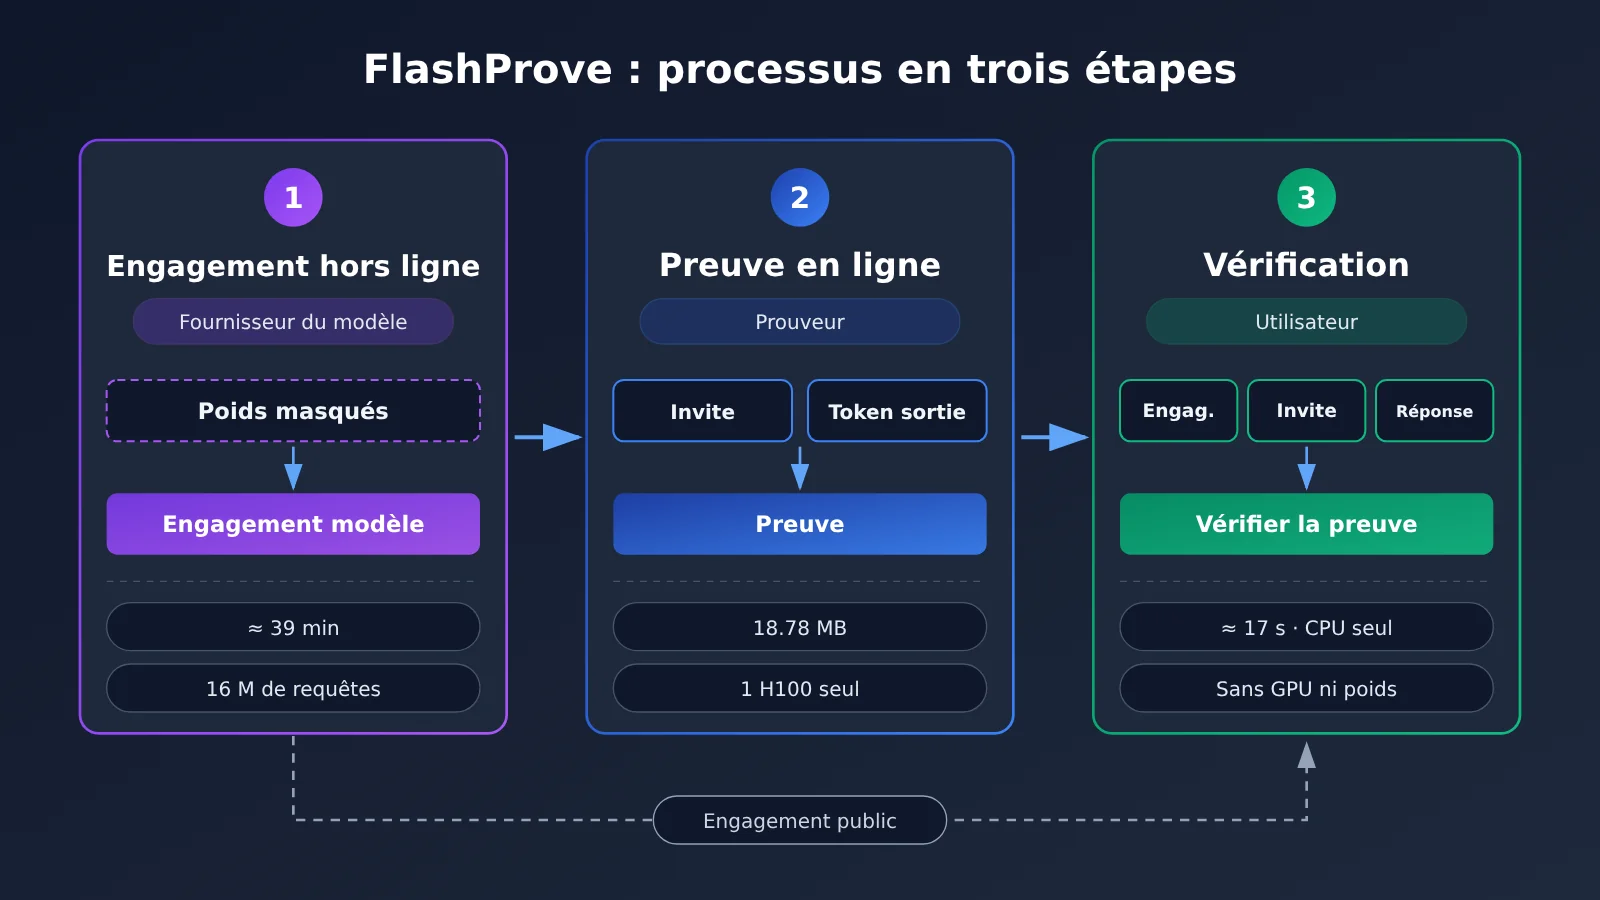
FlashProve ne compte que deux rôles : le fournisseur du modèle, qui joue le rôle de prouveur (Prover), et l’utilisateur, qui joue celui de vérificateur (Verifier). Le déroulé se découpe en deux phases — hors ligne puis en ligne — auxquelles s’ajoute la vérification côté utilisateur.
Le mécanisme en trois étapes
- Engagement hors ligne sur le modèle (Model Commitment) : le prouveur publie un engagement sur les poids du modèle, qu’on peut voir comme une courte « empreinte ». Il verrouille un jeu de poids précis, mais les poids eux-mêmes restent masqués. Dans nos tests, cette étape ne s’exécute qu’une fois par modèle, prend environ 39 minutes, et l’engagement produit couvre à peu près 16 millions de requêtes avant de devoir être renouvelé.
- Génération de la preuve en ligne : à réception de la requête du vérificateur (le prompt et les tokens de sortie correspondants), le prouveur produit un fichier de preuve. L’énoncé démontré est celui-ci : « le modèle engagé, à l’exécution, produit bien ces tokens de sortie ».
- Contrôle côté vérificateur : quiconque dispose de l’engagement, du prompt et de la réponse peut vérifier la preuve — sans les poids, avec une puissance de calcul limitée — et acquérir la certitude que les poids engagés ont bien produit exactement ces tokens sur ce prompt.
Les quatre propriétés de sécurité de FlashProve
Les deux premières (complétude et fiabilité) peuvent en réalité être obtenues par un vérificateur qui connaît les poids et dispose d’assez de calcul : il lui suffit de refaire le calcul lui-même. Ce sont les deux suivantes qui donnent tout son sens au système :
- Complétude (Completeness) : une preuve produite par un prouveur honnête est toujours acceptée.
- Fiabilité (Soundness) : forger une preuve valide d’un énoncé faux coûte autant que casser une hypothèse cryptographique largement reconnue ; le vérificateur n’a donc pas besoin de faire confiance au prouveur.
- Divulgation nulle (Zero Knowledge) : le vérificateur ne peut accéder ni aux poids, ni aux valeurs intermédiaires de calcul, ni savoir quels experts ont été activés à chaque couche — mais l’architecture du modèle, elle, n’est pas masquée.
- Succinctude (Succinctness) : ce qui est prouvé, c’est une exécution d’un modèle quantifié d’environ 232 Go ; le vérificateur ne reçoit pourtant qu’un fichier d’environ 19 Mo, contrôlable en quelques secondes sur un CPU à 24 cœurs.
Comment l’architecture MoE allège le coût de preuve de FlashProve
L’accélération obtenue par FlashProve repose largement sur la structure MoE (mixture of experts). Dans Llama 4 Maverick, chaque token ne mobilise qu’environ 17B des 400B de paramètres : la charge de travail du prouveur est donc proportionnelle à ces ~17B seulement, et la preuve continue de masquer quels experts ont été précisément choisis.
Deux autres choix d’ingénierie comptent tout autant. D’abord la preuve par lots a posteriori : le prouveur lit en parallèle, comme lors d’un prefill, un texte déjà achevé, et n’ouvre l’engagement sur les poids qu’une fois par lot. Ensuite l’adaptation à une seule carte : les poids sont découpés couche par couche, prouvés segment par segment et chargés en flux depuis la mémoire ordinaire — un seul GPU de 80 Go accompagné d’environ 290 Go de mémoire hôte suffit à faire tourner l’ensemble.
Données de coût mesurées pour FlashProve
Le coût est l’indicateur clé pour savoir si l’inférence prouvable peut réellement être déployée. L’environnement de test d’Anthropic se compose d’un H100 unique et de 24 cœurs CPU côté prouveur, tandis que le vérifieur n’utilise que des CPU. Chaque requête correspond à une fenêtre de 1024 tokens.
| Étape | Indicateur | Valeur mesurée |
|---|---|---|
| Engagement hors ligne | Durée / validité | environ 39 minutes / environ 16 millions de requêtes |
| Preuve en ligne | Durée pour un lot de 24 requêtes | environ 223 secondes |
| Preuve en ligne | Débit de traitement | environ 110 tokens/s |
| Fichier de preuve | Taille unitaire | 18,78 Mo |
| Téléchargement côté vérifieur | Taille de l’engagement sur les poids | environ 6,5 Mo |
| Temps de vérification | 24 threads / 1 thread | 17 secondes / 21 secondes (vérifications de la phase hors ligne comprises) |
| Comparaison avec vLLM | Multiple du temps GPU unitaire | environ 72× (66-77×), environ 94× sous charge maximale |
La base de comparaison est la même version FP8 du modèle exécutée avec vLLM sur 8 H100. Autrement dit, le temps GPU nécessaire pour prouver un lot de requêtes représente environ 70 à 95 fois celui d’une inférence normale sur le même lot, soit un surcoût d’environ deux ordres de grandeur.
110 tokens/s ne signifie pas prouver une réponse complète en temps réel
C’est le point qui prête le plus à confusion quand on lit les résultats de FlashProve. Le rapport technique le précise clairement : chaque preuve ne vérifie en réalité qu’un seul token après l’invite. Les 110 tokens/s correspondent au débit avec lequel le prouveur traite les fenêtres de requêtes, et non à la vitesse de vérification d’une réponse complète token par token.
| Base de calcul | Débit | Explication |
|---|---|---|
| Lot de 24 requêtes, calculé sur le volume de fenêtres traitées | environ 110 tokens/s | Le chiffre mis en avant dans le titre du blog ; chaque preuve vérifie un token |
| Vérification de chaque token de la réponse, calculé sur les tokens vérifiés | 39,1 tokens/s | Plus proche du scénario « vérifier une réponse entière » |
| Preuve d’une requête isolée | 17,6 tokens/s | Une preuve prend environ 58 secondes, sans l’avantage du traitement par lots |
Dire que « FlashProve peut déjà prouver des réponses complètes en temps réel » n’est donc pas exact. Une formulation plus rigoureuse serait la suivante : avec un traitement par lots, un contexte court et une preuve a posteriori, FlashProve ramène le coût de l’inférence prouvable à un niveau jusqu’ici difficilement imaginable.
FlashProve face aux approches existantes d’inférence prouvable
Dans le monde académique, l’inférence prouvable est généralement appelée zkML. Anthropic a fait le point sur les avancées du domaine dans un article de blog, et la comparaison chiffrée est assez parlante.
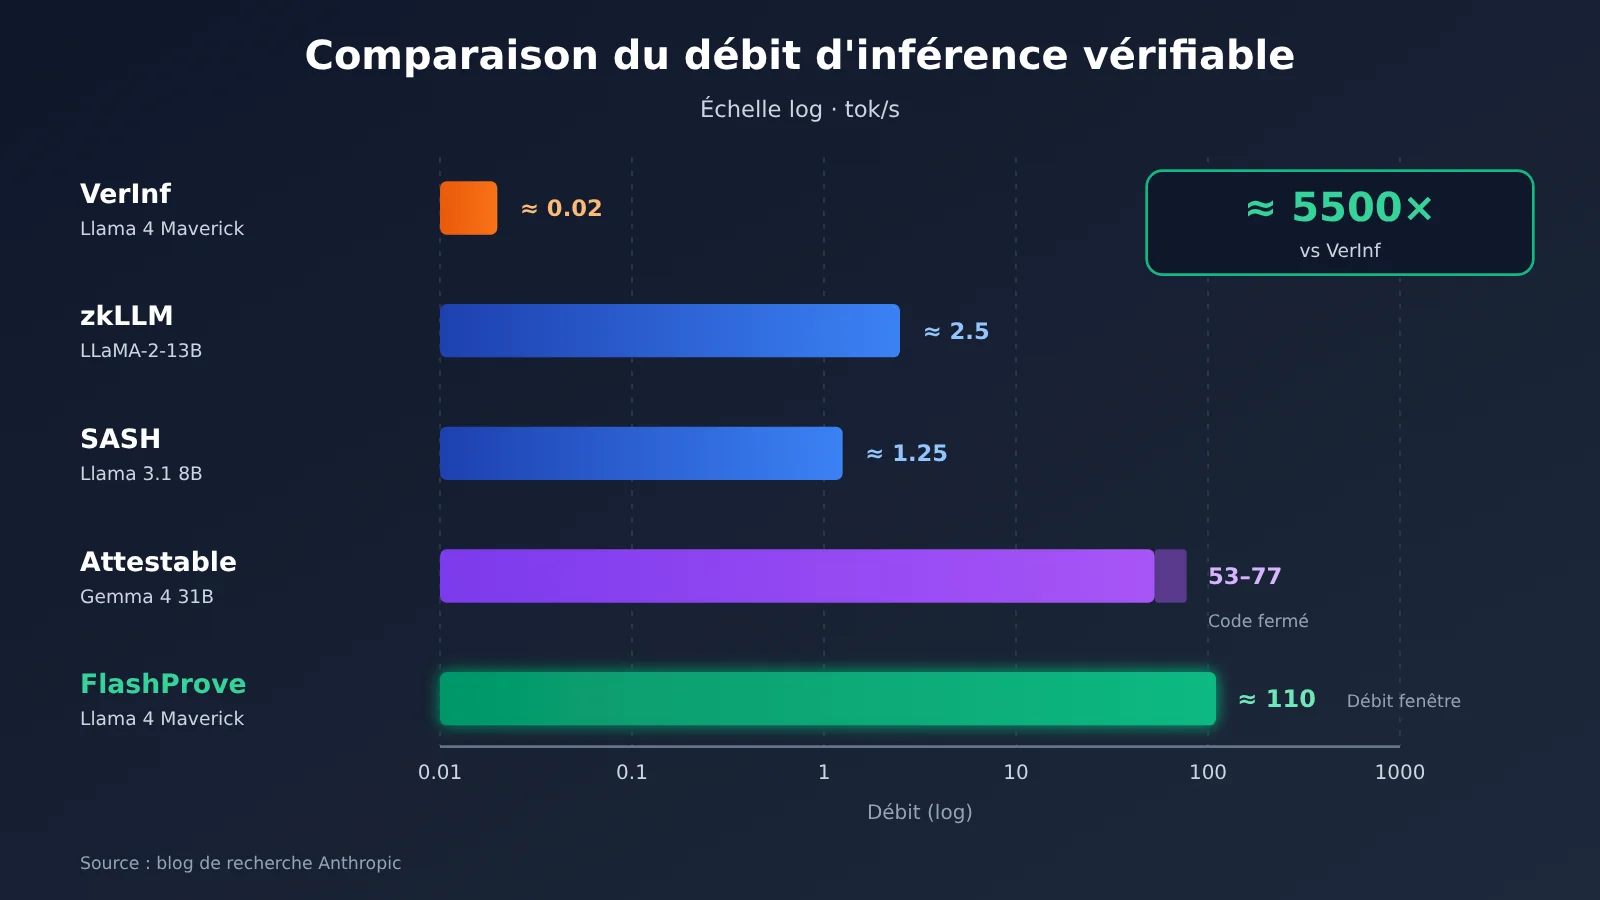
| Solution | Modèle prouvé | Débit / durée | Remarques |
|---|---|---|---|
| VerInf | Llama 4 Maverick (MoE 400B) | Environ 0,02 tok/s, soit 14,3 heures pour 1000 tokens | Preuve de 93,6 Go, vérification de près d’une journée |
| zkLLM (2024) | LLaMA-2-13B | Environ 2,5 tok/s en traitement par lots | Une seule A100 |
| SASH (2026) | Llama 3.1 8B | Environ 1,25 tok/s | Une seule H100 |
| Attestable | Gemma 4 31B (modèle dense) | 53-77 tok/s | Solution commerciale, pas encore open source |
| FlashProve | Llama 4 Maverick (MoE 400B) | Environ 110 tok/s | Preuve d’environ 19 Mo, vérification en quelques secondes, open source |
Comparaison avec VerInf : VerInf était jusqu’ici la seule solution connue à avoir prouvé le même modèle, mais ses preuves pèsent 93,6 Go et leur vérification prend près d’une journée, ce qui la rend pratiquement inutilisable. FlashProve, lui, ramène la taille de la preuve à environ 19 Mo et la vérification à une quinzaine de secondes. Pour la première fois, un audit par un tiers sur un simple CPU devient réaliste.
Comparaison avec Attestable : Attestable affiche d’excellents chiffres commerciaux sur les modèles denses, mais au moment de la rédaction du blog, aucune bibliothèque open source correspondante n’avait été publiée. L’atout de FlashProve, c’est que le code, les preuves Lean et la documentation sont entièrement ouverts : tout le monde peut les reproduire et les améliorer. En contrepartie, la solution dépend pour l’instant fortement de l’architecture MoE.
Ce que FlashProve peut prouver, et ce qu’il ne peut pas prouver
Pour les utilisateurs d’API tierces, comprendre les limites compte autant que comprendre les capacités. Le tableau ci-dessous résume les principales réserves formulées dans le billet de recherche et le rapport technique :
| Dimension | Ce que FlashProve sait faire | Ce que FlashProve ne sait pas (encore) faire |
|---|---|---|
| Identité du modèle | Prouve le lien avec un engagement (commitment) précis sur les poids, et confirme qu’il s’agit bien du « modèle engagé » | Ne peut pas prouver que cet engagement correspond à un modèle commercial portant tel ou tel nom ; il faut un engagement public distinct |
| Exactitude de la sortie | Prouve que les tokens vérifiés sont le résultat du décodage glouton d’un modèle quantifié en entiers | Ne couvre pas directement les implémentations en virgule flottante ni les sorties issues d’un échantillonnage aléatoire (température supérieure à 0) |
| Confidentialité | La preuve elle-même ne divulgue pas les poids | Ne masque pas l’architecture du modèle ; les attaques par canaux auxiliaires, comme le temps de génération, sont hors périmètre |
| Longueur du contexte | Prend en charge un contexte allant jusqu’à 1024 tokens | Très en deçà des centaines de milliers, voire du million de tokens courants dans les scénarios de chat |
| Moment de la protection | Détecte a posteriori les problèmes d’intégrité | Ne peut pas empêcher qu’une réponse altérée parvienne d’abord à l’utilisateur |
| Architecture du modèle | Adapté aux modèles MoE | Les modèles denses et les autres architectures nécessitent des recherches supplémentaires |
Les limites de détection de la preuve a posteriori de FlashProve
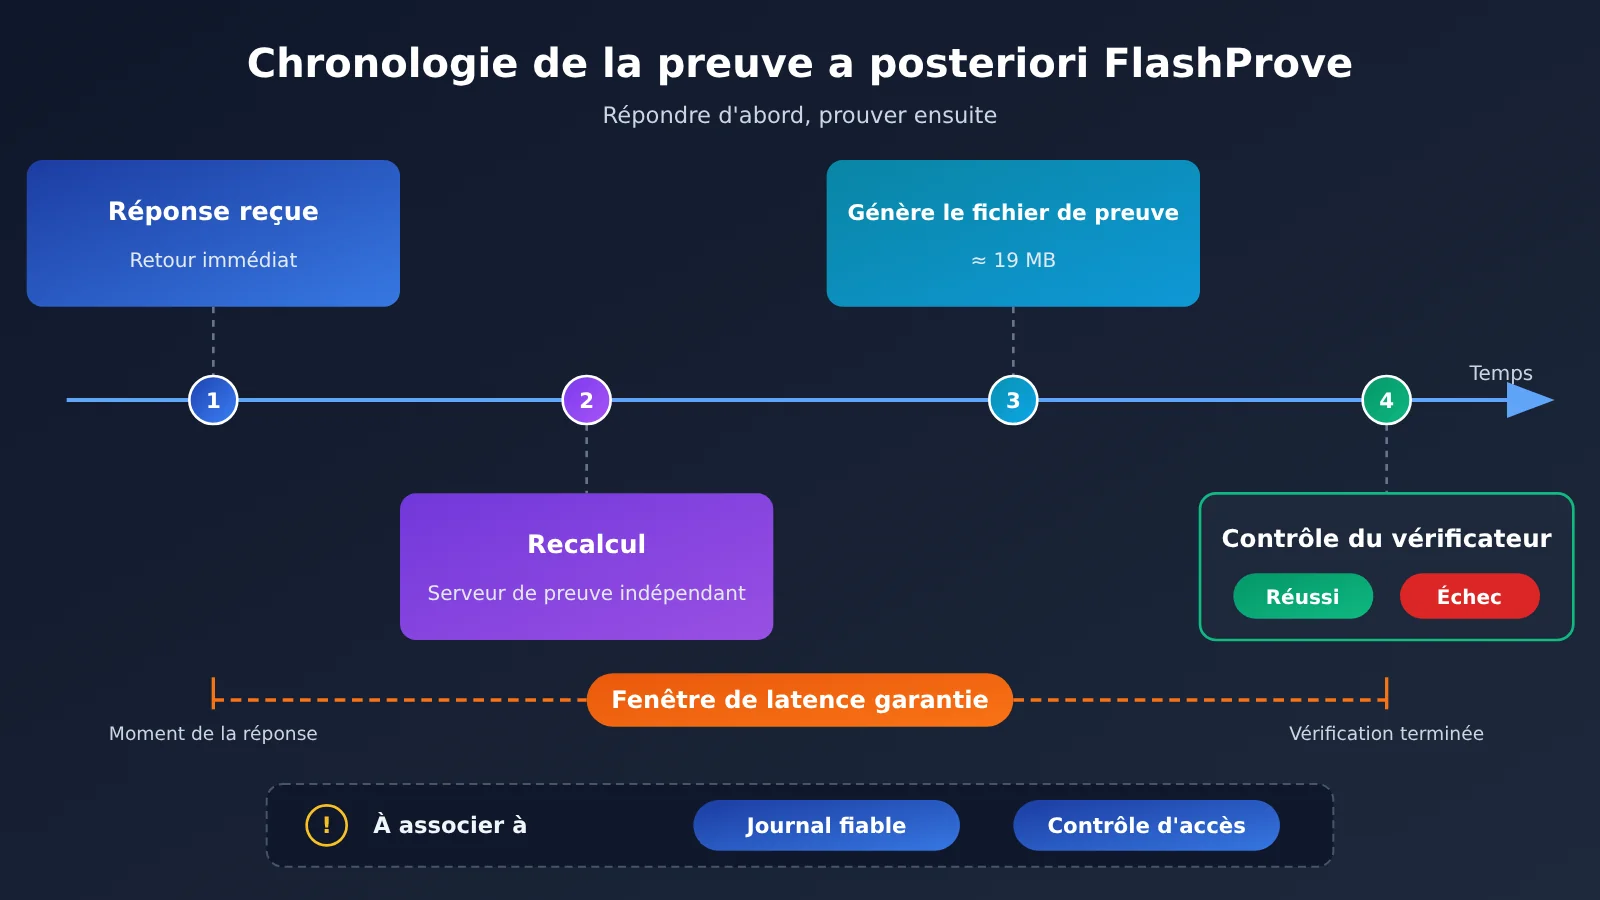
FlashProve repose sur une preuve a posteriori (Post-hoc Proving) : l’utilisateur reçoit d’abord la réponse, puis un serveur de preuve indépendant refait le calcul et génère la preuve, que le vérificateur contrôle enfin. Cette approche tolère une preuve plus lente et évite ainsi de devoir choisir entre sécurité et efficacité. En contrepartie, la garantie arrive avec du retard : un échec de la preuve ne fait que révéler le problème, il ne protège pas l’utilisateur avant qu’il ait reçu la réponse.
Le rapport technique rappelle aussi que, si le système de journalisation est lui-même contrôlé par l’attaquant, celui-ci peut envoyer du contenu altéré à l’utilisateur tout en faisant enregistrer uniquement les résultats corrects dans les journaux. FlashProve doit donc être associé à des mesures de sécurité comme des journaux de confiance et un contrôle d’accès.
Ce que la vérification formelle de FlashProve ne couvre pas encore
« Preuve formelle réalisée avec Lean » se comprend facilement comme « tout le système est prouvé correct », mais ce n’est pas le cas. Voici les limites listées dans le rapport technique :
- La preuve Lean de la propriété de connaissance nulle (zero-knowledge) ne couvre pour l’instant que les preuves à requête unique, pas les preuves par lots.
- Le code du côté prouveur GPU a été généré par une IA à partir de la représentation Lean, et son équivalence avec cette représentation n’a pas été démontrée.
- Le vérificateur rapide en C++ utilisé au quotidien a lui aussi été généré par une IA, sans garantie formelle ; on sait seulement que, dans les tests, ses conclusions concordent toutes avec celles du vérificateur Lean.
- Le long document de spécification du protocole a été généré par une IA et n’a pas été relu en détail par les auteurs ; il faut le distinguer du rapport technique rédigé par ces derniers.
Ces limites n’invalident pas la recherche. Elles montrent simplement que la vérification formelle porte aujourd’hui sur les propriétés mathématiques de la couche protocole, et qu’il faut encore un audit humain ou par agents pour combler l’écart entre le code exécutable et le protocole.
Analyse d’impact : FlashProve est-il près de s’inviter dans les appels quotidiens aux API tierces ?
Impact pour les développeurs et les utilisateurs d’API
- Pas de place dans la chaîne d’appels quotidienne à court terme : un surcoût GPU d’environ deux ordres de grandeur, des fichiers de preuve d’environ 19 Mo par requête et une limite de 1024 tokens de contexte le rendent difficilement utilisable tel quel pour des API conversationnelles à haute fréquence.
- Un champ d’application restreint : le système suppose une architecture MoE, un modèle quantifié en entiers et un décodage glouton. La plupart des appels en production reposent sur un échantillonnage aléatoire et une inférence en virgule flottante, donc impossible de l’appliquer directement.
- Une valeur surtout conceptuelle : pour la première fois, « vérifier l’identité d’un modèle » passe de l’impossible au problème d’ingénierie. Les développeurs doivent garder en tête que le champ du nom de modèle renvoyé, l’ID du modèle ou de simples journaux de requêtes ne valent pas une preuve cryptographique.
💡 Conseil : tant que l’inférence prouvable n’est pas mature, les critères les plus utiles pour choisir un service tiers sont la transparence de la facturation, la traçabilité des journaux d’appels et la cohérence constatée lors de vos propres tests. Avec une plateforme d’agrégation comme APIYI (apiyi.com), vous pouvez interroger plusieurs modèles en parallèle et conserver l’historique complet des appels, ce qui facilite les recoupements et les audits de votre côté.
Impact sur le secteur et la réglementation
- Un outil de plus dans la boîte à outils d’évaluation et de conformité : les régulateurs pourraient exiger des fournisseurs qu’ils joignent une preuve aux requêtes d’inférence d’une période donnée, afin de confirmer que le matériel sert bien le modèle annoncé, sans révéler les poids propriétaires. Anthropic reconnaît toutefois que cela ne prouve pas que le matériel n’effectue pas en parallèle un entraînement en douce.
- Les approches logicielles et le matériel de confiance se complètent : les environnements d’exécution de confiance (TEE) reposent sur du matériel inviolable fourni par les fabricants, tandis que les zkSNARK s’appuient sur la difficulté de problèmes de calcul. Même si le matériel et le système d’exploitation sont compromis, il reste impossible de forger une preuve. Chacune des deux approches trouvera sa place selon les cas d’usage.
- La vérification en production chez Anthropic suit une autre voie : dans la mise à jour du 19 octobre 2026 de sa Frontier Safety Roadmap, Anthropic indique avoir construit un prototype de son projet de vérification de l’inférence sur du trafic d’inférence réel. Le dispositif signe le trafic interne de tokens et recalcule l’inférence sur des serveurs de confiance. Il a aussi détecté une anomalie d’intégrité extrêmement rare et non malveillante. Le projet a été rebaptisé « inference verification ». Il est lié à FlashProve mais en reste indépendant : il ne faut pas les confondre.
Ce que les utilisateurs d’API tierces peuvent faire dès maintenant : mettre en place leur propre journal d’audit des appels
Comme les preuves cryptographiques ne sont pas encore utilisables en pratique, ce que les développeurs peuvent faire dès aujourd’hui, c’est soigner la « traçabilité ». L’exemple ci-dessous fixe temperature=0 lors de l’appel, puis écrit dans un journal local l’horodatage de la requête, l’ID de la requête, le champ du modèle renvoyé et le hash de la réponse, ce qui facilite les tests de cohérence ultérieurs. Il faut le souligner : il s’agit uniquement d’un enregistrement d’audit côté ingénierie, pas d’une preuve cryptographique de l’identité du modèle.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句话解释零知识证明"}],
    temperature=0
)
print(resp.model, resp.id)
print(resp.choices[0].message.content)
Voir le code complet du journal d’audit
import hashlib
import json
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé pour appeler plusieurs modèles
)

def audited_call(prompt: str, model: str, log_path: str = "audit.jsonl") -> str:
    """Appelle le modèle et enregistre les informations de traçabilité (pas une preuve cryptographique)"""
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        temperature=0,
        max_tokens=512,
    )
    content = resp.choices[0].message.content or ""
    record = {
        "ts": int(start),
        "latency_s": round(time.time() - start, 3),
        "requested_model": model,
        "returned_model": resp.model,   # Simple champ déclaratif renvoyé par le serveur
        "request_id": resp.id,
        "prompt_sha256": hashlib.sha256(prompt.encode()).hexdigest(),
        "output_sha256": hashlib.sha256(content.encode()).hexdigest(),
        "usage": resp.usage.model_dump() if resp.usage else None,
    }
    with open(log_path, "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return content

# Fixer un ensemble d'invites sondes, puis les rejouer régulièrement et comparer les hashs de sortie et la distribution des latences
probes = ["计算 37*43 并只输出结果", "列出三种排序算法的时间复杂度"]
for p in probes:
    for m in ["gpt-4o-mini", "claude-sonnet-4-5"]:
        print(m, audited_call(p, m)[:60])
🚀 Pour démarrer rapidement : vous pouvez obtenir un quota de test gratuit sur APIYI (apiyi.com) et utiliser le script de sondes ci-dessus pour retester régulièrement plusieurs modèles. Précisons-le : ce type de méthode améliore seulement la traçabilité et ne remplace pas une preuve au niveau des poids comme FlashProve.
Pour aller plus loin, quelques bonnes pratiques à combiner :
– fixer l’ID exact du modèle plutôt qu’utiliser des alias vagues ;
– conserver un ensemble d’invites sondes pour suivre dans la durée l’évolution des sorties et de la latence ;
– pour les cas d’usage critiques, interroger plusieurs modèles en parallèle afin de recouper les résultats ;
– suivre les avancées des fournisseurs sur les engagements publics concernant les poids ou sur les mécanismes vérifiables.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que FlashProve ?
FlashProve est un prototype de recherche sur le raisonnement prouvable, publié en open source par Anthropic en novembre 2026. Il repose sur les zkSNARK : le fournisseur du modèle s’engage d’abord sur les poids (commitment), puis génère une preuve pour chaque résultat d’inférence. L’utilisateur n’a pas besoin d’accéder aux poids et peut, avec un simple CPU, vérifier que la réponse provient bien du modèle engagé.
Q2 : Quelle différence entre FlashProve et le projet de vérification d’inférence (inference verification) d’Anthropic ?
Les deux visent un objectif proche, mais leur mise en œuvre diffère. Le projet de vérification d’inférence a déjà fait l’objet d’un prototype sur du trafic de production : il signe le trafic interne de tokens et recalcule les résultats sur un serveur de confiance. FlashProve, lui, est une solution cryptographique purement logicielle, qui reste pour l’instant un prototype de recherche. Il ne faut pas les confondre.
Q3 : Les 110 tokens/s de FlashProve signifient-ils qu’on peut prouver une réponse complète en temps réel ?
Non. Les 110 tokens/s correspondent au débit de traitement par fenêtre en mode batch, et chaque preuve ne vérifie qu’un seul token. Si l’on vérifie chaque token de la réponse, le débit tombe à 39,1 tokens/s, et à 17,6 tokens/s pour une preuve sur une seule requête. De plus, toute la procédure est une preuve a posteriori.
Q4 : APIYI fournit-il déjà une preuve FlashProve pour chaque réponse ?
Non. Aucun élément n’indique aujourd’hui qu’APIYI (apiyi.com) ait déployé FlashProve ou propose des preuves cryptographiques au niveau des poids. Le nom du modèle renvoyé par la plateforme et les journaux d’invocation ne constituent pas une preuve cryptographique. À ce stade, l’approche la plus pragmatique consiste à s’appuyer sur l’interface unifiée et l’historique des appels de la plateforme pour effectuer vos propres tests de reproductibilité et des comparaisons croisées.
Q5 : Comment tester rapidement la cohérence de plusieurs modèles via l’API ?
Nous recommandons une plateforme d’agrégation compatible avec plusieurs modèles :
1. Rendez-vous sur APIYI (apiyi.com), créez un compte et récupérez votre clé API ainsi qu’un quota de test gratuit
2. Dans le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1`
3. Fixez `temperature=0`, puis relancez régulièrement des invites sonde en enregistrant le hash des sorties
Cette méthode permet de repérer des variations anormales, mais relève de l’audit d’ingénierie, pas de la preuve d’identité du modèle.
Q6 : Quelles sont les limites connues de FlashProve ?
Principalement : un surcoût GPU d’environ 70 à 95 fois celui d’une inférence normale ; une fenêtre de contexte limitée à 1024 tokens ; une dépendance à l’architecture MoE, aux modèles quantifiés en entiers et au décodage glouton ; l’architecture du modèle n’est pas masquée, et les attaques par canaux auxiliaires sont hors périmètre ; une preuve a posteriori n’empêche pas qu’un contenu falsifié soit livré avant la vérification ; enfin, il n’existe pas encore de preuve formelle d’équivalence entre le code exécutable et le protocole Lean.
FlashProve : l’essentiel à retenir (Key Takeaways)
- Le déficit de confiance est bien réel : avec les appels à des API tierces, une réponse de bonne qualité ne prouve pas que le modèle annoncé est réellement celui qui tourne derrière.
- Mécanisme central : un engagement hors ligne sur les poids du modèle, associé à une preuve zkSNARK en ligne. L’utilisateur peut vérifier le tout avec un simple CPU.
- Une baisse de coût spectaculaire : sur une fenêtre d’un seul H100, le débit atteint environ 110 tokens/s, pour une preuve d’environ 19 Mo et une vérification d’environ 17 secondes.
- Attention aux chiffres comparés : le débit de la vérification token par token est de 39,1 tokens/s, et seulement 17,6 tokens/s pour une requête isolée.
- Des limites bien définies : uniquement les MoE, un décodage glouton en entiers, un contexte de 1024 tokens et une détection a posteriori.
- Pour s’y mettre : dès aujourd’hui, vous pouvez utiliser l’interface unifiée multi-modèles d’APIYI (apiyi.com) pour refaire vos propres tests et audits.
Conclusion
L’intérêt de FlashProve se résume en trois points :
- La vérification de l’identité d’un modèle devient un problème d’ingénierie : jusqu’ici, prouver qu’il s’agissait bien du même modèle demandait une dizaine d’heures de calcul et près de 100 Go de preuve. On passe maintenant à un traitement par lots de l’ordre de la centaine de tokens/s, avec une preuve de 19 Mo.
- On est encore loin d’un usage en production : un surcoût de deux ordres de grandeur, un contexte court, des contraintes d’architecture et de mode de décodage, sans oublier une vérification formelle incomplète, en font pour l’instant un prototype de recherche.
- Il faut le combiner avec d’autres mécanismes de sécurité : une preuve a posteriori permet de détecter un problème, mais pas de le bloquer. Elle doit donc s’accompagner de journaux de confiance et d’un contrôle d’accès.
Pour quelqu’un qui utilise aujourd’hui des API tierces, l’attitude la plus pragmatique est la suivante : ne pas considérer le champ « nom du modèle » comme une preuve, mais sans tomber dans l’anxiété pour autant. Commencez par bien tenir vos journaux d’appels, refaire régulièrement des tests sondes et croiser les résultats entre plusieurs modèles, tout en suivant de près la maturité de l’inférence prouvable. Avec APIYI (apiyi.com), vous pouvez comparer plusieurs modèles avec une seule clé et établir, sur vos propres données métier, une base de référence de qualité traçable.
📚 Références
- Blog de recherche d’Anthropic – Progress on provable inference for large language models : article de publication original de FlashProve
- Lien :
anthropic.com/research/provable-inference -
Description : présente la conception du système, les données mesurées, la comparaison avec les solutions existantes et leurs limites
-
Rapport technique de FlashProve : détails techniques complets joints au blog de recherche
- Lien :
anthropic.com/research/provable-inference(accessible via le lien « Read the technical report » sur la page) -
Description : précise des points clés comme la méthode de mesure du débit, les limites de la preuve a posteriori et les frontières de la vérification formelle
-
Anthropic Frontier Safety Roadmap : état d’avancement du projet de vérification de l’inférence
- Lien :
anthropic.com - Description : pour comprendre la différence entre l’inference verification et FlashProve
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel d’APIYI. Pour plus de ressources d’intégration, rendez-vous dans le centre de documentation : docs.apiyi.com