Note de l’auteur : à partir de la méthode d’environnements d’entreprise synthétiques publiée par Microsoft Copilot, cet article décortique ses trois composantes — environnement synthétique, génération automatique de requêtes et contrôle qualité — puis propose aux petites et moyennes équipes des étapes et une liste de vérification pour créer leur jeu d’évaluation.
Lorsqu’un assistant IA ou une application de gestion des connaissances s’apprête à être déployé en entreprise, les responsables de l’évaluation se heurtent souvent au même problème : les données qui reflètent le mieux la réalité sont les courriels, les comptes rendus de réunion et les documents de projet de l’entreprise. Mais ces données sont sensibles et ne peuvent pas servir aux tests. À l’inverse, les scores obtenus sur des jeux de référence génériques ne révèlent pas les problèmes propres aux cas d’usage métier. Cet article s’appuie sur un billet publié par Microsoft Research le 30 octobre 2026 pour décortiquer une méthode de construction de jeux d’évaluation fondée sur trois éléments : environnement d’entreprise synthétique + génération automatique de requêtes + contrôle qualité.
Il ne s’agit pas d’une reprise du discours officiel. Les informations publiées par Microsoft décrivent surtout un cadre méthodologique : elles ne fournissent ni invites ni code des outils, et ne dévoilent pas non plus les résultats précis de Copilot sur ces jeux de données. Nous distinguerons ce que le texte original indique explicitement de ce que nous en déduisons, puis nous en tirerons des étapes utiles aux petites et moyennes équipes.
À retenir : à la fin de cet article, vous comprendrez le rôle de chacune des trois composantes d’un jeu d’évaluation d’entreprise synthétique, pourquoi la dimension temporelle et l’adaptation au secteur d’activité sont indispensables, et comment repérer les lacunes de votre processus d’évaluation grâce à une liste de vérification.
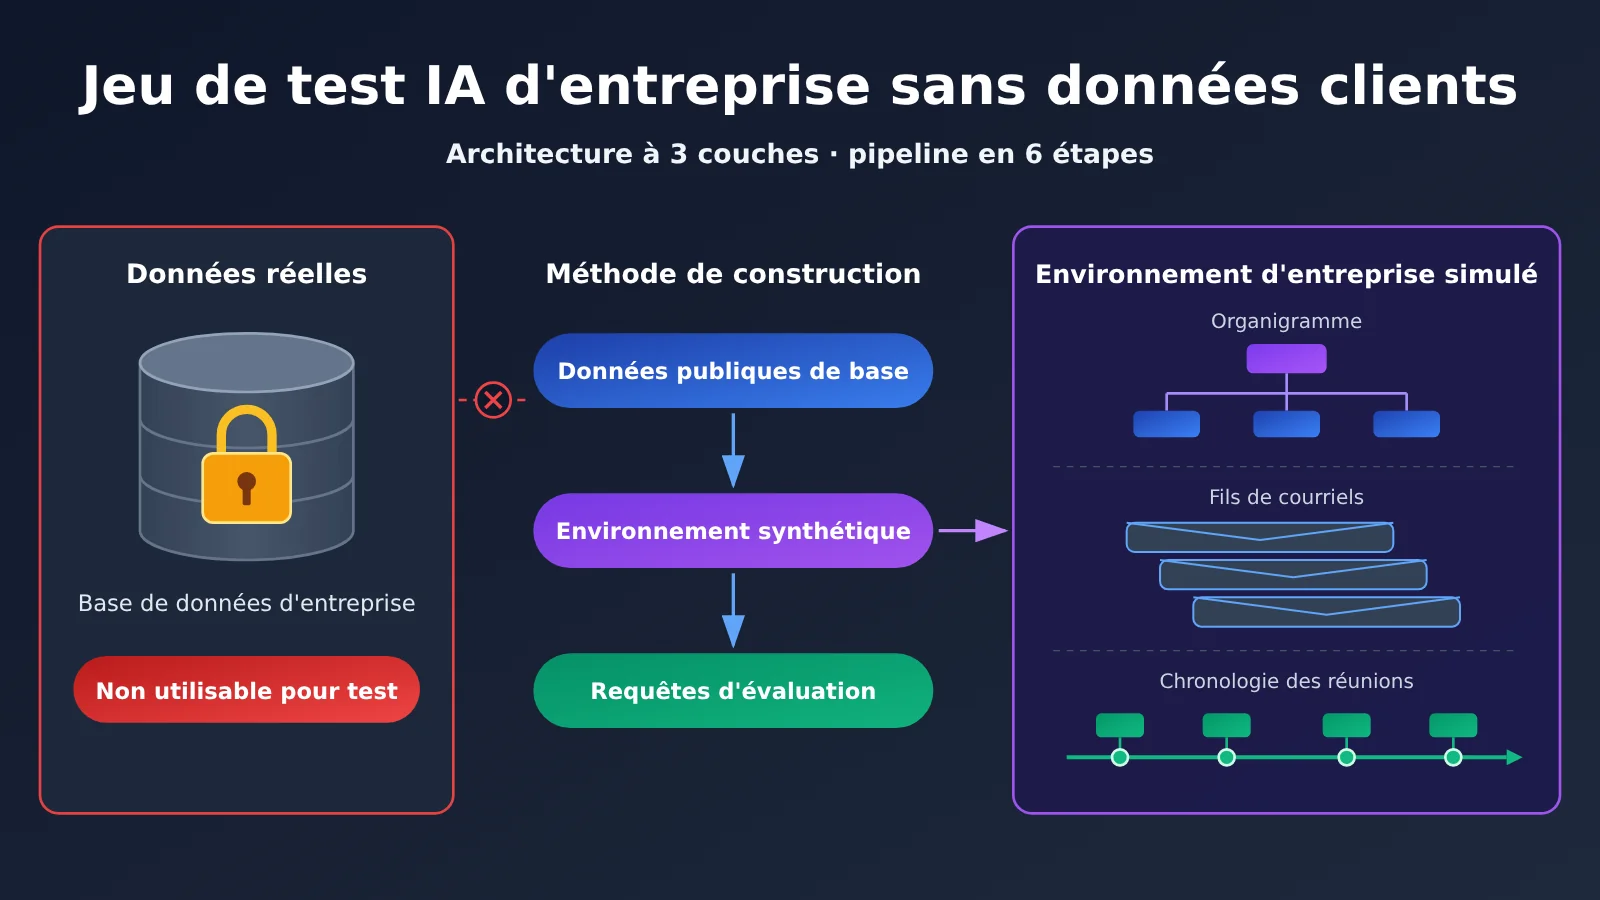
Points clés de l’évaluation dans un environnement d’entreprise synthétique
Microsoft appelle ce système Industry Evaluation Data Generation Platform (plateforme de génération de données d’évaluation sectorielles). Selon l’article d’origine, il repose sur trois piliers, reliés par une couche d’automatisation de bout en bout.
| Composant | Description dans l’article d’origine | Problème résolu |
|---|---|---|
| Environnement d’entreprise synthétique | Espace de travail Copilot simulé, avec des utilisateurs, des réunions, des courriels, des documents et une structure organisationnelle, sans utiliser de données client | Fournit une base pour les tests sans compromettre la confidentialité |
| Pipeline de génération automatique de requêtes | Transforme des idées de requêtes générales en questions adaptées au secteur et aux données de l’environnement | Évite le coût élevé de la rédaction manuelle de milliers de requêtes adaptées aux données |
| Cadre de qualité structuré | Évalue la qualité des données synthétiques selon plusieurs critères | Évite de tirer des conclusions erronées à partir de données manifestement irréalistes |
| Automatisation de bout en bout | Permet de générer à nouveau exactement le même jeu de données avec une configuration identique | Facilite les comparaisons de régression entre versions et la cohérence entre équipes |
Pourquoi les benchmarks génériques ne détectent pas les problèmes des applications d’IA en entreprise
Dans l’entreprise, la difficulté ne tient pas à une question-réponse isolée, mais au contexte organisationnel. Lorsqu’un utilisateur demande : « Prépare pour chaque équipe la liste des actions à mener après cette réunion d’évaluation de sécurité », le modèle doit savoir qui était présent, qui est responsable de chaque module et quels points précis ont été abordés. Il doit aussi citer le compte rendu de la réunion dans sa réponse. L’article d’origine prend l’exemple d’un établissement de santé qui demande à Copilot de résumer une réunion et d’en extraire les actions à mener. L’objectif est de vérifier si la réponse est exacte, complète et étayée.
Les benchmarks génériques ne prennent pas en compte les liens hiérarchiques, l’historique des projets, les habitudes de communication et les processus propres au domaine. Ils ne permettent donc pas de détecter des erreurs propres à l’entreprise, comme attribuer au service B une décision prise par le service A ou omettre une conclusion importante d’une réunion interfonctionnelle. L’idée de Microsoft est la suivante : puisque les données réelles ne peuvent pas être utilisées, créons un environnement dont la structure et le fonctionnement ressemblent à ceux d’une véritable entreprise.
S’appuyer sur des données publiques pour créer des environnements d’entreprise synthétiques
Quand on laisse un grand modèle de langage inventer une structure organisationnelle de toutes pièces, les rôles ont tendance à se ressembler, les lignes hiérarchiques sont trop plates et les activités manquent de diversité. Microsoft utilise trois types de données publiques pour calibrer ses environnements synthétiques. Ces sources ont toutes été examinées et approuvées par ses services juridiques et chargés des politiques.
| Source de données publiques | Utilisation dans l’article d’origine | Alternative pour les petites et moyennes équipes |
|---|---|---|
| Base de données des métiers O*NET (département du Travail des États-Unis) | Rendre les rôles et les responsabilités plus réalistes, calibrer la combinaison et la fréquence des activités propres à chaque rôle, et adapter les processus sectoriels | Établir une liste de rôles à partir de fiches de poste publiques et de classifications professionnelles du secteur |
| Offres d’emploi en ligne | Fournir des intitulés de poste, des niveaux hiérarchiques et des structures de département réalistes | Recueillir les descriptions de poste publiques du secteur visé et en extraire les niveaux de responsabilité et la structure des départements |
| Documents publics de la SEC | Déterminer la taille de l’organisation, la structure des unités opérationnelles et le contexte financier | S’appuyer sur les descriptions des divisions et des effectifs dans les rapports annuels d’entreprises cotées |
Dans la terminologie de Microsoft, chaque espace de travail simulé est appelé un « tenant » : c’est un environnement organisationnel isolé, doté de ses propres utilisateurs, données et configurations. L’article souligne que ces environnements constituent des bases extensibles sur lesquelles chaque équipe peut continuer à construire.
La dimension temporelle : pourquoi « Qu’a-t-on décidé jeudi dernier ? » exige une véritable structure chronologique
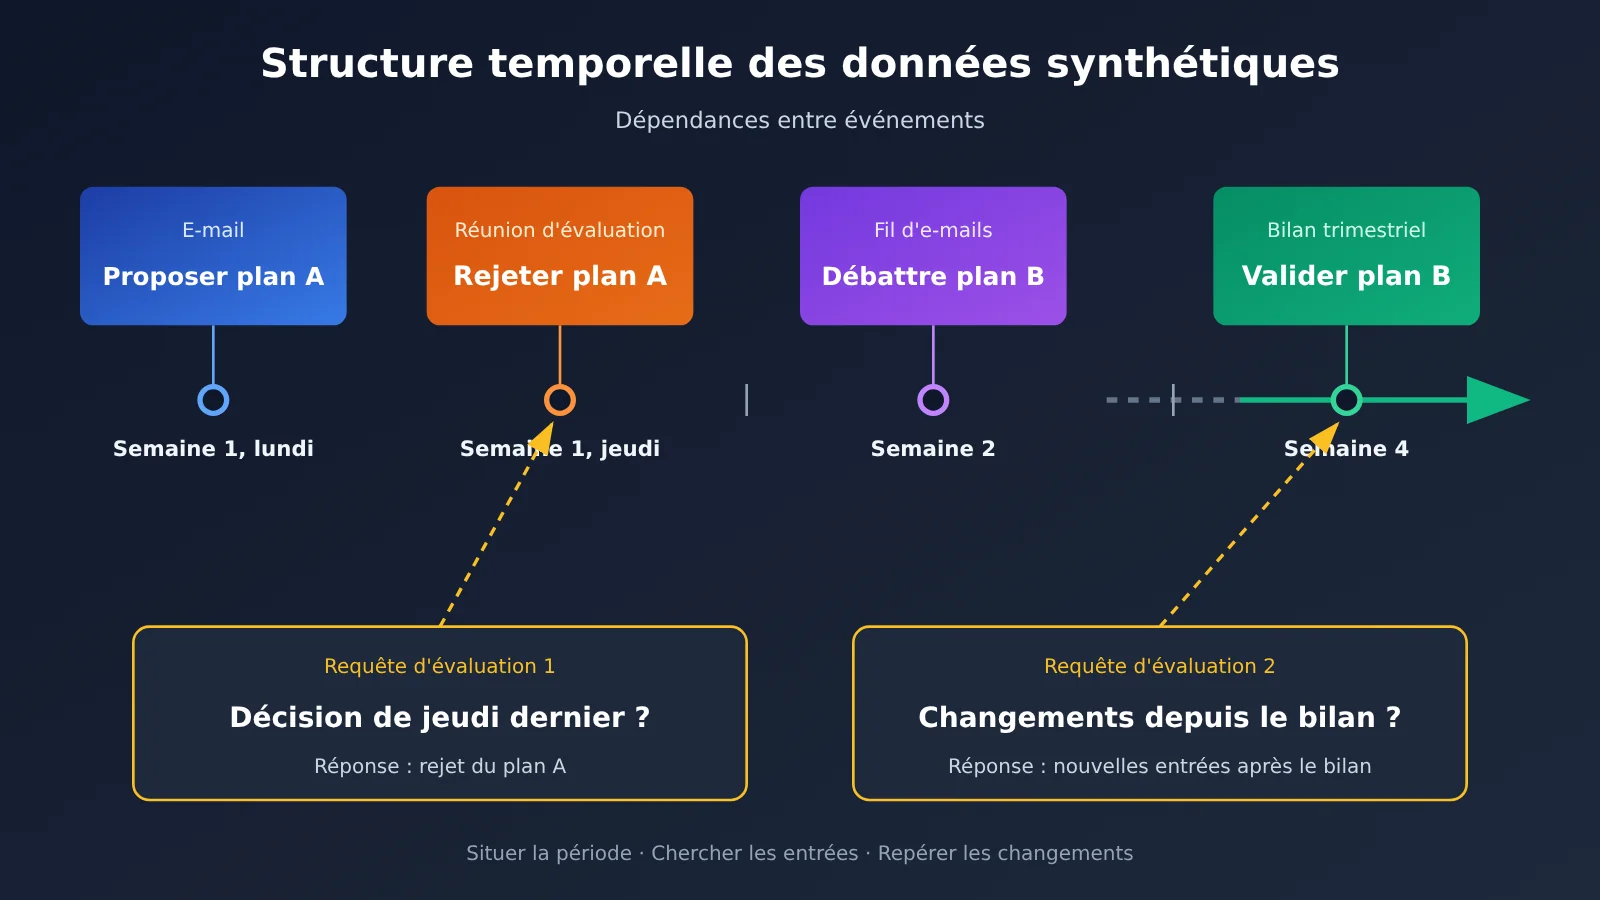
C’est sans doute le point de l’article auquel les petites et moyennes équipes devraient prêter le plus d’attention. L’environnement synthétique de Microsoft n’est pas un instantané figé : c’est une organisation qui évolue au fil du temps, avec un historique de réunions, des calendriers de projet, des fils de discussion qui s’étendent sur plusieurs semaines et des changements organisationnels qui surviennent naturellement. L’article souligne que de nombreuses requêtes adressées à Copilot comportent elles-mêmes une dimension temporelle, comme « Qu’a décidé l’équipe jeudi dernier ? » ou « Qu’est-ce qui a changé depuis la dernière revue trimestrielle ? ».
Pour répondre à ce type de question, le modèle doit faire trois choses : délimiter la période concernée, trouver les informations pertinentes dans cette période et repérer les changements survenus entre-temps. Si les données synthétiques ne sont qu’un ensemble de documents sans lien chronologique, ou si toutes les réunions sont regroupées sur une seule journée, ces questions n’ont soit pas de réponse de référence, soit une réponse trop facile. Dans les deux cas, l’évaluation perd son intérêt. Les données synthétiques doivent donc présenter des liens de cause à effet dans le temps : une proposition formulée le lundi, rejetée en réunion le jeudi, puis remplacée par une autre dans un courriel la semaine suivante. C’est à cette condition que la question « Qu’a-t-on décidé jeudi dernier ? » peut vraiment mettre le modèle à l’épreuve.
Par secteur : un même modèle révèle des problèmes différents selon le domaine
Microsoft a créé des environnements synthétiques pour trois secteurs, chacun correspondant à des processus métier réels :
- Industrie pharmaceutique : dossiers réglementaires, discussions sur les essais cliniques et réunions d’évaluation de la sécurité entre équipes
- Marchés des capitaux : pipeline de transactions, communications sur la conformité et revues des portefeuilles clients
- Entreprises informatiques et logicielles : planification des itérations, discussions sur les revues de code et coordination des lancements de produits
Selon l’article original, une approche par secteur permet de rapprocher les requêtes d’évaluation des questions que les utilisateurs de ces domaines posent réellement. Elle révèle ainsi des défaillances propres à chaque domaine que des tests génériques ne détecteraient pas. Pour les équipes internes d’une entreprise, le fait de ne servir généralement qu’un ou deux secteurs facilite au contraire une évaluation plus approfondie.
Génération automatique de requêtes : les six étapes du pipeline
Un environnement synthétique ne suffit pas : il faut aussi des requêtes d’évaluation. Selon l’article original, rédiger à la main des milliers de requêtes adaptées aux données et au secteur serait trop long et coûteux. Les auteurs ont donc créé un pipeline automatisé. L’article résume les étapes en un seul paragraphe ; le tableau ci-dessous les répartit en six étapes, dans l’ordre décrit. Pour le découpage exact, reportez-vous au schéma original.
| Étape | Points clés de l’article original | Approche simplifiée pour les petites et moyennes équipes |
|---|---|---|
| 1. Bibliothèque de tâches | Partir d’un grand nombre de tâches professionnelles générales | Lister 50 à 100 tâches courantes, comme résumer une réunion, retrouver une décision ou comparer des versions |
| 2. Filtrage par secteur | Sélectionner les tâches pertinentes pour un secteur donné | Demander aux équipes métier de sélectionner les tâches pertinentes pour leur secteur |
| 3. Réécriture métier | Réécrire les tâches avec le vocabulaire et le contexte du domaine | Ajouter la terminologie du secteur et les types de documents courants |
| 4. Génération à partir de l’environnement | Utiliser l’IA pour générer des requêtes ancrées dans les données de l’environnement synthétique | Faire lire au modèle des documents ou des fils de discussion précis avant de générer les questions, ainsi que les réponses de référence et leurs sources |
| 5. Reformulation naturelle | Reformuler les requêtes pour qu’elles ressemblent davantage à des questions posées par de vraies personnes | Ajouter des tournures orales, des omissions et des références implicites, comme « Qu’est-il arrivé à ce projet, finalement ? » |
| 6. Validation | Vérifier l’exactitude et l’unicité de chaque requête | Supprimer les doublons et vérifier par sondage que chaque réponse repose sur un seul élément identifiable dans les données |
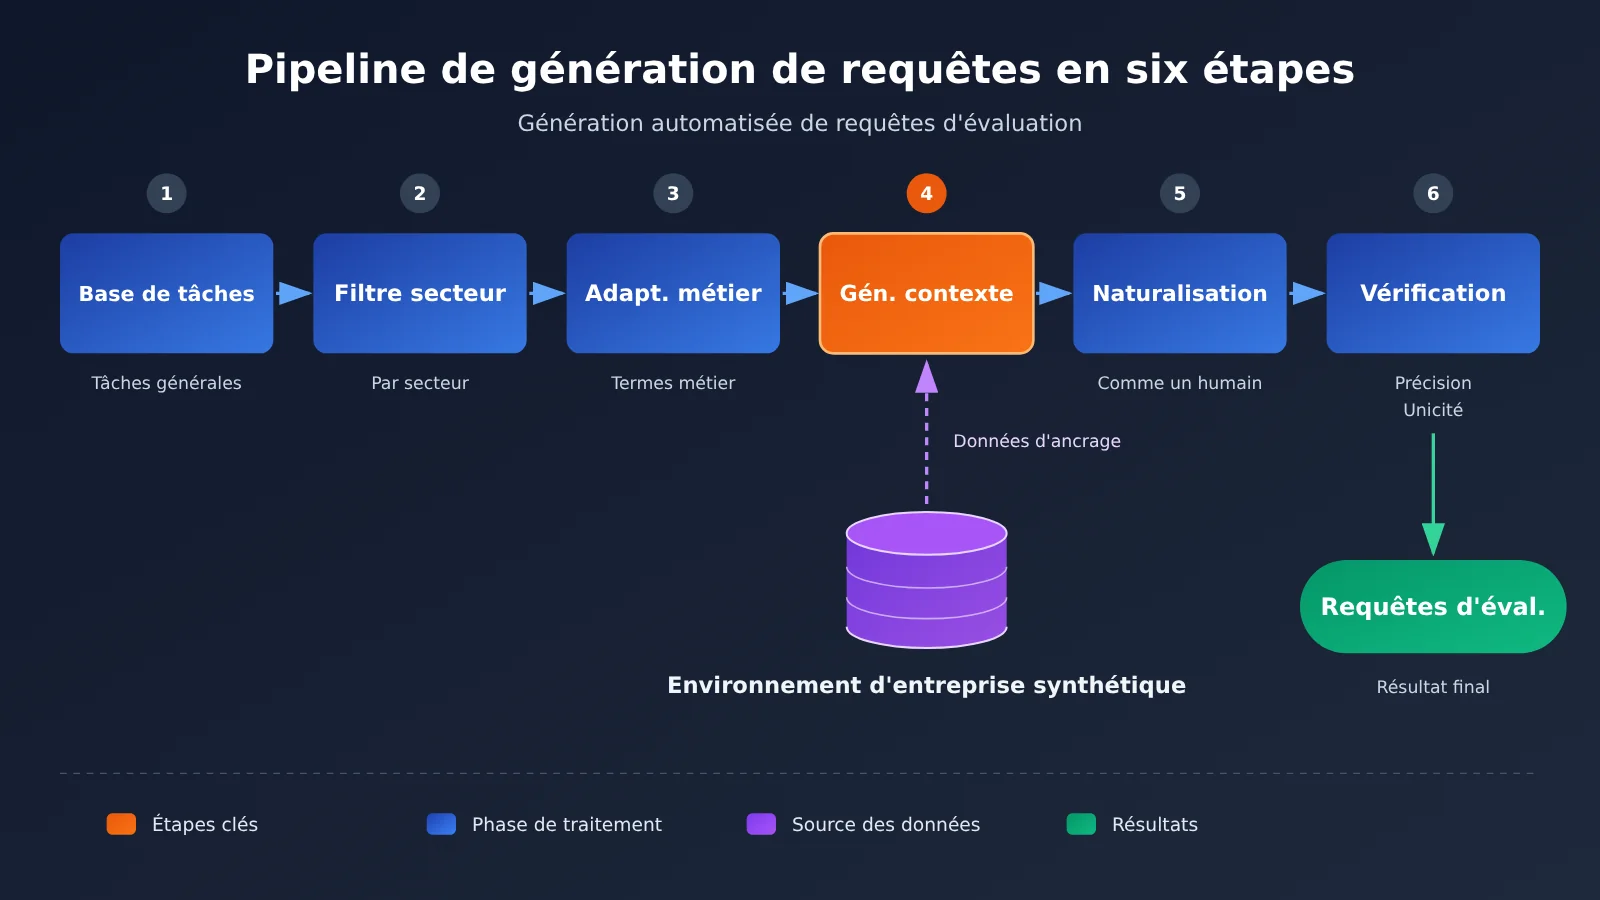
La 4e étape est essentielle : les requêtes doivent être ancrées dans des données précises de l’environnement, faute de quoi il est impossible de juger si les réponses sont correctes. L’« unicité » vérifiée à la 6e étape est aussi facile à négliger. Si les données permettent plusieurs réponses plausibles à une même question, l’évaluation risque d’être contestée.
Aux étapes 4 et 5, vous pouvez utiliser un modèle pour générer les questions, puis un autre pour les reformuler naturellement ou les valider. Cela permet de réduire les biais liés au fait qu’un même modèle pose les questions et y réponde. Avec l’interface compatible OpenAI d’APIYI apiyi.com, il suffit de modifier le nom du modèle pour en changer : le script de génération reste pratiquement identique.
🎯 Conseil technique : pour la génération des requêtes, fixez le modèle d’invite, le nom du modèle et les paramètres tels que la graine aléatoire, puis enregistrez-les dans un fichier de configuration. Lorsque vous changez de modèle pour une expérience comparative, seul le modèle lui-même varie. L’interface unifiée d’APIYI permet de passer d’un fournisseur à l’autre dans un même workflow pour générer et valider les requêtes.
Validation de la qualité des données synthétiques : d’abord les données, puis le modèle
Les données synthétiques doivent elles aussi être évaluées : un modèle peut obtenir un bon score simplement parce que les données sont trop faciles. Le texte original indique que la qualité est mesurée selon « trois dimensions » à l’aide d’un cadre interne d’évaluation sémantique, mais il en énumère en réalité quatre. Le tableau ci-dessous reprend ces quatre dimensions ; gardez cet écart à l’esprit si vous citez la source.
| Dimension de qualité | Question posée dans le texte original | Méthode de vérification concrète |
|---|---|---|
| Fidélité structurelle | La structure de l’organisation reflète-t-elle les véritables niveaux hiérarchiques, tailles d’équipe et relations transversales ? | Mesurer le nombre de niveaux hiérarchiques et la répartition des effectifs par équipe, puis les comparer à des données publiques |
| Pertinence contextuelle | Les requêtes et les workflows représentent-ils les usages réels en entreprise ? | Faire évaluer à l’aveugle un échantillon de requêtes par des professionnels métier, selon leur ressemblance avec de vraies questions |
| Réalisme comportemental | Les utilisateurs simulés présentent-ils des modes de communication et des dynamiques de collaboration proches de ceux des humains ? | Vérifier si les courriels contiennent des chaînes de réponses, et si les réunions donnent lieu à des désaccords et à des suivis |
| Sécurité du contenu | Le contenu est-il exempt d’éléments nuisibles, offensants ou permettant d’identifier une personne, sans usurper l’identité de personnes réelles ? | Détecter automatiquement les formats de noms, numéros de téléphone et numéros de pièces d’identité, puis procéder à une vérification humaine |
Selon le texte original, par rapport à la méthode de génération initiale, l’indicateur global de qualité a progressé de 39 %, et le score de qualité de certains environnements sectoriels a dépassé 0,9 sur 1,0. Le texte attribue cette amélioration à deux facteurs : l’intégration de signaux issus de secteurs réels et l’utilisation de l’indicateur global de qualité pour piloter une amélioration automatisée. Précision importante : ces scores mesurent à quel point les données synthétiques ressemblent à celles de véritables entreprises, et non les performances de Copilot lui-même. Le texte original ne divulgue pas les résultats de Copilot sur ces jeux de données.
Reproductibilité : la condition pour tester les régressions entre versions avec des jeux d’évaluation synthétiques
L’article d’origine relève quatre problèmes concrets en l’absence d’automatisation :
- Reproductibilité : les résultats d’un processus manuel varient légèrement à chaque fois, ce qui complique les comparaisons entre versions
- Échelle : le nombre de variantes de secteurs et de configurations dépasse ce qu’une équipe peut traiter manuellement
- Vitesse d’itération : la création manuelle prend plusieurs jours et retarde les retours
- Cohérence entre équipes : sans outils standardisés, les formats et la qualité des jeux de données ne sont pas compatibles d’une équipe à l’autre
Grâce à l’automatisation, la création d’un jeu de données, qui prenait plusieurs jours de travail manuel, s’exécute désormais automatiquement. Microsoft estime avoir économisé environ 100 000 dollars par jeu d’évaluation, soit environ 300 000 dollars pour l’ensemble du projet. Ces chiffres reflètent l’échelle de Microsoft et ne peuvent pas être appliqués directement à d’autres équipes. Selon l’article, le résultat le plus important est ailleurs : quelle que soit l’équipe qui relance la génération avec une même configuration, elle obtient exactement le même jeu de données.
C’est essentiel pour les tests de régression. Si vous modifiez la stratégie de recherche ou changez de modèle et que le score baisse, vous devez pouvoir déterminer si la variation vient du système, et non des données. Si le jeu de test est légèrement différent à chaque génération, la comparaison entre versions perd son sens.
Le même principe s’applique lorsque vous comparez plusieurs modèles candidats sur APIYI : fixez une version du jeu d’évaluation synthétique, puis utilisez-la pour évaluer chaque modèle séparément. Les résultats de la comparaison ne reflètent ainsi que les différences entre les modèles.
Guide de démarrage rapide pour créer un jeu d’évaluation d’entreprise synthétique en petite équipe
Le système de Microsoft repose sur l’historique complet des communications de plusieurs centaines d’utilisateurs, trois environnements sectoriels, une revue juridique et un répertoire de partage interne. Les petites équipes n’ont pas besoin de le reproduire à l’identique. Voici une version simplifiée de la méthode présentée dans l’article.
Étapes de création
- Définir le périmètre : choisissez un scénario métier, par exemple « questions-réponses sur les comptes rendus de réunion » ou « recherche dans les documents de projet », et limitez-vous à un seul secteur.
- Dessiner l’organisation : appuyez-vous sur des offres d’emploi publiques et des ressources sectorielles pour concevoir une organisation fictive de 20 à 50 personnes. Précisez les services, les niveaux hiérarchiques et les liens de reporting.
- Établir la chronologie : rédigez d’abord une chronologie du projet sur 4 à 8 semaines, avec les événements clés, les points de décision et les changements. Générez ensuite les comptes rendus, courriels et documents en respectant leurs dépendances chronologiques.
- Générer le contenu : utilisez un grand modèle de langage pour générer les documents un par un à partir de la chronologie. Ajoutez à chacun des métadonnées comme la date, l’auteur et les participants.
- Générer les requêtes : créez les questions selon le processus en six étapes présenté plus haut. Pour chacune, fournissez une réponse de référence et le numéro du document source, et signalez séparément les requêtes temporelles.
- Vérifier les données : contrôlez des échantillons selon les quatre dimensions de qualité. L’analyse des données personnelles identifiables (PII) doit porter sur l’ensemble du jeu de données.
- Gérer les versions : consignez la description de l’organisation, la chronologie, les invites, les noms des modèles et leurs paramètres dans une configuration, puis attribuez-lui un numéro de version.
- Lancer l’évaluation : exécutez le système testé sur une version figée du jeu de données et consignez les scores pour chaque type de requête.
🚀 Pour démarrer rapidement : les étapes 4 et 5 nécessitent des appels répétés à un grand modèle de langage. L’interface compatible OpenAI d’APIYI sur apiyi.com permet d’accéder à plusieurs modèles avec la même méthode d’appel. Vous pouvez ainsi utiliser un modèle pour la génération et un autre pour la vérification, en changeant simplement le nom du modèle.
Liste de vérification
- [ ] Les données d’évaluation ne contiennent aucune donnée réelle de clients ou d’employés
- [ ] L’organisation possède une hiérarchie et des collaborations entre services, plutôt qu’une simple liste de personnes
- [ ] Les données suivent une chronologie réaliste couvrant au moins plusieurs semaines, avec des liens de cause à effet entre les événements
- [ ] Une partie des requêtes porte sur le temps, avec des expressions comme « la semaine dernière » ou « depuis le dernier bilan »
- [ ] Les requêtes utilisent la terminologie et les types de documents propres au secteur
- [ ] Chaque requête dispose d’une réponse de référence unique et vérifiable, ainsi que de sa source
- [ ] La qualité des données synthétiques a été vérifiée avant leur utilisation
- [ ] Une même configuration permet de générer à nouveau le même jeu de données
Ce qui demande des moyens importants et ce qui peut être simplifié
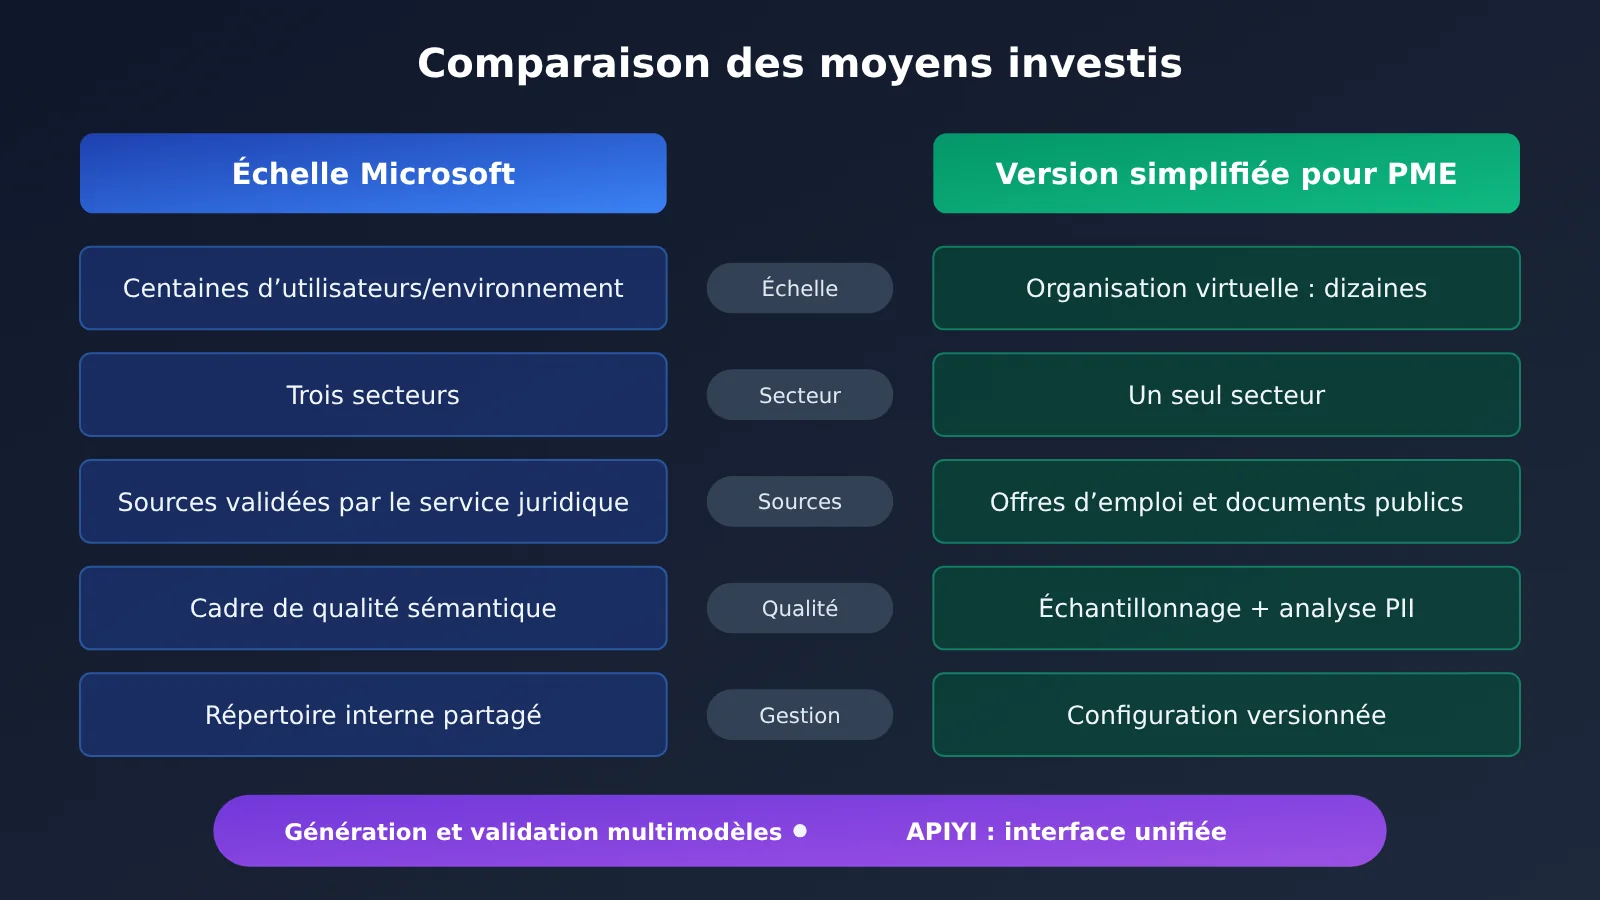
| Étape | Approche de Microsoft | Investissement | Recommandation pour les petites et moyennes équipes |
|---|---|---|---|
| Intégration de données publiques | O*NET, offres d’emploi et documents de la SEC, validés par le service juridique | Élevé | Rassembler manuellement des ressources sectorielles, en vérifiant que leur utilisation est autorisée |
| Taille de l’environnement | Plusieurs centaines d’utilisateurs par environnement, avec un historique complet des communications | Élevé | Quelques dizaines de personnes suffisent pour couvrir les principaux rôles |
| Couverture sectorielle | Trois secteurs | Moyen | Se limiter au secteur dans lequel l’équipe intervient |
| Cadre de qualité | Cadre interne d’évaluation sémantique et ensemble d’indicateurs | Élevé | Échantillonnage manuel + statistiques simples + analyse automatique des données personnelles (PII) |
| Structure temporelle | Organisation qui évolue dans le temps | Indispensable | Établir d’abord une chronologie, puis générer le contenu |
| Reproductibilité | Une même configuration produit les mêmes résultats | Indispensable | Versionner les configurations et mettre en cache les résultats générés |
La taille et le degré d’automatisation peuvent être réduits. En revanche, la structure temporelle, l’ancrage des requêtes et la reproductibilité restent indispensables : ce sont ces trois éléments qui déterminent si les résultats de l’évaluation peuvent servir à décider d’une mise en production. Il faut toutefois préciser qu’aucune documentation publique ne permet actuellement d’estimer le coût réel ou l’efficacité de cette approche pour les petites et moyennes équipes. Les recommandations ci-dessus sont déduites de la méthode présentée dans l’article d’origine.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’un jeu d’évaluation d’environnement d’entreprise synthétique ?
C’est un espace de travail d’entreprise simulé, entièrement généré par programme. Il comprend des employés, une structure organisationnelle, des réunions, des courriels et des documents, ainsi qu’un ensemble de requêtes d’évaluation fondées sur ces données. Il permet de vérifier si une application d’IA d’entreprise peut trouver, recouper et présenter les bonnes informations, sans accéder aux données réelles des clients.
Q2 : Quelle est la différence entre un jeu d’évaluation synthétique et un benchmark généraliste ?
Les benchmarks généralistes sont utiles pour comparer les capacités générales, mais ils ne tiennent pas compte des liens hiérarchiques, de l’historique des projets ni des processus propres à un domaine. Un environnement d’entreprise synthétique conserve ces structures et peut révéler des erreurs que les tests généralistes ne détectent pas, par exemple confondre les départements ou manquer une décision prise lors d’une réunion interfonctionnelle.
Q3 : Quand Microsoft a-t-elle rendu cette méthode publique ?
Microsoft Research a publié un article de blog sur le sujet le 30 octobre 2026. Selon l’article, la plateforme avait été mise à disposition dans un répertoire partagé interne et était devenue la première référence d’évaluation standardisée de Microsoft Copilot.
Q4 : À quels usages cette méthode convient-elle le mieux ?
– **Questions-réponses sur les comptes rendus de réunion** : vérifier la précision des résumés, de l’extraction des actions à mener et des citations
– **Recherche dans les connaissances de l’entreprise** : vérifier si le système trouve la seule source correcte parmi un grand nombre de documents
– **Requêtes temporelles** : tester des questions comme « Qu’a-t-on décidé la semaine dernière ? » ou « Qu’est-ce qui a changé récemment ? »
– **Tests de régression entre modèles ou versions** : comparer les anciennes et les nouvelles solutions sur un jeu de données fixe
Q5 : Comment comparer différents modèles avec le même jeu d’évaluation synthétique ?
L’essentiel est de garder la même version du jeu de données et de ne remplacer que le modèle testé. APIYI apiyi.com propose une interface unifiée compatible avec OpenAI, qui prend en charge plusieurs modèles courants. Il suffit de modifier le nom du modèle pour exécuter le même script d’évaluation sur chaque candidat. La logique de notation et le cadre d’évaluation restent toutefois à votre charge.
Q6 : Les données synthétiques risquent-elles de fausser les résultats ?
Oui, c’est possible. C’est pourquoi l’article prévoit un cadre qualité qui évalue d’abord les données, puis le modèle. Si les données synthétiques sont trop régulières et manquent de désaccords et de bruit réalistes, les scores du modèle peuvent être artificiellement élevés. Il est conseillé de faire évaluer des échantillons à l’aveugle par des experts métier et de calibrer régulièrement les données synthétiques à l’aide de retours réels désidentifiés.
Q7 : Quelles sont les limites connues de cette méthode ?
L’article ne dévoile pas les invites, les outils ou les détails d’implémentation des différentes étapes du pipeline, ni les métriques d’évaluation de Copilot. Le cadre qualité mentionne « trois dimensions », mais en énumère quatre. Le montant des économies provient d’une estimation de Microsoft. L’article indique aussi que les interactions avec des agents sur plusieurs tours, l’évolution d’une organisation sur plusieurs mois ou années et les systèmes d’IA capables d’exécuter des actions font partie des prochains défis d’évaluation à relever.
Points clés des jeux d’évaluation d’environnements d’entreprise synthétiques
- Trois couches indispensables : un environnement synthétique, la génération automatique de requêtes et la validation de la qualité des données. Sans l’une d’elles, l’évaluation n’est pas fiable.
- Calibrage à partir de données publiques : les bases de données sur les métiers, les offres d’emploi et les rapports financiers publics aident à créer une structure organisationnelle réaliste.
- Une chronologie indispensable : les requêtes temporelles exigent des données qui respectent l’ordre réel des événements et leurs liens de causalité.
- Des scénarios propres au secteur pour mieux détecter les problèmes : des requêtes adaptées au domaine révèlent plus facilement les défaillances qui lui sont propres.
- Tester les données avant le modèle : vérifiez les données synthétiques sous quatre angles : structure, contexte, comportement et sécurité.
- La reproductibilité, condition des tests de régression : une même configuration doit générer les mêmes données pour que les comparaisons entre versions aient un sens.
- Comparaison de plusieurs modèles : une fois le jeu de données fixé, l’interface unifiée d’APIYI permet de changer de modèle pour comparer les résultats.
Conclusion
L’approche de Microsoft Copilot pour créer des environnements d’entreprise synthétiques se résume en trois points :
- Protéger la confidentialité grâce aux données synthétiques : en n’utilisant aucune donnée client dès le départ, on peut partager et réutiliser librement les jeux de données entre équipes.
- Miser sur la structure pour gagner en réalisme : la hiérarchie de l’organisation, la chronologie et les processus propres au secteur déterminent la capacité de l’évaluation à déceler de vrais problèmes.
- Automatiser pour garantir la reproductibilité : une même configuration doit produire le même jeu de données pour que les résultats puissent éclairer les décisions de mise en production.
Les petites et moyennes équipes n’ont pas besoin de reproduire l’échelle de Microsoft. En revanche, elles ont tout intérêt à structurer la chronologie, à ancrer les requêtes dans les données et à versionner les configurations. Commencez par un scénario, un secteur et une organisation virtuelle de quelques dizaines de personnes. Réalisez un premier cycle complet, puis élargissez progressivement le périmètre.
Une fois le jeu de données fixé, APIYI apiyi.com permet d’accéder à plusieurs modèles avec la même méthode d’appel compatible OpenAI, puis de comparer directement leurs performances sur le même jeu d’évaluation synthétique.
📚 Références
- Microsoft Research Blog – From synthetic enterprise data evaluations to real Microsoft Copilot AI confidence : article original dont la méthode est analysée ici
- Lien :
microsoft.com/en-us/research/blog/from-synthetic-enterprise-data-evaluations-to-real-microsoft-copilot-ai-confidence -
Description : présente l’environnement synthétique, le pipeline en six étapes, le cadre qualité, la conception respectueuse de la confidentialité et les résultats
-
Base de données des professions O*NET : base d’informations sur les professions du département américain du Travail
- Lien :
onetonline.org -
Description : utilisée dans l’article original pour calibrer la répartition des rôles, responsabilités et activités des employés synthétiques
-
Recherche de documents publics SEC EDGAR : documents publiés par la Commission américaine des valeurs mobilières
- Lien :
sec.gov/edgar - Description : utilisée dans l’article original pour définir la taille, la structure des unités d’affaires et le contexte financier de l’organisation synthétique
Auteur : équipe technique APIYI
Échanges techniques : pour toute question sur l’accès unifié à plusieurs modèles, contactez-nous sur le site APIYI apiyi.com.