Note de l’auteur : découvrez comment l’architecture à deux niveaux Router + Worker de DeepSeek Super-agent sépare la coordination globale de l’exécution indépendante, et quand adopter une approche similaire dans votre système d’agents.
Si vous avez quatre ou cinq fenêtres de Coding Agent ouvertes en même temps, vous connaissez le problème. Une fenêtre corrige un bug de connexion, une autre examine une migration de base de données, une troisième attend les résultats de la CI. À vous de vous souvenir de ce que fait chaque fenêtre, de celles qui attendent votre réponse et des tâches liées entre elles. Les modèles gagnent en autonomie, mais la gestion de ces sessions repose toujours sur les humains.
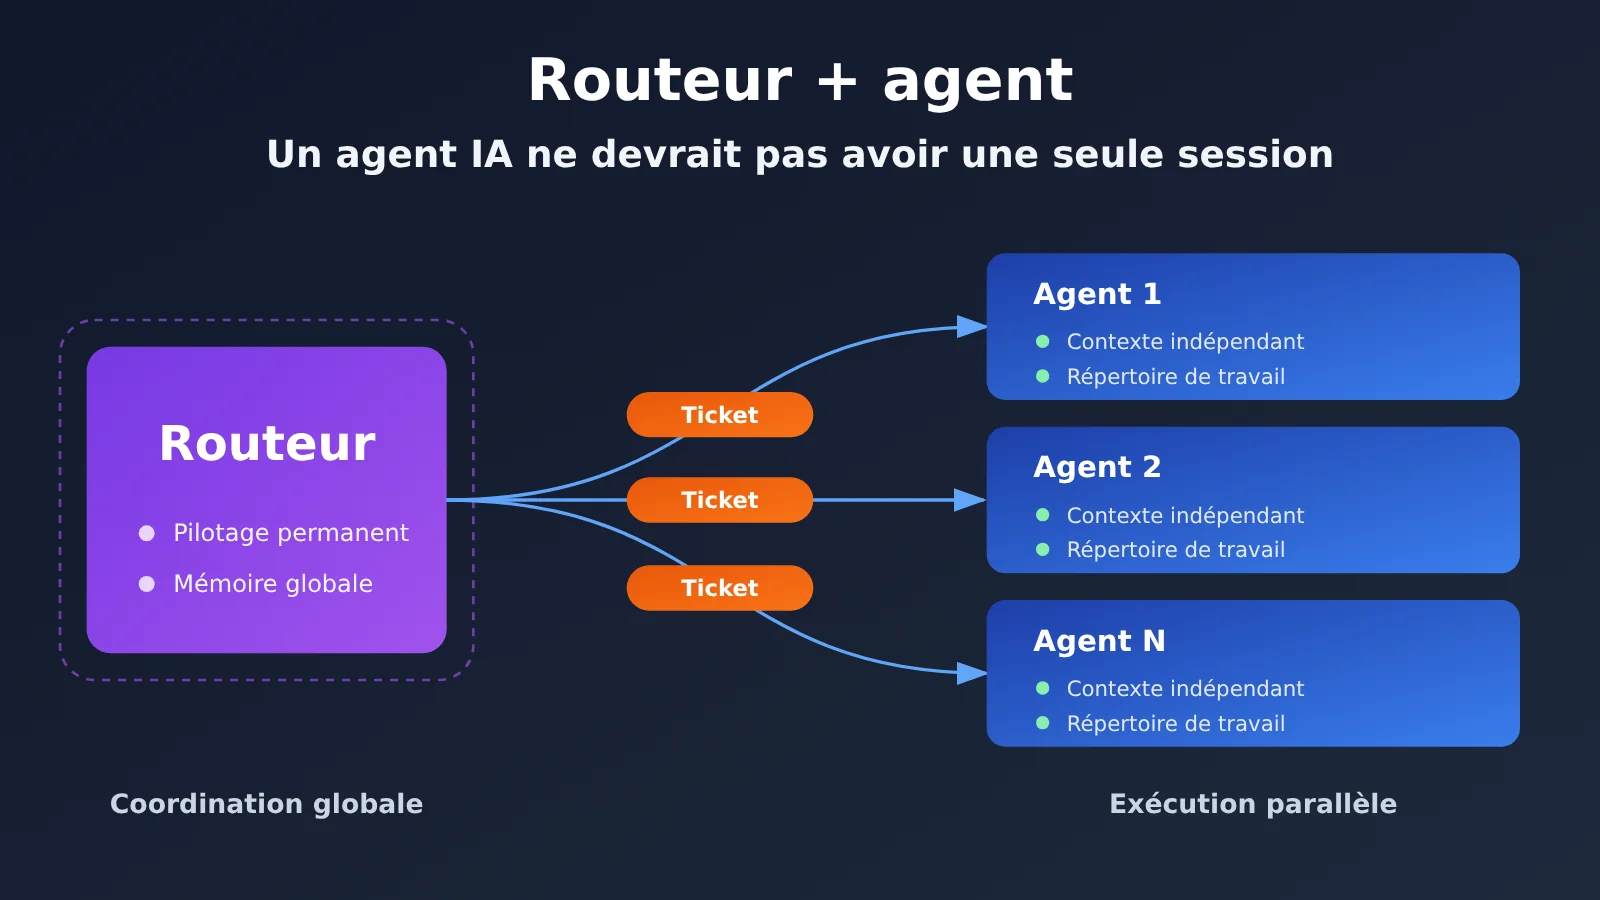
Le 31 octobre 2026, l’équipe DeepSeek Harness a publié l’article technique « Exploration de la conception de Super-agent : vers des systèmes d’agents plus autonomes » et rendu disponible en open source, sous licence MIT, le prototype de recherche dsh-superagent-prototype. Au cœur de ce projet se trouve une architecture à deux niveaux Router + Worker : un Router permanent assure la coordination globale, tandis que plusieurs Workers isolés exécutent les tâches.
Il ne s’agit pas simplement de « faire faire plus de choses à une IA en même temps ». L’intérêt de Super-agent est de séparer la coordination globale de l’exécution indépendante grâce à son architecture, afin d’alléger la gestion humaine des sessions multiples. En suivant le fil « problème — mécanisme — preuves — valeur pour l’ingénierie », cet article examine les motivations de cette architecture, ses mécanismes clés, les résultats expérimentaux officiels et leurs implications pour les appels API et la gestion des coûts.
À retenir : à la fin de cet article, vous comprendrez le problème que résout réellement l’architecture Router + Worker et saurez évaluer quand une approche similaire vaut la peine pour votre système d’agents.
Router + Worker : l’essentiel en bref
Avant d’examiner l’architecture, clarifions les faits essentiels de cette annonce. DeepSeek a publié en open source un prototype de recherche, et non un produit commercial officiel ni un nouveau modèle de base.
| Élément | Détails |
|---|---|
| Date de publication | 31 octobre 2026 (article technique et dépôt GitHub publiés le même jour) |
| Équipe | Équipe DeepSeek Harness |
| Nom du projet | dsh-superagent-prototype, principalement écrit en TypeScript, sous licence MIT |
| Positionnement | Prototype de recherche, non commercial, qui dépend de DeepSeek Harness pour fonctionner |
| Architecture | Structure à deux niveaux : orchestration globale par un Router et exécution isolée par des Workers |
| Fonctionnalités actuelles | Surveillance d’un dépôt GitHub unique, intégration facultative à Feishu, gestion des tickets, sessions Worker indépendantes et création de PR |
| Intérêt de la communauté | Environ 8 900 stars et 898 forks au 2 novembre (ces chiffres évoluent en permanence) |
DeepSeek définit quatre objectifs pour son Super-agent : Continuous (continuité du contexte entre les canaux), Productive (exécution parallèle de plusieurs tâches), Proactive (réponse proactive aux événements dans les limites des autorisations accordées) et Persistent (disponibilité continue et reprise après certaines erreurs). Ce sont des objectifs de conception : cela ne signifie pas que le prototype open source les remplit déjà tous.
Pourquoi un agent IA ne devrait pas se limiter à une seule session
Selon l’équipe DeepSeek, le principal frein des outils de programmation IA n’est plus tant la « capacité du modèle » que « l’attention humaine ». D’après ses observations au quotidien, une personne peut généralement suivre efficacement 3 à 5 sessions d’agents actives. Il s’agit d’une estimation fondée sur l’expérience de l’équipe, et non d’une statistique publique à grande échelle. Elle correspond néanmoins au ressenti de nombreux développeurs.
Le dilemme : une session unique ou plusieurs sessions
Les deux approches courantes ont chacune leurs limites. L’architecture Router + Worker vise à concilier la « continuité du contexte global » et la « capacité de traitement parallèle en arrière-plan ».
| Architecture | Avantages | Problème principal |
|---|---|---|
| Une seule session pour tout le travail | Continuité naturelle du contexte global | Les informations des différentes tâches interfèrent entre elles ; les appels d’outils longs bloquent les nouvelles tâches ; l’ensemble est limité à une seule boucle ReAct |
| Une session indépendante par tâche | Exécution parallèle et isolation des contextes | Absence de mémoire globale ; la personne doit garder en tête les liens entre les tâches ; les conversations et les notifications sont dispersées entre plusieurs fenêtres |
| Architecture à deux niveaux Router + Worker | État global centralisé et contextes d’exécution isolés | Consommation accrue de ressources de calcul ; le Router peut devenir un goulot d’étranglement |
Le problème d’une session unique, c’est l’« engorgement » ; celui de plusieurs sessions, c’est la « dispersion ». Dans le premier cas, une seule fenêtre de contexte doit accueillir les étapes intermédiaires de toutes les tâches. Dans le second, toute la coordination repose sur la personne. L’approche de DeepSeek consiste à introduire dans le système un rôle chargé de « garder une vue d’ensemble », afin que les agents d’exécution puissent se concentrer sur leurs tâches.
Comment fonctionne l’architecture à deux niveaux Router + Worker
Router : la couche de coordination globale
Le Router est une couche logique qui fonctionne en continu. Dans les explorations architecturales actuelles de l’équipe officielle, il prend principalement la forme d’une session LLM permanente, mais le concept ne se limite pas nécessairement à une session de modèle. Son rôle consiste à coordonner plutôt qu’à exécuter :
- recevoir les messages des utilisateurs et les événements externes provenant notamment de GitHub, de la messagerie instantanée et de la CI ;
- maintenir les liens entre les tâches et déterminer s’il faut créer un nouveau travail ;
- vérifier les autorisations, attribuer les tâches aux Workers et assurer la coordination entre elles ;
- rassembler les informations à transmettre aux humains et, si nécessaire, retrouver le contexte d’anciennes tâches.
Un détail important : selon l’équipe officielle, le Router pourrait même se passer de l’outil Bash. En ne lui confiant pas directement des tâches de programmation complexes, on évite qu’il soit bloqué par de longs appels d’outils. Par ailleurs, ses tâches ne nécessitent pas toujours le modèle de raisonnement le plus puissant : un modèle plus léger peut parfois suffire pour les interactions et la répartition des tâches. C’est ce qui permet techniquement d’utiliser différents modèles selon les rôles.
Worker : la couche d’exécution isolée des tâches
Le Worker réalise le travail proprement dit. Dans le prototype public, chaque Ticket correspond à une session Executor et dispose de son propre répertoire de travail. Dans les limites de ses autorisations, le Worker modifie le code, exécute les tests et traite les retours. Une fois le travail terminé, il produit un Report ; si une décision humaine est nécessaire, il définit un état Attention. Le résultat est transmis par le canal d’origine, par exemple une PR GitHub.
Les contextes de modèle des Workers sont indépendants les uns des autres, ce qui évite de mélanger les étapes intermédiaires de plusieurs tâches dans une même fenêtre. Attention toutefois : des sessions et des répertoires séparés ne constituent pas une isolation de sécurité forte. La documentation officielle de déploiement précise que, par défaut, les Workers exécutent les commandes sous l’identité de l’utilisateur du système d’exploitation qui les utilise.
Le parcours d’une Issue GitHub dans le système Router + Worker
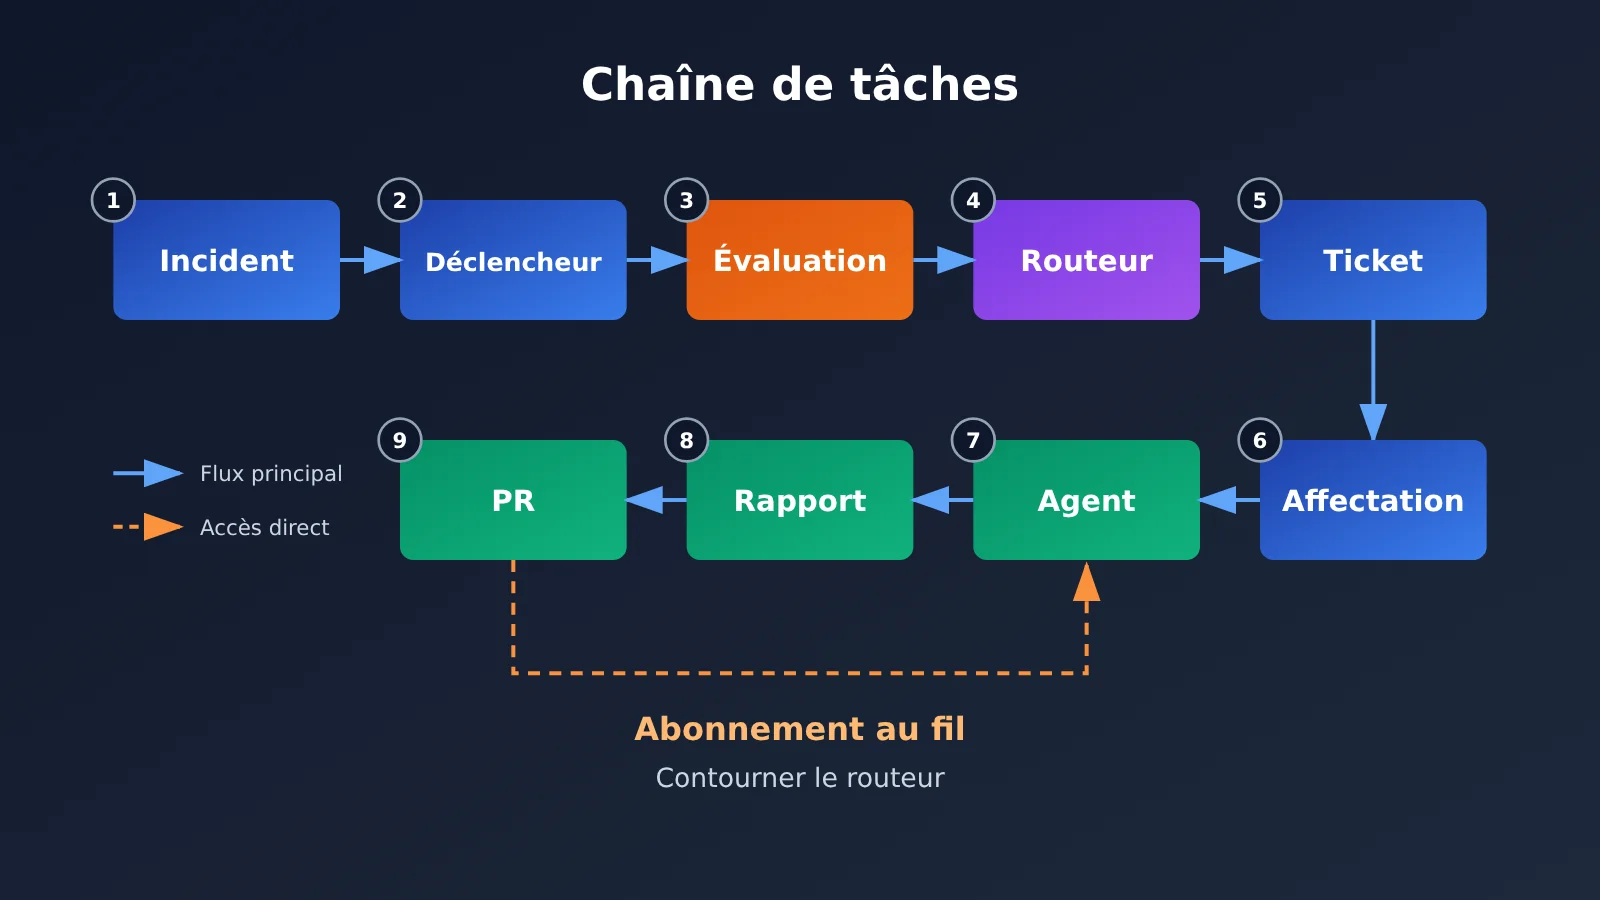
D’après le modèle de domaine de l’implémentation open source, la chaîne de traitement peut se résumer ainsi : Source → Trigger → Eval → Decision → Ticket → Assignment → Executor → Report. Prenons l’exemple d’un utilisateur autorisé qui demande la correction d’un bug dans une Issue GitHub :
- La Source GitHub reçoit un commentaire sur l’Issue et produit un Trigger ;
- Le système filtre d’abord les autorisations à l’aide de règles déterministes, puis le modèle détermine si la demande satisfait aux règles de prise en charge ;
- Le Router accepte la tâche et crée un Ticket, dans lequel sont consignés son périmètre et ses autorisations (Mandate) ;
- Le système crée une Assignment pour le Ticket et l’attribue au Worker concerné ;
- L’Executor effectue la correction dans un répertoire et une session distincts ;
- Le Worker rend compte de sa progression ou soumet son résultat en créant une PR ;
- Le système transmet le résultat à l’utilisateur dans le fil de l’Issue ou de la PR d’origine.
Si l’utilisateur demande ensuite des modifications dans cette PR, le nouveau message peut être automatiquement associé à la tâche initiale. Il n’a donc pas à rechercher quelle session d’agent s’en occupait : c’est un exemple concret de la façon dont l’architecture à deux niveaux allège la charge de gestion humaine.
Les 4 choix de conception clés de Router + Worker
L’architecture à deux niveaux n’est que le squelette : ce sont plusieurs choix d’ingénierie ciblés qui la rendent exploitable. Chacun répond à un problème précis :
| Conception | Problème d’ingénierie résolu | Mécanisme principal |
|---|---|---|
| Acheminement direct par abonnement aux Threads | Tous les messages suivants passent par le Router, ce qui surcharge le nœud central | Le Worker s’abonne aux Threads dont il est responsable et reçoit directement les événements associés |
| Traitement par lots du Router | Lors d’un pic d’événements, le traitement unitaire par le Router limite le débit | Les Triggers accumulés pendant le raisonnement sont regroupés et analysés en un seul lot |
| Inline & Spill | La fenêtre de contexte est limitée et l’injection de toutes les données coûte cher | Les informations récentes indispensables sont placées dans la fenêtre ; les contenus longs ne sont conservés que sous forme de résumé et de pointeur de lecture |
| Rappel en chaîne | Les informations sur les tâches passées sont difficiles à retrouver | Les associations entre Trigger, Thread, Ticket et Worker permettent de remonter progressivement dans l’historique |
Acheminement direct par abonnement aux Threads : réduire les réaffectations du Router
Supposons que le Worker A soit responsable d’une PR. Les commentaires et les résultats CI ultérieurs de cette PR peuvent lui être transmis directement, en fonction du Thread auquel ils appartiennent. Le Router n’a donc pas à prendre une nouvelle décision pour chaque message associé. C’est une façon classique de décharger le nœud central de décisions fréquentes mais de faible valeur.
Cet acheminement direct a toutefois une limite d’autorisation claire. La documentation officielle précise que les messages reçus par abonnement peuvent fournir du contexte, mais ne peuvent pas élargir le Mandate du Ticket d’origine. Si un commentaire ultérieur demande un nouveau travail en dehors du périmètre autorisé, le Worker doit le renvoyer au système pour réévaluation. C’est important pour se protéger contre les instructions non autorisées présentes dans des commentaires externes.
Traitement par lots du Router : absorber les pics d’événements
Lorsque le Router effectue une étape de raisonnement, les nouveaux Triggers sont mis en attente, puis analysés ensemble lors de l’étape suivante. On passe ainsi d’une invocation du modèle par message à plusieurs messages traités par étape de raisonnement. Lorsque les événements sont nombreux, cela réduit nettement le coût de raisonnement par décision.
Inline & Spill et rappel en chaîne : utiliser le contexte comme un cache
DeepSeek considère la fenêtre de contexte comme une forme de cache. Inline consiste à y placer directement les informations récentes susceptibles d’être utiles, comme les derniers commentaires sur la tâche en cours, les lignes de code pertinentes et le code environnant nécessaire. Spill consiste à laisser hors de la fenêtre les contenus peu utilisés ou trop longs, comme une longue discussion passée, en ne conservant qu’un résumé, les ID associés et un point d’accès pour les lire. Quant aux anciens messages sans rapport avec la tâche, il n’est pas nécessaire de les injecter à chaque fois.
Cette approche se prolonge avec le Chain of Recall (rappel en chaîne) : le modèle peut suivre les liens entre les objets Trigger → Thread → Ticket → Worker pour retrouver progressivement les informations historiques dont il a besoin. Cette méthode économise davantage de contexte que l’injection systématique de l’historique complet et se rapproche d’une recherche par index dans une base de données. L’équipe officielle reconnaît toutefois que la mémoire sur plusieurs mois, voire plus longtemps, reste un problème non résolu.
Analyse des résultats expérimentaux Router + Worker
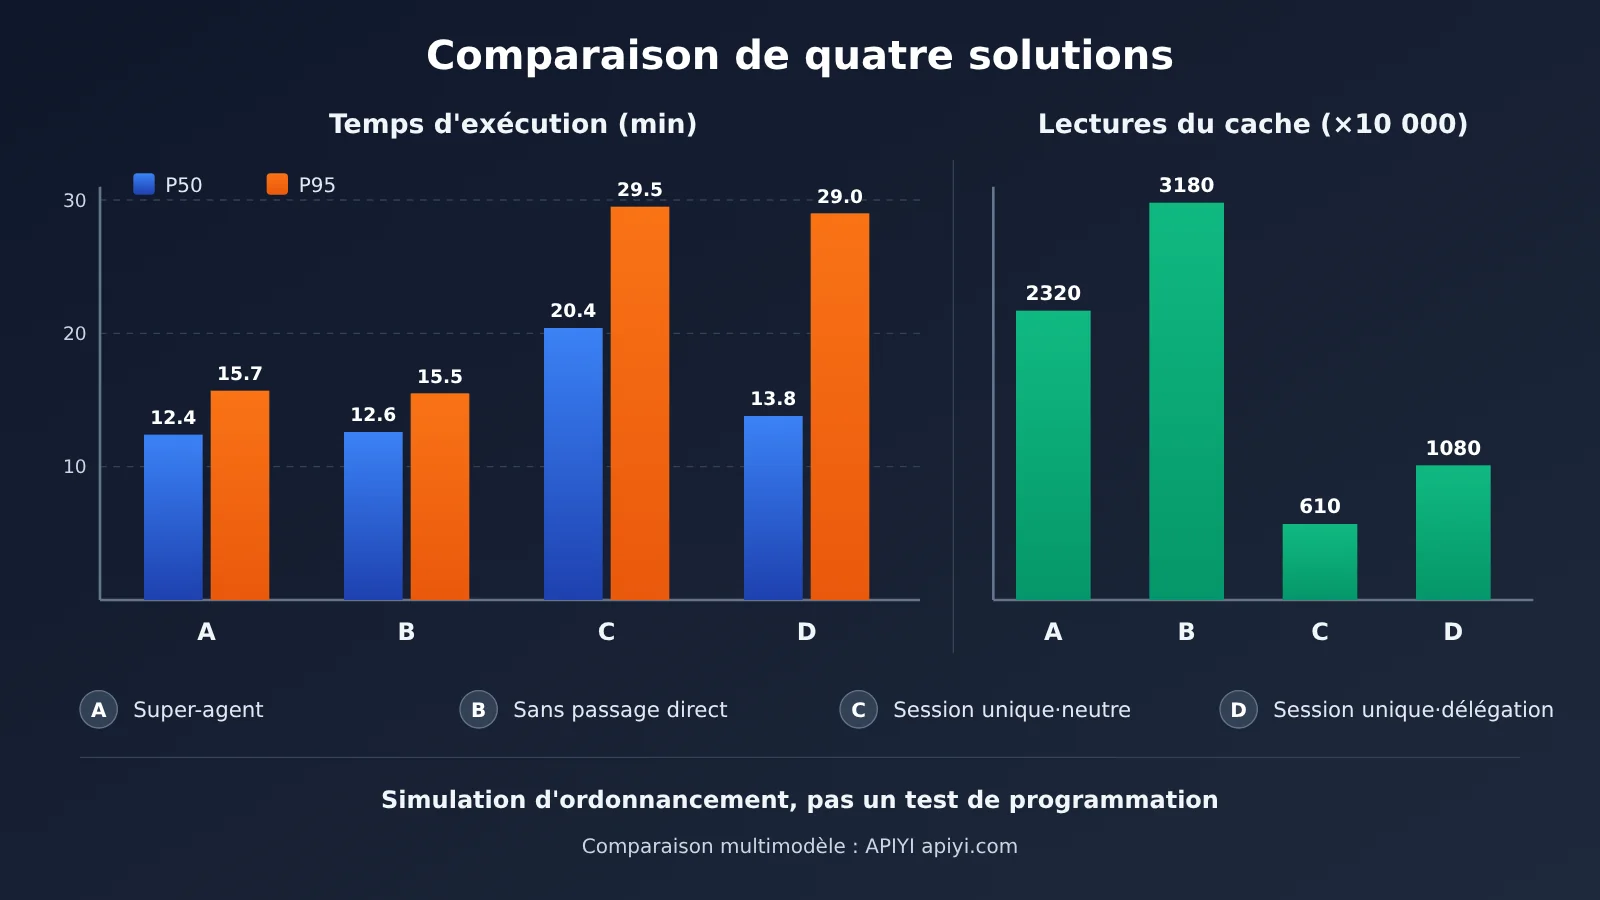
DeepSeek a mené une première série d’expériences avec une charge synthétique. Chaque simulation comportait environ 300 messages, dont une vingtaine de demandes de travail. Le reste se composait de conversations informelles, de retours, de demandes d’annulation et de messages CI. Chaque configuration a été exécutée 5 fois. Le travail de programmation était remplacé par des outils simulés prenant du temps à s’exécuter : ces résultats mesurent donc les performances du système d’orchestration, pas la qualité du code généré.
Comparaison de l’orchestration de bout en bout
| Configuration | Temps de réalisation P50 | Temps de réalisation P95 | Tokens lus en cache par expérience |
|---|---|---|---|
| Super-agent | 12,4 minutes | 15,7 minutes | Environ 23,2 millions |
| Super-agent, sans transmission directe des abonnements | 12,6 minutes | 15,5 minutes | Environ 31,8 millions |
| Session unique + Subagent, invite neutre | 20,4 minutes | 29,5 minutes | Environ 6,1 millions |
| Session unique + Subagent, délégation prioritaire | 13,8 minutes | 29,0 minutes | Environ 10,8 millions |
Par rapport à la configuration à session unique avec invite neutre, Super-agent réduit le temps de réalisation P50 d’environ 39 % et le P95 d’environ 47 %. Face à la configuration à session unique avec délégation prioritaire, son avantage au P50 est modeste, mais la traîne au P95 est nettement plus courte. Autrement dit, le principal bénéfice de l’architecture à deux niveaux est d’éviter que les tâches les plus lentes s’éternisent.
La contrepartie est tout aussi claire : Super-agent lit environ 3,8 fois plus de tokens en cache que la configuration à session unique avec invite neutre. Il utilise davantage de sessions parallèles et de ressources d’inférence pour obtenir des temps de réalisation plus courts et plus stables. Cela ne signifie pas pour autant que le coût total est multiplié par 3,8 : la dépense réelle dépend aussi du tarif des modèles, du taux de correspondance du cache, des tokens d’entrée ordinaires et de sortie, du choix des modèles pour le Router et les Workers, ainsi que des appels aux outils. L’équipe n’a pas encore publié le coût API moyen pour des demandes réelles.
Le test d’ablation sur la transmission directe des abonnements mérite aussi qu’on s’y attarde. Sans cette transmission directe, le nombre de décisions à traiter par le Router augmente d’environ 30 %, et le nombre de tokens lus en cache d’environ 37 %, tandis que le temps de réalisation reste presque inchangé. Conclusion : dans ce test, la transmission directe des abonnements réduit surtout le nombre d’invocations du modèle par le Router et la charge liée au contexte, plutôt que d’accélérer directement le traitement.
Test de charge du traitement par lots du Router
Dans cette série de tests, le Router utilise un modèle réel et les Workers utilisent des modèles simulés :
| Indicateur | Faible densité d’événements | Forte densité d’événements |
|---|---|---|
| Vitesse d’arrivée des événements | Environ 1 par minute | Environ 40 par minute |
| Taille moyenne des lots | 1,0 | 2,8 |
| Durée d’une requête au modèle | 2,5 secondes | 3,9 secondes |
| Temps d’inférence moyen par décision | 6,4 secondes | 1,6 seconde |
Quand la densité d’événements augmente, chaque requête devient plus lente, mais le temps d’inférence moyen par décision diminue. Le traitement par lots améliore donc le débit effectif. La conclusion officielle reste prudente : à la taille actuelle de l’équipe, un seul Router suffit pour le moment, mais cela ne veut pas dire qu’un Router peut traiter un nombre illimité de messages.
Impact de l’architecture Router + Worker pour les développeurs
Répartition des modèles : un modèle léger pour le Router, un modèle adapté à chaque tâche pour le Worker
La leçon technique la plus directe de cette architecture à deux niveaux : tous les rôles n’ont pas besoin du même modèle. Le Router s’occupe principalement de classification, de répartition et de synthèse. Un modèle rapide et peu coûteux lui convient donc bien. Pour le Worker, on choisit un modèle doté de capacités de raisonnement plus solides selon la complexité de la tâche. Le prototype permet d’ailleurs de définir séparément le fournisseur et le modèle du Router et du Worker.
Voici un exemple minimal qui utilise une interface compatible OpenAI pour permettre au Router de décider comment répartir une tâche :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 切换多家模型
)

ROUTER_MODEL = "your-fast-cheap-model"   # 替换为控制台中可用的轻量模型名

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
Voir l’exemple de code d’invocation par niveau Router + Worker
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 角色与模型分层:模型名请替换为你实际可用的模型
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # 按 Ticket 记录 Token 消耗

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 Conseil technique : pour construire un agent à plusieurs niveaux, testez d’abord les performances des modèles légers et des modèles de raisonnement avancés dans les rôles de Router et de Worker, avec une même clé API via APIYI apiyi.com. Vous pourrez ensuite choisir votre configuration sans utiliser systématiquement le modèle le plus coûteux pour tous les rôles.
Maîtriser les coûts : suivre chaque Ticket plutôt que le total
Les expériences officielles montrent qu’une architecture à deux niveaux consomme davantage de ressources d’inférence. Il faut donc suivre les coûts plus finement. Voici quelques pratiques utiles :
- Suivre les jetons par Ticket : distinguez le coût des décisions du Router de celui de l’exécution par les Workers pour repérer les tâches les plus coûteuses ;
- Distinguer les types de frais : comptabilisez séparément les frais des modèles, des outils (recherche, récupération de pages web, etc.) et de l’environnement d’exécution ;
- Surveiller les accès au cache : la majorité des jetons du Super-agent correspond à des lectures depuis le cache. Or, le prix unitaire peut varier fortement selon que les données sont présentes ou non dans le cache : chez DeepSeek, les tarifs officiels diffèrent d’un facteur de plusieurs dizaines ;
- Réduire les décisions inutiles : en s’inspirant du principe d’abonnement direct, envoyez les événements suivants directement au Worker responsable pour éviter que le Router ne les répartisse à nouveau.
💰 Optimisation des coûts : l’exécution de plusieurs Workers en parallèle peut multiplier le nombre d’appels. Avec la facturation à l’usage d’APIYI apiyi.com pour accéder aux modèles de différents fournisseurs, vous pouvez comparer sur une même facture les dépenses réelles par rôle et par modèle, puis optimiser plus facilement les coûts à chaque niveau.
Quand adopter Router + Worker
Une architecture à deux niveaux n’est pas forcément meilleure parce qu’elle est plus complexe. Voici quelques repères :
- Adaptée : plusieurs tâches indépendantes coexistent (par exemple, le Ticket A corrige un bug, le Ticket B examine une migration et le Ticket C gère la CI), et des événements provenant de plusieurs canaux nécessitent une réponse continue ;
- Peut attendre : les tâches sont peu nombreuses, fortement interdépendantes ou concernent surtout la répartition du travail autour d’une seule tâche complexe. Un Agent unique ou une Agent Team classique consommera moins de ressources ;
- Infrastructure à mettre en place d’abord : si l’isolation des permissions, la gestion des conflits de modification de fichiers et les journaux de facturation par tâche ne sont pas encore prêts, lancer des opérations en parallèle risque d’amplifier les problèmes.
Il faut aussi noter que Router + Worker et une Agent Team classique ne poursuivent pas tout à fait le même objectif. Une Agent Team classique répartit souvent une tâche complexe entre des rôles comme la recherche, le développement et les tests. Le Router du Super-agent sert plutôt à coordonner plusieurs tâches indépendantes, sans entrer dans les détails techniques de chacune. La documentation officielle précise aussi que si la session principale d’une Agent Team classique se limite à centraliser les échanges et à répartir les tâches, elle peut former une structure similaire : l’architecture à deux niveaux n’est pas propre à DeepSeek.
Limites de l’architecture Router + Worker et périmètre du prototype
Dans ce type d’analyse, l’erreur la plus facile à commettre consiste à prendre la vision complète décrite dans les documents de conception pour des fonctionnalités déjà présentes dans le prototype open source. Il faut bien distinguer les éléments suivants :
- Déjà pris en charge par le prototype : surveillance d’un seul dépôt GitHub, intégration optionnelle à Feishu, gestion des tickets, sessions et répertoires Worker indépendants, génération de PR, affichage des tâches nécessitant une intervention humaine dans le tableau de bord et reprise du travail à partir des messages suivants ;
- Prévu dans la conception, mais sans preuve d’une implémentation complète : gestion automatique de plusieurs dépôts, fonctionnement continu dans le cloud et environnements accessibles depuis plusieurs appareils au niveau production, réparation autonome complète par un Watchdog indépendant ; la boucle ReAct asynchrone est implémentée dans le Harness, mais n’est pas encore activée par défaut ;
- Une proactivité encadrée : les tâches déduites utilisent par défaut le mode
observe, qui les consigne sans les exécuter ; la fusion automatique des PR est désactivée par défaut.
Plusieurs difficultés architecturales restent ouvertement reconnues. La première est le passage à l’échelle avec un seul Router : l’équipe indique seulement que cette solution suffit à sa taille actuelle, sans réponse sur la répartition à plus grande échelle. La deuxième est la mémoire à long terme : Inline & Spill et le rappel en chaîne répondent aux besoins de contexte à court et moyen terme, mais la mémoire sur plusieurs mois reste un problème non résolu. La troisième concerne les limites des autorisations : par défaut, le Router et les Workers fonctionnent en mode danger-full-access et exécutent les opérations sous le compte système de l’opérateur. L’équipe recommande donc d’utiliser un compte système distinct. L’injection d’invite par des commentaires externes et la gestion des identifiants figurent également parmi les problèmes à résoudre. Un rapport d’audit tiers du code source, portant sur un commit précis, a aussi circulé dans la communauté, mais le déroulement complet de l’attaque n’a pas été reproduit indépendamment : il faut donc le considérer comme un risque potentiel.
Les tests de la communauté confirment également qu’il s’agit bien d’un prototype : un utilisateur a réussi à parcourir tout le processus, de l’Issue à la PR, après un clonage initial et en suivant SETUP.md. Il a aussi signalé des problèmes de reconnaissance des processus Node.js 24, des messages manqués en raison de délais dans les notifications GitHub et des assertions de test qui échouent lorsque la langue du système est le chinois.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que l’architecture à deux niveaux Router + Worker ?
C’est la structure de base de DeepSeek Super-agent : le Router est une couche permanente de coordination globale qui reçoit les événements, maintient les liens entre les tâches et distribue le travail. Les Workers constituent la couche d’exécution isolée : chaque Ticket est traité dans une Session et un répertoire distincts. L’idée centrale est de séparer la coordination globale de l’exécution indépendante.
Q2 : Quelle est la différence entre Router + Worker et une équipe multi-agents classique ?
Une équipe d’agents classique répartit généralement une tâche complexe entre des rôles comme la recherche, le développement et les tests. Router + Worker met plutôt l’accent sur la coordination de plusieurs travaux indépendants, sans que le Router entre dans les détails de chaque tâche. Si la session principale d’une équipe classique se limite aux échanges centralisés et à la répartition entre les tâches, elle peut aussi former une structure similaire à deux niveaux.
Q3 : L’expérience officielle prouve-t-elle que Super-agent améliore l’efficacité du développement de 47 % ?
Non. L’expérience utilisait des outils de développement simulés, avec seulement cinq exécutions par approche. Elle mesurait le temps nécessaire pour terminer l’ordonnancement des tâches, et non la qualité du code ou les capacités de programmation. La baisse d’environ 47 % du P95 indique seulement que les délais les plus longs sont plus courts pour cette charge de travail synthétique. On ne peut pas en déduire un gain d’efficacité en développement réel, ni s’en servir pour comparer les capacités de programmation avec celles de Claude Code ou Codex.
Q4 : Router + Worker coûte-t-il moins cher ?
Pas nécessairement. Dans l’expérience synthétique officielle, le volume de lecture du cache de Super-agent était environ 3,8 fois supérieur à celui de l’approche neutre à session unique : il utilise davantage de ressources pour gagner en rapidité et en stabilité. Les économies possibles reposent sur une répartition des modèles : un modèle léger pour le Router, et des modèles choisis selon la complexité pour les Workers. Avec APIYI sur apiyi.com, vous pouvez mesurer les coûts réels de différentes combinaisons de modèles via une interface unifiée, puis choisir le meilleur compromis.
Q5 : Comment tester rapidement la répartition des modèles entre Router et Workers dans mon projet ?
Voici les étapes conseillées :
1. Créez un compte sur APIYI, apiyi.com, pour obtenir une clé API et un crédit de test gratuit ;
2. Utilisez le code de cet article et définissez `base_url` sur `https://api.apiyi.com/v1` ;
3. Configurez des modèles différents pour le Router et les Workers, puis relevez la consommation de tokens par Ticket et comparez les résultats.
L’interface compatible avec OpenAI permet de changer de modèle en modifiant simplement le paramètre `model`.
Q6 : Le prototype open source peut-il être utilisé directement en production dans une entreprise ?
Ce n’est pas recommandé pour le moment. Il s’agit d’un prototype de recherche : les Workers s’exécutent par défaut avec les privilèges élevés de l’opérateur, GitHub Enterprise Server n’est pas pris en charge et la communauté a signalé des défauts, notamment des notifications manquantes, ainsi que des problèmes de sécurité potentiels. Il vaut mieux l’utiliser dans un environnement isolé pour tester la conception des workflows.
Router + Worker : les points clés
- Positionnement : le super-agent est une architecture système construite autour des modèles ; le code ouvert est celui d’un prototype de recherche, pas d’un produit commercial ;
- Le vrai problème : le goulot d’étranglement se déplace des capacités du modèle vers l’attention humaine. Une seule session sature, tandis que plusieurs sessions dispersent l’attention ;
- Séparation des rôles : le Router assure uniquement la coordination globale, parfois même sans accès à Bash. Les Workers exécutent leurs tâches de façon autonome dans des sessions isolées ;
- Mécanismes clés : la transmission directe des abonnements décharge le Router d’une partie des décisions, le traitement par lots amortit le coût de l’inférence, et Inline & Spill traite le contexte comme un cache ;
- Limites des résultats : les expériences d’ordonnancement montrent que les tâches les plus longues se terminent plus vite, mais consomment davantage de tokens. Elles ne mesurent pas les capacités de programmation ;
- Pour commencer : l’interface unifiée d’APIYI apiyi.com permet de configurer différents modèles selon les rôles et de suivre les coûts par ticket.
Conclusion
Avec Router + Worker, DeepSeek répond à la question : « Pourquoi un agent IA ne devrait-il pas se limiter à une seule session ? »
- Intérêt de l’architecture : séparer la coordination globale de l’exécution autonome permet au système de garder la trace des liens entre les tâches, plutôt que de laisser cette charge à l’utilisateur ;
- Conception technique : la transmission directe des abonnements, le traitement par lots, Inline & Spill et le rappel en chaîne répondent respectivement aux problèmes de charge centrale, de débit en cas de pics, de capacité du contexte et de rappel de l’historique ;
- Du recul sur les résultats : les expériences démontrent un compromis entre efficacité de l’ordonnancement et consommation de ressources. Le passage à l’échelle avec un seul Router, la mémoire à long terme et l’isolation des autorisations restent à résoudre.
Si votre système doit déjà gérer plusieurs tâches indépendantes en parallèle, l’architecture à deux niveaux mérite votre attention. Si les tâches sont peu nombreuses et concentrées, un agent unique reste plus économique. Quelle que soit la structure choisie, la répartition des rôles entre différents modèles et le suivi des coûts par tâche sont essentiels pour maîtriser les dépenses.
Vous pouvez utiliser APIYI apiyi.com pour tester rapidement différents modèles dans les rôles de Router et de Worker. La plateforme propose une interface compatible OpenAI, une facturation à l’usage et un crédit d’essai gratuit pour les nouveaux utilisateurs.
📚 Références
- Article officiel de DeepSeek sur l’architecture : Exploration de la conception d’un super-agent : vers des systèmes d’agents plus autonomes
- Lien :
x.com/DeepSeekHarness/article/2116857257245987236 -
Description : source primaire sur l’architecture à deux couches, les cinq modules, les données expérimentales et les questions non résolues
-
Dépôt GitHub officiel de DeepSeek : dsh-superagent-prototype
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype -
Description : état du projet, code source, licence et cas d’usage actuellement pris en charge
-
Documentation open source du Domain Model : objets de tâche et modèle de flux
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Description : définition des concepts clés, notamment Source, Trigger, Ticket et Assignment
-
Documentation sur les autorisations et les abonnements : règles de Mandate et d’abonnement aux Thread
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Description : explication officielle précisant que l’abonnement aux messages ne peut pas étendre les autorisations
-
Documentation de déploiement : dépendances, comptes et conseils de sécurité
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
Description : mode d’exécution avec privilèges élevés et recommandation d’utiliser un utilisateur système distinct
-
Tarification officielle de l’API DeepSeek : prix des modèles et des outils
- Lien :
api-docs.deepseek.com/quick_start/pricing - Description : différence de prix selon que les données sont présentes ou non dans le cache, pour aider à estimer les coûts
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI, apiyi.com, pour discuter des architectures d’agents et des pratiques d’invocation de plusieurs modèles. Retrouvez plus de ressources dans le centre de documentation docs.apiyi.com.