Note de l’auteur : cet article décrypte les mécanismes clés de l’architecture événementielle de DeepSeek Super-agent. Il distingue les fonctionnalités du prototype déjà publiées en open source, les cas d’usage internes de DeepSeek et les pistes d’architecture futures, puis examine la valeur produit et les compromis techniques des agents proactifs.
Imaginez une discussion de groupe entre développeurs. Quelqu’un lance au passage : « La page de connexion ne s’ouvre encore plus dans Safari. » Personne ne mentionne le robot avec un @, personne ne crée d’Issue. Un peu plus tard, une courte notification apparaît dans le groupe : le problème a été reproduit, sa cause identifiée et une PR corrective préparée, en attente de révision. Selon un article technique officiel de DeepSeek, cette façon de « reproduire et corriger en silence » fait déjà partie des stratégies de travail utilisées dans les discussions de groupe internes de DeepSeek Harness.
Ce n’est pas l’histoire d’une « IA qui commence à agir de son propre chef ». Le changement clé avec DeepSeek Super-agent, c’est que le système peut surveiller en continu les événements externes, repérer le travail à faire et s’y préparer dans le cadre de permissions et de règles clairement définies, puis livrer les résultats au bon moment. Le contrôle des autorisations et l’exécution proactive sont conçus ensemble : l’un ne va pas sans l’autre.
Ce que vous allez en retirer : à la fin de cet article, vous connaîtrez les 5 mécanismes clés de l’architecture événementielle de Super-agent. Vous saurez distinguer ce qui est déjà implémenté dans le prototype open source des cas d’usage internes et des pistes d’architecture, et comment vous inspirer de cette approche pour concevoir des agents proactifs, contrôlés et peu intrusifs.
DeepSeek Super-agent : l’essentiel en bref
Avant d’entrer dans les détails, voici un tableau récapitulatif des informations publiques disponibles sur Super-agent. Il est important de distinguer ce qui est déjà réalisé de ce qui relève encore du projet : c’est essentiel pour bien comprendre cette initiative.
| Élément | Détails | État |
|---|---|---|
| Positionnement du projet | Exploration d’une architecture événementielle pour passer d’un agent réactif à un agent proactif | Décrite dans un article technique officiel et dans la documentation du prototype open source |
| Sources d’événements (Trigger) | Messagerie instantanée, issues GitHub, commentaires sur les PR, revues de code, CI, e-mails, calendriers et événements de collaboration sur les projets | Le prototype public prend principalement en charge GitHub, avec une intégration Feishu facultative ; les e-mails et les calendriers font partie d’une vision architecturale plus large |
| Modes de prise en charge | off, observe, auto |
Décrits dans la documentation open source sur les autorisations ; observe est le mode par défaut |
| Mécanisme d’autorisation | Mandate, qui consigne la source de la tâche, le niveau d’autorisation, le périmètre et la version de la politique | Décrit dans la documentation open source sur les autorisations |
| Tâches asynchrones | Après le lancement d’une tâche, Started est renvoyé et l’exécution se poursuit en arrière-plan sans bloquer les interactions | Déjà implémenté dans DeepSeek Harness, mais pas encore activé par défaut |
| Cas interne | Reproduction et correction « en silence » d’un bug dans une discussion de groupe | Cas d’utilisation interne à DeepSeek, non vérifié de manière indépendante par un tiers |
| Retour de la communauté | Le 1er novembre 2026, un utilisateur a indiqué avoir réussi à passer d’une Issue à une PR | Plusieurs problèmes de configuration sont survenus pendant le déploiement |
Qu’est-ce que l’architecture événementielle de DeepSeek Super-agent ?
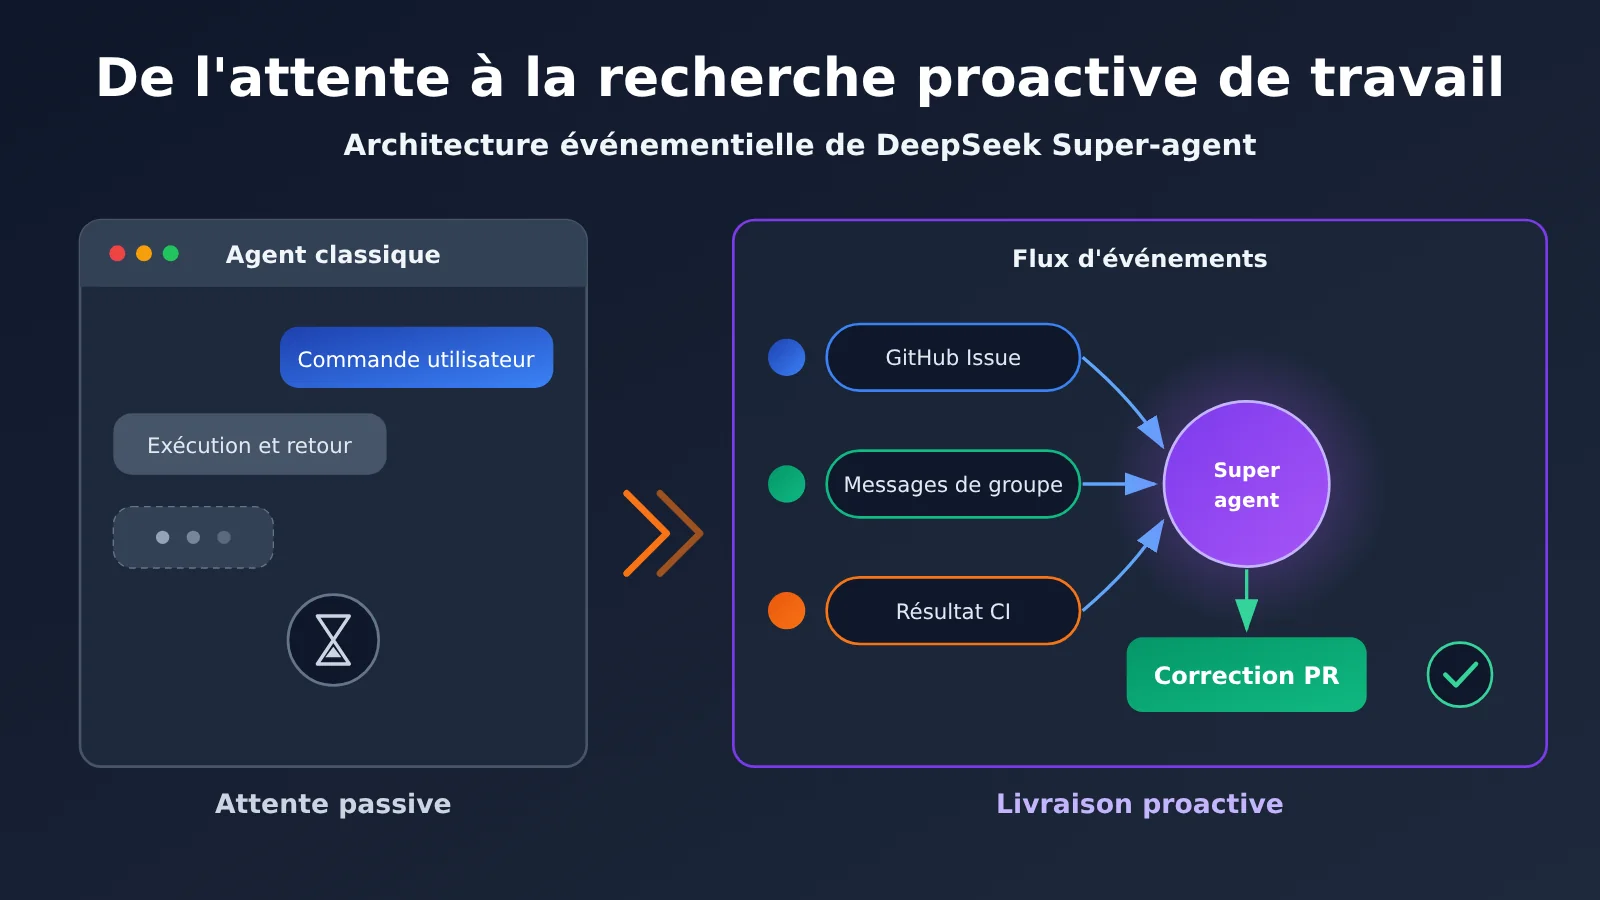
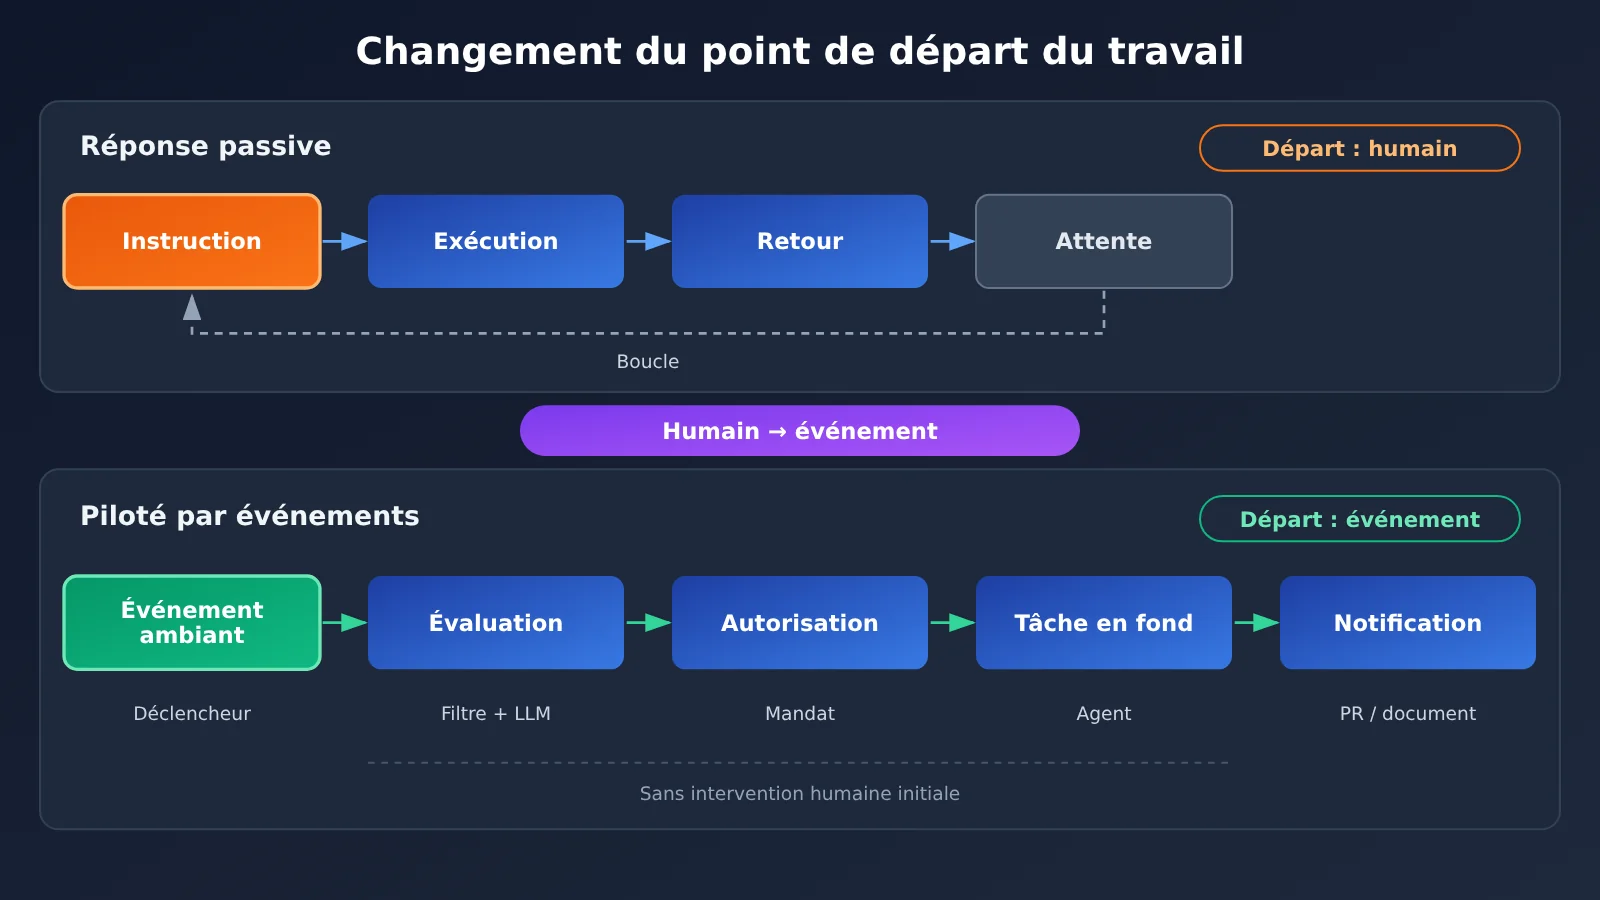
Un agent conversationnel classique fonctionne en boucle : l’utilisateur donne une instruction, l’agent l’exécute, renvoie le résultat, puis attend la suivante. Aussi intelligent soit-il, l’agent commence toujours à travailler parce qu’un utilisateur a lancé une conversation. C’est donc à l’utilisateur de repérer le problème, de le décrire clairement et de penser à revenir consulter le résultat.
DeepSeek Super-agent inverse cette logique. Le système reçoit en continu des événements de son environnement, détermine s’ils révèlent un travail à accomplir, crée des tâches selon les autorisations accordées, les exécute en arrière-plan, puis prévient l’utilisateur au moment opportun. Autrement dit, l’environnement de travail devient lui-même une source d’entrée pour l’agent : la fenêtre de discussion n’est plus le seul point d’accès.
| Dimension | Agent réactif passif | Super-agent événementiel |
|---|---|---|
| Point de départ | L’utilisateur lance une conversation | Événement externe (Trigger) |
| Détection des tâches | Une personne repère et décrit le problème | Le système repère les indices d’une tâche ; l’humain autorise et valide le résultat |
| Exécution | Généralement synchrone, avec attente du résultat | Asynchrone, en arrière-plan, avec préparation spéculative possible |
| Livraison | Résultats fournis progressivement dans la conversation | Notification concise ou livrable structuré (PR, document) |
| Contrôle | Chaque étape dépend des instructions de l’utilisateur | Mode de prise en charge, périmètre d’autorisation du Mandate et règles d’approbation |
| Risques principaux | Charge de gestion manuelle élevée | Déclenchements intempestifs, déferlement de tâches, dépassement des droits, attaques par injection |
Le rôle des Trigger dans Super-agent
DeepSeek désigne les événements externes par le terme Trigger. Un message dans une discussion de groupe, une nouvelle Issue ou l’échec d’un build CI peuvent tous constituer un Trigger. L’essentiel est qu’un Trigger n’est qu’un « indice » : ce n’est pas encore une tâche. La décision d’agir dépend des étapes suivantes de filtrage, d’évaluation et d’autorisation.
Comment Super-agent filtre les événements : Gate programmatique et LLM Assessment
Dans un environnement de travail réel, les messages sans rapport avec les tâches sont nombreux. Un groupe de développeurs peut échanger chaque jour quantité de conversations informelles, d’émojis et de messages répétés. Si chacun d’eux était soumis à un grand modèle de langage, les coûts en tokens et les délais de réponse augmenteraient rapidement. La solution de DeepSeek repose sur deux niveaux de filtrage : des règles déterministes et peu coûteuses éliminent d’abord la grande majorité des événements non pertinents, puis le modèle effectue une analyse sémantique d’un petit nombre d’événements candidats.
| Niveau de filtrage | Critères d’évaluation | Appel à un grand modèle de langage | Rôle principal |
|---|---|---|---|
| Premier niveau : Gate programmatique | Source de l’événement, utilisateur autorisé ou non, appartenance à un groupe ou dépôt surveillé, mention explicite de l’Agent, inclusion dans le périmètre d’événements configuré | Évité autant que possible | Bloquer à faible coût les événements non pertinents ou non autorisés |
| Deuxième niveau : LLM Assessment | Contenu sémantique et contexte des événements candidats | Oui | Déterminer si l’événement correspond à un travail qui mérite d’être traité, par exemple un indice de panne |
Prenons l’exemple de « La page de connexion ne s’ouvre encore plus dans Safari ». Si ce message provient d’un fil de discussion de projet autorisé, le modèle peut y voir un indice de panne ; s’il s’agit simplement d’une conversation sans rapport, le système peut ne rien faire. Cette structure à deux niveaux associe des règles peu coûteuses à une compréhension sémantique plus coûteuse. C’est aussi un élément clé pour maîtriser les coûts d’un Agent piloté par les événements.
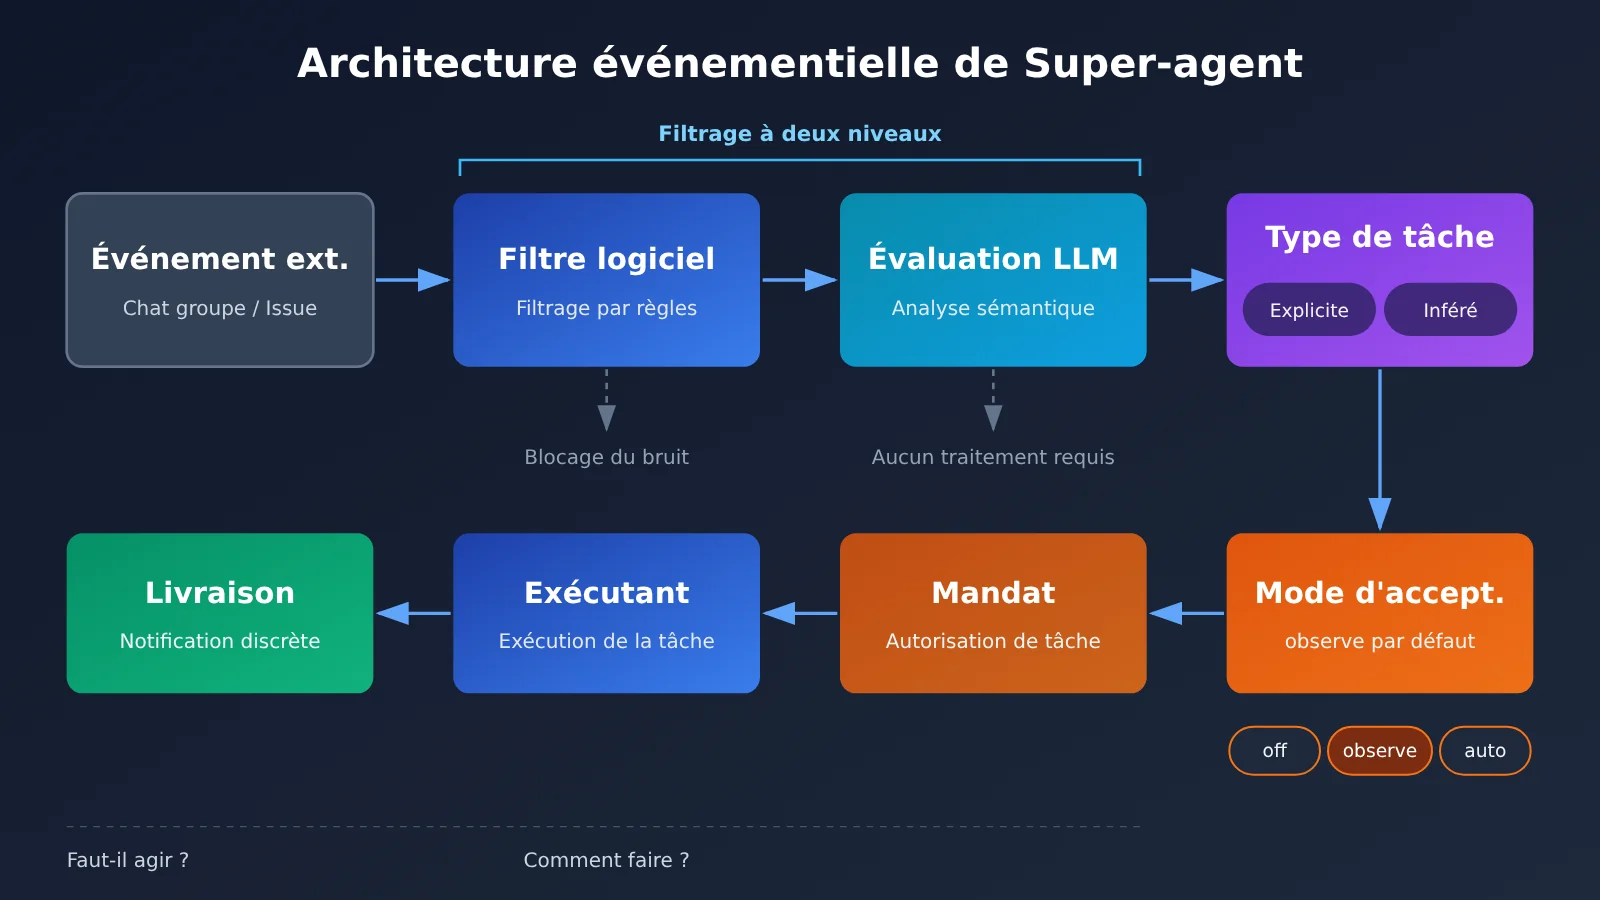
Dans le schéma ci-dessus, l’analyse sémantique et l’exécution des tâches reposent toutes deux sur des API de modèles. Pour reproduire une architecture similaire, les développeurs peuvent passer par une interface compatible OpenAI comme APIYI apiyi.com afin d’accéder à différents modèles depuis un point d’entrée commun, puis les configurer et les comparer selon les couches.
Explicit et Inferred : demandes explicites et tâches déduites
La documentation officielle de DeepSeek sur les autorisations distingue deux types de tâches. Une tâche Explicit correspond à une demande explicitement autorisée : par exemple, un développeur habilité demande directement à l’Agent de corriger un bug dans une Issue. Une tâche Inferred est déduite du contexte : par exemple, quelqu’un mentionne dans une discussion que « les builds échouent parfois ces derniers temps ». Personne n’a demandé de correction, mais le système estime qu’il y a là une piste à examiner.
Le point essentiel : déduire une tâche ne signifie pas être autorisé à l’exécuter. Les tâches Inferred doivent elles aussi respecter les règles d’admission, le périmètre d’exécution et les exigences d’approbation de l’organisation. Cette distinction évite que la « détection proactive » ne se transforme en « action non autorisée ».
Les trois modes de prise en charge du Super-agent : off, observe et auto
La documentation open source sur les autorisations propose trois modes de traitement des tâches déduites :
| Mode | Traitement des tâches déduites | Phase adaptée |
|---|---|---|
off |
Les événements déduits ne sont pas retenus comme tâches candidates | Équipes qui souhaitent traiter uniquement les demandes explicites |
observe (par défaut) |
Analyse et consigne les tâches potentielles, sans les prendre en charge automatiquement | Premier déploiement, évaluation de la qualité des décisions |
auto |
Peut prendre en charge automatiquement les tâches conformes aux règles et ayant passé l’évaluation | Scénarios où les journaux du mode observe ont été examinés et où le niveau de confiance est élevé |
La valeur par défaut est observe : lors de la première installation du prototype public, le système ne se met donc pas automatiquement au travail à partir d’un simple message de discussion. L’équipe officielle recommande d’examiner d’abord les décisions consignées en mode observe avant de choisir d’activer ou non auto. Les demandes explicitement autorisées restent traitées selon les règles applicables dans chaque mode. L’utilisateur garde toujours la main sur le « commutateur » : c’est la base nécessaire pour faire confiance à un Agent proactif.
Mandate : les messages peuvent servir d’entrées, mais pas modifier les autorisations
DeepSeek utilise Mandate pour représenter l’autorisation associée à une tâche : son origine, son niveau d’autorisation, son périmètre et la version de la politique applicable. Supposons qu’un développeur autorise un agent à corriger une Issue, puis que quelqu’un ajoute dans un commentaire de PR : « Profites-en pour migrer toute la base de données. » Ce commentaire peut entrer dans le contexte du Worker, mais il n’élargit pas pour autant l’autorisation initiale à la migration de la base. Une demande hors périmètre doit être évaluée à nouveau.
Le principe souligné par DeepSeek est le suivant : les messages, les commentaires et les documents cités peuvent servir d’entrées à une tâche, mais ils ne peuvent pas modifier directement les règles d’autorisation sous-jacentes. Pour les systèmes qui « écoutent » en continu des contenus externes, c’est une défense essentielle contre l’injection d’invite et le dépassement des autorisations.
Comment un super-agent passe à l’action : exécution spéculative, tâches asynchrones et discrétion
Le filtrage et les autorisations répondent à la question « faut-il agir ? ». Reste à savoir comment le faire sans faire perdre de temps aux utilisateurs. DeepSeek propose trois pistes.
Exécution spéculative : préparer d’abord, attendre la confirmation ensuite
DeepSeek reprend le concept de Speculative Execution (exécution spéculative), issu de l’architecture des ordinateurs : effectuer à l’avance des préparatifs à faible risque, sans savoir si leur résultat sera finalement utilisé.
- Assistant personnel : à la réception d’une invitation à une réunion, l’agent peut consulter l’agenda, recueillir le contexte, vérifier les conflits d’horaire et rédiger une réponse. L’envoi du courriel peut toutefois nécessiter une confirmation de l’utilisateur.
- Recherche et développement : lorsqu’une équipe discute d’un bug, l’agent peut consulter les journaux, tenter de le reproduire, repérer le code concerné et préparer un correctif, puis soumettre le résultat une fois les règles d’autorisation satisfaites.
Cette approche a un coût : des ressources de calcul peuvent être consacrées à un travail qui ne sera finalement pas utilisé. Selon DeepSeek, l’exécution spéculative n’a d’intérêt que si le temps d’attente et les manipulations qu’elle évite aux humains compensent ce surcoût. C’est un compromis d’ingénierie : toutes les tâches ne méritent pas d’être exécutées à l’avance.
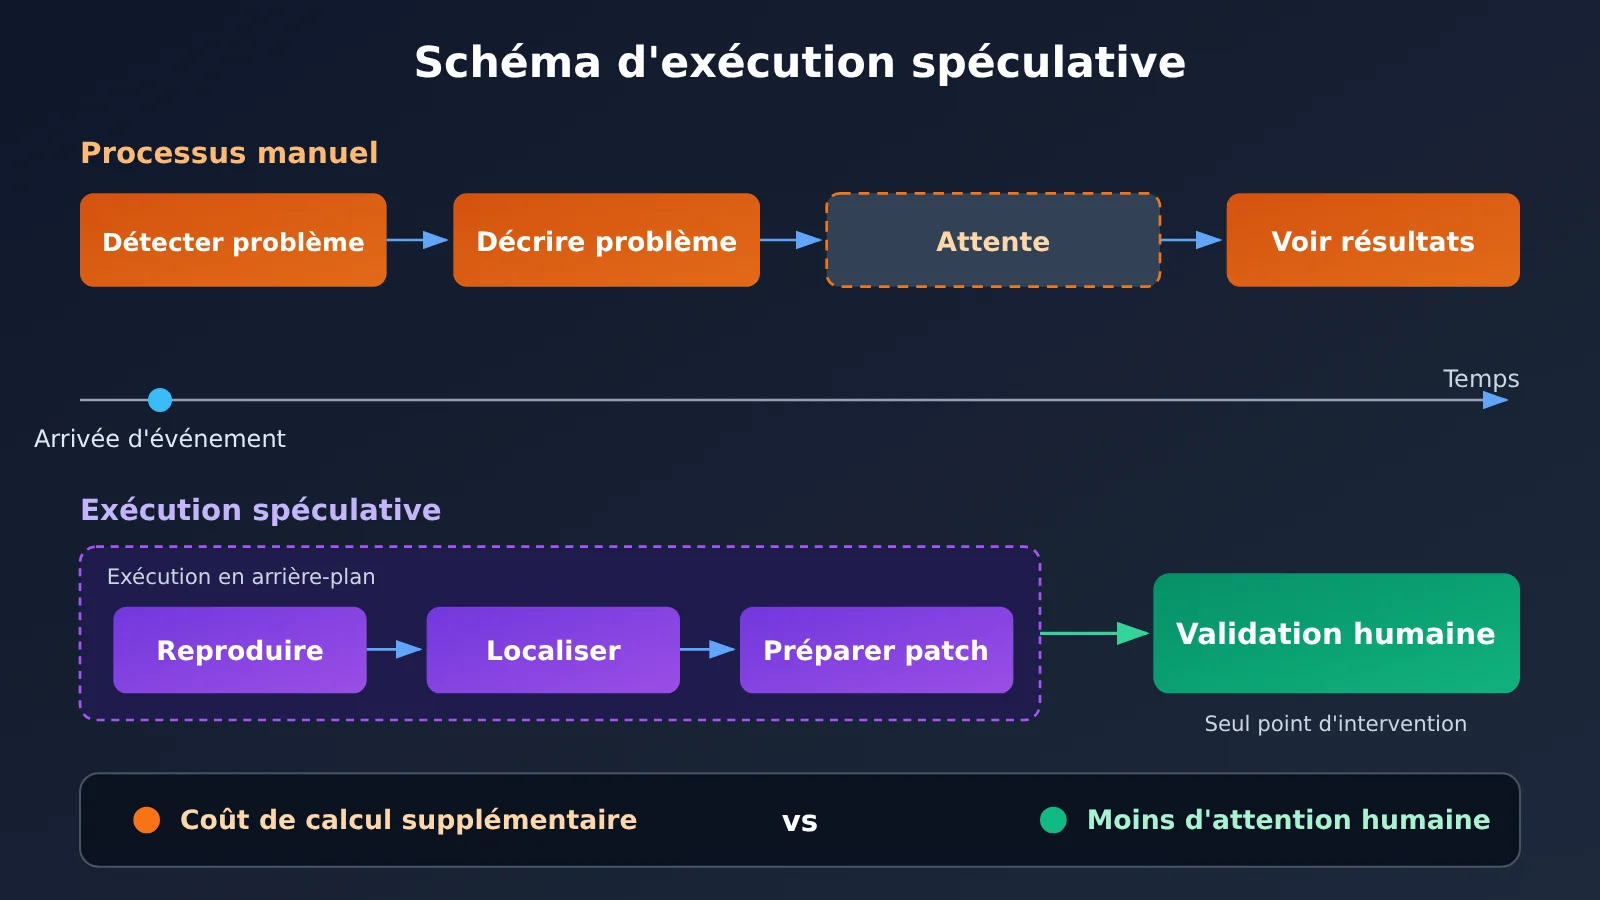
Boucle ReAct asynchrone : les tâches en arrière-plan ne bloquent pas les échanges
Dans une exécution synchrone classique, lorsqu’un agent lance une commande longue, il doit attendre la réponse de l’outil avant de traiter de nouveaux messages. Dans l’approche asynchrone proposée par DeepSeek, le statut Started est renvoyé dès le lancement de la tâche. Son exécution en arrière-plan ne bloque pas les échanges suivants, et son résultat revient dans le système sous forme d’un nouvel événement. L’utilisateur peut poser d’autres questions pendant ce temps, et le système peut aussi arrêter les tâches en arrière-plan devenues inutiles.
Il faut toutefois noter une limite : DeepSeek indique que ce mécanisme de tâches asynchrones est implémenté dans DeepSeek Harness, mais qu’il n’est pas encore activé par défaut. Le prototype public dispose de son propre mécanisme de worker en arrière-plan, mais cela ne signifie pas que toute l’architecture asynchrone envisagée est disponible par défaut.
Discrétion : être proactif ne signifie pas être omniprésent
Le document de DeepSeek sur sa philosophie produit préconise de limiter autant que possible l’attention demandée aux humains, tout en créant un maximum de valeur utile. Concrètement : ne pas signaler chaque invocation d’outil, ne pas inonder les conversations de groupe, ne pas exposer tous les raisonnements intermédiaires, communiquer en priorité lorsqu’une décision ou une validation est nécessaire, et s’abstenir d’envoyer des messages de faible valeur.
Les canaux de communication ont aussi des rôles distincts. La messagerie instantanée sert aux notifications concises, tandis que GitHub, les courriels et les documents accueillent des livrables structurés, avec le contexte du problème, les modifications apportées et les résultats des vérifications. Du point de vue produit, la proactivité et la fréquence des notifications sont deux indicateurs différents : un agent qui fait souvent des comptes rendus n’est pas forcément utile.
Super-agent : les preuves concrètes des cas internes et des tests de la communauté
Pour évaluer une nouvelle architecture, il faut distinguer son « potentiel » de son « état actuel ». Deux types de preuves sont disponibles, chacun avec une portée et un niveau de fiabilité différents.
Les cas internes de DeepSeek illustrent le potentiel de l’architecture. Dans le groupe de discussion interne de DeepSeek Harness, lorsqu’un problème est signalé, l’agent reçoit le message, évalue s’il mérite une investigation, puis tente en arrière-plan de le reproduire et de trouver un correctif. Si le problème est confirmé et qu’une solution simple est trouvée, il prépare ou soumet une PR ; s’il n’obtient aucun résultat utile, il ne dérange pas l’équipe. Il s’agit du mode de fonctionnement interne dévoilé officiellement, et non d’une validation indépendante par un tiers du prototype public dans sa configuration par défaut.
Les tests de la communauté GitHub illustrent l’état actuel du prototype. Le 1er novembre 2026, un utilisateur a indiqué avoir déployé le prototype open source sur Ubuntu en suivant SETUP.md. Il a réussi à faire entrer une demande issue d’une Issue dans le processus de traitement, qui a finalement abouti à une Pull Request. Il a toutefois rencontré plusieurs difficultés : notifications GitHub non reçues, absence de demandes de travail alors que l’état du système semblait normal, nécessité d’ajuster les paramètres de surveillance des Issues et des commentaires dans Source, ainsi que des problèmes de compatibilité liés à la langue du système et à la configuration du compte GitHub.
Ce rapport montre que la chaîne de traitement, de l’événement à la tâche, peut fonctionner de bout en bout. Il ne permet toutefois pas d’affirmer que le projet détecte déjà les bugs de manière fiable, 24 heures sur 24. La génération d’une PR ne signifie pas non plus que les modifications ont été examinées par un humain et fusionnées.
Construire la couche de décision d’un agent événementiel avec une API de modèle
Si vous souhaitez vous inspirer de Super-agent, la couche « Gate programmatique + évaluation par LLM » est la plus simple à mettre en place. L’exemple ci-dessous illustre uniquement la logique de décision sur les événements : il ne représente ni l’implémentation officielle de Super-agent, ni un agent complet.
Exemple minimal
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Consultez la liste des modèles de la plateforme pour connaître les noms disponibles
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
Voir le code complet (Gate + évaluation + mode de prise en charge)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Configuration de la Gate programmatique : règles déterministes, sans appel au LLM
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """Premier niveau : filtrage par règles à faible coût"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """Deuxième niveau : évaluation sémantique par le modèle, distinction entre explicit et inferred"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # Il faut encore vérifier le périmètre d’autorisation
    # Traiter les tâches déduites selon le mode de prise en charge
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 Conseil pour démarrer : pour valider la couche de décision, vous pouvez d’abord obtenir un crédit d’essai gratuit sur APIYI apiyi.com, puis tester plusieurs modèles avec le même code. Comparez leur précision de classification et leur consommation de tokens avant de choisir la configuration de chaque couche.
Orchestration hiérarchique des modèles
L’architecture d’un Super-agent peut se résumer ainsi : événement externe → filtrage par le programme → analyse sémantique par le modèle → décision d’autorisation → exécution par l’Agent → livraison du résultat. Il n’est pas nécessaire d’utiliser le même modèle à chaque niveau :
| Niveau | Nature de la tâche | Choix du modèle |
|---|---|---|
| Filtre programmatique | Vérification de la source, de l’utilisateur et du périmètre | Sans LLM |
| Classification des événements | Textes courts à haute fréquence, sortie structurée | Modèle peu coûteux et à faible latence |
| Exécution complexe | Reproduction et correction de code, raisonnement sur un contexte long | Modèle plus performant |
| Synthèse et notification des résultats | Résumé, livraison structurée | Configuration indépendante possible |
💡 Conseil : il faut vérifier à partir de journaux réels et de tests métier si cette orchestration hiérarchique permet vraiment de réduire les coûts. Il ne faut pas supposer qu’une orchestration multimodèle est forcément moins chère. Grâce à l’interface unifiée d’APIYI apiyi.com, vous pouvez remplacer rapidement les modèles à chaque niveau sans modifier le code métier, puis effectuer des comparaisons A/B.
Analyse des effets de l’architecture événementielle du Super-agent
Pour les développeurs en R&D et en automatisation
- Le point d’entrée passe de la fenêtre de discussion au workflow : les Issues, les commentaires de PR, les résultats de CI et les messages de groupe deviennent des entrées naturelles pour l’Agent. Les développeurs doivent concevoir l’intégration et le filtrage des événements, et pas seulement rédiger des invites.
- La conception des autorisations devient essentielle : la distinction Explicit/Inferred, le mode de prise en charge des tâches et le périmètre du Mandate déterminent si l’Agent peut être accepté au sein d’une équipe.
- L’évaluation doit évoluer : pour mesurer l’efficacité d’un Agent proactif, il ne suffit pas de compter les actions exécutées. Il faut aussi examiner la qualité de la détection des tâches, la proportion de travail à reprendre et le nombre de notifications inutiles.
Pour les équipes chargées des applications IA en entreprise
Les Agents proactifs offrent des perspectives en matière de collaboration en R&D, de diagnostic des incidents et d’automatisation des processus d’entreprise, mais la structure des coûts change. L’évaluation des événements consomme des tokens en continu, l’exécution spéculative peut produire du travail qui ne sera pas retenu, et les tâches complexes nécessitent aussi une vérification humaine. Le cadre d’évaluation ci-dessous s’appuie sur l’architecture officielle ; il ne s’agit pas d’indicateurs de performance officiels publiés par DeepSeek :
| Dimension d’évaluation | Indicateurs à surveiller |
|---|---|
| Qualité de la détection des tâches | Taux de détection des événements pertinents, taux de déclenchement erroné, taux de tâches en double |
| Qualité d’exécution | Proportion de tâches terminées, proportion de travail repris par un humain, proportion de résultats validés |
| Expérience utilisateur | Nombre d’interventions humaines par tâche utile, nombre de notifications inutiles, délai entre l’apparition d’un problème et la livraison d’un résultat prêt à être validé |
| Coûts d’exploitation | Consommation de tokens par événement évalué, coût des modèles par tâche réussie, coût des tâches spéculatives non retenues |
| Gouvernance de la sécurité | Proportion de tâches non autorisées bloquées, efficacité des approbations aux étapes clés, respect du périmètre d’autorisation pour les informations sensibles |
Les risques à prendre au sérieux
Les risques liés aux Agents proactifs comprennent les déclenchements erronés, les avalanches de tâches, les dépassements d’autorisation, l’injection d’invites, le gaspillage de ressources et les fuites d’informations. DeepSeek reconnaît également dans son article technique que le cloisonnement des contextes au sein d’organisations complexes, la mémoire à long terme, les communications sécurisées et la confidentialité restent des problèmes à résoudre. Pour un Agent ayant accès à des dépôts privés et à des identifiants locaux, la prévention de l’entrée d’informations sensibles dans le contexte du modèle ou leur transmission à des canaux externes doit être intégrée à la conception avant le déploiement.
Questions fréquentes FAQ
Q1 : Qu’est-ce que l’architecture événementielle de DeepSeek Super-agent ?
C’est une architecture dans laquelle un agent reçoit en continu des événements de son environnement externe (Trigger). Après un filtrage par programme et une évaluation par le modèle, il peut créer des tâches dans les limites des autorisations accordées, les exécuter en arrière-plan et avertir un humain au moment opportun. Le point de départ n’est plus une « instruction utilisateur », mais un « événement de l’environnement ». Les autorisations et les approbations restent toutefois sous contrôle humain.
Q2 : L’inférence proactive de tâches signifie-t-elle que l’utilisateur perd le contrôle ?
Non. Les tâches inférées (Inferred) doivent respecter les règles d’admission, le périmètre d’exécution et les exigences d’approbation. Par défaut, le prototype public utilise le mode `observe` : il consigne les tâches potentielles sans les accepter automatiquement. L’utilisateur peut choisir `off` pour désactiver complètement l’inférence de tâches, ou activer `auto` après avoir examiné les enregistrements. Le mécanisme Mandate garantit aussi que les messages, comme les commentaires, ne peuvent pas élargir directement le périmètre des autorisations.
Q3 : Que peut faire le prototype open source aujourd’hui ?
Le prototype public prend principalement en charge GitHub et propose une intégration facultative avec Feishu. Il offre déjà trois modes d’acceptation des tâches et le mécanisme d’autorisation Mandate. Des membres de la communauté ont rapporté avoir mené à bien le parcours Issue → PR, mais des problèmes de déploiement subsistent, notamment des notifications non reçues et des incompatibilités de configuration. Les sources d’événements comme les e-mails et les calendriers, ainsi que l’architecture asynchrone complète activée par défaut, relèvent encore d’une vision plus large ou d’implémentations internes.
Q4 : Comment maîtriser le coût en tokens d’un agent proactif ?
La clé est un filtrage à deux niveaux : un Gate programmatique bloque d’abord la plupart des événements sans intérêt, sans appeler de LLM ; seuls quelques candidats sont ensuite transmis au modèle pour évaluation. Il faut aussi utiliser l’exécution spéculative avec prudence, en préparant à l’avance uniquement les tâches dont le bénéfice est évident. En pratique, les statistiques d’utilisation d’APIYI apiyi.com permettent de suivre les coûts du modèle par événement évalué et par tâche réussie, puis d’ajuster les règles de filtrage et la configuration des modèles.
Q5 : Comment construire une couche similaire d’évaluation des événements avec une API de modèle ?
Vous pouvez vous appuyer sur l’exemple de cet article : le Gate programmatique filtre les événements selon des règles, le LLM Assessment produit une évaluation structurée, puis les tâches inférées sont traitées selon le mode d’acceptation choisi. Pour l’invocation du modèle, une interface compatible avec OpenAI suffit. Après inscription sur APIYI apiyi.com, récupérez une clé API et un crédit de test, puis conservez pour `base_url` l’adresse indiquée dans l’exemple. Précisons qu’il s’agit seulement de reprendre les principes de l’architecture : APIYI fournit un accès aux modèles par API, pas un service Super-agent clé en main.
Q6 : Quelles sont les limites connues de Super-agent aujourd’hui ?
Les principales limites sont les suivantes : les sources d’événements du prototype public sont limitées et des problèmes de compatibilité subsistent dans la configuration du déploiement ; le cas interne de « correction silencieuse » n’a pas encore été vérifié de manière indépendante par un tiers ; l’exécution en arrière-plan ne garantit pas un fonctionnement fiable 24 h/24 ; les PR générées nécessitent toujours une revue humaine. L’équipe reconnaît aussi que le cloisonnement du contexte au sein des organisations, la mémoire à long terme et la confidentialité restent à résoudre.
DeepSeek Super-agent : points clés
- Changement central : l’agent commence à travailler à partir d’événements de son environnement, et non plus uniquement d’instructions utilisateur. La fenêtre de discussion n’est plus le seul point d’entrée.
- Filtrage à deux niveaux : le Gate programmatique écarte le bruit à faible coût, puis le LLM Assessment effectue l’analyse sémantique pour concilier coût et précision.
- Autorisation prioritaire : les autorisations Explicit et Inferred sont traitées séparément, avec
observecomme mode par défaut. Le Mandate empêche les messages de modifier les autorisations. - Exécution proactive : l’exécution spéculative et les tâches asynchrones réduisent les temps d’attente, mais leur coût de calcul doit être mis en balance avec les gains réels.
- Livraison sans interruption inutile : l’agent ne communique que lorsqu’une décision ou une validation est nécessaire. Être proactif ne signifie pas multiplier les notifications.
- Un regard prudent sur la situation actuelle : les cas internes montrent le potentiel de l’approche et le prototype open source permet déjà de mener un parcours Issue → PR, mais sa maturité reste limitée.
- Comment s’en inspirer : on peut commencer par créer une couche d’analyse des événements avec une API de modèle, puis comparer les performances de classification et les coûts de différents modèles via APIYI apiyi.com.
Conclusion
L’architecture événementielle de DeepSeek Super-agent ne répond pas à la question « L’IA peut-elle prendre des décisions seule ? », mais plutôt à celle-ci : « Comment permettre à un agent de prendre des initiatives dans les limites des règles et des autorisations ? » Ses principaux mécanismes se résument en trois points :
- Perception et filtrage : les Trigger font de l’environnement de travail une source d’entrées, tandis que le filtrage à deux niveaux maîtrise le bruit et le coût en tokens.
- Autorisation et contrôle : la distinction Explicit/Inferred, les trois modes de prise en charge et le périmètre du Mandate garantissent que l’initiative ne se transforme pas en dépassement des autorisations.
- Exécution et livraison : l’exécution spéculative, les tâches asynchrones et les notifications discrètes font évoluer le rôle humain de la « gestion des tâches » vers la « décision et la validation ».
La valeur d’un agent proactif ne se mesure pas au nombre d’actions exécutées, mais au travail de gestion qu’il épargne et aux résultats fiables qu’il livre. Le prototype open source en est encore à ses débuts : mieux vaut commencer en mode observe pour accumuler des traces de ses décisions et instaurer progressivement la confiance. Si vous concevez une chaîne similaire d’analyse des événements et d’exécution des tâches, vous pouvez utiliser APIYI apiyi.com pour vérifier rapidement les performances de différents modèles à chaque étape, puis faire vos choix à partir de données métier réelles.
📚 Ressources
- Étude de l’architecture DeepSeek Super-agent : analyse de la conception d’un agent proactif et piloté par les événements
- Lien :
blog2.eimoon.com/p/deepseek-super-agent-design/ -
Présentation : couvre les Trigger, l’exécution spéculative, les tâches asynchrones et des cas d’utilisation internes
-
Documentation du mécanisme d’autorisation DeepSeek : Explicit/Inferred, modes de prise en charge et Mandate
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Présentation : la source de référence pour comprendre les trois modes
off,observeetauto -
Philosophie de conception produit de DeepSeek : interruption minimale et respect de l’attention
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
Présentation : explique pourquoi un agent proactif ne devrait pas chercher à se manifester trop souvent
-
DeepSeek Domain Model : définition des concepts clés du domaine
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Présentation : pour mieux comprendre les relations entre tâches, Worker et événements
-
Instructions de déploiement DeepSeek Setup : guide d’installation du prototype open source
- Lien :
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
Présentation : à lire avant de commencer le déploiement
-
Retour d’expérience de la communauté GitHub : test du passage d’une Issue à une PR et problèmes de déploiement
- Lien :
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Présentation : pour découvrir le fonctionnement réel et les limites actuelles du prototype
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Retrouvez d’autres ressources sur l’intégration des modèles dans le centre de documentation docs.apiyi.com.