Note de l’auteur : cet article présente le contexte, les quatre niveaux d’intensité de réflexion et le prix de Gemini 4 Neon, explique comment configurer deux points de terminaison, natif et compatible, dans APIYI, et utilise la même requête minimale pour identifier les erreurs d’intégration courantes.
En une phrase : Gemini 4 Neon a été publié par Google le 18 novembre 2026 ; APIYI l’a mis en ligne le 20 novembre dans les groupes default et svip. L’ID du modèle est gemini-4-neon, avec un tarif affiché de $3 par million de tokens en entrée, $15 en sortie et $0.15 en lecture du cache.Si vous avez besoin d’un contrôle natif des niveaux de réflexion, privilégiez le point de terminaison natif Gemini ; si vous voulez simplement faire pointer un client OpenAI existant vers un autre modèle, le point de terminaison compatible est plus simple.Dans les deux cas, commencez par valider la requête la plus courte, puis activez un par un le streaming, les appels d’outils et les niveaux de réflexion plus élevés.
Cet article n’est pas une simple reprise du communiqué de presse. Les paramètres, prix, benchmarks et parcours de dépannage ci-dessous précisent chacun leur source et leurs conditions d’application ; les exemples de code sont construits d’après la documentation officielle. La note de mise en ligne d’APIYI indique qu’avant la mise en ligne, seule l’API de tarification a été vérifiée, sans appels réels ; cet article ne présentera donc pas le double point de terminaison ni les appels d’outils comme « testés et validés en conditions réelles ».
Valeur essentielle : après lecture, vous pourrez confirmer les spécifications et la logique de facturation de Neon, écrire deux requêtes minimales (native et compatible), choisir le niveau de réflexion selon les résultats de test et identifier rapidement un problème à partir des symptômes d’erreur.
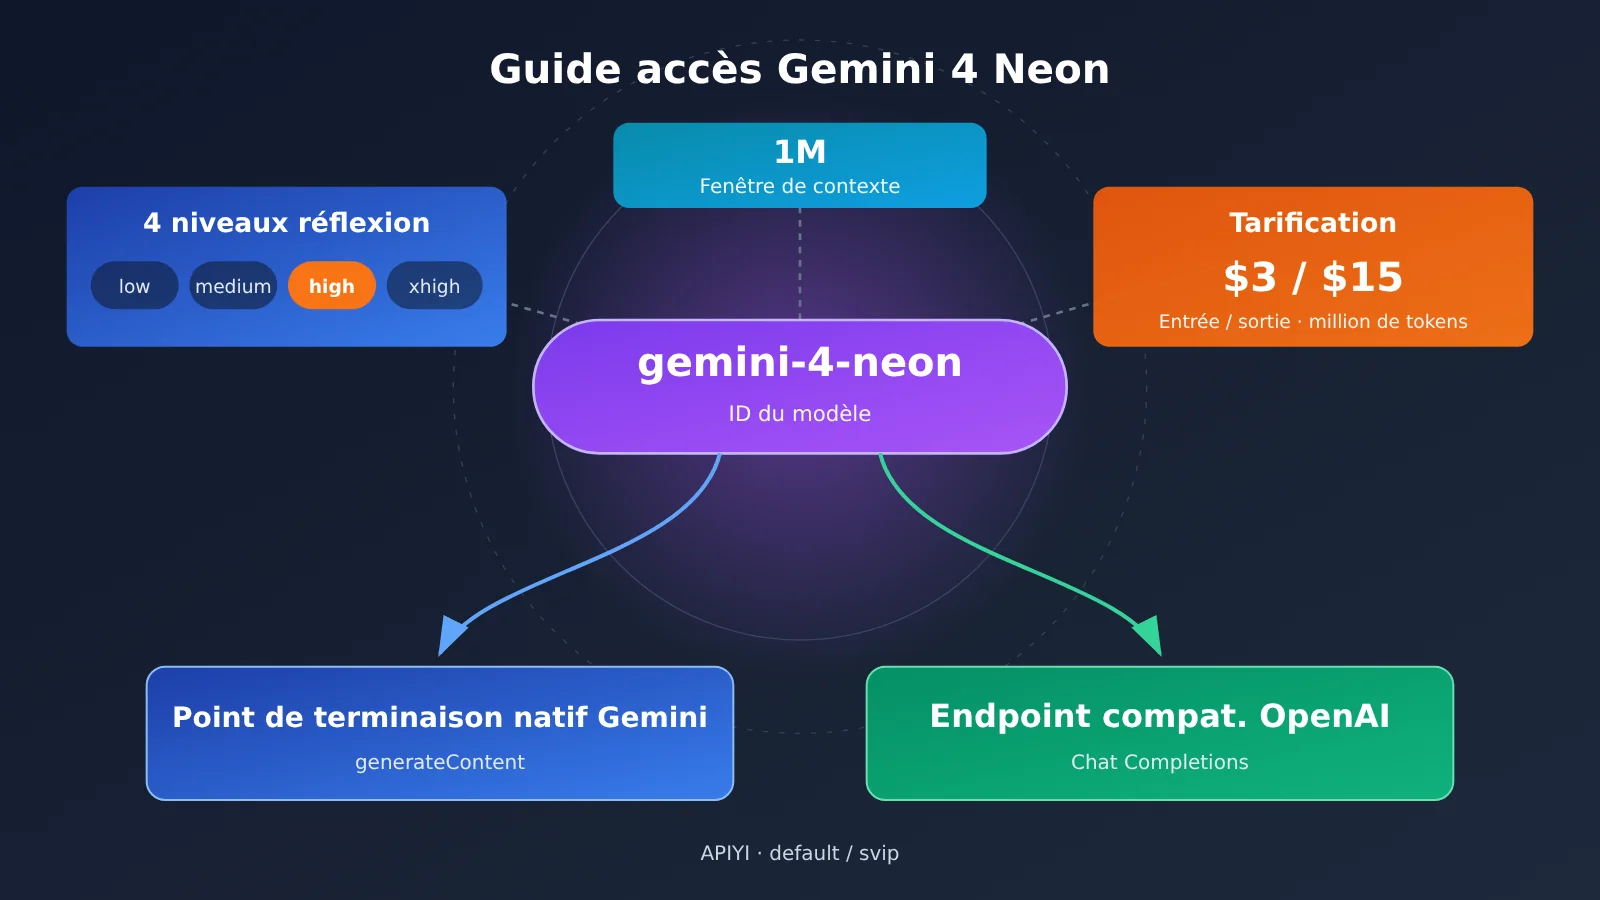
Termes à connaître avant d’intégrer Gemini 4 Neon
Ces notions reviendront plusieurs fois dans la suite. Autant fixer le vocabulaire dès maintenant : vous éviterez bien des confusions au moment de diagnostiquer un problème.
- ID du modèle : la chaîne complète qui désigne le modèle dans la requête, ici
gemini-4-neon. Casse et traits d’union doivent être recopiés à l’identique, sans abréviation maison. - Base URL : l’adresse racine à laquelle le client ajoute le chemin de la requête. La présence d’un préfixe de version comme
/v1dépend du SDK utilisé — une configuration erronée est l’une des causes les plus fréquentes de 404. - Point de terminaison natif Gemini : il reçoit le protocole
generateContentet convient aux cas où vous avez besoin des paramètres de réflexion natifs. - Point de terminaison compatible OpenAI : il utilise le format Chat Completions ; un client OpenAI déjà en place peut donc réutiliser directement la structure de messages de base.
- Niveau de réflexion : valeur d’énumération de l’intensité d’inférence du modèle. Neon prend nativement en charge
low,medium,highetxhigh; APIYI indique dynamiquement que le niveau par défaut esthigh. - Signature de réflexion
thoughtSignature: marqueur de contexte renvoyé par le modèle. Lors d’appels d’outils sur plusieurs tours, il doit être conservé et renvoyé conformément au protocole d’origine. - Fenêtre de contexte : le budget total partagé entre l’entrée, la réflexion et la sortie. Le volume maximal de sortie d’une génération synchrone unique doit être vérifié séparément.
- Prix de lecture du cache : le tarif applicable lorsqu’une entrée existante éligible est réutilisée, bien inférieur au prix d’entrée standard.
Gemini 4 Neon : points clés, paramètres, tarification et groupes
D’après l’annonce de mise en ligne d’APIYI, Neon est le niveau intermédiaire de la gamme Gemini 4, positionné entre Carbon (pour les tâches les plus difficiles) et Hydrogen (pour l’exécution quotidienne). Google l’a publié le 18 novembre et l’a rendu disponible en GA le jour même ; APIYI l’a intégré le 20 novembre.
| Point clé | Contenu | Source et conditions |
|---|---|---|
| ID du modèle | gemini-4-neon |
Registre des modèles APIYI (généré le 2026-11-20) |
| Groupes disponibles | default, svip |
Annonce de mise en ligne APIYI (2026-11-20) |
| Point de terminaison d’accès | Natif Gemini + compatible OpenAI | Annonce de mise en ligne APIYI ; non testé en conditions réelles avant la mise en ligne |
| Fenêtre de contexte | 1M, partagée entre entrée / réflexion / sortie | L’annonce de Google et Artificial Analysis l’indiquent tous deux à 1M |
| Limite de génération synchrone | Environ 64K tokens | Documentation de mise en ligne APIYI |
| Niveaux de réflexion | low / medium / high / xhigh, high par défaut | Annonce de mise en ligne APIYI |
| Tarif affiché (par million de tokens) | entrée $3, sortie $15, lecture du cache $0.15 | Registre APIYI ; l’annonce indique qu’ils sont identiques point par point au site officiel, sans date d’expiration |
Relation entre la fenêtre de contexte et la limite de sortie de Gemini 4 Neon
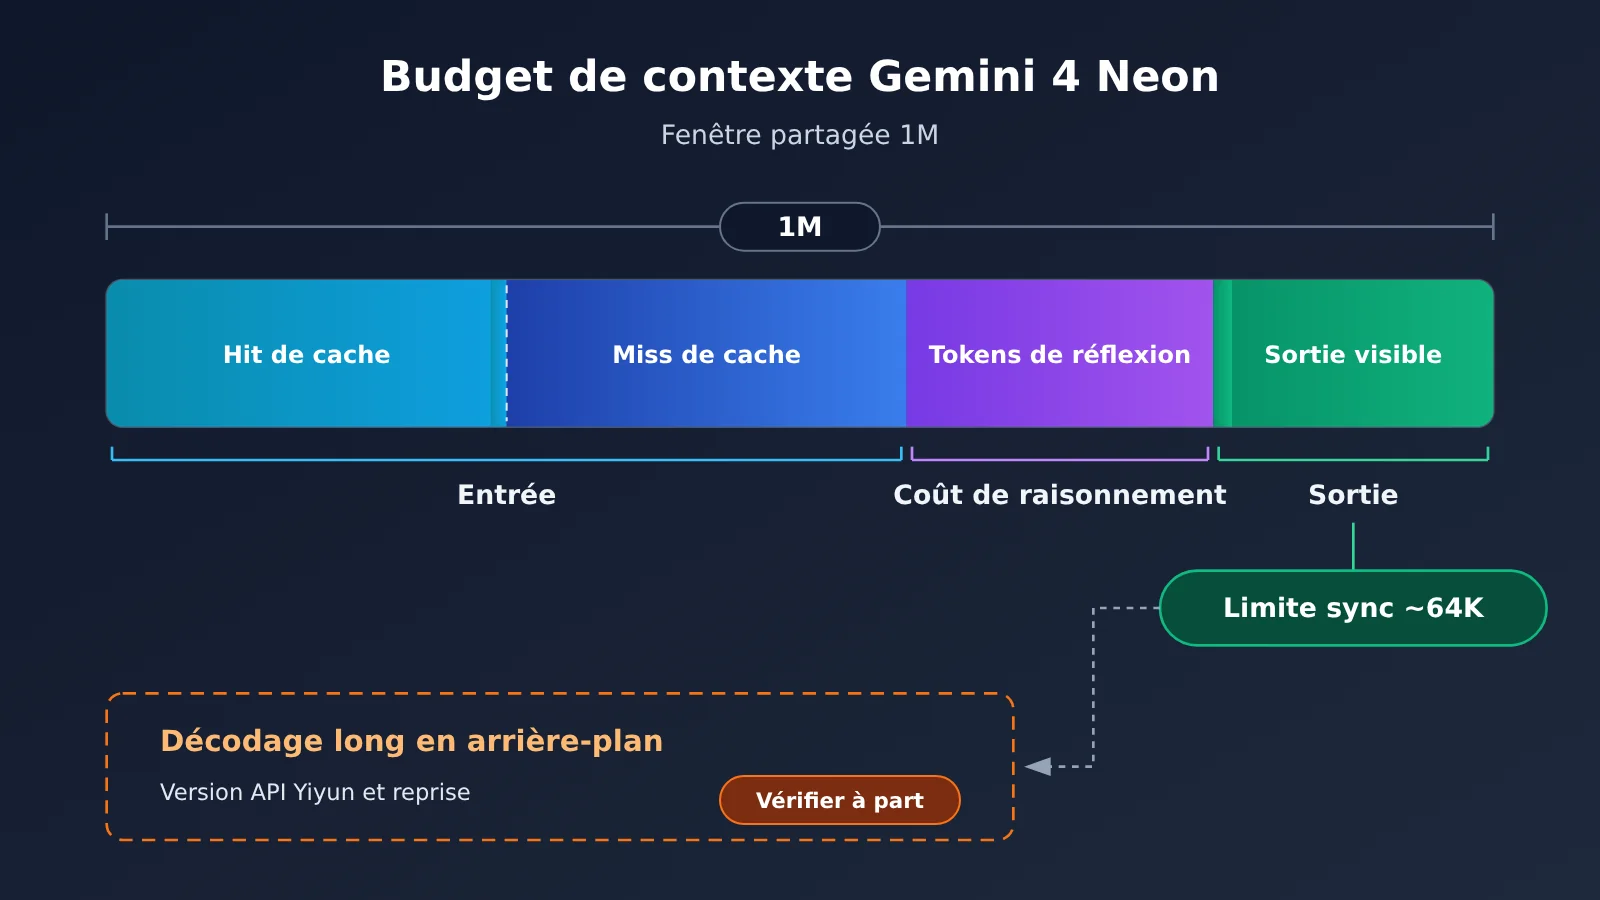
On confond souvent une fenêtre de contexte de 1M avec la possibilité de « sortir 1M en une seule fois ». En réalité, ce 1M est une fenêtre partagée entre l’entrée, la réflexion et la sortie. D’après la documentation de mise en ligne d’APIYI, la limite de génération d’un appel synchrone est d’environ 64K tokens : autrement dit, les entrées longues ne posent pas de problème, mais ne comptez pas sur une seule requête synchrone pour produire plus que cet ordre de grandeur.
La documentation de Google Cloud mentionne une capacité de décodage long en arrière-plan, pouvant aller jusqu’à 1M. Mais elle dépend d’une version spécifique de l’interface cloud et de conditions de reprise ; ce n’est pas la même chose qu’un appel synchrone ordinaire. Pour le point de terminaison Chat Completions compatible avec APIYI, il n’existe actuellement aucun résultat d’appel réel vérifiable pour le décodage long. Si votre activité a besoin de sorties très longues, mieux vaut concevoir dès le départ une génération par segments, puis valider le décodage long séparément.
Comment estimer le prix de Gemini 4 Neon
Voici un exemple de calcul basé sur les tarifs affichés ; il ne correspond pas à une facture réelle. Prenons une requête avec 100K tokens en entrée et 5K tokens de sortie visible : le coût d’entrée est d’environ $0.30, celui de sortie d’environ $0.075, soit environ $0.375 au total. Si 80K de ces tokens d’entrée bénéficient du cache, cette partie est facturée à $0.15, soit environ $0.012, et les 20K restants à $3, soit environ $0.06 : le coût d’entrée diminue nettement.
La façon dont les tokens consommés par la réflexion sont comptabilisés, ainsi que les conditions dans lesquelles le cache s’applique, doivent être vérifiées sur la facture réelle. L’annonce de mise en ligne d’APIYI indique aussi qu’à partir du 1er décembre, une fois le tarif temporaire de Carbon / Argon arrivé à expiration, leurs prix repasseront à $4 / $20 ; à ce moment-là, le tarif affiché de Neon sera inférieur de 25 % aux leurs. Il s’agit d’une comparaison de prix issue de l’annonce de la plateforme, et non d’une comparaison de performances.
Démarrage rapide avec Gemini 4 Neon : deux requêtes minimales, en natif et en compatible
Je vous conseille d’envoyer une requête la plus courte possible sur chacune des deux voies, pour vérifier que l’ID du modèle, le groupe et le routage sont corrects, avant d’ajouter d’autres fonctionnalités. Les exemples ci-dessous sont construits d’après la documentation officielle des SDK Google GenAI et OpenAI, et les clés restent des placeholders.
| Élément comparé | Point de terminaison natif Gemini | Point de terminaison compatible OpenAI |
|---|---|---|
| SDK recommandé | SDK Google GenAI | SDK OpenAI |
| Format de la Base URL | adresse racine de la plateforme, plus api_version="v1beta" |
adresse racine avec /v1 |
| Structure de la requête | contents[].parts[] |
messages[] |
| Niveau de réflexion | generationConfig.thinkingConfig.thinkingLevel |
le mapping des paramètres entre points de terminaison est à valider séparément |
| Cas d’usage | contrôle fin de la réflexion, appels d’outils sur plusieurs tours | bascule rapide d’un code OpenAI existant |
Exemple avec le point de terminaison natif de Gemini 4 Neon
Le point de terminaison natif utilise l’adresse racine de la plateforme, et c’est le paramètre api_version du SDK qui gère le préfixe de version. N’écrivez pas v1beta une seconde fois dans la Base URL, sinon vous obtenez un chemin dupliqué.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # adresse racine de la plateforme APIYI, la version est spécifiée par api_version
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
La notation serpent du SDK finit par correspondre aux champs camelCase du corps de requête REST. Si vous envoyez directement une requête HTTP, la structure du corps ressemble à ceci, avec deux niveaux à surveiller en priorité :
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
Deux points méritent votre attention. D’abord, l’ancien thinkingBudget et le niveau minimal ne s’appliquent pas à Gemini 4 : il faut les supprimer quand vous migrez du code. Ensuite, la documentation Google indique que Gemini 4 ignore temperature et topP ; si vous réglez ces deux paramètres sans voir d’effet, c’est donc le comportement attendu.
Exemple de point de terminaison compatible Gemini 4 Neon
Le point de terminaison compatible convient aux projets qui utilisent déjà le SDK OpenAI. Ci-dessous, on n’utilise que le messages le plus basique, histoire de vérifier d’abord que le routage et le groupe fonctionnent.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Point d'entrée compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "Explique en trois phrases ce qu'est une fenêtre de contexte"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
Dans la réponse, en plus du corps, il est conseillé d’enregistrer aussi finish_reason. Quand le corps est vide, c’est le premier indice à regarder. Le point de terminaison natif correspond aux champs de raison de fin et de note de sécurité présents dans les résultats candidats ; lors du diagnostic, conservez-les également.
Voir le code d’encapsulation avec les informations de diagnostic
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # Indiquez l'adresse du point d'entrée compatible ci-dessus
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """Appelle gemini-4-neon, affiche la raison de fin et l'usage, pour faciliter le diagnostic"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("Corps vide : vérifiez la raison de fin, l'état de sécurité et le budget de sortie")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # Ne réessayer que pour la limitation de débit et l'indisponibilité temporaire, relancer directement les autres erreurs
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("Liste trois tâches adaptées à un long contexte"))
🚀 Démarrage rapide : lors de la création du jeton dans la console APIYI apiyi.com, vérifiez que le groupe du jeton appartient à
defaultousvip. Les nouveaux utilisateurs peuvent d’abord exécuter une fois chacune des deux requêtes minimales ci-dessus avec le quota de test gratuit. Le mode natif et le mode compatible partagent la même clé ; pour changer de point de terminaison, il suffit d’ajuster l’URL de base et la structure de la requête.
Gemini 4 Neon : quel niveau de réflexion choisir ?
Plus le niveau est élevé, plus le raisonnement est approfondi — mais le temps de traitement et le coût augmentent eux aussi. Artificial Analysis (AA) a testé séparément les quatre niveaux de Neon dans l’Intelligence Index v5.0.1, avec les résultats suivants.
| Niveau de réflexion | Indice d’intelligence AA | Temps moyen par tâche | Remarques |
|---|---|---|---|
low |
44 | environ 3,7 minutes | Priorité à la vitesse |
medium |
55 | environ 8,3 minutes | 11 points de plus que low |
high (par défaut) |
60 | environ 14,8 minutes | 5 points de plus que medium |
xhigh |
61 | environ 21,5 minutes | Coût pondéré d’environ 6,44 $ par tâche d’évaluation |
Au vu de ces chiffres, le passage de medium à high apporte encore un gain net, alors que celui de high à xhigh ne rapporte qu’un seul point d’indice, pour environ 6,7 minutes de plus par tâche en moyenne. Ces valeurs proviennent de la chaîne d’évaluation d’AA, et le coût par tâche est calculé selon la pondération des neuf tests. Pour des scénarios comme la lecture de documents ou les questions-réponses interactives, il faut mesurer soi-même le temps et la facture ; la latence de bout en bout, le taux de réussite et la facture réelle d’APIYI doivent également être testés séparément.
Pour choisir votre niveau, voici une piste : commencez par low ou medium pour les tâches de type questions-réponses sensibles à la latence ; gardez le high par défaut lorsqu’il faut un raisonnement en plusieurs étapes ; et n’acceptez de payer plus de temps et d’argent pour xhigh qu’après avoir confirmé, sur votre propre jeu de tests fixe, qu’il apporte un gain réellement significatif.
Comparaison de Gemini 4 Neon avec les modèles du même positionnement
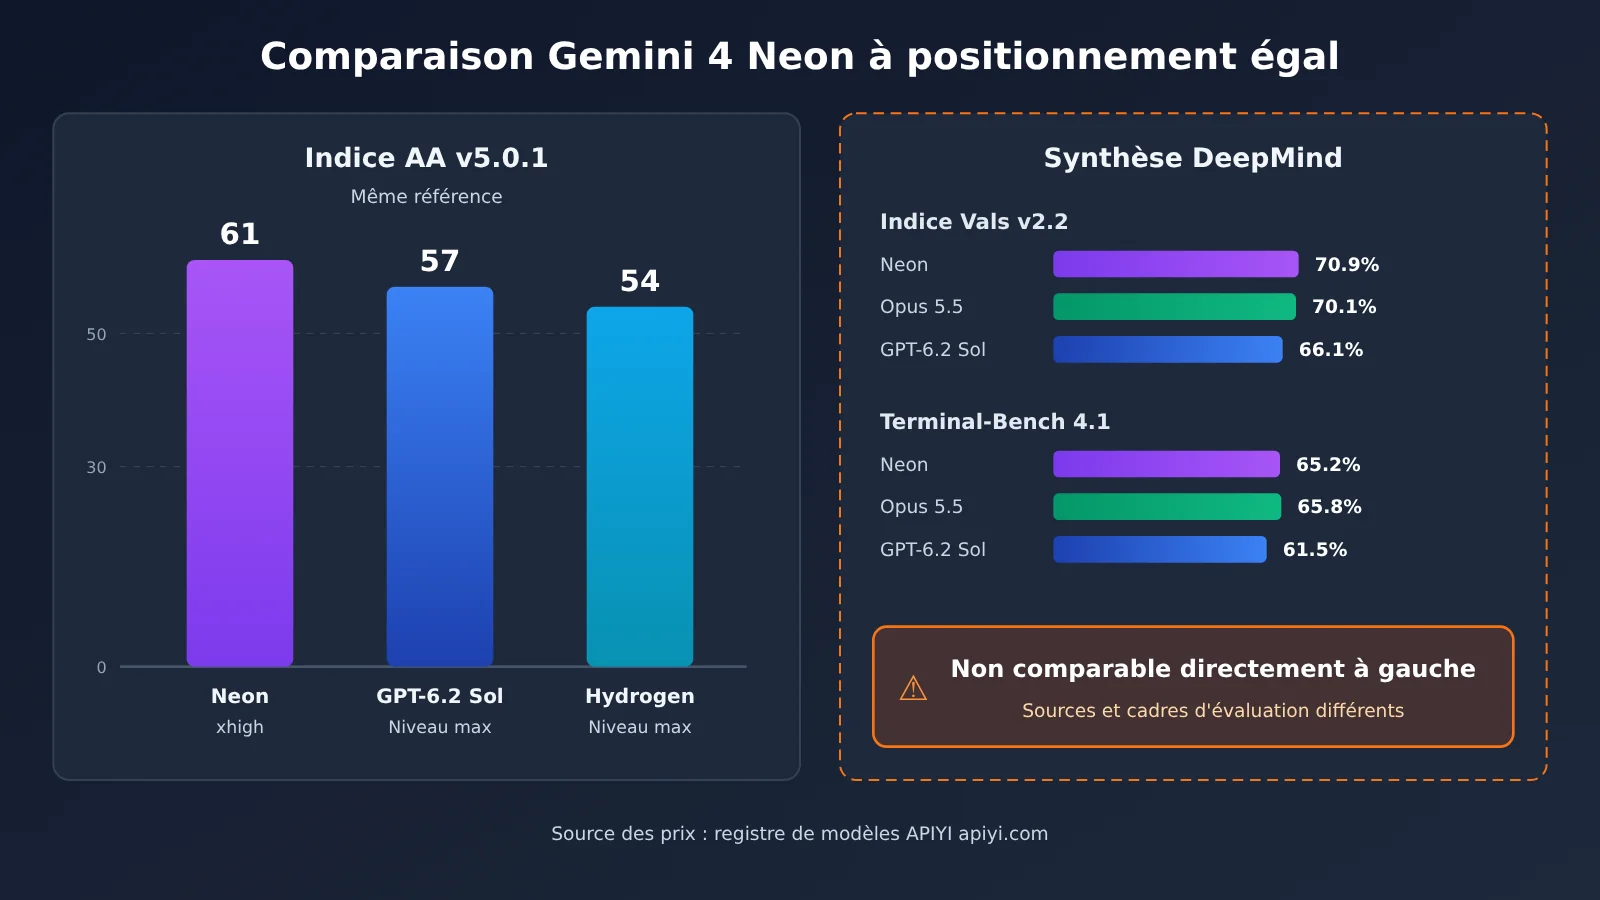
Pour comparer plusieurs modèles, mieux vaut rester sur le même référentiel et sur des niveaux de gamme comparables. Les deux premières colonnes du tableau ci-dessous proviennent de la même version d’AA, les prix du registre APIYI.
| Modèle | Indice AA v5.0.1 (version la plus haute) | Entrée / sortie standard (par million de tokens) | Plateformes disponibles |
|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh) | 3 $ / 15 $ | APIYI apiyi.com, etc. |
| GPT-6.2 Sol | 57 | 2 $ / 10 $ | APIYI, etc. |
| Gemini 4 Hydrogen | 54 | selon le registre | APIYI, etc. |
GPT-6.2 Sol est moins cher sur le papier : en entrée comme en sortie, il coûte un tiers de moins que Neon. Mais sur le même référentiel AA, le score de Neon en xhigh dépasse de 4 points celui de la version la plus haute de Sol. Attention toutefois : un écart de score ne se convertit pas directement en écart de précision métier, et il faut mesurer séparément la latence et la consommation réelle de tokens des deux modèles.
Autre point de repère : la synthèse d’évaluations publiée par Google DeepMind. Sur Vals Index v2.2, Neon atteint 70,9 %, Claude Opus 5.5 70,1 % et GPT-6.2 Sol 66,1 % ; sur Terminal-Bench 4.1, la précision ajustée est respectivement de 65,2 %, 65,8 % et 61,5 %. Cette synthèse s’appuie explicitement sur des sources d’évaluation et des frameworks d’exécution différents, et sur Terminal-Bench, Opus 5.5 fait même un peu mieux que Neon. On peut s’en servir comme indication de tendance, mais le choix final doit se faire sur un même lot de tâches, dans votre propre chaîne d’outils.
💡 Conseil de choix : préparez 20 à 50 cas de test fixes représentatifs de votre activité réelle, puis appelez successivement les différents niveaux de Neon et les modèles candidats sur APIYI apiyi.com avec la même clé, et ne tranchez qu’une fois la précision, les temps de réponse et la facture notés.
Résolution des erreurs d’accès courantes avec Gemini 4 Neon
En cas de problème, revenez d’abord à la requête la plus courte mentionnée plus haut pour servir de référence : confirmez que la chaîne de base fonctionne, puis vérifiez point par point les fonctionnalités nouvellement ajoutées.
| Symptôme | À vérifier en priorité | Piste de correction |
|---|---|---|
| 404 / modèle indisponible | ID du modèle, groupe de jetons, routage, préfixe de version | Copiez gemini-4-neon tel quel ; avec le SDK OpenAI, utilisez le point d’entrée compatible avec /v1 ; avec le SDK GenAI, l’adresse racine suivie de v1beta ; évitez de concaténer plusieurs fois le préfixe de version |
| 400 / comportement incohérent après changement de niveau | Paramètres de réflexion natifs, champs du corps de requête compatible | Sur le point d’entrée natif, utilisez thinkingLevel pour vérifier que le niveau est bien pris en compte ; supprimez thinkingBudget et minimal ; ne mélangez pas les champs des deux protocoles |
| 200 mais corps vide | Motif de fin, état de sécurité, budget de sortie | Vérifiez que le budget de sortie peut contenir à la fois la réflexion et la sortie visible ; consultez les informations de filtrage de sécurité |
| Échec du deuxième tour d’appel d’outil | thoughtSignature, appariement entre appel d’outil et réponse |
Renvoyez la signature de réflexion telle quelle et faites correspondre chaque réponse d’outil à l’appel correct |
| 429 / 503 transitoire en amont | Corps d’erreur, quota de jetons, contraintes de concurrence | En cas de limitation de débit ou d’indisponibilité brève, utilisez un retrait exponentiel avec gigue et un nombre de tentatives limité ; pour les problèmes de solde ou de permissions, corrigez la configuration avant de réessayer |
Gemini 4 Neon : distinguer les erreurs 404 et 400
Une 404 indique généralement que la requête n’a pas été routée vers ce modèle : le problème est un « introuvable » — ID mal orthographié, groupe de jetons qui n’inclut pas ce modèle, ou URL construite avec un préfixe dupliqué comme /v1/v1/... ou /v1beta/v1beta/.... Une 400, elle, signifie que la requête est bien arrivée, mais que le corps ne respecte pas le protocole : le cas le plus fréquent est d’avoir glissé des champs natifs dans une requête compatible, ou d’avoir réutilisé d’anciens paramètres de l’époque Gemini 2.x.
La correspondance des paramètres d’un endpoint à l’autre doit être validée séparément. Si vous essayez de contrôler l’intensité de réflexion sur l’endpoint compatible sans obtenir l’effet attendu, revenez d’abord à l’endpoint natif pour vérifier que le niveau prend réellement effet, puis déterminez s’il s’agit d’un problème de paramètre ou de mapping.
Gemini 4 Neon : corps vide et échecs d’appel d’outils
Quand vous recevez un HTTP 200 sans contenu, la première chose à regarder est la raison de fin. Si la fin est due à une troncature de longueur, cela veut dire que le processus de réflexion a déjà consommé le budget de sortie et qu’il ne reste plus de place pour le texte visible ; si c’est une raison de sécurité, il faut ajuster le contenu d’entrée. Les niveaux de réflexion élevés déclenchent plus facilement le premier cas.
Les échecs d’appel d’outils sur plusieurs tours sont le plus souvent liés à thoughtSignature. D’après la documentation Thought signatures de Google, la signature renvoyée par le modèle doit être transmise telle quelle lors des tours suivants, selon le protocole d’origine, et chaque appel d’outil doit avoir une réponse d’outil correspondante, une pour une. Pour diagnostiquer, commencez par retirer les outils et faire une requête minimale sans outil comme point de comparaison, puis rajoutez les outils progressivement.
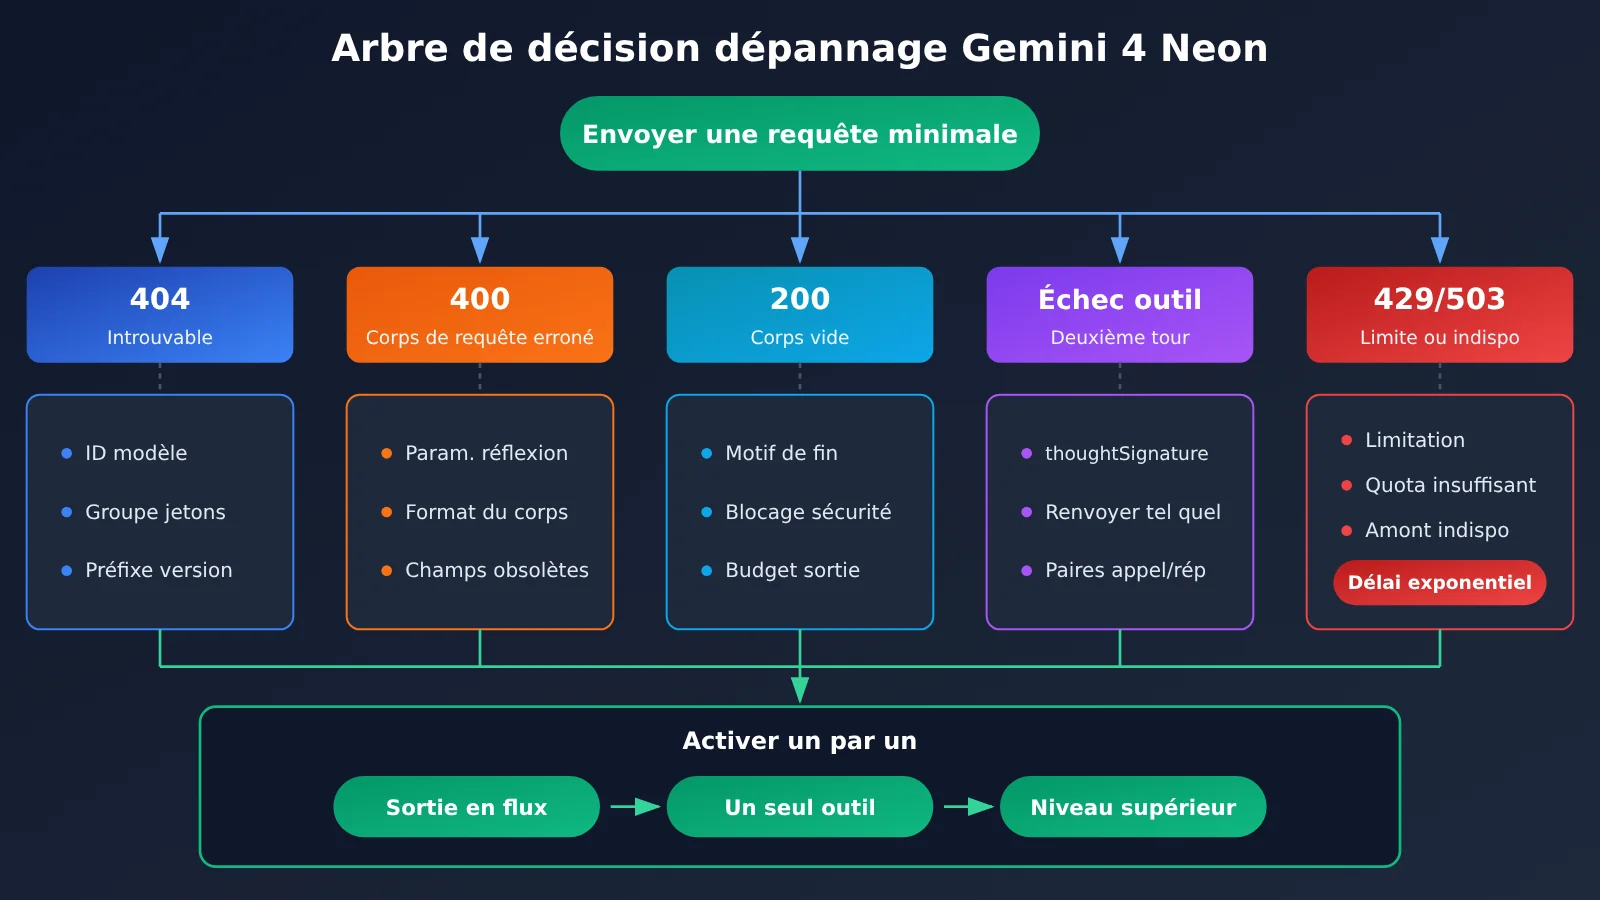
Ordre de validation recommandé pour Gemini 4 Neon
Une fois la requête minimale réussie, mieux vaut activer les fonctionnalités une par une, dans l’ordre ci-dessous, en confirmant le résultat à chaque étape :
- Une requête texte pure, non-streaming, sans outil et avec le niveau par défaut : vérifiez que l’ID, le groupe et le routage fonctionnent correctement.
- Activez la sortie en streaming et vérifiez que l’assemblage des chunks et la lecture de la raison de fin sont corrects.
- Ajoutez un seul outil et déroulez les deux tours complètes « appel → renvoi du résultat → réponse finale », en vérifiant que
thoughtSignatureest bien conservé. - Sur le point de terminaison natif, basculez entre
low/medium/xhighet comparez, avec un jeu de test fixe, les résultats, la latence et la facturation. - Enfin seulement, ajoutez les optimisations liées au coût, comme les entrées longues et la réutilisation du cache.
FAQ
Q1 : Qu’est-ce que Gemini 4 Neon ?
Gemini 4 Neon est le modèle de gamme intermédiaire de Gemini 4, publié par Google le 18 novembre 2026 et passé en GA le jour même. Il se positionne entre Carbon et Hydrogen. Il offre une fenêtre de contexte partagée de 1M et quatre niveaux d’intensité de réflexion, avec l’ID de modèle `gemini-4-neon`.
Q2 : Comment choisir entre Gemini 4 Neon et GPT-6.2 Sol ?
Sur le même benchmark AA Intelligence Index v5.0.1, Neon en `xhigh` obtient 61 points, contre 57 points pour le niveau le plus élevé de Sol. Mais le tarif affiché de Sol est de $2/$10, moins que les $3/$15 de Neon. Un écart de score ne veut pas dire un écart de précision métier : mieux vaut comparer sur votre propre jeu de test les résultats, la latence et la consommation réelle de tokens avant de trancher.
Q3 : Quand Gemini 4 Neon sera-t-il disponible sur APIYI ?
APIYI a mis ce modèle en ligne le 20 novembre 2026, avec les groupes `default` et `svip` ouverts. Selon l’annonce de lancement, le tarif standard n’a pas de date d’expiration.
Q4 : À quels cas d’usage Gemini 4 Neon est-il adapté ?
– **Analyse de longs documents** : la fenêtre de 1M permet d’injecter beaucoup de documentation d’un coup, mais la limite de sortie synchrone par requête est d’environ 64K.
– **Raisonnement multi-étapes et tâches d’agent** : le niveau `high` par défaut offre un bon compromis entre qualité et latence ; pour les appels d’outils, privilégiez le point de terminaison natif.
– **Traitement par lots à coût maîtrisé** : utilisez `low`/`medium` avec réutilisation du cache pour réduire le coût par requête.
Q5 : Comment appeler rapidement Gemini 4 Neon via l’API ?
1. Inscrivez-vous sur APIYI apiyi.com et récupérez des crédits de test gratuits.
2. Créez un jeton appartenant au groupe `default` ou `svip`.
3. Le code OpenAI existant passe par l’entrée compatible ; si vous avez besoin de contrôler le niveau de réflexion, utilisez le SDK Google GenAI pour accéder au point de terminaison natif.
Dans les deux cas, commencez par la requête minimale de cet article pour vérifier que la chaîne fonctionne, puis ajoutez des fonctionnalités.
Q6 : Quelles sont les limitations connues de Gemini 4 Neon ?
– **Limite de sortie** : 1M correspond à une fenêtre partagée, la limite de génération synchrone est d’environ 64K ; les décodages longs dépendent d’interfaces cloud spécifiques et de conditions de reprise.
– **Évolution des paramètres** : `thinkingBudget` et `minimal` ne s’appliquent plus, `temperature` et `topP` sont ignorés.
– **État de validation** : avant la mise en ligne sur APIYI, seul l’endpoint de tarification a été vérifié ; pour les deux points de terminaison et les appels d’outils, il est conseillé de valider d’abord vos propres requêtes sur APIYI apiyi.com.
Gemini 4 Neon : points clés à retenir
- Identité du modèle :
gemini-4-neon, version intermédiaire de Gemini 4, publiée par Google le 18 novembre. - Limites des spécifications : fenêtre de contexte partagée de 1M, plafond de génération synchrone d’environ 64K ; le décodage long doit être validé séparément.
- Tarification affichée : par million de tokens, 3 $ en entrée, 15 $ en sortie et 0,15 $ pour la lecture du cache ; la facture fait foi.
- Arbitrage entre les niveaux : dans les tests AA, passer de
highàxhighn’apporte qu’un point de plus, mais allonge chaque tâche d’environ 6,7 minutes. - Choix du point de terminaison : pour contrôler le niveau de réflexion, passez par le point de terminaison natif ; pour réutiliser du code existant, passez par le point de terminaison compatible.
- Ordre de dépannage : partez de la requête minimale, puis activez successivement le streaming, les outils et des niveaux plus élevés.
En résumé
Les points clés pour intégrer Gemini 4 Neon se résument en trois étapes :
- Vérifiez d’abord les spécifications : 1M correspond à une fenêtre partagée, la sortie synchrone est d’environ 64K, le tarif affiché est de 3 $ en entrée / 15 $ en sortie, et la lecture du cache à 0,15 $.
- Testez les deux points de terminaison une fois chacun : pour le point de terminaison natif, utilisez l’adresse racine avec
v1beta; pour le point de terminaison compatible, utilisez une adresse contenant/v1. Ne mélangez pas les champs. - Choisissez le niveau avec les données : les scores AA ne sont qu’une référence ; ce qui compte au final, c’est la performance, le temps d’exécution et la facture sur votre propre jeu de tests fixe.
Une fois le mode d’intégration confirmé, nous vous recommandons de comparer, sur APIYI apiyi.com et avec la même clé, les différents niveaux de Neon et les autres modèles candidats, avant de choisir la configuration par défaut de l’environnement de production.
📚 Références
-
Annonce du lancement de Gemini 4 Neon sur APIYI : groupes, endpoints, tarifs et limites de sortie
- Lien :
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - Description : publiée le 20/11/2026, elle contient les informations sur les quatre niveaux de réflexion et le niveau par défaut
- Lien :
-
Annonce officielle de Google Gemini 4 Neon : informations de publication officielles
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - Description : publiée le 18/11/2026, elle précise le contexte et le positionnement
- Lien :
-
Page du modèle Gemini 4 Neon sur Artificial Analysis : évaluations indépendantes des quatre niveaux
- Lien :
artificialanalysis.ai/models/gemini-4-neon - Description : scores de l’Intelligence Index v5.0.1 et latences, indicateurs mis à jour dynamiquement
- Lien :
-
Google Gemini API Troubleshooting et Thought signatures : documentation pour le dépannage et les signatures de réflexion
- Lien :
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - Description : signification des codes d’erreur et règles de renvoi des signatures pour les appels d’outils multi-tour
- Lien :
-
Gemini 4 Neon Model Evaluation : synthèse des évaluations de DeepMind
- Lien :
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - Description : résultats d’évaluation issus de multiples sources et frameworks, à préciser les paramètres lors de la citation
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : en cas de problème lors de l’intégration, n’hésitez pas à nous contacter via le site officiel APIYI. Pour plus de détails sur les interfaces, consultez le centre de documentation docs.apiyi.com