Note de l’auteur : décomposer les scores publics de Gemini 4 Neon en trois volets — programmation, travail intellectuel et science — en indiquant la source de chaque élément, pour vous aider à déterminer quel type de tâche il vaut mieux lui confier.
Le 18 novembre 2026, Google a publié Gemini 4 Neon. Dans son billet d’annonce, Sundar Pichai a résumé son positionnement en ces termes : « terminer plus rapidement » les tâches d’ingénierie logicielle complexe, de travail intellectuel et de processus scientifiques. Le même jour, DeepMind a publié la fiche modèle, et Artificial Analysis a également mis en ligne un article de mesure indépendante ainsi qu’une page modèle : les données publiques se sont brusquement multipliées en plusieurs jeux.
Le problème, c’est que ces jeux de chiffres ne sont pas établis selon la même méthodologie. Le blog de Google relève d’auto-déclarations officielles ; le tableau comparatif de la fiche modèle liste bien Claude Opus 5.5 et GPT-6.2 Sol, mais les notes d’évaluation précisent que, par défaut, les résultats des modèles autres que Gemini proviennent des auto-déclarations de chaque éditeur ; seul Artificial Analysis fournit une mesure indépendante. Dans cet article, la date de vérification des données est fixée au 19 novembre 2026 ; je conserve l’étiquette de source pour chaque élément et, lorsque deux jeux de chiffres ne concordent pas, je les présente côte à côte, sans faire de moyenne.
L’essentiel : à la fin de cet article, vous disposerez d’un tableau par type de tâche. Il vous indiquera, pour Gemini 4 Neon, dans les trois domaines que sont la programmation, la lecture de documents et la science, les éléments pour lesquels la source officielle affirme qu’il est premier, ceux pour lesquels les concurrents sont devant dans la fiche modèle, et ceux pour lesquels la mesure indépendante ne lui donne qu’un point d’avance.
Gemini 4 Neon, points clés : d’abord l’entrée, puis on décompose en trois blocs
Le score global, c’est le premier chiffre que la plupart des gens regardent. D’après l’article d’Artificial Analysis, Gemini 4 Neon obtient un score d’intelligence de 61 au niveau de réflexion xhigh, ce qui le place 3e au classement général, derrière GPT-6.2 Astra (max) et Claude Fable 5.2 (max). Le blog Google (auto-déclaration officielle) annonce lui aussi 61 et la 3e place, en ajoutant une phrase : « derrière des modèles plus grands et plus lents ». La colonne AA Index v5.0.1 de la fiche modèle affiche également 61, contre 59 pour Opus 5.5 et 57 pour Sol.
Ce 61 est identique dans les trois sources, mais ce n’est qu’une porte d’entrée. Le score global mélange programmation, lecture de documents et science, alors que le travail que vous devez livrer ne relève en général que d’un seul de ces blocs. Le tableau ci-dessous clarifie d’abord la nature des trois types de sources ; les sections suivantes détaillent chaque bloc.
| Source | Nature | Ce qu’on y regarde dans cet article |
|---|---|---|
| Blog Google | Auto-déclaration officielle | Les catégories où Google revendique la première place, et le score de chacune |
| Fiche modèle DeepMind | Récapitulatif officiel ; les résultats hors Gemini sont surtout des auto-déclarations | Comparaison ligne par ligne des trois colonnes Neon, Opus 5.5 et Sol |
| Article d’Artificial Analysis | Mesures tierces | Coding Agent Index, GDP.pdf, MKA, etc. |
| Page modèle d’Artificial Analysis | Mesures tierces, ventilées par niveau de réflexion | L’écart de score d’intelligence entre les quatre niveaux de réflexion |
La place de Gemini 4 Neon dans la famille
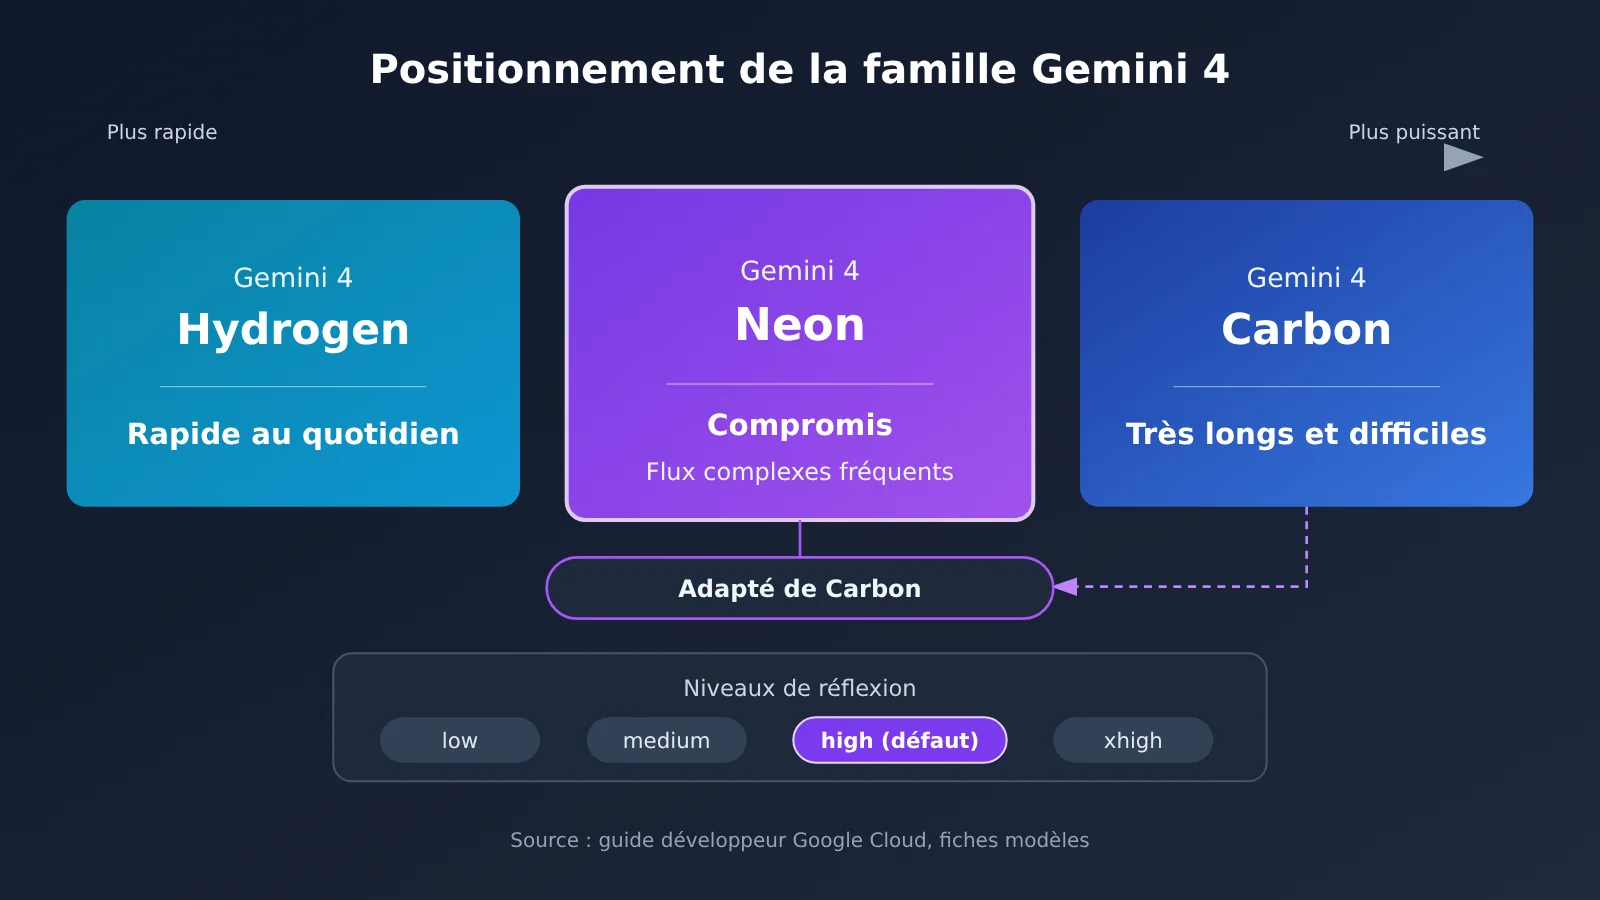
La fiche modèle précise que Gemini 4 Neon est une adaptation de Gemini 4 Carbon, avec une coupure des connaissances en mars 2026, une entrée qui accepte texte, image, audio et vidéo, et une fenêtre unifiée pouvant atteindre 1 million de tokens. Le guide pour développeurs de Google Cloud le situe entre Hydrogen (la boucle rapide du quotidien) et Carbon (les tâches longues et complexes), et le blog officiel indique qu’il vise les flux complexes à haute fréquence.
Comprendre ce positionnement aide à lire les scores qui suivent. Les points de comparaison de Neon varient selon les sources : la fiche modèle ne propose que les colonnes Opus 5.5 et Sol, sans Fable 5.2, Astra ni Carbon ; Artificial Analysis, de son côté, le compare surtout à Carbon, Fable et Opus. Dans les comparaisons par critère, cet article ne comble pas les trous avec des chiffres empruntés à d’autres cases.
Capacités de programmation de Gemini 4 Neon : deux domaines en tête, deux où Opus fait légèrement mieux
La programmation est le sujet sur lequel le blog de Google s’attarde le plus. Selon les chiffres communiqués par Google, Gemini 4 Neon obtient 58.6 sur l’Artificial Analysis Coding Agent Index, soit la 1re place au classement général. L’article d’Artificial Analysis donne quant à lui 59, pour une mesure réalisée sur Antigravity CLI en Neon xhigh. Les valeurs 58.6 et 59 viennent de deux sources différentes ; nous conservons les deux ici.
L’avance du côté des évaluations tierces mérite d’être regardée séparément. Dans l’article d’Artificial Analysis, sur Claude Code, Fable xhigh et Opus 5.5 max sont tous deux à 58, et Carbon high est à 55. Autrement dit, Neon devance ces deux modèles Claude de 1 point.
Les sous-scores de la fiche modèle sont plus détaillés, et Opus 5.5 fait mieux sur deux d’entre eux.
| Projet de programmation (fiche modèle) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4 % | 58.1 % | Non communiqué |
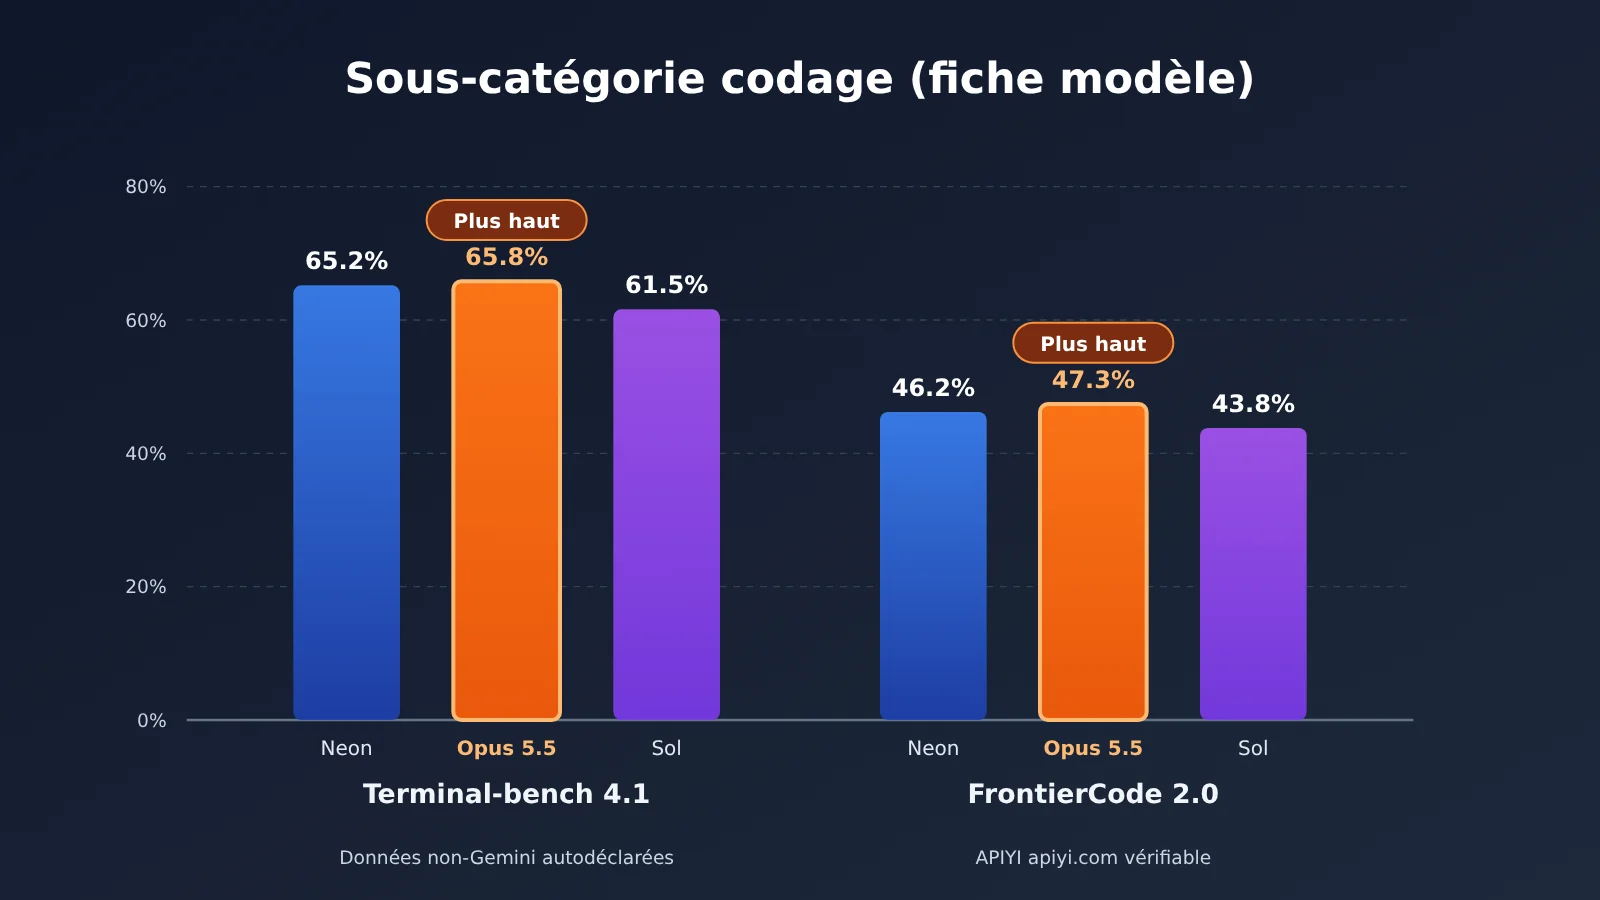
| Terminal-bench 4.1 (après ajustement anti-triche) | 65.2 % | 65.8 % | 61.5 % |
| FrontierCode 2.0 | 46.2 % | 47.3 % | 43.8 % |
| SWE-sweep (harness éditeur) | 39.0 % | 10.1 % | 8.3 % |
| SWE-sweep (harness mini-SWE) | 12.8 % | 3.6 % | 11.6 % |
Comment lire les scores de programmation de Gemini 4 Neon
Sur Terminal-bench 4.1, Opus 5.5 est à 65.8 % et Neon à 65.2 % ; sur FrontierCode 2.0, Opus 5.5 est à 47.3 % et Neon à 46.2 %. Les écarts tournent autour d’un point de pourcentage, mais c’est Opus qui est légèrement devant. Dans le blog officiel, les 46.2 % de FrontierCode 2.0 sont indiqués comme correspondant au niveau high par défaut.
Les deux chiffres de SWE-sweep sont les plus faciles à mal interpréter. 12.8 % correspond au résultat sous le harness mini-SWE, et 39.0 % à celui obtenu dans Google Antigravity (le harness de l’éditeur). Le blog officiel décrit l’écart entre les deux comme un déblocage apporté par le harness : cela reflète le rôle de la chaîne d’outils, et il ne faut pas y voir un rapport de trois entre les modèles eux-mêmes. À noter aussi : sous le harness mini-SWE, Sol est à 11.6 %, très proche des 12.8 % de Neon.
Gemini 4 Neon sur le travail de connaissance : majoritairement en tête, seul Chartography voit Sol passer devant
Sur le travail de connaissance, le blog officiel aligne pas mal de « première place ». Legal Research Bench et Tax Agent Bench sont tous deux annoncés en tête, mais le blog ne donne aucun pourcentage pour ces deux benchmarks ; sur Surge, les tâches de finance, de comptabilité, de modélisation de tableurs et de contraintes complexes sont elles aussi majoritairement classées premières, toujours sans score détaillé par épreuve. Tout cela ne peut être pris que comme des classements revendiqués par l’éditeur lui-même : cet article ne les complète pas avec des chiffres.
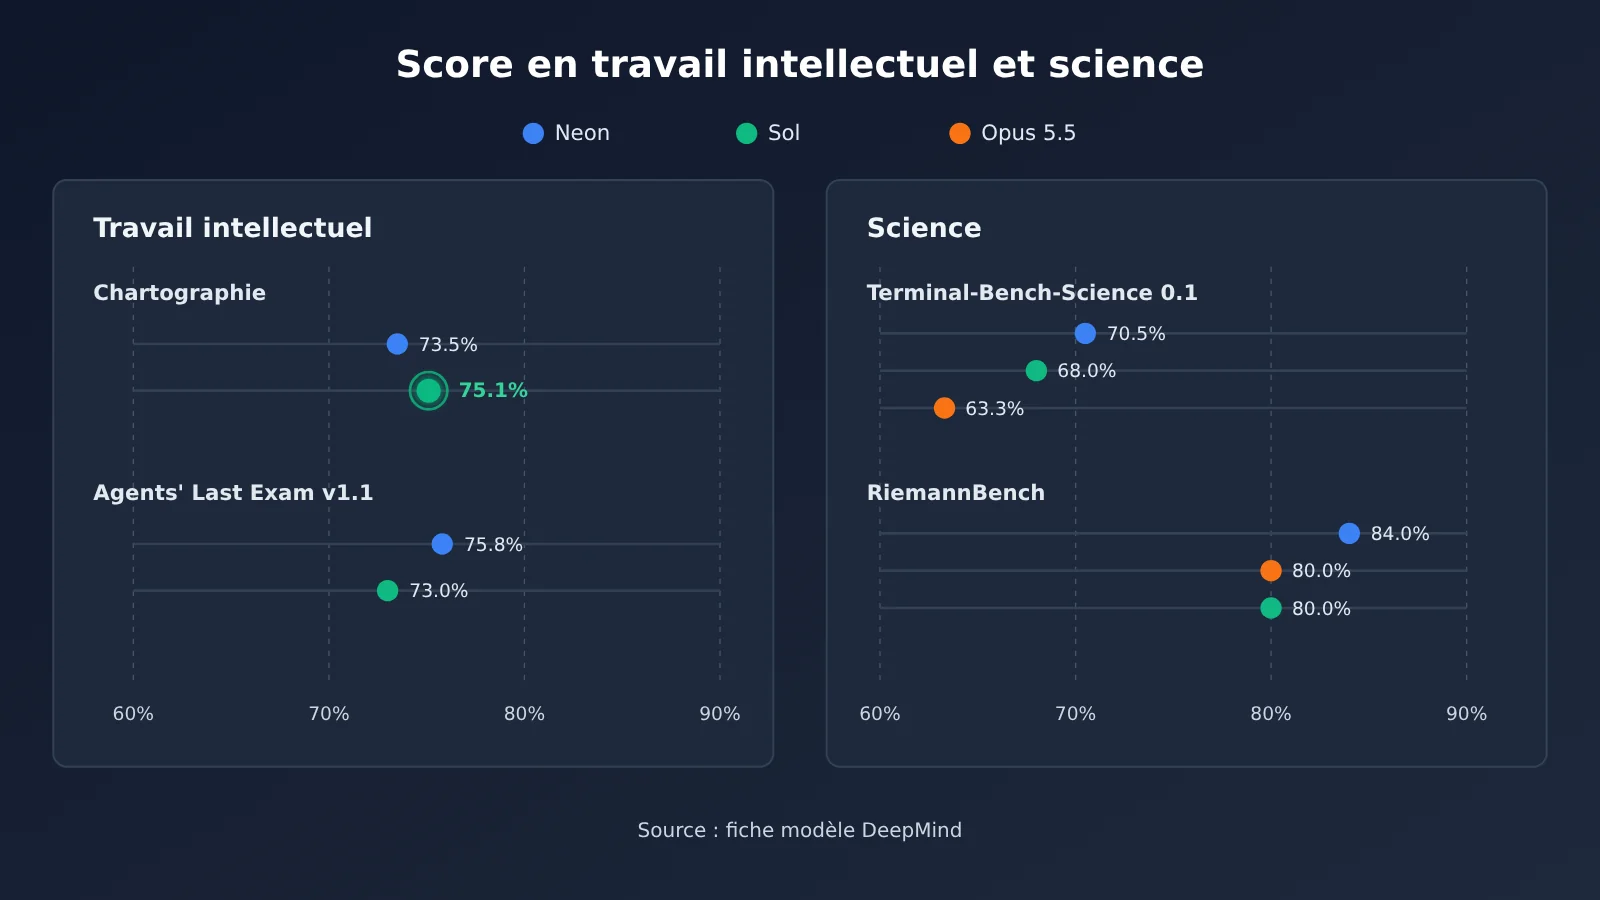
Pour les items qui ont un score, on peut les recouper avec la fiche du modèle. Zapier AutomationBench est premier à 56,3 % dans le blog officiel, Andon Labs Vending-Bench 2 premier avec 16 843 dollars. Chartography est la seule épreuve de ce bloc où Sol fait mieux : Sol 75,1 %, Neon 73,5 %.
Les mesures de tiers apportent davantage de détails. L’article d’Artificial Analysis montre que, sur GDP.pdf, Neon high atteint 33,4 %, tandis que Neon xhigh retombe à 28,0 % et Carbon high à 28,4 % — ce qui confirme que monter d’un cran le niveau de raisonnement ne garantit pas un meilleur score. Sur AA-Briefcase, Neon xhigh obtient un score total de 1700 Elo et une qualité de présentation de 1771 Elo, au-dessus des 1726 de Claude Sonnet 5.5 max. Pour MKA, l’article d’Artificial Analysis annonce 56 % pour Neon, proche des 57 % de Fable max et 2 points au-dessus de Carbon ; la fiche du modèle indique 56,5 %. Les deux chiffres sont conservés tels quels.
Capacités scientifiques de Gemini 4 Neon : trois benchmarks « best in class » selon la source officielle
La science, c’est le domaine où la formulation officielle est la plus affirmative des trois. Le blog de Google qualifie Terminal-Bench Science (70.5 %), RiemannBench (84.0 %) et HLE-Diamond (71.3 %) de « best in class » — des chiffres que l’éditeur déclare lui-même. Le tableau comparatif de la fiche modèle va dans le même sens : sur les trois items, Neon devance Opus 5.5 et Sol, mais la colonne de comparaison est elle aussi un assemblage de résultats auto-déclarés par chaque éditeur.
| Points de connaissance et de science (fiche modèle) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M, BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
Sur GraphWalks, les 95.2 % obtenus sur la plage de contexte long allant de 256k à 1M creusent un écart net avec les 66.8 % d’Opus 5.5 : c’est le point à surveiller en priorité pour les cas d’usage qui impliquent de lire des documents très longs. Sur Terminal-Bench-Science, Sol affiche 68.0 %, soit 2.5 points de pourcentage d’écart avec les 70.5 % de Neon — c’est l’écart le plus faible des trois items scientifiques.
Gemini 4 Neon, tâche par tâche : un tableau récapitulatif
En croisant les trois sources — « l’éditeur annonce la première place », « sur la fiche modèle le concurrent est devant », « les tiers ne montrent qu’un point d’écart » — on obtient le tableau par tâche ci-dessous. Il ne répond pas à la question de savoir qui est le plus fort dans l’absolu ; il indique simplement sur quelle preuve repose chaque score, tâche par tâche.
| Type de tâche | N°1 selon l’éditeur | Fiche modèle : concurrent devant | Tiers : écart d’un point |
|---|---|---|---|
| Programmation | Coding Agent Index : 58,6, 1er au classement général | Terminal-bench 4.1, FrontierCode 2.0 : Opus 5.5 devant | Coding Agent Index : 59 face aux 58 de Fable xhigh et Opus 5.5 max |
| Travail de connaissance | Legal Research Bench, Tax Agent Bench, AutomationBench, Vending-Bench 2 | Chartography : Sol devant | MKA 56 % face à 57 % pour Fable max (Neon 1 point en dessous) |
| Science | Terminal-Bench Science, RiemannBench, HLE-Diamond | — | — |
| Entrée généraliste | Vals Index : 2e (70,9 %) | — | Score d’intelligence AA : 61, soit 1 point de plus que Carbon high |
Gemini 4 Neon : points forts et limites
Points forts
- Trois benchmarks scientifiques en tête : l’auto-évaluation de l’éditeur comme la fiche modèle montrent que Terminal-Bench Science, RiemannBench et HLE-Diamond devancent les deux modèles de référence.
- Bonne lecture en contexte long : sur GraphWalks, la fiche modèle annonce un F1 BFS de 95,2 % entre 256k et 1M, ce qui correspond à une fenêtre unifiée de 1 million de tokens.
- L’outillage change clairement la donne : 39,0 % sur SWE-sweep avec le harness du fournisseur, signe qu’un environnement agent comme Antigravity apporte un gain notable.
- Entrées multimodales complètes : la fiche modèle mentionne la prise en charge du texte, de l’image, de l’audio et de la vidéo ; la page modèle d’Artificial Analysis indique que l’entrée d’Opus 5.5 se limite au texte et à l’image.
Limites
- Pas premier sur chaque item en programmation : sur Terminal-bench 4.1 et FrontierCode 2.0, Opus 5.5 est légèrement devant ; pour les tâches purement terminal ou de code de pointe, mieux vaut tester les deux.
- Un concurrent devant sur la lecture de graphiques : Sol fait mieux sur Chartography ; pour les tâches de reporting à forte densité de graphiques, autant inclure Sol dans la comparaison.
- Un palier élevé ne garantit pas un meilleur score : dans l’article d’Artificial Analysis, xhigh sur GDP.pdf est inférieur à high ; le niveau de réflexion doit être ajusté selon la tâche.
- Contraintes de paramètres assez strictes : le guide développeur précise que passer
thinking_budgetouMINIMALrenvoie une erreurHTTP 400, que le cache de contexte explicite n’est pas pris en charge et que seul fonctionne le cache implicite par préfixe partagé au-delà de 4096 tokens.
Prix et vitesse, une seule phrase ici : la comparaison du coût par tâche avec Carbon varie selon les sources — 32 % de moins selon les chiffres de Google, environ 17 % de moins selon l’article d’Artificial Analysis — et sera développée dans un article dédié à la tarification ; la latence et la vitesse de sortie selon les paliers de réflexion seront traitées dans un article dédié à la vitesse.
Prise en main rapide de Gemini 4 Neon : d’abord la tâche, ensuite le niveau de réflexion
Pour la prise en main, je vous suggère de procéder en trois étapes : choisissez d’abord le type de tâche dans le tableau récapitulatif ci-dessus, puis le niveau de réflexion, et enfin vérifiez dans le tableau récapitulatif APIYI si les modèles de la famille Gemini 4 déjà disponibles suffisent.
- Choisissez le type de tâche : pour le raisonnement scientifique et la lecture de documents longs, regardez d’abord les points forts de Neon ; pour la programmation en terminal et la compréhension de graphiques, ajoutez aussi Opus 5.5 ou Sol à la liste des candidats.
- Choisissez le niveau de réflexion : le guide du développeur indique que Neon ne propose que quatre niveaux —
low,medium,highetxhigh—, avechighpar défaut. La page du modèle Artificial Analysis affiche des scores d’intelligence de 44, 55, 60 et 61 pour les quatre niveaux ; entrehighetxhigh, l’écart n’est que de 1 point, et sur GDP.pdf,highobtient même un meilleur score. Pour la plupart des tâches, il suffit donc de partir du niveau par défaut. - Vérifiez les modèles disponibles : pour les tâches d’orchestration, vous pouvez suivre l’approche du guide du développeur : confier le contrôle principal à un modèle puissant et les sous-tâches rapides à
gemini-4-hydrogen; pour les tâches à long horizon les plus difficiles, envisagezgemini-4-carbon.
Côté adresses d’appel : avec l’interface compatible OpenAI, définissez base_url sur https://api.apiyi.com/v1 ; avec l’interface native Gemini, utilisez https://api.apiyi.com et choisissez la version v1beta. La clé est lue depuis une variable d’environnement, par exemple APIYI_API_KEY ; ne mettez pas la clé en clair dans le code. Lors de l’appel, renseignez model avec gemini-4-carbon ou gemini-4-hydrogen ; dans le tableau récapitulatif APIYI, les deux exposent les points de terminaison chat et gemini.
Le tableau ci-dessous présente les modèles utilisables pour comparaison d’après le tableau récapitulatif APIYI mis à jour le 2026-11-16 (docs.apiyi.com/models.md) et l’interface de tarification interrogée le 2026-11-19 (api.apiyi.com/api/pricing, 285 modèles au total). Les prix sont en dollars par million de tokens.
| ID du modèle | Entrée | Lecture du cache | Sortie | Plateformes disponibles |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | Tableau récapitulatif APIYI, interface de tarification |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | Tableau récapitulatif APIYI, interface de tarification |
claude-opus-5-5 |
4 | 0.2 | 20 | Tableau récapitulatif APIYI, interface de tarification |
gpt-6.2-sol |
2 (3 au-delà de 272000 tokens en entrée) | 0.1 | 10 (environ 11.25 pour le niveau supérieur de l’interface de tarification) | Tableau récapitulatif APIYI, interface de tarification |
Les 2/10 de gemini-4-carbon correspondent au prix actuellement affiché par APIYI, lequel reflète le tarif de lancement de Google jusqu’au 2026-11-30. Sur la page de tarification de Google AI Studio, Gemini 4 Neon est affiché à 3.00 en entrée et 15.00 en sortie par million de tokens, sans offre gratuite ; il n’apparaît encore ni dans le tableau récapitulatif APIYI ni dans l’interface de tarification. Il n’est pas encore disponible, mais nous le mettrons en ligne dès que possible ; les modèles et les prix à retenir sont ceux de la liste des modèles de la plateforme.
🚀 Conseil de prise en main : avant la mise en ligne de Neon, vous pouvez utiliser la même clé via APIYI apiyi.com pour appeler séparément
gemini-4-carbon,claude-opus-5-5etgpt-6.2-sol, et exécuter une fois chacune de vos tâches de programmation ou de reporting. Vous déterminerez ainsi quels types de tâches exigent le niveau de capacités de Neon.
FAQ — questions fréquentes
Q1 : quel est le positionnement du modèle Gemini 4 Neon ?
Modèle intermédiaire de la famille Gemini 4, publié par Google le 18 novembre 2026 et dérivé de Carbon, il est placé par le guide du développeur entre Hydrogen et Carbon. Le blog officiel indique qu’il cible les flux de travail complexes et à haute fréquence. Son ID de modèle est `gemini-4-neon`.
Q2 : quelle place occupe Gemini 4 Neon avec une note globale de 61 ?
L’article d’Artificial Analysis indique 61 points dans le palier xhigh et une 3e place au classement général, derrière GPT-6.2 Astra (max) et Claude Fable 5.2 (max). Le score de 61 affiché dans le blog Google et dans la fiche modèle concorde avec cette information, mais la note globale ne sert que de point d’entrée : il faut examiner les sous-scores en fonction de la tâche.
Q3 : Coding Agent Index, c’est 58.6 ou 59 ?
Les deux sont corrects, mais les sources diffèrent. 58.6 est le chiffre auto-déclaré par Google dans son blog officiel ; 59 est le chiffre mesuré par l’article d’Artificial Analysis sur Neon xhigh avec Antigravity CLI. Il ne faut ni fusionner ni moyenner ces deux valeurs.
Q4 : un tel écart entre 12.8 % et 39.0 % sur SWE-sweep, qu’est-ce que cela signifie ?
Il s’agit des résultats de deux harnais différents : 12.8 % provient de mini-SWE harness, et 39.0 % de Google Antigravity. Le blog officiel attribue cet écart à l’effet de déverrouillage du harnais. Lors du choix du modèle, concentrez-vous donc sur l’environnement d’agent que vous utilisez réellement.
Q5 : sur quels benchmarks les concurrents font-ils mieux que Gemini 4 Neon ?
Dans la fiche modèle, Claude Opus 5.5 est légèrement au-dessus sur Terminal-bench 4.1 et FrontierCode 2.0, tandis que GPT-6.2 Sol est légèrement au-dessus sur Chartography. Dans l’article d’Artificial Analysis, sur MKA, Fable max obtient 57 %, contre 56 % pour Neon.
Q6 : peut-on déjà appeler Gemini 4 Neon via l’API ?
Du côté de Google, le modèle est déjà disponible via Gemini API dans AI Studio et d’autres canaux. Chez APIYI apiyi.com, le tableau récapitulatif et l’endpoint de tarification ne proposent pas encore `gemini-4-neon` ; le modèle n’est pas encore référencé. Nous le mettrons en ligne dès que possible. Les modèles et les tarifs indiqués dans la liste des modèles de la plateforme font foi.
Q7 : quel modèle peut-on utiliser en remplacement pour tester avant sa mise en ligne ?
Vous pouvez appeler `gemini-4-carbon` ou `gemini-4-hydrogen` via l’adresse compatible OpenAI `https://api.apiyi.com/v1` sur APIYI apiyi.com. La même clé API permet aussi de basculer vers `claude-opus-5-5` ou `gpt-6.2-sol` pour une comparaison croisée. Les nouveaux utilisateurs disposent d’un crédit d’essai gratuit.
Q8 : quelles sont les limites d’appel de Gemini 4 Neon ?
Le guide du développeur précise que les niveaux de réflexion se limitent à quatre paliers, de `low` à `xhigh` ; passer `thinking_budget` ou `MINIMAL` renvoie `HTTP 400`. La mise en cache de contexte explicite n’est pas prise en charge. La limite globale est de 1048576 tokens, entrée et sortie comprises, avec par défaut 65536 tokens de sortie maximum par segment.
Gemini 4 Neon — les points clés à retenir
- Le score global n’est qu’une porte d’entrée : le score d’intelligence AA de 61 et la 3ᵉ place concordent sur les trois sources ; le choix du modèle doit quand même se faire tâche par tâche.
- Deux items de programmation sont dépassés : dans la fiche modèle, Terminal-bench 4.1 et FrontierCode 2.0 sont légèrement supérieurs sur Opus 5.5.
- Un point d’avance côté tiers en programmation : Coding Agent Index 59, contre 58 pour Fable xhigh et Opus 5.5 max.
- Majoritairement en tête sur le travail de connaissance : sur Chartography, c’est Sol qui est plus haut ; sur GraphWalks, l’avantage en contexte long est le plus net.
- Trois items scientifiques annoncés « best in class » par l’éditeur : là aussi en tête dans la comparaison de la fiche modèle, mais les données des concurrents sont auto-déclarées.
- Le niveau de réflexion démarre à high : high et xhigh ne diffèrent que d’un point de score d’intelligence, et sur GDP.pdf, high est plus haut.
- Pour commencer, testez les modèles déjà disponibles : avant la mise en ligne de Neon, vous pouvez déjà lancer vos tâches avec Carbon et Hydrogen sur APIYI apiyi.com.
En résumé
Pour savoir à quel point Gemini 4 Neon est puissant, il est bien plus clair de regarder les trois blocs séparément :
- Programmation : l’éditeur le classe lui-même premier sur le Coding Agent Index, l’écart côté tiers n’est que d’un point, et dans la fiche modèle Opus 5.5 est légèrement devant sur deux items.
- Travail de connaissance : AutomationBench, le contexte long de GraphWalks et bien d’autres sont majoritairement en tête ; sur Chartography, c’est Sol qui est plus haut.
- Science : trois items annoncés « best in class » par l’éditeur, avec un avantage constant dans la comparaison de la fiche modèle — c’est le bloc où les preuves sont les plus homogènes.
Le conseil : commencez par classer votre tâche dans l’une de ces catégories, puis reportez-vous au tableau récapitulatif de cet article pour décider si Neon vous est nécessaire. Avant sa mise en ligne, vous pouvez passer par APIYI apiyi.com pour appeler Gemini 4 Carbon, Hydrogen, ainsi qu’Opus et Sol via une interface unifiée et les comparer ; une fois gemini-4-neon disponible, il suffit de remplacer l’ID du modèle pour refaire le test.
📚 Références
-
Blog Google – Introducing Gemini 4 Neon : annonce officielle et scores auto-déclarés
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Description : classements, scores en programmation et en sciences, tels que déclarés par l’équipe elle-même
- Lien :
-
Fiche modèle DeepMind – Gemini 4 Neon : tableau comparatif à trois colonnes et spécifications du modèle
- Lien :
deepmind.google/models/model-cards/gemini-4-neon/ - Description : scores détaillés de Neon, Opus 5.5 et Sol ; les résultats autres que Gemini proviennent par défaut des auto-déclarations de chaque éditeur
- Lien :
-
Guide développeur Google Cloud – Gemini 4 Neon : paramètres et contraintes d’appel
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Description : niveaux de réflexion, limite de tokens, cache et codes d’erreur
- Lien :
-
Article Artificial Analysis – le gain d’intelligence de Gemini 4 Neon : mesures tierces
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Description : Coding Agent Index 59, GDP.pdf, MKA, etc.
- Lien :
-
Page modèle Artificial Analysis – Gemini 4 Neon : indices par niveau de réflexion
- Lien :
artificialanalysis.ai/models/gemini-4-neon - Description : comparaison des scores d’intelligence sur les quatre niveaux
- Lien :
-
Tableau récapitulatif des modèles APIYI : modèles disponibles et prix
- Lien :
docs.apiyi.com/models.md - Description : les modèles et les prix font foi selon la liste des modèles de la plateforme
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com