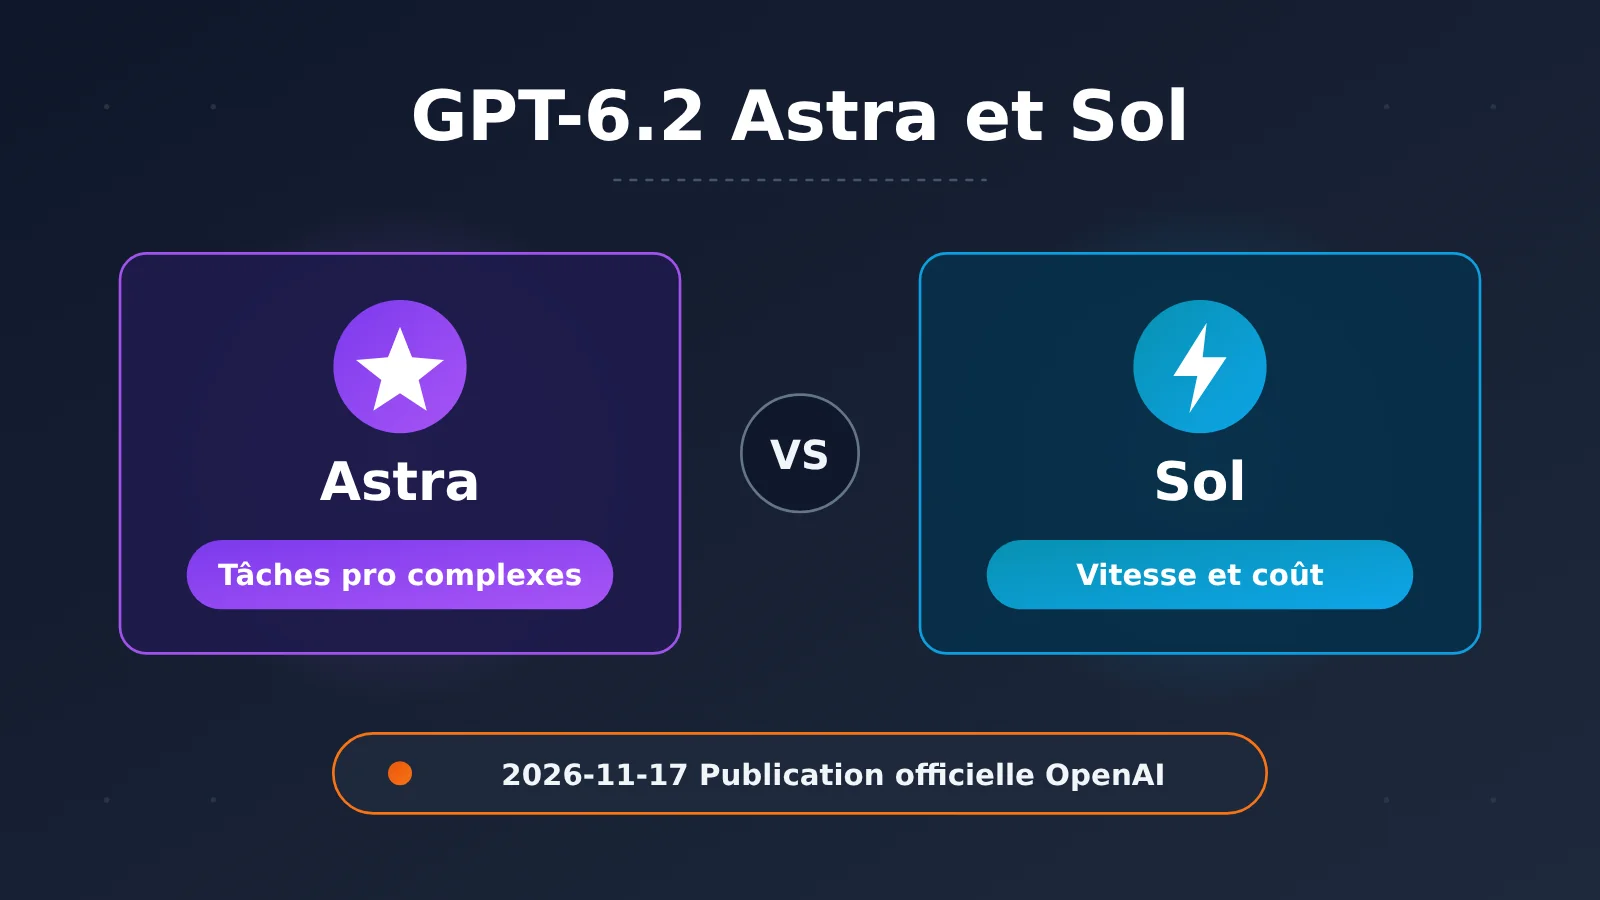
Réponse directe : OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. Selon les rapports officiels, les deux modèles progressent sur GDPval v2 par rapport à leurs prédécesseurs respectifs, et Astra réduit en plus le nombre de jetons de sortie de 22 %. Pour le choix : privilégiez Astra pour les tâches professionnelles complexes, à forte valeur et où une erreur coûte cher ; privilégiez Sol pour les tâches à haut volume, sensibles à la vitesse et au coût. À noter : cette vague de déploiement ne concerne progressivement que ChatGPT Work, Codex et l’API ; la conversation ChatGPT classique n’est pas incluse dans ce cycle. Donc si vous n’utilisez que le ChatGPT standard, vous n’avez pas besoin de revoir votre façon de travailler à cause de cette annonce.
Que retiendrez-vous de cet article ?
- La date de sortie de GPT-6.2 Astra et Sol, la source officielle et les canaux d’accès.
- Ce que disent, et ce que ne disent pas, les données officielles de GDPval v2, ALE et FrontierCode 2.0.
- Les limites d’entrée et de sortie des deux modèles, ainsi que la structure tarifaire standard officielle de l’API.
- Comment les utilisateurs ordinaires et les développeurs doivent choisir entre Astra et Sol.
Sommaire : La suite commence par un tableau conceptuel qui explique des termes comme les noms d’évaluations et la facturation du cache, puis par un aperçu des impacts qui relie cette publication aux différents publics. La première partie du corps présente les faits officiels : 1.1 périmètre de déploiement, 1.2 évaluations officielles, 1.3 limites de capacités et 1.4 prix. La deuxième partie est un jugement éditorial : la portée réelle de la mise à niveau, la répartition des rôles entre les deux modèles, des recommandations de choix et une méthode de vérification de l’intégration.
À savoir : comprendre ces concepts d’abord
Ces termes reviennent dans la documentation officielle comme dans cet article. Commencer par en clarifier le sens permet d’éviter de mal interpréter les données d’évaluation et les prix.
| Concept | Explication rapide |
|---|---|
| GPT-6.2 Astra | Le modèle de cette sortie orienté vers les tâches professionnelles complexes, dont le prix de l’API officielle est plus élevé |
| GPT-6.2 Sol | Le modèle de cette sortie orienté vers la vitesse et le coût, dont le prix de l’API officielle représente environ un quart de celui d’Astra |
| GDPval v2 | L’une des évaluations utilisées officiellement par OpenAI ; les principales données comparatives entre Astra et Sol dans cette sortie en proviennent |
| ALE | Une autre évaluation mentionnée dans le rapport officiel ; cette fois, seul le score d’amélioration d’Astra a été publié |
| FrontierCode 2.0 | L’évaluation de programmation du rapport officiel, utilisée ici pour comparer l’écart entre Sol et Astra au niveau de raisonnement max |
| Point de pourcentage | L’écart entre deux pourcentages ; par exemple, passer de 50 % à 56,2 % correspond à une hausse de 6,2 points de pourcentage |
| Niveau de raisonnement (max) | Le niveau d’intensité de raisonnement configurable du modèle ; max désigne le réglage qui mobilise le plus de calcul de raisonnement |
| Tokens de sortie | L’unité de facturation correspondant au contenu généré par le modèle ; plus la sortie est concise, plus le coût est généralement faible |
| Lecture du cache | La partie d’un contenu d’invite réutilisé qui, après avoir touché le cache, est facturée à un tarif réduit |
| Écriture du cache | Les tokens écrits sont facturés au tarif d’écriture correspondant à la durée de conservation ; ce même lot de tokens n’est plus facturé une seconde fois au tarif d’entrée normal |
| Seuil de contexte long de 272K | Lorsque l’entrée d’une requête dépasse environ 272 000 tokens, l’ensemble de la requête est facturé à un tarif plus élevé |
| ChatGPT Work | Le produit ChatGPT d’OpenAI destiné aux usages professionnels, l’un des points d’accès de cette mise en service |
| Codex | Le produit d’OpenAI destiné à la programmation, l’un des points d’accès de cette mise en service |
Aperçu de l’impact de GPT-6.2 Astra et Sol selon les publics
- Utilisateurs de ChatGPT standard : cette vague de déploiement ne concerne pas ChatGPT standard pour le moment ; à court terme, leur expérience quotidienne ne changera donc pas directement.
- Utilisateurs de ChatGPT Work : ils découvriront les nouveaux modèles au fil d’un déploiement progressif. Ils devront surtout décider quelles tâches confier à Astra et lesquelles confier à Sol.
- Utilisateurs de Codex et développeurs : les données officielles de FrontierCode 2.0 montrent que Sol est proche d’Astra sur ce test. Il vaut la peine de faire une comparaison sur votre propre base de code.
- Développeurs d’API : l’écart de prix entre les deux modèles est net, et il existe des règles de facturation pour le cache et pour la longue fenêtre de contexte de 272K. Le routage des modèles et la conception des invites influencent donc directement la facture.
- Créateurs qui ont besoin de génération vidéo : les nouveaux modèles prennent en entrée du texte et des images, et produisent du texte. Ce ne sont pas des modèles natifs de génération vidéo ; ce type de besoin n’est donc pas directement concerné.
1. Les faits objectifs autour de la publication de GPT-6.2 Astra et Sol
Cette section s’en tient aux informations publiques officielles. Toutes les données d’évaluation citées dans cet article proviennent des rapports officiels d’OpenAI ; elles ne sont pas issues de tests réalisés par l’équipe APIYI. Nous n’avons lancé aucun benchmark et mené aucun entretien.
1.1 Dates de publication et périmètre de disponibilité de GPT-6.2 Astra et Sol
OpenAI a publié GPT-6.2 Astra et Sol le 17 novembre 2026 sur sa page officielle. La date de vérification des informations de cet article est le 18 novembre 2026. La page officielle de publication, les documents du centre d’aide et la page des modèles pour développeurs sont actuellement les sources d’information les plus directes ; les adresses exactes sont indiquées dans les références en fin d’article.
| Élément d’information | Détails |
|---|---|
| Date de publication | 17 novembre 2026 |
| Éditeur | OpenAI |
| Modèles publiés | GPT-6.2 Astra, GPT-6.2 Sol |
| Points d’accès | ChatGPT Work, Codex, API, ouverture progressive |
| Hors périmètre de cette vague | Conversation ChatGPT standard (Chat) |
| Modalité d’entrée | Texte, images |
| Modalité de sortie | Texte |
| Sources officielles | page de publication openai.com, documentation d’aide help.openai.com, page des modèles developers.openai.com |
« Ouverture progressive » signifie que tous les comptes ne verront pas forcément les nouveaux modèles le jour de la publication. Si vous ne trouvez pas encore l’entrée dans ChatGPT Work ou Codex, c’est normal : il s’agit d’un déploiement par vagues. Vous pouvez consulter les explications dans la documentation d’aide officielle.
1.2 Données d’évaluation officielles de GPT-6.2 Astra et Sol
Le rapport officiel fournit trois séries de données. Elles proviennent d’évaluations différentes et leurs points de comparaison ne sont pas les mêmes : il ne faut donc pas les comparer entre elles. Le tableau ci-dessous les présente selon les modalités originales.
| Évaluation | Modèle | Résultat du rapport officiel | Objet de comparaison |
|---|---|---|---|
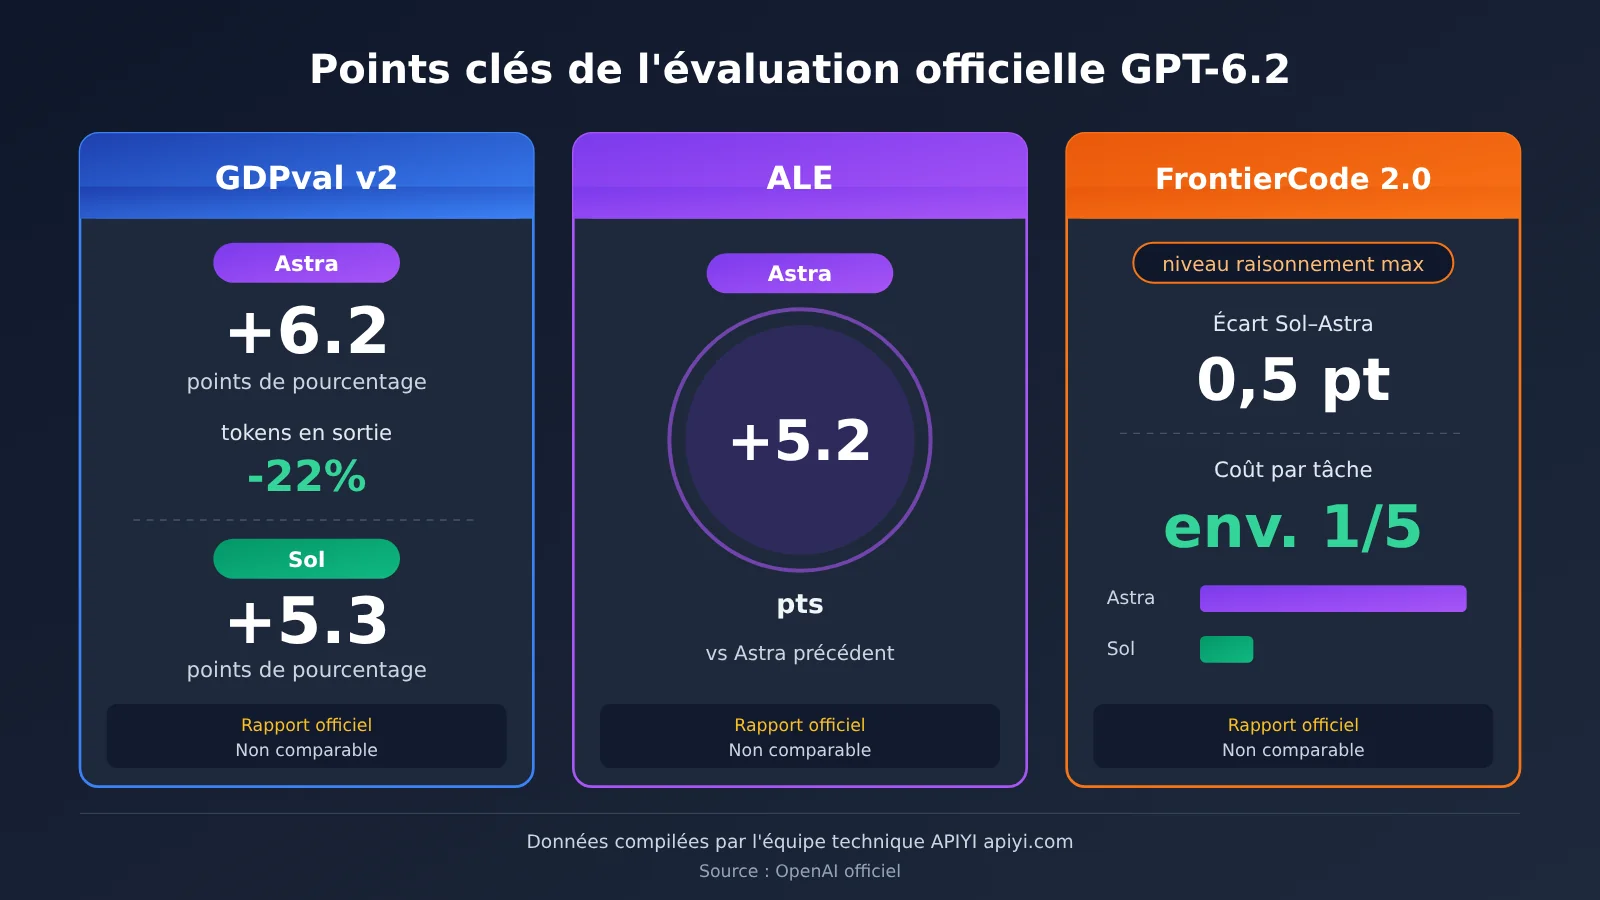
| GDPval v2 | GPT-6.2 Astra | Amélioration de 6,2 points de pourcentage, 22 % de tokens de sortie en moins | GPT-6 Astra |
| GDPval v2 | GPT-6.2 Sol | Amélioration de 5,3 points de pourcentage | GPT-6.1 Sol |
| ALE | GPT-6.2 Astra | Amélioration de 5,2 points | Astra de génération précédente |
| FrontierCode 2.0 (niveau de raisonnement max) | GPT-6.2 Sol | Écart avec Astra inférieur ou égal à 0,5 point, coût par tâche d’environ 1/5 de celui d’Astra | GPT-6.2 Astra |
Trois points méritent attention. Premièrement, les points de comparaison de génération précédente pour Astra et Sol sur GDPval v2 sont différents : Astra est comparé à GPT-6 Astra, tandis que Sol est comparé à GPT-6.1 Sol. Les deux chiffres 6,2 et 5,3 ne permettent donc pas de comparer directement lequel a le plus progressé. Deuxièmement, ALE utilise des « points », alors que GDPval v2 utilise des « points de pourcentage » ; les unités et les méthodes d’évaluation sont différentes. Troisièmement, la conclusion de FrontierCode 2.0 ne vaut que pour le niveau de raisonnement max de ce test. OpenAI n’a pas affirmé que Sol se situait à moins de 0,5 point d’Astra sur toutes les tâches, ni que Sol ne nécessitait qu’un cinquième du coût d’Astra dans tous les scénarios.
1.3 Limites des capacités de GPT-6.2 Astra et Sol
D’après la documentation officielle des modèles, les deux modèles acceptent du texte et des images en entrée, et produisent du texte en sortie. Ils peuvent donc lire des images, analyser des captures d’écran, comprendre des graphiques, puis répondre en texte ou fournir du code, mais ils ne sont pas eux-mêmes des modèles natifs de génération vidéo.
Si votre besoin est de générer des vidéos, cette publication n’apporte pas directement la capacité correspondante. Si votre besoin est de lire des documents, rédiger des rapports, écrire du code ou mener des analyses à plusieurs étapes, cette mise à niveau concerne davantage votre travail.
1.4 Tarifs standards officiels de l’API de GPT-6.2 Astra et Sol
La page officielle du modèle pour les développeurs publie les tarifs standards, exprimés en dollars par million de tokens. Voici les tarifs officiels ; ils ne représentent pas les offres de plateformes tierces.
| Élément de facturation | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Entrée non mise en cache | $8 | $2 |
| Lecture du cache | $0.4 | $0.1 |
| Sortie | $40 | $10 |
| Écriture du cache | Facturé selon le tarif d’écriture de la durée de conservation correspondante, sans cumul avec les frais d’entrée standard | Facturé selon le tarif d’écriture de la durée de conservation correspondante, sans cumul avec les frais d’entrée standard |
| Entrée dépassant 272K | Tarifs d’entrée et de cache ×2 pour toute la requête, sortie ×1.5 | Tarifs d’entrée et de cache ×2 pour toute la requête, sortie ×1.5 |
Ne cumulez pas la facturation du cache. Le volume d’entrée doit être divisé en quatre parties mutuellement exclusives : entrée non mise en cache, lecture du cache, écriture du cache de 30 minutes et écriture du cache de 12 heures ; volume d’entrée non mise en cache = volume d’entrée total − volume de lecture du cache − volume total d’écriture du cache. Chaque partie est multipliée par le tarif correspondant, et un même lot de tokens écrits n’est plus facturé en même temps au prix de l’entrée non mise en cache. Par exemple, pour Astra en contexte court Standard, le prix d’écriture de 30 minutes est de $10 par million de tokens ; il s’agit du tarif d’écriture complet pour cette partie, et non de $8 au prix de l’entrée non mise en cache auquel s’ajouteraient $10. Explication officielle de la facturation du cache
La règle des 272K mérite une attention particulière. Elle n’ajoute pas seulement un supplément au-delà de la limite : lorsque l’entrée d’une requête unique dépasse 272K tokens, les tarifs d’entrée et de cache de toute la requête doublent, et le tarif de sortie passe à 1.5 fois. Les utilisateurs qui ont l’habitude de fourrer l’intégralité de leur base documentaire dans le contexte en une fois pourraient voir leur facture bien plus élevée que prévu.
2. Analyse et appréciation de GPT-6.2 Astra et Sol
Ce qui suit est une interprétation de l’équipe éditoriale d’APIYI, fondée sur les faits officiels présentés plus haut. Il ne s’agit ni de conclusions officielles, ni de nos propres résultats de test. Les parties qui portent sur les tendances relèvent de l’appréciation : vérifiez-les en fonction de vos propres tâches.
2.1 Ce que cette mise à niveau de GPT-6.2 Astra et Sol apporte
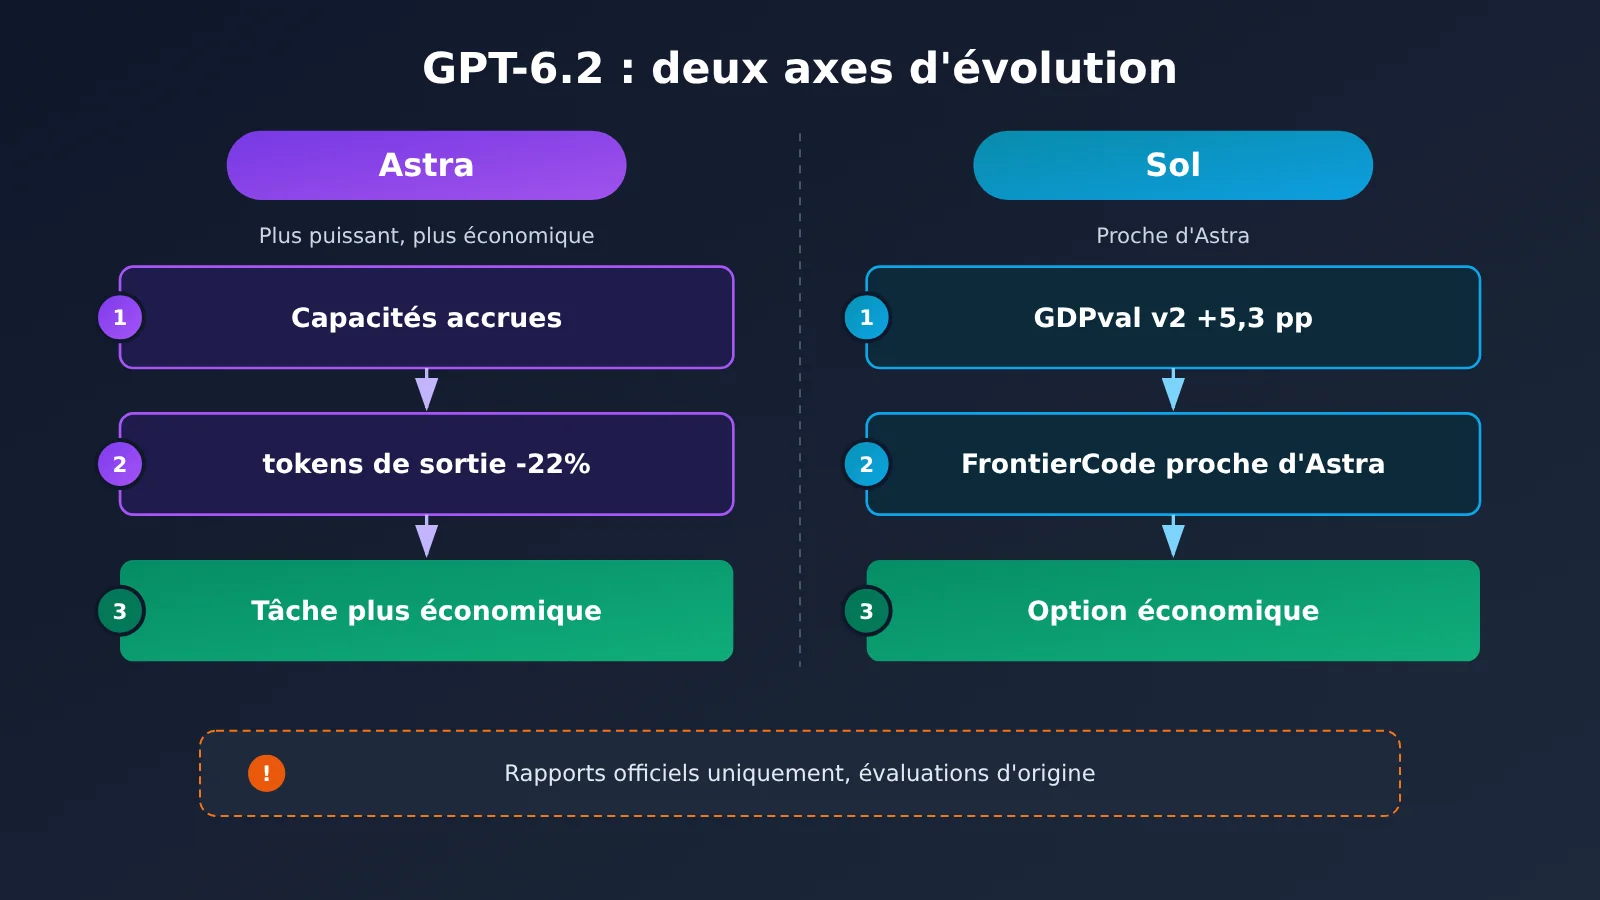
D’après les données officielles, cette mise à niveau se résume à deux axes principaux. Le premier concerne Astra : « plus performant et plus économique ». Sur GDPval v2, il gagne 6.2 points de pourcentage tout en réduisant de 22 % les tokens de sortie. Ces 22 % correspondent à l’évolution de la consommation de tokens de sortie dans le cadre de cette évaluation ; on ne peut pas en déduire directement la longueur visible de chaque réponse ni le pourcentage d’économie.
L’autre axe est le « rapprochement » de Sol. Il gagne 5.3 points de pourcentage sur GDPval v2 et, dans FrontierCode 2.0, l’écart avec Astra reste inférieur à 0.5 point au niveau de raisonnement max. Cela suggère que l’éditeur pousse Sol comme une option aux capacités solides et bien moins chère. Toutefois, ce jugement de « rapprochement » ne repose pour l’instant que sur un seul test de programmation ; il faudra davantage de données pour savoir s’il vaut aussi pour la rédaction, l’analyse, les documents longs, etc.
2.2 Positionnement respectif de GPT-6.2 Astra et Sol
Le tableau ci-dessous compare les deux modèles sur les mêmes critères. La colonne « Scénarios adaptés » relève d’un jugement de la rédaction, déduit des prix et de l’orientation des évaluations officielles ; cela ne signifie pas pour autant que l’autre modèle soit totalement inutilisable dans ces scénarios.
| Critère | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Orientation du positionnement | Tâches complexes, professionnelles et à forte valeur | Tâches sensibles à la vitesse et au coût |
| Prix officiels (entrée/sortie) | $8 / $40 | $2 / $10 |
| Points forts des évaluations officielles | GDPval v2 +6.2 points, tokens de sortie -22%, ALE +5.2 points | GDPval v2 +5.3 points ; sur FrontierCode 2.0, le niveau max reste à moins de 0.5 point d’Astra |
| Scénarios adaptés (jugement de la rédaction) | Rapports critiques, refactorisation de code complexe, raisonnement multi-étapes, aide à la décision où une erreur coûte cher | Traitement par lots, questions-réponses courantes, programmation standard, appels à haute fréquence, validation de prototypes |
| Points de vigilance | Prix unitaire élevé ; le coût augmente plus nettement avec un contexte long | Les tests de programmation sont proches d’Astra, mais on ne peut pas généraliser à toutes les tâches |
| Voies d’accès | ChatGPT Work, Codex, API officielle ; pour les plateformes d’agrégation tierces comme APIYI apiyi.com, se référer à leur liste de modèles | Idem |
Un détail facile à négliger : selon les tarifs officiels, le prix unitaire de Sol est environ le quart de celui d’Astra, tandis que le coût par tâche dans FrontierCode 2.0 est d’environ un cinquième. Cet écart est normal, car le coût d’une tâche dépend aussi du nombre de tokens réellement consommés. Cela rappelle aussi que, pour comparer les coûts, il faut regarder « le coût total pour accomplir une même tâche », et pas seulement le prix unitaire.
Prenons un exemple indicatif basé sur les tarifs officiels : pour une requête avec 100 000 tokens en entrée et 10 000 tokens en sortie, sans tenir compte du cache, Astra revient à environ $0.8 + $0.4 = $1.2, et Sol à environ $0.2 + $0.1 = $0.3. Le coût réel varie selon le niveau de raisonnement, la longueur de sortie et les hits de cache ; le calcul détaillé des coûts ne sera pas développé ici.
2.3 Faut-il choisir GPT-6.2 Astra ou Sol quand on est un simple utilisateur ?
Si vous utilisez ChatGPT Work au quotidien, le plus simple est de raisonner en termes de « coût d’une erreur ». Quand une tâche ratée vous oblige à repasser dessus longtemps, ou qu’elle pèse sur une décision importante — synthèse des points clés d’un contrat, analyse de données complexe, première ébauche d’un rapport officiel —, confiez-la plutôt à Astra. À l’inverse, pour des tâches simples, nombreuses et dont le résultat se vérifie vite — réécriture d’e-mails, mise au propre de comptes rendus de réunion, requêtes du quotidien —, Sol suffit généralement.
Pour les utilisateurs de Codex, les chiffres de FrontierCode 2.0 donnent une piste qui vaut le coup d’essayer : commencez par Sol pour les tâches de développement courantes, puis basculez sur Astra dès qu’il s’agit d’une refactorisation inter-modules, d’un bug difficile à isoler ou d’une conception d’architecture. Mais cela reste une recommandation fondée sur un test unique : le mieux est de vous fier à ce que vous observez sur votre propre base de code.
Si vous vous en tenez au chat ChatGPT classique, cette mise à disposition ne concerne pas cette entrée. Tant que l’équipe officielle n’a pas annoncé un élargissement du périmètre, vous n’avez rien à préparer pour cette sortie.
2.4 Comment les développeurs peuvent vérifier GPT-6.2 Astra et Sol via l’API
La démarche la plus sûre pour un développeur consiste à appeler les deux modèles sur le même lot de tâches réelles, puis à comparer la qualité, la latence et la consommation réelle de tokens. Les exemples ci-dessous sont adaptés de la documentation officielle du SDK ; ils n’ont pas encore été exécutés ni vérifiés. Ils utilisent l’interface officielle OpenAI, et l’ID du modèle doit être confirmé sur la page officielle des modèles. Si vous passez par une plateforme tierce, vérifiez d’abord dans la liste des modèles de la plateforme que le modèle est bien disponible : le présent article n’a vérifié la mise en ligne sur aucune plateforme tierce.
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # API officielle, clé fournie via une variable d'environnement
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # l'ID du modèle fait foi selon la page officielle ou la liste de modèles de la plateforme
    messages=[{"role": "user", "content": "用三句话总结这份需求文档的风险点"}]
)
print(response.choices[0].message.content)
Voir le code complet de l’appel comparatif Astra / Sol
import time
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # API officielle, clé fournie via une variable d'environnement
)

# l'ID du modèle fait foi selon la page officielle des modèles ou la liste de modèles de la plateforme
MODELS = ["gpt-6.2-astra", "gpt-6.2-sol"]

# remplacez par vos propres tâches réelles, pour ne pas se fier à un seul benchmark public
TASKS = [
    "阅读以下函数并指出潜在的并发问题:...",
    "把这段会议记录整理成 5 条待办事项:...",
]

def run(model: str, prompt: str) -> dict:
    start = time.time()
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        usage = resp.usage
        return {
            "model": model,
            "seconds": round(time.time() - start, 2),
            "input_tokens": usage.prompt_tokens,
            "output_tokens": usage.completion_tokens,
            "answer": resp.choices[0].message.content,
        }
    except Exception as e:
        return {"model": model, "error": str(e)}

for task in TASKS:
    for model in MODELS:
        result = run(model, task)
        print(result)
Notez également le volume total d’entrée, les lectures de cache, les écritures de cache selon la durée de rétention, la sortie facturée (raisonnement inclus) et l’usage des outils, puis calculez avec les tarifs réels du fournisseur et du niveau de service ; les prix officiels ne valent que pour une estimation sur l’API officielle. Il est aussi conseillé de limiter l’entrée d’une requête à 272K tokens, pour éviter que la requête entière ne déclenche un tarif plus élevé.
🎯 Conseil technique : si vous voulez comparer plusieurs modèles dans le même code, vous pouvez passer par l’interface compatible OpenAI d’APIYI apiyi.com : une seule clé API suffit pour basculer entre les principaux modèles (OpenAI, Claude, Gemini, etc.). Pour savoir si la série GPT-6.2 est déjà disponible sur la plateforme, référez-vous à la liste des modèles de la plateforme.
2.5 Les variables à suivre pour GPT-6.2 Astra et Sol
La première variable, c’est la portée du déploiement. Le Chat grand public n’est pas concerné par cette vague pour l’instant, et l’on ne sait pas officiellement si l’éditeur élargira l’accès, ni quand : c’est ce qui déterminera à quel moment la majorité des utilisateurs pourra profiter du nouveau modèle. La deuxième variable concerne les données sur d’autres types de tâches. Savoir si Sol parvient à approcher Astra en dehors de la programmation demande des évaluations tierces et davantage de benchmarks officiels.
La troisième variable, c’est le coût réel constaté. La baisse de 22 % des tokens de sortie d’Astra est un résultat mesuré sur GDPval v2 ; sur vos propres tâches, la proportion ne sera pas forcément la même. Mieux vaut consigner régulièrement vos données d’appels réels, plutôt que de figer une stratégie à long terme à partir des chiffres d’une conférence de lancement.
Le Lunyu (Entretiens de Confucius), chapitre Wei Ling Gong, dit : « Pour bien faire son ouvrage, il faut d’abord affûter ses outils. »
📚 Références
Journal des mises à jour de l’API OpenAI (vérification des dates de publication)
-
Page de publication officielle d’OpenAI : annonce et évaluations officielles de GPT-6.2 Astra et Sol
- Lien : texte officiel
- Contenu : date de publication, données GDPval v2, ALE et FrontierCode 2.0
-
Centre d’aide OpenAI : documentation sur ChatGPT Work et Codex
- Lien : texte officiel
- Contenu : points d’entrée et périmètre du déploiement progressif
-
Documentation développeur OpenAI – GPT-6.2 Astra : fiche modèle et tarifs de l’API
- Lien : texte officiel
- Contenu : modalités d’entrée et de sortie, tarifs standard, règles de facturation des longs contextes
-
Documentation développeur OpenAI – GPT-6.2 Sol : fiche modèle et tarifs de l’API
- Lien : texte officiel
- Contenu : modalités d’entrée et de sortie, tarifs standard, règles de facturation des longs contextes
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI (apiyi.com) ; vous trouverez davantage de ressources d’intégration au centre de documentation docs.apiyi.com