
Nota del autor: análisis de los datos de uso de ChatGPT en 165 categorías de actividades laborales publicados en OpenAI Signals v3.0, aclarando los criterios estadísticos y su valor de referencia para desarrolladores y aplicaciones empresariales de IA.
El 26 de octubre de 2026, el equipo de investigación económica de OpenAI publicó «ChatGPT’s expanding world of work» (cuyo título oficial en chino equivale a «El creciente mundo laboral de ChatGPT»), y hizo públicos datos de uso de ChatGPT que abarcan cerca de 100 países y regiones, 165 categorías de actividades laborales y 7 trimestres consecutivos. Estos datos forman parte del programa OpenAI Signals v3.0 y están disponibles para descarga gratuita bajo la licencia CC BY 4.0, de modo que los investigadores pueden usar directamente los CSV para análisis secundarios.
No se trata del lanzamiento de un nuevo modelo ni de una nueva función, sino de un conjunto de datos económicos sobre el uso dirigido a investigadores. Ya están disponibles a la vez el anuncio oficial, el diccionario de datos y las verificaciones de medios externos sobre los CSV originales, y los criterios de las cifras permiten contrastarse mutuamente. En este artículo separaremos claramente las conclusiones oficiales de los cálculos de terceros, para evitar malinterpretar la «proporción de mensajes» como «sustitución de puestos de trabajo».
Valor clave: entender en pocos minutos qué estadísticas incluyen realmente los datos de OpenAI sobre 165 categorías de actividades laborales, qué hallazgos hay y qué relevancia práctica tienen para los desarrolladores de aplicaciones de IA.
Resumen rápido de los datos clave de OpenAI sobre las 165 actividades laborales
Primero, una tabla para dejar claros los datos básicos de esta publicación sobre el uso de ChatGPT:
| Información | Detalle |
|---|---|
| Fecha de publicación | 26 de octubre de 2026 |
| Publicado por | Equipo de Investigación Económica de OpenAI (OpenAI Signals v3.0) |
| Sistema de clasificación | Actividades laborales de nivel intermedio (IWA) de O*NET (EE. UU.) |
| Cobertura | Cerca de 100 países y regiones; 165 tipos de actividades laborales |
| Periodo | Del primer trimestre de 2025 al tercer trimestre de 2026; 7 trimestres en total |
| Fuente de la muestra | Cuentas personales Free, Go, Plus y Pro de personas que declaran tener 18 años o más |
| Exclusiones | ChatGPT Enterprise, Codex, cuentas eliminadas y muestras no permitidas para entrenamiento |
| Licencia de datos | CC BY 4.0; consulta gratuita y descarga en CSV; se requiere atribución |
Las 165 actividades laborales no son 165 ocupaciones
Este es el punto donde más fácil resulta equivocarse al interpretar estos datos de OpenAI. O*NET es una base de datos de información ocupacional respaldada oficialmente por Estados Unidos, y descompone las “ocupaciones” en varios niveles de “actividades laborales”. Por ejemplo, la actividad “editar material escrito” aparece tanto en el trabajo de un editor como en el día a día de docentes, abogados, ingenieros y profesionales de finanzas.
Por eso, OpenAI mide “qué hace la gente con ChatGPT”, no “qué ocupaciones usan ChatGPT”. Las IWA (Intermediate Work Activities, actividades laborales de nivel intermedio) se sitúan entre comportamientos laborales amplios y tareas muy específicas; el marco de referencia de O*NET contiene 332 entradas de IWA en total.
OpenAI solo reporta por separado las actividades frecuentes que cumplen el umbral de muestra; las actividades poco frecuentes se agrupan. Según la revisión de PPC Land del CSV original, la tabla pública en realidad contiene 164 categorías con nombre propio más una categoría agregada, “Other IWA”, lo que da un total de 165 resultados de clasificación. Por eso no se puede decir que OpenAI haya contabilizado por completo las 332 categorías de IWA.
¿Cómo se recopilan y clasifican los datos?
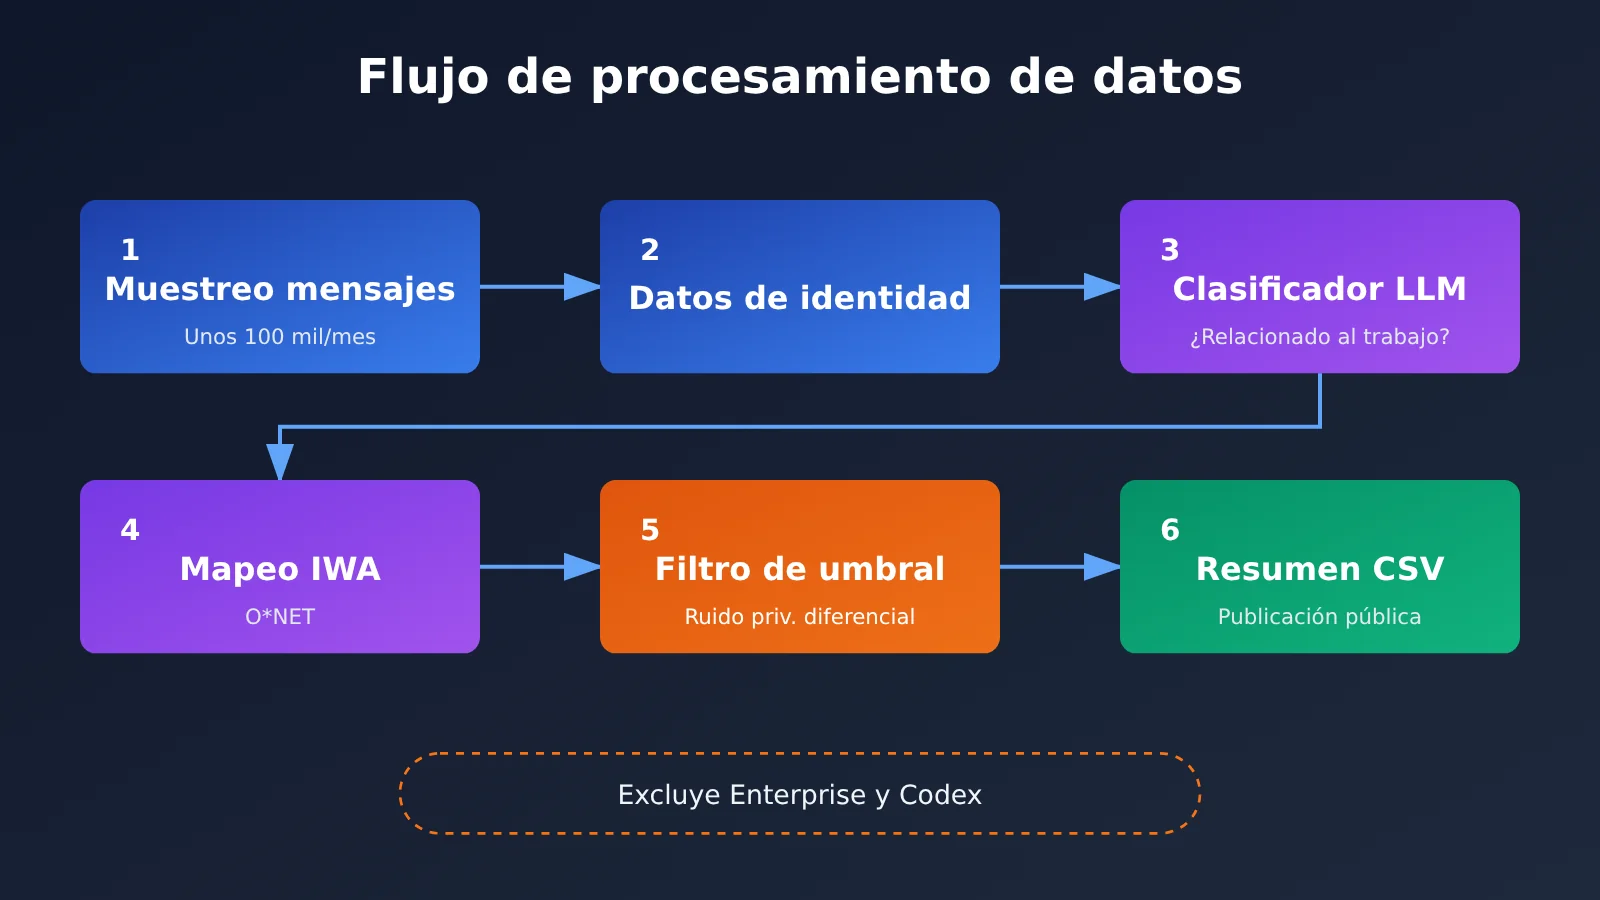
Signals v3.0 toma una muestra de aproximadamente 1 millón de mensajes de ChatGPT al mes. En conjunto, cubre 27 meses, de julio de 2024 a septiembre de 2026, y suma alrededor de 27 millones de muestras clasificadas. Cabe aclarar que los 27 millones son la suma de las muestras de cada mes: no equivalen al número de usuarios únicos ni implican que todos sean mensajes laborales.
La clasificación la realiza un clasificador automatizado basado en modelos de lenguaje: primero determina si el mensaje está relacionado con el trabajo y luego lo asigna a una actividad laboral de O*NET, al tiempo que etiqueta dimensiones como tema, intención, momento y región. En materia de privacidad, OpenAI afirma que los investigadores no leen directamente los chats originales, que la información de identidad se procesa antes de la clasificación, que solo se publican resultados agregados y que las muestras pequeñas se ocultan y reciben ruido de privacidad diferencial. Para publicar la distribución trimestral de actividades laborales por país se exige un mínimo de 1000 mensajes válidos.
El hallazgo más importante de los datos de uso de ChatGPT: los usos laborales están más dispersos
La conclusión principal que ofrece OpenAI es que los tipos de trabajo que los usuarios individuales resuelven con ChatGPT son cada vez más variados. En los 74 países y regiones con registros completos durante 7 trimestres, la proporción media de las diez actividades laborales más frecuentes de cada país dentro de los mensajes laborales clasificados de ese país ha caído de forma notable.
| Periodo | Proporción media de las diez principales actividades laborales por país |
|---|---|
| Primer trimestre de 2025 | 56.0% |
| Tercer trimestre de 2026 | 51.1% |
| Variación | -4.9 puntos porcentuales |
Aquí hay dos matices que deben quedar claros. Primero, 51.1% no es la proporción de un top 10 global unificado, sino que primero se calcula el top 10 de cada país y luego se promedia entre los 74 países; el top 10 de cada país puede ser distinto. Segundo, que baje la proporción no significa que caiga el volumen de mensajes: si el uso total está creciendo, el número absoluto de solicitudes de las actividades de la cabeza todavía podría aumentar.
En otras palabras, más actividades laborales de “cola larga” se reparten una porción mayor. Además, los 74 países y los casi 100 países son dos ámbitos muestrales diferentes; no conviene mezclarlos al citar los datos.
Qué actividades laborales concretas son las más frecuentes
PPC Land realizó un cálculo independiente el 27 de octubre de 2026 basándose en todos los CSV públicos, contabilizando por separado los 74 países y luego promediando. Estas son las seis actividades laborales nombradas más frecuentes del tercer trimestre de 2026 (cálculo de terceros, no una lista directa de los anuncios de OpenAI):
| Puesto | Actividad laboral | Porcentaje medio de mensajes en 74 países |
|---|---|---|
| 1 | Editar materiales escritos o documentos | 15,0% |
| 2 | Crear diseños visuales o contenido de presentación | 7,9% |
| 3 | Desarrollar materiales de marketing o promoción | 5,1% |
| 4 | Explicar información lingüística o cultural | 4,0% |
| 5 | Preparar materiales informativos o didácticos | 3,2% |
| 6 | Programar sistemas informáticos o equipos de producción | 3,1% |
Editar documentos sigue siendo el uso laboral más extendido, y el diseño visual ya ha subido al segundo puesto. El contenido de marketing, los materiales didácticos y la comprensión entre idiomas muestran una demanda clara, mientras que la programación, aunque importante, no ocupa la mayor cuota en esta muestra de cuentas personales.
El diseño visual sube, la programación baja
Según los cálculos de PPC Land, el porcentaje medio en 74 países de «crear diseños visuales o contenido de presentación» pasó del 3,1% en el primer trimestre de 2025 al 7,9% en el tercer trimestre de 2026, un aumento de 4,8 puntos porcentuales, la mayor subida entre las 165 categorías de actividades concretas. En Estados Unidos subió del 2,4% al 7,6% en el mismo periodo, y en el tercer trimestre de 2026 Brasil alcanzó el 11,2% e India el 8,7%.
Por el contrario, «programar sistemas informáticos o equipos de producción» cayó del 7,8% al 3,1%, en Estados Unidos del 6,7% al 2,4%, mientras que India todavía mantenía un 5,8% en el tercer trimestre de 2026. Actividades relacionadas como resolver problemas informáticos o investigar diseños técnicos también disminuyeron en paralelo. Una hipótesis razonable es que los desarrolladores se han pasado a agentes de programación especializados como Codex, pero los datos en sí no demuestran esa migración; una afirmación más prudente sería: en estos datos que excluyen Codex y las cuentas empresariales, la proporción de mensajes laborales de programación ha bajado de forma notable.
El marketing es otra señal que merece atención. El porcentaje medio de «producir materiales de marketing o promoción» pasó del 5,2% al 5,1%, prácticamente igual, y países como Argentina, Pakistán y Nigeria alcanzaron alrededor del 9% en el tercer trimestre de 2026. Esto indica que, aunque la proporción de escritura genérica está bajando, la demanda de contenido de marketing especializado sigue siendo estable.
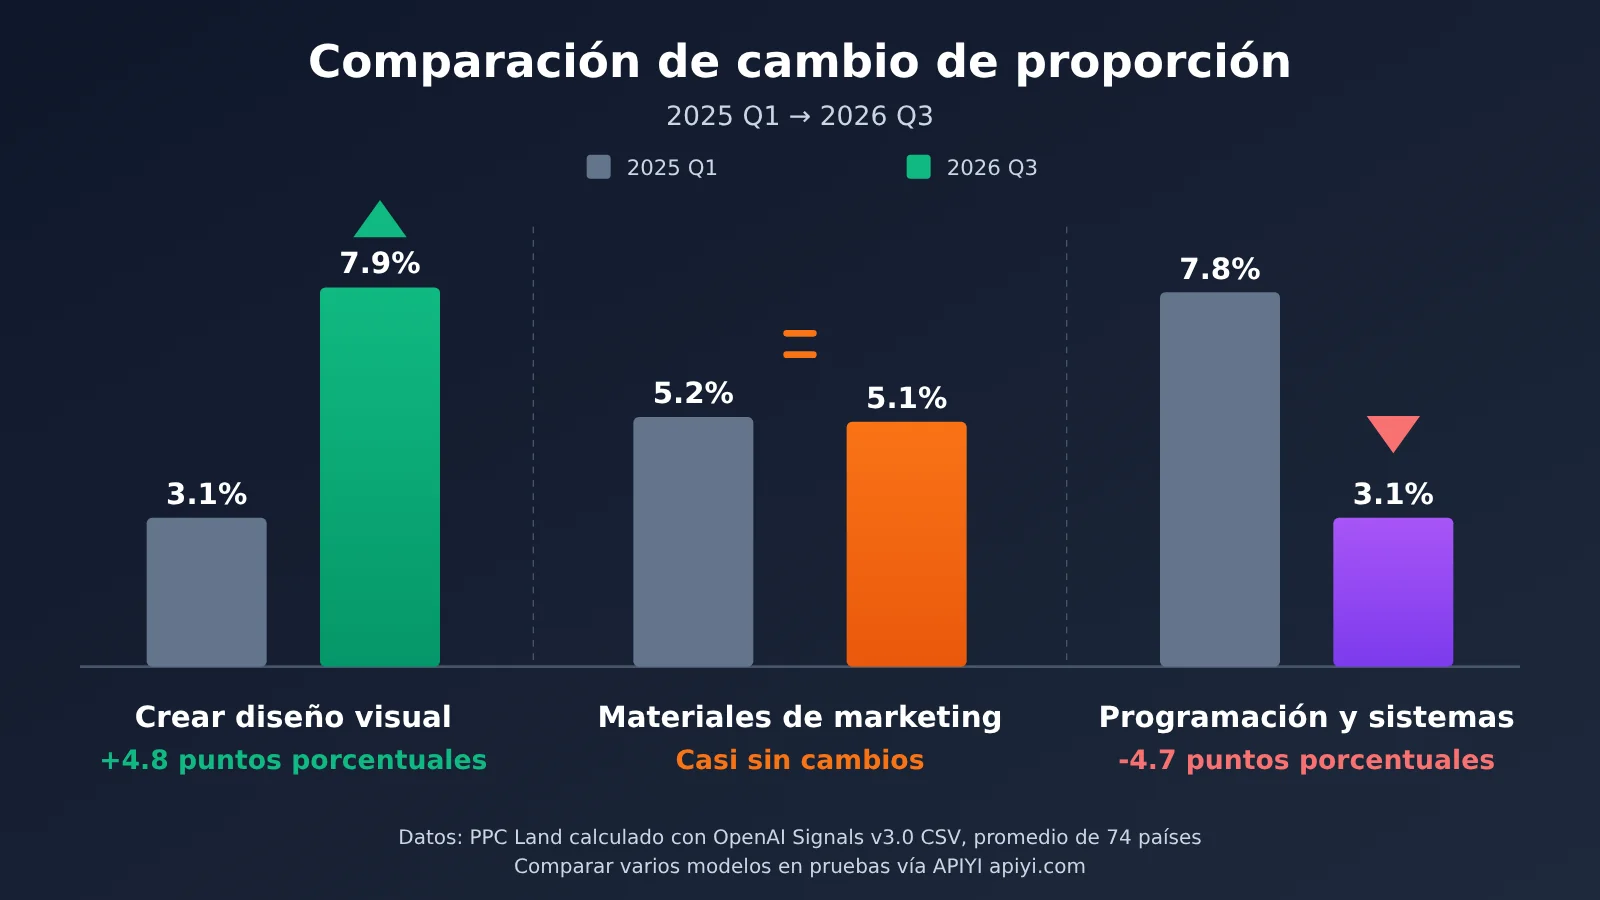
📊 Nota del gráfico: los datos de la imagen superior provienen del recálculo que PPC Land hizo de los CSV públicos de OpenAI. Si quieres comprobar en tu propio negocio qué modelo encaja mejor con solicitudes de «diseño, redacción o programación», puedes usar APIYI apiyi.com con la misma clave API para cambiar entre OpenAI, Claude, Gemini y otros modelos y hacer una comparación a pequeña escala.
Comparación de la estructura de trabajo de ChatGPT entre Estados Unidos y Alemania
PPC Land también revisó, una por una, las Actividades Laborales Generalizadas (Generalized Work Activities) más amplias de los gráficos interactivos de OpenAI (ojo: no están en el mismo nivel que las IWA anteriores y no deben mezclarse). La base estadística es el porcentaje de mensajes relacionados con el trabajo en cada país:
| Actividad laboral general | EE. UU. Q1 2025 | EE. UU. Q1 2026 | Alemania Q1 2025 | Alemania Q1 2026 |
|---|---|---|---|---|
| Tomar decisiones y resolver problemas | 22,8% | 21,6% | 22,0% | 19,4% |
| Pensamiento creativo | 11,8% | 15,6% | 11,3% | 13,1% |
| Registrar información | 10,6% | 11,8% | 10,3% | 11,4% |
| Usar computadoras | 11,7% | 6,7% | 12,7% | 8,4% |
| Proporcionar consultoría y asesoramiento | 5,5% | 9,0% | 7,1% | 11,7% |
| Explicar información a otras personas | 5,1% | 4,0% | 9,5% | 8,6% |
En ambos países, “tomar decisiones y resolver problemas” aparece como un uso importante, y el peso de “pensamiento creativo” y “consultoría y asesoramiento” sube de forma clara. Esto describe el tipo de solicitudes de los usuarios; no significa que ChatGPT ya tome decisiones de negocio por sí solo ni que ofrezca asesoramiento experto validado.
Entre países, el indicador de diferencia en la distribución transnacional que reporta PPC Land (distancia de variación total) subió ligeramente de alrededor del 22,2% a cerca del 23,0%. OpenAI también admite que esa diferencia puede deberse a la estructura laboral, la lengua y la cultura, la disponibilidad de herramientas y los hábitos de uso; los datos de este análisis no bastan para demostrar una relación causal.
Análisis del impacto para desarrolladores de los datos de 165 categorías de actividades laborales
Impacto en los desarrolladores de aplicaciones de IA
- La demanda se está ampliando: los usuarios ya no solo usan ChatGPT para editar documentos; el diseño visual, el marketing, los materiales didácticos y el asesoramiento también representan una cuota considerable. Las herramientas de IA de una sola función deben contemplar escenarios multitarea.
- Lo multimodal gana importancia: el diseño visual es la actividad que más ha crecido. En el mismo periodo, el tema «multimedia» dentro de todos los mensajes personales pasó del 2,0 % al 8,8 % (cálculo de PPC Land), así que vale la pena incluir las capacidades de imagen en la planificación del producto.
- Los escenarios de programación tienden a especializarse: la proporción de mensajes de programación en el chat general ha bajado, lo que sugiere que las necesidades orientadas al desarrollo pueden producirse más en agentes especializados o entornos empresariales, y conviene atenderlas con modelos de código y flujos de trabajo dedicados.
- Método de clasificación reutilizable: OpenAI utiliza un clasificador de LLM para asignar los mensajes a un sistema estándar de tareas. Este mismo enfoque también se puede aplicar al análisis de los registros de tu propio producto.
Impacto en la implementación de IA en las empresas
Los datos de cuentas personales no representan el uso empresarial. Otro conjunto de datos de OpenAI, Enterprise Signals, muestra que, a junio de 2026, entre los clientes empresariales analizados, Codex aportó el 64 % de los tokens de salida combinados de ChatGPT y Codex. Esto indica que la estructura de uso en el ámbito empresarial puede diferir bastante de la de las cuentas personales: a la hora de evaluar una solución interna de IA conviene basarse en los registros de tareas propios, en lugar de aplicar directamente los datos personales de Signals.
🚀 Inicio rápido: si quieres etiquetar las solicitudes de tu negocio como «actividad laboral» igual que hace OpenAI, te recomendamos montar un prototipo rápidamente con APIYI apiyi.com. La plataforma ofrece una interfaz compatible con OpenAI, los nuevos usuarios tienen crédito de prueba gratuito y en pocos minutos puedes ejecutar el ejemplo de abajo.
Reproducir la «clasificación de actividad laboral» con la API
Aquí tienes un ejemplo mínimo que usa un Modelo de Lenguaje Grande para clasificar una solicitud de usuario en unas pocas etiquetas de actividad laboral. El principio es el mismo que el del clasificador de OpenAI (las etiquetas son una simplificación ilustrativa, no el sistema completo de O*NET):
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

labels = "编辑文档, 视觉设计, 营销推广, 语言解释, 教学材料, 编程, 决策分析, 其他"
resp = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": f"从[{labels}]中选一个标签描述这条工作请求,只输出标签:帮我写一份新品发布的公众号推文"}]
)
print(resp.choices[0].message.content)
Ver el código completo de clasificación por lotes y cálculo de porcentajes
import openai
from collections import Counter
from typing import List

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una sola clave API permite cambiar entre varios modelos
)

LABELS = ["编辑文档", "视觉设计", "营销推广", "语言解释",
          "教学材料", "编程", "决策分析", "非工作", "其他"]

SYSTEM = (
    "你是工作活动分类器。先判断请求是否与工作相关,"
    f"再从以下标签中选择一个:{', '.join(LABELS)}。只输出标签本身。"
)

def classify(text: str, model: str = "gpt-4o-mini") -> str:
    try:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": text}],
            temperature=0,
            max_tokens=10,
        )
        label = r.choices[0].message.content.strip()
        return label if label in LABELS else "其他"
    except Exception as e:
        print(f"Error: {e}")
        return "其他"

def activity_share(messages: List[str]) -> dict:
    counts = Counter(classify(m) for m in messages)
    work = {k: v for k, v in counts.items() if k != "非工作"}
    total = sum(work.values()) or 1
    return {k: round(v / total * 100, 1) for k, v in work.most_common()}

if __name__ == "__main__":
    logs = [
        "帮我润色这份季度汇报",
        "设计一组活动海报的构图建议",
        "这段 Python 为什么读不到数据",
        "周末去哪里露营比较好",
    ]
    print(activity_share(logs))
Igual que ocurre con el método de OpenAI, esta clasificación automática puede equivocarse, y una misma tarea puede repartirse en varios mensajes. Por eso, el «porcentaje de mensajes» obtenido no equivale directamente a la carga de trabajo ni al valor de negocio.
Referencia de selección de modelos según la actividad laboral
Si tomamos las actividades con mayor peso en los datos, es posible hacer una selección preliminar por tipo de tarea. El rendimiento concreto, eso sí, hay que medirlo en tus propios datos:
| Actividad laboral | Capacidad prioritaria | Criterio de selección | Plataformas disponibles |
|---|---|---|---|
| Edición de material escrito | Comprensión y reescritura de texto | Modelo de Lenguaje Grande conversacional de uso general con buena relación costo-beneficio | APIYI apiyi.com, API oficial |
| Diseño visual y presentaciones | Generación y comprensión de imágenes | Modelo multimodal / de imagen | APIYI apiyi.com, API oficial |
| Materiales de marketing y promoción | Creatividad y control de estilo | Modelo insignia con un estilo de escritura estable | APIYI apiyi.com, API oficial |
| Programación y depuración | Razonamiento sobre código | Modelo con sólidas capacidades de código o un agente especializado | APIYI apiyi.com, API oficial |
| Toma de decisiones y consultoría | Razonamiento con contexto largo | Modelo de razonamiento, con revisión humana | APIYI apiyi.com, API oficial |
Limitaciones de los datos de OpenAI sobre 165 categorías de actividades laborales
Estos datos tienen mucho valor, pero sus límites también son claros. Estos son los puntos que más conviene tener en cuenta al citarlos:
- La muestra solo incluye cuentas personales de adultos: excluye Enterprise y Codex, así que no representa todos los usos laborales de los productos empresariales de OpenAI.
- La clasificación es automática: el clasificador LLM puede malinterpretar la intención; por ejemplo, «diseñar un plan de promoción para un evento» puede ser trabajo real de marketing o simplemente un interés personal.
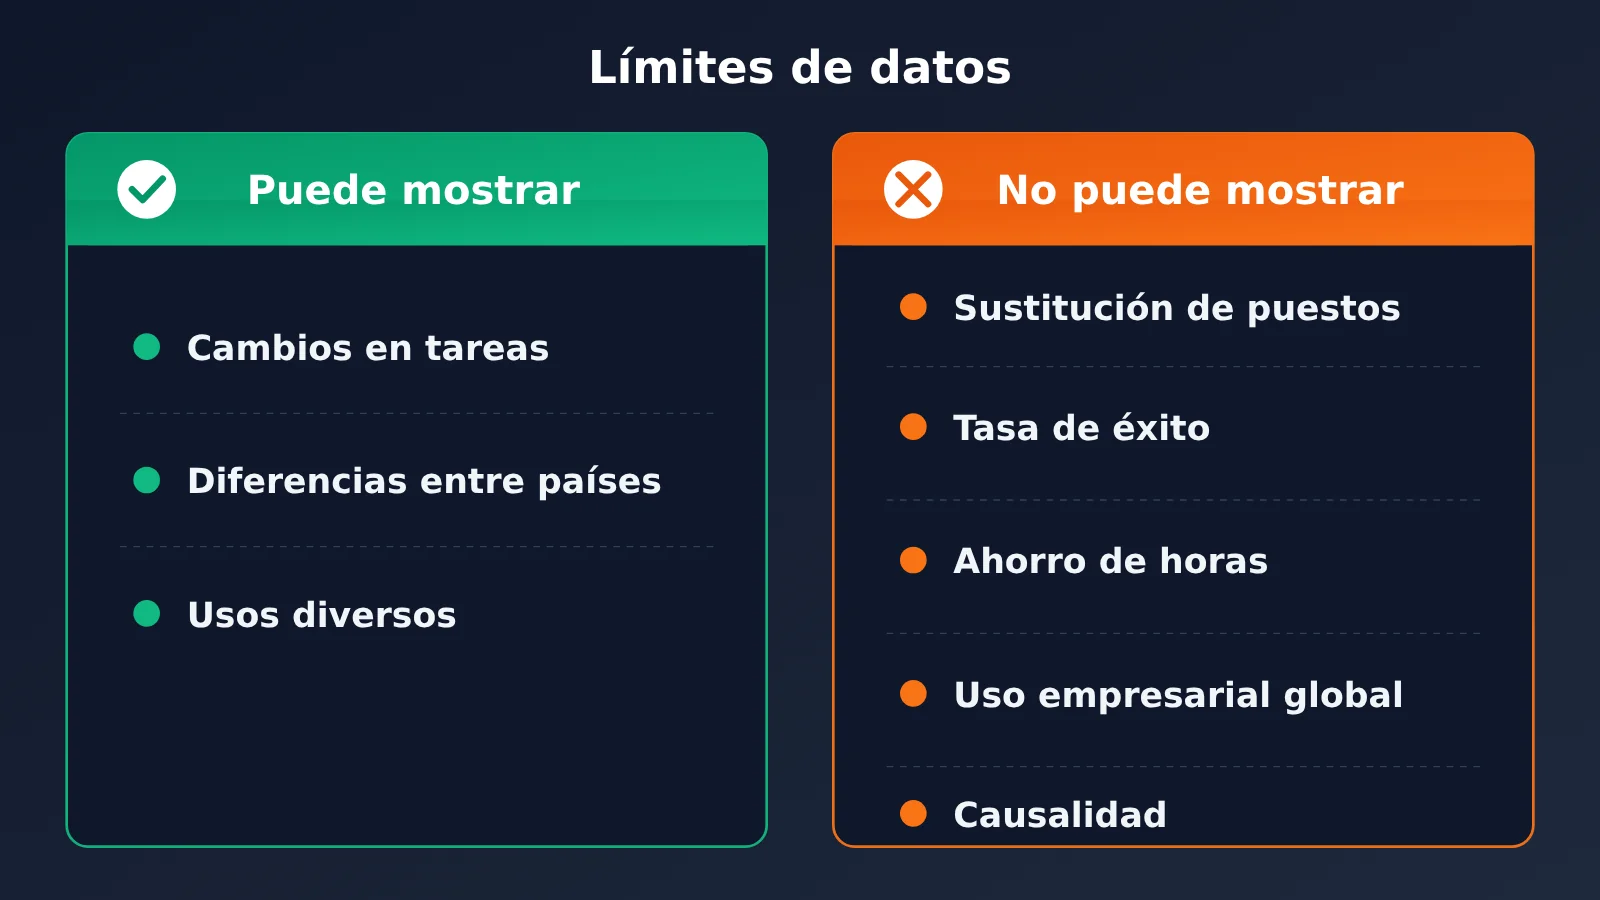
- El porcentaje de mensajes no equivale a producción: no representa el número de tareas, las horas de trabajo, la cantidad de usuarios, el tiempo ahorrado ni la tasa de éxito.
- Hay ruido de privacidad y umbrales de muestra: los resultados de muestras pequeñas se ocultan y se añade ruido de privacidad diferencial.
- No hay una correspondencia uno a uno con la economía real: al ponderar por número de ocupados, cerca del 43% de las actividades laborales reales en Estados Unidos cae en la categoría «Other IWA». Esto no significa que el 43% del trabajo no pueda ser realizado por IA, ni que el 57% restante ya esté cubierto por ChatGPT.
Además, los cálculos de PPC Land muestran que la proporción de mensajes personales etiquetados como relacionados con el trabajo bajó de aproximadamente 51,6% en julio de 2024 a cerca de 32,2% en septiembre de 2026. Lo más probable es que esto tenga que ver con la llegada masiva de usuarios no laborales y con el traslado de parte del trabajo profesional a cuentas empresariales y agentes especializados; no sirve para concluir que ChatGPT se haya vuelto menos importante para el ámbito laboral.
Preguntas frecuentes (FAQ)
P1: ¿Qué son los datos de las 165 categorías de actividades laborales publicados por OpenAI?
Se trata de un conjunto de datos agregados que OpenAI hizo públicos dentro del plan Signals v3.0. En él se asignan los mensajes relacionados con el trabajo de los usuarios particulares de ChatGPT a las 165 categorías de actividades laborales de nivel intermedio de O*NET, y cubre cerca de 100 países y regiones, desde el primer trimestre de 2025 hasta el tercer trimestre de 2026, es decir, 7 trimestres en total. Los datos se pueden descargar en formato CSV de forma gratuita.
P2: ¿Cuál es la diferencia entre las 165 categorías de actividades laborales y las 165 ocupaciones?
Una actividad laboral es «qué se hace»; una ocupación es «qué puesto». Una misma actividad (por ejemplo, editar documentos) puede aparecer en varias ocupaciones, así que estos datos describen qué tipos de trabajo se usan con ChatGPT para llevar a cabo, y no la tasa de uso por ocupación. Mucho menos permiten inferir qué ocupaciones serán reemplazadas.
P3: ¿Cuándo se publicaron estos datos y se actualizarán más adelante?
OpenAI los publicó el 26 de octubre de 2026, con datos hasta el tercer trimestre de 2026. La organización hace un seguimiento trimestral de los cambios, y si habrá actualizaciones continuas dependerá de los anuncios en la página de datos de OpenAI Signals. En este artículo no hacemos suposiciones al respecto.
P4: ¿El descenso en la proporción de mensajes de programación significa que la demanda de programación con IA está cayendo?
No se puede llegar a esa conclusión. Estos datos excluyen Codex y las cuentas corporativas, mientras que Enterprise Signals muestra una proporción muy alta de tokens de salida de Codex en el ámbito empresarial. La demanda de programación podría haberse trasladado a agentes especializados, o también estar relacionada con cambios en la composición de usuarios; los datos por sí solos no permiten distinguirlo.
P5: ¿Cómo reproducir un análisis de clasificación de actividades laborales similar usando la API?
Puedes consultar el código de ejemplo de este artículo y usar un Modelo de Lenguaje Grande para etiquetar tus propias solicitudes de usuario, y luego calcular las proporciones:
1. Accede a APIYI apiyi.com, regístrate y obtén una clave API
2. Reclama el crédito de prueba gratuito para nuevos usuarios
3. Configura el `base_url` del código como `https://api.apiyi.com/v1` y podrás cambiar entre distintos modelos para comparar los resultados de clasificación
P6: ¿Hay alguna forma sencilla de comparar el rendimiento de distintos modelos en tareas de diseño, redacción y programación?
Lo más cómodo es llamar a varios modelos a través de una interfaz unificada, ejecutar el mismo lote de indicaciones y luego evaluar manualmente. Con APIYI apiyi.com, una sola clave te permite invocar modelos como OpenAI, Claude o Gemini, con pago por uso, lo que resulta ideal para este tipo de experimentos comparativos a pequeña escala.
Puntos clave de los datos de OpenAI sobre 165 tipos de actividades laborales
- Se analizan actividades, no ocupaciones: los 165 tipos corresponden a actividades laborales de O*NET e incluyen una categoría combinada de «otras».
- Los usos están más dispersos: en 74 países, la proporción promedio de las diez actividades principales bajó del 56,0 % al 51,1 %.
- El diseño visual es lo que más crece: cálculos de terceros muestran un aumento del 3,1 % al 7,9 %.
- La proporción de programación baja, pero conviene interpretarlo con cautela: la muestra excluye Codex y las cuentas empresariales.
- La demanda de marketing se mantiene estable: la proporción de materiales de promoción y marketing se mantiene alrededor del 5 %.
- La proporción de mensajes no equivale a producción: no permite concluir sustitución de puestos, ahorro de horas de trabajo ni tasas de éxito.
- El método de clasificación se puede reutilizar: con la interfaz multimodelo de APIYI apiyi.com puedes montar rápidamente tu propio análisis de clasificación de tareas.
Resumen
La información central de los datos de uso de ChatGPT de OpenAI sobre 165 tipos de actividades laborales:
- Naturaleza de los datos: un conjunto de datos de investigación abierto y gratuito, con seguimiento trimestral, que registra qué actividades laborales se realizan con ChatGPT en cuentas personales.
- Principales hallazgos: los usos laborales son cada vez más dispersos; suben el diseño visual, la consultoría y el asesoramiento, y el pensamiento creativo, mientras baja la proporción de mensajes de programación general.
- Límites de interpretación: los datos no incluyen cuentas empresariales ni Codex, y la proporción de mensajes no equivale a carga de trabajo, impacto en puestos ni valor económico.
Lo que realmente revelan estos datos no es qué 165 profesiones están a punto de desaparecer, sino que la IA está entrando en distintos flujos de trabajo de formas más detalladas y diversas, y que varía según el país y el tipo de tarea. Para los desarrolladores, en lugar de preguntar «a quién va a reemplazar la IA», conviene ver qué actividades están completando realmente los usuarios con IA y luego elegir el modelo y el flujo de trabajo adecuados para esas actividades.
Recomendamos usar APIYI apiyi.com para validar rápidamente el rendimiento de distintos modelos en tu escenario de negocio; la plataforma ofrece crédito de prueba gratuito y una interfaz unificada para múltiples modelos.
📚 Referencias
- Anuncio oficial de OpenAI: ChatGPT’s expanding world of work: la fuente central de este lanzamiento
- Enlace:
openai.com/index/chatgpt-expanding-world-of-work -
Descripción: 165 tipos de actividades, casi 100 países, conclusiones oficiales del 56,0 % al 51,1 %, etc.
-
Descarga de datos y explicación metodológica de OpenAI Signals: punto de acceso al CSV original y al diccionario de datos
- Enlace:
openai.com/signals/data-download -
Descripción: alcance de la muestra, tratamiento de privacidad y condiciones de la licencia CC BY 4.0
-
PPC Land: Writing drops from 34% to 21% of ChatGPT requests since July 2024: análisis de terceros sobre el CSV
- Enlace:
ppc.land/writing-drops-from-34-to-21-of-chatgpt-requests-since-july-2024 -
Descripción: ranking concreto de actividades y cambios en la proporción de diseño visual y programación
-
PPC Land: Americans use ChatGPT at work most to make decisions: lectura de los gráficos interactivos entre EE. UU. y Alemania
- Enlace:
ppc.land/americans-use-chatgpt-at-work-most-to-make-decisions-1-in-5-requests -
Descripción: datos comparativos por país sobre actividades laborales de carácter amplio
-
Sitio web oficial de O*NET: sistema de clasificación de actividades laborales y ocupaciones
- Enlace:
onetcenter.org -
Descripción: comprensión de la definición de IWA y de las 332 entradas de referencia
-
OpenAI Enterprise Signals: datos de uso de cuentas empresariales
- Enlace:
openai.com/signals/enterprise-data - Descripción: sirve para distinguir los criterios de datos individuales de los empresariales
Autor: Equipo técnico de APIYI
Contacto técnico: puedes contactarnos en la página principal del sitio de APIYI; encontrarás más materiales de integración en el centro de documentación docs.apiyi.com




