Nota del autor: Este artículo analiza los cinco niveles de precios de Kimi K3.1 Pro, la facturación de la caché y los límites de uso según la tabla oficial de precios consultada el 24 de octubre de 2026. También incluye tres ejemplos de cálculo que puedes adaptar para saber cuánto cuesta realmente una solicitud.
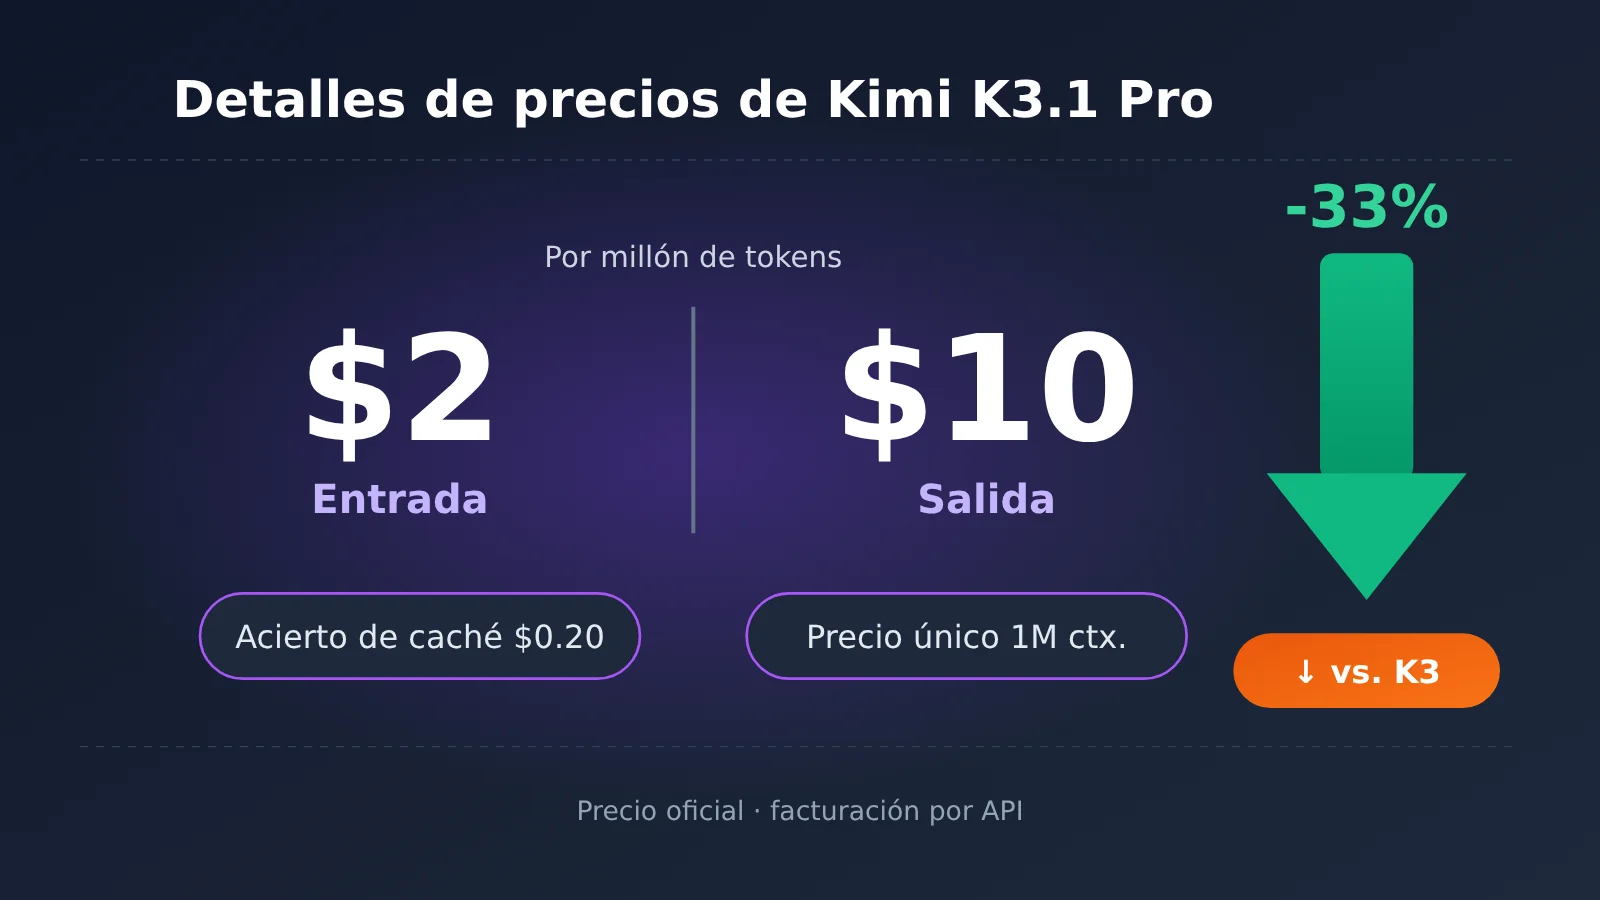
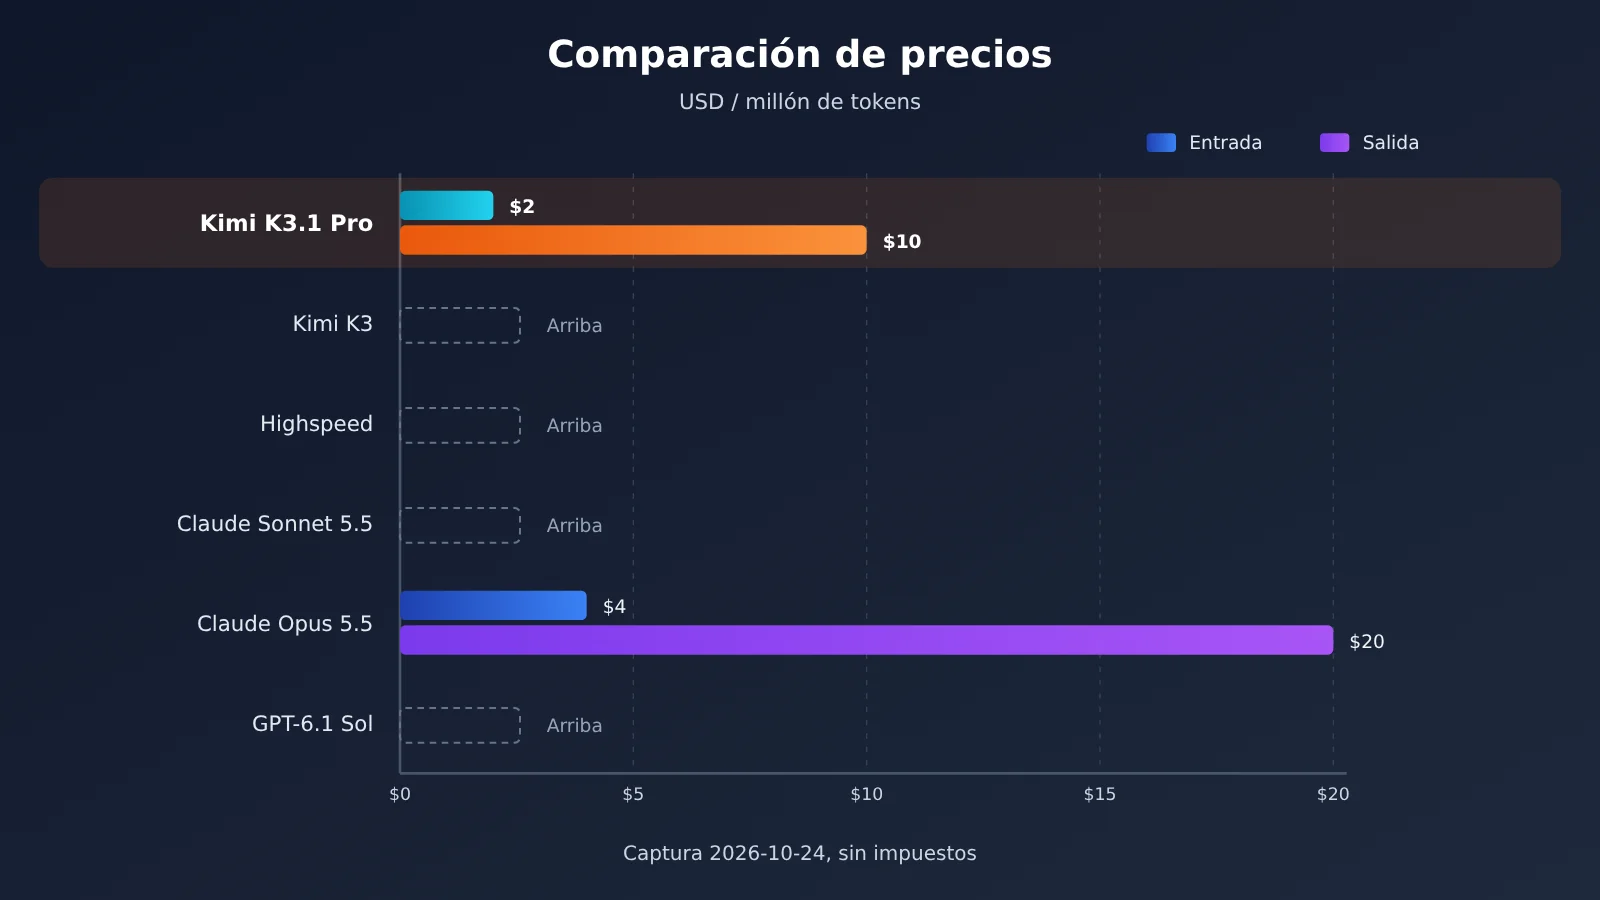
El precio oficial de Kimi K3.1 Pro es de 2 $ por la entrada y 10 $ por la salida; con la caché, solo cuesta 0,20 $ (en dólares por millón de tokens). Es un 33 % más barato que la generación anterior, Kimi K3. Tiene el mismo precio que Claude Sonnet 5.5 y GPT-6.1 Sol, y cuesta la mitad que Claude Opus 5.5.
Estas conclusiones se basan en la página oficial de precios de Moonshot (la documentación de precios de platform.kimi.ai) y en los cálculos de la entidad externa Artificial Analysis. En el artículo, todas las cifras indican su nivel de fuente: «oficial» se refiere a datos publicados por Moonshot en su blog o documentación oficial; «tercera parte», a cálculos externos como los de Artificial Analysis. Cuando no se encuentre una fuente fiable, se indicará «sin verificar».
Este artículo no se limita a copiar una tabla de precios. Que el precio unitario baje un 33 % no significa que tu factura vaya a reducirse en la misma proporción. A continuación, veremos en qué casos ahorrarás y en cuáles no.
Qué te llevas: Al terminar de leer, podrás calcular por tu cuenta el coste de una solicitud a Kimi K3.1 Pro, sabrás en qué casos conviene activar la caché y cuándo tendrás que subir de nivel de límites de uso con antelación. También conocerás las opciones de pago y acceso para desarrolladores de China.
1. Aspectos clave del precio de Kimi K3.1 Pro
Empecemos con una tabla que resume las preguntas más frecuentes. Más adelante, cada sección entra en detalle.
| Aspecto | Detalles | Fuente | Qué significa para ti |
|---|---|---|---|
| Precio base | Entrada: $2 / salida: $10 / aciertos de caché: $0.20 | Oficial | Está en el mismo rango de precio que Sonnet 5.5 y GPT-6.1 Sol |
| Comparación con la generación anterior | Los tres precios unitarios son un 33 % más bajos que los de K3 | Oficial / terceros | El precio por unidad ha bajado de forma significativa |
| Contexto | 1.048.576 tokens, con un precio único sin tramos | Oficial | Los documentos largos no cuestan más por superar cierto límite |
| Coste por tarea | Aproximadamente $1.98 (artículo publicado) / $2.11 (página del modelo) | Terceros | Es prácticamente igual que con K3: el coste no ha bajado en la misma proporción |
| Umbral inicial | Hay que recargar al menos $1; Tier0 permite solo 3 RPM | Oficial | Tendrás que subir de nivel antes de ampliar el uso |
Antes de continuar, conviene aclarar dos términos que aparecerán varias veces. Token es la unidad mínima de facturación del modelo; puedes entenderlo como un «fragmento de palabra». Como referencia, la documentación oficial indica que, en inglés, unos 3 o 4 caracteres equivalen a 1 token. Millón de tokens (MTok) equivale a 1.000.000 de tokens. Así, los $2 de la tabla de precios corresponden al coste de procesar un millón de tokens de entrada.
1.1 ¿Qué conceptos se cobran en Kimi K3.1 Pro?
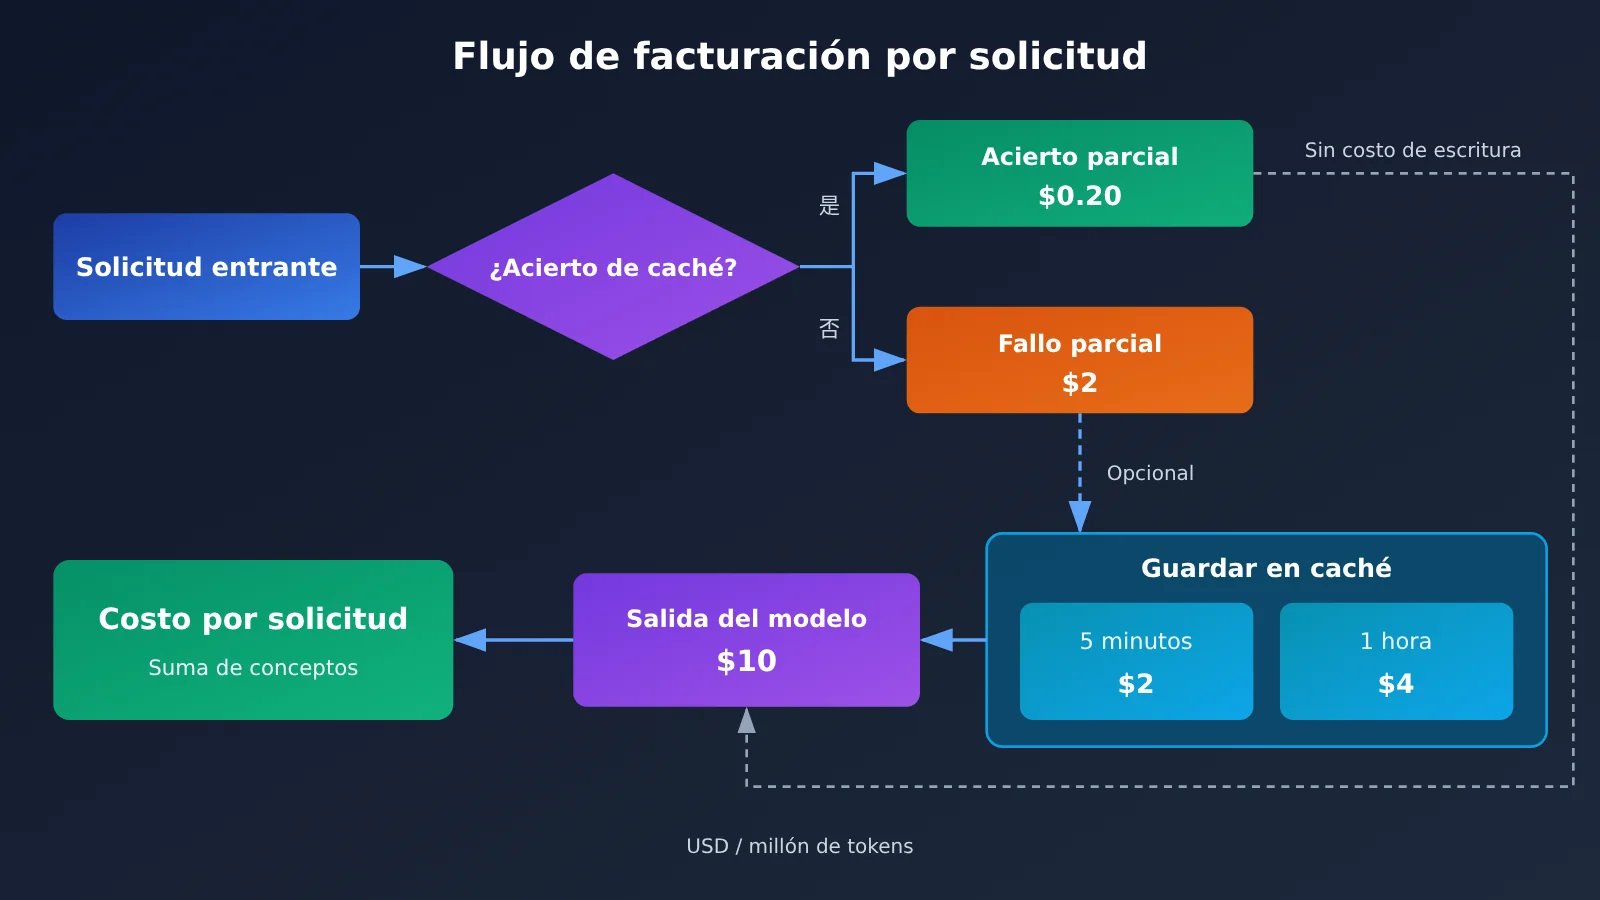
La documentación oficial contempla tres categorías facturables: escritura en caché (con dos opciones, de 5 minutos y de 1 hora), entrada (con acierto o fallo de caché) y salida. Al desglosarlas, se obtienen los cinco precios de la tabla. El coste de cada solicitud es la suma de estos conceptos, calculados según el número de tokens.
La caché de contexto es uno de los aspectos más importantes de estos precios. Si haces varias solicitudes seguidas con el mismo prefijo —por ejemplo, una indicación de sistema extensa—, la plataforma puede guardar ese contenido y reutilizarlo en las siguientes solicitudes. La parte reutilizada se cobra a una tarifa de acierto mucho más baja. Según la documentación oficial, la API de Kimi activa automáticamente la facturación de caché para los prefijos de solicitud repetidos. El TTL predeterminado es de 5 minutos; TTL significa «cuánto tiempo se conserva la caché».
La documentación oficial también recoge varias reglas que es fácil pasar por alto: en la serie K3, los aciertos de caché solo se cobran a la tarifa de acierto, sin ningún cargo adicional por escritura; las API relacionadas con archivos (extracción del contenido de documentos y almacenamiento de archivos) son gratuitas por ahora, pero el contenido extraído se factura por tokens cuando se envía al modelo; los precios de la tabla no incluyen impuestos y el importe final se calcula según las normas de la región de pago.
2. Lista completa de precios de Kimi K3.1 Pro: consulta de un vistazo sus cinco tarifas
La siguiente tabla recoge los precios de los cinco modelos principales actuales de Kimi para que puedas compararlos fácilmente. «No indicado» significa que la página oficial de precios no especifica esa tarifa, no que sea gratis.
| Modelo | Entrada (sin aciertos de caché) | Salida | Entrada con acierto de caché | Escritura en caché, 5 minutos | Escritura en caché, 1 hora |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| kimi-k3 (generación anterior) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
| kimi-k2.7-code | $0.95 | $4.00 | $0.19 | No indicado | No indicado |
| kimi-k2.6 | $0.95 | $4.00 | $0.16 | No indicado | No indicado |
Nota: datos consultados el 24-10-2026. Precios en dólares por millón de tokens, sin impuestos. Fuente: página oficial de precios.
De la tabla se desprenden varias tendencias. Primero, la escritura en caché durante 5 minutos en K3.1 Pro cuesta lo mismo que la entrada normal: $2. Por tanto, activar esta caché apenas supone un coste adicional. La escritura durante 1 hora cuesta $4, el doble que la entrada. Segundo, todas las tarifas de la versión Highspeed duplican las de la versión estándar, salvo el precio de entrada con acierto de caché, que también es de $0.20. En escenarios donde se reutilizan prefijos largos, la diferencia entre ambas versiones se reduce. Tercero, las tarifas por unidad de K2.7 Code y K2.6 son menos de la mitad que las de K3.1 Pro. Para tareas que no requieren la máxima capacidad de razonamiento, siguen siendo opciones más económicas.
2.1 Comparativa de Kimi K3.1 Pro con modelos de precio similar
Al comparar varios modelos populares con el mismo criterio (dólares por millón de tokens), queda más clara la posición de K3.1 Pro.
| Modelo | Entrada / salida | Entrada con caché | Escritura en caché · tramo corto | Escritura en caché · tramo largo | Fuente |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2 / $10 | $0.20 | $2 (5 minutos) | $4 (1 hora) | Oficial |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.20 | $4 (5 minutos) | $8 (1 hora) | Oficial |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | $2.50 (5 minutos) | $4 (1 hora) | Oficial |
| Claude Opus 5.5 | $4 / $20 | $0.20 | $5 (5 minutos) | $8 (1 hora) | Oficial |
| GPT-6.1 Sol (entrada ≤272K) | $2 / $10 | $0.10 | $2.50 (30 minutos) | $5 (12 horas) | Oficial |
| GPT-6.1 Sol (entrada >272K) | $4 / $15 | $0.20 | $5 (30 minutos) | $10 (12 horas) | Oficial |
| GPT-6 Astra (entrada ≤272K) | $10 / $50 | $1.00 | $12.50 (30 minutos) | $25 (12 horas) | Oficial |
| GPT-6 Astra (entrada >272K) | $20 / $75 | $2.00 | $25 (30 minutos) | $50 (12 horas) | Oficial |
Los datos de la tabla proceden de las páginas oficiales de precios de cada proveedor. Se recopilaron el 2026-10-24; los importes están expresados en dólares por millón de tokens y no incluyen impuestos. Los tres proveedores ofrecen distintos periodos para la caché: Kimi y Claude, 5 minutos y 1 hora; OpenAI, 30 minutos y 12 horas. El precio de escritura es, respectivamente, 1,25 y 2,5 veces el precio de entrada sin caché. En la mayoría de los modelos, la lectura de la caché cuesta el 10 % del precio de entrada; GPT-6.1 Sol es la excepción, con un 5 %. OpenAI también aplica distintos tramos según la longitud de la entrada: hasta 272K tokens se cobra la tarifa de contexto corto, y por encima de 272K se pasa a la tarifa de contexto largo. La tabla solo incluye las tarifas estándar: no muestra la opción Batch de OpenAI, que cuesta la mitad, ni Fast (antes Priority) y UltraFast, que son más caras.
En comparación, Claude Sonnet 5.5 y GPT-6.1 Sol tienen un precio más bajo para las entradas con caché ($0.10 en ambos casos), lo que les da ventaja en situaciones donde se reutilizan con frecuencia prefijos largos. Sin embargo, la escritura en caché de Sonnet 5.5 durante 5 minutos cuesta $2.50, un poco más que los $2 de K3.1 Pro. En cambio, K3.1 Pro resulta más adecuado para tareas que requieren cargar documentos grandes de una sola vez, gracias a su menor coste de escritura y a una tarifa uniforme para el contexto. La entrada y la salida de Claude Opus 5.5 cuestan el doble que las de K3.1 Pro; el motivo para elegirlo debería ser su nivel de capacidad, no el precio. El punto débil de GPT-6.1 Sol es la escritura en caché: la tarifa de 30 minutos es de $2.50, más que los $2 del tramo de 5 minutos de K3.1 Pro. Además, el precio depende de la longitud de la entrada: al superar los 272K tokens, la entrada sube a $4 y la salida a $15. Para tareas con documentos largos, hay que tomar como referencia la fila de contexto largo.
Recomendación: las diferencias de rendimiento entre modelos de precio similar dependen de la tarea concreta. Te recomendamos probarlos con el mismo conjunto de indicaciones antes de decidir. En la tabla de modelos de APIYI (apiyi.com) encontrarás claude-sonnet-5-5, claude-opus-5-5, kimi-k3 y otros modelos, para que puedas compararlos con una sola clave API. El nombre exacto y el precio de K3.1 Pro dependerán de la lista de modelos de la plataforma. Esperamos ofrecer este modelo pronto.
3. ¿Cuánto cuesta una solicitud a Kimi K3.1 Pro? 3 ejemplos de cálculo
Una vez entendida la tabla de precios, lo que de verdad importa es saber cuánto cuesta «esta llamada». Los siguientes tres ejemplos cubren situaciones típicas: una conversación breve, la reutilización de una indicación larga y la lectura de un documento extenso. Incluimos los cálculos para que puedas sustituirlos por tus propios números de tokens. La fórmula general es: coste = número de tokens × precio unitario ÷ 1,000,000.
3.1 Ejemplo 1: coste de una solicitud breve a Kimi K3.1 Pro
Situación: una pregunta y respuesta normal, con 2,000 tokens de entrada (sin acierto de caché) y 500 tokens de salida.
- Entrada:
2000 × 2 ÷ 1000000 = $0.004 - Salida:
500 × 10 ÷ 1000000 = $0.005 - Total:
$0.004 + $0.005 = $0.009
Es decir, una conversación breve de este tipo cuesta menos de un centavo de dólar. Ten en cuenta que el precio unitario de salida es cinco veces el de entrada. En las solicitudes breves, la salida suele representar más de la mitad del coste, así que reducir su longitud suele ser más eficaz que comprimir la entrada.
3.2 Ejemplo 2: reutilización y caché de una indicación larga en Kimi K3.1 Pro
Situación: una indicación del sistema de 20,000 tokens y 10 preguntas consecutivas en un plazo de 5 minutos. Cada pregunta añade 1,000 tokens de entrada nueva y genera 800 tokens de salida.
Sin usar la caché, cada solicitud paga el precio completo por toda la indicación:
- Una solicitud:
(20000 + 1000) × 2 ÷ 1000000 + 800 × 10 ÷ 1000000 = $0.042 + $0.008 = $0.05 - 10 solicitudes:
$0.05 × 10 = $0.50
Al usar la caché, la primera solicitud escribe la indicación del sistema en ella y las 9 siguientes la reutilizan:
- Primera solicitud: escritura en caché
20000 × 2 ÷ 1000000 = $0.04, más$0.002por la entrada nueva y$0.008por la salida; total:$0.05 - De la segunda a la décima solicitud: acierto de caché
20000 × 0.2 ÷ 1000000 = $0.004, más$0.002 + $0.008; total por solicitud:$0.014 - Total de las 9 solicitudes siguientes:
$0.014 × 9 = $0.126 - Total:
$0.05 + $0.126 ≈ $0.18
Con la misma conversación de 10 turnos, el coste baja de $0.50 a unos $0.18: un ahorro de alrededor del 60 %. Este patrón —una indicación larga y fija seguida de varias preguntas— es muy común en bots de atención al cliente, asistentes de programación y frameworks de agentes. Es uno de los casos en los que la caché resulta más útil.
3.3 Ejemplo 3: lectura de un documento extenso con Kimi K3.1 Pro
Situación: leer un documento de 300,000 tokens y generar un resumen de 3,000 tokens.
- Entrada:
300000 × 2 ÷ 1000000 = $0.60 - Salida:
3000 × 10 ÷ 1000000 = $0.03 - Total: unos
$0.63
Si haces otra pregunta sobre el mismo documento en un plazo de 5 minutos, la parte del documento se beneficiará de un acierto de caché. El coste de entrada será de solo 300000 × 0.2 ÷ 1000000 = $0.06, a lo que se suma el coste de la salida de esa solicitud. Si necesitas consultar varias veces el mismo contrato, informe financiero o código fuente, concentrar las preguntas dentro del periodo de validez de la caché puede reducir considerablemente el coste.
4. Precio único para el contexto de 1M de Kimi K3.1 Pro: qué significa no tener tramos
El contexto puede entenderse como la cantidad total de contenido que el modelo puede procesar de una vez: incluye la indicación, el historial de la conversación y los documentos que subes. La documentación oficial indica que toda la serie K3 admite un contexto de 1.048.576 tokens y que K3.1 Pro cobra una tarifa plana, sin tramos según la longitud del contexto.
En esencia, las preguntas frecuentes oficiales dicen que K3.1 Pro ofrece un contexto de 1M y una tarifa plana por uso: las escrituras en caché, las entradas —tanto las que aciertan en la caché como las que no— y las salidas tienen el mismo precio unitario. En otras palabras, tanto si envías 2.000 tokens como si envías 800.000, el precio por millón de tokens sigue siendo de 2 dólares. La tarifa no sube porque la solicitud sea más larga.
Esto es importante al comparar modelos, porque no todos los proveedores calculan los precios de la misma manera. La serie GPT-6 de OpenAI aplica tramos según la longitud de la entrada: para ≤272K tokens se cobra la tarifa de contexto corto; al superar los 272K, se pasa de inmediato a una tarifa más cara para contexto largo. Por ejemplo, en GPT-6 Astra, el precio de entrada pasa de 10 a 20 dólares, el de salida de 50 a 75 dólares y el de las entradas que aciertan en la caché de 1,00 a 2,00 dólares. Claude sigue otro enfoque: su página oficial de precios indica que los modelos Claude 4.6 y posteriores —con la excepción de Claude Haiku 5.5— cobran la tarifa estándar para todo el contexto de 1M. Una solicitud de 900.000 tokens tiene el mismo precio unitario que una de 9.000. Solo Claude Haiku 5.5 aumenta la tarifa cuando la indicación supera los 100.000 tokens. Así que K3.1 Pro no es el único modelo que no aplica tramos: Claude Sonnet 5.5 y Opus 5.5 tampoco cobran más según la longitud. Los que realmente cambian de tramo son los modelos de la serie GPT-6.
Para los desarrolladores, la tarifa única ofrece dos ventajas directas:
- El presupuesto se puede calcular de forma lineal: si se duplican los tokens, se duplica el costo. No hay un salto repentino al alcanzar cierta longitud, así que puedes calcular directamente el costo del documento de 300.000 tokens del ejemplo 3 multiplicando por la tarifa unitaria.
- No hace falta dividir los documentos a propósito: con los modelos que aplican tarifas por tramos, algunos usuarios dividen los documentos largos en partes para evitar el tramo más caro. En K3.1 Pro, hacerlo no reduce el costo y puede perjudicar los resultados al perder contexto.
5. Por qué Kimi K3.1 Pro permite ahorrar y en qué casos no
En esta sección vamos a hacer las cuentas con claridad. El precio por token sí ha bajado, pero el costo real de las tareas también depende de la longitud de las respuestas.
| Aspecto | Detalles | Fuente | Impacto en el costo |
|---|---|---|---|
| Reducción del precio por token | Las tarifas de entrada, salida y aciertos de caché son un 33 % más bajas que las de K3 | Oficial / terceros | Ahorro |
| Precio por acierto de caché | $0.20, una décima parte del precio de entrada | Oficial | Gran ahorro cuando se reutilizan prefijos largos |
| Escritura en caché de 1 hora | $4, el doble del precio de entrada | Oficial | Conviene más para tareas con intervalos largos; no hace falta usarla en tareas cortas |
| Razonamiento siempre activo | No se puede desactivar; la salida media es de 55K tokens, un 14 % más que en K3 | Oficial / terceros | Compensa parte de la reducción de precio |
| Costo por tarea | $1.98 (según el artículo de lanzamiento) / $2.11 (costo ponderado de la página del modelo) | Terceros | Prácticamente igual que K3 |
5.1 Tres formas en que Kimi K3.1 Pro permite ahorrar
La primera es la reducción directa del 33 % en el precio por token: de $3/$15 en K3 a $2/$10. El precio por acierto de caché también baja de $0.30 a $0.20. Tanto la lista oficial de precios como los datos de Artificial Analysis coinciden en este punto. La segunda es que los aciertos de caché cuestan solo una décima parte del precio de entrada. Como vimos en el ejemplo 2, las conversaciones con varias rondas y una indicación fija y larga pueden ahorrar alrededor de un 60 %. La tercera es que, aunque la escritura en caché de 1 hora cuesta el doble, permite conservar la caché durante más tiempo. Es útil para tareas en las que pasan más de 5 minutos entre una invocación y otra, como un agente programado que se ejecuta cada cierto tiempo o las consultas sobre documentos largos en las que el usuario se detiene a pensar antes de hacer otra pregunta. Si se producen más de dos aciertos en una hora, lo que pagas de más por la escritura suele compensarse.
5.2 En qué casos Kimi K3.1 Pro no permite ahorrar
El razonamiento es el proceso interno que realiza el modelo antes de responder. Ese contenido también se factura como salida. La documentación oficial indica que no se puede desactivar el razonamiento en K3.1 Pro; solo se puede reducir su intensidad ajustando reasoning_effort a low.
Según las mediciones de Artificial Analysis (un tercero), K3.1 Pro genera una media de unos 55K tokens de salida por tarea en su Intelligence Index, frente a los 48K de K3: un 14 % más. La tarifa de salida es la más alta, así que esos tokens adicionales absorben parte del ahorro derivado de la bajada de precios. El costo por tarea que calcula este tercero es de unos $1.98 (según el artículo de lanzamiento), mientras que el costo ponderado que muestra la página del modelo es de $2.11 (con un descuento del 90 % en la caché). En ambos casos, el costo es prácticamente igual al de K3.
En resumen: si tu uso se basa sobre todo en entradas largas y en reutilizar contenido en varias rondas, la reducción de precio de K3.1 Pro se notará claramente en la factura. Si predominan las tareas de razonamiento complejo con respuestas muy largas, el costo por tarea quizá no sea menor que el de K3. Te recomendamos probar primero con un lote pequeño de tareas reales y revisar la factura resultante.
6. Umbral de recarga y niveles de limitación de Kimi K3.1 Pro
El servicio oficial funciona con pago por uso, sin suscripción. Además, Kimi API, la membresía de Kimi y Kimi Code tienen sistemas de facturación independientes: la membresía no cubre los gastos de API. Para empezar a hacer llamadas, hay que recargar al menos $1. Al alcanzar una recarga acumulada de $5, se recibe un cupón de $5, que no cuenta para el importe acumulado de recarga (según la información oficial).
El nivel de limitación depende del importe acumulado de las recargas. Primero, aclaremos algunas abreviaturas: concurrencia es el número de solicitudes que se pueden procesar al mismo tiempo; RPM es el máximo de solicitudes por minuto; TPM es el máximo de tokens que se pueden procesar por minuto; TPD es el máximo de tokens que se pueden procesar al día.
| Nivel | Recarga acumulada | Concurrencia | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500 mil | 1,5 millones |
| Tier1 | $10 | 15 | 100 | 2 millones | Sin límite |
| Tier2 | $20 | 40 | 100 | 3 millones | Sin límite |
| Tier3 | $100 | 50 | 200 | 3 millones | Sin límite |
| Tier4 | $1000 | 60 | 200 | 4 millones | Sin límite |
| Tier5 | $3000 | 100 | 300 | 5 millones | Sin límite |
Nota: los datos proceden de la documentación oficial sobre límites de uso (página pricing/limits de platform.kimi.ai). Consulta realizada el 2026-10-24.
Las restricciones de Tier0 son muy estrictas: solo se pueden enviar 3 solicitudes por minuto y el total diario es de 1,5 millones de tokens. Con un documento de 300 mil tokens como el del ejemplo 3, bastaría con procesarlo 5 veces en un día para alcanzar el límite. Además, con un TPM de 500 mil, ni siquiera caben dos documentos de ese tamaño en un mismo minuto. Si vas a procesar contenido por lotes o a ofrecer el servicio a usuarios, te conviene elevar la recarga acumulada al menos a Tier1 durante la fase de pruebas.
Hay otro detalle importante: según la información oficial, una vez que se activa la limitación por control de riesgos, no se puede levantar. Antes de poner el servicio en marcha, configura en el cliente el control de la tasa de solicitudes y los reintentos con espera progresiva. No uses scripts concurrentes para tantear el límite.
7. Cómo pagar y conectar Kimi K3.1 Pro desde China
Los canales oficiales cobran en dólares y aplican las reglas de pago según la región. Aunque se puede pagar directamente desde China, a los desarrolladores de allí suelen preocuparles los métodos de pago internacionales, las facturas y tener que gestionar las claves de varios proveedores. Otra opción es conectarse mediante una plataforma agregadora de API, que permite usar una sola cuenta y una sola clave para llamar a varios modelos.
APIYI (apiyi.com) es una plataforma que agrega API de modelos de lenguaje grandes. Con una sola clave API, puedes llamar a modelos populares como OpenAI, Claude y Gemini. Su interfaz es compatible con el formato de OpenAI, cobra según el uso y ofrece créditos de prueba gratuitos a los nuevos usuarios. Según la revisión del catálogo de modelos de la plataforma en docs.apiyi.com/models, realizada el 24 de octubre de 2026, los modelos de la serie Kimi disponibles actualmente son:
kimi-k3: entrada $3 / salida $15 / lectura de caché $0.3kimi-k2.7-code: entrada $0.95 / salida $3.99 / lectura de caché $0.19kimi-k2.6: entrada $0.6 / salida $2.4 / lectura de caché $0.1kimi-k2.5: entrada $0.6 / salida $3.15 / lectura de caché $0.1
El día de la revisión, kimi-k3.1-pro todavía no aparecía en el catálogo de modelos de APIYI, así que este artículo no indica su precio en la plataforma. Consulta en la consola de la plataforma el nombre del modelo, el precio y la fecha de disponibilidad de K3.1 Pro. Estamos trabajando para ofrecer este modelo; mientras tanto, puedes probar el flujo con kimi-k3 y, cuando K3.1 Pro esté disponible, solo tendrás que cambiar el nombre del modelo.
7.1 Pasos para empezar rápidamente con Kimi K3.1 Pro
Tanto si usas el canal oficial como una plataforma agregadora, los pasos de integración son, en general, los mismos. Este ejemplo usa el formato compatible con OpenAI:
- Regístrate y obtén una clave API. En el canal oficial, primero tendrás que recargar al menos $1.
- En el SDK de OpenAI o el cliente que uses, configura
base_urlcomohttps://api.apiyi.com/v1si te conectas mediante APIYI. Si el proyecto usa el formato de Anthropic, configura la URL base comohttps://api.apiyi.com. - Configura
api_keycon tu clave ymodelcon el nombre que aparece en el catálogo de la plataforma; por ejemplo,kimi-k3, que está disponible actualmente. Cuando K3.1 Pro esté disponible, usa el nombre que figure en el catálogo. - Si quieres reducir el costo de salida generado por el razonamiento, añade
reasoning_efforta los parámetros de la solicitud y asígnale el valorlow. Según la documentación oficial, K3.1 Pro permite reducir el nivel de razonamiento, pero no desactivarlo. - Coloca la indicación de sistema larga y fija al principio de los mensajes, y mantenla sin cambios para que el prefijo repetido pueda aprovechar la caché automáticamente.
- Después de llamar al modelo, comprueba en la factura o en los campos de uso de la respuesta cuántos tokens corresponden a la entrada, a los aciertos de caché y a la salida. Luego, vuelve a hacer el cálculo con la fórmula de la sección 3.
Consejo para empezar rápidamente: usa primero los créditos de prueba gratuitos de APIYI en apiyi.com para ejecutar el ejemplo 2 de la sección 3. Compara el uso con y sin un prefijo fijo; es la forma más rápida de comprobar si la caché está funcionando. Consulta el catálogo de modelos para conocer el nombre y el precio de K3.1 Pro en la plataforma. Estamos trabajando para ofrecer este modelo.
Preguntas frecuentes
P1: ¿Cuál es exactamente el precio de Kimi K3.1 Pro?
El precio oficial es de $2 por la entrada, $10 por la salida, $0.20 por las lecturas desde caché, $2 por las escrituras en caché de 5 minutos y $4 por las escrituras en caché de 1 hora. Los precios están en dólares por millón de tokens, no incluyen impuestos y se consultaron el 24-10-2026.
P2: ¿Cuánto más barato es Kimi K3.1 Pro que K3? ¿La factura bajará realmente un 33 %?
Los tres precios unitarios son un 33 % más bajos (según los datos oficiales). Sin embargo, K3.1 Pro siempre activa el modo de razonamiento y genera un 14 % más de tokens de salida, en promedio. Según los cálculos de la entidad independiente Artificial Analysis, el coste por tarea es de aproximadamente $1.98 a $2.11, prácticamente igual que con K3. El ahorro será más notable en tareas con entradas largas y reutilización en varias interacciones.
P3: ¿Qué opción sale más barata, Kimi K3.1 Pro o Claude Sonnet 5.5?
Ambos cuestan lo mismo por entrada y salida: $2/$10. Sonnet 5.5 tiene un precio menor por las lecturas desde caché ($0.10), mientras que K3.1 Pro cobra menos por las escrituras en caché de 5 minutos ($2 frente a $2.50) y mantiene un precio unitario uniforme para el contexto de 1 millón de tokens. Sonnet es más conveniente para reutilizar con frecuencia prefijos cortos; K3.1 Pro, para cargar documentos grandes de una sola vez. Lo mejor es comparar ambos con tareas reales.
P4: ¿Vale la pena activar la caché de 1 hora de Kimi K3.1 Pro?
La escritura en caché de 1 hora cuesta $4, es decir, $2 más que la de 5 minutos. Suele valer la pena si se vuelve a usar el mismo prefijo más de dos veces después de los primeros 5 minutos y antes de que transcurra una hora. Si las llamadas se concentran en unos pocos minutos, basta con la opción predeterminada de 5 minutos.
P5: ¿Cómo pueden los desarrolladores de China usar la API para llamar a Kimi K3.1 Pro?
Pueden usar los canales oficiales o conectarse mediante APIYI apiyi.com con una interfaz compatible con OpenAI. En `base_url`, deben indicar `https://api.apiyi.com/v1`. La plataforma ya ofrece modelos como `kimi-k3` y `kimi-k2.7-code`. El nombre y el precio de K3.1 Pro dependerán de la lista de modelos de la plataforma; esperamos ofrecerlo pronto.
P6: ¿La membresía de Kimi sirve para descontar los costes de la API?
No. Según la información oficial, Kimi API se paga según el uso y no tiene un plan de suscripción. La membresía de Kimi y Kimi Code se facturan por separado.
P7: ¿Qué aspectos de la facturación de Kimi K3.1 Pro conviene tener en cuenta?
– No se puede desactivar el razonamiento, por lo que la cantidad de tokens de salida puede ser mayor. Puedes mitigarlo configurando `reasoning_effort` como `low`.
– Tier0 solo permite 3 RPM y 1,5 millones de TPD; si necesitas más capacidad, solicita una mejora de nivel con antelación.
– Una vez que se activa la limitación de velocidad por controles de riesgo, no se puede revertir.
– La extracción de archivos es gratuita, pero el contenido extraído se factura como entrada cuando se envía al modelo.
P8: ¿Qué se puede preparar mientras la plataforma aún no ofrece K3.1 Pro?
Puedes configurar el flujo de llamadas, la estructura de caché y las estadísticas de uso con `kimi-k3` en APIYI apiyi.com. Cuando K3.1 Pro esté disponible, solo tendrás que cambiar el nombre del modelo. El nombre y el precio concretos dependerán de la lista de modelos de la plataforma; esperamos ofrecerlo pronto.
Puntos clave del precio de Kimi K3.1 Pro
- Precio base: $2 por entrada / $10 por salida / $0,20 por acierto de caché. Precio oficial, sin impuestos.
- Cinco tarifas disponibles: escritura en caché durante 5 minutos por $2 y durante 1 hora por $4; el costo de escritura es muy bajo.
- Posicionamiento frente a otros modelos: cuesta lo mismo que Sonnet 5.5 y GPT-6.1 Sol, y la mitad que Opus 5.5.
- Precio unitario uniforme: la ventana de contexto de 1M no tiene tarifas escalonadas según la longitud, así que el presupuesto se puede estimar de forma lineal.
- Costo real: el modo de pensamiento permanente genera un 14 % más de salida, por lo que el costo por tarea es prácticamente igual al de K3 (según terceros).
- Requisito inicial: recarga mínima de $1; Tier 0 permite solo 3 RPM y el límite de velocidad por control de riesgos no se puede eliminar.
- Acceso desde China: puedes conectarte mediante la API compatible con OpenAI de APIYI. El nombre del modelo y el precio de K3.1 Pro dependerán de la lista de modelos de la plataforma; lo incorporaremos lo antes posible.
Resumen
Puntos clave del precio de Kimi K3.1 Pro:
- Precio unitario: $2 por entrada / $10 por salida / $0,20 por acierto de caché. Es un 33 % más barato que K3 y mantiene un precio uniforme para la ventana de contexto de 1M.
- Cómo ahorrar: coloca los prefijos largos y fijos al principio y aprovecha la caché. En conversaciones de varias rondas, puedes reducir alrededor de un 60 % el costo de entrada.
- Expectativas de costo: el pensamiento permanente genera salidas más largas. En tareas complejas de razonamiento, el costo por tarea se acerca al de K3; no calcules el presupuesto suponiendo una reducción del 33 %.
- Preparación para el lanzamiento: mejora con antelación el nivel de límites de velocidad y configura el control de ritmo para evitar que se active un límite por control de riesgos que no se puede eliminar.
Te recomendamos usar primero la fórmula de la sección 3 con tu propia distribución de tokens para estimar los costos y, después, validarlos con unas pocas tareas reales. Si necesitas comparar modelos como Kimi, Claude y GPT desde China con una sola clave API, puedes solicitar un crédito gratuito en APIYI, apiyi.com, para hacer pruebas. El nombre del modelo y el precio de K3.1 Pro en la plataforma dependerán de la lista de modelos; lo incorporaremos lo antes posible.
Referencias
- Plataforma abierta de Kimi: precios de los modelos: precios y reglas de facturación de los cinco niveles de K3.1 Pro y otros modelos
- Enlace:
platform.kimi.ai/docs/pricing/chat -
Nota: Fuente oficial de la tabla de precios y de la facturación unificada para contextos de 1M
-
Plataforma abierta de Kimi: recargas y límites de uso: niveles de Tier0 a Tier5 y controles de riesgo
- Enlace:
platform.kimi.ai/docs/pricing/limits -
Nota: Fuente oficial de los requisitos de recarga y los límites de RPM/TPM/TPD
-
Artificial Analysis: Kimi K3.1 Pro: estimación de costes por tarea y tokens de salida de terceros
- Enlace:
artificialanalysis.ai -
Nota: Fuente de los datos de coste por tarea de $1.98 / $2.11 y de 55K tokens de salida mencionados en este artículo
-
Lista de modelos de APIYI: modelos disponibles actualmente en la plataforma y sus precios
- Enlace:
docs.apiyi.com/models - Nota: Información sobre la disponibilidad real de modelos como Kimi y Claude en la plataforma
Autor: equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página de inicio del sitio web de APIYI. Encontrarás más información en el centro de documentacióndocs.apiyi.com.