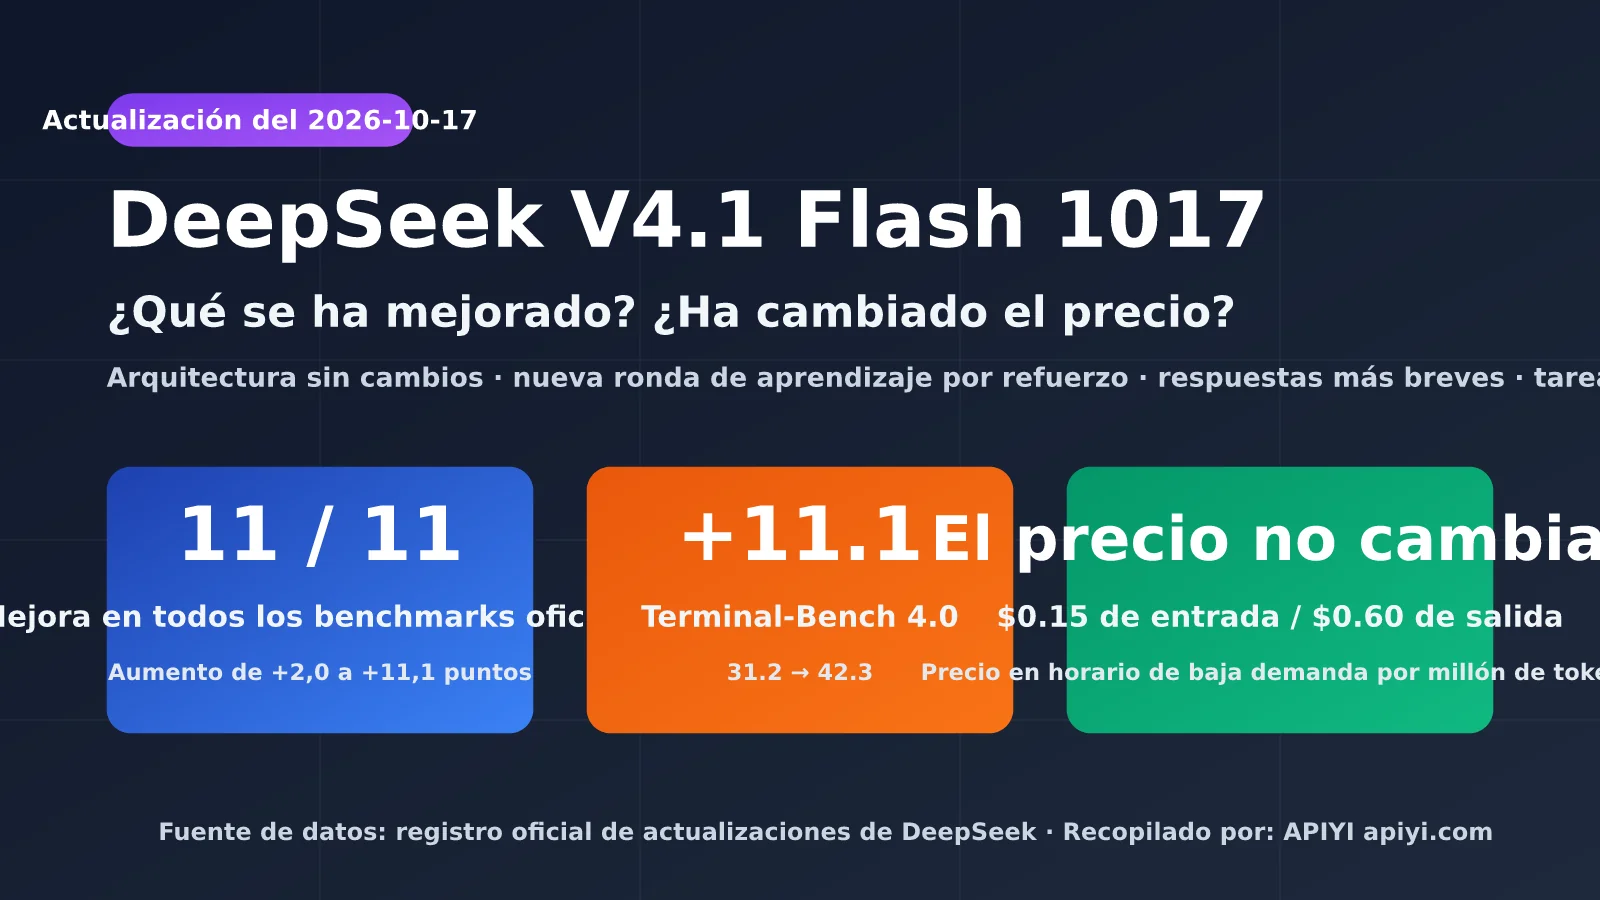
El 17 de octubre de 2026, DeepSeek actualizó discretamente V4.1 Flash a DeepSeek-V4.1-Flash-1017. La compañía presentó el cambio como una actualización menor, pero, a juzgar por los datos publicados, los 11 benchmarks que presentó mejoraron, y Terminal-Bench 4.0 subió 11,1 puntos. Eso ya va más allá de unos simples retoques.
A muchos desarrolladores les interesan sobre todo dos cosas: ¿qué ha mejorado exactamente en DeepSeek V4.1 Flash 1017? ¿Ha cambiado el precio? En este artículo responderemos basándonos únicamente en los datos de las notas de actualización oficiales de DeepSeek, su página de precios y la ficha del modelo en Hugging Face. Las afirmaciones de terceros se identificarán por separado.
Lo esencial: al terminar de leer, sabrás cuánto ha mejorado realmente la versión 1017, por qué mantener el precio significa en la práctica pagar menos y cómo reducir a la mitad el coste de la API de DeepSeek aprovechando las horas de menor demanda.
Qué es DeepSeek V4.1 Flash 1017: una actualización menor sin cambios de arquitectura
DeepSeek V4.1 Flash es el modelo más pequeño de la nueva familia de arquitecturas que se lanzó el 10 de septiembre de 2026 y admite de forma nativa la comprensión de imágenes. La versión 1017 es su primera iteración, publicada aproximadamente un mes después. Las notas oficiales de la actualización son concisas: el modelo se actualiza a DeepSeek-V4.1-Flash-1017, y la web y la aplicación reciben la actualización al mismo tiempo. Tanto la forma de invocar la API como los precios se mantienen sin cambios.
Según la información técnica de Hugging Face, la versión 1017 conserva la misma arquitectura: 552B de parámetros en el modelo principal, con unos 8B de parámetros activos por token durante el prellenado y alrededor de 16B durante la decodificación, además de 196B de memoria condicional Engram. Los análisis de la comunidad anglófona coinciden en que el cambio proviene de una nueva ronda de posentrenamiento con aprendizaje por refuerzo. No se modificaron los archivos de configuración, el tokenizador ni la codificación de indicaciones, por lo que no hace falta cambiar el código existente.
| Aspecto | DeepSeek V4.1 Flash 1017 | Descripción |
|---|---|---|
| Fecha de lanzamiento | 2026-10-17 | Primera iteración de la versión inicial del 10 de septiembre |
| Nombre del modelo en la API | deepseek-flash |
El alias apunta automáticamente a la versión más reciente |
| Nombres de modelos anteriores | deepseek-v4-flash, entre otros |
Siguen disponibles; se redirigen a la 1017 y se cobran al precio de Flash |
| Arquitectura | MoE, 552B de parámetros principales, 8B/16B activos | Igual que en la versión inicial |
| Contexto / salida máxima | 1M / 384K | Datos de la página oficial de precios |
| Modo de razonamiento | Razonamiento (predeterminado) y sin razonamiento | Ambos modos están disponibles |
| Multimodalidad | Admite imágenes de entrada | La versión Pro aún no admite visión |
| Licencia de código abierto | MIT | Los pesos están disponibles en Hugging Face y ModelScope |
| Límite de concurrencia | 2.500 | La versión Pro tiene un límite de 500 |
Cabe destacar una indicación específica de DeepSeek: la versión 1017 se optimizó para DeepSeek Harness, Tencent CodeBuddy y WorkBuddy. Además, se recomienda usar DeepSeek Harness 0.2.1-rc.1 o una versión posterior. Esto sugiere que el entrenamiento se centró en escenarios de programación con agentes. Si utilizas un ciclo de agente propio, es posible que la mejora real sea menor que la que muestran las cifras oficiales.
🎯 Consejo técnico: los alias de modelo apuntan automáticamente a la versión más reciente. Antes de cambiar el tráfico de producción, conviene ejecutar una prueba de regresión con muestras de tu propio negocio. Con APIYI en apiyi.com puedes invocar DeepSeek y otros modelos principales con la misma clave, lo que facilita compararlos con un único conjunto de pruebas.
Qué mejoró en DeepSeek V4.1 Flash 1017: comparación detallada de 11 benchmarks
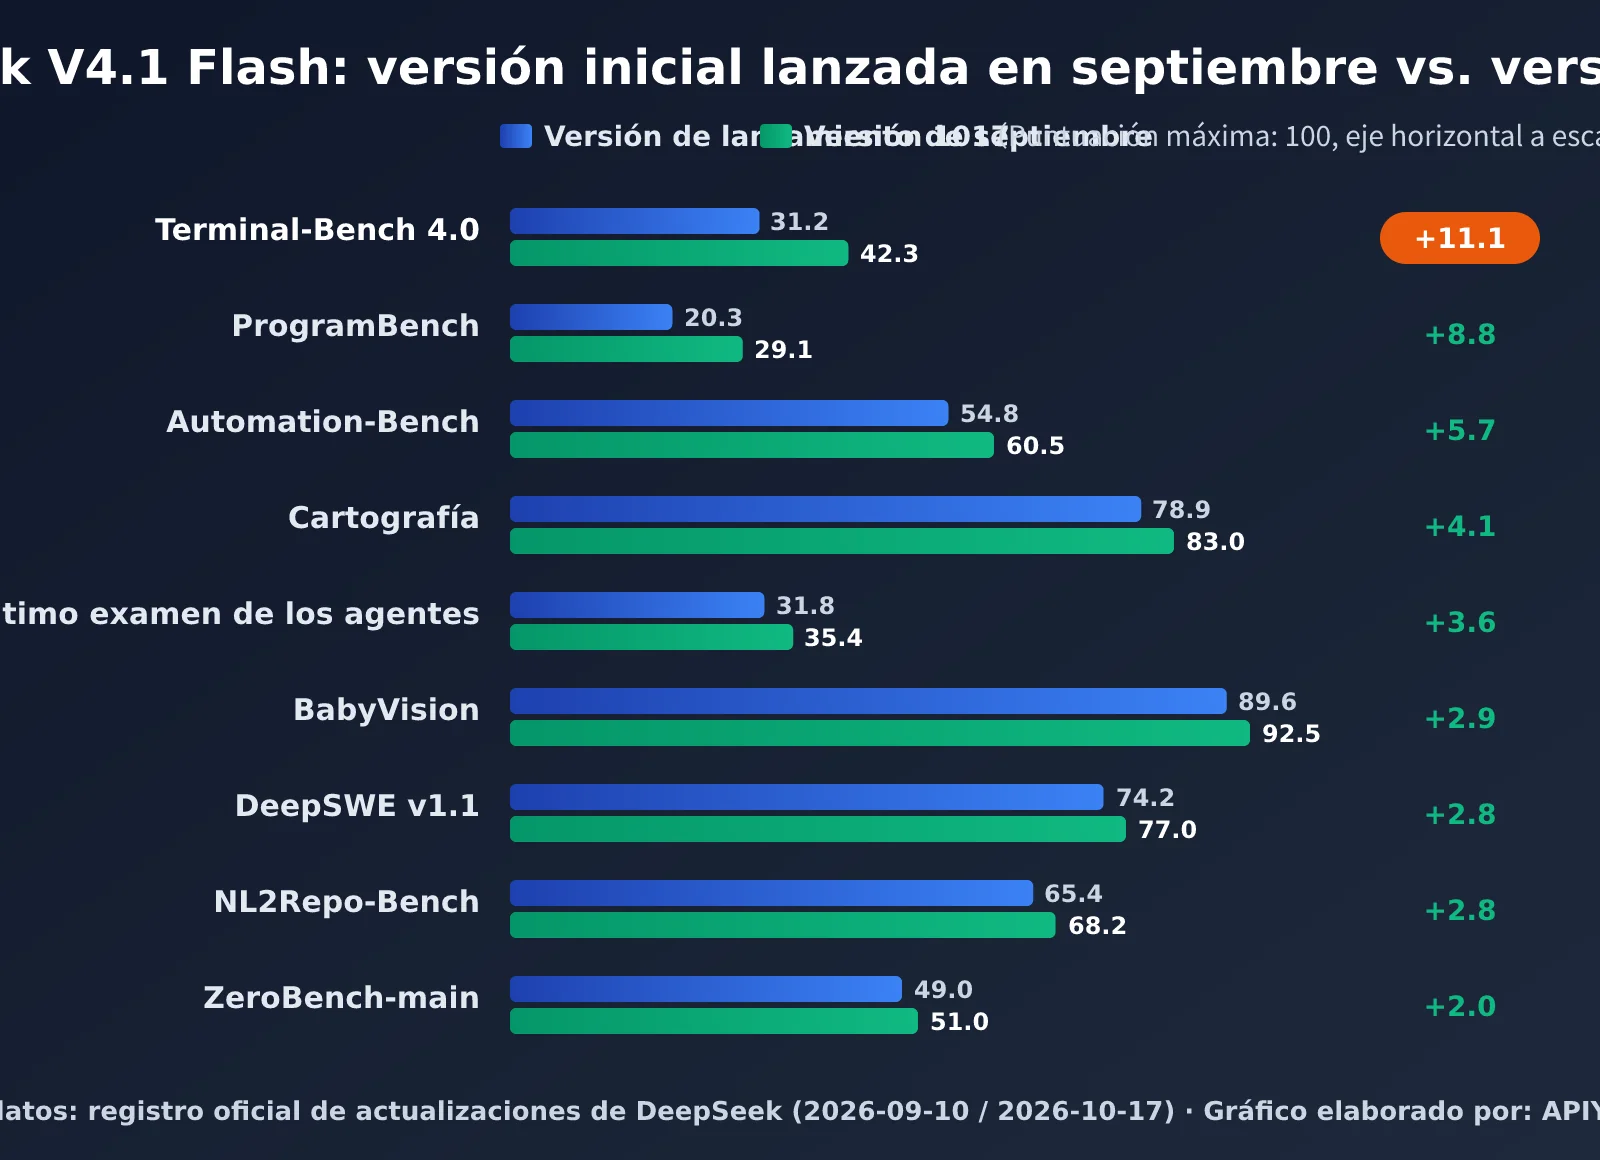
La forma más directa de responder a «¿qué mejoró?» es comparar los resultados de la versión oficial de septiembre con los de la versión 1017 de octubre. Los datos de la tabla proceden de las notas oficiales de actualización de DeepSeek. El registro oficial no incluye la puntuación anterior de Apex Bench, así que se cita la recopilación de la comunidad anglófona y debe tomarse solo como referencia.
| Benchmark | Dimensión evaluada | Versión inicial de septiembre | Versión 1017 | Mejora |
|---|---|---|---|---|
| Terminal-Bench 4.0 | Tareas de agente en terminal | 31.2 | 42.3 | +11.1 |
| ProgramBench | Generación de programas | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | Razonamiento general (la puntuación anterior procede de terceros) | 64.6 | 72.1 | +7.5 |
| HLE (sin herramientas) | Razonamiento sobre conocimientos complejos | 36.8 | 42.6 | +5.8 |
| Automation-Bench | Flujos de trabajo automatizados | 54.8 | 60.5 | +5.7 |
| Chartography (con herramientas) | Comprensión de gráficos | 78.9 | 83.0 | +4.1 |
| Agents’ Last Exam | Agentes de propósito general | 31.8 | 35.4 | +3.6 |
| BabyVision (con herramientas) | Comprensión visual | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | Ingeniería de software | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | Generación de repositorios a partir de lenguaje natural | 65.4 | 68.2 | +2.8 |
| ZeroBench-main (con herramientas) | Razonamiento visual | 49.0 | 51.0 | +2.0 |
La tabla deja ver tres señales. Primero, las mayores mejoras se concentran en tareas de agentes y programación: las subidas relativas de Terminal-Bench 4.0 y ProgramBench superan el 35 %, en línea con la afirmación oficial de que se optimizó el modelo para Harness y CodeBuddy. Segundo, los benchmarks visuales también mejoran de forma constante, entre 2 y 4 puntos, lo que indica que el ajuste posterior no sacrificó las capacidades multimodales. Tercero, los criterios de evaluación de algunos benchmarks no son exactamente iguales en ambas versiones. Por ejemplo, la versión más reciente de Automation-Bench se identifica como v1.0.6, y no se especifica si la versión inicial de HLE usaba herramientas. Por eso, conviene no basar las conclusiones en una sola cifra.
Mejoras de eficiencia de DeepSeek V4.1 Flash 1017: respuestas más cortas y tareas más rápidas
Además de las puntuaciones, DeepSeek destaca otro cambio fácil de pasar por alto: la versión 1017 tarda menos en completar las tareas y genera respuestas más cortas. Esto importa tanto como las puntuaciones en las API que cobran por Token: si para una misma tarea se generan menos Tokens, la factura también baja.
Cabe señalar que DeepSeek no ha publicado el porcentaje exacto de reducción, y la comunidad anglófona aún no cuenta con mediciones fiables que comparen ambas versiones. Lo más prudente es analizar muestras de tus propios casos de uso y medir los cambios en usage.completion_tokens para saber cuánto se reducen realmente los costos.
La comunidad anglófona resumió el método de entrenamiento como «programación guiada por deseos» (Wish-Driven Programming): el modelo primero completa un proyecto de principio a fin, después evalúa el resultado frente al objetivo y va iterando. Entre los ejemplos que mostró DeepSeek están la reconstrucción en 3D de la Ciudad Prohibida, un juego de carreras para navegador y una recreación de Portal 2 con Godot. Este tipo de proyectos de larga duración se corresponde precisamente con benchmarks como Terminal-Bench y ProgramBench, y ayuda a explicar por qué las puntuaciones de las tareas de agentes son las que más subieron.
¿Ha cambiado el precio de DeepSeek V4.1 Flash 1017? Cómo funcionan las tarifas de horas valle y punta
En resumen: el precio de la API de DeepSeek V4.1 Flash 1017 no ha cambiado y sigue siendo exactamente el mismo que el de la versión de lanzamiento de septiembre. Pero conviene entender este «sin cambios» en contexto: el precio ya había bajado en septiembre y, además, DeepSeek aplica actualmente dos tarifas, una para horas valle y otra para horas punta. El precio efectivo por token puede variar al doble según el horario.
| Concepto de facturación (por millón de tokens) | Flash en horas valle | Flash en horas punta | V4 Pro en horas valle | V4 Pro en horas punta |
|---|---|---|---|---|
| Entrada (acierto de caché) | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada (fallo de caché) | $0.15 | $0.30 | $0.66 | $1.32 |
| Salida | $0.60 | $1.20 | $1.98 | $3.96 |
Según la definición oficial, las horas punta son de lunes a viernes, de 01:00 a 04:00 y de 06:00 a 10:00 UTC. En hora de Pekín, corresponden a los días laborables de 09:00 a 12:00 y de 14:00 a 18:00. Los festivos oficiales de China no se consideran horas punta. El resto del tiempo —incluidas la noche, la pausa del mediodía, los fines de semana y todo el día en los festivos— se factura con la tarifa de horas valle, es decir, la mitad de la tarifa de horas punta.
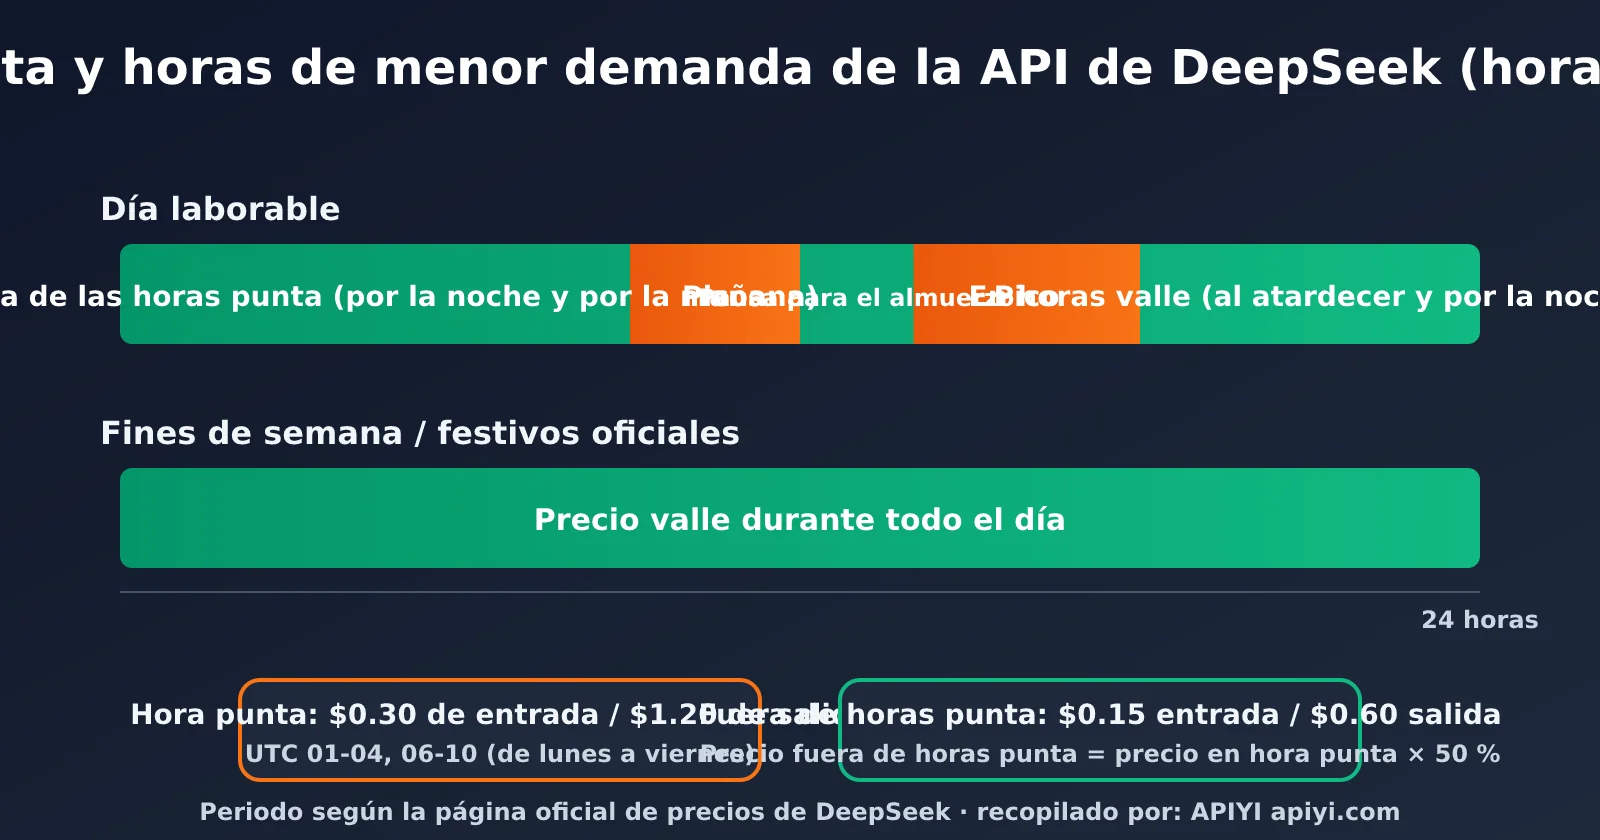
Este horario tiene un efecto directo en los equipos de China: las horas punta coinciden casi por completo con la jornada laboral. Si tienes tareas que no necesitan una respuesta en tiempo real —como traducciones por lotes, etiquetado de datos sin conexión o análisis de repositorios de código—, prográmalas después de las 18:00 o durante el fin de semana. El precio se reduce a la mitad al instante, un ahorro más directo que cualquier optimización de indicaciones.
Evolución del precio de DeepSeek V4.1 Flash
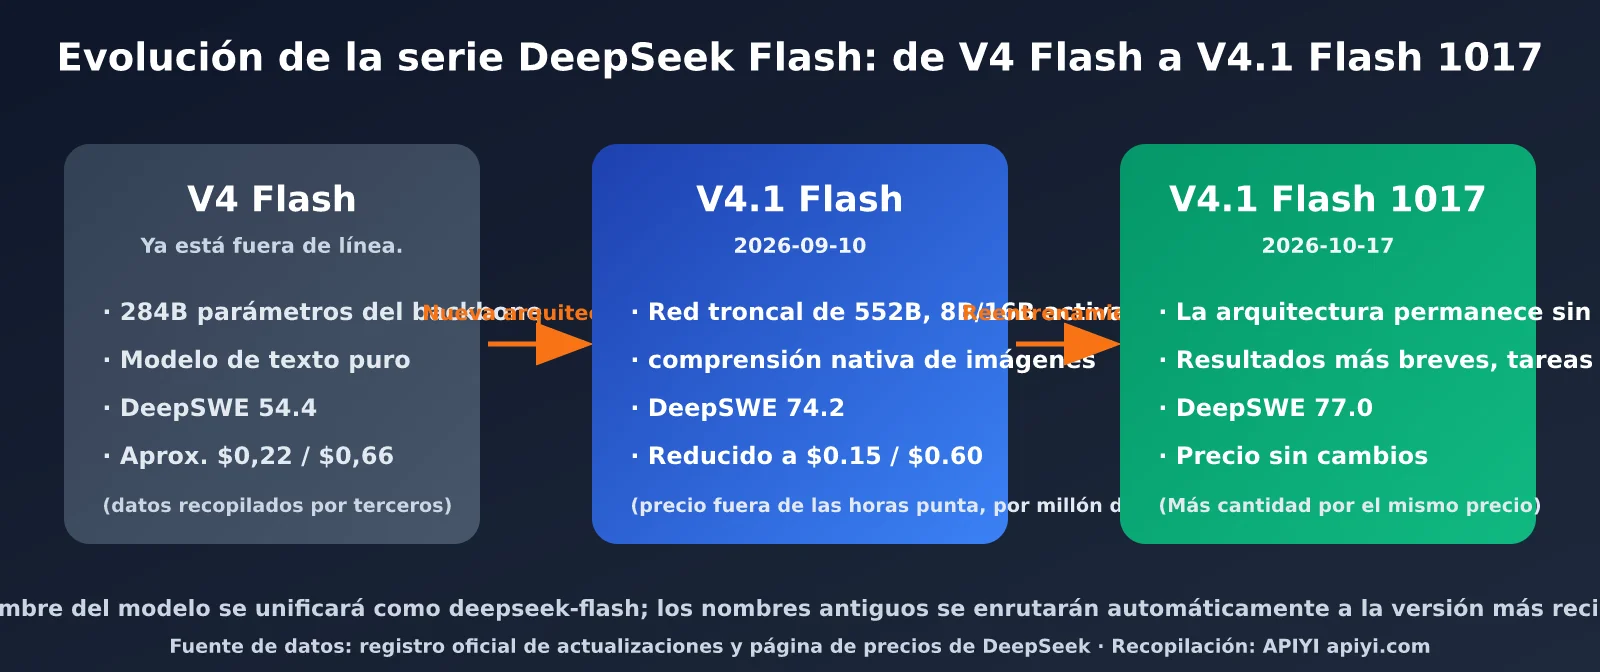
Si ampliamos la perspectiva, la serie Flash pasó por un proceso de «bajar el precio y después ofrecer más sin cobrar más» en dos meses. Los precios de la época de V4 Flash proceden de recopilaciones de la comunidad en inglés y son solo orientativos; los datos de septiembre y octubre son oficiales.
| Versión | Fecha de lanzamiento | Entrada (fallo de caché) | Entrada (acierto de caché) | Salida | Cambio |
|---|---|---|---|---|---|
| V4 Flash | Antes de septiembre de 2026 | Aprox. $0.22 | Aprox. $0.007 | Aprox. $0.66 | Retirado |
| V4.1 Flash | 2026-09-10 | $0.15 | $0.003 | $0.60 | Reducción de precio anunciada oficialmente |
| V4.1 Flash 1017 | 2026-10-17 | $0.15 | $0.003 | $0.60 | Mismo precio, mejores capacidades |
Los precios de la serie V4.1 de la tabla corresponden a horas valle; durante las horas punta se duplican.
Por qué «mismo precio» equivale, en la práctica, a pagar menos
El precio unitario no cambia, pero el coste total de cada tarea depende de «precio unitario × número de tokens». La confirmación oficial de que la versión 1017 genera respuestas más cortas significa que una misma tarea consume menos tokens de salida. Como el precio de salida es cuatro veces el de entrada, reducir la salida ahorra más que reducir la entrada.
Veamos un ejemplo orientativo: si un agente consume en horas valle un millón de tokens de entrada sin aciertos de caché y 200.000 tokens de salida, el coste es de unos $0.15 + $0.12 = $0.27. Si el volumen de salida se reduce un 20 % (solo a modo de ejemplo; el resultado real dependerá de tus mediciones), el coste de salida bajaría de $0.12 a unos $0.096. Si además se reutiliza un contexto largo con la tarifa de $0.003 por acierto de caché, el coste real puede reducirse aún más.
💰 Optimización de costes: En proyectos con muchas llamadas o presupuestos ajustados, puedes programar las tareas que no sean en tiempo real para las horas valle y reutilizar las indicaciones de sistema fijas para aumentar la tasa de aciertos de caché. Si haces las invocaciones a través de la plataforma APIYI apiyi.com, también podrás consultar en un solo lugar el desglose de uso de los distintos modelos y calcular el coste real de cada tipo de tarea.
API de Search y Fetch: nuevos cargos disponibles con la versión 1017
La versión 1017 llegó con otro cambio: DeepSeek abrió sus propias funciones de Search (búsqueda en internet) y Fetch (extracción de páginas web) a desarrolladores externos. Se cobran por separado, a $0.75 por cada mil solicitudes completadas con éxito, y no forman parte del coste de los tokens del modelo.
La página oficial de precios también establece un periodo de transición: por ahora, estas solicitudes son gratuitas si se hacen con DeepSeek Harness, Claude Code o Codex. El cobro por solicitud empezará a las 00:00 del 1 de noviembre de 2026, hora de Pekín. Si tu flujo de trabajo con agentes depende mucho de las búsquedas en internet, te conviene calcular el número de llamadas antes de noviembre para estimar de antemano este nuevo coste.
Primeros pasos con DeepSeek V4.1 Flash 1017: ejemplo de llamada a la API
Como la versión 1017 conserva el nombre de modelo deepseek-flash, el código existente empezará a usar la nueva versión automáticamente, sin necesidad de cambiar nada. Aquí tienes un ejemplo mínimo compatible con el SDK de OpenAI:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

resp = client.chat.completions.create(
    model="deepseek-flash",  # 实际可用模型名以平台模型列表为准
    messages=[{"role": "user", "content": "用 Python 写一个读取 CSV 并按列求和的函数"}],
)
print(resp.choices[0].message.content)
print(resp.usage)  # 记录 Token 用量,便于对比新旧版本输出长度
Ver el código completo: script para comparar la longitud de las respuestas de las versiones nueva y anterior
import time
import statistics
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 调用多个模型
)

PROMPTS = [
    "解释 Python 中生成器和迭代器的区别,并给出示例",
    "写一个带重试和指数退避的 HTTP 请求函数",
    "把下面的 SQL 改写成 pandas 代码:SELECT city, AVG(price) FROM orders GROUP BY city",
]

def run(model: str, prompts: list[str]) -> dict:
    out_tokens, latency = [], []
    for p in prompts:
        start = time.time()
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": p}],
        )
        latency.append(time.time() - start)
        out_tokens.append(resp.usage.completion_tokens)
    return {
        "model": model,
        "avg_output_tokens": statistics.mean(out_tokens),
        "avg_latency_s": round(statistics.mean(latency), 2),
    }

if __name__ == "__main__":
    # 将历史记录中的 completion_tokens 与本次结果对比,即可估算 1017 的输出缩短幅度
    print(run("deepseek-flash", PROMPTS))
Estas recomendaciones prácticas pueden ayudarte a ponerlo en marcha más rápido:
- Modo de razonamiento:
deepseek-flashactiva el modo de razonamiento de forma predeterminada. Para tareas sencillas de preguntas y respuestas o conversión de formatos, puedes cambiar al modo sin razonamiento y ahorrar tokens de salida. Consulta la documentación oficial para conocer la sintaxis exacta de los parámetros. - Parámetros de muestreo: la ficha del modelo en Hugging Face recomienda
temperature=1.0ytop_p=0.95. Si ya habías ajustado la temperatura para la versión anterior, te recomendamos volver a probarla. - Nombre del modelo anterior:
deepseek-v4-flashsigue disponible, pero ahora se enruta a la versión 1017. Te recomendamos usardeepseek-flashde forma uniforme para evitar problemas si el alias deja de estar disponible más adelante. - Pruebas de regresión: una respuesta más corta puede afectar a los sistemas posteriores que dependen de un formato o una longitud fijos. Antes de cambiar de versión, pruébala con datos reales.
🚀 Empieza ahora: te recomendamos usar la plataforma APIYI apiyi.com para crear prototipos rápidamente. Su interfaz compatible con OpenAI está lista para usar: en pocos minutos podrás integrar DeepSeek V4.1 Flash 1017 en un proyecto existente y compararlo con otros modelos mediante pruebas A/B.
Para qué casos conviene DeepSeek V4.1 Flash 1017: comparación con V4 Pro
Tras la actualización 1017, surge una pregunta práctica: ¿sigue teniendo sentido usar el V4 Pro, que es más caro? Según la página oficial de precios, Flash ofrece ventajas en precio, concurrencia y capacidades visuales, mientras que Pro sigue siendo el modelo de mayor tamaño que DeepSeek ofrece actualmente al público.
| Criterio | deepseek-flash (V4.1 Flash 1017) | deepseek-v4-pro (V4 Pro 0813) | Recomendación |
|---|---|---|---|
| Precio de salida (horas de menor demanda) | $0.60 / millón de tokens | $1.98 / millón de tokens | Flash cuesta aproximadamente el 30 % de Pro |
| Contexto / salida máxima | 1M / 384K | 1M / 384K | Empate |
| Comprensión visual | Sí | No | Elige Flash si vas a enviar imágenes |
| Límite de concurrencia | 2,500 | 500 | Elige Flash para el procesamiento por lotes con alta concurrencia |
| Optimización para programación con agentes | Optimizado específicamente para Harness y CodeBuddy | General | Prueba primero Flash para agentes de programación |
| Plataformas disponibles | DeepSeek oficial, APIYI apiyi.com, entre otras | Las mismas | Una interfaz unificada facilita el cambio |
Con esta información, estas son algunas pautas para elegir según el caso:
- Agentes de programación y automatización de terminales: prioriza Flash 1017. Esta es el área en la que se concentra la mayor parte de las mejoras de esta versión y su precio es aproximadamente un tercio del de Pro.
- Comprensión de gráficos, capturas de pantalla y documentos: la única opción es Flash, ya que Pro todavía no admite entradas visuales.
- Tareas offline a gran escala: el límite de concurrencia de 2,500 de Flash, combinado con su precio en horas de menor demanda, ofrece la mejor relación calidad-precio.
- Razonamiento complejo que exige la máxima calidad en cada respuesta: compara Flash y Pro con el mismo conjunto de ejemplos antes de decidir. No te bases únicamente en las puntuaciones de referencia.
💡 Recomendación: la elección del modelo depende principalmente del tipo de tarea y de los requisitos de calidad. Te recomendamos probar Flash y Pro con el mismo conjunto de datos reales en la plataforma APIYI apiyi.com. Como basta con cambiar el nombre del modelo para alternar entre ellos mediante una interfaz unificada, podrás llegar a una conclusión rápidamente.
Preguntas frecuentes
P1: ¿Tengo que cambiar el código para usar DeepSeek V4.1 Flash 1017?
No. La API oficial mantiene el mismo formato de llamada: deepseek-flash apunta automáticamente a la versión 1017 y el nombre anterior, deepseek-v4-flash, también se redirige a la nueva versión. Lo único recomendable es hacer pruebas de regresión para confirmar que el análisis de los resultados en los sistemas posteriores sigue funcionando con las respuestas más cortas. En la plataforma APIYI, apiyi.com, puedes obtener cuota de prueba y comprobar rápidamente cómo funciona la nueva versión en tu caso de uso.
P2: ¿Ha cambiado realmente el precio de DeepSeek V4.1 Flash 1017?
El precio por unidad no ha cambiado: en horario de menor demanda, la entrada sin acierto de caché cuesta $0.15, la entrada con acierto de caché, $0.003, y la salida, $0.60 por millón de tokens. En horas punta, las tarifas se duplican. Sin embargo, como la versión 1017 genera menos texto, el costo total de una misma tarea suele ser menor. Lo único nuevo es que las API Search y Fetch se cobran por uso: cada una cuesta $0.75 por cada 1.000 solicitudes completadas correctamente.
P3: ¿A qué horas corresponde el horario punta en China?
En días laborables, de 09:00 a 12:00 y de 14:00 a 18:00, hora de Pekín; es decir, de 01:00 a 04:00 y de 06:00 a 10:00 UTC. Los días festivos oficiales de China no cuentan como horas punta. El resto del tiempo se aplica la tarifa de menor demanda, que equivale a la mitad de la tarifa punta.
P4: ¿Son fiables las mejoras de rendimiento de la versión 1017?
Las puntuaciones proceden de una publicación oficial de DeepSeek y todavía se están realizando reproducciones independientes por parte de terceros. Algunos benchmarks dependen de marcos de trabajo específicos: por ejemplo, Terminal-Bench 4.0 utiliza el marco Claude Code y DeepSWE, el marco Mini-SWE-V2. Los resultados pueden variar al usar un ciclo de agente propio. La forma más fiable de decidir si cambiar es probar el modelo con tus propios datos y tu propio marco de trabajo.
P5: ¿Se puede desplegar DeepSeek V4.1 Flash 1017 localmente?
Sí. Los pesos se publican con licencia MIT en Hugging Face y ModelScope, y son compatibles con marcos de inferencia como vLLM, SGLang y Transformers. Sin embargo, los 552.000 millones de parámetros de la arquitectura principal requieren mucha memoria de GPU, por lo que para los equipos pequeños y medianos suele resultar más rentable usar la API directamente.
Puntos clave
- Qué ha mejorado: la arquitectura no cambia, pero se ha realizado una nueva ronda de aprendizaje por refuerzo. El modelo mejora en los 11 benchmarks oficiales; Terminal-Bench 4.0 pasa de 31,2 a 42,3.
- Cambios en eficiencia: las tareas se completan más rápido y las respuestas son más cortas, lo que reduce directamente el costo por tarea cuando se cobra por token.
- ¿Ha cambiado el precio? No. La tarifa de menor demanda es de $0.15 por la entrada y $0.60 por la salida; en horas punta se duplica. El horario punta corresponde a los días laborables, de 9:00 a 12:00 y de 14:00 a 18:00, hora de Pekín.
- Nuevos cargos: Search y Fetch cuestan $0.75 cada una por cada 1.000 solicitudes. A partir del 1 de noviembre, se empezará a cobrar por las llamadas desde Harness, Claude Code y Codex.
- Integración: se sigue usando
deepseek-flash, sin necesidad de cambiar el código. Basta con hacer una prueba de regresión antes de cambiar.
Resumen
Volviendo a las dos preguntas del título, la respuesta se puede resumir en tres puntos:
- ¿Qué ha mejorado? DeepSeek V4.1 Flash 1017 es una versión reentrenada con la misma arquitectura. La mejora más notable está en la capacidad de programación de agentes; la comprensión visual también mejora de forma moderada. Además, las respuestas son más cortas y la generación es más rápida.
- ¿Ha cambiado el precio? No: se mantiene en el nivel establecido tras la reducción de septiembre. Al generar menos texto, el costo real es menor; y durante las horas de menor demanda, el precio se reduce a la mitad.
- ¿Qué hay que hacer? No es necesario cambiar el código, pero conviene hacer una prueba de regresión y evaluar cómo afectará a los flujos de trabajo de los agentes el cobro por uso de Search/Fetch a partir de noviembre.
Para los equipos que ya usan o planean usar DeepSeek en agentes de programación, procesamiento por lotes o comprensión de gráficos, la versión 1017 es una actualización que ofrece más por el mismo precio y vale la pena probar cuanto antes. Puedes validar su rendimiento rápidamente a través de APIYI, en apiyi.com. Usa una interfaz unificada para comparar DeepSeek V4.1 Flash 1017 con otros modelos líderes sobre el mismo conjunto de muestras y, después, decide cómo distribuir el tráfico de producción.
Lecturas relacionadas
Si te interesa la serie de modelos DeepSeek, te recomendamos seguir leyendo:
- 📘 DeepSeek V4.1 Flash: análisis del lanzamiento, nueva arquitectura y capacidades multimodales nativas: descubre los cambios de arquitectura de la versión lanzada en septiembre.
- 📊 Guía para optimizar los costos de la API de DeepSeek: aciertos de caché y programación en horas de menor demanda: aprende técnicas prácticas para reducir el costo de los tokens.
- 🚀 Cómo elegir un modelo para agentes de programación: comparación entre Flash, Pro y los principales modelos cerrados: explora las mejores combinaciones para distintos casos de uso.
Referencias
- Registro de actualizaciones de la API de DeepSeek: notas oficiales de lanzamiento y datos de referencia de las versiones V4.1 Flash y 1017
- Enlace:
api-docs.deepseek.com/updates -
Nota: fuente principal de las puntuaciones de referencia y la información sobre versiones de este artículo
-
Modelos y precios de DeepSeek: precios oficiales, horarios de mayor demanda y reglas de facturación de Search/Fetch
- Enlace:
api-docs.deepseek.com/quick_start/pricing -
Nota: consulta la información actualizada en tiempo real en la página oficial
-
Ficha del modelo en Hugging Face: arquitectura, parámetros y parámetros de muestreo recomendados para DeepSeek-V4.1-Flash
- Enlace:
huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash -
Nota: referencia para la implementación local y la configuración de parámetros
-
Artículo comparativo de Regolo: comparación de precios y resultados de referencia entre V4 Flash y V4.1 Flash
- Enlace:
regolo.ai - Nota: el precio anterior de V4 Flash citado en el artículo procede de esta recopilación de un tercero
Autor: Equipo técnico de APIYI
Intercambio técnico: Te invitamos a comentar y debatir. Puedes consultar más recursos en el centro de documentación de APIYI: docs.apiyi.com