Últimamente, muchos desarrolladores han compartido una experiencia «contraintuitiva»: claude-opus-5-5 no se siente lento en absoluto y, en muchas tareas, incluso termina antes que claude-sonnet-5-5. Si el modelo insignia es rápido y potente, ¿Sonnet solo conserva como ventaja que cuesta la mitad? La respuesta no es tan simple. En este artículo desglosaremos, con 6 conjuntos de datos públicos, las diferencias reales entre claude-sonnet-5-5 y claude-opus-5-5, y responderemos una pregunta aún más práctica: cómo repartir el trabajo entre ambos modelos en escenarios de Agent empresariales con entradas y salidas de contenido extenso.
Valor principal: al terminar de leer, entenderás la verdadera razón por la que Opus es «rápido», las ventajas concretas de Sonnet más allá del precio y una arquitectura de Agent bimodelo Opus + Sonnet que puedes implementar directamente.
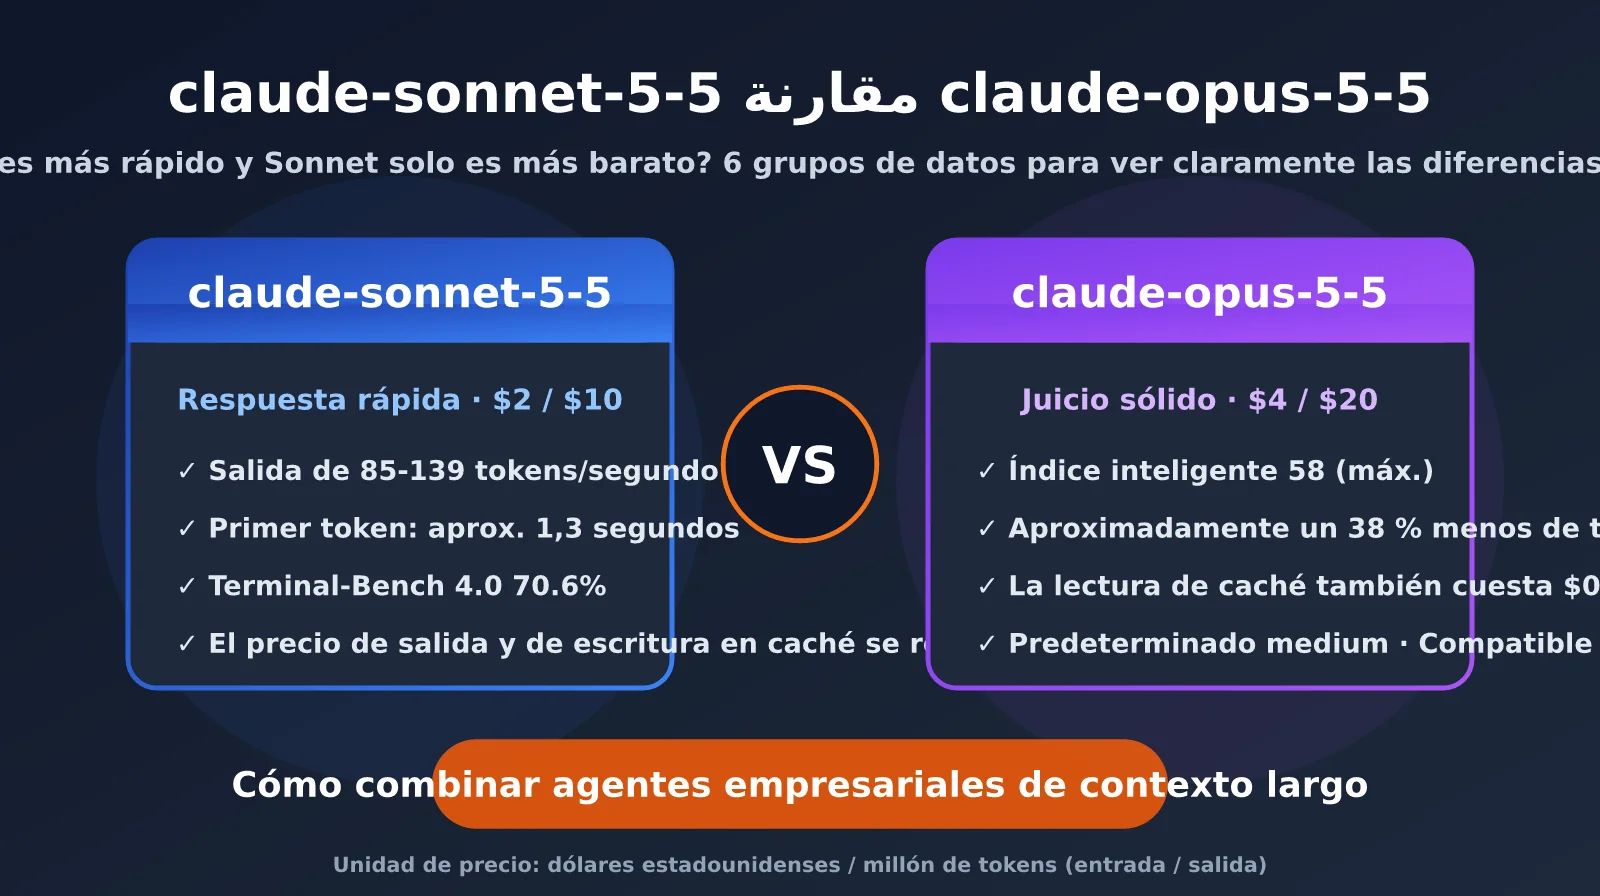
Vista rápida de los parámetros clave de claude-sonnet-5-5 y claude-opus-5-5
claude-opus-5-5 se lanzó el 22 de septiembre de 2026 y claude-sonnet-5-5 el 28 de septiembre; ambos pertenecen a la familia Claude 5.5. El cambio más destacado de esta generación es que Opus ha bajado de precio: su tarifa pasó de los $5/$25 de Opus 5 a $4/$20, una reducción del 20 %. La lectura de caché bajó aún más, de $0.50 a $0.20, exactamente igual que Sonnet. Por su parte, Sonnet 5.5 mantiene la tarifa de $2/$10; según la información oficial, el coste por tarea puede ser hasta un 30 % menor que en la generación anterior.
| Parámetro | claude-sonnet-5-5 | claude-opus-5-5 |
|---|---|---|
| Fecha de lanzamiento | 2026-09-28 | 2026-09-22 |
| Precio de entrada / salida | $2 / $10 | $4 / $20 |
| Lectura de caché | $0.20 | $0.20 (5 % del precio de entrada base) |
| Escritura de caché de 5 minutos | $2.50 | $5 |
| Precio Batch | $1 / $5 | $2 / $10 |
| Ventana de contexto | 1 millón de tokens, sin recargo por contexto largo | 1 millón de tokens, sin recargo por contexto largo |
| Salida máxima | 128K (300K en la beta de Batch) | 128K (300K en la beta de Batch) |
| Nivel de razonamiento predeterminado de la API | high | medium |
| Modo Fast | No compatible | Compatible; velocidad de salida aprox. 2,5 veces mayor, $8 / $40 |
| Plataformas disponibles | APIYI apiyi.com, API oficial de Anthropic | APIYI apiyi.com, API oficial de Anthropic |
La tabla esconde dos detalles que afectan directamente a la experiencia. Primero, sus niveles de razonamiento predeterminados son distintos: Opus usa medium por defecto, mientras que la API de Sonnet usa high. Esta es la razón principal por la que muchas personas perciben que Opus es más rápido. Segundo, el precio de lectura de caché es idéntico, lo que reduce drásticamente la diferencia de costes de entrada entre ambos en escenarios de Agent que reutilizan mucho contexto extenso.
🎯 Sugerencia de prueba: al comparar los dos modelos, especifica siempre el mismo nivel de razonamiento; de lo contrario, las conclusiones pueden quedar muy distorsionadas. Recomendamos usar la misma clave en APIYI apiyi.com para invocar por separado claude-sonnet-5-5 y claude-opus-5-5, cambiando únicamente los parámetros
modelyreasoning_effortpara realizar una prueba comparativa.
Por qué claude-opus-5-5 parece incluso más rápido que claude-sonnet-5-5
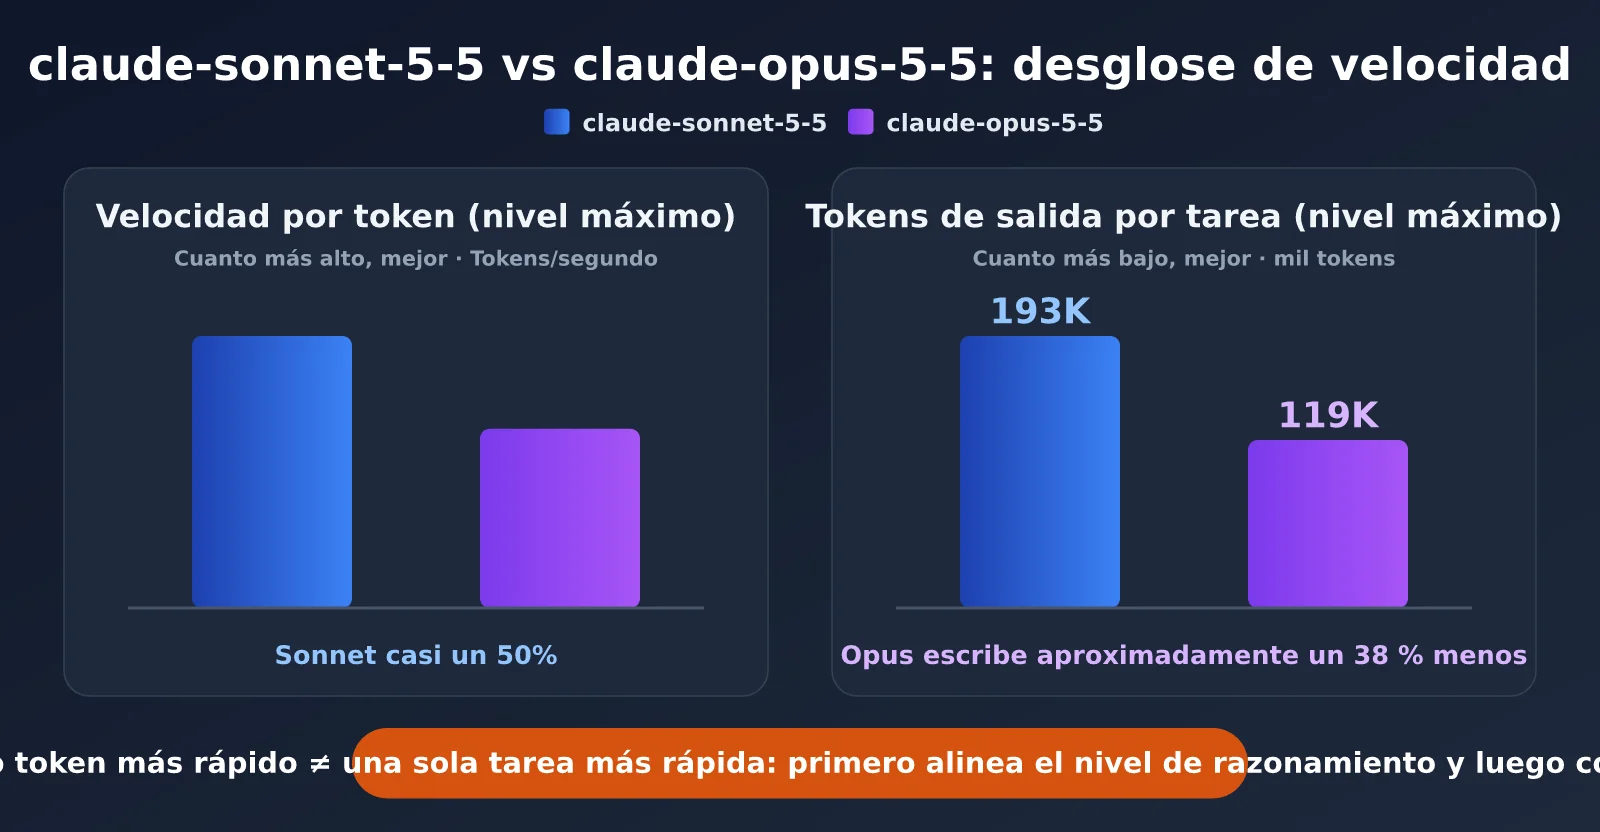
Si nos centramos exclusivamente en la velocidad de generación, claude-sonnet-5-5 es claramente más rápido. Las mediciones de Artificial Analysis muestran que Sonnet 5.5 genera entre 85 y 139 tokens por segundo según el nivel de razonamiento, frente a 74-93 tokens por segundo de Opus 5.5. Anthropic también clasifica la latencia de Sonnet como «rápida» y la de Opus como «media». Entonces, ¿de dónde viene la sensación de que «Opus es más rápido»? Principalmente de tres razones.
Razón 1: los niveles predeterminados son distintos; Sonnet razona un nivel más por defecto
Opus 5.5 redujo el nivel predeterminado de la API desde high, en la generación anterior, hasta medium. Según la compañía, el nivel medium ya alcanza o supera el rendimiento de Opus 5 en high. En cambio, la API de Sonnet 5.5 sigue usando high de forma predeterminada y su modo de razonamiento no se puede desactivar. Pruebas independientes encontraron que, en high, Sonnet genera aproximadamente el doble de tokens que en medium, sin una mejora evidente de calidad. Si invocas ambos modelos con sus parámetros predeterminados, Sonnet está, en la práctica, «pensando un nivel más», por lo que naturalmente tarda más.
Razón 2: Opus tiene una mayor eficiencia de tokens
En el índice de inteligencia de Artificial Analysis, Sonnet 5.5 en nivel max genera una media de unos 193.000 tokens por tarea, la cifra más alta registrada por esa organización. Opus 5.5, en el mismo nivel, genera unos 119.000 tokens. Que cada token se produzca más rápido no significa necesariamente que cada tarea termine antes. Sonnet puede emitir cerca de un 50 % más de tokens por segundo, pero si necesita escribir un 60 % más de contenido, el tiempo total de extremo a extremo puede igualar o incluso superar al de Opus.
Razón 3: Opus tiene acceso exclusivo al modo Fast
Opus 5.5 admite el modo Fast, actualmente en vista previa de investigación. Con una configuración de inferencia más rápida para el mismo modelo, la velocidad de salida puede aumentar hasta unas 2,5 veces, con un precio de $8/$40. Si activaste el modo Fast para Opus en una herramienta de programación, la impresión de que «Opus va muy rápido» se amplifica todavía más. Hay que tener en cuenta que el modo Fast solo aumenta los tokens generados por segundo: no mejora la latencia del primer token y no comparte caché de indicaciones con la velocidad estándar.
| Métrica de velocidad | claude-sonnet-5-5 | claude-opus-5-5 | Explicación |
|---|---|---|---|
| Velocidad de salida (tokens/segundo) | 85-139 | 74-93 | Sonnet es más rápido por token |
Tokens generados por tarea (nivel max) |
unos 193.000 | unos 119.000 | Opus consume menos tokens |
| Latencia del primer token (nivel bajo) | unos 1,3 s (medium) |
unos 14,3 s (low) |
Sonnet responde antes |
| Clasificación oficial de latencia | Rápida | Media | Según la página de modelos de Anthropic |
| Tiempo en tareas reales de programación (terceros) | 29 min 27 s | 44 min 50 s | Sonnet es unas 1,5 veces más rápido |
La conclusión es esta: con los parámetros predeterminados, Opus puede terminar antes, pero si ambos se configuran en niveles adecuados, Sonnet mantiene una ventaja clara en velocidad de respuesta. Esto es especialmente relevante en la latencia del primer token: Sonnet comienza a generar en alrededor de 1,3 segundos en medium, algo crucial para los Agent interactivos orientados al usuario.
¿claude-sonnet-5-5 solo tiene ventaja de precio? Datos comparativos de capacidades
Empecemos con un dato quizá inesperado: en el nivel max, Sonnet no es necesariamente más barato que Opus. Al ejecutar todo el índice de inteligencia de Artificial Analysis, Sonnet 5.5 (max) costó alrededor de $8.977, mientras que Opus 5.5 (max) costó unos $8.708. Opus resulta incluso ligeramente más barato y obtiene una puntuación superior: 58 frente a 56. La razón es precisamente la eficiencia de tokens mencionada antes. Por eso, si solo usas Sonnet en el nivel max, ni siquiera tienes garantizada una ventaja de precio.
Entonces, ¿dónde está el valor de Sonnet? La siguiente tabla muestra la puntuación de ambos en el índice de inteligencia según el nivel de razonamiento y deja claro cómo conviene utilizarlo:
| Nivel de razonamiento | Índice de inteligencia de claude-sonnet-5-5 | Índice de inteligencia de claude-opus-5-5 |
|---|---|---|
| max | 56 | 58 |
| xhigh | 52 | 56 |
| high | 47 | 54 |
| medium | 41 | 51 |
| low | — | 42 |
En inteligencia general, Opus supera a Sonnet en todos los niveles equivalentes. Además, su ventaja es más visible en precisión factual —66 % frente a 54 % en AA-Omniscience—, así como en índices de áreas especializadas como derecho, finanzas y estrategia. Sin embargo, Sonnet conserva ventajas difíciles de sustituir en varios escenarios:
- Programación con agentes de terminal: en Terminal-Bench 4.0, Sonnet (
max) alcanza el 70,6 %, por encima del 66,4 % de Opus (xhigh). Sin embargo, en el mismo nivelxhigh, Opus sigue liderando con un 66,4 % frente al 61,5 % de Sonnet; Sonnet necesita usar el nivel máximo para superarlo. - Latencia de respuesta: tanto la latencia del primer token como la velocidad de salida por segundo son notablemente mejores, lo que lo hace adecuado para interacciones en tiempo real y escenarios de interfaz con salida en streaming.
- Entradas sin acierto de caché y escritura de caché: ambos precios unitarios son solo la mitad de los de Opus, por lo que resulta más conveniente para tareas de entrada extensa y puntual en las que cada documento es nuevo.
- Salidas largas y procesamiento por lotes: el precio de salida es de $10 frente a $20, y en Batch es de $5 frente a $10. Al generar informes o documentos largos a gran escala, la ventaja de coste se duplica directamente.
- Ejecución con alta concurrencia: según el posicionamiento oficial de Anthropic, Sonnet es el complemento más rápido y económico de Opus, ideal para ejecutar en paralelo, como subagentes, un gran número de subtareas bien definidas.
En otros benchmarks públicos, Opus lidera por cerca de 2 puntos en CursorBench 4.0 (57,8 % frente a 55,5 %), FrontierCode 1.1 (54,4 % frente a 52,1 %) y OSWorld 2.1 (81,8 % frente a 80,1 %). En ProgramBench, una prueba de terceros que recopila resultados de reconstrucción de programas con contexto largo, Opus obtiene un 91,2 % frente al 79,7 % de Sonnet, una diferencia mucho más marcada. Esto indica que cuanto más se necesita realizar juicios precisos dentro de un contexto extremadamente largo, mayor es la ventaja de Opus.
💡 Sugerencia de selección: la forma adecuada de usar Sonnet es entre los niveles
mediumyxhigh, tratándolo como «ejecutor». Opus, en cambio, encaja mejor como «tomador de decisiones» a partir demedium. Si quieres comprobar la diferencia en tu propio negocio, puedes ejecutar una misma tarea con documentos largos en APIYI apiyi.com y comparar la calidad de los resultados con el coste real.
El coste real de los agentes empresariales con contexto largo
La carga típica de un Agent empresarial incluye contratos, repositorios de código o bases de conocimiento de cientos de miles de tokens como entrada, y como salida informes extensos, reescrituras por lotes o código distribuido en varios archivos. Dado que ambos modelos admiten un contexto de 1 millón de tokens y no aplican recargo por contexto largo, los factores que realmente determinan el coste son la tasa de acierto de caché y la longitud de la salida. A continuación se estiman varios escenarios habituales con los precios oficiales (para Sonnet se estiman 1,6 veces más tokens de salida que Opus, reflejando la diferencia de eficiencia de tokens entre ambos en el nivel max):
| Escenario | Composición de la carga | claude-sonnet-5-5 | claude-opus-5-5 | Relación de coste |
|---|---|---|---|---|
| Preguntas iterativas con contexto largo | 500 000 tokens de contexto, 95 % de aciertos de caché y 25 000 tokens nuevos escritos | Aprox. $0.28 (12 000 tokens de salida) | Aprox. $0.37 (7500 tokens de salida) | 1 : 1.3 |
| Primera carga de un documento largo | 500 000 tokens escritos en caché de 5 minutos + 10 000 tokens de salida | Aprox. $1.35 | Aprox. $2.70 | 1 : 2 |
| Generación de informes extensos | 50 000 tokens de entrada + 50 000 de salida (misma cantidad de salida) | Aprox. $0.60 | Aprox. $1.20 | 1 : 2 |
| Generación masiva sin conexión | Modo Batch, 100 000 tokens de entrada y salida respectivamente | Aprox. $0.60 | Aprox. $1.20 | 1 : 2 |
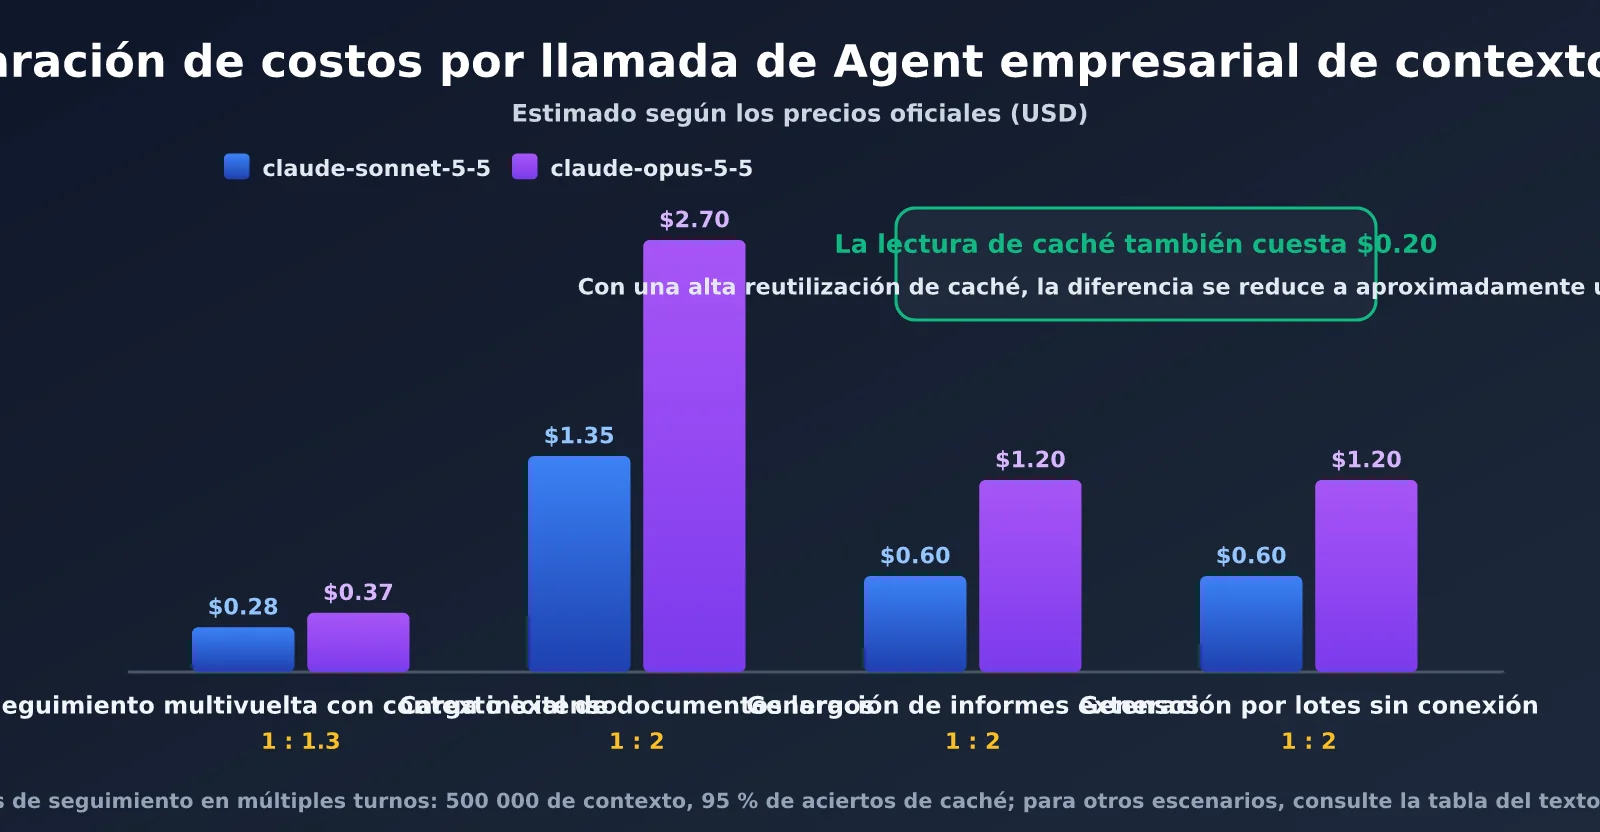
Esta tabla revela un patrón muy importante: en preguntas iterativas con «entrada larga + alto acierto de caché + salida corta», Opus solo cuesta aproximadamente un 30 % más que Sonnet, porque las lecturas de caché, que representan la mayor parte del coste, tienen el mismo precio en ambos modelos, y Opus además consume menos tokens de salida. En cambio, en escenarios de «primera carga de documentos nuevos» y «generación de salidas largas», la ventaja de coste de Sonnet vuelve a ser de la mitad. En otras palabras, Opus es adecuado para «releer repetidamente el mismo material extenso y tomar decisiones», mientras que Sonnet encaja mejor para «procesar material nuevo de una sola vez» o «generar contenido largo».
Hay otro detalle en el que es fácil equivocarse: la caché de indicaciones no se puede compartir entre modelos. Si Opus lee una vez el mismo documento de 500 000 tokens y después lo lee Sonnet, habrá que pagar por separado dos escrituras en caché. Por tanto, la clave de una arquitectura de dos modelos es mantener el contexto largo «residente» en un único modelo siempre que sea posible, mientras que el otro solo recibe un resumen depurado de la tarea.
Combinación recomendada de claude-sonnet-5-5 y claude-opus-5-5
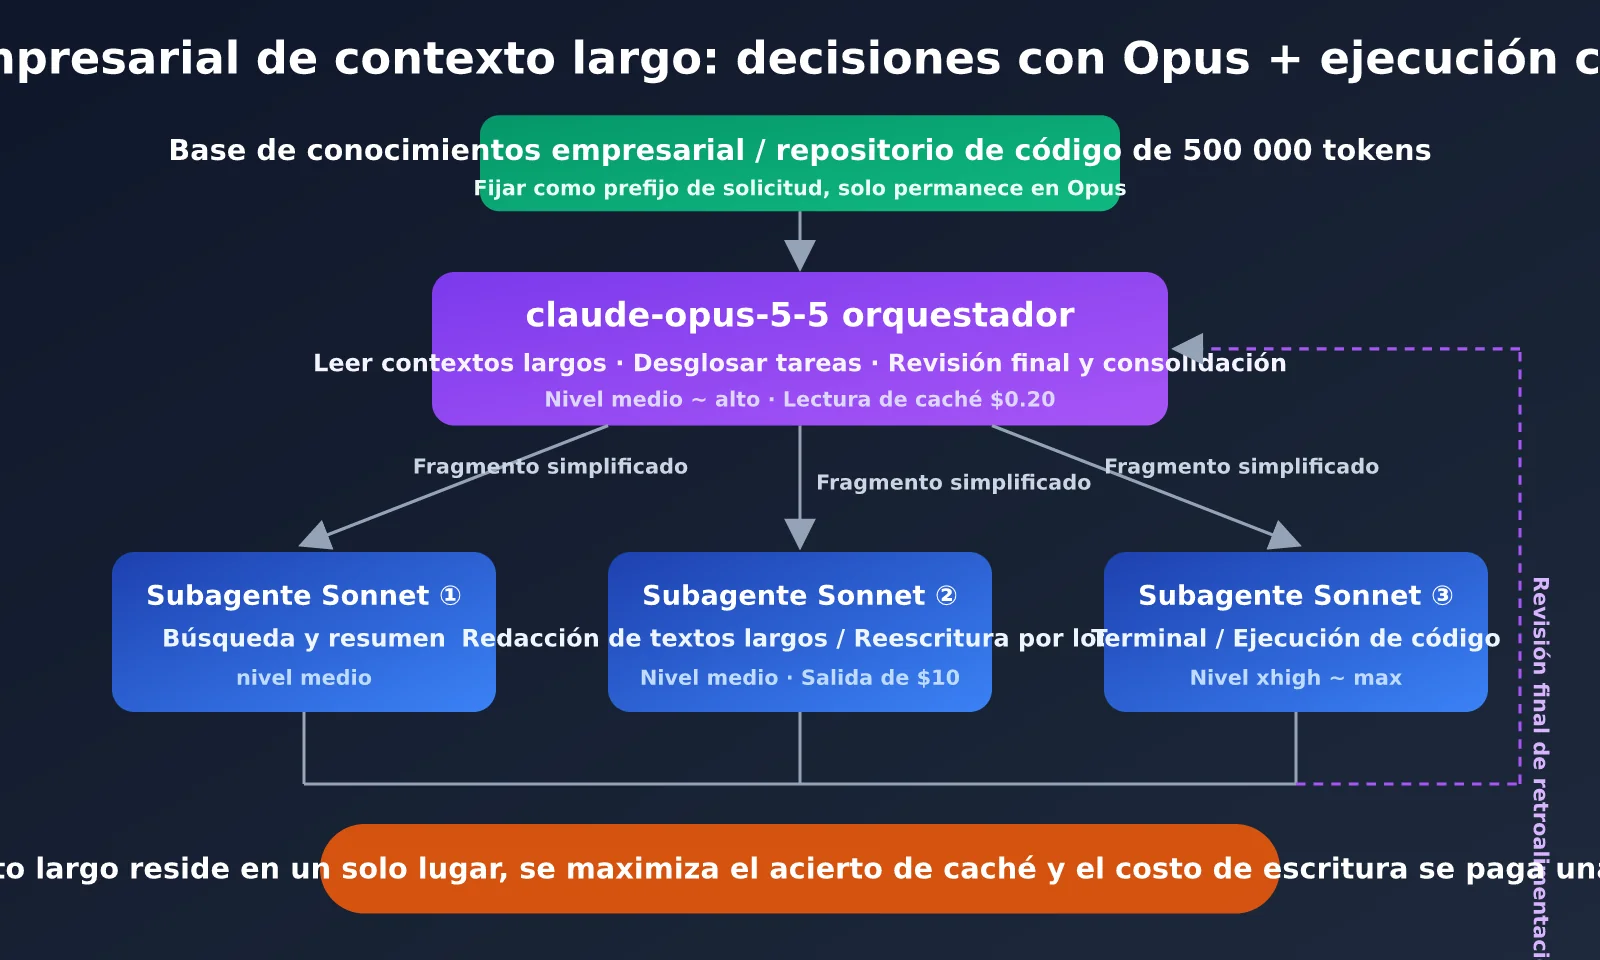
A partir de estos datos, recomendamos una arquitectura por capas de «Opus decide, Sonnet ejecuta» para los Agent empresariales que manejan contenido largo. Dependiendo de qué modelo mantenga el contexto largo, se puede aplicar en dos modalidades.
Modalidad 1: Opus orquesta + subagentes Sonnet en paralelo
Es adecuada para escenarios que requieren decisiones complejas sobre materiales extensos, como revisión de contratos, migración de código entre repositorios o due diligence. Opus mantiene el contexto largo completo —con aciertos de caché sostenidos— y se encarga de comprender el panorama global, descomponer la tarea y distribuirla entre varios subagentes Sonnet. Cada Sonnet recibe únicamente la pequeña sección de material que le corresponde y unas instrucciones claras, y la ejecuta rápidamente en paralelo con el nivel medium. Por último, Opus consolida los resultados y realiza la revisión final. En esta modalidad, solo se paga una caché costosa de contexto largo, mientras Sonnet produce los bloques de texto extensos a la mitad del precio de salida.
Modalidad 2: Sonnet en primera línea + escalado a Opus como respaldo
Es adecuada para escenarios interactivos y de alto volumen, como preguntas y respuestas sobre bases de conocimiento empresariales, Agent de atención al cliente o asistentes internos de TI. Sonnet mantiene el contexto largo y ofrece una respuesta del primer token de alrededor de un segundo con el nivel medium. Cuando encuentra una solicitud de baja confianza, que requiere una evaluación de cumplimiento, o ante una clara insatisfacción del usuario, escala a Opus el problema resumido junto con los fragmentos clave. La mayor parte del tráfico se procesa con Sonnet a bajo coste, y solo una pequeña parte de las consultas complejas recurre a Opus.
| Rol del Agent | Modelo recomendado | Nivel recomendado | Motivo |
|---|---|---|---|
| Orquestador / planificador | claude-opus-5-5 | medium ~ high | Mayor inteligencia integral y precisión factual; buena eficiencia de tokens |
| Análisis de contexto largo y revisión final | claude-opus-5-5 | high ~ xhigh | Clara ventaja para realizar juicios precisos con contexto largo |
| Redacción larga / reescritura masiva | claude-sonnet-5-5 | medium | El precio de salida se reduce a la mitad y la generación por segundo es más rápida |
| Subagente de terminal / ejecución de código | claude-sonnet-5-5 | xhigh ~ max | Mejor resultado en Terminal-Bench con el nivel máximo |
| Interfaz de conversación en tiempo real | claude-sonnet-5-5 | medium | Latencia hasta el primer token de aproximadamente 1,3 segundos |
| Procesamiento por lotes sin conexión | claude-sonnet-5-5 | medium | Batch a $1/$5, compatible con salidas largas de 300K |
Implementar la orquestación con Opus y la ejecución con Sonnet usando la misma interfaz
A continuación tienes un ejemplo mínimo de la modalidad 1. Utiliza una interfaz compatible con OpenAI; ambos modelos comparten una misma clave:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

def ask(model, prompt, effort="medium"):
    r = client.chat.completions.create(
        model=model, reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}])
    return r.choices[0].message.content

plan = ask("claude-opus-5-5", "阅读以下合同全文,拆成 3 个独立审查子任务,每行一个:\n" + contract_text)
drafts = [ask("claude-sonnet-5-5", f"完成子任务并输出审查意见:{t}") for t in plan.splitlines() if t.strip()]
report = ask("claude-opus-5-5", "汇总并终审以下意见,输出最终报告:\n" + "\n".join(drafts), effort="high")
Despliega para ver: ejemplo completo con subagentes paralelos y un prefijo fijo de contexto largo
import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

ORCHESTRATOR = "claude-opus-5-5"
WORKER = "claude-sonnet-5-5"

async def call(model, messages, effort="medium"):
    r = await client.chat.completions.create(
        model=model, reasoning_effort=effort, messages=messages)
    return r.choices[0].message.content, r.usage

async def run(long_doc: str, goal: str):
    # 1. El documento largo se coloca como prefijo fijo del sistema y solo reside en Opus, facilitando los aciertos de caché en varias rondas
    base = [{"role": "system", "content": "你是企业文档分析编排者。以下是完整材料:\n" + long_doc}]
    plan, _ = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"目标:{goal}\n请拆成最多 5 个子任务,每个子任务附上所需的原文片段,用 --- 分隔。"}])

    # 2. Los subagentes Sonnet reciben solo fragmentos resumidos y los ejecutan en paralelo
    tasks = [t.strip() for t in plan.split("---") if t.strip()]
    results = await asyncio.gather(*[
        call(WORKER, [{"role": "user", "content": f"独立完成以下子任务,输出结构化结论:\n{t}"}])
        for t in tasks])

    # 3. Se vuelve a Opus para la revisión final y se reutiliza el mismo prefijo de contexto largo
    merged = "\n\n".join(r[0] for r in results)
    final, usage = await call(ORCHESTRATOR, base + [
        {"role": "user", "content": f"核对以下子任务结论与原文是否一致,修正错误后输出最终报告:\n{merged}"}],
        effort="high")
    print("终审 Token 用量:", usage)
    return final

# asyncio.run(run(open("contract.md").read(), "识别合同中的付款、违约与知识产权风险"))
🚀 Empieza rápido: las cuentas oficiales de Claude imponen requisitos elevados según la región de registro y el método de pago, por lo que los equipos empresariales suelen atascarse durante la activación. Puedes registrarte primero en APIYI apiyi.com para obtener créditos de prueba y usar una sola clave para invocar tanto
claude-opus-5-5comoclaude-sonnet-5-5. Pon en marcha esta arquitectura de dos modelos antes de evaluar el coste a escala.
Recomendaciones para decidir entre claude-sonnet-5-5 y claude-opus-5-5
Condensamos el análisis anterior en 4 principios accionables:
- Define primero el nivel y luego compara modelos: usa Sonnet en medium~xhigh y Opus en medium~high, para evitar el desperdicio de tokens que puede provocar Sonnet en el nivel high predeterminado.
- Asigna a Opus los contextos largos con alta reutilización de caché: la lectura de caché cuesta lo mismo y Opus solo es aproximadamente un 30 % más caro, a cambio de mayor precisión y menos retrabajo.
- Deja en manos de Sonnet la carga de material nuevo y las salidas largas: tanto la escritura en caché como el precio por token de salida cuestan la mitad que en Opus; para tareas offline, además, puedes sumar el 50 % de descuento de Batch.
- Mantén el contexto largo en un único lugar: la caché no se puede compartir entre modelos. Los subagentes solo deben recibir fragmentos resumidos para evitar pagar repetidamente por la escritura en caché.
En cuanto al modo Fast de Opus, es adecuado para escenarios extremadamente sensibles a la velocidad de cada respuesta y con presupuesto suficiente, pero duplica el precio y no comparte caché. Para la mayoría de los agentes empresariales, asignar la interacción en tiempo real a Sonnet en el nivel medium suele ser más rentable que activar Fast en Opus.
Preguntas frecuentes
Q1: claude-opus-5-5 ya es muy rápido; ¿sigue siendo necesario usar claude-sonnet-5-5?
Sí. La rapidez de Opus proviene principalmente de un nivel predeterminado más bajo y de una mayor eficiencia de tokens, mientras que Sonnet sigue teniendo una ventaja clara tanto en velocidad de salida por segundo como en latencia hasta el primer token. Además, su precio de salida es solo la mitad. Para redacción extensa, conversaciones en tiempo real y subagentes paralelos, Sonnet sigue siendo el ejecutor más adecuado.
Q2: ¿Puede claude-sonnet-5-5 en el nivel max sustituir a Opus?
Puede hacerlo en tareas específicas, como programación en terminal: Sonnet (max) incluso supera a Opus en Terminal-Bench 4.0. Sin embargo, su índice global de inteligencia sigue siendo 2 puntos inferior y, en el nivel max, Sonnet consume más tokens, por lo que el coste total ya iguala o incluso supera ligeramente al de Opus. Si necesitas calidad al máximo nivel, normalmente es más rentable usar Opus directamente.
Q3: ¿Cómo pueden los agentes empresariales de documentos largos controlar el coste de ambos modelos?
La clave es aumentar la tasa de aciertos de caché: mantén los documentos largos fijos en el prefijo de la solicitud, deja que solo un modelo conserve el contexto completo y envía a los subagentes únicamente fragmentos resumidos. Se recomienda invocar los modelos mediante APIYI apiyi.com y revisar el uso de tokens de caché devuelto; ajusta gradualmente la estructura del prefijo. La tasa de aciertos de caché suele ser la palanca más eficaz para reducir costes.
Q4: ¿Qué hay que tener en cuenta al migrar de Sonnet 5 u Opus 5 a 5.5?
Ambos modelos 5.5 incluyen cambios incompatibles con versiones anteriores: el modo de razonamiento no se puede desactivar, las llamadas forzadas a herramientas (tool_choice configurado como any o tool) devolverán un error 400, y las herramientas anteriores de operación de ordenador también deben actualizarse. Antes de migrar, conviene ejecutar los casos de regresión en un entorno de pruebas, comparar en paralelo las salidas de los modelos nuevos y antiguos, y solo entonces cambiar el tráfico de producción.
Resumen
Comparar claude-sonnet-5-5 con claude-opus-5-5 no es tan simple como decir que «lo caro es mejor y lo barato es peor». Tras la reducción de precio de Opus 5.5, la lectura de caché cuesta lo mismo que en Sonnet, y su nivel medium predeterminado ya ofrece una eficiencia muy alta. Opus supera a Sonnet de forma general en juicios precisos con contextos largos e inteligencia integral. Por su parte, Sonnet 5.5 mantiene ventajas irremplazables en velocidad de respuesta, coste de salida, programación en terminal y ejecución de alta concurrencia. Por tanto, Sonnet no se limita a una ventaja de precio: sus puntos fuertes destacan cuando se usa en el nivel y rol adecuados.
Para los Agent empresariales que procesan grandes volúmenes de contenido de entrada y salida, la combinación más razonable es «Opus decide, Sonnet ejecuta»: Opus conserva el contexto largo y se encarga de la planificación y la revisión final; Sonnet trabaja en paralelo en el nivel medium para redactar y ejecutar tareas; y la parte sin conexión se delega a Batch. En la práctica, puedes comenzar fijando los niveles para realizar pruebas comparativas, dividir después los Agent según la tabla de roles de este artículo y, finalmente, optimizar los costes de forma continua mediante dos métricas: la tasa de aciertos de caché y los tokens de salida.
Si quieres validar rápidamente este enfoque de doble modelo, se recomienda invocar de forma unificada claude-opus-5-5 y claude-sonnet-5-5 mediante APIYI apiyi.com. La interfaz de la plataforma es compatible con el formato de OpenAI y permite cambiar libremente entre ambos modelos con una sola clave API, lo que resulta ideal para pruebas de selección y orquestación multimodelo en producción.
Referencias:
– Documentación de precios de Anthropic: platform.claude.com/docs/en/about-claude/pricing
– Documentación del modo Fast de Anthropic: platform.claude.com/docs/en/build-with-claude/fast-mode
– Comparativa de Sonnet 5.5 y Opus 5.5 de Artificial Analysis: artificialanalysis.ai
– Análisis del lanzamiento de Opus 5.5 de Digital Applied: digitalapplied.com
– Comparativas Sonnet 5.5 vs. Opus 5.5 de Kingy AI y Emergent: kingy.ai、emergent.sh
Sobre el autor: Equipo técnico de APIYI, especializado en integración de API de Modelos de Lenguaje Grandes y prácticas de ingeniería. Puedes contactar con nosotros a través de APIYI apiyi.com para intercambiar experiencias sobre la orquestación de Agent y la optimización de costes con claude-opus-5-5 y claude-sonnet-5-5.