Nota del autor: Cuando se lanza un modelo nuevo, ¿cómo comprobar con tus propias tareas de largo horizonte si merece la pena cambiar? Este artículo divide esa pregunta en un proceso ejecutable de 5 pasos.
Cada mes, casi, se publica un modelo nuevo y las clasificaciones de benchmarks no dejan de actualizarse. Tomemos como ejemplo Hy4 de Tencent Hunyuan, lanzado oficialmente en noviembre de 2026: según la compañía, frente a la versión preliminar ha optimizado específicamente las capacidades de agente y las tareas de largo horizonte, y ha entrado en los primeros puestos entre los modelos de código abierto en varios benchmarks. Pero para los desarrolladores solo hay una pregunta que de verdad importa: ¿es mejor que el modelo que uso ahora en mis tareas? Este artículo presenta un método de validación comparativa de modelos nuevos basado en tus propias tareas de largo horizonte, que te ayuda a llegar en uno o dos días a una conclusión respaldada por datos.
No es otro artículo interpretando puntuaciones de benchmarks. Las clasificaciones miden la capacidad general; tu negocio mide otra cosa: si el modelo puede llevar una tarea de varios pasos de principio a fin, si puede corregirse por su cuenta cuando se equivoca y cuánto cuesta completar cada trabajo.
Valor principal: al terminar de leer, sabrás construir un conjunto de validación de tareas de largo horizonte pequeño pero preciso, comparar el modelo nuevo y el actual con 6 métricas y, usando la facturación real, calcular el «coste por entrega exitosa» para decidir si cambiar o no.
Puntos clave para validar tareas de largo horizonte con un modelo nuevo
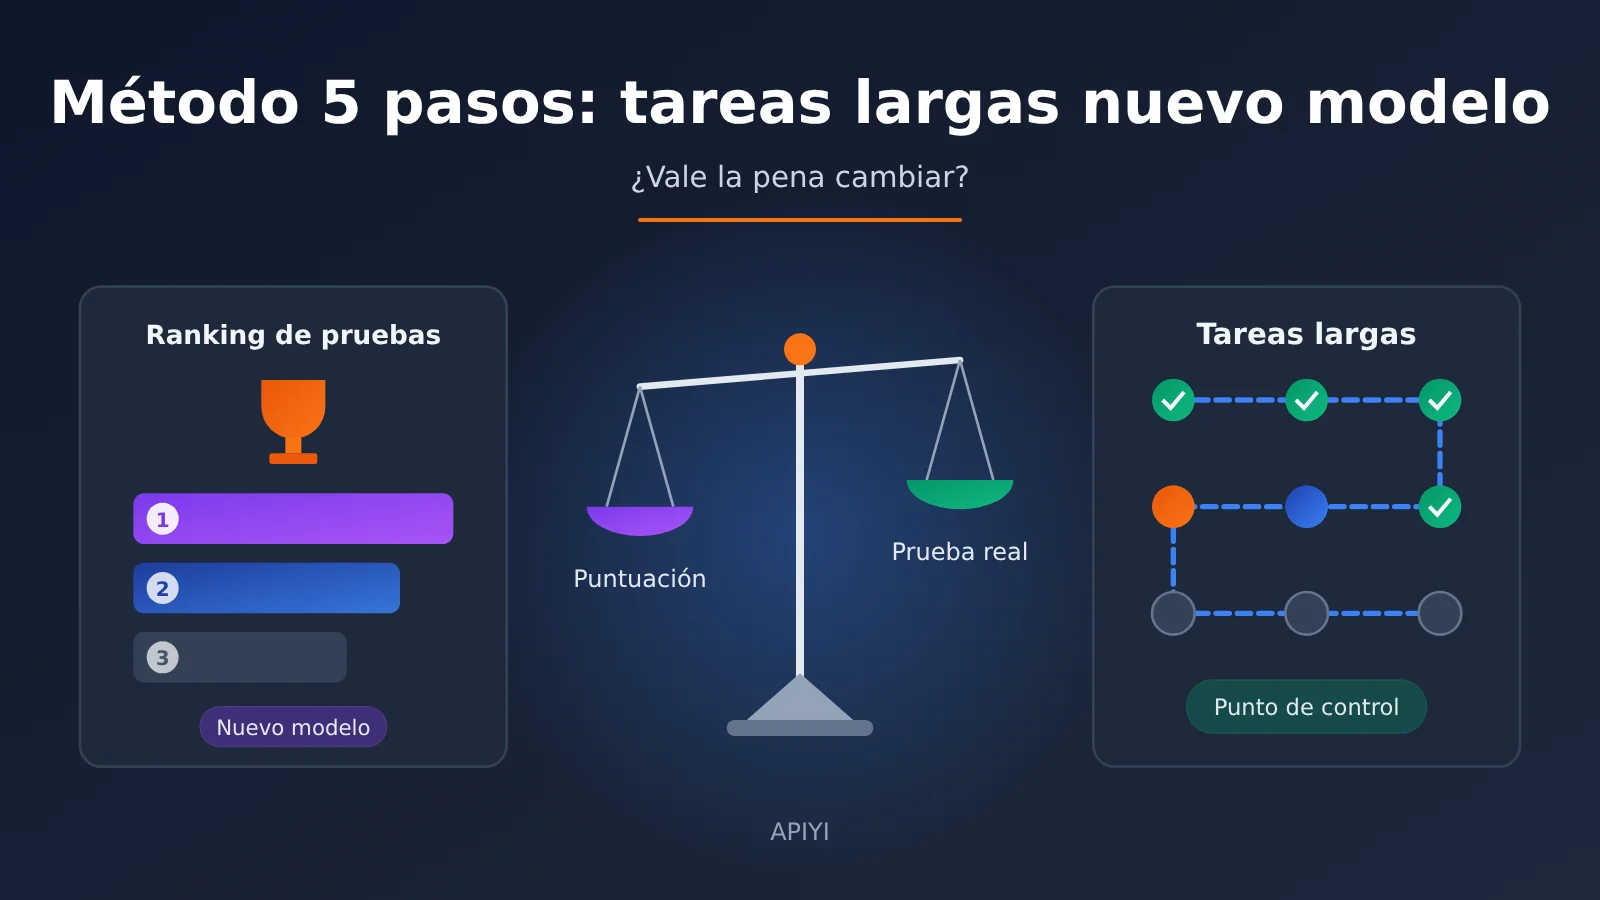
Antes de ponerte manos a la obra, conviene tener clara la diferencia entre validar tareas de largo horizonte y hacer una prueba normal de un solo turno. Las pruebas de un solo turno miran si una respuesta queda bien; la validación de tareas de largo horizonte mira si el objetivo sigue ahí después de decenas de pasos consecutivos.
| Punto clave | Descripción | Valor |
|---|---|---|
| Usa tus propias tareas | Extrae de 3 a 5 tareas de varios pasos de un negocio real, en lugar de usar problemas públicos | Las conclusiones se conectan directamente con el beneficio del negocio |
| Grupo de control fijo | El modelo actual y el nuevo se ejecutan sobre la misma tarea y con la misma cadena de herramientas | Elimina diferencias de indicaciones y entorno |
| Prioriza las métricas de proceso | Registra el mantenimiento del objetivo, la autocorrección y el número de intervenciones humanas | Detecta problemas de estabilidad que los benchmarks no muestran |
| Calcula el coste por entrega | Contabiliza el coste en tokens por “cada entrega exitosa” | Evita decisiones erróneas por mirar solo el precio unitario |
| Define el umbral para cambiar de modelo | Escribe de antemano el criterio de “cuánto tiene que mejorar para que merezca la pena cambiar” | Evita que un solo caso espectacular te desvíe |
Por qué la validación de tareas de largo horizonte es más fiable que los benchmarks
Los problemas de los rankings públicos suelen ser cerrados y de cadena corta, justo lo contrario del trabajo real de un Agent. En la evaluación de referencia, una tarea de largo horizonte para Hy4 pedía pasar de la investigación, el desarrollo, la revisión y la corrección hasta llegar a un juego 3D jugable; por el camino se añadieron además un video de referencia y nuevos requisitos. Este tipo de tareas pone a prueba si el modelo, a medida que se acumulan los pasos, recuerda el plan inicial, distingue lo que ya está hecho de lo que queda pendiente y ajusta el plan cuando los resultados intermedios no salen como se esperaba.
Otro fenómeno que llama la atención es el efecto de sinergia entre “modelo + cadena de herramientas”. En la misma evaluación, Hy4 generó en WorkBuddy, en media hora, 14 archivos PPT, un Excel y un documento Word de 19 páginas. Los evaluadores también señalan claramente que el modelo se encarga de comprender, planificar y decidir, mientras que la cadena de herramientas se ocupa de leer, calcular, renderizar y escribir. Esto implica que, cuando valides un modelo nuevo, tienes que ejecutarlo dentro de tu propia cadena de herramientas; las conclusiones que se sacan fuera de ese entorno tienen un valor de referencia limitado.
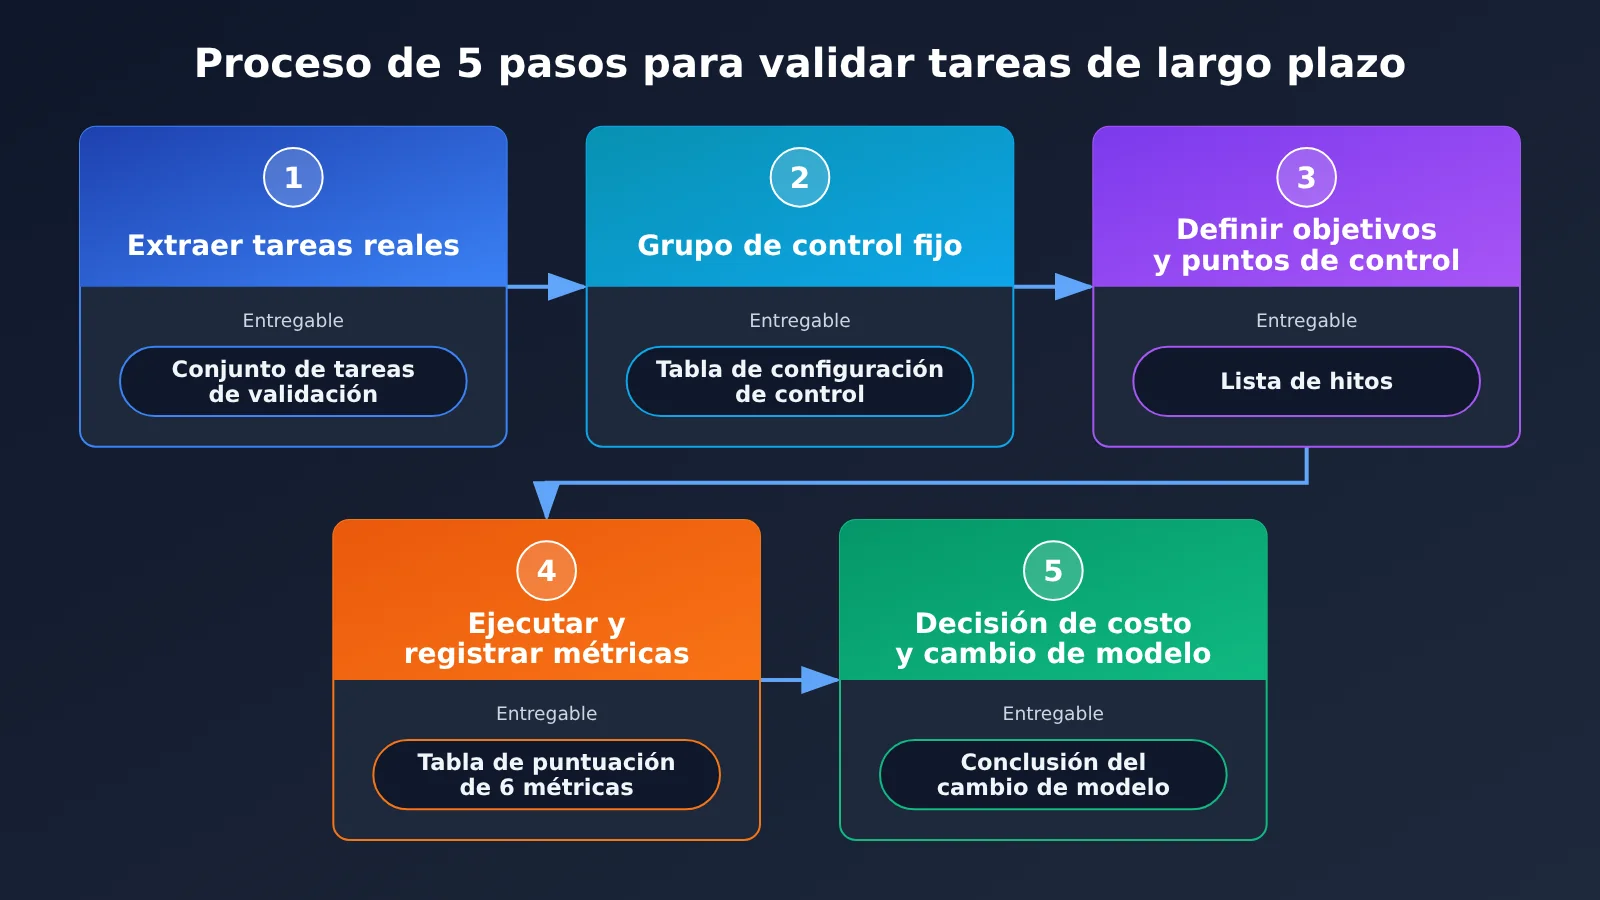
Validación de tareas de largo horizonte con nuevos modelos: guía rápida en 5 pasos
Este flujo no depende de ningún framework en particular. Siempre que la invocación del modelo se haga a través de una interfaz unificada, podrás cambiar de modelo y comparar con bajo costo.
Paso 1: extrae tareas de largo horizonte de tu negocio real
Lo importante del conjunto de validación no es que sea grande, sino que se parezca a la realidad. Te sugiero elegir de 3 a 5 tareas que cubran los tres tipos de escenarios más habituales, los que más esfuerzo manual requieren y los más propensos a errores en tu negocio. Cada tarea debería cumplir estas tres condiciones: al menos 10 pasos, requerir el uso de herramientas y tener entregables claros.
Puedes inspirarte en estos tipos de tareas de largo horizonte para diseñar tu propia versión:
- Procesamiento por lotes de documentos: te dan una carpeta con más de diez documentos y debes resumir cada uno, generar material de presentación y consolidarlo en una tabla y un informe.
- Desarrollo de aplicaciones: partiendo de la descripción de requisitos, completar el desarrollo, las pruebas propias, las correcciones y entregar finalmente un producto que se pueda ejecutar.
- Replicación multimodal: subir capturas de pantalla o grabaciones de pantalla y pedir al modelo que, tras entender el contenido, replique la interfaz o la interacción correspondiente.
- Uso del ordenador: hacer que el modelo vea la pantalla, encuentre botones, haga clic e introduzca datos para completar un flujo de operación entre varias aplicaciones.
Paso 2: fijar el grupo de control y el entorno de ejecución
La clave de un experimento controlado es “cambiar solo una variable”. El modelo antiguo y el nuevo deben usar la misma indicación del sistema, el mismo conjunto de definiciones de herramientas y los mismos materiales de entrada. Se recomienda ejecutar cada tarea al menos 3 veces y tomar el promedio y el peor resultado, ya que la aleatoriedad en tareas de largo horizonte es mucho mayor que en preguntas y respuestas de un solo turno.
| Elemento de configuración | Configuración recomendada | Descripción |
|---|---|---|
model |
Modelo actual vs. modelo nuevo | Único parámetro que puede variar |
temperature |
Mantener igual en ambos grupos, preferiblemente bajo | Reduce la interferencia de la aleatoriedad en las conclusiones |
max_tokens |
Dejar margen según la salida más larga de la tarea | Evita subestimar la capacidad del modelo por truncamiento |
Definición de herramientas tools |
Lista de funciones y descripciones idénticas | Las diferencias en la descripción de herramientas afectan notablemente el comportamiento de invocación |
| Indicación del sistema | Misma versión, sin ajustar específicamente para el modelo nuevo | Primero medir el rendimiento “out of the box” y luego el rendimiento tras el ajuste |
| Número de repeticiones | Al menos 3 veces por tarea | Observar la estabilidad, no el mejor resultado |
Si tu proyecto usa tanto interfaces estilo OpenAI como estilo Anthropic, cambiar de modelo suele implicar cambiar el SDK, la autenticación y el formato de solicitud, lo que complica mucho los experimentos controlados. Al invocar mediante una plataforma unificada de agregación de API, basta con modificar el campo model para completar el cambio.
🚀 Consejo para empezar rápido: APIYI apiyi.com ofrece acceso API a los principales modelos tratados en este artículo y es compatible tanto con el formato de interfaz de OpenAI como con el de Anthropic. Para hacer experimentos controlados, solo hay que sustituir el parámetro
modelpara cambiar entre el modelo antiguo y el nuevo. El método de integración,base_urly la configuración de autenticación deben consultarse en el centro de documentación de APIYI: docs.apiyi.com.
Paso 3: Definir anclas de objetivo y puntos de control para la tarea
El modo de fallo más habitual en tareas de largo recorrido no es «no saber hacerlo», sino «irse haciendo y olvidarse de qué había que hacer». En la evaluación de referencia se usó la instrucción /goal para obligar al modelo a mantener siempre un objetivo concreto, y esa idea se puede trasladar a cualquier entorno de validación. Puedes dejar escrito con claridad el objetivo final al principio de la tarea y dividir los entregables en varios hitos comprobables.
Tomemos como ejemplo la tarea del «minijuego 3D realista»: los evaluadores dividieron el objetivo en 5 elementos: escena del juego, aspecto visual y sensación al jugar, sonido y jugabilidad, flujo de trabajo y entrega final. Tus propias tareas también deberían dividirse así, con cada hito asociado a un punto de control que permita juzgar de forma objetiva si está «hecho o no hecho»; así la puntuación posterior será mucho más sencilla.
Paso 4: Ejecutar y registrar 6 métricas
En cada ejecución hay que conservar el registro completo de la conversación y de las llamadas a herramientas, y después puntuar según la tabla siguiente. Las 4 primeras miden «si se puede terminar»; las 2 últimas miden «si sale a cuenta».
| Métrica | Cómo medirla | Forma de puntuar |
|---|---|---|
| Tasa de finalización de la tarea | Puntos de control completados / puntos de control totales | Porcentaje, media de 3 ejecuciones |
| Grado de mantenimiento del objetivo | Si en la segunda mitad se sigue avanzando en torno al objetivo inicial, si hay omisiones o desviaciones | Puntuación humana de 1 a 5 |
| Capacidad de autocorrección | Si tras un error intermedio (fallo, test fallido) es capaz de corregirlo por sí mismo | Registrar «número de errores / número de autocorrecciones» |
| Número de intervenciones humanas | Rondas en las que hace falta que una persona añada aclaraciones o corrija el rumbo | Cuantas menos, mejor |
| Tiempo empleado | Tiempo de reloj desde el inicio hasta la entrega | En minutos, incluyendo el tiempo de ejecución de herramientas |
| Coste por entrega | Coste total en tokens / número de entregas exitosas | Calculado según el criterio de facturación real |
El «número de intervenciones humanas» merece especial atención. La conclusión de la evaluación de referencia es que Hy4, en la mayoría de tareas cotidianas de oficina y creativas, prácticamente puede entregar de una sola vez, pero en trabajos con muchas operaciones de ordenador y flujos complejos todavía necesita varias rondas de interacción para ayudarle a entender la intención. Esa es justo la diferencia que tienes que cuantificar en tus propias tareas: cada intervención supone un coste en horas de trabajo.
Paso 5: Calcular los costos y decidir si cambiar de modelo
El cálculo de costos debe hacerse por «entrega exitosa», no basta con comparar los precios unitarios de entrada y salida. Un modelo que tiene un precio unitario bajo pero que necesita ejecutarse dos veces puede terminar costando más. Las tareas de larga duración tienen además una particularidad: el contexto arrastra una y otra vez el historial, así que la tasa de acierto de la caché influye mucho en el gasto total.
La fórmula es: costo de una tarea = tokens de entrada sin acierto en caché × precio unitario de entrada + tokens de entrada con acierto en caché × precio de caché + tokens de salida × precio unitario de salida. Después, divide el costo total de varias ejecuciones entre el número de entregas exitosas. Para los precios unitarios de entrada y salida, el precio de caché y los criterios de facturación de cada modelo, consulta los datos reales de la página de precios de APIYI en docs.apiyi.com/models; este artículo no incluye cifras concretas para no inducir a error cuando cambien los precios.
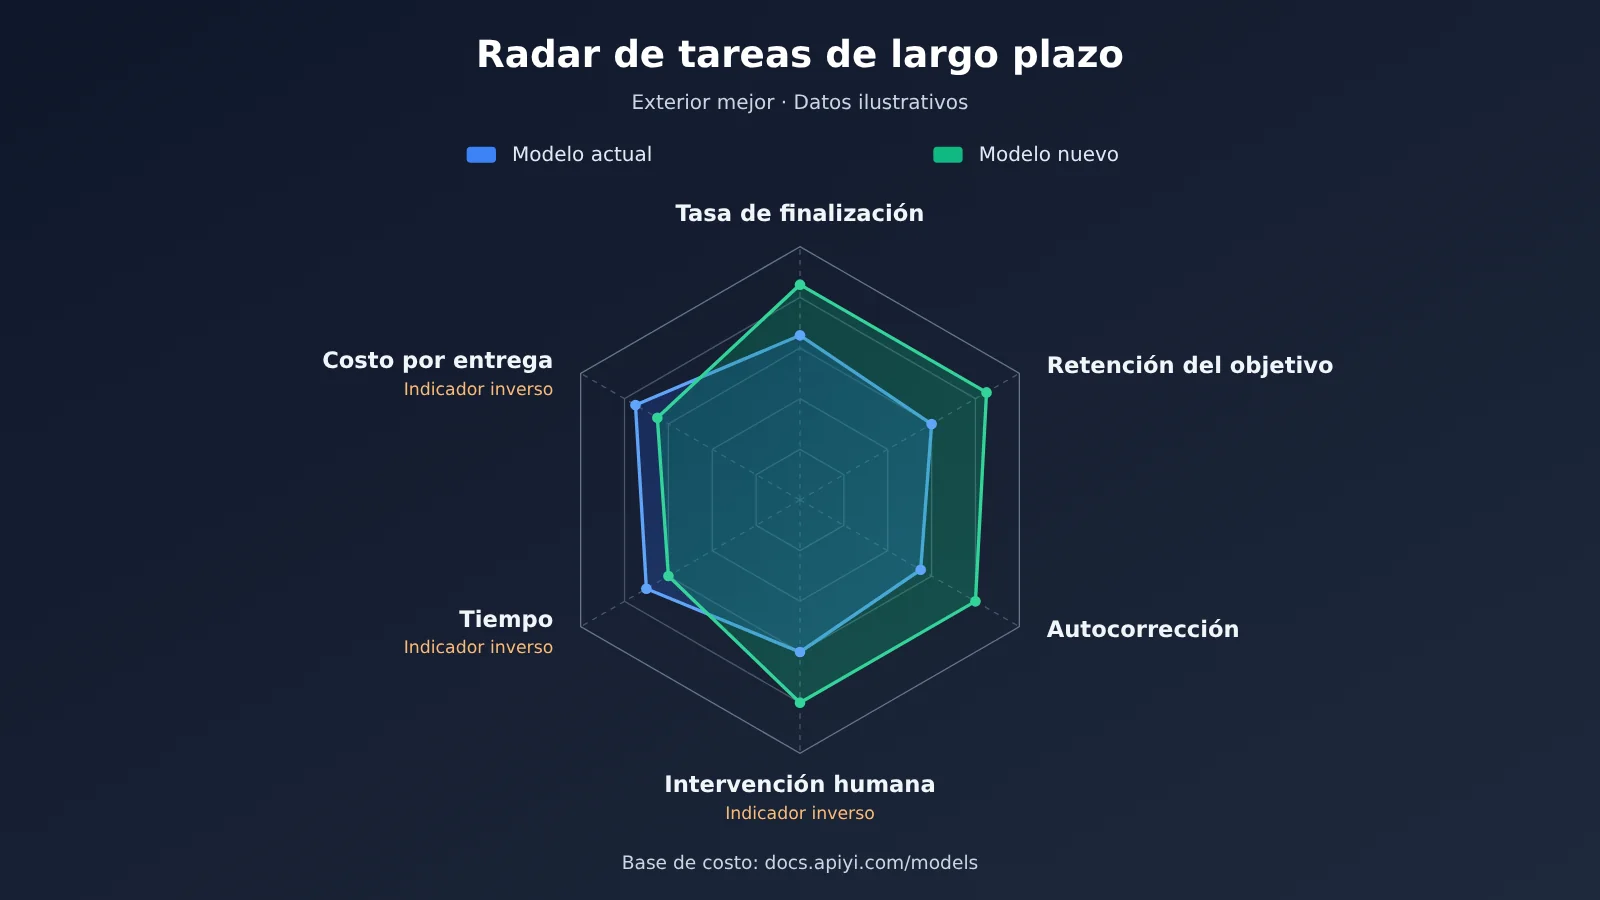
💰 Consejo para el cálculo de costos: al hacer la comparación, conviene invocar tanto el modelo actual como el nuevo desde la misma plataforma, para que las estadísticas de uso y los criterios de facturación sean consistentes; así, el «costo por entrega» que obtengas será realmente comparable. La página de precios de APIYI docs.apiyi.com/models enumera los precios de entrada, salida y caché de cada modelo, y puedes usarla directamente como base para el cálculo.
Criterios de decisión para validar tareas de largo horizonte con nuevos modelos
Cuando terminas de recoger los datos, lo que más preocupa es quedarse con un “cada uno tiene sus ventajas y no hay forma de decidir”. Lo recomendable es definir las reglas de decisión antes de empezar el experimento. La siguiente tabla puede servir como punto de partida; después ajusta los umbrales según la sensibilidad de tu negocio.
| Resultado de la comparación | Decisión sugerida | Motivo |
|---|---|---|
| La tasa de finalización mejora claramente y el costo por entrega se mantiene o baja | Cambiar directamente | Se benefician tanto la calidad como el costo |
| La tasa de finalización mejora claramente, pero el costo sube | Cambiar según el escenario | Usar el nuevo modelo solo en tareas de alto valor y alta dificultad |
| La tasa de finalización se mantiene y el costo baja claramente | Cambio gradual | Sustituir primero en tareas de bajo riesgo y observar durante un tiempo |
| La tasa de finalización se mantiene y disminuyen las intervenciones | Priorizar el cambio | El esfuerzo humano ahorrado suele valer más que el costo en tokens |
| La tasa de finalización baja o la estabilidad empeora | No cambiar por ahora | Esperar a la siguiente versión o ajustar la indicación y volver a medir |
Hay otra dimensión que se suele pasar por alto: la reconstrucción de tareas que traen las nuevas capacidades. Por ejemplo, Hy4 incorpora comprensión visual, puede leer directamente una grabación de pantalla y analizarla fotograma a fotograma, además de tomar capturas de pantalla de sus propios resultados de forma continua y optimizar mediante autoevaluación y retroalimentación. Si tu flujo anterior necesitaba que una persona convirtiera las capturas en descripciones de texto, puede que el nuevo modelo no solo haga “mejor la misma tarea”, sino que elimine un paso de todo el flujo. Este tipo de beneficio conviene registrarlo por separado; no lo midas únicamente con la puntuación de las tareas antiguas.
Referencia de selección al comparar modelos principales
Al hacer comparaciones, normalmente se prueba el nuevo modelo junto con el modelo en producción y otros candidatos del mismo nivel. La siguiente tabla muestra el enfoque de selección; para las capacidades concretas, toma como referencia tus propias pruebas con tareas de largo horizonte.
| Tipo de candidato | Tareas de largo horizonte adecuadas | Punto clave de validación | Plataforma disponible |
|---|---|---|---|
| Modelo nuevo de código abierto/nacional | Procesamiento por lotes de documentos de oficina, agentes para escenarios en chino | Mantenimiento del objetivo, relación calidad-precio | APIYI apiyi.com, etc. |
| Modelo principal de código cerrado en producción | Programación compleja, razonamiento de alta dificultad | Como línea base de calidad | APIYI apiyi.com, etc. |
| Modelo con capacidades multimodales | Réplica de capturas/grabaciones de pantalla, comprensión de interfaces | Precisión de la comprensión visual, autocorrección | APIYI apiyi.com, etc. |
| Modelo ligero y rápido | Distribución de subtareas, organización de formatos | Tiempo y costo | APIYI apiyi.com, etc. |
💡 Sugerencia de elección: no compares un solo candidato con el modelo en producción. Si pones dos o tres candidatos más en el mismo conjunto de validación bajo una interfaz unificada, a menudo descubrirás una mejor solución basada en “combinar modelos según el escenario”. APIYI permite invocar varios modelos principales de forma unificada, lo que facilita llevar este tipo de combinación a la práctica rápidamente.
Preguntas frecuentes (FAQ)
P1: ¿Qué es la validación de tareas de largo recorrido de un nuevo modelo?
La validación de tareas de largo recorrido consiste en probar el modelo con tareas reales que incluyen varios pasos, requieren invocar herramientas y tienen entregables claros. Lo que se evalúa es si el modelo mantiene el objetivo a lo largo de pasos consecutivos, si puede corregirse a sí mismo cuando comete un error y el coste del entregable final, no la calidad de una respuesta de un solo turno.
P2: ¿Qué diferencia hay entre la validación de tareas de largo recorrido y consultar un Benchmark público?
Los Benchmark son muy valiosos para comparar capacidades generales de forma transversal, pero sus ejercicios difieren bastante de tu negocio y suelen ser tareas de cadena corta. La validación de tareas de largo recorrido, en cambio, se ejecuta directamente sobre tu cadena de herramientas y tus datos, y saca a la luz problemas como el olvido del objetivo, el uso indebido de herramientas o la necesidad de corregir al modelo una y otra vez de forma manual. Lo más sensato es combinar ambos: primero filtrar candidatos con los rankings y después decidir con tus propias tareas.
P3: ¿Cuánto tiempo después del lanzamiento de un nuevo modelo conviene empezar a validarlo?
Se recomienda lanzar cuanto antes una primera ronda de pruebas «listas para usar» tras el lanzamiento, porque muchos modelos nuevos ofrecen un periodo gratuito por tiempo limitado. En los materiales de referencia, Hy4 tiene en WorkBuddy un periodo gratuito del 4 al 15 de noviembre. Si los resultados de la primera ronda son buenos, entonces sí merece la pena dedicar tiempo a ajustar las indicaciones para el nuevo modelo y hacer una segunda ronda de pruebas.
P4: ¿Cuántas tareas necesita el conjunto de validación para ser suficiente?
Con 3-5 tareas muy ajustadas a tu negocio suele bastar para llegar a conclusiones orientativas; repite cada tarea 3 veces para observar la estabilidad. Más que acumular cantidad, asegúrate de que las tareas cubran tus escenarios más frecuentes, los que más mano de obra consumen y los más propensos a errores, y diseña puntos de control claros para cada tarea.
P5: ¿Cómo comparar varios modelos cambiando entre ellos con bajo coste?
La forma más cómoda es invocar a través de una plataforma de interfaz unificada. APIYI apiyi.com es compatible con los dos formatos de interfaz, OpenAI y Anthropic; para cambiar de modelo solo hay que modificar el parámetro `model`, sin tocar la definición de herramientas ni las indicaciones. Los pasos concretos de integración están en el centro de documentación docs.apiyi.com.
P6: ¿Cómo calcular con precisión el coste de las tareas de largo recorrido?
Hay que calcularlo como «coste por entrega exitosa», es decir, el gasto total en tokens de varias ejecuciones dividido entre el número de entregas exitosas, distinguiendo la parte de entrada que acierta en caché de la que no. Los precios unitarios y de caché de cada modelo deben tomarse de los datos reales de la página de precios de APIYI docs.apiyi.com/models; un mismo criterio de facturación en una sola plataforma hace que la comparación sea más justa.
P7: ¿Qué limitaciones tiene la validación de tareas de largo recorrido?
Primero, la muestra es pequeña: un resultado espectacular o un fallo puntual pueden ser casualidad, así que hay que repetir las ejecuciones. Segundo, la evaluación manual es subjetiva; se recomienda que dos personas puntúen por separado y se promedie. Tercero, los resultados dependen mucho de la cadena de herramientas, y al cambiar de framework de Agent hay que volver a medir. Además, el techo de capacidad del modelo suele depender de la dificultad de las tareas de prueba, así que conviene añadir periódicamente tareas más difíciles al conjunto de validación.
Verificación de tareas de largo plazo con el nuevo modelo: conclusiones clave
- Habla con tus propias tareas: 3-5 tareas reales de varios pasos acercan más el beneficio de cambiar de modelo que cualquier ranking.
- Cambia solo una variable: el modelo nuevo y el anterior deben compartir indicaciones, herramientas y entradas; ejecuta cada tarea al menos 3 veces.
- No puede faltar un ancla de objetivo: toma la idea de
/goalpara dividir hitos; cuanto más objetivos sean los checkpoints, más precisa será la evaluación. - Mira las 6 métricas en conjunto: tasa de finalización, mantenimiento del objetivo, autocorrección, número de intervenciones, tiempo y costo de entrega.
- Calcula el costo por entrega: distingue los aciertos de caché y usa como base de facturación la página de precios de APIYI docs.apiyi.com/models.
- Presta atención a la reestructuración de procesos: capacidades nuevas como la comprensión visual pueden eliminar directamente pasos manuales del flujo anterior.
Resumen
Puntos clave de la verificación de tareas de largo plazo con el nuevo modelo:
- Tareas reales: el conjunto de validación sale del negocio y cubre escenarios frecuentes, de alto consumo de tiempo y propensos a errores.
- Comparación rigurosa: entorno fijo, ejecuciones repetidas y umbrales de cambio de modelo definidos de antemano.
- Cuentas claras: mide el beneficio real con el costo de una entrega exitosa y el número de intervenciones manuales.
Cada lanzamiento de un modelo nuevo es una oportunidad para revisar el flujo de trabajo. En lugar de dejarte llevar por rankings y videos de demostración, dedica uno o dos días a dar una respuesta concreta con tus propias tareas de largo plazo. Recomendamos usar APIYI apiyi.com para poner el modelo nuevo y el anterior bajo la misma interfaz y compararlos rápidamente; consulta las instrucciones de integración en docs.apiyi.com y toma los datos de facturación de docs.apiyi.com/models.
📚 Referencias
- 爱范儿 – Prueba práctica de Tencent Hy4: casos de prueba reales de tareas de largo recorrido, multimodalidad y operación de computadora de Hy4
- Enlace:
ifanr.com/1687613 -
Descripción: ofrece diseños de prueba aprovechables como la restricción de objetivo
/goal, el desarrollo de juegos de largo recorrido y el procesamiento por lotes de documentos -
Centro de documentación de APIYI: instrucciones de integración de modelos y del formato de interfaz
- Enlace:
docs.apiyi.com -
Descripción: consulta cómo configurar las interfaces compatibles con OpenAI y Anthropic
-
Página de precios de modelos de APIYI: precios de entrada, salida y caché de cada modelo
- Enlace:
docs.apiyi.com/models - Descripción: la única base de referencia de precios para el cálculo de costes
Autor: Equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal de APIYI apiyi.com; para más materiales sobre integración de modelos, visita el centro de documentación docs.apiyi.com