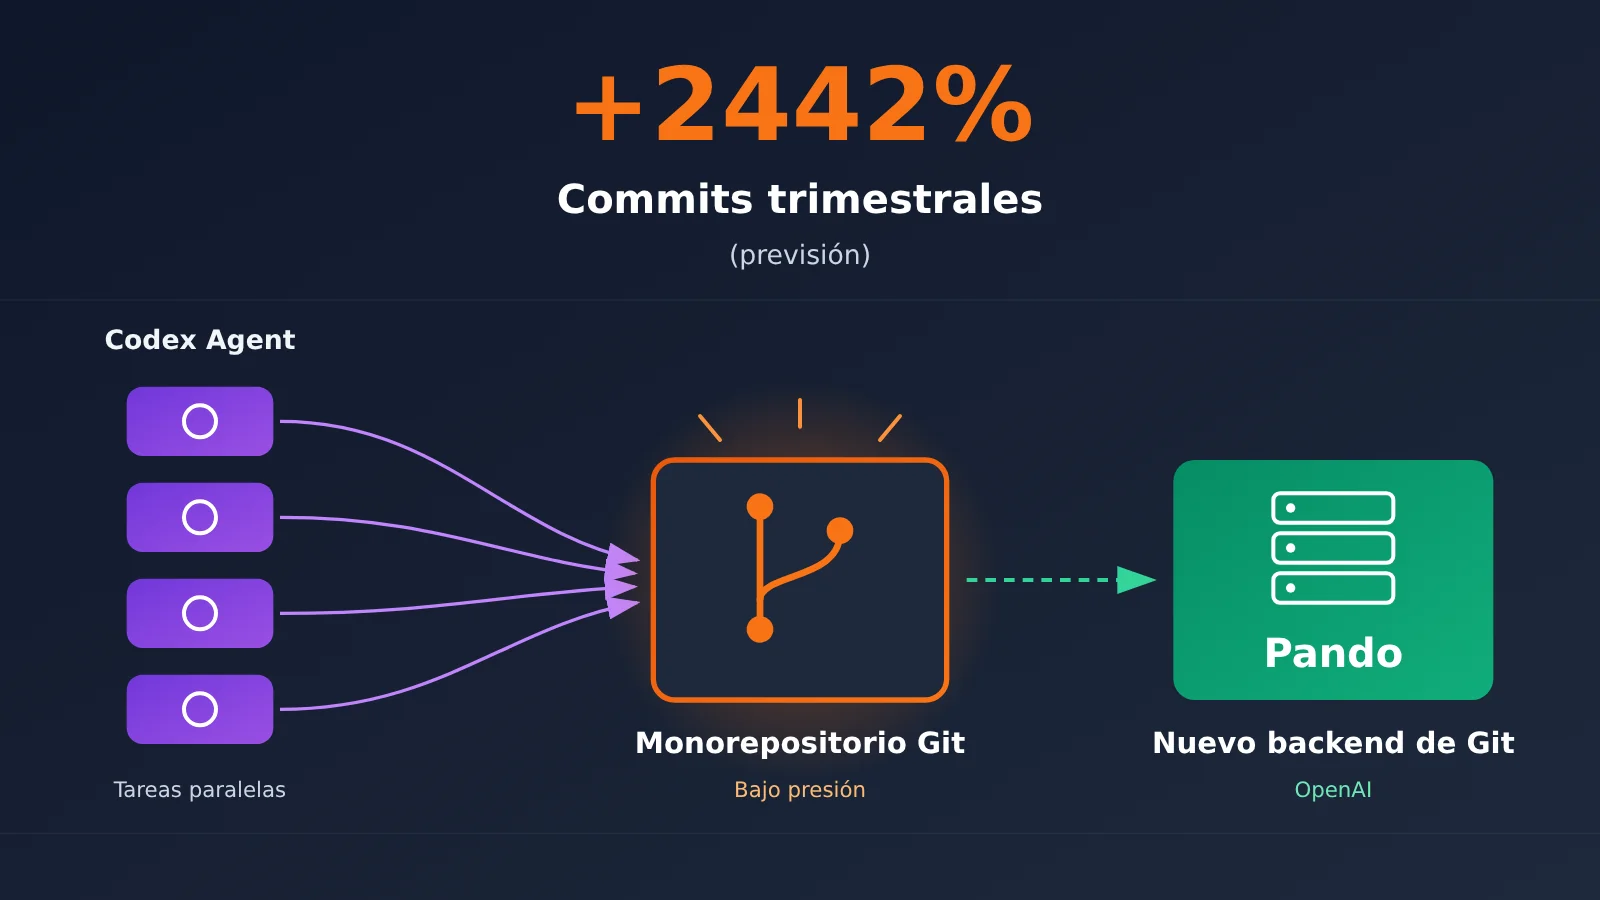
Nota del autor: OpenAI ha presentado Pando, su nuevo backend de Git. Se prevé que, impulsado por Codex, el número de commits trimestrales en su monorepositorio aumente un 2442% con respecto al primer trimestre de 2024. En este artículo analizamos cómo el impacto de la programación con IA se extiende desde la generación de código hasta Git, la integración continua (CI) y la revisión de código.
El 2 de noviembre de 2026, OpenAI publicó el artículo técnico «Scaling Git at OpenAI». Según un gráfico incluido en él, se prevé que el número de commits trimestrales en el monorepositorio de OpenAI aumente un 2442% en el cuarto trimestre de 2026 con respecto al primer trimestre de 2024. Para hacer frente a la presión del desarrollo concurrente impulsado por Codex, OpenAI reconstruyó su backend de Git y lo llamó Pando.
No se trata de un rumor ni de un eslogan publicitario sobre cómo «la IA multiplica por 24 la cantidad de código». Los datos proceden del blog oficial de ingeniería de OpenAI y el artículo está firmado por tres profesionales técnicos: Aaron Friel, Taylor Blau y Ted Nyman. Antes de seguir, conviene aclarar dos cosas: el 2442% es una previsión, ya que el cuarto trimestre aún no ha terminado; además, la cifra contabiliza los commits fusionados en la rama master, no las líneas de código y mucho menos la productividad.
Qué aprenderás: al terminar este artículo, entenderás cómo Codex está cambiando la escala del desarrollo de software en OpenAI mediante tareas paralelas, por qué esto pone bajo presión la infraestructura de Git y hacia dónde se están desplazando los cuellos de botella del desarrollo.
Codex y la infraestructura Git de OpenAI: datos clave
Empecemos con una tabla que resume los hechos. Toda la información procede de publicaciones oficiales de OpenAI; los datos que no se han hecho públicos se indican expresamente.
| Dato | Detalle |
|---|---|
| Fecha de publicación | 2 de noviembre de 2026, «Scaling Git at OpenAI» |
| Autores | Equipo de ingeniería de OpenAI (Aaron Friel, Taylor Blau y Ted Nyman) |
| Anuncio principal | Pando, un nuevo backend de servidor Git compatible con el protocolo y los clientes estándar de Git |
| Contexto inmediato | Codex aumentó el desarrollo en paralelo y el sistema Git anterior empezó a presentar problemas de rendimiento y fiabilidad |
| Puesta en producción | Empezó a gestionar tráfico de producción en abril de 2026, unas 10 semanas después del inicio del proyecto |
| Resultados clave | La mediana de latencia de los push bajó casi un 80 % y se entregan cerca de 1 PB de datos Git al día |
| Disponibilidad | Solo para uso interno de OpenAI; no se han anunciado una versión pública del servidor, precios ni fecha de apertura |
Evolución completa de los commits trimestrales impulsados por Codex
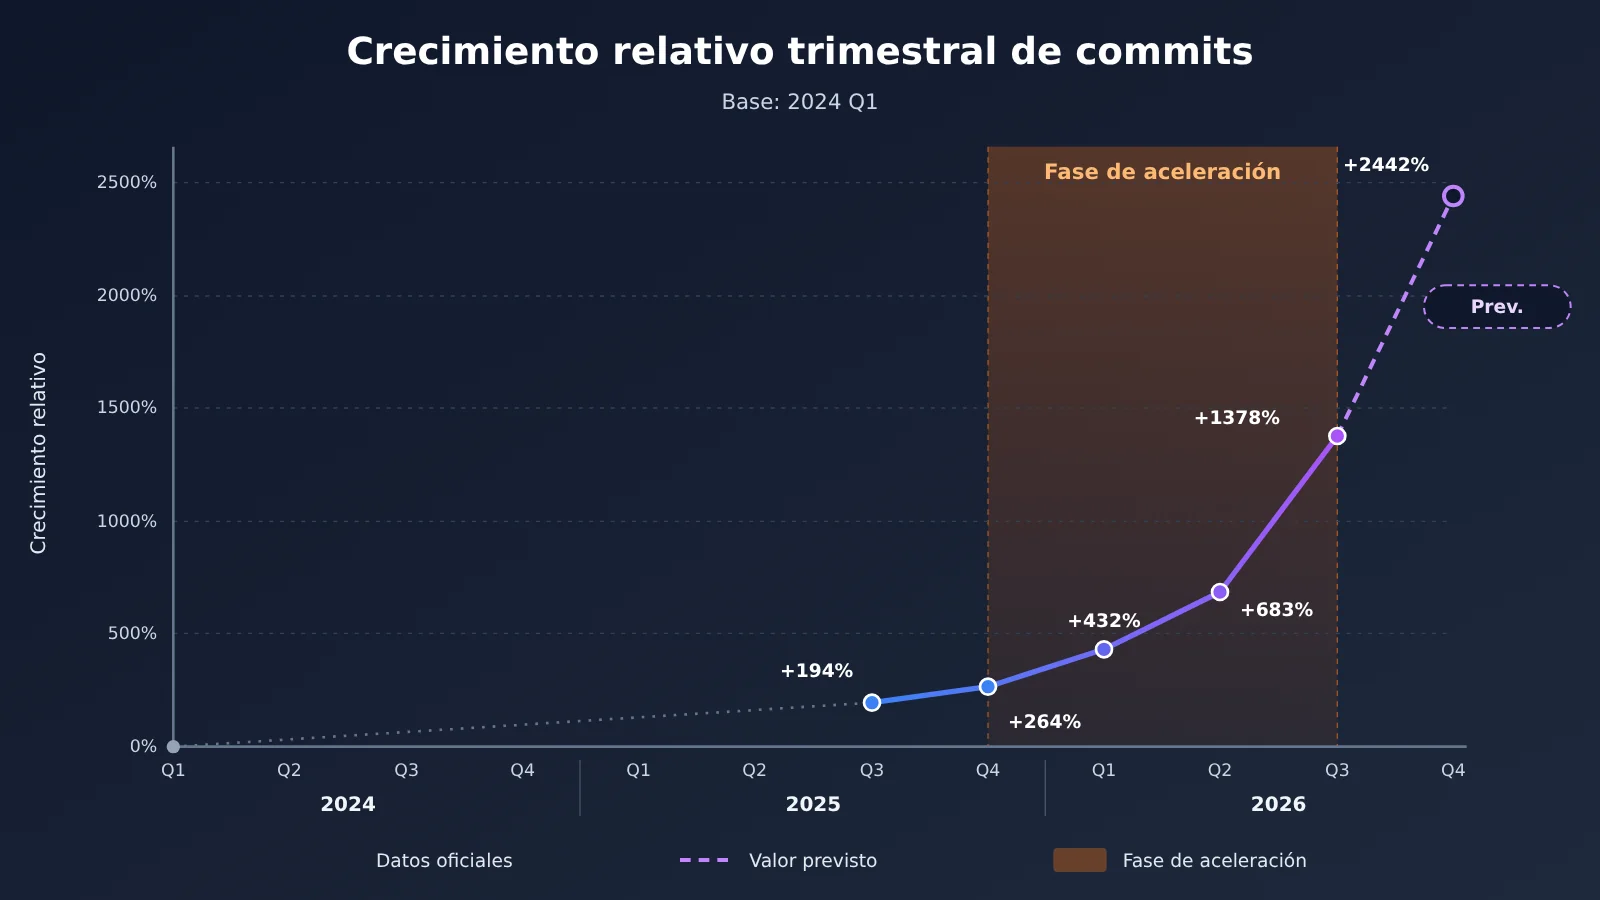
Muchos artículos solo citan la cifra del 2442 %. La serie trimestral completa ayuda a entender mejor el panorama. La siguiente tabla usa el primer trimestre de 2024 como referencia y muestra el crecimiento del número de commits trimestrales incorporados a la rama master del monorepositorio de OpenAI.
| Trimestre | Crecimiento respecto a 2024 Q1 | Multiplicador aproximado respecto al periodo base |
|---|---|---|
| 2024 Q2 | +35% | 1.35 |
| 2024 Q4 | +98% | 1.98 |
| 2025 Q2 | +194% | 2.94 |
| 2025 Q4 | +264% | 3.64 |
| 2026 Q1 | +432% | 5.32 |
| 2026 Q2 | +683% | 7.83 |
| 2026 Q3 | +1,378% | 14.78 |
| 2026 Q4 | +2,442% (previsión) | 25.42 |
De estos datos se desprenden tres cosas. Primero, el crecimiento ya estaba en marcha entre 2024 y 2025, así que no se puede atribuir por completo a Codex. Segundo, la curva se acelera claramente entre el +264% de 2025 Q4 y el +1,378% de 2026 Q3, en línea con la tendencia de desarrollo paralelo mediante agentes que describe OpenAI. Tercero, la empresa solo publicó tasas de crecimiento relativas, no el número absoluto de commits por trimestre.
Otro dato, medido con un criterio diferente, apunta en la misma dirección. El 20 de julio de 2026, el blog para desarrolladores de OpenAI señaló, al presentar Codex Code Review, que el número semanal de pull requests internos se había más que duplicado respecto al cuarto trimestre anterior. Este dato y el crecimiento trimestral de commits usan criterios y periodos distintos: no se pueden sumar ni convertir directamente entre sí. Aun así, ambos muestran que la actividad de cambios en el código está aumentando rápidamente.
Cómo Codex traslada la presión a la infraestructura de Git
A primera vista, parece que «la IA escribe código más rápido» solo afecta a cada desarrollador. Pero la explicación de OpenAI apunta a otra dimensión: Codex aumenta la cantidad de tareas que todo el sistema de ingeniería puede ejecutar en paralelo. Un ingeniero puede encargar a varios agentes funcionalidades independientes al mismo tiempo. Cada agente genera ramas, commits y operaciones Push, que a su vez desencadenan una serie de lecturas automatizadas.
La siguiente tabla resume esta cadena de causa y efecto según la descripción oficial de OpenAI.
| Etapa | Qué sucede | Impacto en la infraestructura de Git |
|---|---|---|
| A. Menor costo de ejecución | Un ingeniero encarga a varios agentes cambios simultáneos en funcionalidades independientes | Aumenta la cantidad de tareas de desarrollo |
| B. Mayor paralelismo | Se generan más ramas, commits y operaciones Git Push | Aumentan las solicitudes de escritura y las actualizaciones de ramas |
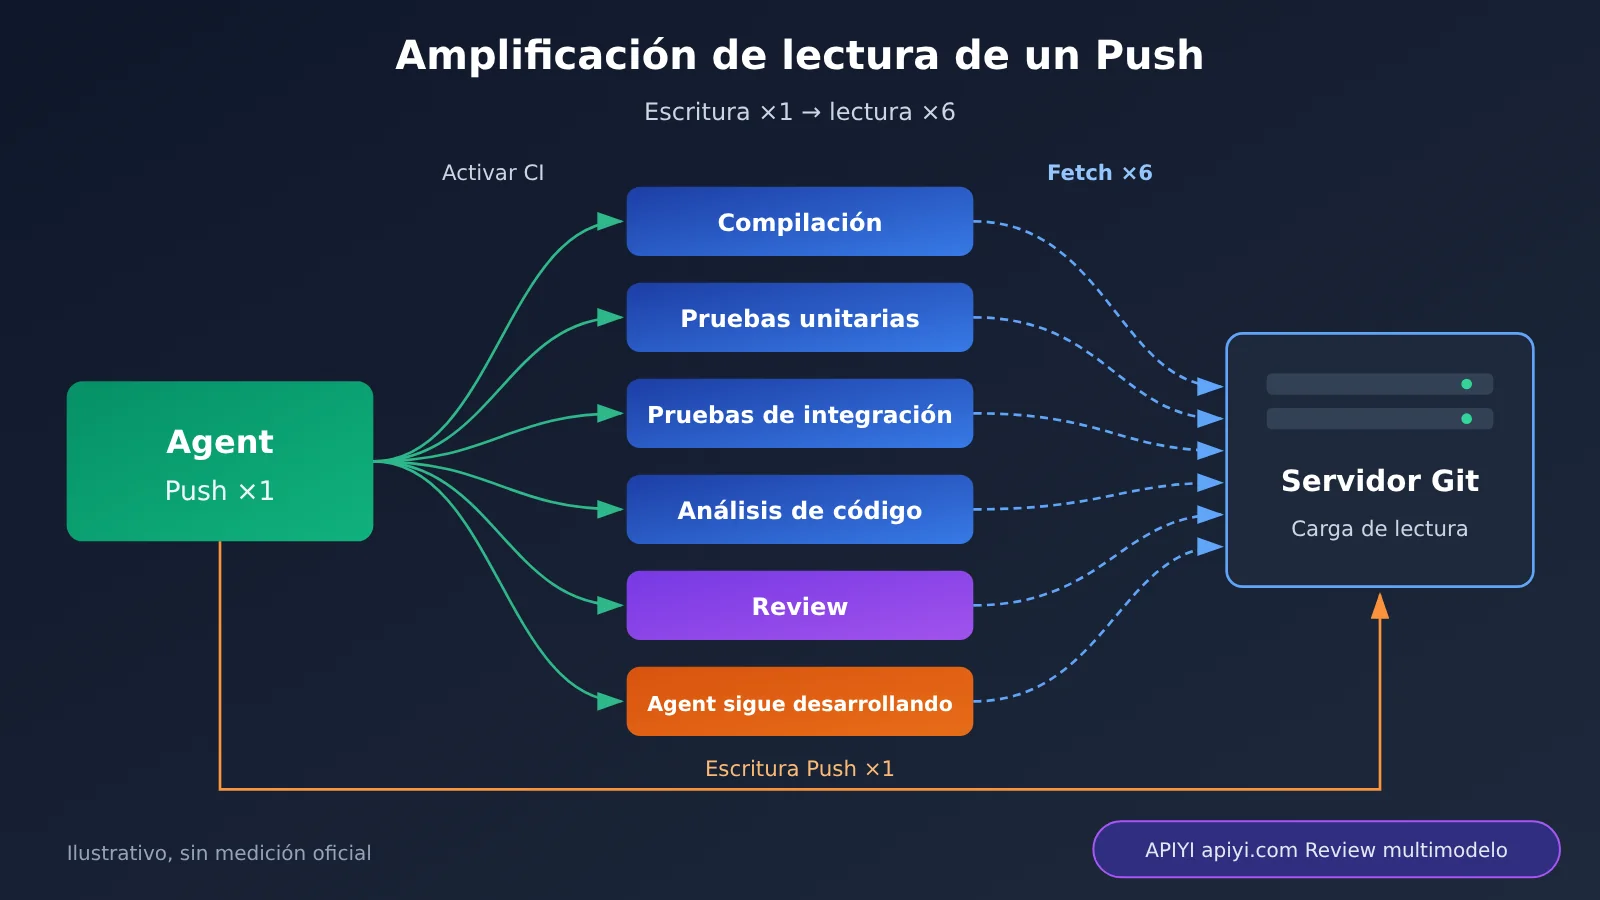
| C. Amplificación en los pipelines | Un Push activa múltiples compilaciones, pruebas y análisis de CI | Se hace Fetch del mismo commit repetidamente |
| D. Presión sobre la infraestructura compartida | Aumentan simultáneamente las fusiones, la sincronización de estados y la entrega de datos de versiones | Push / Fetch se vuelven más lentos y fallan los Merge |
| E. Desplazamiento del cuello de botella | El modelo escribe código más rápido, pero Git, CI y Review no amplían su capacidad al mismo ritmo | Las etapas posteriores limitan la velocidad de entrega |
Un ejemplo de amplificación de la carga
Este ejemplo sirve solo para ilustrar la idea; las cifras no son mediciones reales de OpenAI. Supongamos que un Push activa 6 tareas de CI y que cada una hace Fetch del código una vez. En ese caso, 100 operaciones Push podrían generar unas 600 lecturas de código. Si los agentes multiplican la cantidad de operaciones Push, el volumen de lecturas también crecerá en la misma proporción.
El número real de solicitudes depende de la caché de CI, la reutilización de tareas y la arquitectura de compilación, pero la tendencia es clara: el aumento de escrituras se amplifica en las lecturas. Y ahí es donde el servidor Git empieza a tener problemas. OpenAI también señala que varios trabajos de CI, tareas de investigación y entornos de desarrollo pueden obtener repetidamente el mismo commit.
Qué falló en el antiguo sistema Git de OpenAI
OpenAI reveló que, desde finales de 2025, los sistemas que sostenían su monorrepositorio tenían cada vez más dificultades para soportar la nueva carga. Entre los síntomas estaban la ralentización de Git Fetch y Push, los fallos al fusionar cambios y una fiabilidad de la infraestructura que en ocasiones caía por debajo del 90%.
Es importante entender bien qué significa «por debajo del 90%». Se refiere a la fiabilidad del sistema durante determinados períodos; no se han publicado los criterios de medición específicos ni la serie temporal completa. No debe interpretarse como que «el 10% del código tenía defectos» ni como que «más del 10% de los commits de OpenAI fallaban».
Desde el punto de vista técnico, la arquitectura anterior tenía dos cuellos de botella estructurales:
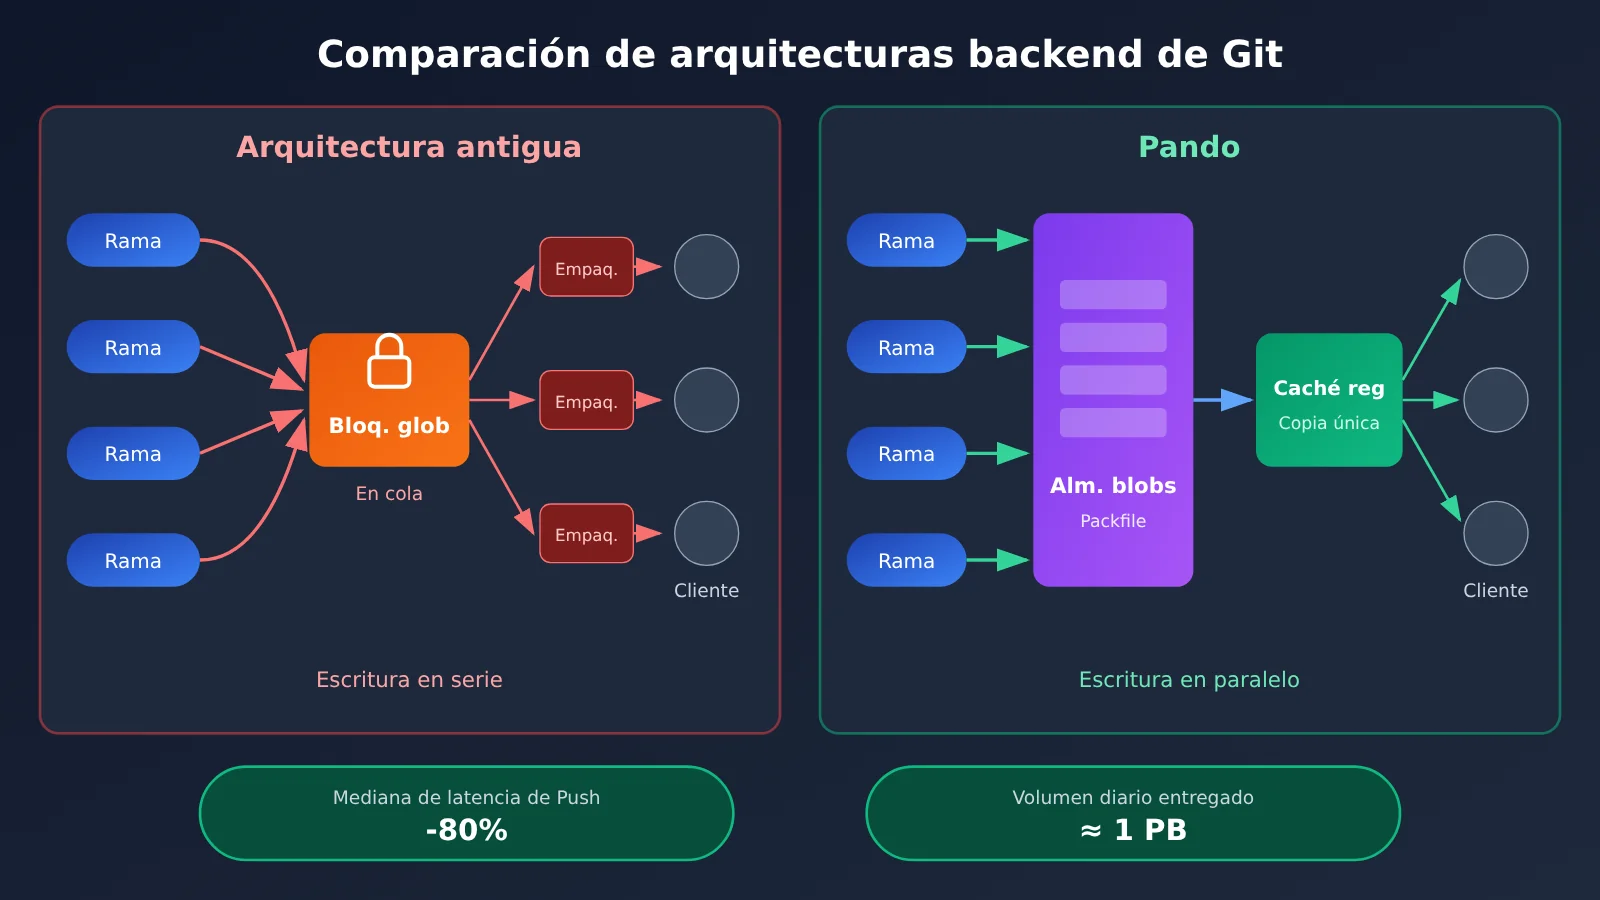
- Las actualizaciones de ramas requerían coordinación global: muchos servicios Git distribuidos tradicionales deben mantener un estado coherente de todas las referencias del repositorio. Aunque dos agentes modifiquen ramas que no tienen ninguna relación, pueden acabar compitiendo por la misma vía de coordinación.
- Los paquetes de descarga se calculaban repetidamente: como cada cliente ya dispone de un historial de Git diferente, el servidor suele tener que recorrer los objetos, empaquetarlos y comprimirlos por separado para cada uno. Cuando varios agentes leen la misma versión, este trabajo costoso se repite.
Cuando los ingenieros humanos llevaban el peso del trabajo, estos dos problemas eran aceptables. Pero, con la llegada simultánea de numerosos agentes y tareas de CI, se convirtieron en cuellos de botella para el sistema.
Cómo responde Pando a la presión que Codex ejerce sobre Git
OpenAI no ha abandonado Git. Pando sigue utilizando el protocolo y los clientes estándar de Git, por lo que los comandos y flujos de trabajo de los ingenieros prácticamente no cambian. Lo que se rediseñó fue la forma en que el servidor almacena los datos, actualiza las referencias y los distribuye. La siguiente tabla compara las principales diferencias entre la solución anterior y Pando.
| Aspecto | Servidor Git tradicional | Pando |
|---|---|---|
| Escritura en ramas | Coordinación estricta de todo el repositorio; incluso las ramas no relacionadas pueden tener que esperarse entre sí | Cada rama se actualiza de forma independiente; solo se requiere coordinación para un mismo Ref |
| Modelo de consistencia | Instantánea consistente de todo el repositorio | Consistencia causal; se garantiza el orden y la lectura de las propias escrituras en una misma rama |
| Distribución de lecturas | Los datos se vuelven a empaquetar y comprimir según el estado del cliente | Se reutilizan los Packfiles guardados durante el Push y se distribuyen a través de la caché |
| Caché | Depende de la implementación | Servicio de caché regional, con una tasa de aciertos de Packfiles superior al 99% |
| Compatibilidad con clientes | Git estándar | Git estándar, con distribución mediante el mecanismo packfile-uri |
Las dos ideas centrales de Pando
La primera es la concurrencia de escritura. Pando deja de mantener una instantánea consistente de todo el repositorio en un único momento y permite que cada rama mantenga sus propias versiones de forma independiente. Los Push de distintas ramas pueden ejecutarse en paralelo; solo hay que resolver conflictos entre solicitudes que modifican el mismo Ref. La contrapartida es que, al leer varias ramas en una misma operación, el cliente puede ver versiones de distintos momentos. OpenAI considera que esta concesión es adecuada para su caso.
La segunda es la reutilización en las lecturas. Pando almacena cada Packfile recibido en un Push como datos inmutables en un Blob Store. Cuando otros clientes hacen Fetch, el servidor selecciona los Packfiles existentes en función de los Commit que el cliente ya tiene y los que necesita, en lugar de volver a empaquetarlos. En segundo plano, también combina numerosos Packfiles pequeños en conjuntos más grandes organizados por niveles, para evitar que los clientes que llevan mucho tiempo sin actualizarse tengan que descargar demasiados archivos.
Los datos de producción publicados oficialmente incluyen una reducción de casi el 80% en la mediana de latencia de Push, la distribución de cerca de 1 PB de datos de Git al día y un pico de más de 57 TB de Packfiles distribuidos en una sola hora. Es importante tener en cuenta que 1 PB es el volumen distribuido: las lecturas repetidas de los mismos datos también cuentan, por lo que no significa que se genere 1 PB de código nuevo cada día.
También vale la pena mencionar que Pando es en sí mismo un producto desarrollado con la participación de agentes. Según OpenAI, un ingeniero diseñó su arquitectura principal y varios equipos de agentes participaron en la implementación. Para validarlo, utilizaron una batería de pruebas de compatibilidad con Git y pruebas de simulación deterministas. Sin embargo, OpenAI no afirmó que todo el código fuera escrito por IA.
Análisis del impacto de la programación con IA: el cuello de botella se desplaza más allá de la escritura de código
Impacto en desarrolladores y equipos
Lo más relevante de la historia de Pando no es que OpenAI haya desarrollado su propio backend de Git, sino la tendencia que revela: la programación con IA reduce el costo de generar código, y la presión se traslada a las etapas posteriores del proceso de ingeniería. Git es solo el primer punto donde se ha hecho visible; la revisión de código, las pruebas y la integración también están bajo presión.
En su artículo sobre Codex Code Review, OpenAI reconoce que cada vez hay más PR esperando revisión. A los revisores les cuesta comprender a tiempo las restricciones heredadas y evaluar los riesgos de compatibilidad de las API. Por eso, Codex Code Review puede leer las reglas de revisión definidas en AGENTS.md dentro del repositorio, para proteger los contratos existentes de las API, detectar registros que podrían filtrar datos de clientes y evitar que se rompan las integraciones con servicios existentes.
Para los equipos que desarrollan con IA, esto implica varios ajustes concretos:
- Documentar las reglas de revisión: plasmar las restricciones implícitas del equipo en archivos de reglas como AGENTS.md, para que la revisión con IA tenga criterios claros.
- Dejar margen en CI: cuando los agentes trabajan en paralelo, la cantidad de trabajos de CI puede crecer antes que los costos de personal. Conviene evaluar con antelación la caché y las cuotas de concurrencia.
- Replantear las métricas: no basta con contar commits o PR; también hay que prestar atención al tiempo de entrega y a la tasa de fallos de los cambios.
- Priorizar la capacidad de validación: la cobertura de pruebas, las pruebas con simulaciones y las pruebas de compatibilidad determinan si el código generado por los agentes puede integrarse con confianza.
Ejemplo mínimo de revisión de código con varios modelos de IA
Si quieres probar en tu propio repositorio un flujo de «revisión de diffs según reglas», puedes crear rápidamente un prototipo con una interfaz compatible con OpenAI. El siguiente ejemplo lee un diff local y le pide al modelo que lo revise según unas reglas:
import openai, subprocess

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
diff = subprocess.run(["git", "diff", "HEAD~1"], capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="YOUR_MODEL",  # Sustituye por un modelo de programación disponible en la plataforma
    messages=[{"role": "user", "content": f"请审查以下改动,重点关注 API 兼容性和日志泄露风险:\n{diff}"}],
)
print(resp.choices[0].message.content)
Ver el código completo (lectura de reglas de AGENTS.md + comparación de modelos)
import subprocess
from pathlib import Path
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Una clave para invocar modelos de varios proveedores
)

def load_rules(path: str = "AGENTS.md") -> str:
    """Lee las reglas de revisión del repositorio; si no existen, devuelve las reglas predeterminadas."""
    p = Path(path)
    if p.exists():
        return p.read_text(encoding="utf-8")
    return "1. 不得破坏已有 API 契约\n2. 日志中不得输出客户数据\n3. 不得破坏已有服务集成"

def get_diff(base: str = "HEAD~1") -> str:
    """Obtiene el diff que se va a revisar."""
    return subprocess.run(
        ["git", "diff", base], capture_output=True, text=True
    ).stdout

def review(diff: str, rules: str, model: str) -> str:
    """Invoca el modelo para revisar los cambios de código según las reglas."""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": f"你是严格的代码审查者,请依据以下仓库规则审查:\n{rules}"},
            {"role": "user", "content": f"待审查 Diff:\n{diff}\n请逐条列出风险点和修改建议。"},
        ],
        max_tokens=1500,
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    rules, diff = load_rules(), get_diff()
    # Sustituye por los nombres de los modelos que quieras comparar y observa las diferencias en sus revisiones
    for model in ["MODEL_A", "MODEL_B"]:
        print(f"===== {model} =====")
        print(review(diff, rules, model))
🚀 Consejo para empezar: al crear un prototipo de revisión con IA, puedes obtener crédito gratuito de prueba a través de APIYI apiyi.com. Con una misma clave API puedes invocar modelos como OpenAI, Claude y Gemini, y comparar la calidad de sus revisiones según las reglas de tu repositorio.
Impacto en el sector
En su cobertura, The New Stack señala que OpenAI fue una de las primeras empresas en usar agentes de programación de forma intensiva y que la presión que ha experimentado su infraestructura podría anticipar los problemas que enfrentarán otras grandes empresas y plataformas de alojamiento de código. Es una valoración de tendencias del medio, no una prueba de que GitHub o GitLab ya hayan sufrido los mismos fallos.
La comunidad de desarrolladores también está dividida. Los más optimistas creen que la reducción de los costos de programación hará viables muchos proyectos pequeños que antes no merecían la pena. Los más escépticos señalan que más commits no equivalen a un mayor valor del software: si la revisión y las pruebas no siguen el ritmo, la entrega no será necesariamente más rápida. Otros comentarios recuerdan que los problemas de escala de los grandes monorepos no son nuevos de la era de la IA.
Cómo interpretar los datos de Codex: cinco métricas que no hay que confundir
Al hablar de los resultados de la programación con IA, uno de los errores más habituales es mezclar métricas distintas. Esta tabla te ayuda a distinguir qué nos dice cada dato y qué no.
| Métrica | Qué mide | Situación en esta noticia |
|---|---|---|
| Número de commits | Frecuencia de las confirmaciones de cambios | Se prevé un crecimiento trimestral de +2,442%; solo se dispone del valor relativo |
| Número de PR | Actividad de propuestas y fusiones de cambios | Los PR semanales se han más que duplicado respecto al cuarto trimestre anterior |
| Líneas de código | Tamaño del código | No se ha publicado; no puede calcularse a partir del aumento de commits |
| Lead Time | Tiempo desde el inicio de un cambio hasta su entrega | No se ha publicado |
| Tasa de fallos de los cambios | Proporción de cambios que causan fallos tras su puesta en producción | No se ha publicado |
El caso de Pando demuestra que la carga de desarrollo de código de OpenAI creció de forma significativa y que su infraestructura Git existente llegó a un cuello de botella. No demuestra que la calidad del software o la productividad de los desarrolladores hayan aumentado en la misma proporción, ni permite calcular a cuántos ingenieros ha sustituido Codex.
Además, Harness Engineering, publicado por OpenAI en febrero de 2026, es otro experimento independiente: partiendo de un repositorio vacío, se completó en unos cinco meses un proyecto de alrededor de un millón de líneas de código, con unos 1,500 PR en total. Son datos de otro proyecto, sin relación con Pando, pero también reflejan una tendencia: el trabajo de los ingenieros se está desplazando hacia la arquitectura, la cadena de herramientas, los ciclos de retroalimentación y la aceptación del código.
💡 Recomendación: Si tu equipo también está incorporando agentes de programación, conviene empezar a pequeña escala y comparar cómo generan y revisan código distintos modelos. Con la interfaz unificada de APIYI apiyi.com puedes cambiar rápidamente de modelo y evaluarlos con los mismos casos de prueba antes de elegir el modelo principal.
Preguntas frecuentes FAQ
P1: ¿Codex realmente multiplicó por 24 la cantidad de código de OpenAI?
No exactamente. El dato oficial indica que «se prevé que el número de commits trimestrales fusionados en master aumente un 2442 % respecto al primer trimestre de 2024». Es una previsión que mide commits, no líneas de código. Un commit puede contener cambios grandes o pequeños, por lo que esta cifra no equivale ni a cantidad de código ni a productividad.
P2: ¿Pando es una alternativa a GitHub?
No. Pando es un backend de servidor compatible con el protocolo Git estándar que solo se utiliza internamente en OpenAI. Al 3 de noviembre de 2026, no se han publicado el servidor, sus precios ni una fecha de apertura. Lo que OpenAI ha publicado es un repositorio con una versión mejorada del cliente Git, y algunas modificaciones ya se han incorporado al proyecto original de Git. Eso no significa que el servidor de Pando sea de código abierto.
P3: ¿Los equipos normales necesitan reconstruir su infraestructura Git como OpenAI?
La mayoría no lo necesita. OpenAI trabaja con un repositorio monolítico de enorme tamaño y una alta concurrencia de agentes. Para los equipos pequeños y medianos, los cuellos de botella suelen estar en las cuotas de CI, la cobertura de pruebas y la disponibilidad de personas para revisar el código. Conviene priorizar esas áreas.
P4: ¿Cómo probar la revisión de código con IA o un flujo de trabajo con un agente de programación a bajo costo?
Puedes empezar con un prototipo mínimo que use una interfaz compatible con OpenAI. Siguiendo el ejemplo de código de este artículo, lee el Diff y el archivo de reglas y envíalos al modelo para su revisión. Al registrarte en APIYI apiyi.com, obtienes crédito gratuito para pruebas. Cambia el base_url a `https://api.apiyi.com/v1` y podrás comparar los resultados de revisión de varios modelos con la misma clave API.
P5: ¿La programación con IA solo está generando más código de baja calidad?
Ese es precisamente el centro del debate en la comunidad y, por ahora, no hay una conclusión definitiva. OpenAI no ha publicado datos sobre cambios en la tasa de defectos, la tasa de reversiones o el costo neto de desarrollo, por lo que no se puede afirmar que la calidad haya empeorado o mejorado en general. Una opción prudente es hacer seguimiento tanto del ciclo de entrega como de la tasa de fallos de los cambios en tu propio equipo. También puedes usar APIYI apiyi.com para acceder a varios modelos y realizar revisiones cruzadas, reduciendo el riesgo de que un solo modelo pase por alto algún problema.
Codex y los cambios en la infraestructura de Git: puntos clave
- La precisión importa: el 2442% es el crecimiento previsto de commits trimestrales para el cuarto trimestre de 2026, no de líneas de código.
- El crecimiento se acelera: la curva se vuelve más pronunciada después del cuarto trimestre de 2025, aunque ya crecía desde 2024.
- La presión viene de la concurrencia: Codex permite ejecutar más tareas en paralelo y el aumento de escrituras se multiplica en las lecturas de CI.
- El sistema anterior dejó de dar abasto: desde finales de 2025, Push y Fetch se volvieron más lentos y la fiabilidad cayó en ocasiones por debajo del 90%.
- La solución de Pando: escrituras independientes por rama, reutilización de Packfiles y caché redujeron la latencia mediana de Push cerca de un 80%.
- El cuello de botella se desplaza: la revisión de código, las pruebas, la integración y la entrega son las nuevas limitaciones.
- Para empezar: usa la interfaz unificada de APIYI apiyi.com para crear rápidamente un prototipo de revisión con varios modelos.
Resumen
Los cambios que Codex ha traído a OpenAI se pueden resumir en tres puntos:
- Escala: se prevé que los commits trimestrales del monorepositorio crezcan un 2442% respecto al primer trimestre de 2024. El número de PR también se está duplicando, lo que amplifica considerablemente la actividad de cambios en el código.
- Infraestructura: los agentes en paralelo generan más ramas, operaciones Push y lecturas de CI. El backend de Git anterior presentó problemas de rendimiento y fiabilidad, y OpenAI creó Pando en unas 10 semanas para hacerles frente.
- Flujo de ingeniería: escribir código ya no es la etapa más lenta; la capacidad de revisión, pruebas y entrega determina si la programación con IA puede generar valor real.
Para la mayoría de los equipos, en lugar de perseguir un mayor número de commits, conviene reforzar primero la capacidad de aceptación y revisión, y después ampliar gradualmente la cantidad de agentes que trabajan en paralelo. Si quieres validar rápidamente un flujo de revisión con IA o de agentes de programación, puedes usar la cuota gratuita de APIYI apiyi.com para comparar el rendimiento real de varios modelos.
📚 Referencias
- Scaling Git at OpenAI: artículo técnico oficial de OpenAI sobre Pando (2026-11-02)
- Enlace:
openai.com/index/scaling-git-at-openai -
Descripción: fuente principal de los hechos y los datos de crecimiento trimestral de commits del artículo
-
Custom Code Review rules for Codex: blog para desarrolladores de OpenAI (2026-07-20)
- Enlace:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Descripción: fuente de los datos sobre la duplicación de PR semanales y las reglas de revisión de AGENTS.md
-
Harness engineering: experimento independiente de OpenAI sobre desarrollo con agentes (2026-02-11)
- Enlace:
openai.com/index/harness-engineering -
Descripción: caso independiente para entender cómo cambia el papel de los ingenieros; no está relacionado con el proyecto Pando
-
OpenAI Git Fork: repositorio público del cliente Git que mantiene OpenAI
- Enlace:
github.com/openai/git -
Descripción: consulta las mejoras del cliente, como packfile-uri
-
Cobertura de The New Stack: análisis de Pando por un medio externo (2026-11-02)
- Enlace:
thenewstack.io - Descripción: referencia para evaluar las tendencias del sector
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página de inicio del sitio oficial de APIYI. Para más información sobre la integración de modelos, visita el centro de documentación en docs.apiyi.com