Nota del autor: A partir del diseño del superagente de DeepSeek, analizamos cómo se asignan los modelos al router y a los workers en un sistema multiagente, y cómo afectan los tokens de lectura de caché al costo de la arquitectura.
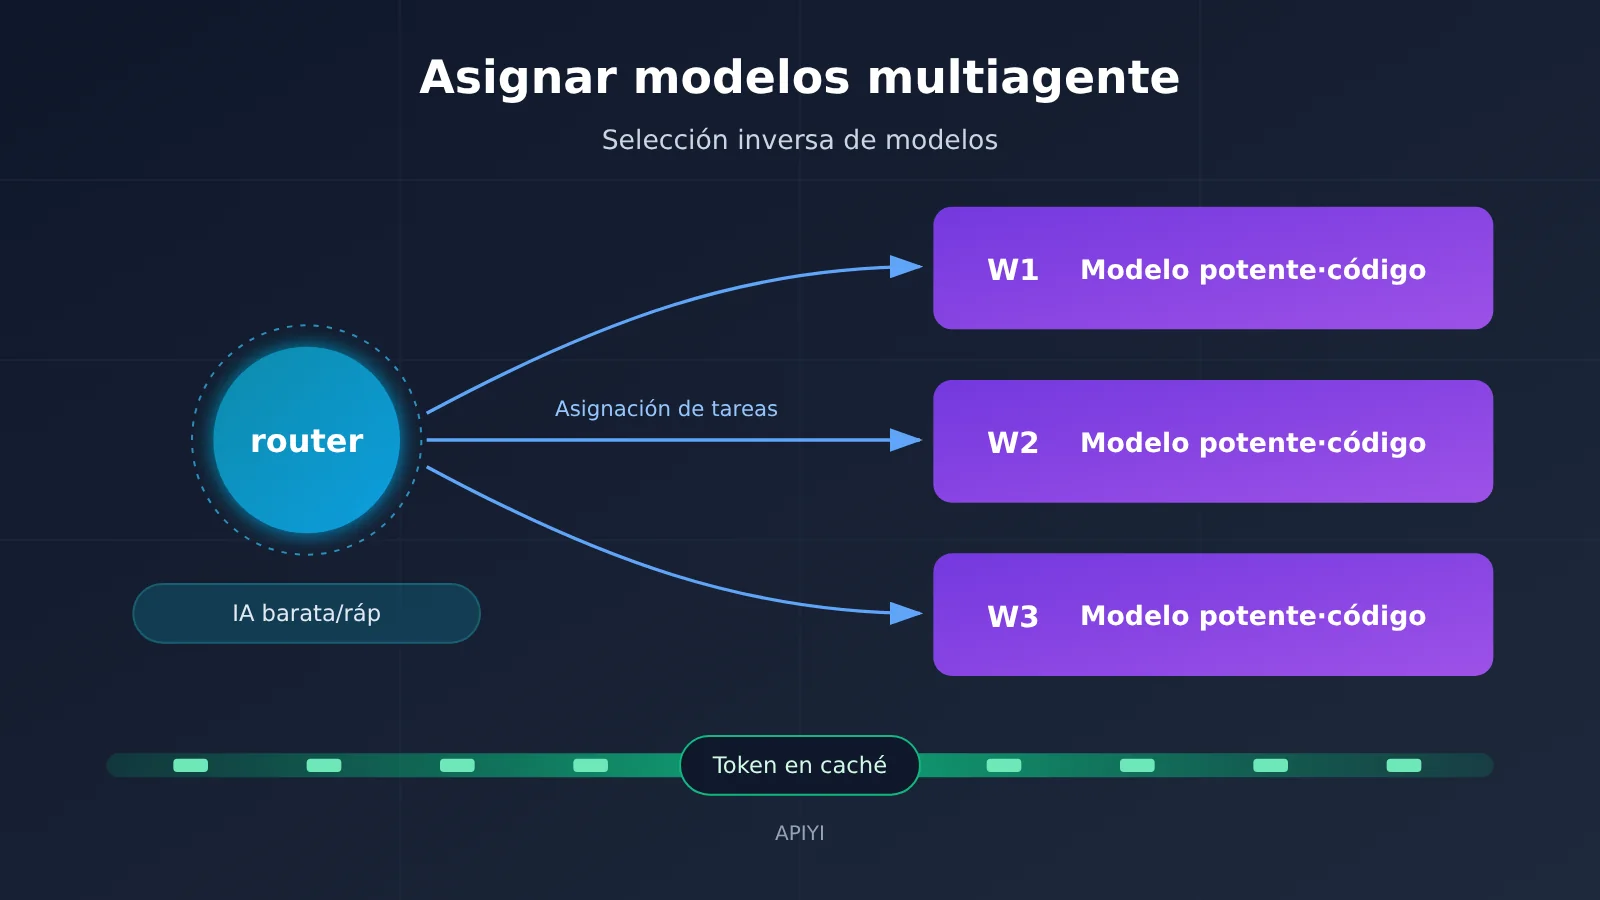
Al construir un sistema de programación multiagente, la mayoría asigna el modelo más potente al «jefe» y deja modelos más baratos para quienes ejecutan las tareas. El diseño de superagente que el equipo de DeepSeek Harness presentó en noviembre de 2026 propone lo contrario: un modelo económico para el router y uno potente para los workers. El router, que conversa y reparte tareas, usa un modelo ligero; los workers, que escriben el código, usan el modelo más potente.
Este artículo no se limita a contar la noticia. Traducimos esta arquitectura en criterios prácticos para elegir modelos: qué capacidades necesita el router, cuáles necesitan los workers, cómo estimar los tokens de lectura de caché y cuándo conviene elegir un modelo económico. Los datos de pruebas que citamos son, según la propia DeepSeek, resultados «indicativos»; también aclararemos sus límites.
Qué te llevarás: al terminar, podrás crear un plan para asignar modelos por función en tu propio sistema multiagente y estimar su orden de magnitud en costos a partir del volumen de lecturas de caché.
Puntos clave para asignar modelos en un sistema multiagente
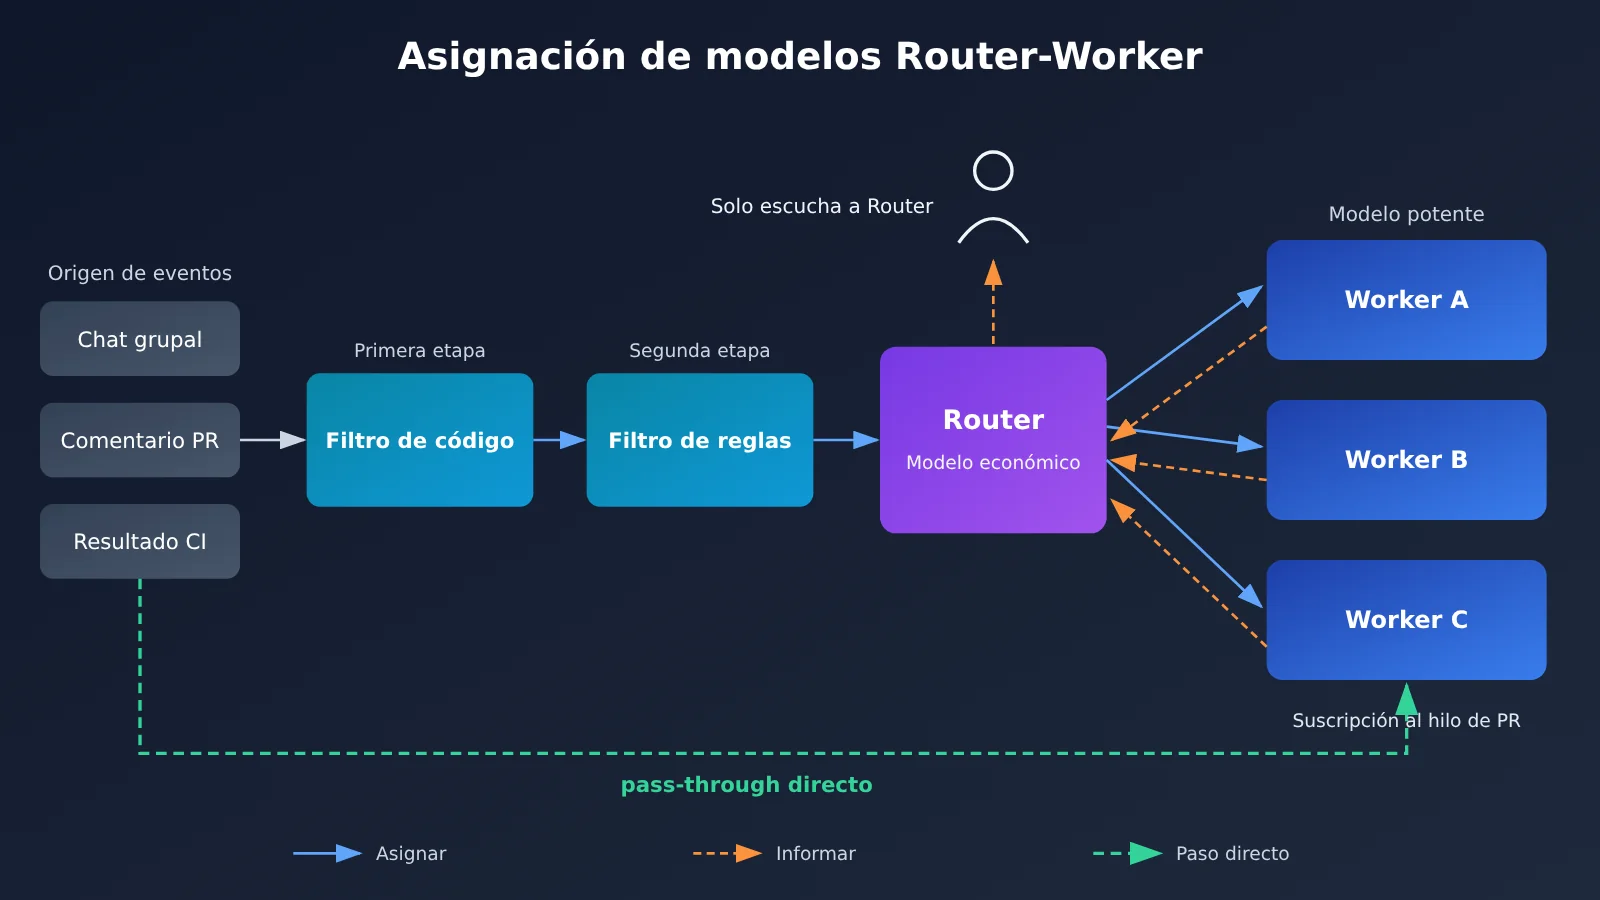
El diseño de DeepSeek tiene dos capas. El router es una sesión persistente que se comunica con las personas, asigna tareas y hace seguimiento de las relaciones entre ellas. Cada worker recibe una sola tarea, trabaja con un contexto limpio e independiente y nunca conversa directamente con las personas: solo informa al router sobre su estado. Con esta división de responsabilidades, la siguiente tabla sirve como punto de partida para asignar los modelos.
| Rol | Responsabilidad principal | ¿Escribe código? | Modelo recomendado | Motivo |
|---|---|---|---|---|
| router | Conversar, asignar tareas y seguir sus relaciones | No; puede funcionar sin acceso al shell | Ligero, económico y rápido | Su trabajo es sencillo, pero se invoca con frecuencia, por lo que la latencia y el costo por llamada importan más |
| worker | Recibir una tarea y completarla mediante código | Sí | El modelo de programación más potente disponible | La calidad del código determina directamente el resultado de la entrega |
| capa de filtrado de eventos | Filtrar el ruido de los chats grupales y las notificaciones de CI | No | Primero, código convencional; después, un modelo pequeño | La mayoría de los eventos no necesitan llegar al modelo |
Por qué conviene «invertir» la asignación de modelos en un sistema multiagente
DeepSeek considera que el cuello de botella de la programación asistida por IA ya no es la capacidad del modelo, sino la atención humana. Una persona normalmente solo puede seguir de 3 a 5 sesiones de agentes activas a la vez. Con más, resulta difícil saber cuál espera aprobación, cuál está bloqueada o cuáles dos están modificando discretamente el mismo PR. Por eso, el valor del router no está en ser «inteligente», sino en asignar tareas y llevar el registro de forma estable. No descompone las tareas: solo las asigna y les da seguimiento. Esto lo distingue del patrón habitual en el que un «agente principal» divide una tarea en pasos.
Como el router no necesita razonamiento profundo ni escribe código, usar ahí el modelo más caro sería un desperdicio. Es el worker quien produce el código, y su calidad determina el éxito de la entrega. Por eso, el presupuesto para los modelos más potentes debe destinarse a los workers. Esa es la «inversión en la selección de modelos»: cuanto más cerca está un rol del usuario, más ligero es el modelo; cuanto más cerca está del código, más potente.
Qué capacidades necesitan router y worker
Para elegir modelos concretos, primero hay que desglosar las responsabilidades de cada rol en capacidades. Esta lista sirve para evaluar directamente los modelos candidatos.
| Capacidad | Requisitos del router | Requisitos del worker | Consejo para elegir |
|---|---|---|---|
| Seguimiento de instrucciones y clasificación | Alto: debe identificar de forma fiable a quién corresponde cada tarea | Medio | Para el router, prioriza la precisión de la asignación |
| Contexto largo y consulta de información previa | Medio: amplía la información progresivamente mediante ID y resúmenes | Alto: necesita leer mucho código | Para el worker, revisa la ventana de contexto y la capacidad de búsqueda de código |
| Calidad de generación de código | No es necesaria | Máxima prioridad | No escatimes en el presupuesto del worker |
| Latencia de respuesta | Alta prioridad: toma decisiones con frecuencia | Media: puede tardar algo más en cada tarea | Elige para el router un modelo rápido de tipo Flash |
| Sensibilidad al precio unitario | Muy alta: el volumen de lecturas de caché es enorme | Media | El precio unitario del router influye en el costo total |
| Llamadas a herramientas | Pocas: puede funcionar sin acceso a shell | Muchas: necesita ejecutar código y hacer pruebas | Delimita los permisos de cada rol |
Hay otro requisito del router que es fácil pasar por alto: su configuración debe impedir que «se ponga manos a la obra». DeepSeek dejó al router sin permisos de shell precisamente para evitar que trabaje directamente en las tareas. Por eso, al elegir su modelo, no hace falta buscar uno que «sepa hacer de todo»; más bien hay que aceptar que «solo sepa repartir tareas».
Coste de los tokens de lectura de caché en la asignación de modelos multiagente
No basta con que el router sea barato: el verdadero coste de esta arquitectura está en los tokens de lectura de caché. El router mantiene una sesión de larga duración y lee repetidamente el contexto almacenado en caché; además, varios workers funcionan en paralelo y cada uno lee una gran cantidad de contexto. Los datos de las pruebas de DeepSeek muestran el problema con claridad.
| Métrica de la prueba | Valor | Explicación |
|---|---|---|
| Mensajes por ronda | Aproximadamente 300 | Unos 20 son solicitudes de trabajo reales |
| Tiempo medio de finalización del superagente | 12,4 minutos | El caso más lento tardó 15,7 minutos |
| Tiempo de referencia de una sola sesión en el caso más lento | 29,5 minutos | Se utiliza como comparación |
| Carga de decisiones del router | De aproximadamente 1 a 40 por minuto | El tiempo por decisión bajó de 6,4 a 1,6 segundos |
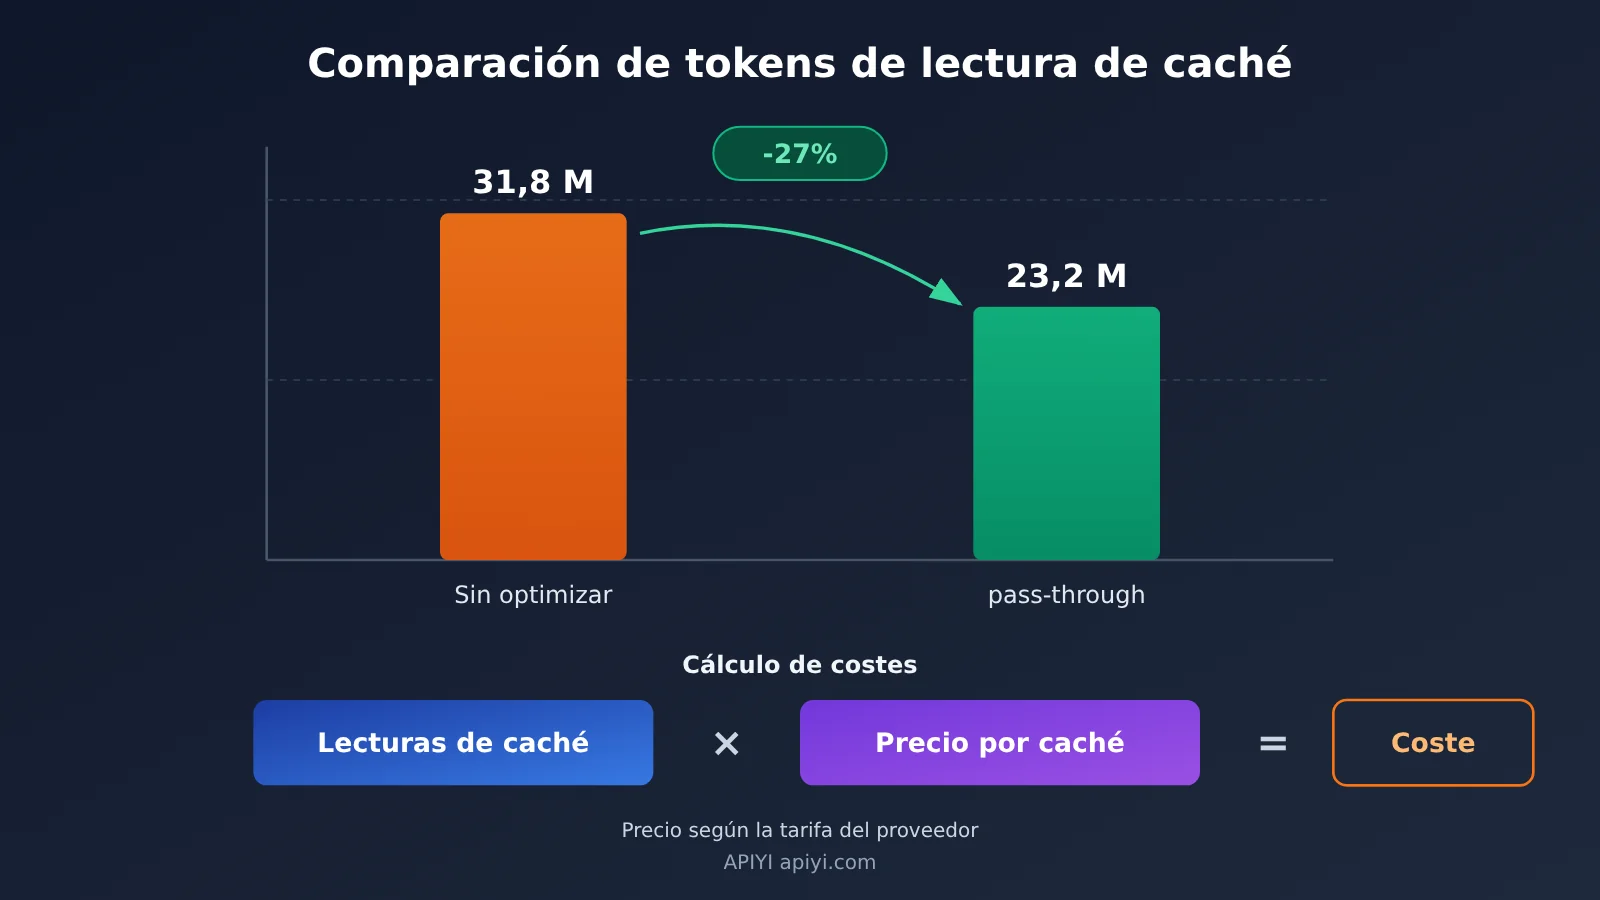
| Tokens de lectura de caché | 23,2 millones | Con la optimización pass-through activada |
| Lecturas de caché sin optimización | 31,8 millones | Cuando los workers no se suscriben directamente al hilo |
| Coste de caché | Aproximadamente 7 dólares | Según la tarifa Flash de DeepSeek en horas de baja demanda |
Cómo estimar el coste de asignación de modelos multiagente según las lecturas de caché
Para hacer la estimación, puedes dividir el coste de una ejecución en tres partes: los tokens de lectura de caché multiplicados por su precio unitario, más los tokens de entrada que no se encontraron en caché multiplicados por el precio de entrada, más los tokens de salida multiplicados por el precio de salida. En una arquitectura router-worker, el primer componente suele representar la mayor parte del coste, así que el precio de lectura de caché es el que más conviene vigilar al elegir un modelo.
Si calculamos a partir de las cifras publicadas, unos 7 dólares por 23,2 millones de tokens de lectura de caché equivalen a aproximadamente 0,3 dólares por millón de tokens. Es una aproximación derivada de los datos publicados, no una tarifa oficial; para conocer el precio real, consulta la lista vigente del proveedor del modelo. Con esta referencia, puedes sustituir el precio de lectura de caché de cada modelo candidato y ver rápidamente cuánto se multiplicaría el coste de la misma carga de trabajo con un modelo más caro.
La optimización pass-through también merece atención. Cuando los workers se suscriben al hilo, los nuevos eventos les llegan directamente, sin que el router tenga que retransmitirlos. Así, las lecturas de caché bajaron de 31,8 a 23,2 millones de tokens, una reducción aproximada del 27%. En otras palabras, optimizar la arquitectura puede reducir la factura directamente, igual que cambiar a un modelo más barato.
Tres límites de los datos originales que conviene tener en cuenta
- La fase de programación está simulada: en la prueba, «escribir código» se sustituyó por una herramienta que solo consume tiempo. Se evalúa el comportamiento de la planificación, no la calidad del código, por lo que no sirve para demostrar qué modelo ofrece los mejores resultados como worker.
- Los datos son solo orientativos: DeepSeek aclara que estas cifras son indicativas, no una prueba de referencia rigurosa.
- La comparación de precios con la categoría Sonnet es inconsistente: el resumen del artículo menciona una estimación de unos 4,64 dólares según la tarifa de Sonnet, pero el cuerpo afirma que el mismo uso sería «claramente más caro» en una categoría de precio superior. Las dos afirmaciones se contradicen. No se recomienda citar esta comparación concreta antes de verificarla en el artículo original de DeepSeek.
Guía rápida para asignar modelos en un sistema multiagente
Para llevar la lógica anterior a tu propio sistema, puedes seguir estos pasos. Aquí no incluimos código: todas las opciones de configuración se explican en línea para que puedas adaptarlas a tu framework.
- Primero define los roles y después elige los modelos: enumera todos los roles del sistema que invocan modelos. Distingue al menos entre router, worker y filtro de activación, e indica para cada uno si escribe código y si necesita herramientas.
- Haz que los nombres de los modelos sean configurables: establece parámetros independientes para cada rol, como
router_model,worker_modelyfilter_model. No fijes los nombres de los modelos en el código de negocio. - Garantiza la delegación mediante la estructura: elimina del router las herramientas de ejecución, como shell. El experimento de DeepSeek mostró que un agente de sesión única no delegó en ninguna de las 5 ejecuciones con una indicación neutral; la más lenta tardó casi media hora. Incluso cuando la indicación exigía delegar explícitamente, en 1 de las 5 ejecuciones el agente consideró que la tarea era demasiado pequeña y la hizo por su cuenta.
- Filtra primero: usa código convencional para descartar el ruido de los eventos de activación según su origen y una lista de permitidos. Entrega al modelo solo los eventos restantes para que los evalúe según las reglas del equipo.
- Registra los tokens leídos de la caché: en cada ejecución, registra tres categorías de tokens: lecturas de caché, entrada no almacenada en caché y salida. Usa la fórmula anterior para calcular el costo de cada ejecución.
- Compara distintos modelos: mantén el mismo conjunto de tareas y cambia solo
router_model. Observa cómo varían la precisión de la asignación, la latencia y el costo antes de decidir si conviene pasar a un modelo de gama inferior.
En los pasos 2 y 6, la forma de integración afecta directamente la eficiencia de las pruebas. Si el router y el worker son de distintos proveedores y mantienes claves y configuraciones de SDK por separado, cada cambio obliga a modificar varios puntos. Con una plataforma de interfaz unificada como APIYI apiyi.com, puedes usar la misma clave API y el mismo formato de solicitud compatible con OpenAI. Basta con cambiar el parámetro model para asignar modelos de distintos proveedores al router y al worker, lo que reduce considerablemente el costo de las pruebas comparativas.
🚀 Recomendación para empezar: al validar el prototipo, configura en APIYI apiyi.com los parámetros de modelo del router y del worker con la misma clave. Ejecuta el mismo conjunto de tareas y registra el consumo de tokens. Consulta la lista actual de la plataforma para saber qué modelos están disponibles, por ejemplo, los modelos de la gama Flash de DeepSeek.
Cuándo elegir modelos económicos para los roles de un sistema multiagente
Los modelos económicos no sirven para todo. Esta tabla reúne algunos criterios para decidir si conviene usar un modelo más barato para cada rol.
| Características del escenario | Recomendación | Motivo | Vía de acceso |
|---|---|---|---|
| El rol solo asigna tareas, hace seguimiento y comprueba el contexto en caché | Elegir un modelo rápido y económico | La tarea es sencilla; el precio unitario y la latencia son los factores principales | APIYI apiyi.com o la API oficial del proveedor |
| El rol genera y modifica código | Elegir un modelo potente | La calidad del código determina el resultado entregado | APIYI apiyi.com o la API oficial del proveedor |
| La lectura de caché alcanza decenas de millones y se repite a diario | Priorizar un menor precio unitario de lectura de caché | El costo de la caché crece de forma lineal con el número de ejecuciones | Calcular según la lista de precios del proveedor |
| Tareas puntuales y ligeras | Usar pago por consumo | El volumen es pequeño y no compensa añadir complejidad a la arquitectura | Cualquier canal de pago por consumo |
| Tareas automatizadas frecuentes y con uso intensivo de tokens | Evaluar planes mensuales o con límites elevados | El costo marginal de cada ejecución deja de reflejarse en la factura | Según las condiciones de cada suscripción |
Para la última fila hay una referencia: según una noticia publicada en ese mismo periodo, Claude Code Pass costaba 9,99 dólares al mes y ofrecía límites de tasa entre 2 y 5 veces mayores para modelos abiertos como Kimi K3.1 Pro, GLM 5.3 y DeepSeek V4.1 Flash, con tres límites de uso: cada 5 horas, semanal y mensual. La noticia también señalaba que, para etapas que solo toman decisiones de enrutamiento o comprueban el contexto en caché, los modelos rápidos y económicos son más adecuados desde el punto de vista técnico, no solo más baratos. Eso sí, estos planes te limitan a los modelos incluidos: si un worker depende de un modelo que queda fuera del plan, seguirá necesitando otra vía de acceso.
Riesgos y límites de la asignación de modelos en sistemas multiagente
La asignación de modelos resuelve problemas de costos y reparto de tareas, pero no los desafíos pendientes de la propia arquitectura. DeepSeek reconoce dos problemas sin resolver. El primero es la memoria a largo plazo: después de varios meses de funcionamiento, sigue siendo difícil conservar el historial relevante sin desbordar la ventana de contexto. El segundo es la inyección de indicaciones: cualquier agente que lea eventos externos, como mensajes de chats grupales o comentarios en PR, puede ser manipulado. Además, el router y los workers están conectados mediante un bucle compartido en la nube, por lo que una fuente de eventos comprometida podría, en teoría, propagar instrucciones a todas las máquinas con las que interactúa el sistema.
Esto afecta directamente a la asignación de modelos. Que el router use un modelo barato no significa que se pueda reducir su protección, ya que precisamente es el primero en entrar en contacto con eventos externos. En el despliegue interno de DeepSeek, las acciones proactivas se ejecutan primero en un modo de registro que indica «esto es lo que habría hecho», en lugar de llevarlas a cabo de inmediato. Por ejemplo, con la estrategia de «reproducir y corregir en silencio», cuando alguien reporta un bug, el agente intenta reproducirlo en segundo plano. Solo si lo confirma y lo corrige, presenta un PR mientras la conversación sigue en curso; si no consigue reproducirlo, no envía nada. Al poner en marcha un sistema nuevo, es más prudente observar primero los registros y ampliar sus permisos de forma gradual.
Además, el prototipo DSH Super Agent está identificado claramente en GitHub como código de investigación, no como un producto final. Se pueden tomar sus ideas de diseño como referencia, pero no se recomienda desplegarlo directamente en producción.
Preguntas frecuentes FAQ
Q1: ¿Qué es la «inversión en la selección de modelos» en un sistema multiagente?
Consiste en usar un modelo ligero y económico para el router y el modelo más potente para el worker. El router solo se encarga de conversar, asignar y dar seguimiento a las tareas; no escribe código. El worker se encarga de programar, así que el presupuesto para el modelo potente debe destinarse al worker, no al «coordinador».
Q2: ¿En qué se diferencia la arquitectura router-worker del patrón en el que un agente principal descompone las tareas?
En el patrón de agente principal, este debe descomponer la tarea en pasos, lo que exige mayor capacidad de razonamiento. El router de DeepSeek no descompone las tareas: solo las asigna y les da seguimiento, por lo que puede usar un modelo más ligero. A cambio, el worker debe ser capaz de completar toda la tarea de forma independiente.
Q3: ¿Cuándo se hizo público este diseño? ¿Se puede usar DSH Super Agent directamente?
La información relacionada se publicó el 3 de noviembre de 2026. DSH Super Agent es un prototipo de investigación publicado en GitHub junto con el artículo sobre el diseño. Sus responsables aclaran que no es un producto con soporte oficial y que solo sirve para entender la arquitectura.
Q4: ¿Es viable enseñar a un solo agente a delegar usando únicamente indicaciones?
Las pruebas de DeepSeek muestran que no es fiable: con una indicación neutral no hubo ninguna delegación en cinco ejecuciones, y con una indicación que enfatizaba la delegación también hubo una ejecución sin delegaciones. Para delegar de forma fiable hace falta una separación estructural, por ejemplo, dividir las sesiones y retirar las herramientas de ejecución, en lugar de escribir indicaciones más largas.
Q5: ¿Cómo se pueden configurar fácilmente modelos de distintos proveedores para el router y el worker dentro de un mismo sistema?
La clave es configurar el nombre del modelo por separado para cada rol y unificar la forma de acceso:
1. Regístrate en APIYI apiyi.com y obtén una clave API
2. Configura por separado el parámetro `model` del router y del worker en el sistema
3. Mantén el formato de las solicitudes sin cambios y sustituye solo el nombre del modelo para hacer pruebas comparativas
Así no necesitas mantener una configuración de SDK distinta para cada proveedor. Consulta la lista actual de la plataforma para conocer los modelos disponibles.
Q6: ¿Se pueden usar directamente los datos de costos del artículo original para elaborar un presupuesto?
No es recomendable aplicarlos directamente. La fase de programación es simulada, los datos son solo orientativos y las comparaciones de precio con modelos de la categoría de Sonnet presentan inconsistencias. Es mejor medir las lecturas de caché con tu propio conjunto de tareas y multiplicar el resultado por el precio unitario vigente. En APIYI apiyi.com puedes mantener las tareas sin cambios y ejecutar una ronda con cada modelo para obtener datos adaptados a tu caso.
Q7: ¿Qué limitaciones conocidas tiene esta arquitectura?
Hay tres principales: el deterioro de la memoria tras un funcionamiento prolongado; el riesgo de inyección de indicaciones al leer eventos externos; y el gran volumen de tokens leídos de la caché, que puede aumentar considerablemente los costos al usar modelos caros. Además, por ahora faltan datos sobre los resultados obtenidos con modelos concretos para el router, por lo que es necesario hacer pruebas propias.
Claves de la asignación de modelos en sistemas multiagente
- Invertir la elección de modelos: usar un modelo ligero y económico para el router, y modelos potentes para los workers que escriben código.
- El cuello de botella es la atención: una persona normalmente solo puede supervisar entre 3 y 5 sesiones; el router se encarga de centralizar la comunicación.
- La delegación depende de la estructura: quitarle al router las herramientas de ejecución es mucho más fiable que modificar la indicación.
- La caché concentra gran parte del costo: en una ronda de pruebas se leyeron 23,2 millones de tokens de caché, por lo que el precio unitario es clave.
- La arquitectura también permite ahorrar: el paso directo (pass-through) redujo las lecturas de caché aproximadamente un 27 %.
- Conviene citar los datos con cautela: la codificación fue simulada, los resultados son solo orientativos y los precios deben verificarse.
- Usar una interfaz unificada para experimentar: en APIYI apiyi.com basta con cambiar el parámetro
modelpara comparar distintas asignaciones.
Resumen
La idea central de esta asignación de modelos multiagente es usar un modelo económico para el router y modelos potentes para los workers:
- Elegir según la función: usar modelos rápidos y económicos para los roles que solo asignan y supervisan tareas, y modelos potentes para los que escriben código.
- Calcular los costos de caché: los tokens de lectura de caché son el principal gasto de esta arquitectura, así que conviene comparar primero su precio unitario.
- Decidir con pruebas propias: los datos del texto original solo sirven como orientación; la decisión final debe basarse en el costo y los resultados obtenidos con tus propias tareas.
Una buena forma de empezar es crear un prototipo router-worker con un conjunto pequeño de tareas y configurar el nombre del modelo como un parámetro para cada rol. Después, puedes ir cambiando el modelo del router y observar cómo varían la precisión de las asignaciones y el costo. Para hacer la comparación, puedes usar APIYI apiyi.com y acceder a modelos de distintos proveedores con una sola clave, de modo que la elección se base en tus propios datos.
📚 Referencias
- DeepSeek’s Super Agent Harness: Fixing the Attention Bottleneck in AI Coding: análisis del diseño del superagente de DeepSeek
- Enlace:
mindstudio.ai/blog/deepseek-super-agent-harness-design -
Descripción: incluye la arquitectura router-worker, experimentos de delegación, datos de tokens en caché y problemas aún sin resolver
-
Claude Code Pass Pricing: What’s in the $9.99/Month Plan: análisis del plan mensual con límites elevados
- Enlace:
mindstudio.ai/blog/claude-code-pass-pricing - Descripción: analiza las ventajas y desventajas de la facturación por uso y los planes mensuales para flujos de trabajo con múltiples agentes y un uso intensivo de tokens
Autor: Equipo técnico de APIYI
Intercambio técnico: Contáctanos desde la página principal de APIYI, apiyi.com, para hablar sobre la asignación de modelos entre múltiples agentes. Para más información sobre la integración, visita el centro de documentación en docs.apiyi.com