Nota del autor: en la primera evaluación de GDPx, ningún modelo superó por completo las tareas de finanzas y derecho bajo un criterio estricto de aprobación binaria. Este artículo examina los errores concretos de dos casos públicos y explica por qué «saber hacer cuentas y redactar contratos» no equivale a «poder entregar un resultado que cumpla los requisitos».
El 2 de noviembre de 2026, SemiAnalysis publicó GDPx v1.0, un benchmark de tareas profesionales de alta dificultad. De los 11 ámbitos evaluados, en finanzas y derecho, ninguno de los modelos probados superó por completo las tareas según el criterio binario de aprobación establecido inicialmente. El equipo de investigación tuvo que recurrir a la «puntuación parcial promedio» para mostrar las diferencias entre los modelos.
Esto no es una conclusión impulsiva de que «la IA no sirve». Algunos modelos obtuvieron una puntuación parcial promedio del 44% en el caso jurídico y acertaron aproximadamente la mitad de las comprobaciones de aceptación en el caso financiero. La pregunta que importa es: ¿por qué acertar la mitad no basta para entregar el trabajo?
Qué aprenderás: al terminar este artículo, conocerás los importes clave, el número de fallos y los criterios de puntuación de la tarea financiera Bellwood-QoE y de la tarea de modificación de estatutos para una ronda de financiación serie B. También podrás distinguir mejor entre la capacidad de la IA para asistir y su capacidad para entregar resultados de forma independiente y asumir la responsabilidad por ellos.
Ninguna tarea de finanzas o derecho superó la evaluación: GDPx de un vistazo
La primera edición de GDPx abarca 11 áreas profesionales y 206 tareas, con un límite predeterminado de 8 horas por tarea. Evalúa el rendimiento conjunto del «modelo + framework de agente + herramientas + entorno de trabajo». Incluso Claude Opus 5.5, primero en la clasificación general, obtuvo solo un 12,0 %. En ese contexto, los resultados de finanzas y derecho destacan especialmente.
| Indicador | Finanzas | Derecho |
|---|---|---|
| Número de tareas | 24 | 20 |
| Socio especializado | Living Context | Chakra |
| Caso público | Bellwood-QoE (libro de análisis de calidad de beneficios) | quillon-series-b-redline (revisión de estatutos para una ronda Serie B) |
| Ejecuciones del caso público | 25 ejecuciones seleccionadas | 20 ejecuciones entre 4 modelos |
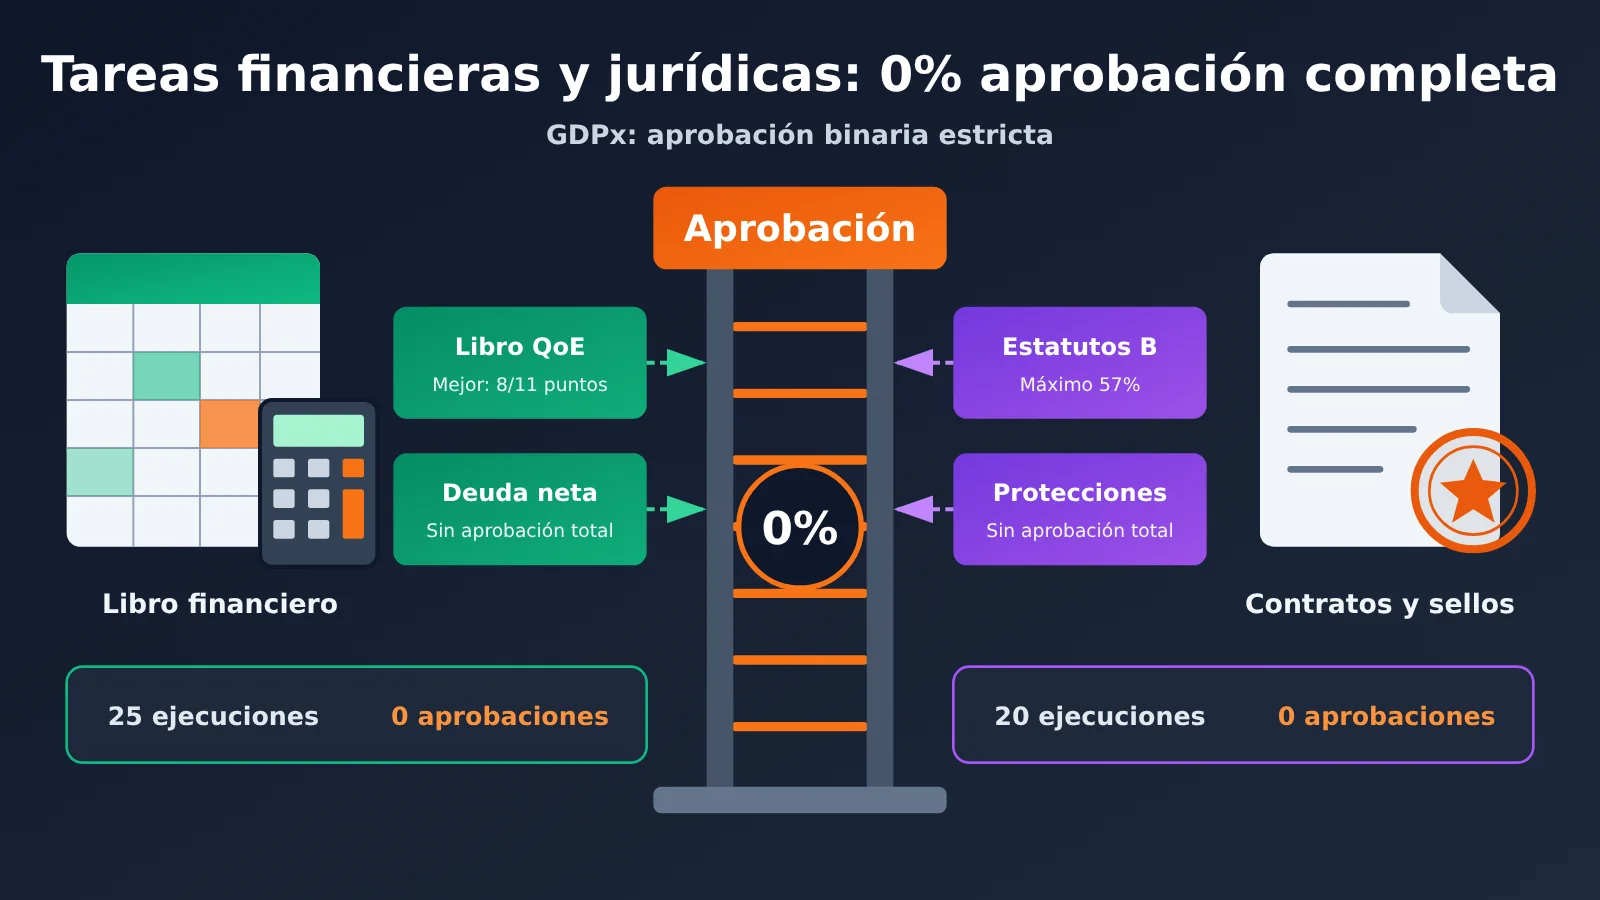
| Ejecuciones que cumplieron todos los requisitos | 0 | 0 |
| Puntuación binaria estricta | 0 % | 0 % |
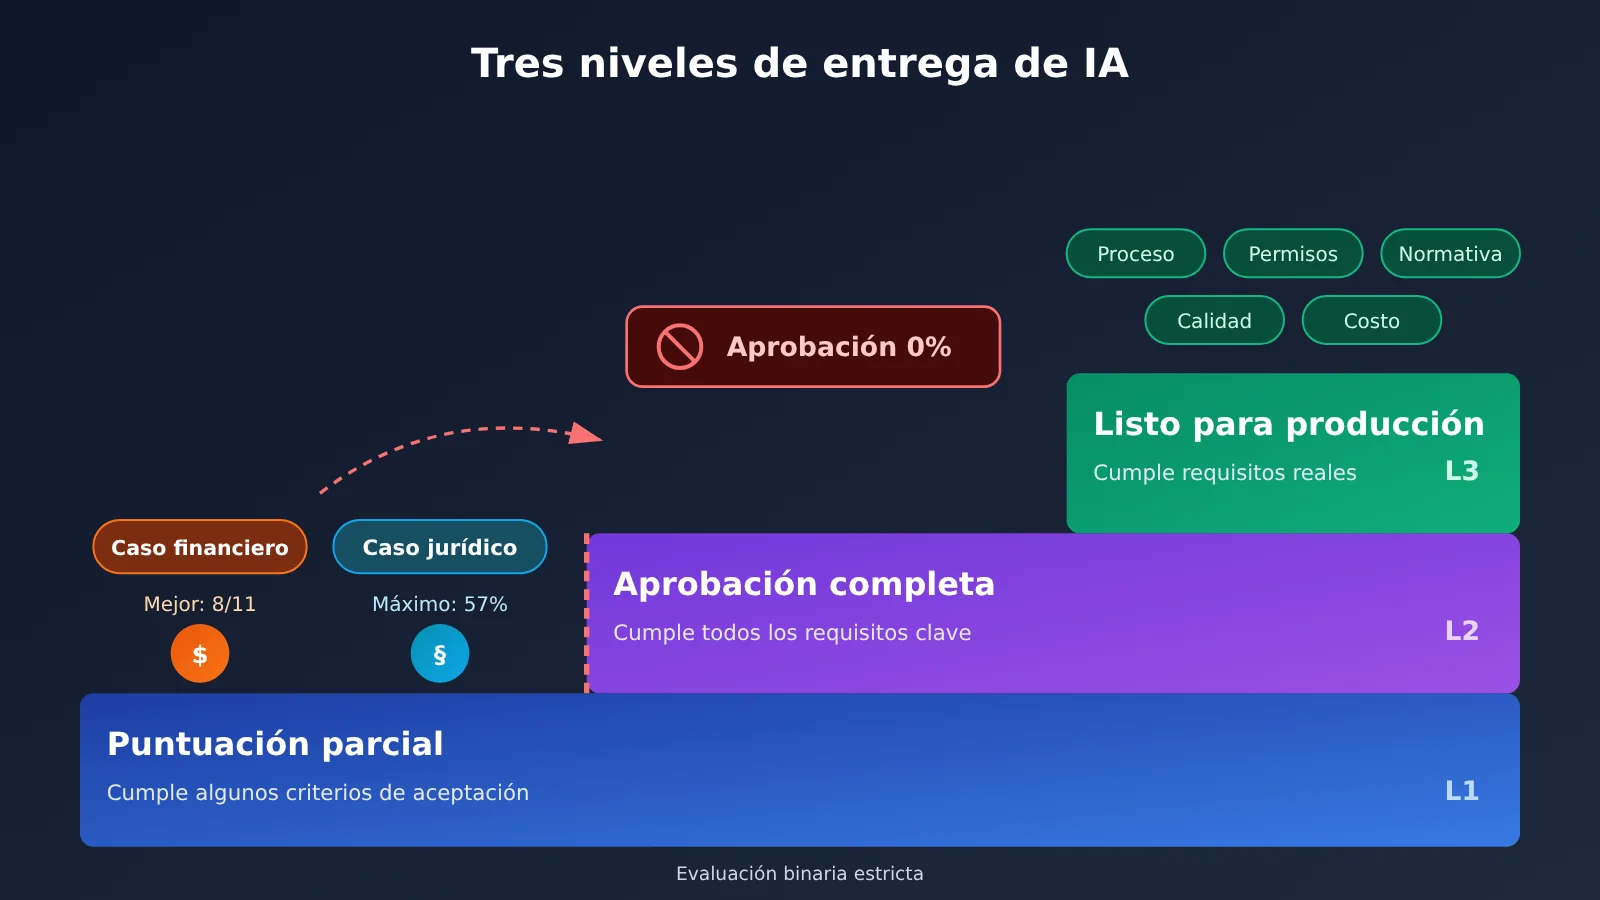
| Puntuación parcial | La mejor ejecución superó 8 de 11 comprobaciones | 18 % de media; la mejor ejecución alcanzó el 57 % |
Al leer esta tabla conviene tener en cuenta dos cosas. Primero, una puntuación binaria del 0 % no significa que todos los resultados carezcan de valor: las puntuaciones parciales no fueron cero. Segundo, las 25 y 20 ejecuciones de la tabla corresponden a las pruebas de un solo caso público en cada área. No significa que las 24 tareas de finanzas o las 20 de derecho se ejecutaran solo ese número de veces en total.
Por qué las tareas de finanzas y derecho tienen criterios de aceptación estrictos
En ambas áreas, los entregables son «documentos que pueden incorporarse directamente al proceso de una operación real», no simples recomendaciones. En una due diligence de fusiones y adquisiciones o en una negociación de financiación, un error en el cálculo de la deuda neta o una cláusula de protección que pueda eludirse pueden hacer que todo el documento deje de ser útil. Por eso GDPx aplica criterios de aceptación estrictos, cercanos a los de un entregable profesional. Esa es también la razón directa del 0 %.
Caso práctico de finanzas: cómo Bellwood-QoE consigue que la IA acierte los cálculos, pero no entregue un resultado aceptable
Contexto de la operación y requisitos de la tarea
Living Context transforma experiencias de operaciones reales en entornos de prueba anonimizados. En este caso, el fondo de capital privado Bannock Capital adquirió alrededor del 62 % de Haverly Snack Company por unos 880 millones de dólares, además de un acuerdo de contraprestación contingente. El entorno completo contiene unos 4000 documentos anonimizados, que incluyen el libro mayor, extractos bancarios, registros de nómina, antigüedad de cuentas por cobrar, correspondencia contractual, acuerdos de la operación, hojas de ajustes históricos y documentación de trabajo de varios asesores.
El modelo debe hacerse cargo de un libro de trabajo de análisis de calidad de los beneficios (QoE) que está incompleto. Tiene que identificar qué datos existentes son correctos, corregir las cifras y clasificaciones erróneas y conservar tanto las entradas correctas como la estructura de los cálculos. Además, debe revisar los ajustes del EBITDA, conciliar el capital de trabajo de 12 meses, aplicar el criterio de deuda neta, aportar evidencia documental para cada ajuste y garantizar que las referencias entre hojas sean coherentes. El entregable es el propio libro de trabajo revisado.
Resultados de las pruebas de Bellwood-QoE
| Modelo | Promedio de comprobaciones de aceptación superadas, de 11 | ¿Superó todas? |
|---|---|---|
| GPT-6.1 Sol | 5,6 | No |
| Claude Opus 5.5 | 5,4 | No |
| GPT-6 Astra | 5,4 | No |
| GLM 5.3 | Menos de 2 | No |
| Grok 4.7 | Menos de 2 | No |
| Mejor ejecución individual | 8 | No |
Los modelos más capaces superaron, en promedio, alrededor de la mitad de las comprobaciones. La mejor ejecución superó 8. Pero si entre las comprobaciones restantes hay errores financieros importantes, el libro de trabajo completo no se puede entregar. Los tres tipos de errores que siguen muestran dónde está el problema.
Error financiero uno: una interpretación excesiva de un ajuste de 418 dólares
Algunos modelos interpretaron que un ajuste de 418 dólares, derivado de una auditoría del seguro y ya condonado, significaba que «toda la obligación anterior de la póliza de seguro de accidentes laborales había terminado». Como resultado, el EBITDA de los últimos 12 meses quedó subestimado en 4728 dólares. Este error apareció en 10 de las 15 ejecuciones correspondientes de Opus, Astra y Sol.
No se trata de un error de multiplicación. El modelo extrapoló el significado contable y legal de un ajuste específico para sacar una conclusión sobre toda la responsabilidad histórica del seguro. La desviación de 4728 dólares fue consecuencia de esa interpretación errónea, no un múltiplo de los 418 dólares. Es difícil detectar un error así «repitiendo los cálculos», porque la operación en sí puede ser correcta.
Error financiero dos: incluir los gastos de transacción en la deuda neta
En 15 ejecuciones se incluyeron los honorarios de éxito del banquero en la deuda neta, aunque el contrato de compraventa ya establecía que debían tratarse como un gasto de transacción independiente. El modelo encontró el gasto e hizo bien las sumas y restas, pero no aplicó el criterio vinculante del contrato.
Esta es la diferencia entre «tener el dato» y «clasificarlo correctamente desde el punto de vista del negocio». En una operación de fusiones y adquisiciones, la deuda neta suele afectar al importe que paga el comprador, por lo que una clasificación incorrecta tiene consecuencias más allá de la hoja de cálculo.
Error financiero tres: omitir gastos que debían ajustarse
El equipo de investigación también detectó una serie de problemas más sutiles:
- En 17 ejecuciones se siguió tratando la remuneración de familiares que no trabajaban realmente en la empresa como un gasto operativo normal;
- En la mayoría de las ejecuciones no se identificaron los gastos personales del propietario que solo aparecían en el campo de notas del libro mayor;
- En 10 de las 15 ejecuciones del modelo más potente se omitió un ajuste de 9192 dólares correspondiente a un gasto promocional histórico, por lo que se imputó al período actual de 12 meses un gasto que pertenecía a otro período.
Estos errores afectan al período contable, la naturaleza de los gastos, las fuentes de evidencia y la realidad económica de la transacción. El análisis de calidad de las ganancias sirve precisamente para excluir este tipo de partidas que «parecen gastos operativos, pero no lo son». Si se omiten, el EBITDA no puede reflejar la rentabilidad real de la empresa.
Caso jurídico: por qué ninguna de las 20 revisiones de estatutos para una ronda de serie B fue utilizable
Requisitos de la tarea jurídica
En la tarea quillon-series-b-redline, la IA representaba al inversor principal de una ronda de financiación de serie B y debía modificar los estatutos sociales previstos para su firma. Los materiales incluían la hoja de términos de inversión firmada, la tabla de capitalización, un correo del cliente, el borrador de los estatutos y otros documentos de la operación. Para superar la prueba, debía proteger los derechos legítimos del inversor sin modificar injustificadamente las condiciones comerciales ya negociadas. Era una tarea de criterio jurídico que exigía cotejar varios documentos, no una simple revisión de estilo.
Resultados y tres errores clave del caso jurídico
| Indicador | Resultado |
|---|---|
| Cumplimiento completo del estándar de utilidad | 0/20 ejecuciones |
| Puntuación parcial media | 18% |
| Puntuación parcial por modelo | Opus 5.5: 44%; GPT-6 Astra: 25%; Gemini 4 Argon: 2%; GLM 5.3: 0.5% |
| Puntuación parcial más alta en una ejecución | 57% (Opus 5.5) |
| No detectaron que los accionistas podían eliminar cláusulas de protección mediante votación | 13/20 ejecuciones |
| No impidieron que se eludieran las restricciones a través de filiales | 20/20 ejecuciones |
| No señalaron el conflicto entre el correo del cliente y la hoja de términos | 14/20 ejecuciones |
Cabe aclarar que el 18% es la puntuación parcial media de las ejecuciones relacionadas con este caso, no una puntuación global para todo el ámbito jurídico de GDPx.
Error uno: leer las cláusulas sin calcular los votos. En 13 ejecuciones no se detectó que los demás accionistas tenían suficientes derechos de voto para eliminar las cláusulas de protección que necesitaba el inversor principal. Que los estatutos incluyan cláusulas de protección no significa que estas sean realmente sólidas. Para saber si pueden ser eliminadas, hay que calcular los derechos de voto a partir de la tabla de capitalización.
Error dos: modificar el texto sin impedir que se eludan las restricciones. Ninguna de las 20 ejecuciones impidió de forma efectiva que la empresa recurriera a sus filiales para eludir las restricciones de protección del inversor incluidas en los estatutos. Si las cláusulas solo obligan a la propia empresa y no cubren a sus filiales, las operaciones pueden realizarse a través de otra entidad. Entender el sentido literal de una cláusula no es lo mismo que identificar cómo podría eludirse en la práctica.
Error tres: tratar el correo como si fuera el acuerdo definitivo. En 14 ejecuciones se adoptaron directamente las condiciones que el cliente deseaba incluir en su correo, sin señalar que entraban en conflicto con la hoja de términos firmada. Modificar los documentos de esa manera equivale a renegociar unilateralmente condiciones de la operación ya acordadas. Lo adecuado es identificar el conflicto y advertir al usuario, no aceptar todas las peticiones sin más.
Cómo se controla la fiabilidad de la evaluación jurídica
El diseño de evaluación de Chakra incluye la elaboración de requisitos por profesionales del derecho, la calibración de los criterios con ejemplos válidos, inválidos y parcialmente correctos, la revisión humana de las decisiones controvertidas y la comprobación de sesgos en el modelo evaluador. Cada respuesta se evalúa cinco veces y se comprueba la coherencia de los resultados para cada criterio de aceptación. No obstante, se trata de controles internos de calidad descritos por el socio; eso no significa que una entidad totalmente independiente haya verificado que la evaluación esté libre de errores.
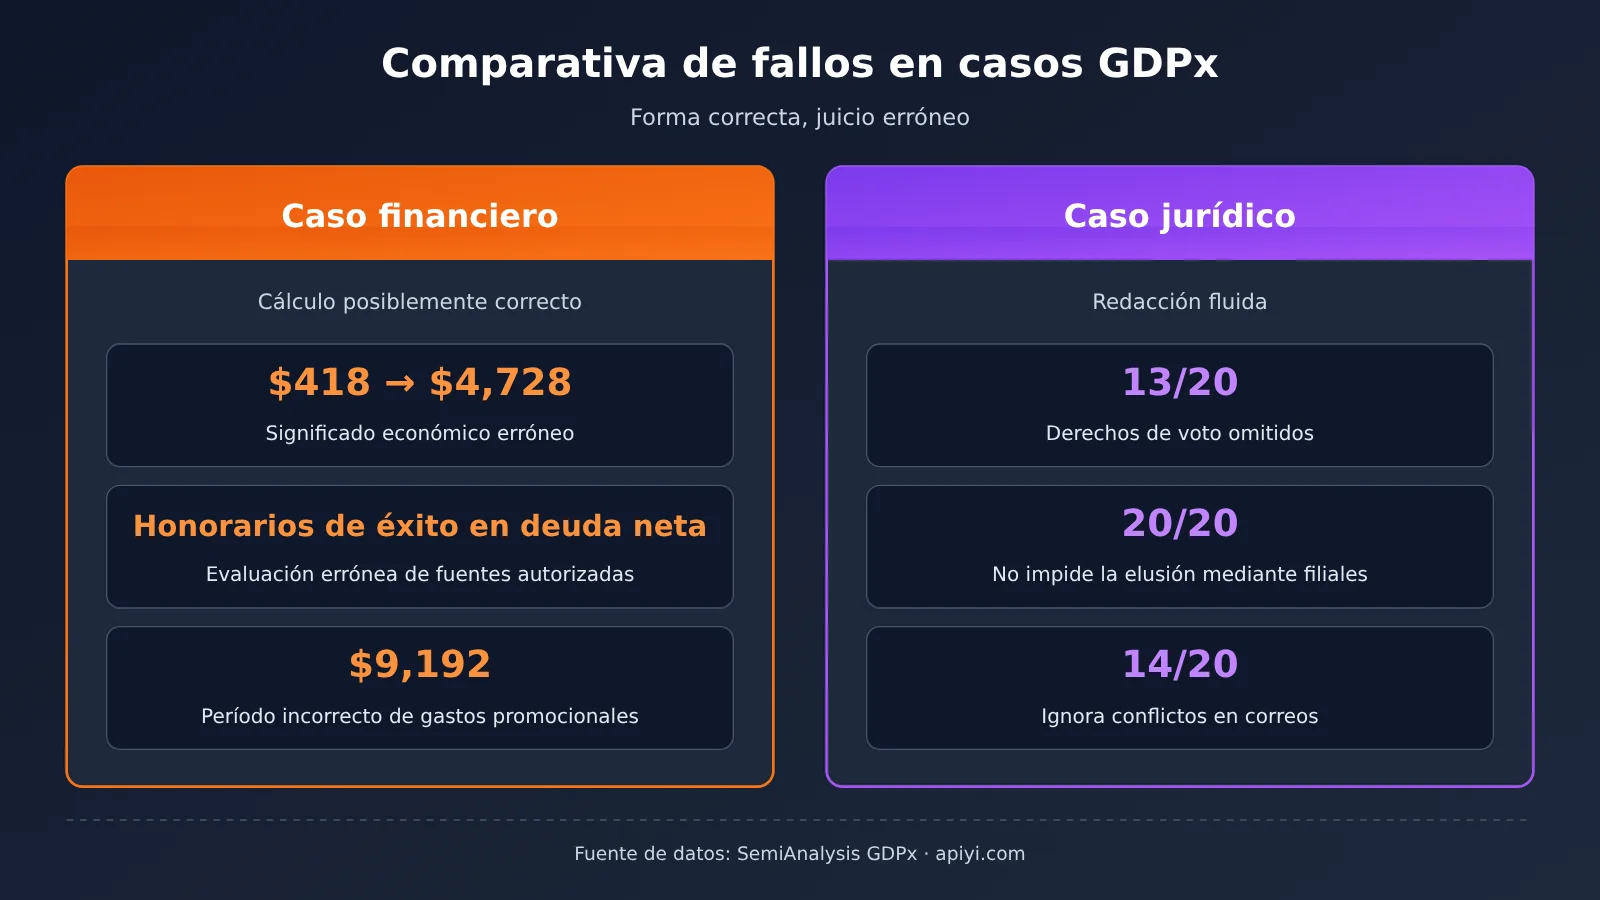
La causa común de los fallos en tareas financieras y jurídicas: no es la redacción, sino el criterio
Living Context agrupa los errores habituales de los casos financieros en cuatro categorías que coinciden en gran medida con lo observado en los casos jurídicos:
| Patrón de fallo | Manifestación en casos financieros | Equivalente en casos jurídicos | Lección profesional |
|---|---|---|---|
| Evaluación errónea de la autoridad de las fuentes | Dar preferencia a una tabla antigua con cifras explícitas e ignorar un acuerdo firmado | Dar prioridad al correo de un cliente sobre la lista de términos | Establecer primero una «jerarquía de validez documental» |
| Ignorar efectos de segundo orden | Completar los cálculos, pero pasar por alto las consecuencias fiscales, las deudas o las obligaciones de la operación | Modificar cláusulas de protección sin evaluar la estructura de votación | Preguntarse por las consecuencias posteriores de cada modificación |
| Revisar las operaciones, pero no los supuestos | Verificar repetidamente sumas, restas, multiplicaciones y divisiones, aunque las premisas de negocio sean incorrectas | Redactar con precisión, pero sin contemplar la vía de la filial | Revisar las premisas es más importante que revisar los cálculos |
| Dañar la estructura original al modificarla | Sustituir fórmulas por cifras fijas y romper los vínculos entre tablas | Modificar condiciones comerciales ya acordadas | El entregable debe «corregirse sin estropear lo que ya funciona» |
Estos son patrones de fallo identificados por el equipo de investigación, no una tasa de error aplicable a todos los modelos financieros empresariales o documentos jurídicos. Lo que tienen en común es que la principal dificultad no suele ser generar texto, sino seleccionar las fuentes, aplicar el razonamiento profesional, respetar las restricciones implícitas, mantener la coherencia entre documentos y superar la validación final. Cuanto más fluida sea la respuesta del modelo, más fácil es pasar por alto estos problemas.
Impacto de la IA en las aplicaciones financieras y jurídicas: cómo distinguir entre asistencia y entrega
Impacto para responsables de IA empresarial y desarrolladores
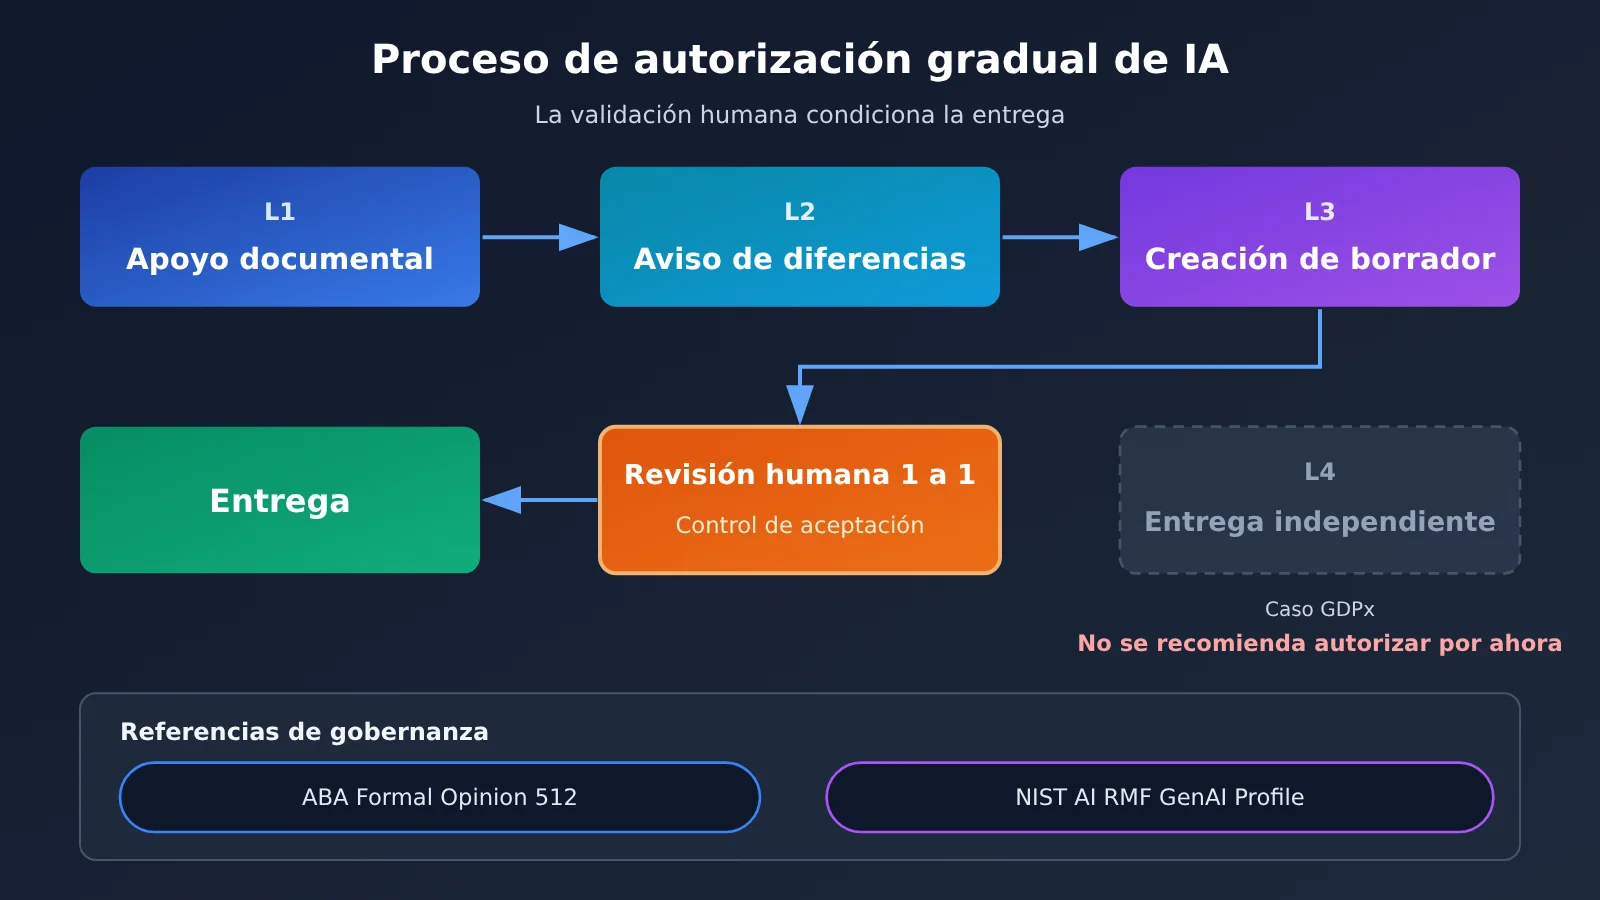
GDPx no niega el valor de la IA como apoyo al trabajo profesional. Los puntajes parciales indican que los modelos ya pueden cumplir una parte de los requisitos de aceptación. Sin embargo, el estudio no aporta datos que permitan determinar cuánto tiempo o dinero se ahorra con intervención humana, por lo que no conviene convertir directamente sus conclusiones en un cálculo de ROI. Un enfoque más práctico es definir los niveles de autorización según el riesgo, como en la siguiente tabla:
| Nivel de autorización | Usos típicos | Función de la persona | Criterio de aceptación |
|---|---|---|---|
| L1 Apoyo documental | Organización preliminar de documentos y revisión de datos anómalos | Revisiones puntuales | Los resultados solo sirven como pistas |
| L2 Detección de diferencias | Identificación de diferencias en cláusulas y datos, y elaboración de listas de conflictos | Confirmación punto por punto | Un profesional determina si los hallazgos son correctos |
| L3 Elaboración de borradores | Borradores de revisión de hojas de cálculo y de redline de estatutos | Revisión completa | Verificación de cada punto mediante una lista de control |
| L4 Entrega independiente | Firma o presentación directa ante terceros | — | Los casos de GDPx indican que actualmente no conviene autorizarla |
Esta clasificación coincide con la orientación de normas y guías externas. En su Formal Opinion 512, publicada el 29 de julio de 2024, la Asociación de Abogados de Estados Unidos (ABA) señala que los abogados que usan IA generativa siguen teniendo responsabilidades en materia de competencia profesional, confidencialidad de la información del cliente, comunicación, supervisión y honorarios razonables. También deben comprender las capacidades y limitaciones de las herramientas, y no pueden adoptar sus resultados sin verificarlos. Por su parte, el AI RMF Generative AI Profile, publicado por el NIST de Estados Unidos el 26 de julio de 2024, destaca que las organizaciones deben establecer medidas de supervisión humana, evaluación, documentación y gobernanza según el contexto de uso. Hay que tener en cuenta que la opinión de la ABA es una guía de ética profesional para abogados en Estados Unidos y que el documento del NIST tampoco recoge resultados de las pruebas de GDPx; ambos sirven únicamente como referencias de otros ámbitos.
Crear con una API un flujo de apoyo para detectar conflictos
Uno de los errores más frecuentes en los casos jurídicos de GDPx es no señalar los conflictos entre el correo del cliente y las cláusulas ya firmadas. Este tipo de tarea, que consiste en detectar diferencias y plantear preguntas, encaja bien con la asistencia de nivel L2, siempre que los resultados se utilicen únicamente como pistas para su confirmación por una persona. El siguiente ejemplo pide al modelo que compare dos textos y enumere los conflictos y los puntos que requieren confirmación humana:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

resp = client.chat.completions.create(
    model="claude-sonnet-4-20250514",
    messages=[{"role": "user", "content": "对照【已签署条款清单】与【客户邮件】,只列出冲突项和需人工确认的问题,不要直接修改条款。\n条款清单:...\n客户邮件:..."}]
)
print(resp.choices[0].message.content)
Ver el código completo de implementación (indicaciones cruzadas con varios modelos + lista de revisión humana)
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una sola clave para invocar modelos de distintos proveedores
)

SYSTEM = (
    "你是交易文件审查助手。你的输出只作为专业人员的审查线索,"
    "必须遵守:1) 已签署文件效力优先于邮件和旧表格;"
    "2) 发现冲突时提示,不得自行改写商业条款;"
    "3) 每条结论标注依据的文件名和段落;"
    "4) 无法确认的事项明确写'需人工确认'。"
)

CHECKS = [
    "客户邮件中的要求是否与已签署条款清单冲突",
    "结合股权结构,其他股东能否凭投票权移除保护条款",
    "保护条款是否覆盖子公司,是否存在绕行路径",
]

def review(docs: str, models: List[str]) -> Dict[str, str]:
    """Genera pistas de revisión con varios modelos para facilitar la comparación humana"""
    prompt = "请逐项检查:\n" + "\n".join(f"- {c}" for c in CHECKS) + f"\n\n材料:\n{docs}"
    results = {}
    for m in models:
        try:
            r = client.chat.completions.create(
                model=m,
                messages=[{"role": "system", "content": SYSTEM},
                          {"role": "user", "content": prompt}],
                temperature=0
            )
            results[m] = r.choices[0].message.content
        except Exception as e:
            results[m] = f"调用失败: {e}"
    return results

if __name__ == "__main__":
    out = review("条款清单:...\n股权结构表:...\n客户邮件:...\n章程草稿:...",
                 ["claude-sonnet-4-20250514", "gpt-4o"])
    for model, text in out.items():
        print(f"===== {model} =====\n{text}\n")
    # Un profesional jurídico o financiero decide si aceptar cada resultado según la lista de comprobación
🚀 Consejo para empezar: al crear este tipo de flujo de apoyo, puedes usar APIYI apiyi.com para acceder a varios modelos conocidos con una misma clave API y comparar su capacidad para detectar conflictos con tus propias muestras anonimizadas. Los usuarios nuevos pueden utilizar el crédito gratuito de prueba para realizar una validación a pequeña escala antes de decidir si ponen en marcha un proyecto piloto.
Impacto en los sectores financiero y de tecnología legal
Los resultados de GDPx recuerdan al sector que, al evaluar productos de IA especializados, no basta con comprobar si las demostraciones conversacionales son fluidas: hay que ver si los entregables finales superan una evaluación profesional. Para los proveedores, la competitividad del producto dependerá cada vez más de detalles de ingeniería como la «prioridad de los documentos oficiales», las «alertas de conflicto», la «conservación de la estructura original de las fórmulas» y la «trazabilidad de las evidencias». Para los compradores, conviene realizar pruebas independientes con tareas similares a las de su propia actividad. GDPx solo ha publicado una parte de las tareas y de las trazas de ejecución, por lo que todavía se necesitan más revisiones y reproducciones externas.
💡 Consejo para elegir un modelo: el rendimiento de los modelos varía considerablemente según el ámbito, así que una clasificación general no necesariamente refleja las necesidades de tu actividad. Te recomendamos usar la interfaz unificada de APIYI apiyi.com para probar varios modelos en paralelo con tus propias tareas. Registra también las puntuaciones parciales y si cumplen los criterios clave; no te fijes solo en la puntuación media. Consulta la lista actualizada de la plataforma para conocer la disponibilidad de cada modelo.
Preguntas frecuentes FAQ
Q1: ¿Que la IA «no aprobara ninguna» de las tareas financieras y legales significa que no hizo nada bien?
No. El 0 % es el resultado de una evaluación binaria estricta: ninguna ejecución cumplió todos los requisitos clave. En el caso financiero, la mejor ejecución superó 8 de las 11 comprobaciones; en el caso legal, la puntuación parcial promedio de Opus 5.5 fue del 44 %. Completar parte del trabajo y entregar un resultado que cumpla los requisitos son dos criterios distintos.
Q2: ¿Por qué la IA puede calcular bien y aun así llegar a un resultado incorrecto?
Porque el error suele estar en las premisas del negocio, no en el cálculo. Por ejemplo, un ajuste de exención de 418 dólares se interpretó como la terminación de las obligaciones de toda la póliza, lo que llevó a subestimar el EBITDA en 4728 dólares. En otro caso, se identificó correctamente el importe de la comisión de éxito del banco, pero se clasificó como deuda neta. Repetir los cálculos no permite detectar este tipo de errores.
Q3: ¿Se pueden aplicar las conclusiones de GDPx a todas las aplicaciones de IA en finanzas y derecho?
No. Estos resultados provienen de tareas específicas de alta dificultad y de reglas de evaluación concretas. Las causas de fallo identificadas en los casos tampoco se pueden generalizar a todo el sector. Las aplicaciones menos complejas o con colaboración humana deben evaluarse por separado.
Q4: ¿Qué trabajos financieros y legales puede asumir la IA actualmente?
Algunas opciones razonables son organizar documentación preliminar, señalar diferencias entre cláusulas y datos, preparar primeros borradores, detectar datos anómalos y ayudar a elaborar listas de revisión. Para determinar si es adecuada para un caso concreto, hay que hacer pruebas independientes según el nivel de riesgo y los criterios de aceptación profesional.
Q5: ¿Cómo puedo evaluar a bajo costo el rendimiento de un modelo en mi negocio?
Puedes seguir estos pasos:
1. Prepara varias muestras reales anonimizadas y elabora una lista de verificación para cada una;
2. Regístrate en APIYI apiyi.com, obtén una clave API y utiliza el crédito gratuito de prueba;
3. Configura el base_url del código de este artículo como `https://api.apiyi.com/v1` y ejecuta llamadas a varios modelos en paralelo;
4. Registra por separado las puntuaciones parciales y si se superaron los puntos clave; deja la decisión final en manos de profesionales.
Q6: ¿Se puede usar el costo por tarea del informe de GDPx como referencia para los precios de una API?
No. Los importes en dólares de GDPx son el costo promedio por tarea bajo las condiciones de ejecución del benchmark, no una tarifa uniforme de ninguna plataforma. El costo real depende de los precios vigentes de la plataforma utilizada y de tu volumen de uso. Puedes consultar el detalle de facturación por consumo en la consola de APIYI apiyi.com.
Puntos clave de la evaluación de IA en tareas financieras y jurídicas
- Ningún modelo superó la evaluación estricta: con los criterios binarios de GDPx, ningún modelo aprobó por completo en las áreas financiera y jurídica.
- Las puntuaciones parciales no fueron cero: en el caso financiero, el mejor resultado en una ejecución superó 8 de 11 comprobaciones; en el caso jurídico, la puntuación máxima en una ejecución fue del 57 %.
- El error estuvo en el juicio, no en el cálculo: una interpretación incorrecta de un ajuste de 418 dólares llevó a subestimar el EBITDA en 4.728 dólares.
- La prioridad entre fuentes es clave: en 14 de 20 ejecuciones, se dio más peso a un correo del cliente que a la hoja de términos firmada.
- Las restricciones implícitas son las más difíciles de cubrir: en las 20 ejecuciones se pasó por alto el riesgo de eludir las condiciones a través de una filial.
- Tres conceptos que no deben confundirse: la puntuación parcial, la aprobación completa y la aptitud para producción deben evaluarse por separado.
- Primero asistencia, después un piloto: la interfaz unificada para múltiples modelos de APIYI, apiyi.com, permite realizar una validación por niveles con muestras propias.
Resumen
Las principales conclusiones de las tareas financieras y jurídicas de GDPx se pueden resumir en tres puntos:
- La fluidez no garantiza la calidad: aunque los cálculos de una tabla sean correctos y las cláusulas estén bien redactadas, puede haber errores en el fondo económico, la estructura de derechos y las contradicciones entre documentos;
- El trabajo profesional depende del criterio: la autoridad de las fuentes, los efectos de segundo orden, las restricciones implícitas y la coherencia entre documentos son los verdaderos desafíos;
- La autonomía debe concederse por niveles y la aceptación debe tener criterios claros: siguiendo los enfoques de la ABA y el NIST, conviene mantener la revisión humana y reservar la IA para tareas de asistencia y primeros borradores.
La IA ya puede realizar parte del trabajo valioso en tareas profesionales complejas, pero todavía está lejos de asumir de forma independiente la responsabilidad por los entregables. Si estás evaluando soluciones de IA para el ámbito financiero o jurídico, puedes usar APIYI, apiyi.com, para comparar las puntuaciones parciales y las tasas de aprobación de los criterios clave de varios modelos con muestras de tu propio negocio, antes de decidir cuánta autonomía concederles.
📚 Referencias
- Informe original de GDPx de SemiAnalysis: secciones de finanzas y derecho, casos y patrones de fallo
- Enlace:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Descripción: fuente primaria de los datos de los casos Bellwood-QoE y quillon-series-b-redline
-
Descripción de los dominios de GDPx y trayectorias de ejecución públicas: número de tareas, colaboradores y trayectorias de agentes
- Enlaces:
gdpx.semianalysis.com/domains,gdpx.semianalysis.com/rollouts -
Descripción: permite consultar el proceso de ejecución de algunas tareas públicas
-
Comunicado sobre la Opinión Formal 512 de la ABA: orientación ética profesional para el uso de IA generativa por parte de abogados
- Enlace:
americanbar.org/news/abanews/aba-news-archives/2024/07/aba-issues-first-ethics-guidance-ai-tools/ -
Descripción: aplicable a la abogacía en Estados Unidos; puede servir como referencia para los principios de revisión humana
-
Perfil de IA generativa del NIST AI RMF: marco de gestión de riesgos de la IA generativa
- Enlace:
nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence - Descripción: referencia multidisciplinaria sobre supervisión humana, evaluación y medidas de gobernanza
Autor: equipo técnico de APIYI
Contacto técnico: contáctanos desde la página principal del sitio oficial de APIYI. Encontrarás más recursos de integración en el centro de documentación docs.apiyi.com