Nota del autor: xAI retiró oficialmente el identificador grok-imagine-image-quality el 2 de noviembre de 2026. Las solicitudes antiguas no generan errores, pero el modelo subyacente ya se ha cambiado a Image 2.0 Low. A partir de esta migración de Grok Imagine, repasamos los riesgos de la gestión de versiones de las API de IA y cómo afrontarlos.
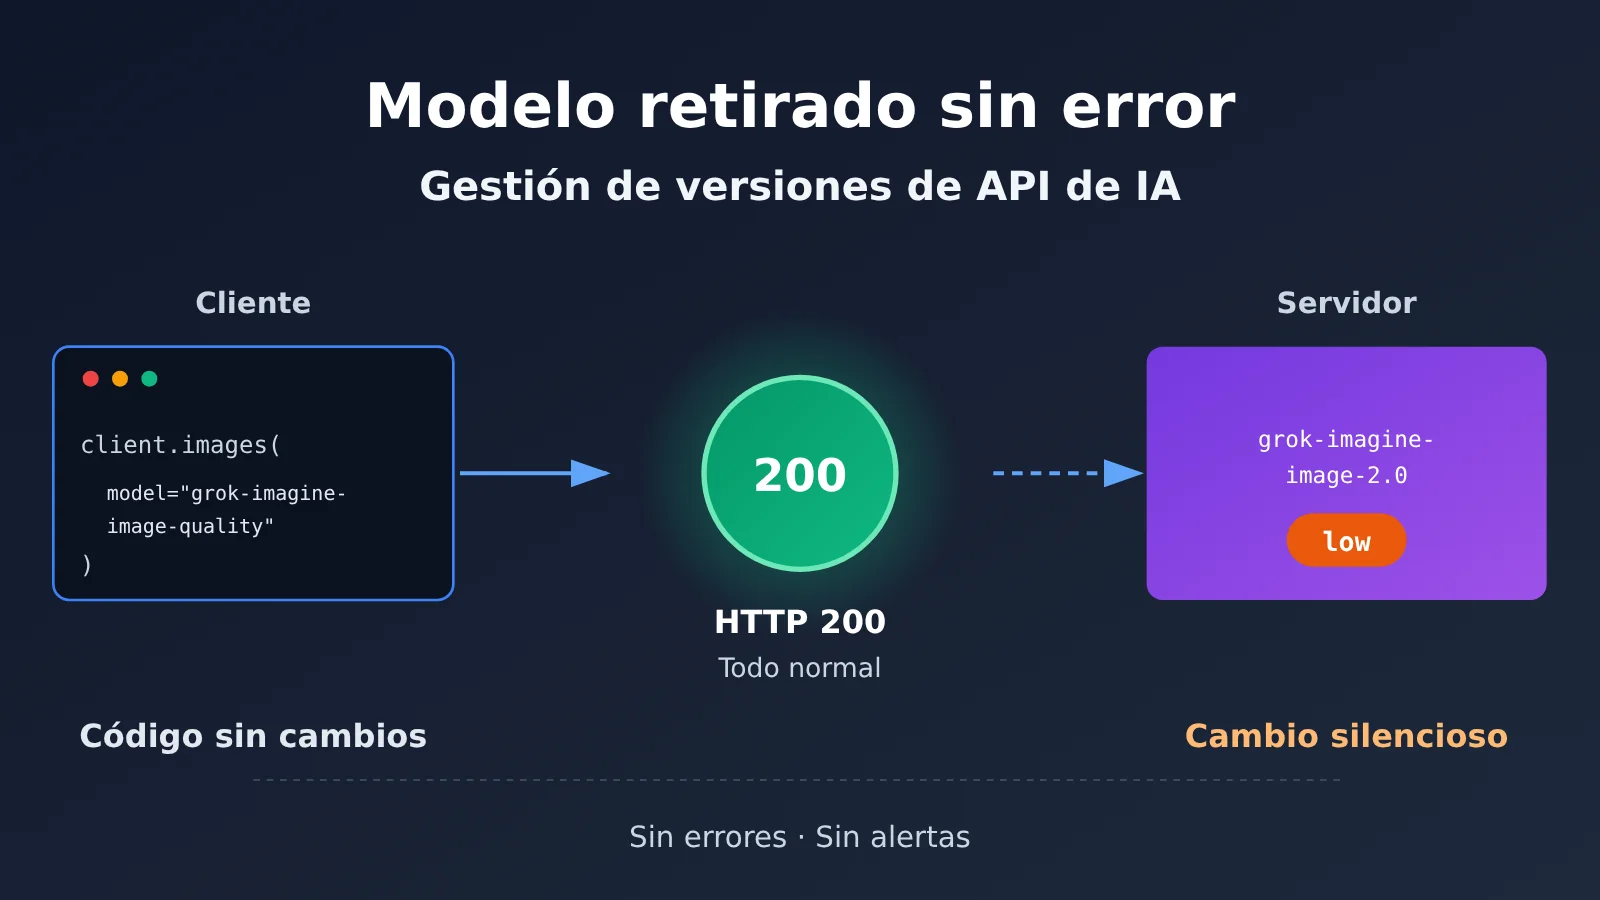
Hoy, 2 de noviembre de 2026, xAI ha ejecutado oficialmente la migración de modelos de imagen que había anunciado. El identificador antiguo grok-imagine-image-quality sigue funcionando, pero el modelo que se ejecuta realmente ahora es grok-imagine-image-2.0, con el nivel de calidad fijado en low. Para la mayoría de las aplicaciones, no ha cambiado ni una línea de código, las solicitudes siguen devolviendo respuestas y el panel de monitoreo no muestra ninguna alerta roja.
Esto no es un informe de incidente. Las reglas de migración provienen del aviso oficial que xAI publicó el 2 de septiembre, con 60 días de antelación. Por ahora, no hay pruebas de que se hayan producido fallos generalizados entre los usuarios. Lo que merece atención es el problema de ingeniería que revela: que una interfaz siga siendo compatible y las llamadas tengan éxito no significa que el modelo, la calidad de los resultados y el costo sigan siendo los mismos.
Qué te llevarás: al terminar este artículo, sabrás exactamente qué cambió en esta migración de Grok Imagine, entenderás por qué las API de IA necesitan un mecanismo de gestión de versiones independiente del monitoreo habitual de disponibilidad y tendrás una lista de comprobación para revisar tu sistema de inmediato.
Datos clave sobre la retirada del modelo Grok Imagine
Empecemos por los hechos confirmados en la documentación oficial. Es importante aclarar que el 2 de noviembre no es la fecha de lanzamiento de Image 2.0, que se publicó el 7 de agosto, sino la fecha en que entra en vigor la retirada de un identificador antiguo de la API.
| Dato | Detalle |
|---|---|
| Fecha de entrada en vigor | 2 de noviembre de 2026 (anunciado el 2 de septiembre, con 60 días de aviso) |
| Fuente | Guía de migración oficial de xAI |
| Identificador retirado | grok-imagine-image-quality |
| Modelo de reemplazo | grok-imagine-image-2.0, con quality fijado en low |
| Interfaces afectadas | /v1/images/generations y /v1/images/edits |
| Compatibilidad | El identificador antiguo sigue siendo reconocido y las estructuras de solicitud y respuesta se mantienen compatibles |
| Sin cambios | xAI confirma que grok-imagine-image (1.0) no se ve afectado |
| Cómo comprobarlo | El campo model de la respuesta indica qué modelo ha atendido realmente la solicitud |
La cadena de redirecciones de los identificadores antiguos de Grok Imagine
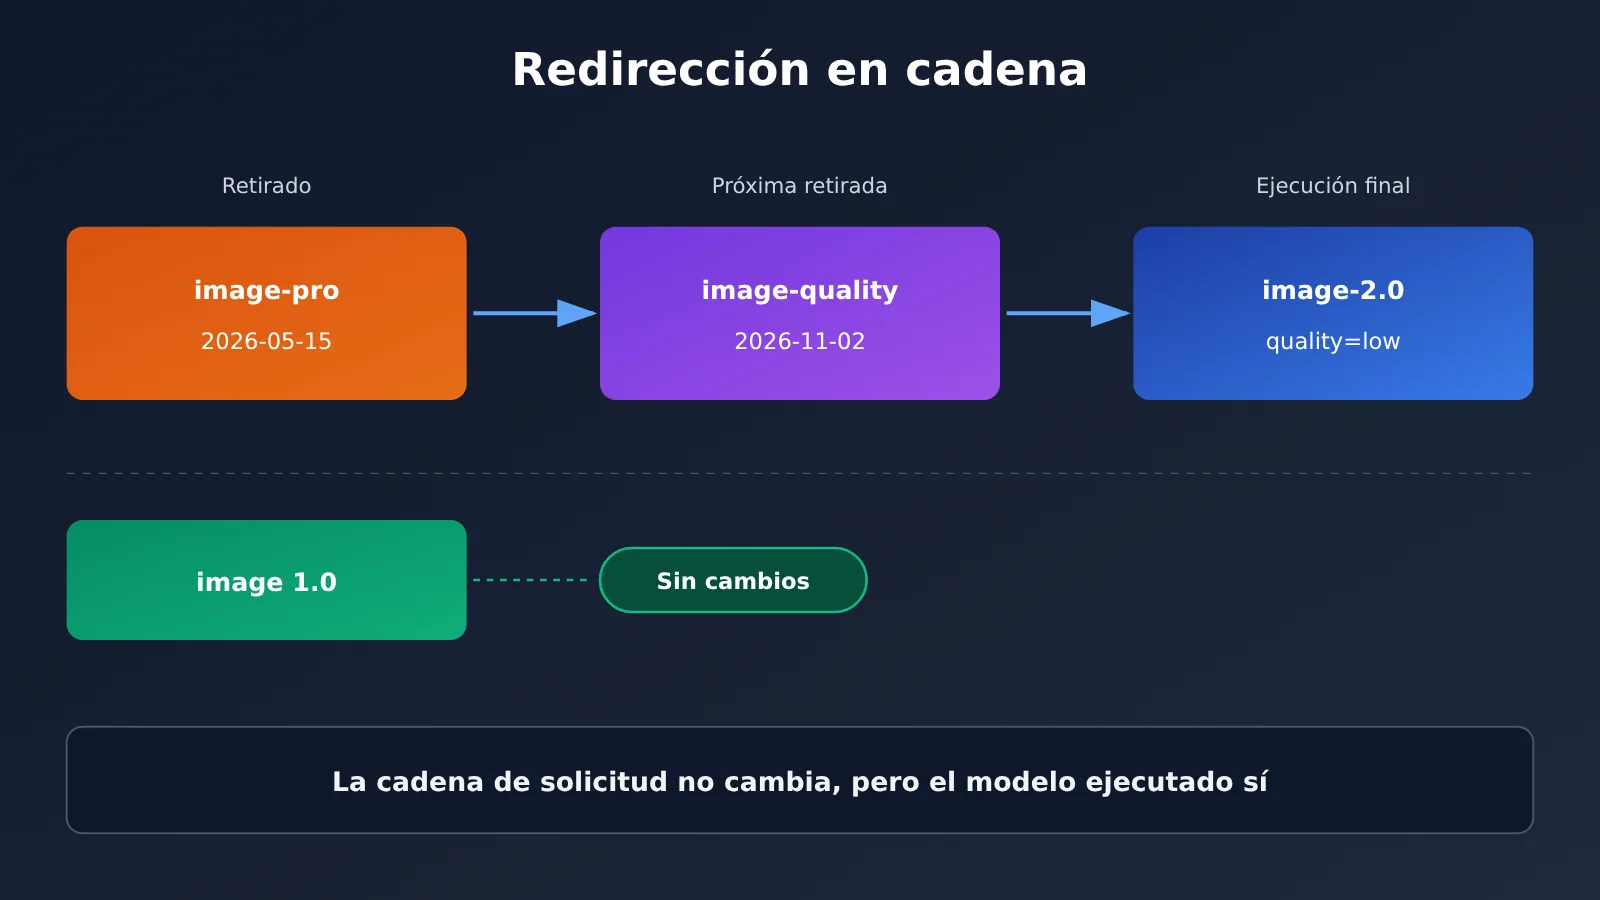
Uno de los detalles más fáciles de pasar por alto en esta migración es la «cadena de redirecciones». El 15 de mayo de 2026, xAI ya había retirado un identificador aún más antiguo, grok-imagine-image-pro, y redirigido sus solicitudes a grok-imagine-image-quality. A partir del 2 de noviembre, la cadena se extiende un paso más.
En otras palabras, una aplicación que nunca haya actualizado su configuración y siga usando el identificador pro ahora utiliza Image 2.0 Low. Ya no basta con revisar la cadena de texto del modelo en el archivo de configuración para saber qué modelo se está ejecutando realmente.
| Identificador configurado en la aplicación | Estado | Ruta real después del 2 de noviembre |
|---|---|---|
grok-imagine-image-pro |
Retirado el 15 de mayo | pro → quality → 2.0 (low) |
grok-imagine-image-quality |
Retirado el 2 de noviembre | quality → 2.0 (low) |
grok-imagine-image-2.0 |
Disponible oficialmente | 2.0, permite seleccionar low / medium / auto |
grok-imagine-image |
1.0, sigue disponible | No se ve afectado por este cambio |
Los 4 riesgos de gestión de versiones de API de IA que plantea la migración a Grok Imagine
El siguiente análisis deduce riesgos de ingeniería a partir de los mecanismos oficiales; no es una estadística de incidentes ocurridos en xAI. Podemos agruparlos en cuatro categorías: identidad del modelo, calidad del resultado, facturación y monitoreo.
Riesgo 1: cambios en la identidad del modelo
La cadena de solicitud del cliente no cambia, pero sí el modelo que se ejecuta en el servidor. xAI hace que el campo model de la respuesta indique el modelo real utilizado. Es una buena noticia, siempre que tu sistema registre y compare ese campo. Muchas aplicaciones solo fijan el nombre del modelo en la solicitud y nunca leen la información del modelo en la respuesta.
Riesgo 2: cambios en la calidad y el estilo de los resultados
Lo que confirma la documentación oficial es la «compatibilidad de la estructura de las solicitudes», no que las imágenes generadas sean idénticas. Al presentar Image 2.0, xAI destacó capacidades como el seguimiento de indicaciones con múltiples condiciones, la generación de texto pequeño y diseños complejos, y la edición con varias imágenes de referencia. Al mismo tiempo, algunos usuarios de Reddit r/grok comentaron que la versión 2.0 no les resultaba tan práctica como la anterior para los detalles de la piel, la iluminación natural y la conservación de la imagen original.
Estas opiniones son experiencias subjetivas y se refieren principalmente al producto de consumo, así que no permiten concluir que la versión 2.0 haya empeorado en general. Pero sí muestran algo importante: una misma indicación puede producir una composición, un estilo o un resultado de edición localizada diferente después de cambiar de modelo. Hay que comprobarlo mediante pruebas de regresión, en lugar de dar por hecho que «si es compatible, no hay problema».
Riesgo 3: cambios en la facturación y los niveles de calidad
Esta migración es un caso en el que los precios bajan, pero precisamente por eso deja aún más clara la importancia de configurar bien los niveles. Estos son los precios oficiales de xAI por imagen generada, en dólares y sin incluir el costo de entrada de las imágenes de referencia:
| Resolución | Quality anterior | 2.0 Low | 2.0 Medium |
|---|---|---|---|
| 1K | $0.05 | $0.04 | $0.06 |
| 1.5K | $0.06 | $0.05 | $0.07 |
| 2K | $0.07 | $0.06 | $0.08 |
Para 10,000 imágenes 1K al mes, el costo teórico de generación sería de unos $400 si se mantiene el identificador anterior, que pasa automáticamente a 2.0 Low: $100 menos que los $500 de Quality anterior. Si se cambia explícitamente a 2.0 Medium, el costo sube a $600, es decir, $100 más que antes. En edición de imágenes también hay que sumar $0.01 de entrada por cada imagen de referencia. Por ejemplo, con 1 imagen de referencia y 1 imagen de salida 1K, el costo sería de $0.06 con Quality anterior, $0.05 con 2.0 Low y $0.07 con 2.0 Medium.
La diferencia en los valores predeterminados es menos evidente. Desde el 28 de agosto, si no se especifica quality en 2.0, se usa auto por defecto. Actualmente, auto selecciona low para texto a imagen y medium para edición de imágenes. La documentación oficial usa «currently», por lo que no es una asignación permanente. Así que «mantener el identificador anterior» y «cambiar a 2.0 sin especificar quality» no son equivalentes para la edición de imágenes, y sus costos también son distintos. Además, aunque la tabla de precios incluye 1.5K, la documentación de parámetros de generación solo enumera actualmente 1k y 2k como valores de resolution. Para saber si se puede especificar 1.5k, hay que comprobarlo mediante pruebas.
Riesgo 4: puntos ciegos en el monitoreo
Si tu aplicación solo vigila los códigos de estado HTTP, la tasa de éxito y el tiempo de respuesta, el cambio de modelo será prácticamente «invisible» en las métricas. El modo asíncrono (deferred) de generación de imágenes de xAI ofrece otro ejemplo: pending devuelve HTTP 202, done devuelve HTTP 200 y failed también devuelve HTTP 200, pero incluye información del error en la respuesta. HTTP 200 no siempre significa que la operación haya tenido éxito.
Comparativa de la gestión de versiones entre proveedores
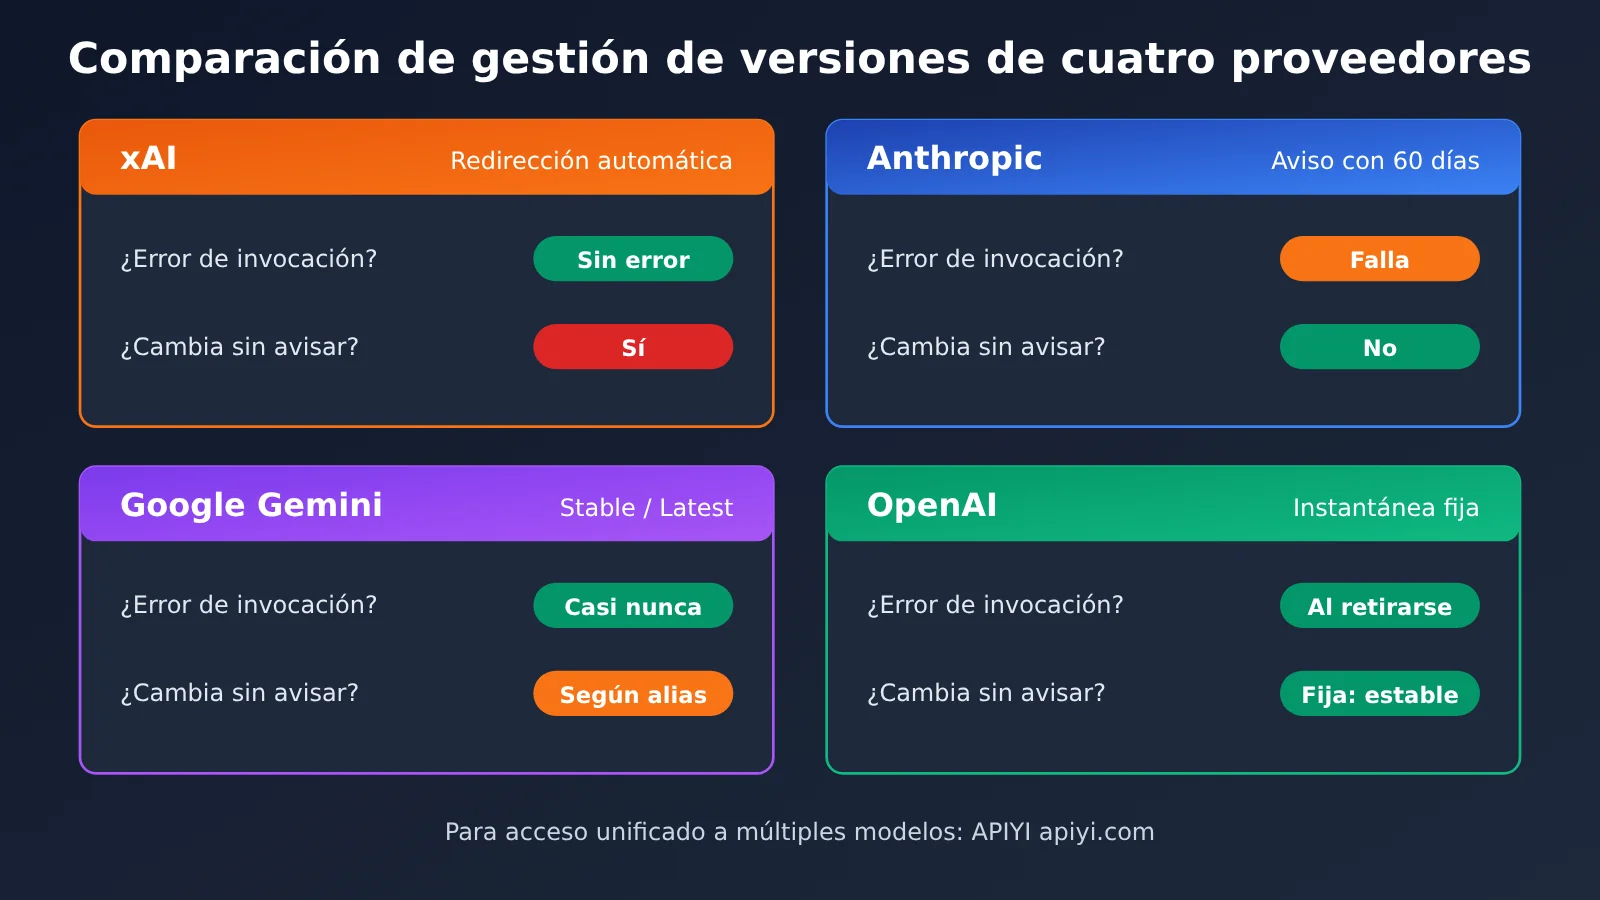
La estrategia de xAI, que mantiene los identificadores antiguos y sustituye el modelo en el servidor, es solo una de las posibles. No se puede asumir que todos los proveedores sigan la misma regla. Al comparar la documentación oficial de varios de ellos, las diferencias son claras.
| Proveedor | Política oficial de versiones | Comportamiento tras la retirada o el cambio | Qué implica para los desarrolladores |
|---|---|---|---|
| xAI | Los identificadores retirados siguen siendo válidos y el servidor redirige la solicitud | No se produce un error, pero cambia el modelo utilizado | Es imprescindible comprobar el campo model de la respuesta |
| Anthropic | Cuatro etapas: Active / Legacy / Deprecated / Retired | Las solicitudes fallan después de Retired; los modelos públicos se notifican con al menos 60 días de antelación | El fallo es visible; hay que seguir los avisos de deprecación |
| Google Gemini | Stable / Preview / Latest / Experimental | El alias Latest cambia automáticamente con cada nueva versión; los cambios incompatibles se notifican con antelación | Se recomienda Stable en producción y cautela con Latest |
| OpenAI | Recomienda fijar una instantánea del modelo en producción | La compatibilidad de la estructura de la API con versiones anteriores no garantiza resultados idénticos | Fijar una instantánea y crear un conjunto de evaluación, sin perder de vista las fechas de retirada |
Comparación con xAI: xAI ofrece la transición más «fluida» en cuanto a compatibilidad del cliente: el código antiguo no deja de funcionar de repente. El costo es que el cambio de modelo no se manifiesta como un error. En cambio, la estrategia de Anthropic, que hace fallar las solicitudes a modelos en estado Retired, es más «ruidosa», pero permite detectar el problema antes.
Comparación con Google y OpenAI: Google ha incorporado explícitamente al alias Latest la idea de que «el identificador no cambia, pero la versión sí», lo que muestra que este mecanismo es público y habitual. OpenAI, por su parte, recomienda el enfoque contrario: fijar una instantánea en producción y crear un conjunto de evaluación. Ambos casos muestran que la gestión de versiones no es un problema aislado de un proveedor, sino un reto de ingeniería que hay que afrontar al usar cualquier API de IA.
💡 Recomendación: La semántica de las versiones varía mucho entre proveedores. Si integras varios modelos, conviene registrar de forma uniforme tanto el «modelo solicitado» como el «modelo ejecutado». Si utilizas APIYI apiyi.com para acceder a modelos de varios proveedores mediante una interfaz compatible con OpenAI, también es recomendable conservar ambos campos en la capa de aplicación para facilitar las comparaciones.
Cómo gestionar las versiones de una API de IA: registros, costos y despliegues graduales
Paso 1: distinguir entre el modelo solicitado y el modelo utilizado
Las convenciones semánticas de OpenTelemetry para IA generativa incluyen dos atributos clave: gen_ai.request.model identifica el modelo solicitado por el cliente, mientras que gen_ai.response.model identifica el modelo que generó realmente la respuesta. xAI no proporciona automáticamente todos los campos de telemetría, por lo que la aplicación debe recopilarlos y mapearlos por su cuenta. Estos son los campos recomendados para los registros de la aplicación; son sugerencias de ingeniería, no requisitos oficiales:
| Campo | Uso | Consideraciones |
|---|---|---|
requested_model / served_model |
Detectar redirecciones silenciosas | El modelo utilizado se obtiene del campo model de la respuesta |
quality_requested / quality_effective |
Rastrear el nivel de calidad | Si el valor efectivo solo puede deducirse de la documentación, debe marcarse como inferido |
response_status / business_status |
Distinguir entre el resultado HTTP y el resultado de la operación | Una operación asíncrona fallida también puede devolver HTTP 200 |
cost_usd |
Costo real de cada operación | En xAI puede calcularse a partir de cost_in_usd_ticks |
reference_image_count / resolution |
Atribución de costos | En las operaciones de edición hay que incluir el costo de entrada |
prompt_template_version / evaluation_result |
Comparación de regresiones | No registres por defecto indicaciones sensibles ni imágenes de usuarios |
Segundo paso: registrar en el código el modelo utilizado y el costo
La documentación oficial de xAI sobre Cost Tracking, actualizada el 2026-10-10, indica que el objeto usage de la respuesta puede incluir cost_in_usd_ticks. La fórmula de conversión es cost_usd = cost_in_usd_ticks / 10000000000: en el ejemplo oficial, 400000000 ticks equivalen a $0.04. Este campo es específico de xAI; si usas un SDK o una plataforma de terceros, comprueba que lo transmitan sin cambios.
El siguiente ejemplo minimalista muestra cómo comparar los modelos en cada solicitud:
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
REQUESTED_MODEL = "grok-imagine-image-2.0"  # 示例名称,可用模型以平台实际列表为准

resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers={"Authorization": "Bearer YOUR_API_KEY"},
    json={"model": REQUESTED_MODEL, "prompt": "A tech magazine cover",
          "quality": "low", "resolution": "1k", "n": 1},
    timeout=180,
).json()

served = resp.get("model")
if served and served != REQUESTED_MODEL:
    print(f"[版本告警] 请求 {REQUESTED_MODEL},实际执行 {served}")
Ver la implementación completa con validación del costo y del resultado
import time
import logging
import requests
from typing import Optional

logging.basicConfig(level=logging.INFO)
log = logging.getLogger("model_governance")

BASE_URL = "https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
TICKS_PER_USD = 10_000_000_000  # xAI 官方换算:1 美元 = 10^10 ticks


def generate_image(
    prompt: str,
    model: str,
    quality: str = "low",          # 显式填写,避免 auto 默认值随上游变化
    resolution: str = "1k",
    api_key: str = "YOUR_API_KEY",
    expected_unit_cost: Optional[float] = None,
) -> dict:
    start = time.time()
    r = requests.post(
        f"{BASE_URL}/images/generations",
        headers={"Authorization": f"Bearer {api_key}"},
        json={"model": model, "prompt": prompt, "quality": quality,
              "resolution": resolution, "n": 1},
        timeout=180,
    )
    latency_ms = int((time.time() - start) * 1000)
    body = r.json() if r.content else {}

    # 1. 执行模型校验
    served_model = body.get("model")

    # 2. 业务结果校验:HTTP 200 不等于拿到可用图片
    data = body.get("data") or []
    has_image = bool(data and (data[0].get("url") or data[0].get("b64_json")))
    business_ok = r.status_code == 200 and has_image and not body.get("error")

    # 3. 成本:字段可能不被透传,缺失时记录为 None 而不是 0
    ticks = (body.get("usage") or {}).get("cost_in_usd_ticks")
    cost_usd = ticks / TICKS_PER_USD if ticks is not None else None

    record = {
        "requested_model": model,
        "served_model": served_model,
        "quality_requested": quality,
        "resolution": resolution,
        "response_status": r.status_code,
        "business_status": "ok" if business_ok else "failed",
        "latency_ms": latency_ms,
        "cost_usd": cost_usd,
    }

    if served_model and served_model != model:
        log.warning("模型重定向: %s -> %s", model, served_model)
    if cost_usd is not None and expected_unit_cost is not None \
            and abs(cost_usd - expected_unit_cost) > 1e-6:
        log.warning("单价偏离预期: 预期 %.4f 实际 %.4f", expected_unit_cost, cost_usd)

    log.info("generation record: %s", record)
    return record


if __name__ == "__main__":
    generate_image(
        prompt="A clean product shot on white background",
        model="grok-imagine-image-2.0",  # 以平台模型列表为准
        quality="low",
        expected_unit_cost=0.04,
    )
🚀 Inicio rápido: si quieres probar primero esta lógica de registro, puedes registrarte en APIYI apiyi.com para obtener crédito de prueba y comprobar los campos del registro con algunos prompts de tu negocio. Ten en cuenta que los modelos de imagen disponibles, los parámetros de calidad compatibles y los precios reales deben consultarse en la lista de modelos y la página de precios de la plataforma. Los precios de terceros no son los precios oficiales de xAI.
Tercer paso: conjunto de prueba fijo y validación gradual
Siguiendo el método Canary Release de Google SRE y las recomendaciones de OpenAI sobre conjuntos de evaluación, puedes migrar los modelos de imagen así: prepara primero un conjunto fijo de muestras que cubra carteles con texto, imágenes de productos, edición de retratos, composiciones con varios sujetos y modificaciones locales. Después, fija el prompt, la imagen de entrada, la resolución, la calidad, la relación de aspecto y la cantidad de imágenes generadas. Luego compara el seguimiento de instrucciones, la conservación de los sujetos, la precisión del texto, los cambios fuera de la zona editada, la tasa de aprobación en la revisión humana y el costo por imagen aprobada. Por último, siempre que puedas controlar el enrutamiento, cambia una pequeña parte del tráfico y observa las métricas antes de ampliarlo.
Es importante ser realistas: esta retirada de xAI se aplica desde el proveedor, así que los desarrolladores no pueden dar por hecho que podrán volver al modelo subyacente Quality que ha sido retirado. Aquí, «revertir» significa cambiar a un modelo alternativo que se haya validado y siga disponible, pausar las funciones afectadas o ajustar el parámetro quality, no restaurar una versión antigua a la que ya no se puede acceder.
Impacto de la migración a Grok Imagine para desarrolladores y plataformas de API
Impacto para los desarrolladores
- Amplía la búsqueda: no busques solo
grok-imagine-image-quality; revisa también alias más antiguos, comogrok-imagine-image-pro. - Define los parámetros explícitamente: al migrar directamente a 2.0, especifica low o medium. No dejes que auto decida el nivel de calidad y el costo de tus tareas de edición.
- Actualiza el cálculo de costos: cuando la documentación oficial dice «$0.01 menos por imagen», se refiere al precio de salida. La reducción total será distinta en tareas de edición que utilizan imágenes de referencia.
- Verifica la calidad por separado: además de la tasa de éxito de las llamadas, incorpora criterios de aceptación a nivel de negocio y métricas de costo por resultado válido.
Impacto para las plataformas de agregación de API
Para las plataformas que dan acceso a múltiples modelos, la gestión de versiones se está convirtiendo en una necesidad real de los clientes: necesitan saber a qué modelo del proveedor llegó su solicitud, conocer las fechas de retirada y redirección y los cambios de precio, comprobar que los parámetros clave como quality se transmiten correctamente y contar con información trazable sobre los modelos y la facturación. Son aspectos que las plataformas de agregación pueden evaluar y desarrollar.
🎯 Recomendación técnica: si accedes a modelos de varios proveedores a través de una plataforma de agregación como APIYI apiyi.com, durante la migración conviene verificar tres cosas: que el campo model de la respuesta refleje el modelo real del proveedor, que el parámetro quality se transmita correctamente y que la facturación coincida con el precio unitario esperado. Si detectas alguna diferencia, guarda el ID de la solicitud y contacta con el soporte técnico de la plataforma: es mucho más eficiente que revisar las facturas después.
Preguntas frecuentes
P1: ¿En qué consiste exactamente la retirada del modelo Grok Imagine?
A partir del 2 de noviembre de 2026, el identificador `grok-imagine-image-quality` de la API de xAI queda retirado, pero se puede seguir utilizando. El servidor redirige las solicitudes a `grok-imagine-image-2.0` y fija el nivel en low. Esto afecta tanto a la interfaz de generación como a la de edición; el modelo 1.0, `grok-imagine-image`, no se ve afectado.
P2: ¿El código antiguo devolverá un error 404 o fallará directamente?
No. Según la información oficial, el identificador antiguo sigue siendo válido y se redirige automáticamente; la estructura de las solicitudes y respuestas mantiene la compatibilidad. Precisamente ahí está el detalle: que no aparezca un error no significa que los resultados y el precio unitario sigan siendo los mismos. Esto difiere de la política de Anthropic, donde las solicitudes fallan cuando un modelo entra en estado Retired.
P3: ¿Basta con cambiar a grok-imagine-image-2.0 para que todo funcione exactamente igual que antes?
No del todo. Si cambias a 2.0 sin especificar quality, el valor predeterminado es auto: actualmente usa low para texto a imagen y medium para edición de imágenes. En cambio, si conservas el identificador antiguo, se fija en low. Para edición con medium, el precio por imagen de salida de 1K es de $0.06, superior a los $0.05 del antiguo Quality. Conviene especificar el nivel de forma explícita y comprobar los resultados con un conjunto de pruebas fijo.
P4: ¿Cómo puedo confirmar qué modelo está utilizando realmente mi sistema?
Lee y registra el campo `model` de la respuesta y compáralo con el modelo solicitado. Registra también el costo real calculado a partir de `cost_in_usd_ticks`, si está disponible. Si haces la invocación a través de plataformas de terceros como APIYI apiyi.com, comprueba además si estos campos se transmiten sin modificaciones. Consulta la página oficial de cada plataforma para conocer la disponibilidad y los precios de sus modelos.
P5: Si no me gustan los resultados del nuevo modelo, ¿puedo volver al antiguo Quality?
No des por hecho que puedas hacerlo. La retirada la impone el proveedor y no se garantiza el acceso al modelo que estaba detrás del antiguo Quality. Puedes ajustar el parámetro quality, cambiar a un modelo alternativo que hayas validado para tu caso de uso o desactivar temporalmente la función afectada. Tener preparada una alternativa que ya hayas probado te permitirá reaccionar con más calma; puedes usar la interfaz unificada de APIYI apiyi.com para cambiar entre modelos y probarlos.
P6: ¿Image 2.0 es mejor que la versión anterior?
No hay una respuesta única. Cuando xAI lo lanzó, afirmó que ocupaba el segundo puesto en las clasificaciones de Arena de texto a imagen y edición de imágenes de aquel momento; ese dato corresponde al 7 de agosto. Una instantánea de Arena de finales de octubre lo situaba en el quinto puesto de la clasificación general de edición de una sola imagen y en el sexto de texto a imagen. Algunos usuarios de la comunidad también han expresado su insatisfacción con el acabado realista y la conservación de la imagen original. Las capacidades anunciadas, las pruebas independientes y las preferencias subjetivas son dimensiones distintas: la referencia más fiable es el conjunto de pruebas de tu propio caso de uso.
Claves para gestionar las versiones de API de IA
- Una invocación exitosa no significa que el modelo no haya cambiado: el identificador antiguo de Grok Imagine no devuelve ningún error, pero ya redirige silenciosamente a 2.0 Low.
- Los alias pueden encadenar redirecciones: pro → quality → 2.0 Low. No basta con revisar el identificador configurado.
- Los valores predeterminados también cambian: auto selecciona actualmente low para generación y medium para edición; conviene especificarlos de forma explícita.
- Para calcular los costes, revisa la factura real: las tareas de edición incluyen el coste de entrada de la imagen de referencia, así que la reducción total no coincide con la del precio de salida.
- HTTP 200 no garantiza que la tarea haya tenido éxito: una tarea asíncrona con estado failed también puede devolver 200.
- Cada proveedor aplica una política distinta: las redirecciones, los errores, los cambios en caliente de Latest y las instantáneas fijadas requieren tratamientos diferentes.
- Puedes empezar por los registros: en APIYI apiyi.com, usa el crédito de prueba para registrar tanto el modelo solicitado como el modelo ejecutado.
Resumen
Las principales lecciones de esta migración de Grok Imagine son:
- Las políticas de compatibilidad pueden ocultar cambios: xAI optó por una redirección fluida para los clientes, por lo que los cambios de modelo, nivel y precio unitario no se manifiestan como errores.
- La gestión de versiones necesita mecanismos propios: registrar tanto el modelo solicitado como el ejecutado, hacer seguimiento del coste real y validar los resultados a nivel de negocio son tareas que la supervisión convencional de disponibilidad no cubre.
- El plan de contingencia debe prepararse de antemano: no se puede revertir la retirada forzosa de un modelo por parte del proveedor; solo puedes contar con modelos alternativos y configuraciones de parámetros que hayas probado previamente.
Te recomendamos hacer una revisión hoy mismo: busca los identificadores antiguos de modelos en el código, compáralos con el campo model de las respuestas, fija explícitamente el parámetro quality para las tareas de edición y generación, y prepara un conjunto de muestras de prueba. Puedes usar APIYI apiyi.com para montar un entorno de comparación de varios modelos mediante una interfaz unificada y mejorar la observabilidad de las versiones antes del próximo cambio del proveedor.
📚 Referencias
- Guía de migración de modelos de imagen de xAI del 02-11-2026: reglas de retirada y redirección
- Enlace:
docs.x.ai/developers/migration/imagine-image-quality-nov-2 -
Descripción: fuente de primera mano sobre los identificadores retirados, los modelos que los reemplazan, los niveles de calidad y el alcance del cambio
-
Historial de retiradas de xAI del 15-05-2026: registro de migración del identificador pro
- Enlace:
docs.x.ai/developers/migration/may-15-retirement -
Descripción: recurso clave para entender las redirecciones encadenadas
-
Página oficial de precios y modelos Image 2.0 de xAI: resolución y precio por nivel
- Enlace:
docs.x.ai/developers/pricing -
Descripción: base para calcular los costos de las imágenes generadas y de las imágenes de referencia de entrada
-
Documentación de parámetros de generación de imágenes de xAI: valor predeterminado de quality y estado asíncrono
- Enlace:
docs.x.ai/developers/model-capabilities/images/generation -
Descripción: comportamiento de auto y estados HTTP del modo deferred
-
xAI Cost Tracking: campo de costo real por solicitud
- Enlace:
docs.x.ai/developers/cost-tracking -
Descripción: significado de cost_in_usd_ticks y cómo convertirlo
-
Documentación de retirada de modelos de Anthropic: las cuatro etapas del ciclo de vida de un modelo
- Enlace:
docs.anthropic.com/en/docs/about-claude/model-deprecations -
Descripción: referencia para comparar la política de fallo de solicitudes tras la retirada de un modelo
-
Documentación de versiones de modelos de Google Gemini: diferencias entre Stable y Latest
- Enlace:
ai.google.dev/gemini-api/docs/models -
Descripción: mecanismo de cambio automático de alias
-
Ingeniería de indicaciones y descripción general de la API de OpenAI: fijación de snapshots y recomendaciones de evaluación
- Enlace:
developers.openai.com/api/docs/guides/prompt-engineering -
Descripción: recomendaciones oficiales para fijar snapshots en producción y crear conjuntos de evaluación
-
Google SRE Canary Release: método de despliegue gradual
- Enlace:
sre.google/workbook/canarying-releases/ -
Descripción: validación con una pequeña parte del tráfico para reducir el alcance de los cambios
-
Convenciones semánticas de IA generativa de OpenTelemetry: atributos del modelo en solicitudes y respuestas
- Enlace:
opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/ - Descripción: definiciones de gen_ai.request.model y gen_ai.response.model
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI. Para más recursos de integración, visita el centro de documentación en docs.apiyi.com.