Nota del autor: tomando como ejemplo una solicitud de control de calidad de atención al cliente, desglosamos la aceptación de salidas, la conservación del estado de la conversación y la recuperación de resultados en segundo plano de GPT-6.2 Sol en la Responses API.
Conclusión primero: Para integrar GPT-6.2 Sol en un sistema de producción, hay que dividir una misma tarea de negocio en cuatro comportamientos y definir criterios de aceptación para cada uno. Esos cuatro comportamientos son el feedback inmediato en la interfaz, el resultado apto para almacenarse, el contexto entre turnos y el estado final. Los eventos en streaming solo se encargan de la visualización; antes de almacenar, hay que obtener la respuesta completa y superar la validación del esquema y las reglas de negocio. En la información entre turnos, primero hay que decidir quién mantiene el estado. Las tareas en segundo plano solo reconocen el ID de respuesta y el estado terminal; las notificaciones pueden duplicarse, por lo que las escrituras deben ser idempotentes.
Para lograr estos cuatro puntos hay dos requisitos previos. Primero, cuando se necesiten herramientas integradas o personalizadas, hay que seguir las notas de migración de GPT-6.2 y usar Responses API; este artículo también se limita a analizar el comportamiento de ejecución de Responses. Segundo, si se invoca a través de una plataforma agregadora, la disponibilidad de capacidades como el modo en segundo plano y Webhook dependerá de la configuración actual de la plataforma. En APIYI apiyi.com, gpt-6.2-sol ya figura públicamente con dos entradas: responses y chat.
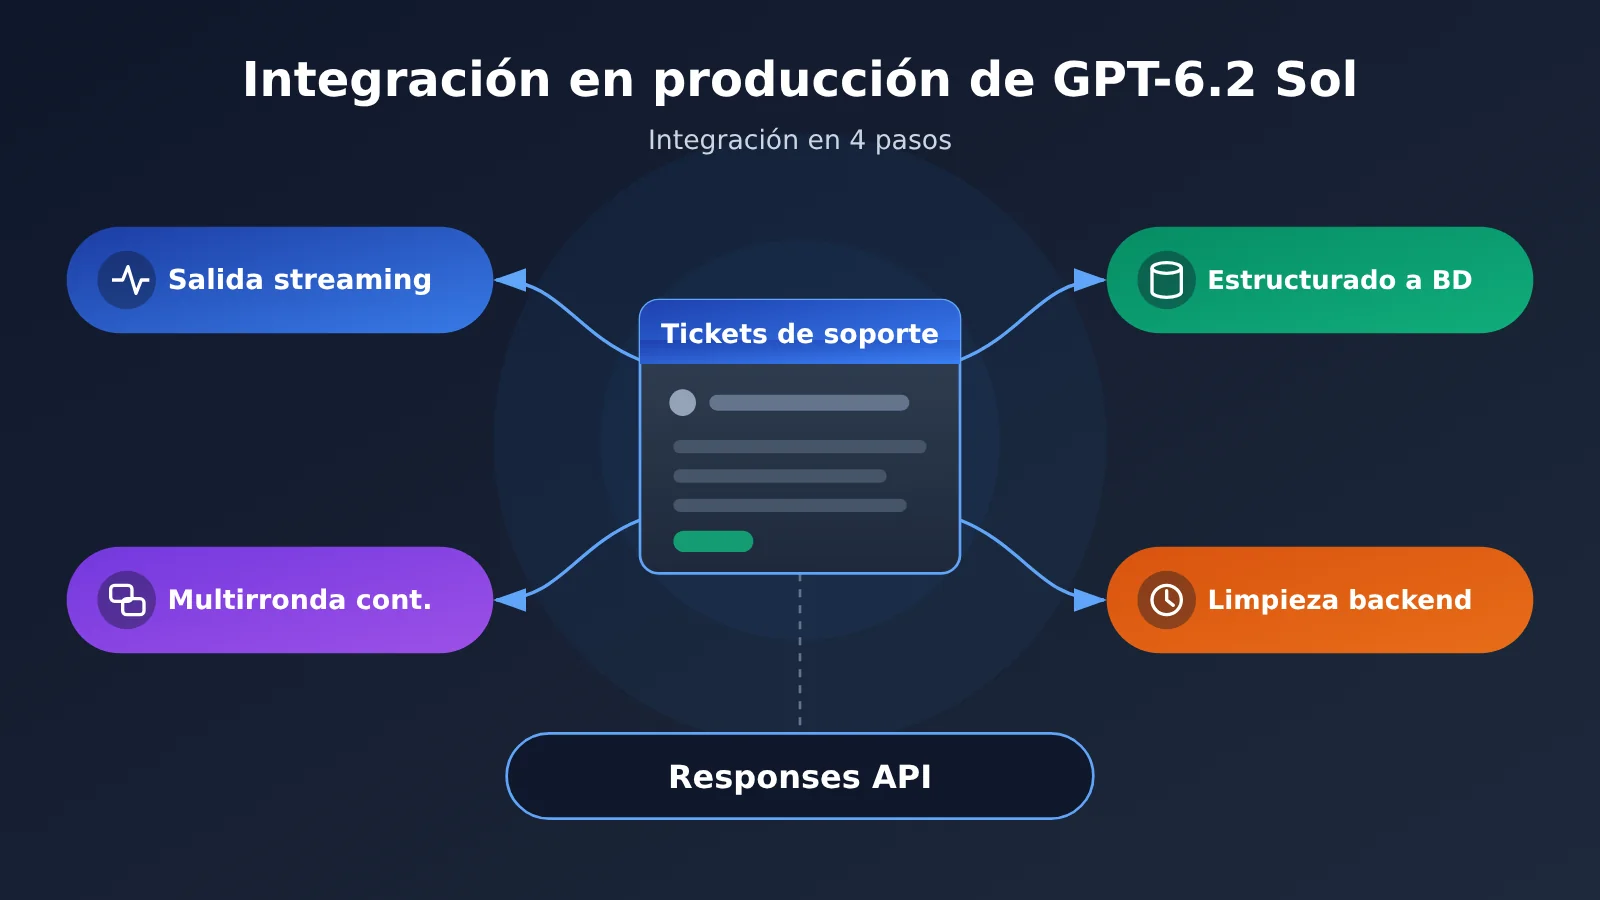
GPT-6.2 Sol: mapa de conocimiento para la integración en producción
Todo el artículo gira en torno a un flujo: iniciar solicitud → mostrar → continuar → releer → validar. El siguiente diagrama de flujo indica el resultado de cada paso y la sección del texto que le corresponde.
Iniciar solicitud (model=gpt-6.2-sol, Responses API)
  │
  ├─▶ Mostrar【Sección 1】
  │     Eventos incrementales → la página muestra en tiempo real las observaciones de control de calidad
  │     Evento de estado final → finaliza la carga; respuesta completa → Schema + validación de negocio → guardado en base de datos / revisión manual
  │
  ├─▶ Continuar【Sección 2】
  │     Historial autogestionado / previous_response_id / Conversation
  │     Separar las reglas permanentes (developer) de las instrucciones de la ronda actual (instructions)
  │
  ├─▶ Releer【Sección 3】
  │     envío en background → guardar ID de respuesta → verificación de firma y deduplicación del Webhook → relectura por ID → guardar estado final
  │
  └─▶ Validación final【Sección 4】
        éxito / incompleto / notificación duplicada / desconexión del cliente / cambio de Schema
Índice de integración de GPT-6.2 Sol
| Sección | Pregunta que responde | Qué aporta al resto del texto | Qué podrás hacer al terminar |
|---|---|---|---|
| 1. Streaming y salida estructurada | Cómo ver el flujo en la página y cómo recibir el resultado en el sistema | Define los criterios de “completado” y “apto para almacenar” | Distinguir la ruta de visualización de la ruta de almacenamiento |
| 2. Estado multi-turno | Cómo conectar la siguiente solicitud con la ronda anterior | Determinar quién conserva el estado y bajo qué condiciones | Cambiar solo el foco de la ronda actual sin romper el prefijo |
| 3. Tareas en segundo plano | Cómo guardar el resultado cuando el usuario abandona la página | La correspondencia entre el ID de respuesta, el ID de tarea y el estado final | Implementar verificación de firma, deduplicación y escritura idempotente |
| 4. Validación para el lanzamiento | Qué comportamientos deben validarse de antemano | Resume los criterios de las tres primeras secciones | Generar un registro de regresión trazable |
Las secciones 1 a 3 corresponden, cada una, a una ruta de ejecución. Si solo vas a implementar una, puedes consultar la que necesites. La sección 4 depende de los estados definidos en las tres primeras, así que conviene dejarla para el final.
Términos de GPT-6.2 Sol que conviene conocer
| Término | Explicación |
|---|---|
| SSE | Protocolo mediante el cual el servidor envía eventos al cliente en orden a través de una única conexión HTTP. |
| Structured Outputs | Función de la API que exige que el contenido estructurado devuelto en una respuesta exitosa cumpla con un JSON Schema compatible. |
| Respuesta de rechazo | Elemento de contenido devuelto cuando el modelo rechaza explícitamente completar la tarea; requiere un flujo aparte. |
| Estado de la conversación | Contexto, como mensajes y resultados de herramientas, que se conserva para solicitudes posteriores. |
| Elemento de razonamiento cifrado | Elemento de respuesta cifrado que sirve para continuar el estado de razonamiento y puede devolverse junto con el contexto. |
| Prefijo | Secuencia de contexto al inicio de la solicitud actual que coincide exactamente con la de la ronda anterior. |
| Ventana de finalización | Rango de tiempo objetivo para completar esta respuesta, definido después de que el servicio acepta la solicitud en segundo plano. |
| Webhook | Notificación firmada que el servidor envía activamente a la URL indicada por la aplicación. |
| Estado final | Estado definitivo después de que la tarea se completa, falla, queda incompleta o se cancela. |
| Idempotente | Propiedad por la que procesar repetidamente el mismo callback o la misma tarea produce un único efecto de negocio. |
1. Salida en streaming y validación estructurada de GPT-6.2 Sol
1.1 Las dos rutas de salida de GPT-6.2 Sol
Veamos primero un escenario de control de calidad en atención al cliente. El agente de turno abre un ticket y la página debe mostrar de inmediato las observaciones de supervisión que genera el modelo. El resultado del mismo análisis también debe guardarse en la base de datos de control de calidad para las estadísticas de fin de día. Estas dos necesidades tienen definiciones distintas de «completado», así que conviene tratarlas como dos rutas separadas.
| Ruta | Consumidor | Señal de la que depende | Condición para considerar «completado» | Destino en caso de fallo |
|---|---|---|---|---|
| Ruta de visualización | Página del agente | Evento incremental response.output_text.delta |
Recibir response.completed o un evento terminal de fallo |
Aviso en la página, conservando lo ya mostrado |
| Ruta de almacenamiento | Base de datos de control de calidad | Objeto de respuesta completo | Pasan tanto la validación de esquema como la validación de negocio | Rechazo, respuesta incompleta y formato incorrecto van a revisión manual |
Cuando se configura stream=true en una solicitud en streaming, el servidor envía eventos sucesivamente mediante HTTP SSE. La página solo necesita ir añadiendo a la vista el texto de response.output_text.delta. El estado de carga debe terminar cuando llegue un evento terminal; que el texto deje de aparecer no significa que la tarea haya terminado.
1.2 Ejemplo de visualización en streaming de GPT-6.2 Sol
El siguiente ejemplo solo se encarga de la visualización. Entrega el texto incremental al frontend y finaliza la espera cuando llega al estado terminal:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Punto de entrada compatible con OpenAI de APIYI
)

stream = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "你是客服质检督查员,只依据工单原文给出意见。"},
        {"role": "user", "content": "工单 #A1024:客户三次催单未获回复……"},
    ],
    stream=True,
)

for event in stream:
    if event.type == "response.output_text.delta":
        push_to_page(event.delta)          # Añadir en tiempo real a la página
    elif event.type == "response.completed":
        finish_loading(event.response.id)  # Finalizar la carga con el estado terminal
    elif event.type in ("response.failed", "response.incomplete"):
        show_error(event.type)             # Mostrar por separado fallo e incompleto
push_to_page, finish_loading y similares son funciones del lado del negocio. La lista completa de eventos de estado terminal debe consultarse en la documentación oficial de respuestas en streaming.
1.3 Orden de validación de la salida estructurada de GPT-6.2 Sol
En la Responses API, la salida estructurada se declara en text.format, no dentro del mensaje. Cuando la ruta de persistencia recibe la respuesta completa, se decide en el siguiente orden:
- Revisa el estado de la respuesta. Una respuesta incompleta (
statuscon valorincomplete) pasa directamente a revisión manual; no se intenta analizar un JSON a medias. - Revisa los elementos de contenido. Si aparece un elemento de contenido de tipo rechazo, se sigue el flujo de rechazo, no se trata como error de formato.
- Analiza el JSON y realiza la validación del esquema.
- Realiza validaciones de negocio: el ticket original existe; los campos faltantes deben ser claramente visibles y no pueden completarse de forma silenciosa.
Ver el código completo de persistencia estructurada de GPT-6.2 Sol
import json
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

QA_SCHEMA = {
    "type": "object",
    "properties": {
        "ticket_id": {"type": "string"},
        "verdict": {"type": "string", "enum": ["合格", "需整改", "信息不足"]},
        "issues": {"type": "array", "items": {"type": "string"}},
        "missing_fields": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["ticket_id", "verdict", "issues", "missing_fields"],
    "additionalProperties": False,
}

resp = client.responses.create(
    model="gpt-6.2-sol",
    input=[{"role": "user", "content": "请质检工单 #A1024:……"}],
    text={"format": {"type": "json_schema", "name": "qa_result",
                     "schema": QA_SCHEMA, "strict": True}},
)

def route(resp):
    if resp.status == "incomplete":
        return ("manual_review", "incomplete", resp.incomplete_details)
    for item in resp.output:
        for part in getattr(item, "content", []) or []:
            if part.type == "refusal":
                return ("manual_review", "refusal", part.refusal)
    try:
        data = json.loads(resp.output_text)
    except json.JSONDecodeError:
        return ("manual_review", "bad_json", None)
    if not ticket_exists(data["ticket_id"]):
        return ("manual_review", "unknown_ticket", data)
    return ("save", "ok", data)

print(route(resp), resp.id)
Ten en cuenta que aprobar la validación del esquema solo indica que la estructura es correcta, no que el contenido lo sea. La comprobación de si existe el número de ticket y de si los campos faltantes se señalan fielmente debe hacerse en la capa de negocio.
🎯 Consejo técnico: en un entorno de pruebas, puedes iniciar tanto solicitudes en streaming como no streaming a través de APIYI apiyi.com, y comparar el estado terminal y el resultado de persistencia del mismo ticket en ambas rutas. Así puedes confirmar de antemano que la lógica de carga del frontend y las ramas de persistencia no interfieren entre sí.
2. Continuidad del estado en conversaciones multiturno de GPT-6.2 Sol
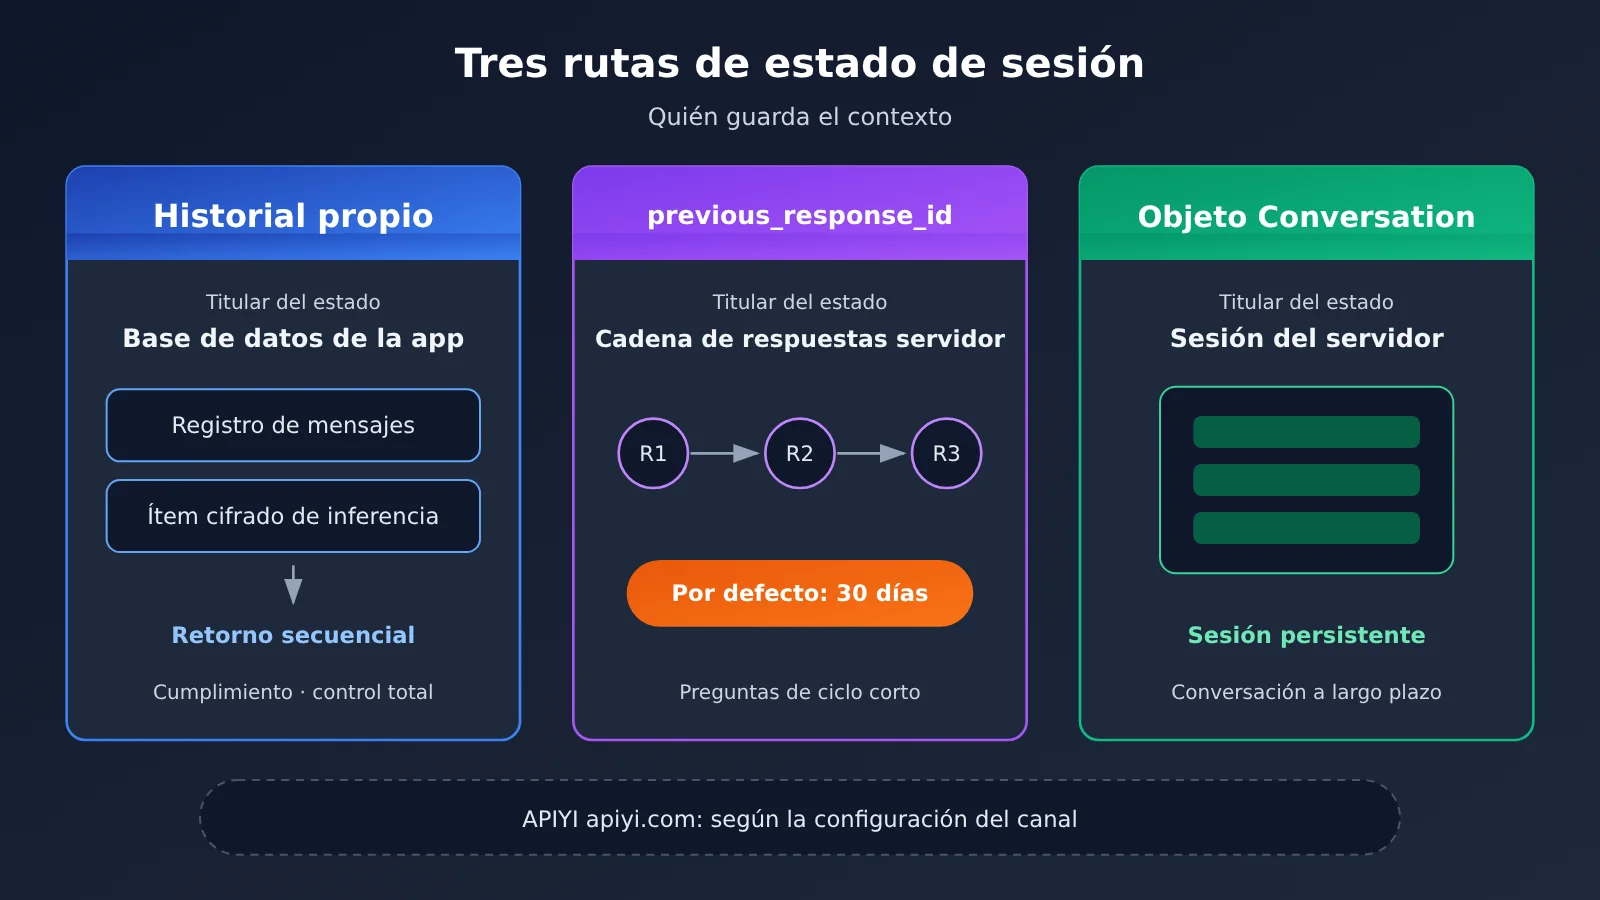
2.1 Comparación de las tres rutas de estado de GPT-6.2 Sol
El agente añade nuevos hechos a la misma orden de trabajo y quiere que el modelo continúe el análisis desde la ronda anterior. En ese momento, la primera pregunta que hay que responder es: ¿quién conserva el contexto?
| Ruta | Titular del estado | Condiciones de retención | Escenario adecuado | Plataforma disponible |
|---|---|---|---|---|
| Historial autogestionado | La propia aplicación | Lo decide la aplicación; hay que reenviar los mensajes en el orden original junto con los elementos de respuesta necesarios | Cuando hay requisitos de cumplimiento normativo o se necesita control total del contexto | API oficial, APIYI apiyi.com |
previous_response_id |
Cadena de respuestas del servidor | Solo se puede continuar mientras la respuesta siga disponible; el objeto de respuesta se guarda 30 días por defecto | Repreguntas continuas de ciclo corto | Según la configuración actual del canal |
| Objeto Conversation | Objeto de conversación del servidor | Los elementos adjuntos a Conversation se rigen por las reglas de retención de ese objeto | Conversaciones que necesitan una persistencia más duradera | Según la configuración actual del canal |
Si eliges el historial autogestionado y además quieres que el razonamiento sea continuo, no basta con reenviar texto. Debes conservar todos los elementos de respuesta necesarios y reproducirlos en orden, incluidos los elementos de razonamiento cifrados.
2.2 Cómo cambiar solo el foco de revisión con GPT-6.2 Sol
Supongamos que en la segunda ronda solo quieres cambiar el foco de la revisión de “tiempo de respuesta” a “cumplimiento del guion”. La forma correcta es: colocar las reglas generales de control de calidad en el primer mensaje developer de la cadena, y escribir el foco específico de esta ronda en el instructions de nivel superior. instructions solo afecta a la solicitud en la que se proporciona y no contamina las rondas posteriores.
first = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "通用质检规则:依据工单原文;缺项必须列出……"},
        {"role": "user", "content": "质检工单 #A1024,关注响应时效。"},
    ],
)

second = client.responses.create(
    model="gpt-6.2-sol",
    previous_response_id=first.id,
    instructions="本轮只审查话术合规,不重复时效结论。",  # solo se aplica a esta solicitud
    input=[{"role": "user", "content": "补充:坐席第二次回复使用了模板话术。"}],
)
Escribirlo así tiene otra ventaja: la primera regla no cambia y el prefijo también se mantiene estable.
2.3 Riesgo de cambio de prefijo en GPT-6.2 Sol
GPT-6.2 puede eliminar los elementos de razonamiento correspondientes en varias situaciones: reescribir el historial antiguo, hacer un cambio parcial de modelo (por ejemplo, una degradación) y cambiar de usuario u organización. En una sesión Standard de un solo agente que necesita continuidad, si quieres ajustar el nivel de razonamiento o el Schema de salida, debes agregar un elemento configuration_update aplicable en lugar de modificar la configuración antigua. Los campos concretos de ese elemento se rigen por la guía de migración de GPT-6.2.
Cuando haya que actualizar reglas de largo plazo, agrega un nuevo mensaje developer al final del contexto; no edites las reglas antiguas ni modifiques la configuración anterior de herramientas y Schema. Aunque el prefijo se mantenga estable, que la caché acierte sigue dependiendo de la solicitud concreta y de las condiciones de procesamiento; no lo tomes como un resultado garantizado.
3. Persistencia en base de datos de tareas en segundo plano de GPT-6.2 Sol
3.1 Envío en segundo plano y ventanas de finalización de GPT-6.2 Sol
El resumen de tickets pendientes de revisión al cierre del día puede tardar bastante, y los agentes no van a quedarse todo el tiempo mirando la página. Para este tipo de tareas, envíalas con background: true. Justo después de enviarlas, guarda de forma persistente el ID de respuesta devuelto y mapéalo uno a uno con el ID de tarea de negocio.
La ventana de finalización se elige según el tiempo de espera aceptable; el valor predeterminado es soonest. 2h y 8h son ventanas con descuento dentro de Standard, actualmente forman parte de una funcionalidad en pruebas públicas y no permiten activar streaming al enviar. Los nombres de los parámetros de la ventana de finalización y los requisitos de almacenamiento se rigen por la documentación del modo en segundo plano.
| Ventana de finalización | Uso previsto | Streaming | Tareas de control de calidad adecuadas |
|---|---|---|---|
soonest (predeterminada) |
Completar lo antes posible | Según la documentación del modo en segundo plano | Revisiones que hay que repasar durante el turno |
2h |
Ventana con descuento de Standard, pruebas públicas | No se activa | Resumen después del turno |
8h |
Ventana con descuento de Standard, pruebas públicas | No se activa | Resumen por lotes al cierre del día |
3.2 Webhooks de GPT-6.2 Sol: verificación de firma, deduplicación y relectura
Mientras la tarea está en cola o en curso, basta con consultar el mismo ID de forma continuada. Si recibes un evento de finalización, procésalo en este orden:
- Verifica la firma. Si falla, descarta el evento directamente.
- Deduplica usando
webhook-id. Una misma notificación puede reenviarse. - Vuelve a leer la respuesta completa usando
event.data.id. La notificación en sí no se usa como resultado. - Escribe de forma idempotente el estado final y el resultado usando el ID de tarea.
Ver el código de recuperación de tareas en segundo plano de GPT-6.2 Sol
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Enviar
job = client.responses.create(
    model="gpt-6.2-sol",
    background=True,
    input=[{"role": "user", "content": "汇总今日待审工单摘要:……"}],
)
db.save_task(task_id="QA-20261120-01", response_id=job.id, status=job.status)

# Gestión del webhook
def on_webhook(headers, raw_body):
    event = verify_and_parse(headers, raw_body)        # Verificación de firma; si falla, lanzar excepción
    if db.seen_webhook(headers["webhook-id"]):         # Deduplicación
        return 200
    db.mark_webhook(headers["webhook-id"])
    resp = client.responses.retrieve(event.data.id)    # Releer la respuesta completa
    task_id = db.task_by_response(resp.id)
    db.upsert_result(task_id, status=resp.status,      # Escritura idempotente por ID de tarea
                     body=resp.output_text if resp.status == "completed" else None)
    return 200
Cuando el usuario cierra la página y vuelve más tarde, el frontend solo tiene que consultar la base de datos local con el ID de tarea de negocio. Si el estado aún no ha llegado al estado final, el servidor sigue consultando con el ID de respuesta guardado.
Hay que prestar especial atención a la retención de datos. El modo en segundo plano almacena temporalmente los datos de respuesta para permitir la relectura. Esto no cambia aunque se configure store: false o la organización tenga ZDR activado, así que contrasta con la documentación de control de datos para confirmar si es aceptable.
💡 Consejo de integración: La URL de callback del webhook y el modo en segundo plano requieren compatibilidad por parte del canal. Antes de integrarte mediante APIYI apiyi.com, conviene confirmar primero si el grupo de cuenta actual tiene habilitados el modo en segundo plano y la capacidad de callback. Si aún no están disponibles, puedes validar primero la máquina de estados mediante sondeo por ID de respuesta.
4. Lista de verificación de aceptación del lanzamiento de GPT-6.2 Sol
4.1 Tabla de aceptación sintética de GPT-6.2 Sol
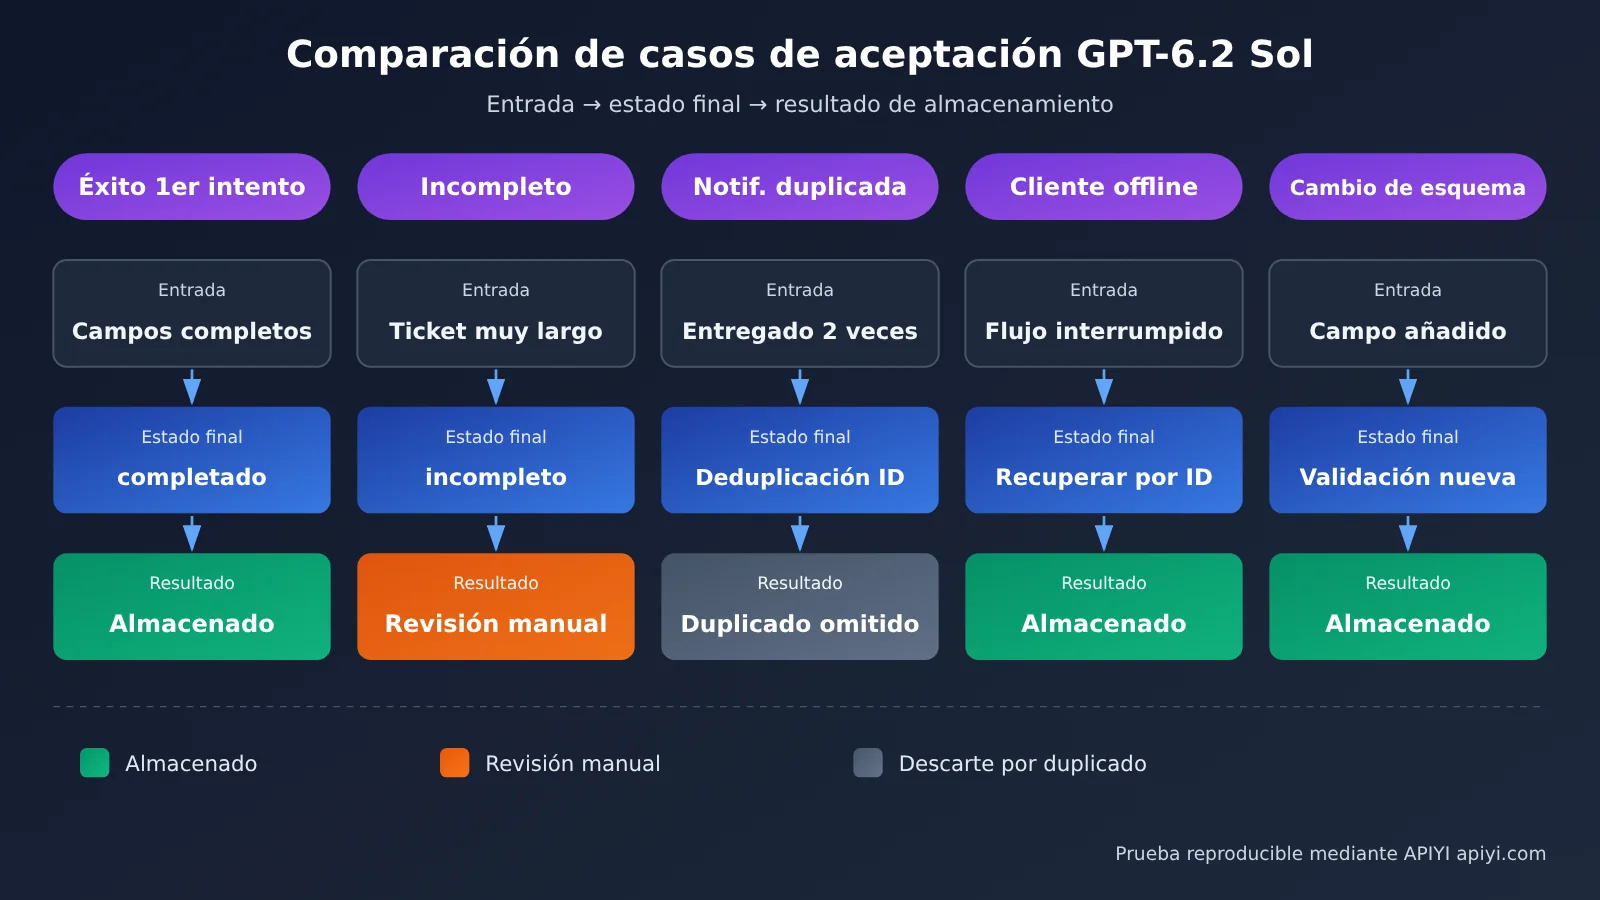
La siguiente tabla de aceptación continúa con el caso sintético de control de calidad de atención al cliente, convirtiendo los criterios de decisión de las tres secciones anteriores en casos de uso ejecutables, uno por uno.
| Caso de uso | Condiciones de entrada | Estado o resultado esperado |
|---|---|---|
| Éxito en el primer intento | Un ticket real existente, con todos los campos completos | Estado final completed; validación de Schema y de negocio superada; se escribe un resultado según el ID de la tarea |
| Una respuesta incompleta | Reducir artificialmente el límite de salida, o usar un ticket extremadamente largo | Estado incomplete; no se analiza el JSON; pasa a revisión manual y se registra el motivo |
| Una notificación duplicada | El mismo webhook-id se entrega dos veces |
La segunda se deduplica; la tabla de resultados contiene solo un registro |
| Una desconexión del cliente | Se corta la conexión del navegador durante el streaming | Se recupera el estado mediante el ID de respuesta ya guardado; el resultado almacenado no se ve afectado por la página |
| Un cambio de Schema | Se añade un campo obligatorio a mitad de la sesión | El ajuste se completa mediante configuración adicional, sin reescribir la configuración anterior; los nuevos resultados se validan con el nuevo Schema |
Cada caso de uso debe guardar cuatro datos: el ID del modelo invocado (gpt-6.2-sol), los parámetros de ejecución, el ID de respuesta y la versión de configuración del lado de la aplicación. Si surge un problema, estos cuatro datos permiten localizar exactamente qué solicitud concreta fue.
4.2 Criterios para la regresión de GPT-6.2 Sol
| Elemento | Contenido registrado | Descripción |
|---|---|---|
| Modelo | gpt-6.2-sol |
Se cita el ID público de la ficha del modelo |
| Endpoint | Responses | Las llamadas a funciones y las herramientas integradas siguen esta ruta |
| Nivel de razonamiento | El nivel realmente utilizado | Ni Responses ni Chat Completions aceptan none |
| Uso | usage.output_tokens y el subelemento de tokens de razonamiento que contiene |
La facturación de salida ya incluye los tokens de razonamiento |
| Cambio de tramo de facturación | Si la entrada de una sola solicitud supera 272K | La interfaz pública de precios de APIYI establece el cambio de tramo en 272.000 tokens de entrada; la facturación real se rige por la factura |
Al migrar sistemas antiguos, hay que verificar por separado el endpoint, los parámetros de la solicitud, la entrada multiturno, el contexto de razonamiento y la caché. Una vez completada la verificación, se ejecuta la regresión con el mismo lote de casos de uso tanto en la solicitud de ejemplo como en la solicitud de producción.
🚀 Recomendación de aceptación: los cinco tipos de casos de uso se pueden incluir en CI y ejecutar automáticamente cada vez que se modifique el Schema o se cambie de canal. Gracias a la Key unificada de APIYI apiyi.com, es posible comparar las diferencias de comportamiento entre distintos grupos sobre el mismo conjunto de casos de uso.
Si los cinco casos de uso de la tabla de aceptación pasan todos y cada uno puede rastrearse mediante su ID de respuesta, significa que esta cadena de control de calidad ya cumple las condiciones para salir a producción.
Referencias
- Ficha del modelo GPT-6.2 Sol: ID del modelo, contexto y reglas de facturación
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Enlace:
- Guía de migración a GPT-6.2: selección de endpoints, cambios de prefijo y actualización de configuración
- Enlace:
developers.openai.com/api/docs/guides/latest-model
- Enlace:
- Respuestas en streaming y salida estructurada: eventos SSE y
text.format- Enlace:
developers.openai.com/api/docs/guides/streaming-responses
- Enlace:
- Estado de la conversación:
previous_response_idy Conversations- Enlace:
developers.openai.com/api/docs/guides/conversation-state
- Enlace:
- Modo en segundo plano y webhooks: ventana de finalización, verificación de firma y deduplicación
- Enlace:
developers.openai.com/api/docs/guides/background
- Enlace:
Autor: equipo técnico de APIYI
Consultas técnicas: le invitamos a contactarnos desde la página principal del sitio de APIYI; más material de integración está disponible en el centro de documentación docs.apiyi.com