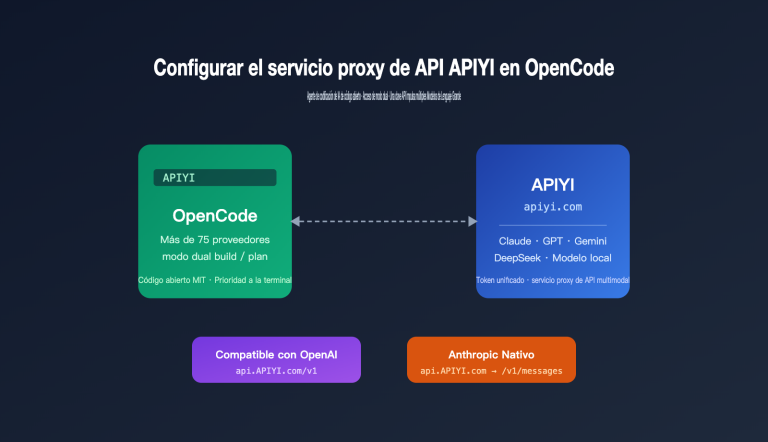
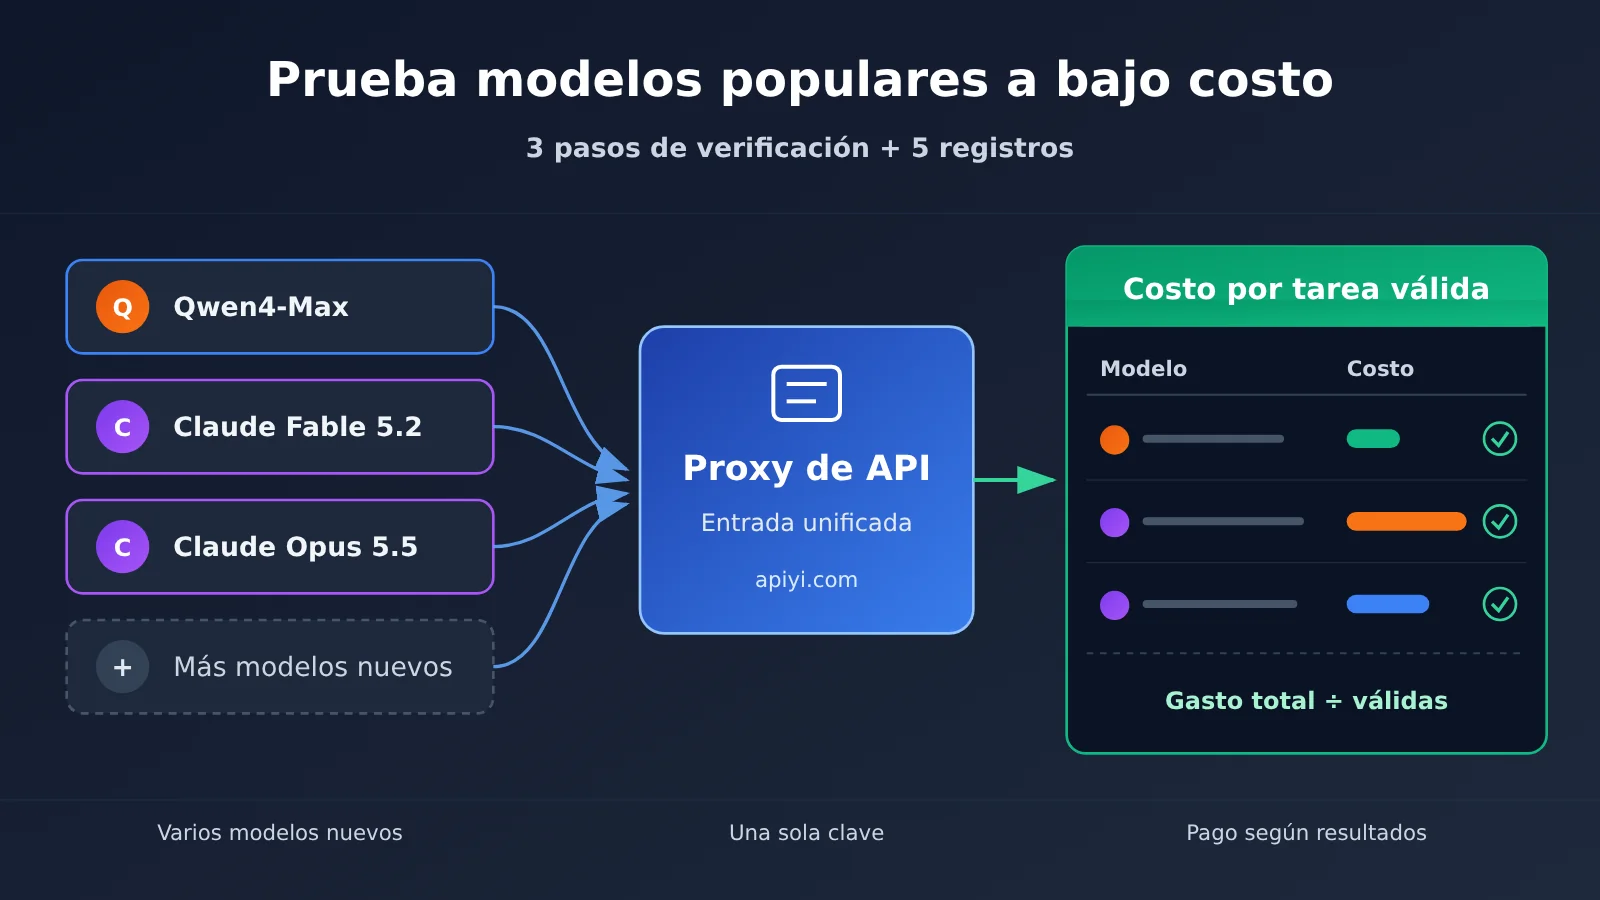
Cuando se lanzan muchos modelos nuevos a la vez y quieres probar con bajo costo todos los populares, la forma más sencilla es completar la integración mediante un único punto de entrada de un servicio proxy de API. Así te ahorras el trabajo repetitivo de registrarte proveedor por proveedor y configurar cada SDK. Pero un punto de entrada unificado solo resuelve «cómo conectarse», no «a quién elegir». El orden correcto es revisar primero el catálogo de modelos, los permisos de la clave y los endpoints, y después comparar, con un mismo lote de tareas reales, los resultados aceptables y el gasto total. En este artículo tomamos APIYI apiyi.com como ejemplo para mostrar este proceso de prueba con presupuesto pequeño y criterios de aceptación.
¿Qué puedes aprender al terminar de leer este artículo?
- Los ID exactos de modelo, los endpoints disponibles y los grupos de Qwen4-Max y Claude Fable 5.2 en el catálogo actual.
- Un conjunto reutilizable de código básico de integración y un método para consultar primero «qué modelos puede ver esta clave».
- Cómo controlar el costo de la prueba con tareas de muestra, registros de uso (usage) y facturación, y cómo decidir según el «costo por tarea aceptable».
Índice: en la sección «Hechos objetivos» se enumeran primero las entradas del catálogo, las condiciones de integración y la política de prueba con fecha de corte 2026-11-17, y se aclara a quién pertenecen los precios cotizados y las puntuaciones de ranking que aparecen en materiales de terceros. La sección «Análisis y juicio» aborda tres puntos: cómo diseñar una muestra con las mismas tareas, cómo registrar los costos y la brecha entre que el catálogo sea visible, la invocación sea exitosa y el resultado sea aceptable. Al final se incluye una tabla de registro para que cada lector la complete por su cuenta.
Conceptos previos: lo que necesitas saber antes de probar modelos populares con un servicio proxy de API
| Concepto | Breve explicación |
|---|---|
| Servicio proxy de API | Una pasarela que conecta las solicitudes a modelos de varios proveedores en un único punto de acceso |
| ID del modelo | Cadena que se usa en la solicitud para especificar con exactitud el modelo, por ejemplo qwen4-max |
| Endpoint | Ruta de solicitud concreta mediante la que el servicio ofrece una capacidad, como chat, responses o messages |
| Grupo de tokens | Configuración que define qué canales de modelos puede usar una clave y con qué coeficiente de facturación se cobra |
| usage | Registro de consumo incluido en la respuesta, que sirve para verificar los tokens realmente consumidos en esta operación |
| Lectura de caché | Reutilización de un prefijo de entrada ya procesado; su precio puede ser distinto del de una entrada nueva |
| Costo por tarea válida | Costo total de todos los intentos ÷ número de tareas que finalmente cumplen los criterios de aceptación |
Resumen de impacto: qué significa probar modelos con un servicio proxy de API para distintos perfiles
- Desarrolladores que se conectan por primera vez: con una URL base y una clave API puedes cambiar de modelo, sin tener que configurar cuentas y SDK en varias plataformas.
- Equipos que ya tienen un negocio en marcha: pueden probar nuevos modelos con sus propios criterios de aceptación, sin depender de las conclusiones de rankings de terceros; aun así, parámetros como las llamadas a herramientas, la visión y el razonamiento deben adaptarse por separado.
- Usuarios particulares sensibles al presupuesto: limita primero el número de tareas y la longitud de entrada, y luego echa cuentas según los resultados aprovechables. No te fijes solo en el precio por cada millón de tokens.
Hechos objetivos: catálogo actual de modelos populares y condiciones de acceso del servicio proxy de API
Qué hay en el catálogo: entradas de qwen4-max y claude-fable-5-2
El registro de modelos legible por máquina que APIYI hace público (docs.apiyi.com/model-registry.json) declara que la fuente de datos es la interfaz de precios de la plataforma y que se generó en 2026-11-17T07:54:33Z. La tabla contiene 285 registros de modelos. Cabe tener en cuenta que se trata del número de registros del catálogo, no del número de modelos realmente disponibles para una cuenta concreta. Las tres entradas relevantes para este artículo son las siguientes:
| ID exacto del modelo | Endpoint del catálogo | Grupo (ID de máquina) | Precio de catálogo: entrada / salida / lectura de caché (USD por millón de tokens) |
|---|---|---|---|
claude-fable-5-2 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 8 / 40 / 0.2 |
claude-opus-5-5 |
chat / messages | ClaudeCode / ClaudeCodeReverse / ClaudeOfficial / default / svip | 4 / 20 / 0.2 |
qwen4-max |
chat / responses / messages | ClaudeCode / CodexResponses / default / svip | 1.5 / 4.5 / 0.075 |
Todos los precios anteriores son precios de catálogo del 2026-11-17, no lo que paga realmente una cuenta; la liquidación real también depende de factores como el grupo de tokens. Además, antes algunos blogs y anuncios antiguos afirmaron que estos dos modelos «aún no estaban disponibles». Esas afirmaciones solo reflejan el estado en el momento de su publicación y no permiten concluir si hoy se pueden invocar.
El registro incluye el grupo inverso (ClaudeCodeReverse) para Fable, pero los anuncios iniciales y las FAQ no habilitaban ese grupo. Por eso, este artículo usa como ejemplo el grupo default o ClaudeCode; no garantiza que el grupo inverso esté disponible. Si necesitas un canal oficial de reenvío, revisa el grupo ClaudeOfficial en la entrada de Fable.
Cómo conectarse: Base URL y verificación de visibilidad
La documentación de inicio rápido (docs.apiyi.com/getting-started, consultada el 2026-11-17) ofrece esta configuración básica:
- Base URL del SDK compatible con OpenAI:
https://api.apiyi.com/v1 - Base URL del SDK de Anthropic:
https://api.apiyi.com - Como primer paso, solicita
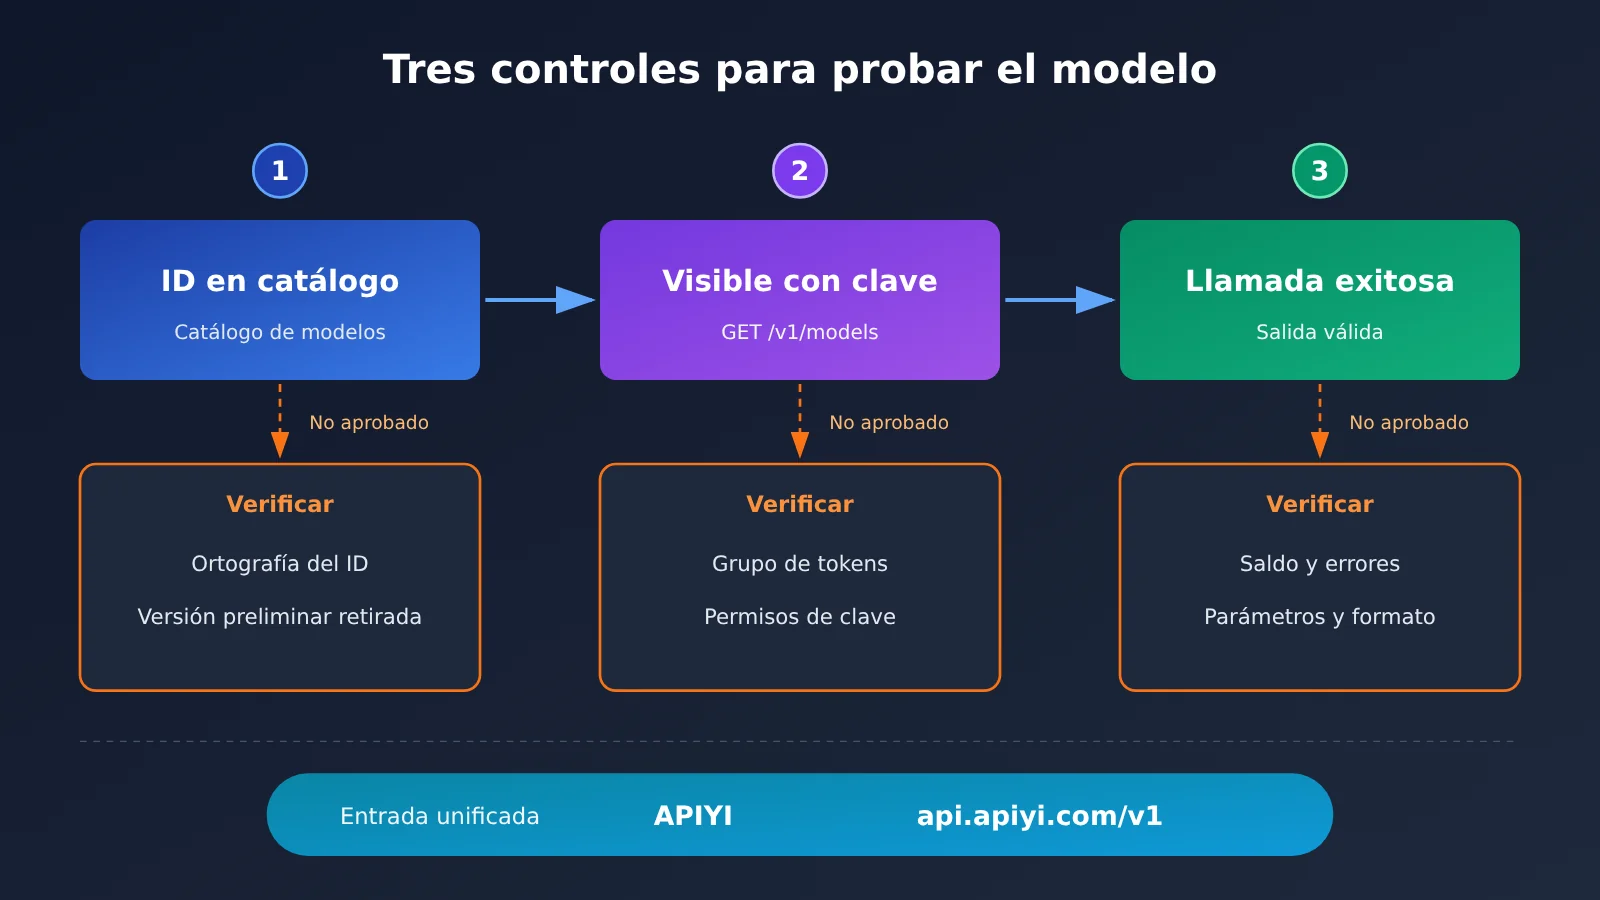
GET /v1/modelspara verificar qué modelos ve tu clave actual y, a continuación, elige el endpoint compatible.
Ambos modelos admiten el endpoint de chat, así que los ejemplos siguientes usan Chat Completions compatible con OpenAI. Primero confirma que el modelo es visible, luego envía una solicitud mínima e imprime el uso (usage):
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Entrada compatible con OpenAI de APIYI
)

visible = {m.id for m in client.models.list().data}
for model in ["qwen4-max", "claude-fable-5-2"]:
    if model not in visible:
        print(f"{model}: 本密钥不可见,检查令牌分组")
        continue
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是API中转站。"}],
        max_tokens=100,
    )
    print(model, r.usage, r.choices[0].message.content)
Cuota de prueba: consulta la página de inicio rápido vigente
La página de inicio rápido actual indica que al registrar una cuenta se incluye una cuota de prueba de 0.05 dólares, suficiente para validar la primera invocación sin recargar saldo. La afirmación de tarjetas anteriores, “regístrate y recibe 3 millones de tokens”, ya no aplica; lo que muestre la página de tu cuenta es lo que cuenta. Además, durante la redacción de este artículo no se realizó ninguna invocación de modelo de pago; todos los “costos” mencionados aquí son estimaciones basadas en los precios de catálogo, no facturas reales.
Qué comparte y qué no comparte la interfaz unificada
Según la documentación de capacidades de generación de texto de APIYI, la interfaz de chat unificada sirve para comparar la parte compartida de entrada y salida de texto. El historial de conversaciones multiturno lo organiza por su cuenta quien realiza la llamada. Las capacidades, la configuración de razonamiento y los parámetros opcionales siguen variando entre modelos; necesidades como llamada a herramientas, entrada visual o intensidad de razonamiento requieren adaptación individual. Reemplazar únicamente el campo model no exime de ese trabajo.
Cómo interpretar fuentes de terceros: precios y puntuaciones de OrcaRouter
Los materiales en inglés que se han discutido recientemente sobre estos dos modelos provienen, en su mayoría, del blog de OrcaRouter, otro proveedor de servicios de enrutamiento (publicado el 2026-11-16). La información clave es la siguiente:
- Fecha de lanzamiento: Qwen4-Max está disponible oficialmente desde el 2026-11-16; Claude Fable 5.2 se lanzó el 2026-11-09; el llamado “Claude Fable 5.5” no existe en la lista oficial de modelos de Anthropic.
- Puntuaciones y costo por tarea: los datos de Artificial Analysis citados en el artículo (consultados el 2026-11-17) muestran que el índice compuesto de Qwen4-Max es de aproximadamente 42.9, con un costo medido de 3.27 dólares por cada tarea del índice; Fable 5.2, en el nivel medium predeterminado, tiene un índice de 56.4 y un costo de 3.80 dólares por tarea. El artículo también señala que Qwen4-Max genera una cantidad de tokens de salida más bien elevada durante las evaluaciones.
- Retirada de las versiones de vista previa: los ID de vista previa como
qwen4-max-previewdejarán de estar disponibles el 2026-11-25 a las 24:00 (UTC+8); el ID oficial que se mantendrá después esqwen4-max.
Todas estas cifras pertenecen a ese proveedor de servicios y a las evaluaciones de terceros correspondientes; no son los precios de APIYI ni las conclusiones de las pruebas realizadas para este artículo. Su valor como referencia reside en que permiten extraer una idea: un precio unitario bajo no equivale a un costo por tarea bajo.
Análisis y evaluación: cómo probar a fondo los modelos populares con bajo costo usando un servicio proxy de API
Primero define la tarea y los criterios de aceptación, y luego prepara una muestra pequeña con las mismas preguntas
Un punto de acceso unificado reduce el costo de integración a casi cero, así que el costo real se traslada a «qué probar». Recomendamos seleccionar de necesidades reales 3–5 tareas pequeñas y, para cada una, fijar de antemano la versión de la entrada, el criterio de aprobación y la base de decisión. Por ejemplo, «la salida debe ser JSON parseable y contener 5 campos», o «el resumen no debe omitir ninguno de los 3 números del texto original». Si no escribes los criterios antes, al final lo único que queda suele ser «cuál me parece mejor».
A continuación, envía la misma entrada a cada modelo candidato por separado, manteniendo la misma regla de evaluación: una respuesta vacía, un formato incorrecto o un truncamiento no cuentan como aprobado. También conviene empezar con el conjunto mínimo común de parámetros: solo define model, messages y max_tokens. Las necesidades de llamada a herramientas, visión, intensidad de razonamiento, etc., mérelas en una ronda de pruebas aparte, para evitar confundir «los parámetros no están bien ajustados» con «el modelo no sirve».
🚀 Sugerencia para empezar: la primera muestra pequeña puedes completarla directamente con el crédito de prueba que incluye el registro en APIYI apiyi.com. Primero confirma que dos o tres modelos candidatos estén visibles y se puedan invocar con tu clave API, y luego decide si recargas para ampliar el alcance de las pruebas.
Contabilizar todos los intentos: costo por tarea válida
En cada solicitud hay que anotar la entrada, la salida y la lectura de caché del campo usage (si la respuesta devuelve ese campo); los reintentos y las solicitudes fallidas también deben registrarse todos. El indicador clave es el costo por tarea válida = gasto total de todos los intentos ÷ número de tareas válidas. Contar solo el gasto del intento que salió bien subestima sistemáticamente a los modelos «baratos pero que necesitan varios reintentos».
A continuación, un cálculo puramente aritmético con el precio de catálogo (no representa el cobro real; los coeficientes de grupo cambian el resultado). Supongamos que la entrada de una sola solicitud es de 2,000 tokens y la salida de 500 tokens:
| Modelo | Costo de entrada | Costo de salida | Estimación por solicitud | Con 0.05 USD alcanza para aproximadamente |
|---|---|---|---|---|
qwen4-max (1.5 / 4.5) |
0.003 USD | 0.00225 USD | Aprox. 0.0053 USD | Aprox. 9 veces |
claude-fable-5-2 (8 / 40) |
0.016 USD | 0.02 USD | Aprox. 0.036 USD | Aprox. 1 vez |
De esta tabla se sacan dos conclusiones. Primera: usar el crédito de prueba para comprobar «si funciona o no» es suficiente, pero comparar en serio la calidad requiere más presupuesto. Segunda: si un modelo produce en la práctica salidas más largas, o necesita dos reintentos para ser válido, la ventaja de precio unitario se esfuma; justo eso es lo que describen los materiales de terceros mencionados antes. Por eso el presupuesto conviene controlarlo en dos capas: primero acotar con el saldo de la cuenta y el max_tokens por solicitud, empezar con textos cortos y, una vez confirmada la tasa de aprobación, pasar a contextos largos.
Aquí tienes un script de registro listo para reutilizar; escribe cada intento en un CSV, lo que facilita calcular después el costo por tarea válida:
Ver el script de registro de muestras para las mismas tareas
import csv, time
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

MODELS = ["qwen4-max", "claude-fable-5-2"]
TASKS = [
    {"id": "t1", "prompt": "把下面的会议记录整理为 JSON:...", "check": lambda s: s.strip().startswith("{")},
    # añade 2–4 tareas reales más, cada una con su función de validación bien definida
]

with open("trial_log.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["model", "task", "attempt", "prompt_tokens", "completion_tokens",
                "cached_tokens", "passed", "latency_s", "error"])
    for model in MODELS:
        for t in TASKS:
            for attempt in range(1, 3):  # reintentar como máximo una vez, y registrar también los fallos
                start = time.time()
                try:
                    r = client.chat.completions.create(
                        model=model,
                        messages=[{"role": "user", "content": t["prompt"]}],
                        max_tokens=800,
                    )
                    text = r.choices[0].message.content or ""
                    u = r.usage
                    details = getattr(u, "prompt_tokens_details", None)
                    cached = getattr(details, "cached_tokens", 0) if details else 0
                    ok = bool(text) and t["check"](text)
                    w.writerow([model, t["id"], attempt, u.prompt_tokens,
                                u.completion_tokens, cached, ok,
                                round(time.time() - start, 2), ""])
                    if ok:
                        break
                except Exception as e:
                    w.writerow([model, t["id"], attempt, 0, 0, 0, False,
                                round(time.time() - start, 2), str(e)[:120]])
Qué te ahorra y qué no te ahorra un punto de entrada unificado
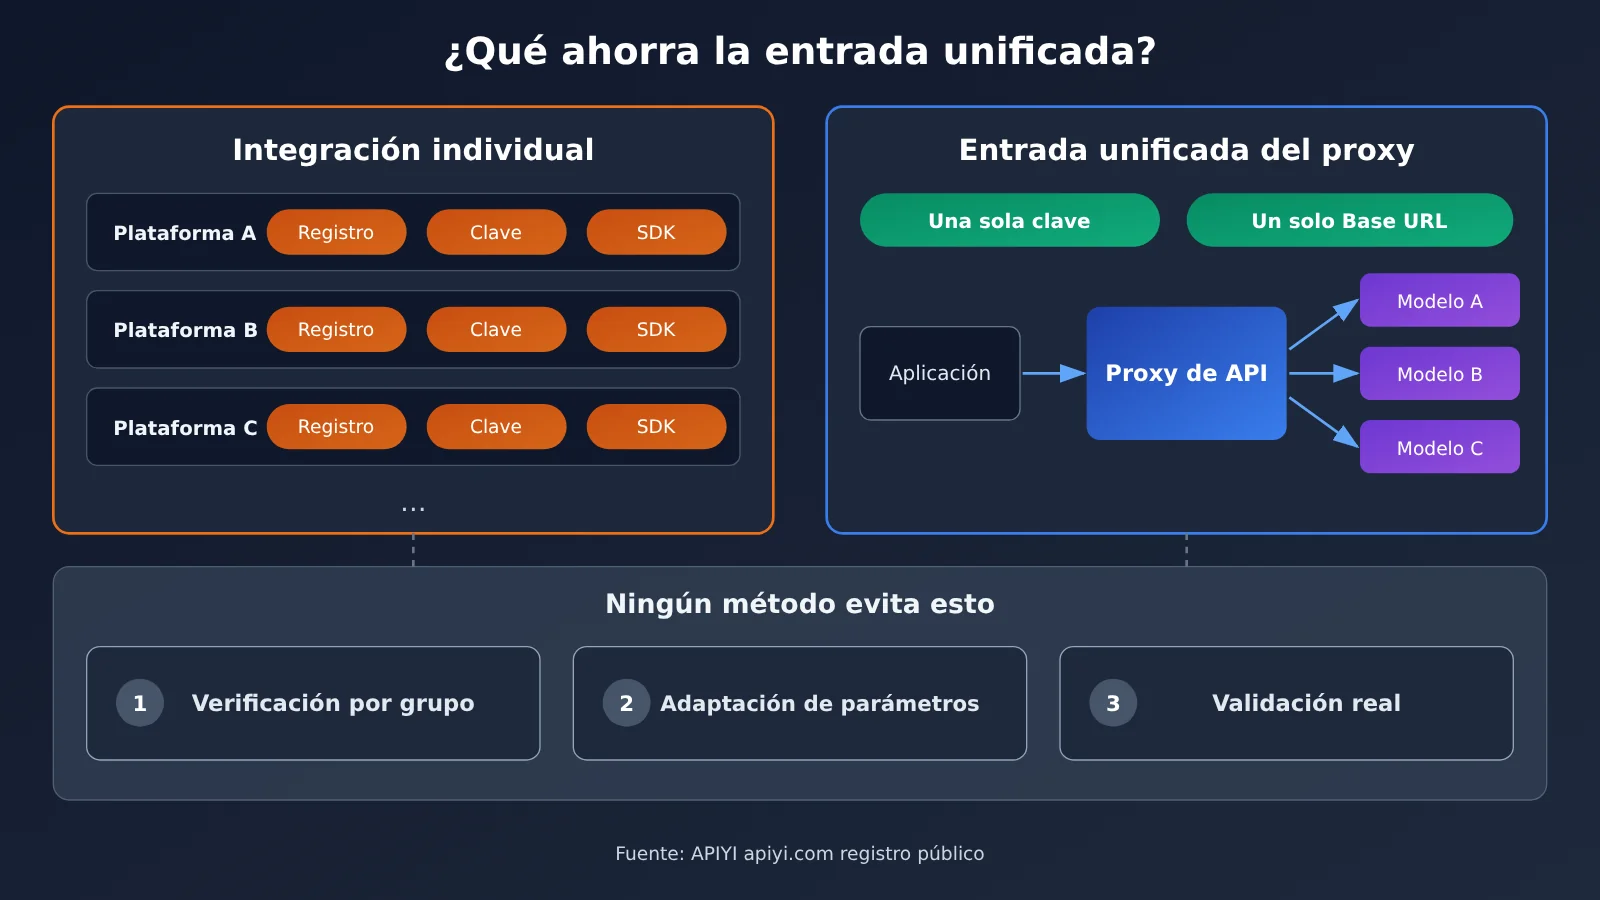
Lo que ahorra un punto de entrada unificado son las cuentas, claves y configuraciones de SDK duplicadas. Lo que no ahorra son tres cosas:
- Agrupación y visibilidad: que algo esté en el catálogo no significa que tu clave pueda verlo;
- Adaptación de parámetros: los parámetros que no son comunes hay que tratarlos por separado según el modelo;
- Aceptación de resultados: ver el modelo tampoco equivale a que la invocación tenga éxito ni a que la salida sea conforme.
Catálogo visible, clave visible, invocación exitosa y salida conforme son cuatro niveles consecutivos que se recorren uno tras otro, y cada uno requiere verificarse por separado. La siguiente tabla te sirve para ir marcando cada punto durante las pruebas:
| Elemento de verificación | Cómo verificarlo | Causa frecuente cuando no pasa |
|---|---|---|
| El ID del modelo existe en el catálogo | Consultar el registro público y confirmar que el ID esté escrito con precisión | Se usó un ID de vista previa o un alias |
| Visible para esta clave | Llamar a GET /v1/models |
El grupo del token no incluye ese canal |
| Endpoint compatible | Comparar con la columna de endpoints del catálogo | Se usó chat para llamar a una capacidad que solo admite responses |
| Invocación exitosa | Enviar una petición mínima real | Saldo insuficiente o parámetros no admitidos |
| Salida conforme | Revisar con reglas de validación predefinidas | Formato incorrecto, truncamiento, retorno vacío |
💡 Recomendación: crea un token aparte para las pruebas en la consola de APIYI apiyi.com y marca solo los grupos que necesites para probar. Así la facturación y el usage quedan separados del tráfico de producción, y después será más fácil calcular el costo por tarea conforme.
La tabla de conclusiones que debes completar tú
Este artículo no ofrece un ranking de calidad entre qwen4-max y claude-fable-5-2, porque no hemos hecho experimentos en tu tarea y los rankings de terceros tampoco representan tu negocio. Lo más fiable es ejecutar una muestra pequeña y completar tú mismo la siguiente tabla antes de decidir:
| Modelo | Número de intentos | Número de tareas aprobadas | Gasto total (según factura) | Costo por tarea aprobada | Parámetros que requieren ajustes adicionales |
|---|---|---|---|---|---|
| qwen4-max | |||||
| claude-fable-5-2 | |||||
| Tu modelo actual |
Dos sugerencias para tener en cuenta; ambas son opiniones, no conclusiones verificadas. Primera: incluye también tu modelo actual en la misma tabla, y solo vale la pena migrar a un modelo nuevo cuando supere claramente al actual en «costo por tarea aprobada» o en «tasa de aprobación». Segunda: al principio, cuando un modelo nuevo sale, el ID, el precio y los límites de parámetros pueden cambiar; el ID de vista previa mencionado antes, que se retirará el 25 de noviembre, es un ejemplo. Se recomienda poner el ID del modelo en un archivo de configuración en lugar de codificarlo directamente, y mantener una ruta de respaldo. Si necesitas ampliar el abanico de candidatos, puedes seguir añadiendo modelos nuevos a través del punto de acceso unificado de APIYI apiyi.com y volver a ejecutar la misma batería de tareas y reglas de evaluación.
Los rankings y catálogos solo pueden decirte qué modelos vale la pena probar; qué modelo se adapta realmente a tu negocio lo responde esa tabla que tienes que construir tú mismo. Como escribió Lu You en «Enseñando a mi hijo Ziyu en una noche de invierno mientras leo»: «Lo que se obtiene del papel siempre parece superficial; para comprender realmente algo, hay que practicarlo».