Nota del autor: en este artículo se desglosan por separado la puntuación compuesta de terceros, los precios oficiales, la lectura de caché y las comparaciones prueba por prueba entre GPT-6.2 Sol y Claude Fable 5.2, explicando qué cifras se pueden comparar directamente y cuáles no se dejan resumir con un simple «quién es más fuerte».
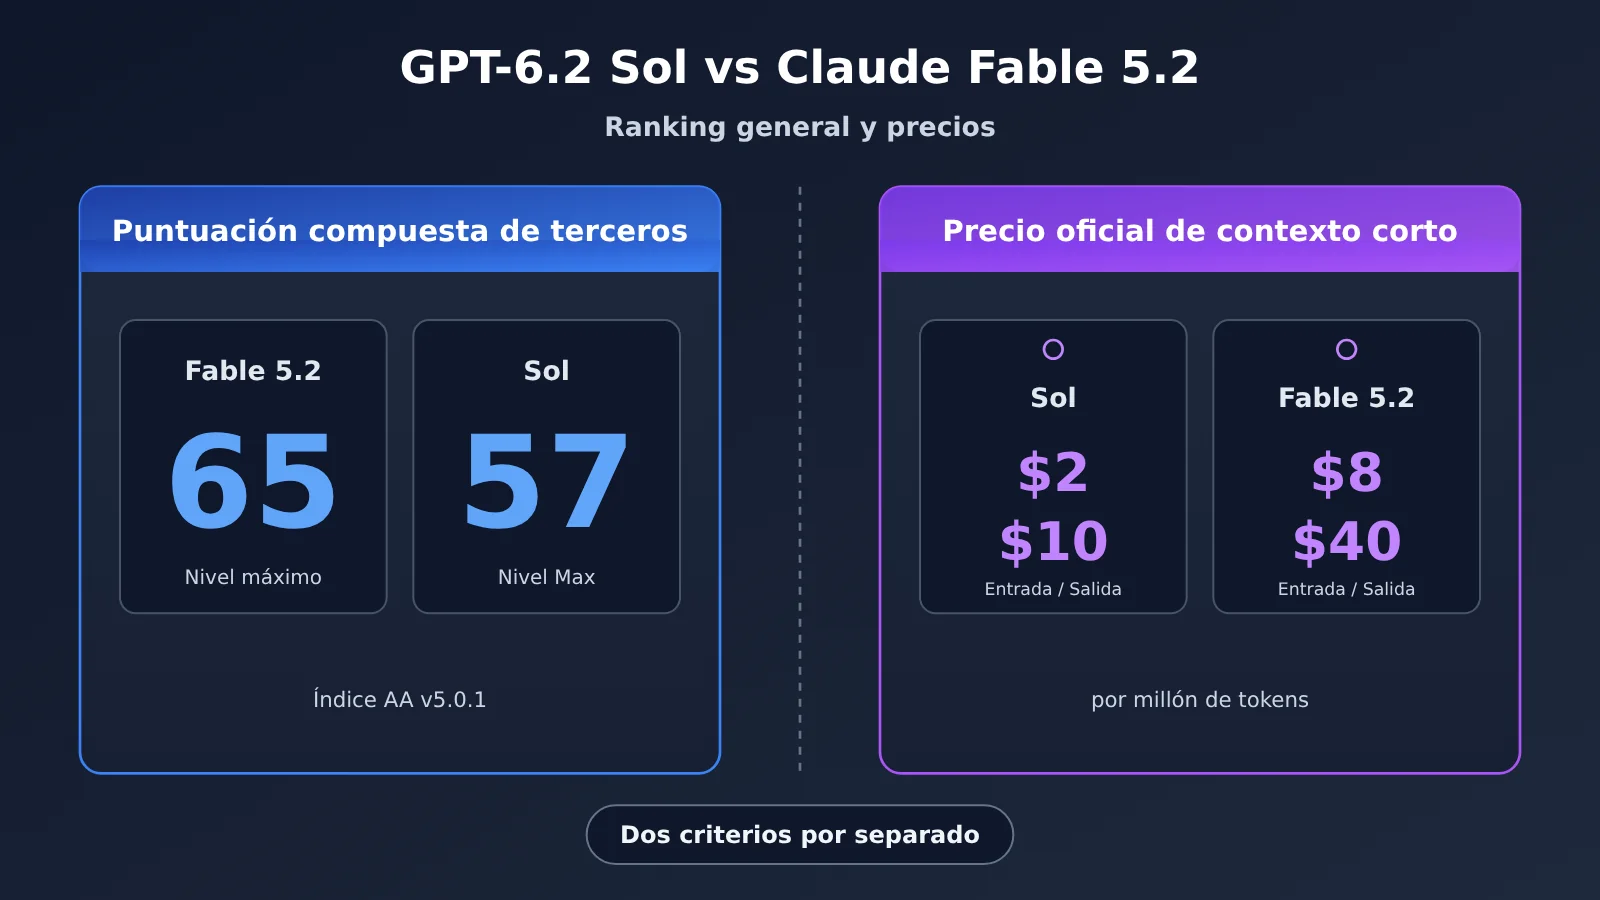
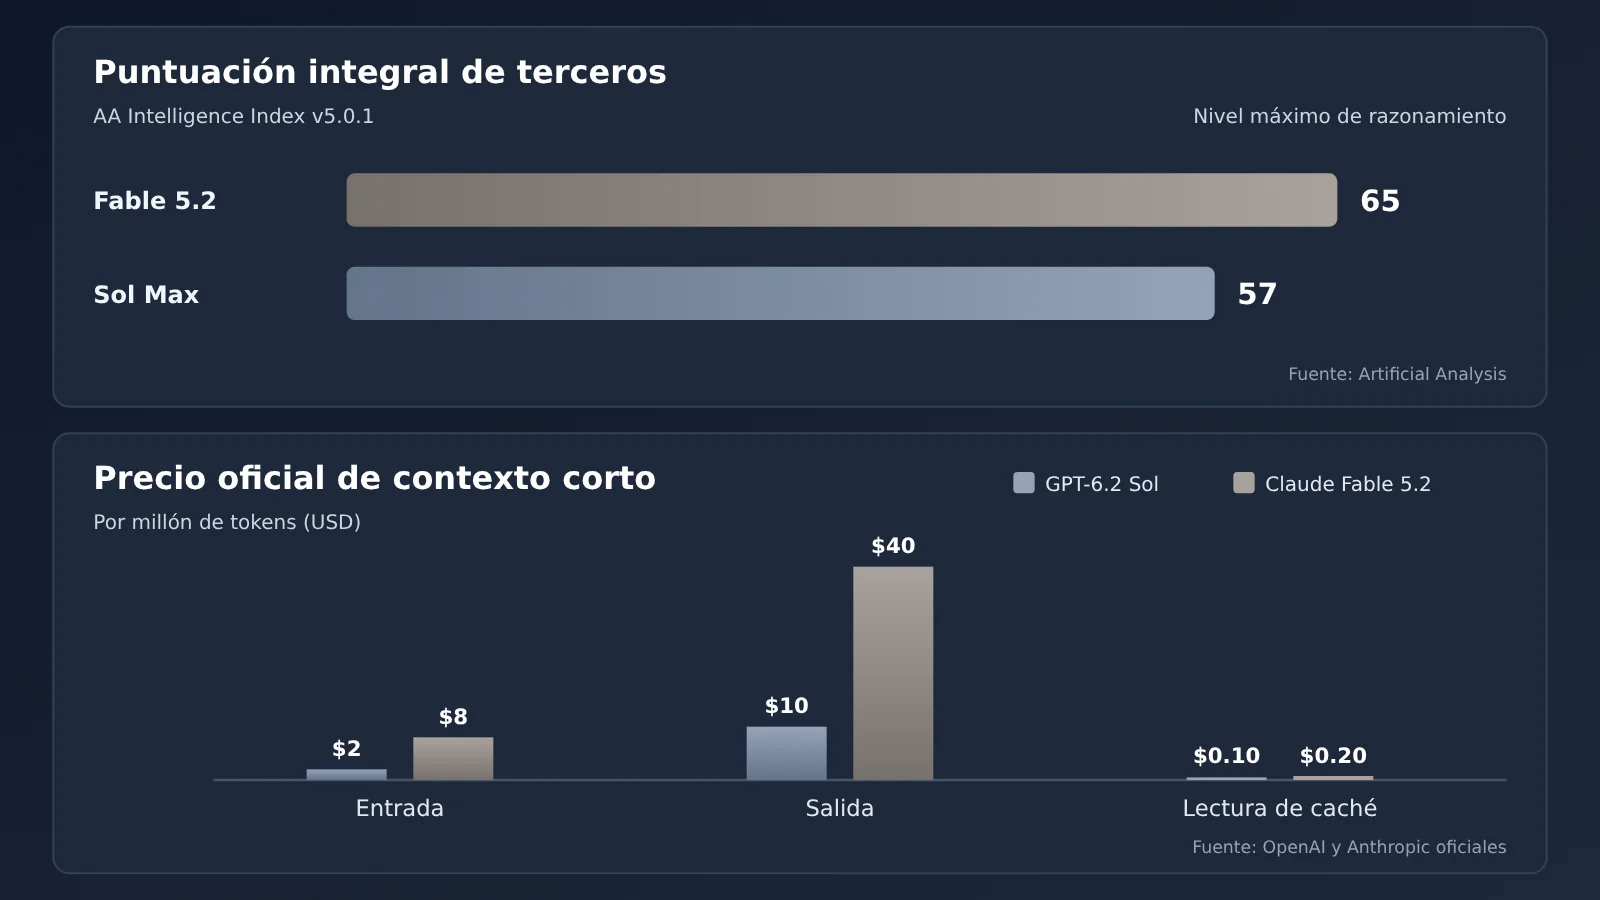
Al comparar GPT-6.2 Sol y Claude Fable 5.2, el error más fácil de cometer es dejar que un simple «quién es más fuerte» tape todas las cifras. El 2026-11-17 OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol, y ese mismo día la agencia independiente Artificial Analysis actualizó su clasificación compuesta: Claude Fable 5.2 alcanzó 65 puntos en su nivel de razonamiento más alto, mientras que GPT-6.2 Sol obtuvo 57 puntos en su nivel Max. Por otro lado, según las tarifas oficiales de ambas empresas para contextos cortos, el precio unitario de entrada y de salida de Sol es exactamente la cuarta parte del de Fable.
La diferencia de puntuación es grande, y la de precios también. Las dos cosas son ciertas, pero no se anulan entre sí ni se pueden fusionar en una sola conclusión. Este artículo no va a elegir un bando por ti. Los datos autodeclarados por los fabricantes, las clasificaciones de terceros y las tarifas oficiales pertenecen a tres criterios de medición distintos; aquí los desglosamos capa por capa y señalamos aparte qué pruebas individuales carecen en realidad de una comparación oficial directa entre Sol y Fable.
Valor clave: al terminar de leer, tendrás tres conjuntos de cifras verificables —puntuación compuesta, tarifas y lectura de caché—, sabrás qué pruebas individuales no sirven para comparar Sol con Fable, y podrás decidir según tu propia tarea qué lado consultar primero.
Puntos clave de GPT-6.2 Sol y Claude Fable 5.2
La siguiente tabla presenta de entrada las cifras a nivel de conclusiones, y cada fila especifica el criterio de medición correspondiente. Los apartados posteriores desarrollan cada una en detalle.
| Punto clave | Cifra | Criterio de medición e interpretación |
|---|---|---|
| Puntuación global | Fable 5.2 obtiene 65, Sol (Max) 57 | Índice de terceros: Artificial Analysis Intelligence Index v5.0.1, con el nivel de razonamiento máximo de cada modelo |
| Precio de lista de entrada/salida con contexto corto | Sol $2 / $10, Fable $8 / $40 (por cada millón de tokens) | Precios de lista oficiales de ambas empresas; Sol equivale a un cuarto de Fable, y solo para estas dos partidas |
| Precio de lista de lectura de caché | Sol $0.10, Fable $0.20 | Precio de lista oficial; Sol cuesta la mitad que Fable, no un cuarto |
| Comparación directa en materiales oficiales | Elo de evaluación humana a ciegas AA-3D: Sol 1259, Fable 1271 | Cita oficial; el resto de las comparaciones individuales oficiales son en su mayoría de Astra contra Fable, o de Sol contra sus propios modelos anteriores |
| Disponibilidad en APIYI | claude-fable-5-2 ya está en el catálogo; gpt-6.2-sol aún no lo está |
Prevalece la lista de modelos de la plataforma |
Sobre el precio de lista de GPT-6.2 Sol en la tabla: las cifras anteriores corresponden al precio oficial de OpenAI; el modelo aún no está disponible en el catálogo y lo incorporaremos lo antes posible. Los nombres de modelos y los precios prevalecen según la lista de modelos de la plataforma.
Por qué la comparación entre GPT-6.2 Sol y Claude Fable 5.2 debe hacerse por capas
El índice global comprime decenas de tareas en una sola puntuación, así que sirve para responder «en qué nivel aproximado se encuentra el conjunto», pero no responde «cuál conviene más para mi tarea concreta». El precio de lista responde cuánto cuesta cada millón de tokens, lo cual no equivale a cuánto cuesta completar una tarea, porque en ambos lados el nivel de razonamiento, la cantidad de tokens de pensamiento y la tasa de acierto de la caché modifican la factura real.
Las tareas individuales constituyen una tercera capa. En el anuncio de OpenAI, las pruebas individuales donde aparece Fable se comparan en su mayoría contra GPT-6.2 Astra, y no contra Sol. Atribuirle a Sol los resultados de Astra es el error de lectura más frecuente en este tipo de comparaciones, y este artículo se encargará específicamente de separar ambos casos.
GPT-6.2 Sol frente a Claude Fable 5.2: diferencias clave
Puntuación compuesta de terceros de GPT-6.2 Sol y Claude Fable 5.2
Artificial Analysis es una agencia de evaluación independiente, así que las cifras que siguen no son autoevaluaciones de OpenAI ni de Anthropic. Su Intelligence Index v5.0.1 puntúa cada modelo por separado según su nivel de razonamiento, por lo que, al comparar, conviene dejar claro qué nivel se está usando.
| Modelo | Nivel de razonamiento | Intelligence Index v5.0.1 | Costo por tarea del índice compuesto (según la página de cada modelo) |
|---|---|---|---|
| Claude Fable 5.2 | Nivel de razonamiento más alto | 65 (primero del ranking) | $26.54 |
| GPT-6.2 Astra | Max / Xhigh | 62 | $4.00 (Max) |
| Gemini 4 Carbon | Nivel más alto | 60 | — |
| Claude Opus 5.5 | Nivel más alto | 59 | — |
| GPT-6.2 Sol | Max | 57 | $1.01 |
| GPT-6.2 Sol | Xhigh / High / Medium / Low | 56 / 55 / 53 / 41 | — |
Según Artificial Analysis, Sol sube 2 puntos frente a GPT-6.1 Sol y llega a 57, empatando con GPT-6 Astra, con un costo por tarea que ronda el 15 % del de este último. El «costo por tarea» de la tabla es lo que le costó a este tercero ejecutar el índice: refleja el resultado combinado del nivel de razonamiento, la longitud del pensamiento y el precio de lista, no el precio de catálogo de la API.
Eso sí: OpenAI declara oficialmente que en Agents’ Last Exam Astra cuesta alrededor del 5 % de lo que cuesta Fable, pero eso corresponde a otro conjunto de tareas. No se puede convertir $26.54 a ese «5 %» oficial, ni tampoco aplicar ese dato a Sol.
Precios oficiales y caché de GPT-6.2 Sol y Claude Fable 5.2
Empecemos por GPT-6.2 Sol. Según la página de modelos de OpenAI, la tarifa estándar para contexto corto es: entrada $2, lectura de caché $0.10, escritura de caché (con retención de 30 minutos) $2.50, escritura de caché de 12 horas $5 y salida $10. Aún no está disponible en la plataforma; lo incorporaremos lo antes posible. El nombre del modelo y los precios deben confirmarse en la lista de modelos de la plataforma. La nota de lanzamiento aclara que Sol mantiene los precios por token de API de GPT-6.1 Sol.
Según la documentación de Anthropic, Claude Fable 5.2 tiene estos precios: entrada $8, salida $40, escritura de caché de 5 minutos $10, escritura de caché de 1 hora $16 y lectura de caché $0.20. En la tabla general de modelos de APIYI (apiyi.com), claude-fable-5-2 y claude-fable-5-2-thinking figuran con entrada, salida y lectura de caché de $8 / $40 / $0.2, coincidiendo con los precios oficiales; las páginas de descripción de ambos modelos devuelven por ahora un 404, así que los precios de referencia son los de la tabla general.
| Concepto (por 1 millón de tokens) | GPT-6.2 Sol (oficial de OpenAI) | Claude Fable 5.2 (oficial de Anthropic) | Relación entre ambos |
|---|---|---|---|
| Entrada (contexto corto) | $2 | $8 | Un cuarto |
| Salida (contexto corto) | $10 | $40 | Un cuarto |
| Lectura de caché | $0.10 | $0.20 | La mitad |
| Escritura de caché | 30 minutos: $2.50; 12 horas: $5 | 5 minutos: $10; 1 hora: $16 | Plazos de retención distintos; no conviene dividir directamente |
| Batch | 50% del precio estándar | Entrada y salida a mitad de precio | Reglas similares |
| Nivel acelerado | Fast cuesta el doble del precio estándar; Ultrafast cuesta el triple hasta el 2027-02-28 y 6 veces a partir del 2027-03-01 | Fast mode: entrada $16, salida $80, con una velocidad de hasta unas 2.5 veces | Mecanismos distintos |
Los valores de GPT-6.2 Sol en la tabla corresponden a los precios oficiales de OpenAI. Aún no está disponible en la plataforma; lo incorporaremos lo antes posible. El nombre del modelo y los precios deben confirmarse en la lista de modelos de la plataforma.
La afirmación de que «Sol cuesta un cuarto de lo que cuesta Fable» solo se cumple en la entrada y la salida con contexto corto. La página de modelos de OpenAI añade otra regla: cuando la entrada de una sola solicitud supera los 272K tokens, los precios unitarios de entrada y de caché se duplican, la salida se cobra a 1.5 veces la tarifa de contexto corto y, además, el cálculo se aplica a toda la solicitud. En ese caso, el precio unitario de salida de Sol ya no es $10, y estimar con la regla del cuarto te llevaría a error; para la facturación de contexto largo del lado de Fable, la referencia es la documentación de Anthropic.
Especificaciones e interfaces de GPT-6.2 Sol y Claude Fable 5.2
Ambos modelos cuentan con una ventana de contexto en el orden del millón de tokens y una salida máxima de 128K. Las diferencias están en las modalidades de entrada, los ajustes de razonamiento y las interfaces, aspectos que influyen directamente en la forma de integrarlos.
| Aspecto | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| Contexto / salida máxima | 1,050,000 (entrada máxima 922,000) / 128,000 | 1M / 128K |
| Entrada / salida | Texto e imágenes / texto | Según lo indique la documentación de Anthropic |
| Corte de conocimiento | 2026-06-01 | 2026-06 |
| Configuración de razonamiento | La API no permite fijar el reasoning effort en none | El effort predeterminado es high; el pensamiento está activado y no se puede desactivar |
| Endpoints oficiales | Chat Completions, Responses y Batch | API de Anthropic |
| APIYI | No disponible en el catálogo | claude-fable-5-2 y claude-fable-5-2-thinking, con endpoints chat y messages |
Al invocar Fable en APIYI —que ya figura en el catálogo—, la URL base para el modo compatible con OpenAI es https://api.apiyi.com/v1, y hay que indicar el modelo claude-fable-5-2; si tu proyecto ya trabaja con el protocolo Anthropic Messages, también puedes recurrir al endpoint messages de la plataforma. En cuanto a los grupos, la tabla general lista ClaudeCode, Claude_Reverse, Claude_Enterprise, Default y SVIP.
GPT-6.2 Sol y Claude Fable 5.2: cada prueba por separado
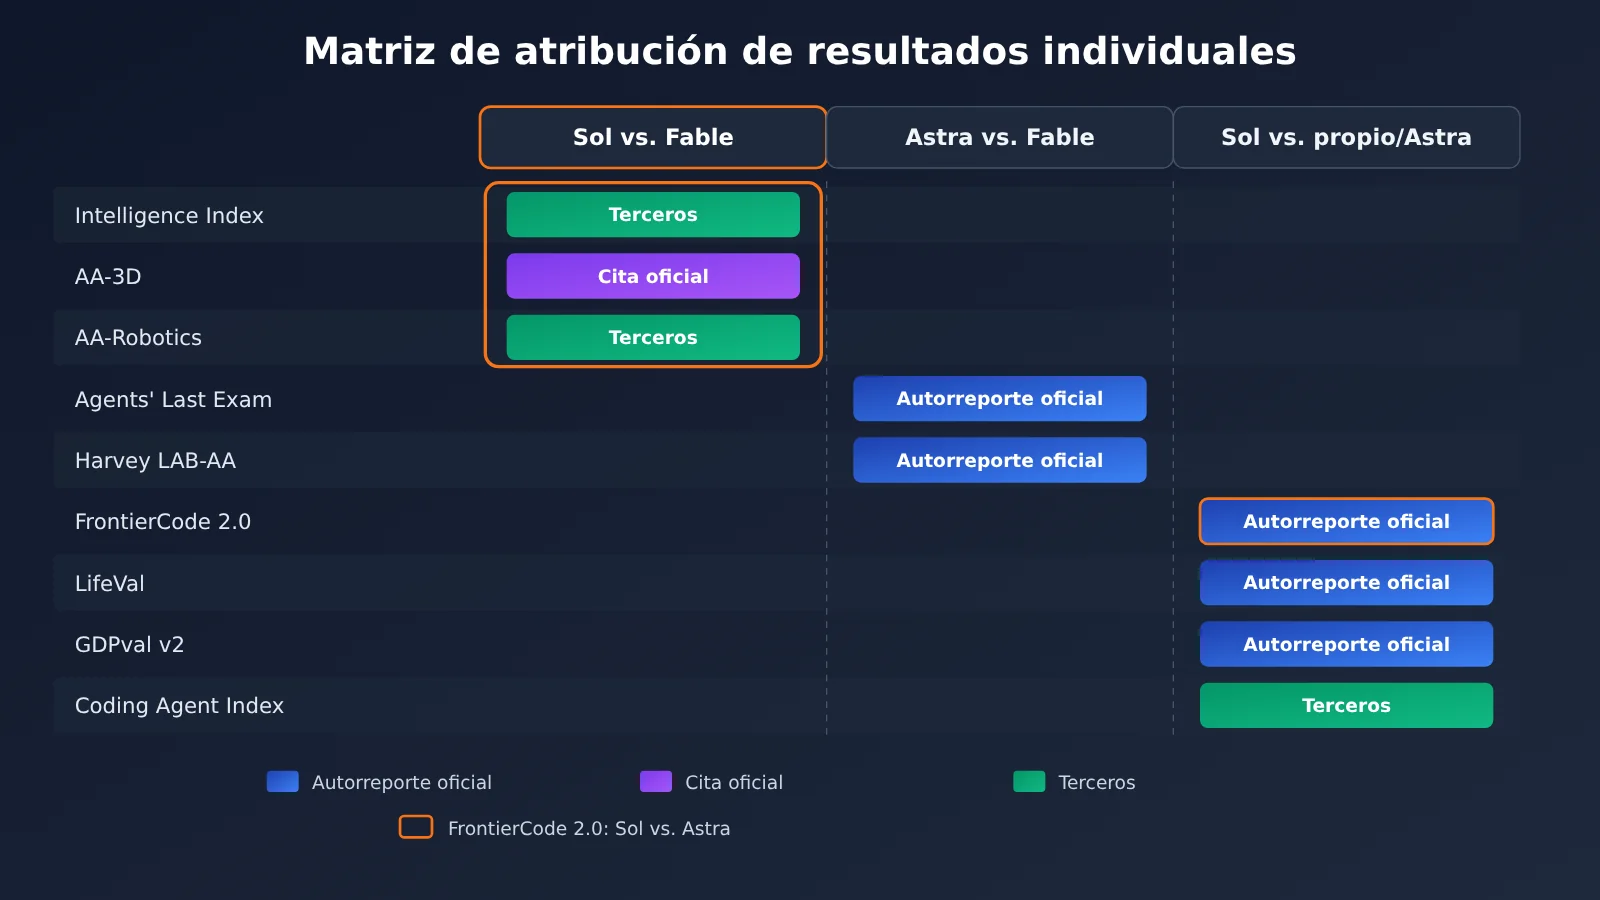
Esta es la sección más importante del artículo. El anuncio oficial de OpenAI incluye bastantes resultados individuales, pero las comparaciones directas de «Sol vs Fable» dentro de ellos son escasas. La siguiente tabla los desglosa uno por uno según la fuente y las partes comparadas.
| Prueba | Fuente | Partes comparadas y resultado | ¿Comparación directa Sol vs Fable? |
|---|---|---|---|
| Intelligence Index v5.0.1 | AA de terceros, nivel de razonamiento máximo | Fable 65, Sol (Max) 57 | Sí (puntuación compuesta de terceros) |
| AA-3D, Elo de evaluación humana a ciegas | Relatado oficialmente | Sol 1259, Fable 1271 | Sí (el único caso en los materiales oficiales) |
| AA-Robotics v0.1 | AA de terceros, vista previa de investigación | Sol 78, Fable 75 | Sí (vista previa de terceros; en cuanto al nivel de razonamiento, remitirse a la página de AA) |
| Agents’ Last Exam | Autoreporte oficial | Astra supera a Fable por 5.5 puntos, con un costo de aproximadamente el 5% | No, es Astra vs Fable |
| Harvey LAB-AA v1.1 | Autoreporte oficial | La tasa de aprobación de Astra es más del doble que la de Fable, con un costo de aproximadamente un sexto | No, es Astra vs Fable |
| FrontierCode 2.0 | Autoreporte oficial | Sol y Astra difieren en menos de 0.5 puntos, costo de aproximadamente un quinto, ambos en nivel Max | No, es Sol vs Astra |
| LifeVal | Autoreporte oficial | Sol supera a GPT-6 Astra, con un costo de aproximadamente un séptimo | No |
| GDPval v2 | Autoreporte oficial | Sol supera a GPT-6.1 Sol por 5.3 puntos | No |
| Coding Agent Index | AA de terceros, nivel max | Sol queda 3 puntos por debajo de GPT-6.1 Sol | No |
El resultado de GPT-6.2 Sol en FrontierCode 2.0 no puede trasladarse a la comparación con Fable
FrontierCode 2.0 fue diseñado por Cognition y evalúa si las modificaciones sobre repositorios de código reales logran ser fusionadas por los mantenedores. El resultado autoreportado indica que Sol y Astra difieren en menos de 0.5 puntos, con un costo de aproximadamente un quinto del de Astra; ambos están en el nivel Max. Aquí Fable no participa, así que no se puede escribir que «Sol difiere de Fable en menos de 0.5 puntos en FrontierCode».
De la misma manera, en Agents’ Last Exam y Harvey LAB-AA quien supera a Fable es Astra. El anuncio no ofrece datos sobre cómo se compara Sol con Fable en estas dos pruebas, y no se debe inferir.
Las pruebas de ciencia y código de GPT-6.2 Sol y Claude Fable 5.2
Con Terminal-Bench-Science 0.1 también hay que ir con cuidado. El autoreporte oficial indica que Astra supera a GPT-6 Astra por 9 puntos porcentuales; en las notas al pie, Fable 5.2 aparece con dos cifras: una proviene de la prueba de Artificial Analysis con mini-swe-agent, y la otra es el 74.6% que Anthropic reportó con Claude Code y razonamiento en nivel Max. Estas dos cifras de Fable provienen de pruebas distintas, no pueden tratarse como una misma comparación y, además, ninguna de las dos es un resultado de Sol.
Del lado de los terceros, Artificial Analysis señala que Sol en el Coding Agent Index (harness Codex, max) queda 3 puntos por debajo de GPT-6.1 Sol, sobre todo porque SWE-Atlas-QnA-AA baja 14 puntos, lo que implica una mayor tendencia a omitir hechos clave. La tasa de alucinaciones de AA-Omniscience (Max) que midió para Sol es del 55%. Estas cifras no tienen valores equivalentes de Fable, así que solo sirven para entender las debilidades propias de Sol.
Recomendaciones de escenarios para GPT-6.2 Sol y Claude Fable 5.2
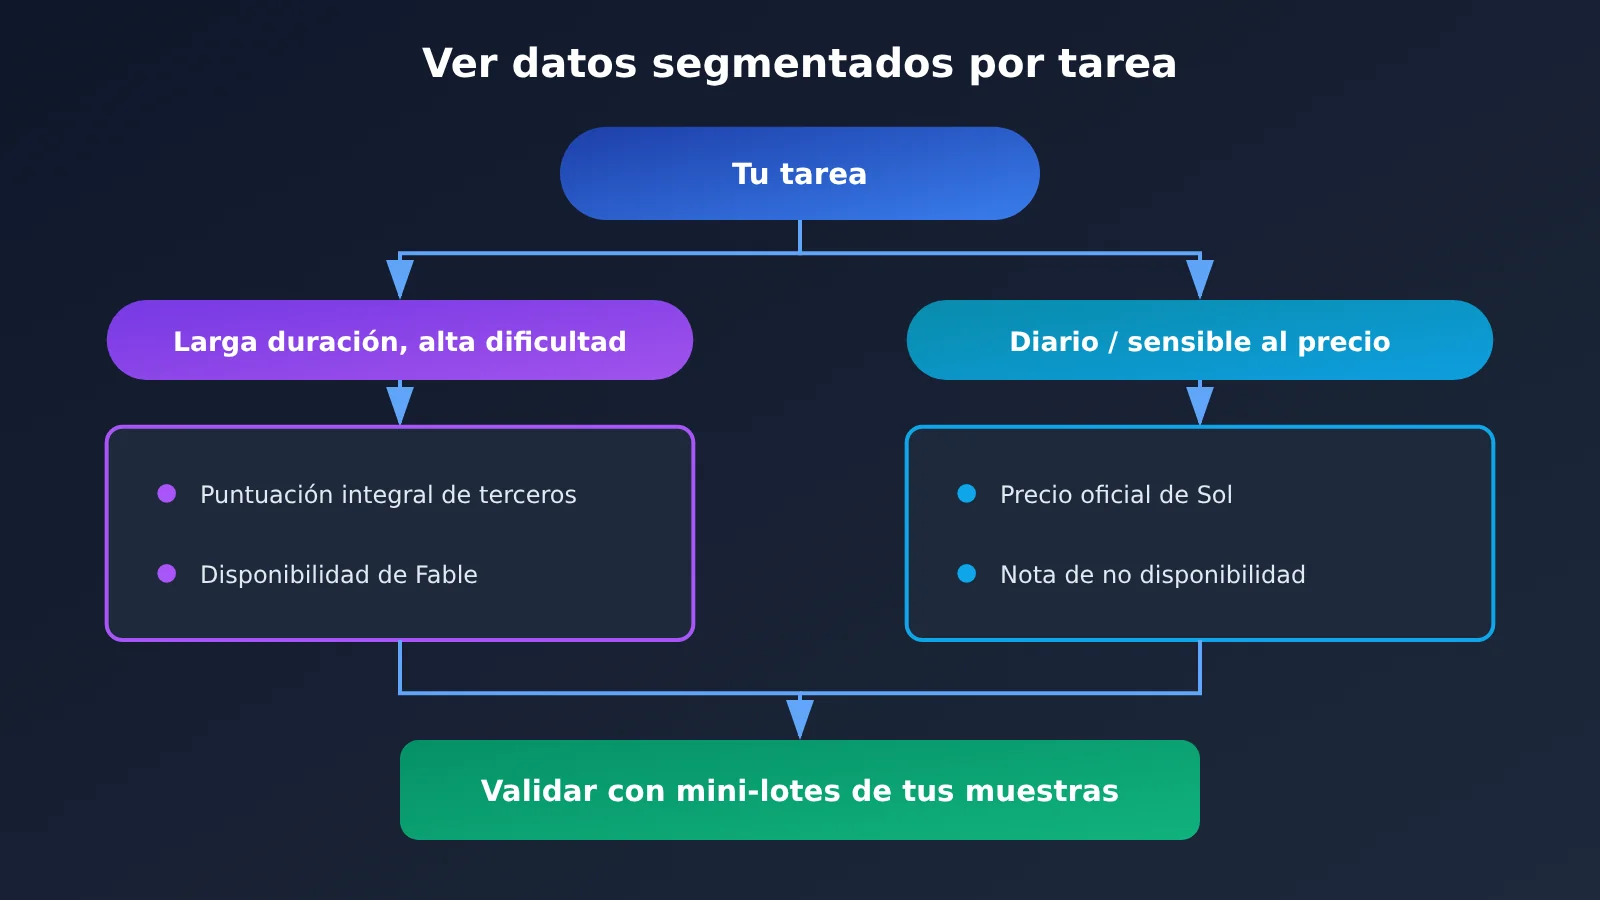
Esta sección no va a decidir por ti cuál usar; solo aclara qué grupo de datos deberías consultar primero según el tipo de tarea.
Tareas para las que conviene consultar primero los datos de Claude Fable 5.2
- Tareas integrales largas, de alta dificultad y multipaso: mira primero la puntuación global de terceros. Fable alcanza 65 en el nivel máximo de razonamiento del Intelligence Index v5.0.1 y encabeza la clasificación; es, por ahora, el dato global directamente comparable con Sol.
- Proyectos que necesitan integrarse de inmediato:
claude-fable-5-2ya está disponible en APIYI, así que puedes probarlo al instante con tus propias muestras. - Proyectos donde hay que tener en cuenta el gasto de razonamiento: el razonamiento de Fable viene activado por defecto y no se puede desactivar; el effort predeterminado es high, de modo que al hacer el presupuesto debes incluir los tokens de razonamiento.
Tareas para las que conviene consultar primero los datos de GPT-6.2 Sol
- Tareas cotidianas y tareas por lotes sensibles al precio: revisa primero el precio de lista oficial para contextos cortos y las reglas de Batch, y después los resultados autoreportados oficialmente en tareas cotidianas, como LifeVal y GDPval v2.
- Solicitudes que se mantienen dentro de los 272K: la brecha de precios de Sol —con la entrada a un cuarto del precio de la salida— se concentra precisamente en este rango.
- Equipos que ya trabajan con ChatGPT Work o Codex: según el anuncio oficial, Plus, Pro, Enterprise y Edu están disponibles a partir de hoy, y Pro 200 recibe por primera vez Ultrafast, que se ofrece empezando por Sol.
GPT-6.2 Sol y Claude Fable 5.2: guía de inicio rápido
Esta sección organiza los pasos según el tipo de tarea. No incluimos código en el texto: los nombres de los modelos y las direcciones van escritos en las propias frases.
Tareas largas y de alta dificultad: consulta primero la puntuación general de Fable y su disponibilidad en la plataforma. Crea una clave API en la consola de APIYI, cambia la base URL de tu SDK compatible con OpenAI a https://api.apiyi.com/v1 y en el campo model escribe claude-fable-5-2; si prefieres que el nombre del modelo deje claro que incluye razonamiento, también puedes usar claude-fable-5-2-thinking. Según la tabla de precios general, cuesta $8 por entrada, $40 por salida y $0.2 por lectura de caché, en línea con los precios oficiales de Anthropic. Te recomendamos empezar con 20 o 50 de tus propias tareas reales para medir la tasa de finalización y el consumo de tokens, y así valorar si esos 65 puntos se notan realmente en tu caso de uso.
Tareas del día a día sensibles al precio: revisa después el precio oficial de Sol y el aviso de que aún no está disponible. El precio oficial de OpenAI para GPT-6.2 Sol es de $2 por entrada, $0.10 por lectura de caché y $10 por salida. Todavía no está disponible; lo subiremos a la plataforma lo antes posible. El nombre del modelo y su precio deben confirmarse siempre en la lista de modelos de la plataforma. Mientras tanto, consulta periódicamente la lista de modelos en apiyi.com y no uses gpt-6.1-sol ni gpt-6-sol como sustitutos en tus pruebas: no son la versión 6.2, y además la tarifa de lectura de caché de gpt-6-sol es distinta.
Cuando Sol esté disponible, ten en cuenta tres cosas: el parámetro reasoning effort no puede establecerse en none; las solicitudes con entradas de más de 272K reciben un recargo sobre el pedido completo; y aunque el endpoint oficial admite Chat Completions y Responses, los endpoints de la plataforma se confirman en la lista de modelos.
🚀 Inicio rápido: una misma clave API sirve para invocar modelos de varios proveedores en la plataforma. Te aconsejamos probar primero Fable en APIYI (apiyi.com) con el crédito gratuito de prueba, dejar listos tus scripts de evaluación y tus muestras, y cuando Sol esté disponible, simplemente cambiar el nombre del modelo para repetir la comparación con las mismas muestras.
Recomendaciones para decidir entre GPT-6.2 Sol y Claude Fable 5.2
A continuación tienes una lista de verificación que te ayudará a aplicar estas cifras a tus propias tareas.
- Aclara primero la base de los datos: ¿lo que estás citando es una puntuación global de terceros, un resultado individual autoinformado por el fabricante o un precio oficial? No los sumes entre sí ni intentes convertir unos en otros.
- Verifica el nivel de razonamiento: los 57 puntos de Sol corresponden al nivel Max; el nivel High se queda en 55 y el Low apenas llega a 41. Fíjate en la puntuación del nivel que realmente vayas a usar.
- Haz cuentas según la longitud de la solicitud: dentro de 272K puedes estimar la entrada y la salida a razón de un cuarto; por encima de 272K hay que recalcular conforme a las reglas de solicitud completa de OpenAI.
- Calcula la caché por separado: la lectura de caché cuesta $0.10 frente a $0.20, es decir, una cuesta el doble que la otra; además, la duración de retención de la escritura en caché no es la misma, así que estima cada una según tu propia estrategia de caché.
- Comprueba si existe la comparación directa que te interesa: si del aspecto que te importa solo hay datos de Astra frente a Fable o de Sol frente a Astra, no puedes tomarlos como una conclusión de Sol frente a Fable.
- Ten en cuenta las políticas de seguridad: según la información oficial, ambos modelos 6.2 alcanzan el nivel «crítico» de ciberseguridad del marco de preparación; con una protección más estricta, una parte de las solicitudes legítimas de investigación de vulnerabilidades será rechazada.
💡 Consejo de elección: el modelo que elijas dependerá de la longitud de la tarea, del nivel de razonamiento y de la tasa de acierto de la caché. Puedes probar ambos con el mismo lote de muestras en la plataforma APIYI y dejar que hablen la factura y la tasa de finalización, sin necesidad de fiarte de un único ranking.
Preguntas frecuentes (FAQ)
Q1: ¿Qué son GPT-6.2 Sol y Claude Fable 5.2?
GPT-6.2 Sol es el modelo que OpenAI lanzó el 17 de noviembre de 2026 junto con GPT-6.2 Astra: su ID de modelo es `gpt-6.2-sol`, acepta texto e imágenes como entrada y genera texto, con una ventana de contexto de 1.050.000 tokens. Claude Fable 5.2 es el modelo que Anthropic lanzó el 9 de noviembre de 2026, con una ventana de contexto de 1M, una salida máxima de 128K y el razonamiento activado por defecto, sin opción de desactivarlo.
Q2: ¿El 65 frente a 57 del ranking general demuestra que Claude Fable 5.2 supera a GPT-6.2 Sol en todos los aspectos?
No. El 65 frente a 57 es el resultado en el Artificial Analysis Intelligence Index v5.0.1, una medición de terceros en la que Fable usó su nivel de razonamiento más alto y Sol el nivel Max. Esa cifra refleja el nivel general del índice y no implica que cada prueba individual presente la misma diferencia. En el Elo de la evaluación humana a ciegas AA-3D citado en los anuncios oficiales, Sol obtiene 1259 y Fable 1271, con una brecha claramente menor; en la vista previa de investigación AA-Robotics v0.1 de terceros, Sol logra 78 y Fable 75.
Q3: ¿El precio de GPT-6.2 Sol es realmente un cuarto del de Claude Fable 5.2?
Solo se cumple en la entrada y la salida con contexto corto. Según los precios oficiales, Sol cuesta $2 la entrada y $10 la salida, mientras que Fable cuesta $8 la entrada y $40 la salida. Aún no está disponible en el catálogo: lo publicaremos lo antes posible; el modelo y los precios definitivos serán los que figuren en la lista de modelos de la plataforma. La lectura de caché cuesta $0.10 frente a $0.20, es decir, la mitad; a partir de 272K de entrada, Sol aplica un recargo a todo el pedido y la salida pasa a costar 1.5 veces el precio de contexto corto, así que en ese caso ya no se puede estimar como un cuarto.
Q4: ¿Cuánta diferencia hay entre GPT-6.2 Sol y Claude Fable 5.2 en FrontierCode 2.0?
Los materiales oficiales no incluyen esa comparación. La «diferencia de menos de 0.5 puntos» de FrontierCode 2.0 compara a GPT-6.2 Sol con GPT-6.2 Astra, ambos en el nivel Max, y el costo de Sol ronda la quinta parte. Fable no participó en esa comparación.
Q5: ¿Cómo invocar GPT-6.2 Sol y Claude Fable 5.2 mediante la API?
Los pasos son los siguientes:
1. Regístrate en APIYI (apiyi.com) y obtén una clave API y un crédito de prueba gratuito.
2. Configura el base URL del SDK compatible con OpenAI con la dirección de la plataforma y usa `claude-fable-5-2` como model para invocar a Fable.
3. `gpt-6.2-sol` todavía no está disponible; cuando se publique, el modelo y los precios definitivos serán los de la lista de modelos de la plataforma, y podrás repetir las pruebas con el mismo conjunto de muestras.
Q6: ¿Qué limitaciones conocidas tienen GPT-6.2 Sol y Claude Fable 5.2?
En el caso de Sol: según las mediciones de terceros de AA, la tasa de alucinaciones en el nivel Max es del 55%, y su Coding Agent Index queda 3 puntos por debajo del de GPT-6.1 Sol, sobre todo porque tiende a omitir hechos clave; el reasoning effort no se puede fijar en none; sus controles de ciberseguridad son más estrictos y se rechaza parte de la investigación legítima de vulnerabilidades. En el caso de Fable: el razonamiento no se puede desactivar, el effort por defecto es high y los tokens de razonamiento se cobran; el Fast mode tiene una tarifa de $16 la entrada y $80 la salida.
Q7: Oficialmente, el costo de Astra es solo el 5% del de Fable: ¿se puede contrastar con los $26.54 de terceros?
No se puede. El «alrededor del 5 %» es el coste autodeclarado oficialmente en Agents’ Last Exam, con Astra y Fable como objeto de comparación; los $26.54 corresponden al coste por tarea de Fable cuando Artificial Analysis ejecuta su índice compuesto. Son tareas distintas y provienen de fuentes distintas: no puedes dividir una entre la otra, ni usarlas para deducir el coste de Sol. Si solo buscas hacerte una idea del orden de magnitud, resulta más fiable registrar la facturación real con tus propias muestras en la plataforma APIYI.
Puntos clave de GPT-6.2 Sol y Claude Fable 5.2 (Key Takeaways)
- Puntuación global: en el índice de terceros de AA, Fable alcanza 65 en su nivel de razonamiento más alto y Sol 57 en el nivel Max; es la comparación directa dentro del mismo ranking.
- Precios de lista: para entrada y salida con contexto corto, Sol cuesta la cuarta parte que Fable ($2 frente a $8, $10 frente a $40).
- Lectura de caché: $0.10 frente a $0.20; la diferencia es solo la mitad, no se aplica la regla del cuarto.
- Contexto largo: cuando la entrada de Sol supera los 272K, el recargo se aplica a toda la solicitud y la proporción original deja de valer.
- Pocas comparaciones directas: en el material oficial, el único duelo Sol contra Fable es AA-3D, con 1259 frente a 1271.
- No reutilices los resultados: FrontierCode 2.0 es Sol contra Astra, mientras que ALE y Harvey son Astra contra Fable.
- Disponibilidad: Fable se puede invocar directamente en APIYI (apiyi.com); Sol aún no está en el catálogo, así que la referencia definitiva es la lista de modelos.
Resumen
Para comparar GPT-6.2 Sol y Claude Fable 5.2, la clave está en separar las tres capas de números:
- Puntuación compuesta de terceros: Fable 65, Sol (Max) 57; sirve para ubicar en qué nivel general se encuentra cada modelo.
- Precios oficiales: en contexto corto, la entrada y la salida difieren en un cuarto; la lectura de caché, en la mitad; y el contexto largo se calcula por separado según las reglas de cada modelo.
- Tareas individuales: la mayoría de las métricas oficiales por tarea no son comparaciones directas de Sol contra Fable; antes de citarlas, confirma quiénes son los modelos comparados.
La diferencia de puntuaciones y la diferencia de precios no se pueden fusionar en una sola frase de «cuál vale más la pena». Lo más prudente es usar tus propias muestras, fijar el nivel de razonamiento y registrar por separado la tasa de finalización y los costos facturados. Fable ya se puede probar en APIYI (apiyi.com); GPT-6.2 Sol todavía no está disponible en el catálogo. Lo incorporaremos lo antes posible; la lista de modelos de la plataforma es la referencia definitiva para nombres y precios.
📚 Referencias
-
Artículo de lanzamiento de OpenAI: notas de lanzamiento de GPT-6.2 Astra y Sol y resultados por tarea autoreportados
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Descripción: resumen de los resultados por tarea autoreportados oficialmente, la disponibilidad y los precios
- Enlace:
-
Página del modelo de OpenAI – GPT-6.2 Sol: especificaciones, precios y reglas de facturación de 272K
- Enlace:
platform.openai.com/docs/models/gpt-6.2-sol - Descripción: esta es la referencia definitiva para el precio de escritura en caché, el recargo por contexto largo y los multiplicadores del nivel acelerado
- Enlace:
-
Tarjeta de sistema de OpenAI: evaluaciones de seguridad de GPT-6.2 Astra y Sol
- Enlace:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descripción: niveles del marco de preparación y evaluaciones de alineamiento
- Enlace:
-
Artículo y páginas de modelos de Artificial Analysis: Intelligence Index v5.0.1 de terceros
- Enlace:
artificialanalysis.ai/models/claude-fable-5-2 - Descripción: puntuaciones compuestas por categoría, costo por tarea individual y el Coding Agent Index
- Enlace:
-
Documentación de Anthropic – Claude Fable 5.2: precios oficiales y especificaciones
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: escritura en caché, lectura de caché, Fast mode y configuración de effort
- Enlace:
-
Tabla general de modelos de APIYI: modelos y precios disponibles en la plataforma
- Enlace:
docs.apiyi.com/models.md - Descripción: datos con fecha 2026-11-17 15:54 (UTC+8); la lista de modelos de la plataforma es la referencia definitiva para nombres y precios
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos desde la página principal de APIYI; para más información sobre modelos e interfaces, consulta el centro de documentación en docs.apiyi.com