Nota del autor: Los equipos que conectan OpenAI, Claude, Gemini y Qwen al mismo tiempo pueden separar tokens por proyecto dentro de una sola cuenta, asignar a cada token un límite de gasto, una vigencia, una lista blanca de modelos y un grupo, y conciliar las cuentas desde los registros de tokens.
Quienes lideran I+D e integran varios modelos a la vez suelen encontrarse con tres problemas. Primero, las claves están repartidas en los paneles de cada proveedor y cuesta saber quién tiene cuál. Segundo, al final de mes la factura no coincide con los proyectos y no se sabe cuánto gastó cada uno. Tercero, cuando una clave se comparte entre varias personas, si quieres retirar el acceso a una sola persona, no queda otra que invalidar la clave entera. Este artículo presenta una cuenta APIYI + tokens separados por proyecto como forma de gestión, para llevar la gestión empresarial de múltiples modelos a pasos de configuración que se pueden ejecutar.
No es otro artículo sobre «por qué hace falta un proxy». Cada elemento de configuración que aparece abajo se corresponde con las explicaciones sobre tokens y grupos en la documentación de APIYI apiyi.com. Toda cifra relacionada con velocidades o grupos se indicará como tomada del texto original de la documentación.
Valor clave: después de leer esto, puedes crear un token independiente para cada proyecto, limitar cuánto puede gastar, durante cuánto tiempo puede usarse, qué modelos puede invocar y por qué grupo debe pasar, y consultar el consumo de cada proyecto en los registros de tokens.
Puntos clave de la gestión multi-modelo empresarial: claves, cuotas y registros separados por proyecto
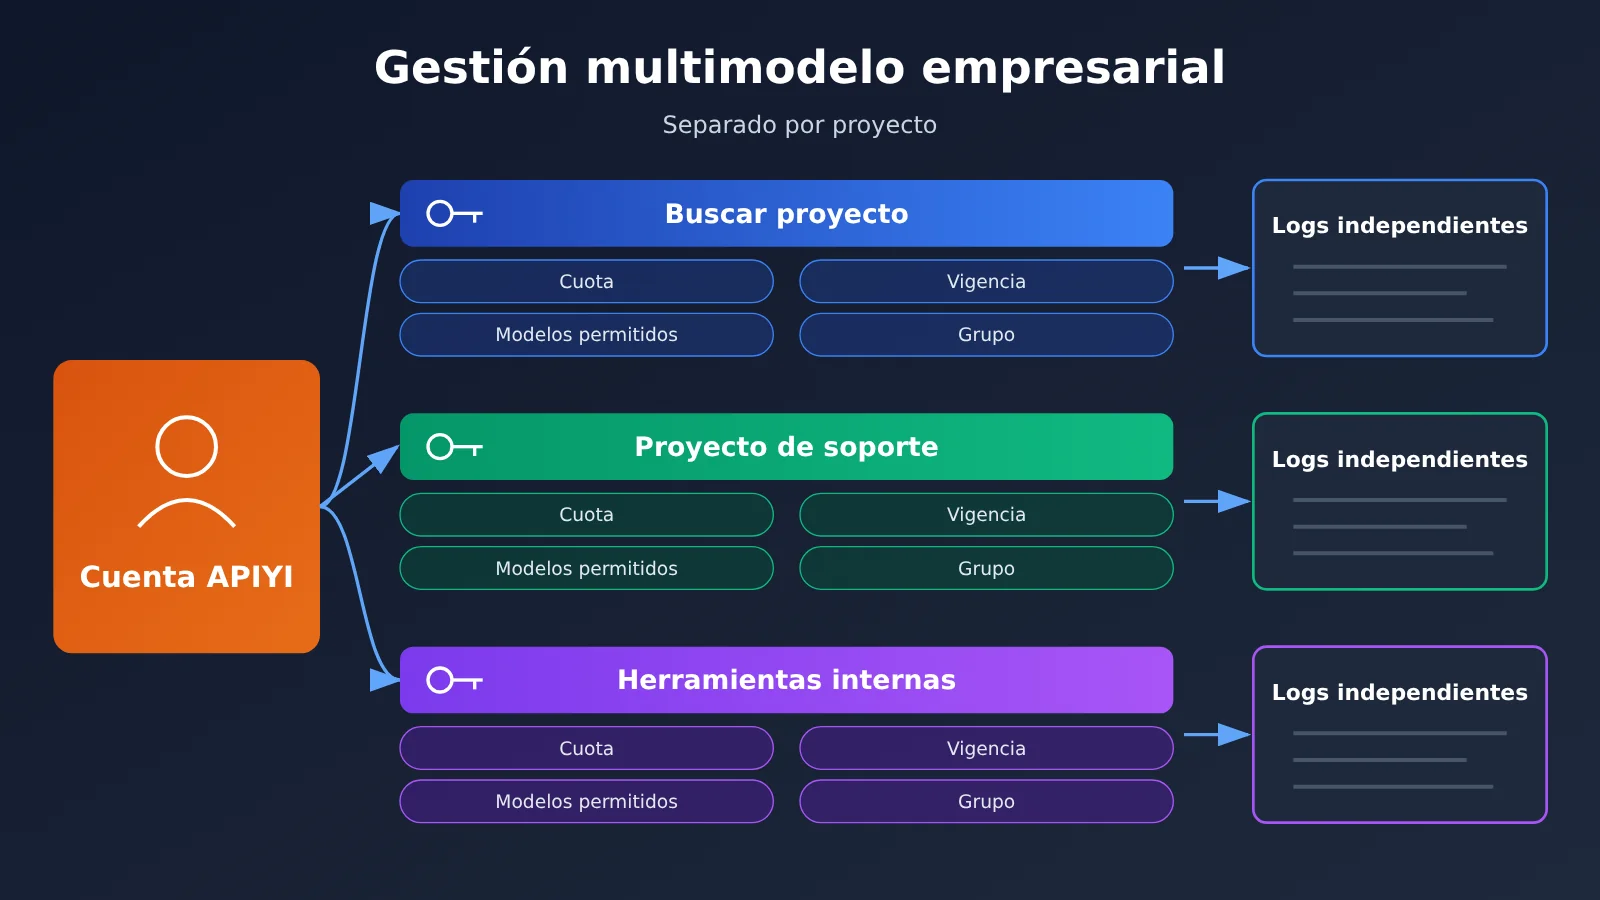
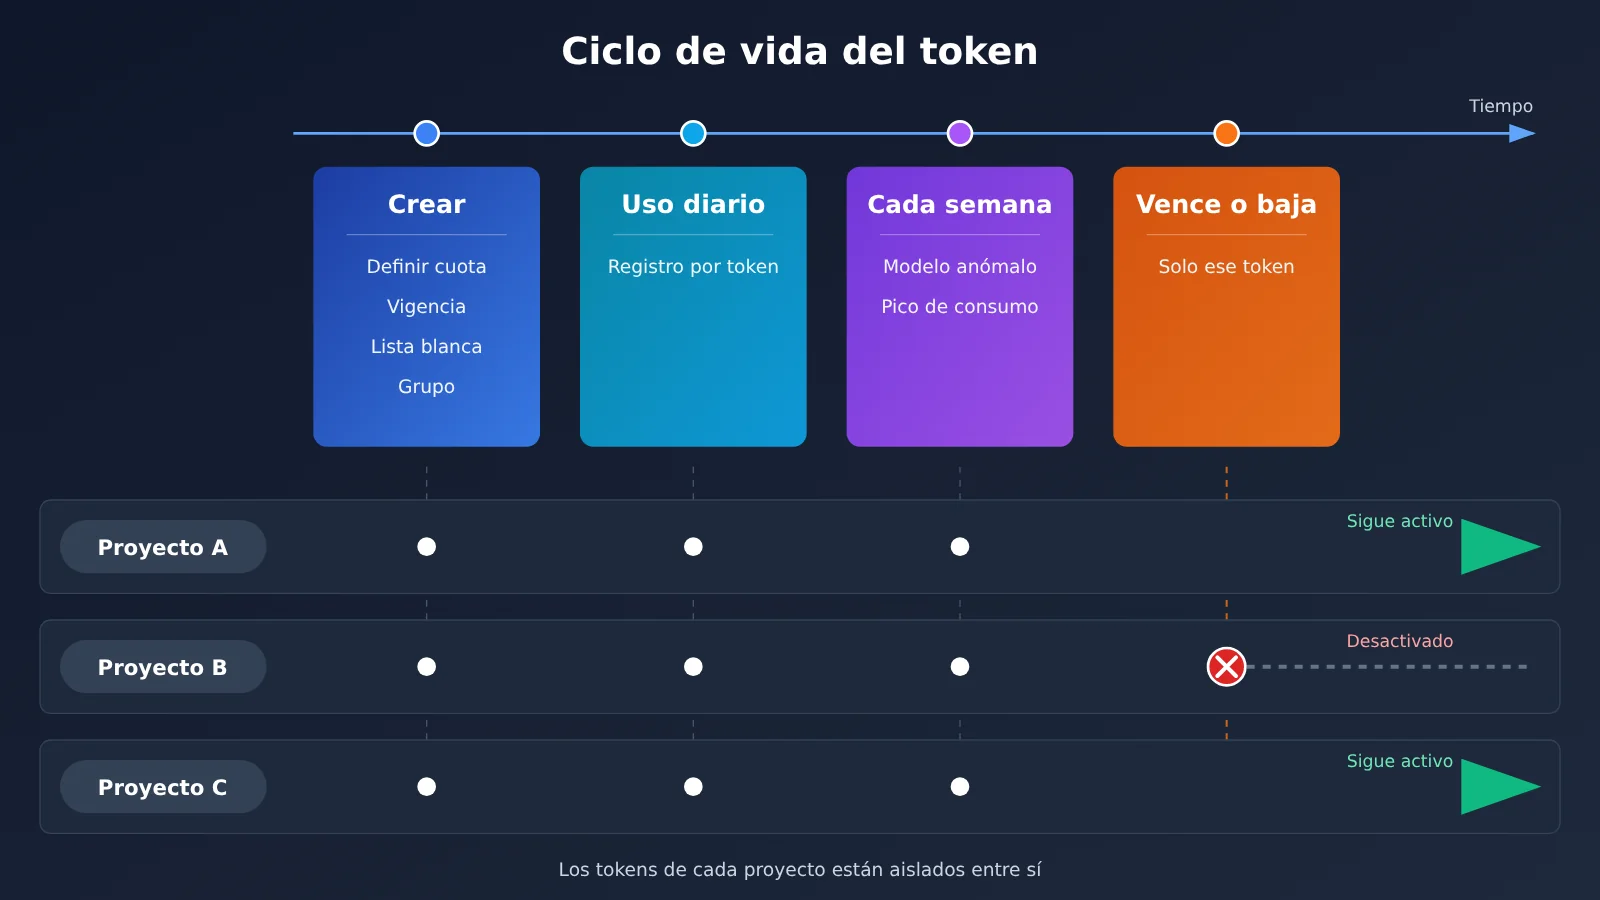
La clave de la gestión multi-modelo empresarial está en separar los límites de gestión, no en concentrarlos en una única llave maestra. En APIYI, el token es la clave API y comienza con sk-. La documentación indica que cada token puede configurar de forma independiente la cuota, la fecha de expiración, los modelos disponibles y el grupo; además, el consumo, la cuota restante y los registros de invocación también se registran por separado.
| Aspecto | Descripción | Valor para el responsable de desarrollo |
|---|---|---|
| Crear tokens por proyecto | Al registrarse se incluye un token predeterminado, y puedes crear uno para cada proyecto o cada miembro | Al desactivar a una persona o un proyecto, no afecta a los demás invocadores |
| Configurar cuota y vigencia por separado | Cada token permite fijar un límite de cuota y una fecha de expiración | Los sobrecostes de presupuesto y los vencimientos de outsourcing se pueden limitar de antemano |
| Lista blanca de modelos | Sin lista blanca, puedes usar los más de 200 modelos seleccionados de toda la plataforma (según la documentación); con lista blanca, solo se pueden usar los modelos indicados | Evita que un proyecto cambie por su cuenta a un modelo más caro |
| El grupo determina el canal y el multiplicador | El grupo define el upstream, los modelos disponibles y el multiplicador de facturación | El mismo modelo en distintos grupos puede dar facturas diferentes |
| Registros separados por token | El consumo y los registros de invocación de cada token se consultan por separado | La conciliación de fin de mes se puede hacer directamente contra cada proyecto |
Por qué separar tokens por proyecto en la gestión multi-modelo empresarial
Hay un punto de la documentación que conviene aclarar primero: cuando varias personas usan un mismo token, el limitador de velocidad depende de la cuenta, no de la cantidad de tokens. La documentación original dice que, en general, una sola cuenta no tiene problemas dentro de 100 RPM, y que el TPM no se evalúa. Esto es lo que afirma la documentación, no el resultado de una prueba de carga, y tampoco constituye un SLA.
Por eso, el objetivo de separar tokens no es esquivar el límite de velocidad, sino lograr aislamiento de gestión. Un token corresponde a un proyecto o a un miembro; cuando surge un problema, solo se detiene ese token, y al revisar las cuentas solo se mira ese token. Si todos comparten el token predeterminado, el consumo en los registros se mezcla y no se puede separar por proyecto, ni se puede detener con precisión a un invocador concreto.
Reglas de grupos y respaldo en la gestión multi-modelo empresarial
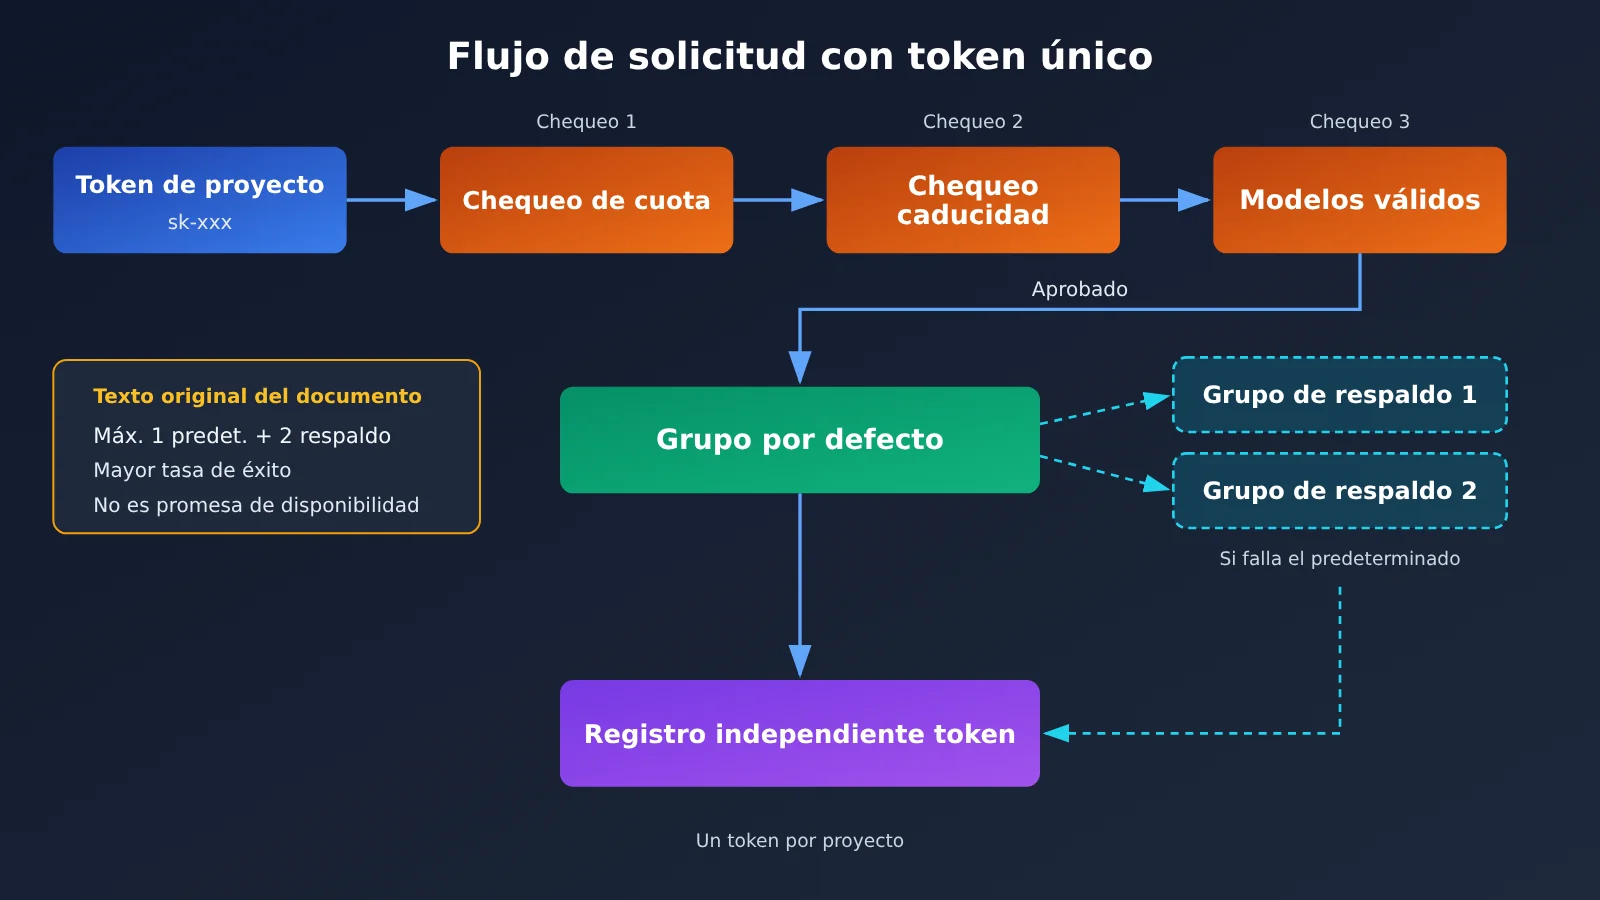
El grupo es el canal de recursos. Según la documentación original, un token puede configurar como máximo 1 grupo predeterminado y 2 grupos de respaldo. El respaldo significa que, cuando el grupo predeterminado no puede satisfacer la solicitud, el sistema cambia automáticamente al grupo de respaldo. La documentación describe el respaldo como «mejorar la tasa de éxito de las invocaciones», no como una garantía de disponibilidad, así que no hay que entenderlo como «nunca falla».
La gran mayoría de los modelos de texto pueden usar el grupo Default. Los modelos exclusivos, como los de vídeo, requieren otro grupo; si el token no tiene ese grupo, el modelo correspondiente no se puede invocar. Además, hay que tener en cuenta que «más de 200 modelos» se refiere al total de modelos seleccionados de toda la plataforma, y no significa que cada modelo esté en el grupo Default; hay que guiarse por el grupo indicado en la página de cada modelo.
Gestión de múltiples modelos en la empresa: guía rápida con 5 pasos para crear tokens por proyecto
A continuación, tomamos como ejemplo un equipo con tres proyectos —búsqueda aumentada, robot de atención al cliente y herramienta interna de redacción— para mostrar el flujo completo de configuración. El punto de acceso es la página de tokens https://api.apiyi.com/token.
Paso 1: planifica los tokens; un token por proyecto o por persona
Primero prepara una tabla de planificación de tokens y luego créalos en el panel de administración. Así evitas ir creando y modificando sobre la marcha y acabar volviendo al viejo esquema de «una sola llave para todos».
| Nombre del token | Quién lo usa | Lista blanca de modelos | Grupo predeterminado | Grupo de respaldo | Cuota y vigencia recomendadas |
|---|---|---|---|---|---|
proj-search |
Servicio de búsqueda aumentada | gemini-3.8-flash, qwen3.8-max |
Default |
Configurar según los grupos disponibles en la página del modelo | Fijar la cuota según el presupuesto mensual; vigencia indefinida |
proj-support |
Robot de atención al cliente | claude-sonnet-5-5 |
Default |
Configurar según los grupos disponibles en la página del modelo | Fijar la cuota según el presupuesto mensual |
team-writing-zhang |
Herramienta personal de un miembro del equipo | claude-opus-5-5 |
Default |
Sin configurar | Cuota pequeña; establecer fecha de caducidad |
vendor-outsource |
Equipo subcontratado | Incluir solo los modelos necesarios para la entrega | Default |
Sin configurar | Cuota alineada con el ciclo del contrato; caduca automáticamente al vencer |
Las recomendaciones de gestión de la tabla reflejan nuestro criterio. Para saber a qué grupos pertenece cada modelo en concreto, consulta la página del modelo; no copies esta tabla al pie de la letra.
Paso dos: crear el token y configurar las cuatro restricciones
Al crear un token nuevo en la página de tokens, rellena los cuatro campos en este orden:
- Cuota: ajústala al presupuesto mensual del proyecto. Cuando se agota, ese token deja de consumir saldo y los demás tokens no se ven afectados.
- Fecha de expiración: imprescindible para externos y colaboradores temporales; al vencer, no hay que recuperarlos a mano.
- Modelos disponibles (lista blanca): marca solo los modelos que el proyecto necesita de verdad. Si lo dejas vacío, equivale a abrir todos los modelos del sitio, y eso no es recomendable.
- Grupos: elige primero el grupo predeterminado y luego añade, si hace falta, hasta 2 grupos de respaldo.
Paso tres: meter las claves en variables de entorno, con un nombre de variable distinto por proyecto
No dejes las claves escritas a fuego en el código ni en el repositorio. Lo recomendable es que cada proyecto use un nombre de variable de entorno propio; por ejemplo, en el entorno de despliegue defines APIYI_KEY_SEARCH=sk-... y APIYI_KEY_SUPPORT=sk-..., y luego cada servicio lee la suya. Así, cuando rotas la clave de un proyecto concreto, solo tienes que cambiar una variable.
Cuarto paso: llamar mediante la interfaz compatible con OpenAI
APIYI ofrece una interfaz compatible con OpenAI. Para integrarla solo hay que cambiar dos cosas:
- Establecer
base_urlenhttps://api.apiyi.com/v1 - Leer
api_keydesde la variable de entorno del propio proyecto, por ejemploos.environ["APIYI_KEY_SEARCH"]
Con el SDK oficial de Python, el núcleo es una sola línea de inicialización: client = OpenAI(api_key=os.environ["APIYI_KEY_SEARCH"], base_url="https://api.apiyi.com/v1"). Después basta con llamar a client.chat.completions.create(model="gemini-3.8-flash", messages=[...]). Si cambias model por un modelo que no esté en la lista blanca, ese token no podrá realizar la llamada. Esto es justamente lo que se busca conseguir con la lista blanca.
Quinto paso: revisar los registros de tokens cada semana y conciliar por token a fin de mes
El consumo, el saldo restante y los registros de llamadas de cada token se pueden consultar por separado. Se recomienda revisar los registros de cada token una vez por semana, prestando atención a dos cosas: si ha aparecido algún modelo no previsto y si la curva de consumo se ha disparado de repente. Al final del mes, agregando por token obtendrás el costo desglosado por proyecto.
🎯 Consejo técnico: al ponerlo en marcha por primera vez, se recomienda desactivar el token predeterminado o dejarlo solo para los administradores, y luego crear uno a uno los tokens en la página de tokens de APIYI apiyi.com siguiendo la tabla de planificación anterior. Así, desde el primer día, todas las llamadas podrán atribuirse a un proyecto concreto en los registros.
La factura de gestionar múltiples modelos en la empresa: cambiar de modelo cambia la factura
Lo que los equipos multimodelo pasan por alto con más frecuencia es esto: cambiar un modelo o cambiar un grupo hace que la factura cambie también. Los precios de abajo vienen de la tabla general de modelos de APIYI, todos son precios de lista predeterminados por millón de tokens, con datos actualizados el 2026-11-16 09:39 (UTC+8).
| ID del modelo | Precio de entrada | Precio de salida | Lectura de caché | Endpoints / grupos indicados en la documentación | Plataforma disponible |
|---|---|---|---|---|---|
claude-opus-5-5 |
$4 | $20 | $0.2 | Endpoints chat y messages | APIYI apiyi.com |
claude-sonnet-5-5 |
$2 | $10 | $0.1 | Según la página del modelo | APIYI |
qwen3.8-max |
$1.65 | $4.95 | $0.20625 | Endpoints chat y messages; grupos ClaudeCode, Default, SVIP | APIYI |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse con multiplicador 0.5×, Default y SVIP a 1× | APIYI |
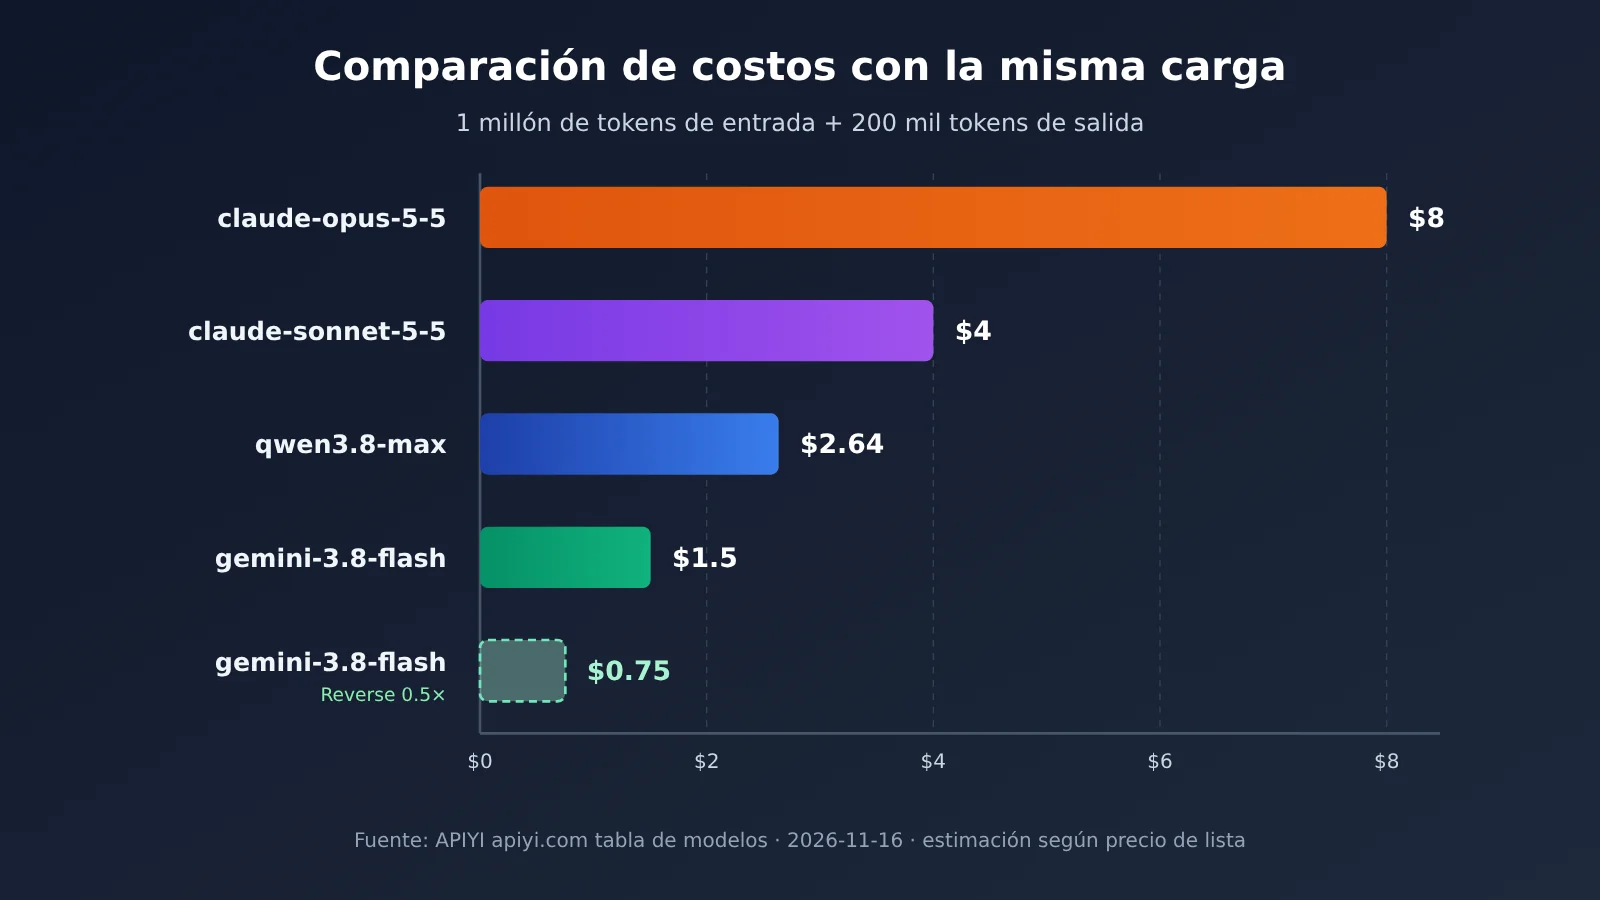
Según la documentación, la fórmula de facturación por uso es: tokens de entrada × precio de entrada + tokens de salida × precio de salida. Supongamos que un proyecto consume al mes 1 millón de tokens de entrada y 200 mil tokens de salida; estimando con los precios de lista:
claude-opus-5-5: 4 + 0.2 × 20 = $8claude-sonnet-5-5: 2 + 0.2 × 10 = $4qwen3.8-max: 1.65 + 0.2 × 4.95 = $2.64gemini-3.8-flash(Default, 1×): 0.75 + 0.2 × 3.75 = $1.5; si va por Gemini_Reverse (0.5×), al convertir según el multiplicador sale aproximadamente $0.75
Como se puede ver, con la misma carga de trabajo, cambiar de modelo hace que el costo varíe varias veces, y cambiar de grupo también altera directamente el cobro real. Por eso establecer listas blancas y grupos para los tokens es, en esencia, poner un techo al precio unitario del proyecto. Al consultar modelos y comparar precios, toma como referencia la lista de modelos de APIYI apiyi.com. Después de confirmar en qué grupos está un modelo y cuál es su multiplicador, agrégalo al token correspondiente. La dirección de llamada es uniforme: https://api.apiyi.com/v1; para cambiar de modelo solo hay que modificar el parámetro model, no hace falta cambiar base_url.
Si el equipo está evaluando un modelo recién publicado, por ejemplo qwen4-max, lanzado por Alibaba Cloud el 2026-11-16, hay que tener en cuenta que por ahora no está en la tabla general y tampoco aparece en la interfaz de precios de la plataforma. Aún no está disponible; lo publicaremos lo antes posible. Los modelos y precios se rigen por la lista de modelos de la plataforma. Antes de que esté disponible, no lo incluyas en la planificación de listas blancas de ningún token.
Modelos de facturación en la gestión empresarial de múltiples modelos: no mezclar pago por consumo y pago por solicitud
El documento recomienda usar «prioridad al pago por consumo» para los modelos de texto. El pago por solicitud consiste en un precio fijo por cada petición y se usa principalmente para imágenes y video. Si un mismo token se emplea tanto para texto como para generar imágenes, en los logs aparecerán registros de facturación por token y por solicitud al mismo tiempo; como las unidades son distintas, no se pueden sumar directamente.
Lo más recomendable es crear tokens separados para los proyectos de texto y los de generación de imágenes o video. Los modelos dedicados, como los de video, ya requieren un grupo independiente; después de separarlos, tanto la configuración de grupos como las unidades de facturación quedan más claras.
| Forma de facturación | Método de cálculo (texto original del documento) | Uso típico | Recomendación de separación de tokens |
|---|---|---|---|
| Por consumo | tokens de entrada × precio de entrada + tokens de salida × precio de salida | Conversación de texto, código, resúmenes | Un token aparte para el proyecto de texto; el documento recomienda priorizar el pago por consumo |
| Por solicitud | Precio fijo por cada petición | Generación de imágenes y video | Un token aparte para imágenes/video, con el grupo dedicado correspondiente configurado |
Sobre la liquidación, el documento indica que las recargas se liquidan a un tipo de cambio fijo de 1:7, pueden combinarse con promociones de recarga y el cargo real se rige por la consola. Los procesos de compra, contratos y facturas no se abordan en este artículo; si los necesita, confirme directamente con la plataforma.
💡 Sugerencia de selección: cree un token aparte con límite bajo para modelos de alto precio (como
claude-opus-5-5) y entréguelo solo a quienes realmente lo necesiten. El token para tareas batch diarias debe incluir únicamente modelos de precio unitario bajo. En APIYI apiyi.com, revise primero la lista de modelos, los grupos y los multiplicadores antes de asignar; así evitará facturas sorpresa a fin de mes.
Preguntas frecuentes sobre la gestión empresarial de múltiples modelos
P1: ¿Qué es la gestión empresarial de múltiples modelos con tokens separados por proyecto?
Consiste en crear, dentro de una misma cuenta, una clave API (token) independiente para cada proyecto o miembro. Cada token tiene su propia cuota, fecha de vencimiento, lista blanca de modelos y grupo. El consumo y los registros de invocación se guardan por token, por lo que tanto la desactivación como la conciliación pueden hacerse con precisión hasta el nivel de proyecto.
P2: Si creo muchos tokens, ¿el límite de velocidad se multiplica?
No. La documentación indica claramente que el límite de velocidad depende de la cuenta y no del número de tokens. El texto original señala que, por lo general, una sola cuenta no tiene problemas dentro de 100 RPM y que TPM no se evalúa. Esto es solo lo que dice la documentación, no un SLA. Separar tokens sirve para aislar la gestión, no para aumentar la cuota.
P3: Si configuro un grupo de respaldo, ¿ya no habrá fallos?
No. Según la documentación, un token puede tener como máximo 1 grupo predeterminado más 2 grupos de respaldo. Los grupos de respaldo se activan automáticamente cuando el grupo predeterminado no puede satisfacer la solicitud, y su función es mejorar la tasa de éxito de las invocaciones. Del lado del negocio, aún deben mantenerse la lógica de reintentos y degradación.
P4: ¿Qué pasa si no se configura una lista blanca de modelos?
La documentación original dice: si no se configura la lista blanca, el token puede usar los más de 200 modelos destacados de toda la plataforma. Para la gestión, esto implica un riesgo considerable, porque un proyecto podría cambiar sin querer a un modelo de alto costo. En escenarios empresariales, se recomienda que cada token incluya solo los modelos que el proyecto realmente necesita.
P5: Si ya tengo código con el SDK de OpenAI, ¿cómo lo cambio para llamar usando tokens por proyecto?
Solo hay que cambiar dos cosas: establecer `base_url` en `https://api.apiyi.com/v1` y cambiar `api_key` para que se lea desde la variable de entorno del propio proyecto. Los tokens se crean en la página de tokens de APIYI (apiyi.com). Para cambiar de modelo, basta modificar el parámetro `model`.
P6: ¿Por qué cierto modelo de video no se puede invocar con mi token?
Los modelos exclusivos, como los de video, requieren un grupo aparte. Si este grupo no está configurado en el token, el modelo no estará disponible. Consulta la página del modelo para ver a qué grupo pertenece y luego añádelo a la configuración de grupos del token; también puedes crear un token exclusivo para el negocio de video.
P7: ¿Por qué el mismo modelo cuesta diferente en distintos proyectos?
Normalmente se debe a que el multiplicador del grupo es diferente. Por ejemplo, la página del modelo `gemini-3.8-flash` indica que el grupo Gemini_Reverse tiene un multiplicador de 0.5×, mientras que Default y SVIP tienen 1×. Al conciliar cuentas, hay que revisar modelo y grupo juntos, no solo el precio de lista.
P8: ¿Qué limitaciones tiene este enfoque?
Separar tokens resuelve el aislamiento de claves, cuotas y registros, pero no aumenta el límite de velocidad de la cuenta ni sustituye los reintentos y el monitoreo del lado del negocio. Los modelos recién publicados deben esperar a que se publiquen en la plataforma antes de poder añadirlos a la lista blanca. Los precios y grupos específicos deben verificarse en la lista de modelos de APIYI (apiyi.com).
Puntos clave para la gestión empresarial de múltiples modelos
- El token es la clave: comienza con
sk-, crea uno por proyecto o por miembro para poder desactivarlo de forma individual - Configura las cuatro restricciones en conjunto: cuota, tiempo de expiración, lista blanca de modelos y grupo; si falta una, queda un hueco en la gestión
- El límite de velocidad depende de la cuenta: la documentación original indica que, por lo general, no hay problema dentro de 100 RPM, que TPM no se evalúa y que dividir tokens no aumenta la cuota
- El respaldo no equivale a una garantía: como máximo 1 grupo predeterminado + 2 grupos de respaldo (según la documentación original); su función es mejorar la tasa de éxito
- Cambiar de modelo altera la factura: el precio unitario del modelo y el multiplicador del grupo determinan conjuntamente el cargo real; solo conciliando por token se ve con claridad
- Separa texto y generación de imágenes: las unidades por volumen y por uso son distintas; gestionar con tokens separados facilita la conciliación
- Entrada unificada: todos los proyectos pasan por
https://api.apiyi.com/v1; solo el token distingue permisos y facturación
Resumen
La gestión empresarial de múltiples modelos no requiere una llave maestra que abra los paneles de todos los proveedores, sino que hay que separar los permisos por proyecto:
- Claves separadas por proyecto: un token por proyecto o por persona; desactivar y rotar no se afectan mutuamente.
- Establecer límites de cuota y modelos: usa la cuota para controlar el gasto total, y la lista blanca y los grupos para controlar el precio unitario.
- Conciliar registros por token: revisa anomalías cada semana y resume los costos por token a fin de mes.
Recomendamos primero elaborar la tabla de planificación de tokens según el primer paso de este artículo, y luego crear cada token en la página de tokens de APIYI apiyi.com. Al verificar modelos, precios y grupos, toma como referencia la lista de modelos de la plataforma; así, al implementarlo una vez, podrás ordenar claramente la facturación de múltiples modelos.
📚 Referencias
-
Centro de documentación de APIYI: tokens y grupos, modos de facturación, tabla general de modelos
- Enlace:
docs.apiyi.com - Descripción: corresponde a las rutas
/faq/token-and-groups.md,/faq/token-billing-modes.md,/models.md,/models/gemini-3-8-flash.md; la información sobre tokens, grupos y precios de este artículo se basa en ellas
- Enlace:
-
Documentación de Alibaba Cloud Bailian Qwen4-Max: información publicada por el fabricante
- Enlace:
help.aliyun.com/zh/model-studio/qwen4-max - Descripción: este modelo fue publicado por el fabricante el 2026-11-16; el estado de disponibilidad en la plataforma se rige por la lista de modelos
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes ponerte en contacto con nosotros a través de la página de inicio del sitio web de APIYI; encontrarás más detalles sobre la configuración de tokens y grupos en el centro de documentación