Nota del autor: este artículo explica cómo construir un AI Agent personal con la interfaz del modelo, herramientas, memoria, programación y un entorno de ejecución, y usa como ejemplo un flujo de trabajo de inteligencia de noticias de IA para mostrar las responsabilidades y los costos de cada parte del sistema construido por cuenta propia.
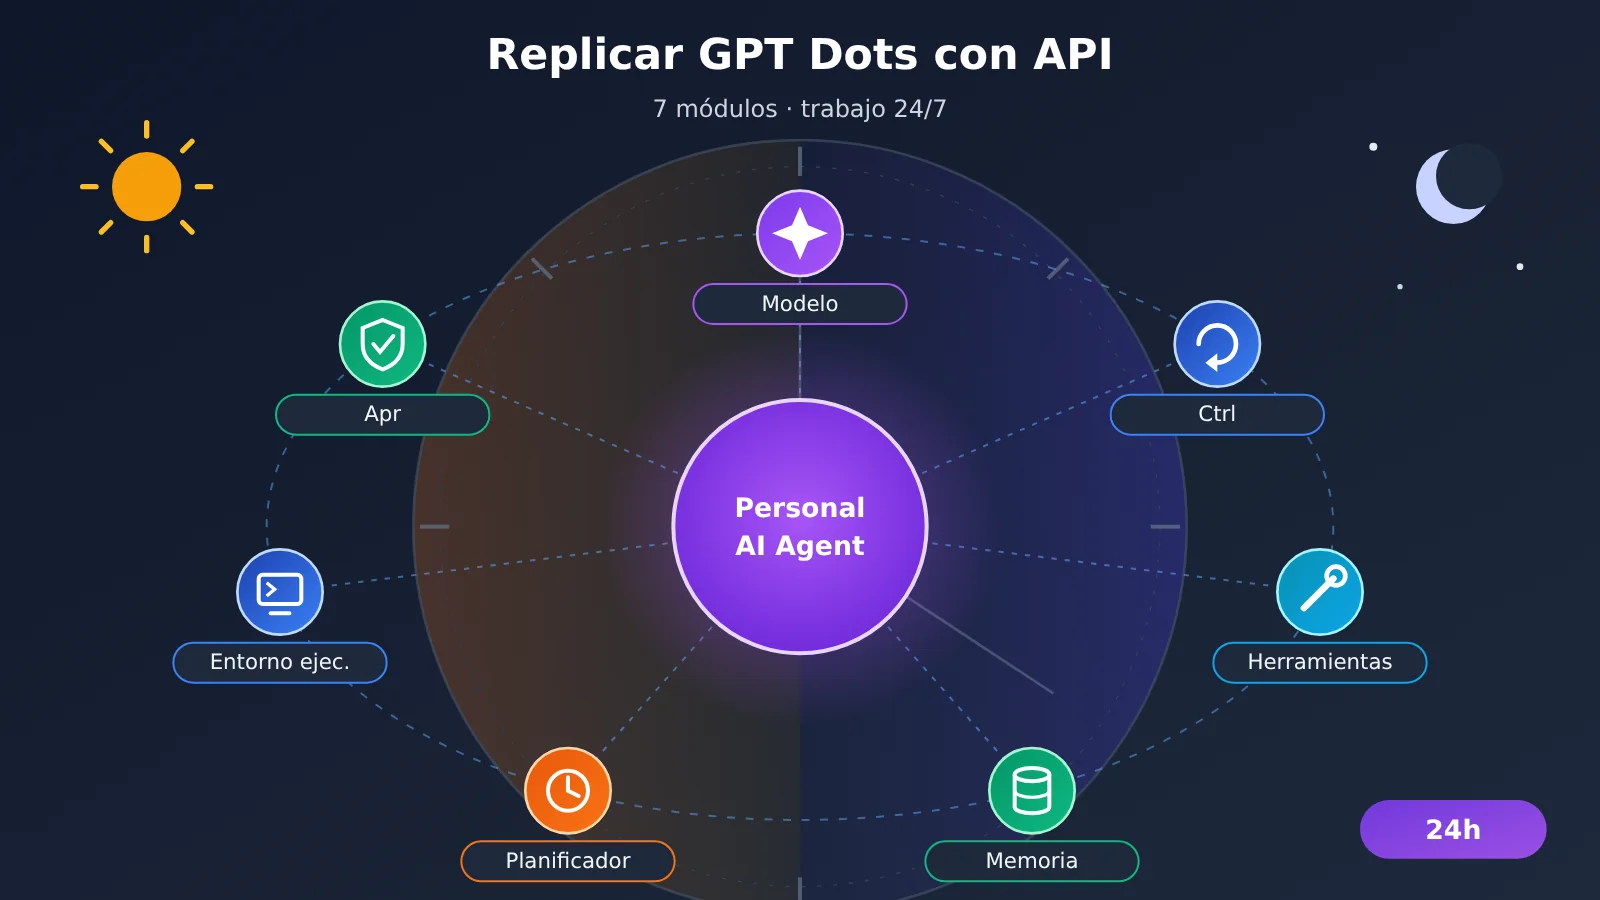
Reproducir GPT Dots con API significa reproducir su modo de trabajo: el modelo se encarga de decidir, el programa de ejecutar, la base de datos de recordar y el programador de hacer que las tareas sigan avanzando cuando ya te has ido. La interfaz del modelo es solo una de las capas. El sistema de herramientas, la memoria a largo plazo, la cola de tareas, el entorno de ejecución y el mecanismo de aprobación tienen que ser construidos por el propio desarrollador. La configuración de modelos propietarios de OpenAI, la computadora en la nube y el ecosistema de 4,000+ aplicaciones forman parte del producto Dots en sí, y esas partes no se pueden obtener directamente mediante API. El “24 horas” del título se refiere a la forma de trabajo en la que el Agent sigue avanzando tareas en segundo plano según lo planificado; el tiempo real de disponibilidad del sistema depende del servidor, la cola y los mecanismos de reintento.
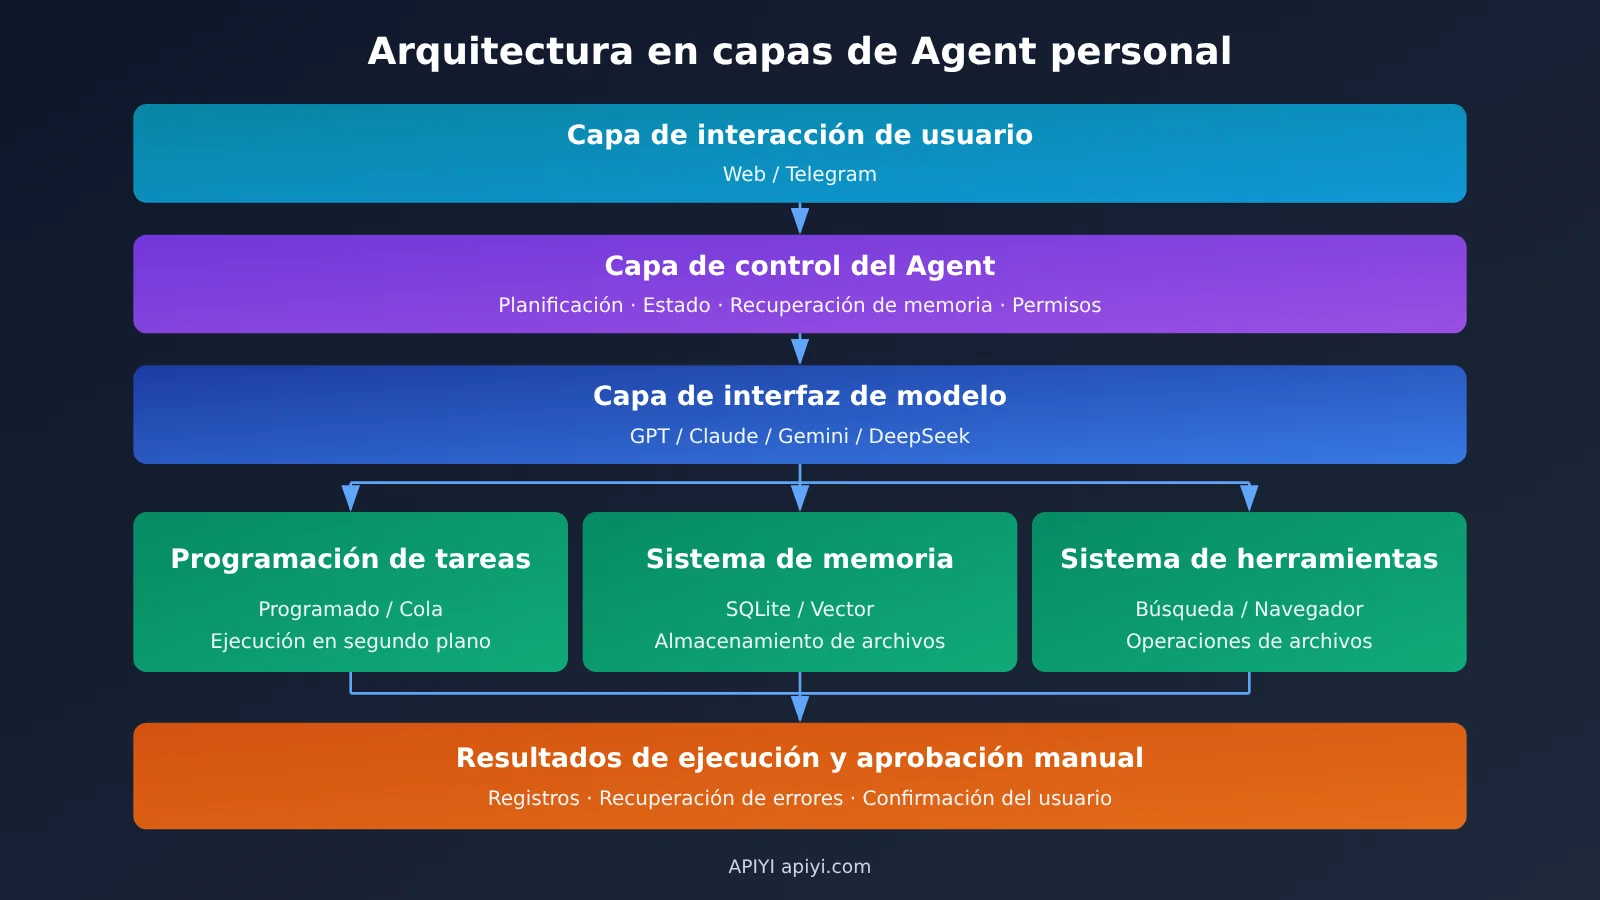
El artículo se desarrolla en el orden de construcción. La parte 1 divide Dots en 7 módulos e indica cuáles los proporciona el modelo y cuáles deben construirse por cuenta propia. Las partes 2 a 6 implementan, en orden, la integración del modelo, la invocación de herramientas, la memoria a largo plazo, la programación en segundo plano y el entorno de ejecución. La parte 7 combina estos componentes en el diseño completo de Personal AI Radar. La parte 8 calcula el costo total, incluidos los costos no relacionados con el modelo, y explica los límites de capacidad de la solución construida por cuenta propia.
Para saber: términos que conviene conocer antes de reproducir GPT Dots
| Término | Explicación |
|---|---|
| API | Interfaz mediante la cual una aplicación invoca un modelo o un servicio externo; en este artículo, se refiere principalmente a la interfaz de invocación de Modelos de Lenguaje Grande |
| Agente | Sistema de aplicación que usa el modelo para tomar decisiones, invocar herramientas y hacer avanzar las tareas |
| Function Calling | El modelo emite una solicitud estructurada de invocación de herramienta; tu programa la ejecuta y luego devuelve el resultado al modelo |
| tool_use / tool_result | Tipos de mensaje de la interfaz Claude Messages que representan, respectivamente, la solicitud de invocación de herramienta y el resultado de su ejecución |
| SQLite | Base de datos embebida de un solo archivo, adecuada para guardar datos ligeros como preferencias, estados de tareas y registros |
| Búsqueda vectorial | Convertir texto en vectores y localizar información relacionada según la similitud semántica |
| Cola de tareas | Almacena las tareas pendientes y las distribuye a los Workers en segundo plano por orden o por prioridad |
| Checkpoint | Instantánea del progreso guardada cuando la tarea alcanza determinado paso, desde la cual se puede reanudar tras una interrupción |
| Entorno de ejecución | La computadora o el contenedor donde realmente se ejecutan el navegador, el código y las operaciones de archivos |
| Playwright | Biblioteca de automatización que controla el navegador mediante código, usada para abrir páginas web, hacer clic y extraer contenido |
| Prompt Injection | Ataque en el que páginas web o documentos esconden instrucciones maliciosas para intentar secuestrar el comportamiento del Agente |
| MCP | Protocolo abierto que conecta aplicaciones de modelos con herramientas externas y fuentes de datos |
1 ¿De qué módulos se compone GPT Dots?
1.1 Las capacidades oficiales de GPT Dots
Dots es un agente personal de IA siempre activo que OpenAI lanzó el 29 de septiembre de 2026. Según la documentación oficial, tiene su propia computadora en la nube y su propio navegador; cuando el usuario apaga su computadora, las tareas en la nube que ya se hayan delegado siguen ejecutándose. Puede combinar la memoria de ChatGPT, sus propias notas y los datos de las aplicaciones conectadas, avanzar varios proyectos a la vez y comunicarse con el usuario a través de ChatGPT, Slack, Microsoft Teams y otros canales.
La forma de trabajar de Dots también incluye tres mecanismos clave. La investigación proactiva (Proactive Research) lee en segundo plano fuentes de información autorizadas y genera notas de investigación; este proceso es de solo lectura, y las acciones posteriores deben pasar por el flujo normal de aprobación. Las tareas programadas y la monitorización de eventos permiten que Dot trabaje de forma continua según un plan o según eventos. Custom Rules y Auto-review comprueban permisos e intención del usuario antes de operaciones como enviar correos o comprar; las operaciones de alto riesgo, como transferencias o cambios de contraseña, deben quedar en manos del usuario.
1.2 Los siete módulos de GPT Dots y su correspondencia con una implementación propia
Si descomponemos las capacidades de Dots, obtenemos 7 módulos. La siguiente tabla muestra la implementación correspondiente de cada módulo en una solución propia:
| Módulo | Cómo se manifiesta en Dots | Implementación correspondiente en una solución propia | ¿Quién lo proporciona? |
|---|---|---|---|
| Modelo | Razonamiento, planificación, selección de herramientas | API de modelos como GPT, Claude, Gemini, DeepSeek, etc. | Servicio de modelos |
| Controlador del agente | Dividir tareas, coordinar múltiples proyectos | Bucle escrito por uno mismo o LangGraph, OpenAI Agents SDK | Desarrollador |
| Herramientas | Navegador, complementos de aplicaciones, Codex | Function Calling + funciones de herramienta implementadas por uno mismo, servicios MCP | Desarrollador |
| Memoria | ChatGPT Memory, notas de Dot, contexto del proyecto | SQLite + recuperación vectorial + sistema de archivos | Desarrollador |
| Programación de tareas | Tareas programadas, monitorización de eventos, agente en segundo plano | APScheduler, Celery, cola Redis | Desarrollador |
| Entorno de ejecución | Computadora en la nube independiente | Servidor en la nube, Docker, Playwright | Desarrollador |
| Aprobación de seguridad | Custom Rules, Auto-review, control por parte del usuario | Lista blanca de herramientas, cola de aprobaciones, registro de operaciones | Desarrollador |
En la tabla, solo la primera fila la proporciona directamente la API de modelos; las otras seis filas requieren implementación de ingeniería. Esta es la razón por la que “una clave API por sí sola no basta para obtener todas las capacidades de Dots”: la clave API abre la puerta de la invocación del modelo; las manos y los pies, la memoria y la rutina del agente tendrás que montarlos tú mismo.
2 Preparar las interfaces de modelo necesarias para reproducir GPT Dots
2.1 Conectar varios modelos mediante APIYI
APIYI apiyi.com ofrece interfaces compatibles con OpenAI y la interfaz nativa Messages de Claude. Con una sola clave API puedes invocar modelos de distintos proveedores. Los diferentes modelos utilizan protocolos distintos, así que hay que distinguirlos al configurar:
| Tipo de modelo | Protocolo | Base URL | Campos de invocación de herramientas |
|---|---|---|---|
| Modelos compatibles con OpenAI como GPT, DeepSeek, Qwen | OpenAI Chat Completions | https://api.apiyi.com/v1 |
tools / tool_calls |
| Claude | Anthropic Messages (/v1/messages) |
https://api.apiyi.com |
tool_use / tool_result |
| Gemini | Protocolo compatible con Gemini | Configurar según la interfaz correspondiente en la documentación oficial | Según el protocolo correspondiente |
Los ID de modelo y los precios en tiempo real se rigen por la lista de modelos de la plataforma. El código siguiente lee los ID de modelo de forma uniforme desde variables de entorno; para cambiar de modelo solo hay que ajustar la configuración, y el código del Agent permanece igual.
2.2 La invocación mínima del modelo para reproducir GPT Dots
Primero comprobemos que la interfaz responde. Guarda el siguiente código como llm.py; en los capítulos siguientes importaremos client desde aquí:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Interfaz compatible con OpenAI de APIYI
)
MODEL = os.environ["RADAR_MODEL"]  # Rellena con el ID del modelo realmente disponible en la lista de modelos

if __name__ == "__main__":
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[{"role": "user", "content": "用三句话说明什么是个人 AI Agent"}],
    )
    print(resp.choices[0].message.content)
Cuando Claude utiliza la interfaz nativa Messages, se usa el SDK de Anthropic y la Base URL no lleva /v1:
import os
import anthropic

claude = anthropic.Anthropic(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com",  # El SDK añade automáticamente /v1/messages
)

resp = claude.messages.create(
    model=os.environ["CLAUDE_MODEL"],
    max_tokens=1024,
    tools=[{
        "name": "search_news",
        "description": "检索近期 AI 新闻",
        "input_schema": {
            "type": "object",
            "properties": {"query": {"type": "string"}},
            "required": ["query"],
        },
    }],
    messages=[{"role": "user", "content": "查一下今天的模型发布新闻"}],
)
for block in resp.content:
    if block.type == "tool_use":
        print(block.id, block.name, block.input)
Cuando Claude devuelve tool_use, tu programa ejecuta la herramienta y luego envía un bloque tool_result con role: user, usando tool_use_id para vincularlo a la solicitud; si la herramienta falla, se establece is_error: true y el modelo ajustará el siguiente paso en función de eso.
🚀 Inicio rápido: primero ejecuta los dos fragmentos anteriores con la cuota de prueba gratuita de APIYI, comprueba que tanto la vía compatible con OpenAI como la vía nativa de Claude devuelven llamadas a herramientas, y luego pasa al desarrollo del Agent.
2.3 Diferencias en compatibilidad de interfaces y capacidad de llamada a herramientas
La compatibilidad de protocolos resuelve el problema de “poder enviar la solicitud”, pero el rendimiento de cada modelo en las llamadas a herramientas sigue siendo diferente. La metodología de pruebas de llamada a herramientas para múltiples modelos publicada por APIYI en noviembre de 2026 ofrece varios puntos clave de observación: en la serie Gemini, hay que fijarse en las llamadas paralelas y en si se cuela texto adicional en el JSON final; en la serie Qwen, en la selección cuando hay herramientas distractoras y en el mapeo de ID a lo largo de múltiples turnos; en la serie Claude, en el manejo de is_error y en el número de rondas de llamada; y en la serie GPT, en el grado de cumplimiento estricto del Schema y en el consumo de tokens.
Estos son puntos de atención para las pruebas, no una preferencia preestablecida por un modelo. Se recomienda dar a los modelos candidatos la misma definición de herramientas y las mismas tareas, registrar el número de llamadas, el número de errores de parámetros, el total de tokens y la tasa final de aciertos, y decidir con datos cuál será el modelo principal del agente.
La Responses API también debe validarse por separado. La documentación de APIYI indica que el endpoint /v1/responses lista principalmente modelos como GPT-4.1, o3, etc.; mientras que la documentación actual de llamadas a herramientas de OpenAI señala que GPT-6 Astra y GPT-6.1 Sol usan la Responses API. Si tienes previsto usar las capacidades de Responses API de los nuevos modelos, debes incluir las llamadas a herramientas, las herramientas integradas y la gestión de estado como elementos de prueba de compatibilidad, y validar cada punto antes de pasar a producción.
3 Usar Function Calling para que los agentes tipo GPT Dots ejecuten tareas
3.1 El ciclo de trabajo de Function Calling
El ciclo de Function Calling tiene solo cuatro pasos: el programa envía la tarea y la definición de las herramientas al modelo; el modelo devuelve el nombre de la herramienta que quiere invocar junto con sus parámetros; el programa ejecuta realmente esa herramienta; el programa añade el resultado de la ejecución al mensaje y lo vuelve a enviar al modelo, que decide si seguir invocando o dar una respuesta.
La clave está en el tercer paso. El modelo solo genera la solicitud de invocación; acceder al buscador, leer y escribir archivos, enviar mensajes… todo eso lo hace tu código. Por eso, el alcance de permisos de las herramientas, la validación de las entradas y la gestión de fallos recaen por completo en el desarrollador.
3.2 Un sistema mínimo de herramientas compuesto por tres tools
Personal AI Radar necesita tres herramientas básicas: search_news para buscar noticias, read_file para leer materiales del directorio de trabajo y save_note para escribir los resultados organizados en la base de datos de materiales. A continuación, el ciclo completo del Agent:
Ver el código completo del ciclo de invocación de herramientas reproducido con GPT Dots
import json
import pathlib
import sqlite3
from llm import client, MODEL

WORKDIR = pathlib.Path("./workspace").resolve()
DB_PATH = "radar.db"

TOOLS = [
    {"type": "function", "function": {
        "name": "search_news",
        "description": "检索近期 AI 新闻,返回标题、链接、发布时间和摘要列表",
        "parameters": {
            "type": "object",
            "properties": {
                "query": {"type": "string"},
                "days": {"type": "integer", "minimum": 1, "maximum": 7},
            },
            "required": ["query"],
        },
    }},
    {"type": "function", "function": {
        "name": "read_file",
        "description": "读取工作目录中的文本文件",
        "parameters": {
            "type": "object",
            "properties": {"path": {"type": "string"}},
            "required": ["path"],
        },
    }},
    {"type": "function", "function": {
        "name": "save_note",
        "description": "把一条整理好的新闻资料保存到资料库",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {"type": "string"},
                "url": {"type": "string"},
                "summary": {"type": "string"},
                "project": {"type": "string"},
            },
            "required": ["title", "url", "summary", "project"],
        },
    }},
]

def search_news(query: str, days: int = 1):
    # Conecta el servicio de búsqueda que elijas: API de búsqueda, agregador RSS o scraping propio
    raise NotImplementedError("请接入实际的搜索服务")

def read_file(path: str):
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):          # Solo se permite leer dentro del directorio de trabajo
        return {"error": "path outside workspace"}
    return {"content": p.read_text(encoding="utf-8")[:20000]}

def save_note(title: str, url: str, summary: str, project: str):
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "INSERT OR IGNORE INTO notes(url, title, summary, project) VALUES (?, ?, ?, ?)",
            (url, title, summary, project),
        )
    return {"saved": True}

REGISTRY = {"search_news": search_news, "read_file": read_file, "save_note": save_note}

def run_agent(task: str, system: str, max_rounds: int = 8) -> str:
    messages = [
        {"role": "system", "content": system},
        {"role": "user", "content": task},
    ]
    for _ in range(max_rounds):
        msg = client.chat.completions.create(
            model=MODEL, messages=messages, tools=TOOLS,
        ).choices[0].message
        messages.append(msg.model_dump(exclude_none=True))

        if not msg.tool_calls:
            return msg.content

        for call in msg.tool_calls:
            fn = REGISTRY.get(call.function.name)
            try:
                args = json.loads(call.function.arguments or "{}")
                result = fn(**args) if fn else {"error": "unknown tool"}
            except Exception as e:
                result = {"error": f"{type(e).__name__}: {e}"}
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })
    raise RuntimeError("超过最大工具调用轮次")
Este código tiene tres decisiones de diseño que conviene mantener. max_rounds limita el número de iteraciones del ciclo para evitar que el modelo llame una y otra vez a la misma herramienta y queme tokens. Las excepciones de las herramientas se envuelven en {"error": ...} y se devuelven al modelo, dándole la oportunidad de cambiar de parámetros o de plan. read_file usa la validación de rutas para encerrar el alcance de lectura dentro del directorio de trabajo: esa es la frontera de permisos más básica.
3.3 Pasar de un bucle escrito a mano a un framework de agentes
Un bucle escrito a mano encaja en escenarios de una sola tarea y pocas herramientas. Cuando la tarea requiere recuperación tras interrupciones, aprobación humana o ramificaciones complejas, se puede migrar a LangGraph: ofrece State para guardar el estado de la tarea, Checkpointer para persistir el progreso y Human-in-the-loop para pausar y esperar revisión. El OpenAI Agents SDK también ofrece orquestación de flujos de trabajo y Guardrails. Cuando crece el número de herramientas, MCP permite encapsular capacidades como búsqueda, archivos y correo en servicios independientes, reutilizables por varios agentes.
4 Cómo dotar de memoria a largo plazo a un agente estilo GPT Dots
4.1 División de la memoria en cuatro capas
El contexto de Dots proviene de ChatGPT Memory, de las notas del propio Dot, del contexto de la tarea actual y de los datos de aplicaciones conectadas. Además, las tareas nuevas solo recuperan historial cuando hace falta y no cargan el registro completo de conversaciones. Un agente propio puede adoptar la misma idea y gestionar la memoria por capas:
| Capa de memoria | Contenido almacenado | Ciclo de vida | Momento de escritura |
|---|---|---|---|
| Contexto actual | Instrucciones de la tarea actual, resultados recientes de herramientas | Tarea actual | Cada turno de conversación |
| Memoria de proyecto | Objetivos del proyecto, decisiones clave, progreso | Durante la vigencia del proyecto | Al completar la tarea o cambiar una decisión |
| Memoria de usuario | Preferencias, áreas de interés, formato de informes | Largo plazo | Cuando el usuario expresa una preferencia de forma explícita |
| Memoria de experiencia | Causas de fallos, métodos de corrección | Largo plazo, actualización según reglas | Tras un fallo de la tarea o una modificación del usuario |
En cada invocación del modelo, solo se incluye en el prompt el contexto actual más las memorias relevantes recuperadas. Meter todo el historial de mensajes en la solicitud aumenta el costo de tokens y reduce la calidad de la recuperación al mismo tiempo.
4.2 Diseño del esquema de tablas SQLite
El siguiente esquema de tablas cubre las cuatro capas de memoria y el estado de las tareas; la tabla runs también se encarga de la recuperación desde puntos de interrupción de la parte 5:
CREATE TABLE IF NOT EXISTS user_memory (
    key TEXT PRIMARY KEY, value TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS projects (
    id TEXT PRIMARY KEY, goal TEXT, decisions TEXT, status TEXT, updated_at TEXT
);
CREATE TABLE IF NOT EXISTS runs (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, run_date TEXT,
    next_stage TEXT, state_json TEXT,
    status TEXT, error TEXT, updated_at TEXT,
    UNIQUE (project_id, run_date)
);
CREATE TABLE IF NOT EXISTS notes (
    url TEXT PRIMARY KEY, title TEXT, summary TEXT, project TEXT,
    created_at TEXT DEFAULT CURRENT_TIMESTAMP
);
CREATE TABLE IF NOT EXISTS lessons (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    project_id TEXT, lesson TEXT, created_at TEXT
);
notes usa la URL como clave primaria, así que si se vuelve a extraer la misma noticia, se deduplica automáticamente. La restricción única (project_id, run_date) de runs garantiza que cada proyecto tenga solo un registro de ejecución por día; tras reiniciar, se puede encontrar el progreso de ese día.
4.3 Recuperar material histórico con búsqueda vectorial
Los datos estructurados se consultan con SQL; el material semánticamente relacionado se recupera con búsqueda vectorial. La idea es generar embeddings a partir de notes.summary y lessons.lesson, guardarlos en una base de datos vectorial como sqlite-vec o Chroma, y registrar el proyecto, la fecha y la fuente en los metadatos. Al generar temas, primero se buscan materiales similares de los últimos 30 días usando las noticias del día; se adjuntan al prompt los resúmenes de los resultados coincidentes y así el modelo puede determinar si «esta noticia es un avance de un tema existente o un evento completamente nuevo». De este modo, el usuario no tiene que volver a explicar el contexto cada vez.
5 Hacer que un Agent tipo GPT Dots trabaje continuamente en segundo plano
5.1 Diferencias entre los tres mecanismos en segundo plano
La ejecución en segundo plano involucra tres mecanismos, cada uno con responsabilidades distintas. Las tareas programadas son disparadas por un planificador del sistema (APScheduler, cron) según el tiempo, y resuelven «cuándo empezar». Las solicitudes de modelo en segundo plano se refieren a respuestas asíncronas como OpenAI Background Mode: tras enviar la solicitud se obtiene un response ID, se consulta el estado periódicamente y se recupera el resultado; tiene su propio ciclo de vida y condiciones de retención de datos, y resulta adecuada para inferencias únicas de larga duración. La programación de Agent a largo plazo se compone de una cola de tareas, estado persistente y Workers, y se encarga de impulsar, reintentar y recuperar tareas de varios días y de múltiples etapas.
El flujo de datos recomendado es: planificador → cola de tareas → Agent Worker → API del modelo → ejecución de herramientas → base de datos de resultados → notificación. Las tareas periódicas y las de larga duración se gestionan por separado: las periódicas solo se encargan de encolar, mientras que las de larga duración las avanza el Worker según el estado.
5.2 Checkpoint por etapas y reintento ante fallos
A continuación se muestra el esqueleto de programación de Personal AI Radar. Cada vez que se completa una etapa se escribe un Checkpoint, y tras reiniciar el proceso se continúa desde next_stage:
import time
from datetime import date
from apscheduler.schedulers.blocking import BlockingScheduler
from radar_store import load_or_create_run, save_checkpoint, mark_failed
from radar_stages import HANDLERS, TransientError
from notify import notify_owner

STAGES = ["collect", "verify", "analyze", "topics", "report"]

def daily_radar():
    run = load_or_create_run("ai-radar", date.today().isoformat())
    if run.status == "done":
        return
    start = STAGES.index(run.next_stage)
    for stage in STAGES[start:]:
        for attempt in range(3):
            try:
                run.state = HANDLERS[stage](run.state)
                save_checkpoint(run, done_stage=stage)   # Escribe en la tabla runs
                break
            except TransientError:                       # Errores reintentables como red, limitación de tasa, etc.
                time.sleep(30 * 2 ** attempt)
        else:
            mark_failed(run, stage)
            notify_owner(f"Radar 在 {stage} 阶段失败,进度已保存")
            return

sched = BlockingScheduler(timezone="Asia/Shanghai")
sched.add_job(daily_radar, "cron", hour=8, minute=0,
              misfire_grace_time=3600, max_instances=1)
sched.start()
max_instances=1 evita que se inicie de nuevo mientras la ronda anterior no ha terminado, y misfire_grace_time permite recuperar la tarea del día tras una breve caída del servidor. Cuando falla, se conserva el progreso y se notifica al usuario; el segundo disparo continúa desde la etapa fallida. La entrada, salida, tiempo de ejecución y consumo de Tokens de cada etapa se escriben en el log, lo que facilita el diagnóstico y el cálculo de costes.
6 Darle a un agente estilo GPT Dots una computadora con la que pueda trabajar
6.1 El reparto de funciones entre los cuatro tipos de entornos de ejecución
Dots cuenta con su propia computadora en la nube. Si lo construyes por tu cuenta, esta parte la tienes que aportar tú como desarrollador, y las opciones más habituales son cuatro:
- Playwright: controla el navegador mediante código; resulta adecuado para hacer scraping de páginas web con estructura estable y extraer datos después de iniciar sesión. Su comportamiento es predecible y el costo es bajo.
- Browser Use: permite que el modelo conduzca el navegador con lenguaje natural; encaja en tareas web donde la estructura de las páginas cambia y los pasos no son fijos. Cada paso consume una invocación del modelo.
- Computer Use: el modelo observa capturas de pantalla y opera el ratón y el teclado; sirve para software de escritorio sin API y requiere usarse junto con un entorno de escritorio virtual.
- Docker: entorno aislado para ejecutar código y procesar archivos. Los scripts que genera el agente se ejecutan dentro del contenedor, así que si algo falla no afecta a la máquina host.
6.2 Cómo combinan las decisiones del modelo y el entorno de ejecución
La API del modelo se encarga de decidir y el entorno de ejecución se encarga de actuar; los dos se conectan mediante funciones de herramienta. La combinación típica de Radar es esta: Playwright extrae el cuerpo de las noticias, un contenedor Docker ejecuta los scripts de limpieza de datos y el modelo solo recibe el texto ya limpio para tomar decisiones. El contenido de las páginas web se pasa siempre al modelo como “material de referencia”, y en la indicación del sistema se deja claro que las instrucciones que aparezcan en ese material no se deben ejecutar; las herramientas de envío y publicación entran todas en una cola de aprobación. Con esto se reduce el riesgo de inyección de indicaciones.
🎯 Consejo técnico: las llamadas a herramientas relacionadas con el entorno de ejecución hacen que el número de turnos de conversación aumente de forma notable. Antes de lanzar el producto, puedes comparar en APIYI, usando la misma definición de herramientas, cuántos turnos y cuánto consumo de tokens requiere cada uno de varios modelos candidatos, y luego decidir cuál será el modelo principal y cuál el de respaldo.
7 Práctica: construir Personal AI Radar con API
A continuación presento el diseño de Personal AI Radar, que muestra el flujo de trabajo completo desde la recopilación de información hasta el informe diario. El rendimiento real de cada etapa depende del modelo, el servicio de búsqueda y las fuentes de información que elijas; antes de ponerlo en producción, debes validarlo con datos reales.
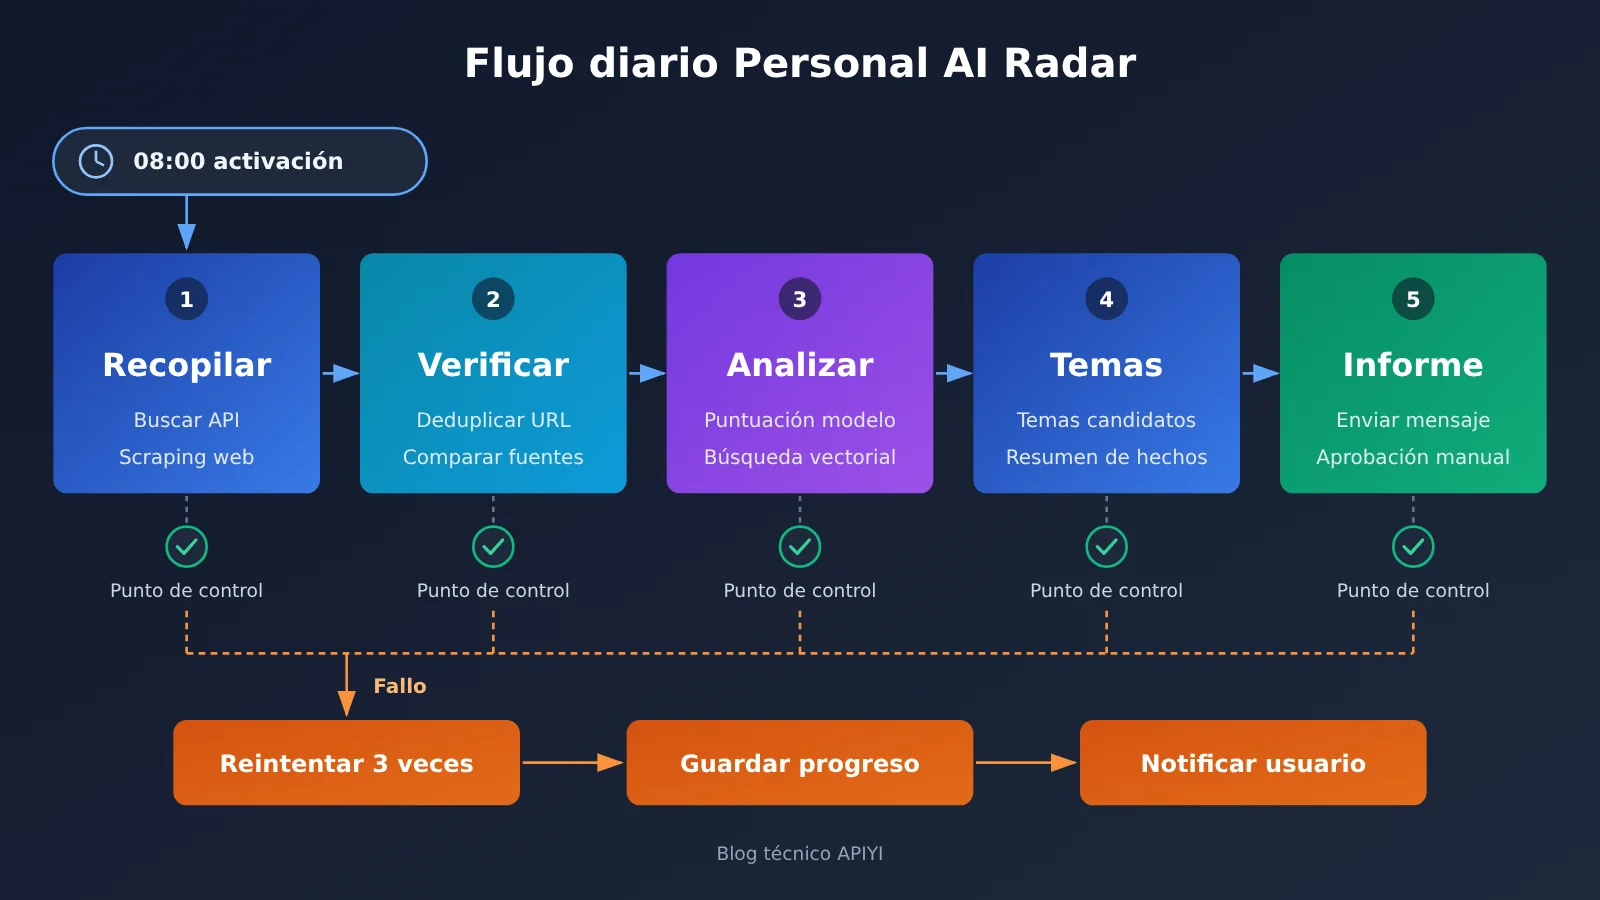
7.1 Las cinco etapas de Personal AI Radar
- Recopilar (collect): llama a
search_newspara buscar noticias de las últimas 24 horas según las palabras clave que sigue el usuario, usa Playwright para extraer el cuerpo de los artículos, deduplica por URL y lo guarda en un estado temporal. - Verificar (verify): realiza una comparación cruzada de múltiples fuentes sobre el mismo evento, dando prioridad a los anuncios oficiales y a las fuentes primarias; las entradas que solo tienen una única fuente se marcan como «pendientes de verificación».
- Analizar (analyze): el modelo genera para cada noticia un JSON estructurado que incluye el resumen del evento, los hechos clave con su procedencia y la relevancia respecto a las áreas de interés del usuario; al mismo tiempo, busca material histórico para determinar si es un evento nuevo o un avance de un tema ya existente.
- Seleccionar temas (topics): combina las preferencias de la memoria del usuario y los temas ya escritos en la memoria del proyecto para generar temas candidatos; cada tema viene con un resumen de hechos y enlaces a las fuentes, y se escribe en la tabla
notes. - Informar (report): genera el boletín del día y lo envía al usuario; cuando el usuario responde en el chat con instrucciones como «modificar», «volver a ejecutar» o «adoptar», el Agent actualiza la memoria del proyecto y vuelve a ejecutar según sea necesario.
7.2 Configuración clave y manejo de excepciones
Se recomienda concentrar la configuración central de Radar en un único archivo YAML, que incluya las palabras clave de interés, la lista blanca de fuentes, los ID del modelo principal y del modelo de respaldo, la hora diaria de ejecución, la zona horaria, el máximo de rondas de herramientas por ejecución y el límite de presupuesto diario de tokens. Los ID de los modelos se inyectan mediante variables de entorno, así que cambiar de modelo no requiere modificar el código.
El manejo de excepciones se distingue por tipo. Los errores temporales como tiempo de espera de red o limitación de velocidad se reintentan con retroceso exponencial; cuando falla el análisis del JSON generado por el modelo, el mensaje de error se devuelve como resultado de la herramienta para que el modelo vuelva a generarlo una vez; si el modelo principal falla repetidamente, se cambia al modelo de respaldo; cuando el uso de tokens del día supera el presupuesto, se omiten las entradas de baja relevancia en la etapa de análisis y se indica en el boletín. Todas las acciones de publicación o envío de correos solo generan borradores y esperan la confirmación del usuario.
8 Costos y límites de capacidad de un Agent propio al estilo GPT Dots
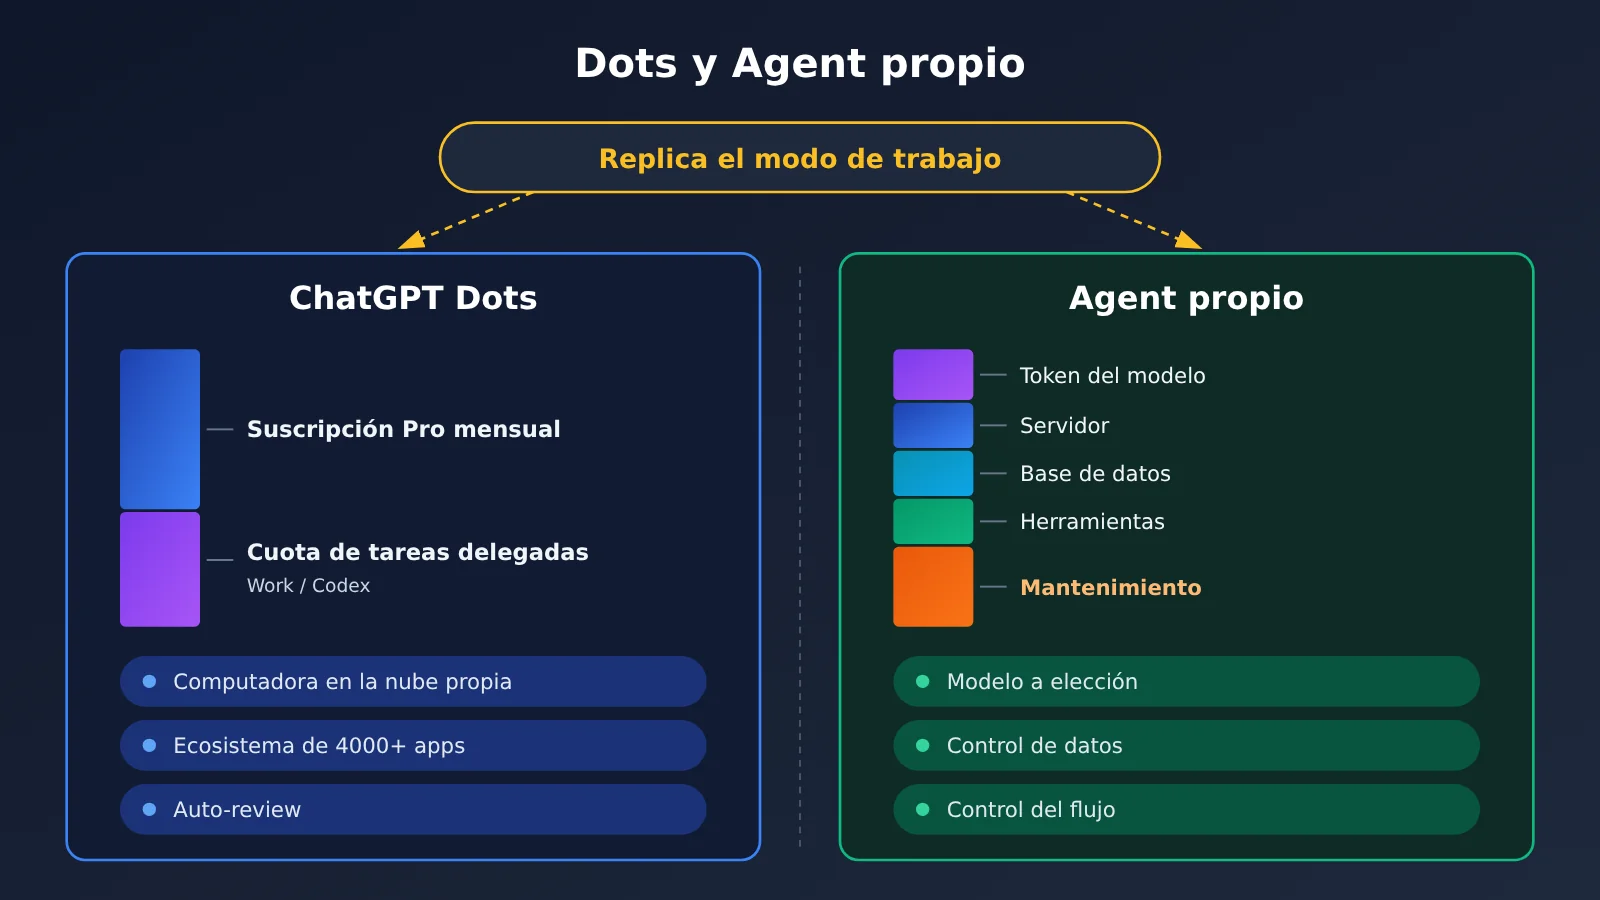
8.1 Los cinco costos de un desarrollo propio
El costo total de un Agent propio se puede expresar así:
C_total = C_model + C_server + C_database + C_tools + C_maintenance
- Tokens del modelo: en cada invocación se acumula
tokens de entrada ÷ 10⁶ × precio de entrada + tokens de salida ÷ 10⁶ × precio de salida. En ejecuciones prolongadas también hay que contabilizar las rondas de invocación de herramientas, los reintentos, la transmisión repetida de contexto y los aciertos de caché. - Servidor: la instancia en la nube que ejecuta el planificador, los workers y el navegador; la automatización del navegador exige bastante memoria.
- Base de datos: SQLite en sí no tiene costo; cuando el volumen de datos crece y se migra a PostgreSQL o a una base de datos vectorial gestionada, aparecen costos de almacenamiento.
- Herramientas: servicios de terceros como API de búsqueda, proxies de scraping web o servicios de notificaciones cobran por uso o por mes.
- Mantenimiento: las horas de desarrollo dedicadas a adaptarse a cambios en las fuentes de información, actualizaciones del modelo y mejoras de dependencias suelen ser, a largo plazo, la partida con mayor peso.
8.2 Referencia de precios de modelos
La nota técnica de APIYI del 13 de noviembre de 2026 ofrece los siguientes ejemplos de precios de modelos Claude, que sirven para estimar el coste del modelo:
| Modelo | Entrada / millón de Tokens | Salida / millón de Tokens | Lectura de caché / millón de Tokens | Plataforma disponible |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | APIYI |
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | APIYI |
| Claude Fable 5.2 | $8 | $40 | $0.20 | APIYI |
Los modelos realmente disponibles, los grupos y los precios en tiempo real se rigen por la lista de modelos de docs.apiyi.com/models. El precio solo refleja la tarifa unitaria; la tasa de éxito de las tareas hay que medirla aparte con el método de la sección 2.3. En tareas como Radar, la mayor parte de la entrada son indicaciones del sistema e historial repetidos, y el precio de lectura de caché es muy inferior al de la entrada normal: usar bien la caché es la principal forma de controlar el coste en Tokens.
8.3 Comparativa de precios de suscripción de Dots
En el caso de los usuarios individuales, las suscripciones ChatGPT Pro 100, Pro 200 y Pro 500 cuestan $100, $200 y $500 al mes, respectivamente. Las tres modalidades permiten usar Dots, y la documentación oficial no detalla una tarifa mensual independiente para Dot en los planes Pro individuales. Las tareas de ChatGPT Work o Codex que Dot delega se calculan según las cuotas y reglas del producto correspondiente; el consumo depende del modelo, el contexto, el razonamiento, las llamadas a herramientas y el volumen de recuperación. El plan Pro individual exige tener al menos 18 años y, por ahora, no está disponible en el Espacio Económico Europeo, Reino Unido ni Suiza.
En el ámbito empresarial, los espacios de trabajo Enterprise que cumplan los requisitos pueden optar por una tarifa fija según el tipo de trabajo o por facturación según el uso. A partir del 18 de noviembre de 2026 se empezará a cobrar por los Dots habilitados; durante el período de vista previa previo no se cobra, y las tareas delegadas a Work o Codex se facturan aparte. Los importes concretos dependerán de la cotización que se aplique a cada espacio de trabajo.
8.4 Límites de las soluciones de desarrollo propio
Una solución de desarrollo propio puede reproducir por completo el modelo de trabajo central de Dots: ejecución continua de tareas, memoria por capas, llamadas a herramientas, ejecución programada y aprobación humana. Su ventaja es que puedes cambiar de modelo libremente, controlar por completo los datos y los flujos, y personalizar los flujos de trabajo según las necesidades concretas del negocio.
Las partes propietarias de Dots tendrás que cubrirlas por tu cuenta o aceptar la diferencia: la configuración interna de modelos de OpenAI, la computadora en la nube propia de Dot, un ecosistema de más de 4.000 complementos de aplicaciones, canales de comunicación en Slack y Teams, y el sistema de revisión de seguridad Auto-review. Dots también tiene sus límites: una prueba práctica realizada por un periodista de Axios en octubre de 2026 mostró que Dots puede completar la planificación de un viaje de varios pasos y la creación de un álbum conmemorativo de 38 páginas, pero en el contenido aparecieron estadísticas cuestionables y, en la sección de compras, guiaba al usuario para que la completara por su cuenta. Un agente de desarrollo propio también necesita revisión humana de los resultados; las operaciones que impliquen cuentas y fondos deben mantener la confirmación humana.
Preguntas frecuentes (FAQ)
P1: ¿Una sola clave API puede obtener directamente todas las capacidades de GPT Dots?
La clave API proporciona la capacidad de invocación del modelo. La memoria, las herramientas, la planificación, el entorno de ejecución y la aprobación deben construirse por tu cuenta, y la computadora en la nube patentada de Dots y su ecosistema de aplicaciones tampoco están disponibles a través de la API. Con una sola clave de APIYI apiyi.com puedes cambiar cómodamente entre varios modelos, pero el resto del Agent sigue implementándose según las partes 3 a 6 de este artículo.
P2: Al replicar GPT Dots, ¿debo elegir la interfaz compatible con OpenAI o la interfaz nativa de Claude?
Puedes conectar cualquiera de las dos al mismo Agent. Modelos como GPT y DeepSeek usan la interfaz compatible con OpenAI; Claude, a través de la interfaz nativa Messages, puede usar por completo los mecanismos `tool_use`, `tool_result` e `is_error`. Se recomienda abstraer una capa de interfaz unificada de invocación de herramientas en el controlador, escribiendo un adaptador para cada una de las dos rutas.
P3: ¿El rendimiento de la invocación de herramientas es igual entre distintos modelos?
Tras la compatibilidad de protocolos, cada modelo sigue presentando diferencias en invocación paralela, cumplimiento del Schema, recuperación de errores y número de rondas de invocación. Realiza pruebas comparativas con las mismas definiciones de herramientas y tareas, registrando el número de invocaciones, errores de parámetros, Tokens y tasa de acierto, y luego decide el modelo principal y el modelo de respaldo.
P4: ¿Cómo logra un Agent autoimplementado «trabajar 24 horas»?
«24 horas» se refiere a una forma de trabajo que avanza las tareas de forma continua en segundo plano según un plan. Su implementación depende de tres cosas: un programador (scheduler) residente en el servidor, un estado de tarea con Checkpoint y un Worker que se pueda reintentar. Cuando hay mantenimiento del servidor o fallos en dependencias, la tarea se pausa y, tras recuperarse, continúa desde el punto de interrupción.
P5: ¿Cuánto cuesta aproximadamente Personal AI Radar al mes?
Depende de la cantidad de fuentes de información, la profundidad de procesamiento de cada noticia y el modelo elegido. Ejecútalo primero durante una semana, usa los registros para contabilizar los Tokens de entrada y salida diarios, calcula el costo del modelo con la fórmula de la sección 8.1 y el precio unitario del modelo, y súmale el servidor, la API de búsqueda y las horas de mantenimiento.
P6: ¿Cómo puede un Agent autoimplementado prevenir el Prompt Injection?
Pasa el contenido de páginas web y documentos como material de referencia y declara en el prompt del sistema que las instrucciones contenidas en el material no deben ejecutarse; las herramientas solo deben exponer los permisos mínimos necesarios para completar la tarea; las operaciones de envío externo, publicación y eliminación entran en una cola de aprobación manual; todas las invocaciones de herramientas se registran en logs. Estas medidas reducen significativamente el riesgo, pero los resultados aún requieren revisiones manuales periódicas por muestreo.
GPT Dots: puntos clave para replicar
- Objetivo de la replicación: replicar el modo de funcionamiento de Dots. Los modelos propietarios, el computador en la nube y el ecosistema de aplicaciones deben reemplazarse por cuenta propia.
- Siete módulos: modelo, controlador, herramientas, memoria, planificador, entorno de ejecución y aprobación. Solo el modelo proviene de la API.
- Llamada a herramientas: el modelo emite la solicitud y el programa ejecuta la herramienta; la gestión de permisos y fallos queda a cargo del desarrollador.
- Memoria por capas: el contexto actual, el proyecto, el usuario y la experiencia se almacenan en cuatro capas separadas y se recuperan bajo demanda.
- Ejecución en segundo plano: planificador + cola de tareas + Checkpoint, con reintentos ante fallos y recuperación desde el punto de interrupción.
- Cálculo de costes: además de los tokens del modelo, hay que contar servidores, bases de datos, herramientas y horas de mantenimiento.
- Selección del modelo: conectar varios modelos de forma unificada mediante APIYI y elegir el modelo principal con el mismo conjunto de datos de prueba.
Resumen
Replicar GPT Dots con una API: puntos clave:
- Distinguir capas: la API del modelo se encarga de las decisiones, el framework del agente de la orquestación y el entorno de ejecución de actuar; las tres se construyen por separado.
- Primero, completar el circuito mínimo: un modelo, tres herramientas, una tabla SQLite y una tarea programada bastan para crear un agente personal capaz de funcionar de forma sostenida.
- Elegir con datos: el rendimiento de los modelos en llamadas a herramientas y su coste real deben determinarse con pruebas en igualdad de condiciones.
Personal AI Radar es un buen punto de partida: cubre cinco capacidades centrales de Dots —trabajo continuo, memoria, llamada a herramientas, planificación y colaboración humano-máquina. Recomendamos conectar varios modelos candidatos a través de APIYI apiyi.com, completar las pruebas comparativas con el mismo conjunto de definiciones de herramientas y luego incorporar a tu agente el modelo que haya demostrado mayor estabilidad.
📚 Referencias
- Anuncio oficial de OpenAI: Presentamos Dots:Posicionamiento de Dots como producto, computadora en la nube y ecosistema de aplicaciones
- Enlace:
openai.com/index/introducing-dots -
Descripción: La fuente principal para conocer las capacidades oficiales de Dots
-
ChatGPT Learn – Tareas y memoria:Tareas de largo plazo, agentes en segundo plano, memoria e investigación proactiva de Dots
- Enlace:
learn.chatgpt.com/docs/dots/tasks-and-memory -
Descripción: Referencia para diseñar la jerarquía de memoria y los mecanismos de programación de agentes propios
-
Centro de ayuda de OpenAI – Acerca de los niveles de ChatGPT Pro:Reglas de precios y cuotas de Pro 100, Pro 200 y Pro 500
- Enlace:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers -
Descripción: Para comparar el costo de construir tu propia solución con el gasto de suscripción
-
ChatGPT Learn – Guía de administración de Dots para empresas:Cómo habilitar Dots en un espacio de trabajo Enterprise y cómo se factura
- Enlace:
learn.chatgpt.com/docs/enterprise/dots-admin-guide -
Descripción: Referencia para usuarios empresariales que evalúan el costo de Dots
-
Documentación de Function Calling de OpenAI:Formato de solicitud y respuesta para la invocación de herramientas
- Enlace:
developers.openai.com/api/docs/guides/function-calling -
Descripción: Base oficial para implementar el bucle de herramientas de la parte 3
-
Documentación oficial de LangGraph:Entorno de ejecución para flujos de trabajo de agentes con estado y de largo plazo
- Enlace:
langchain-ai.github.io/langgraph -
Descripción: Implementaciones listas para usar de checkpoints, persistencia y aprobación humana
-
Prueba reproducible de invocación de herramientas multimodelo de APIYI:Diseño en 5 pasos de una prueba breve de invocación de herramientas multiturno
- Enlace:
help.apiyi.com/en/one-key-multi-model-reproducible-tool-calling-test-en.html -
Descripción: Método de prueba para comparar el desempeño de la invocación de herramientas entre distintos modelos
-
Guía de configuración de Base URL de APIYI:Configuración de endpoints compatibles con OpenAI, Claude y Gemini
- Enlace:
help.apiyi.com/en/apiyi-base-url-v1-claude-gemini-endpoint-config-guide-en.html - Descripción: Referencia para configurar la integración de modelos multiprotocolo
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos a través del sitio web oficial de APIYI; para más material de integración, visita el centro de documentación en docs.apiyi.com