Resumen: En las tareas de video basadas en código de VibeVideoBench, GPT-6 Astra ya está al mismo nivel que Claude Opus 5.5: su calidad global es ligeramente superior y su costo, menor; Opus 5.5 es más consistente en la entrega; el modelo general de nueva generación de OpenAI aún no se ha lanzado, así que su capacidad de video tendrá que verificarse con pruebas reales después del lanzamiento.
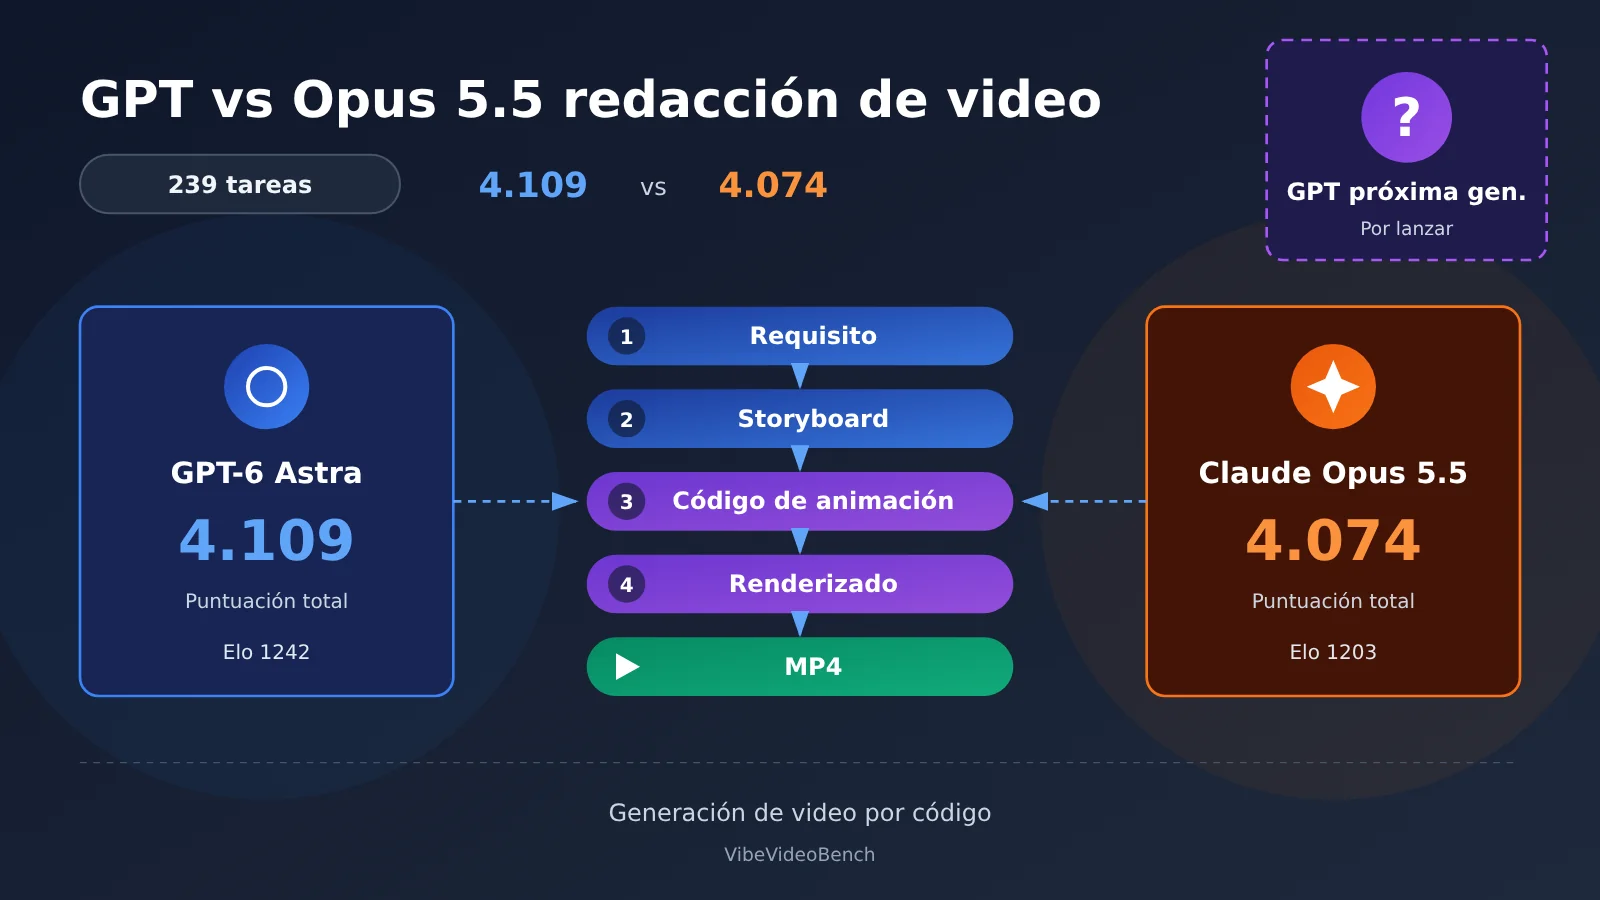
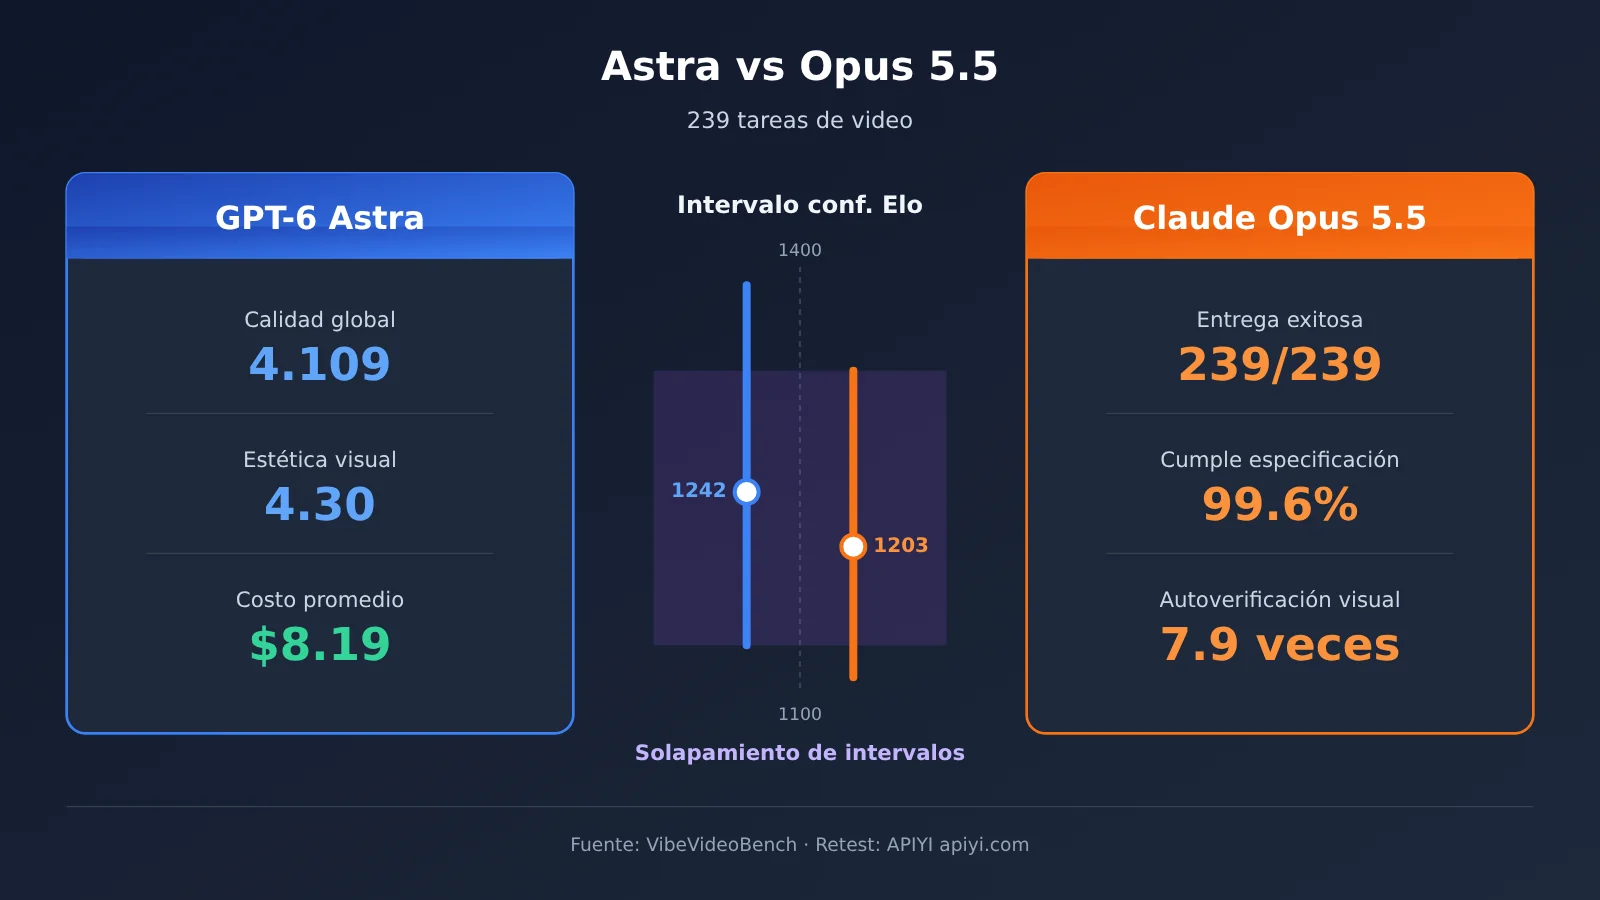
La conclusión, primero: A 15 de noviembre de 2026, en la ruta de «un agente escribe código, invoca herramientas de renderizado y entrega un MP4 completo», GPT-6 Astra y Claude Opus 5.5 son los dos sistemas más parejos de VibeVideoBench. Astra obtuvo una puntuación de calidad global de 4.109 y Opus 5.5, de 4.074; en la prueba ciega humana, sus puntajes Elo fueron 1242 y 1203, respectivamente, sin diferencias estadísticamente significativas. Opus 5.5 entregó las 239 tareas y alcanzó una tasa de éxito estricta del 76.3%, superior al 74.5% de Astra; Astra registró un costo promedio de API de 8.19 dólares por tarea, aproximadamente la mitad de lo que cuesta Opus 5.5. OpenAI ha hecho públicas dos evidencias de que sus modelos internos son claramente superiores a Astra, pero aún no ha anunciado el nombre, la fecha de lanzamiento ni los resultados específicos en video del GPT general de nueva generación. Por tanto, la respuesta a la pregunta del título es: el GPT actual ya ha alcanzado ese nivel; si la próxima generación logrará marcar una diferencia dependerá de las pruebas reales tras su lanzamiento.
Avance del contenido: A continuación delimitaremos el alcance de la evaluación y luego desglosaremos los resultados generales, los resultados por categoría, las preferencias humanas y los datos de costo de VibeVideoBench para explicar de dónde vienen las ventajas de cada uno; después revisaremos las señales públicas sobre los modelos internos de OpenAI y el estado de lanzamiento de la próxima generación, y analizaremos el verdadero cuello de botella de los agentes de video; por último, propondremos una metodología de prueba comparativa que pueda reutilizarse directamente cuando se lance el nuevo modelo, para ayudarte a decidir si vale la pena sustituir la solución actual.
Para saber: términos que conviene conocer antes de leer este artículo
| Término | Explicación |
|---|---|
| Code-driven Video Generation | Generación de video impulsada por código: la IA escribe los programas de animación y renderizado, y la salida final es un MP4 |
| Native Video Generation | Generación de video nativa: el modelo genera las imágenes de video directamente a partir de texto o imágenes; productos representativos son Sora y Veo |
| VibeVideoBench | Benchmark de evaluación dedicado a medir cómo un Agente de IA produce videos completos de forma autónoma, publicado el 26 de octubre de 2026 |
| Harness | Entorno de ejecución del modelo, que ofrece capacidades como ejecución de código, acceso a archivos y llamada de herramientas, por ejemplo Codex CLI o Claude Code |
| L1 / L2 / L3 | Los tres niveles de evaluación: verificación de entrega del programa, verificación punto por punto de los requisitos de la tarea y puntuación de calidad del video mediante revisión multimodal |
| 严格任务成功率 | Tasa de éxito en tareas estrictas: proporción de tareas en las que el video se entrega con éxito y cumple todas las restricciones; más exigente que la simple «tasa de entrega» |
| Bradley–Terry Elo | Método de puntuación que calcula la preferencia relativa entre modelos a partir de comparaciones por pares hechas por personas |
| Multi-agent Orchestration | Orquestación multiagente: hacer que varios Agentes se repartan el trabajo y colaboren, para luego integrar los resultados |
| Render Pipeline | Pipeline de renderizado de video: generación de imagen, procesamiento de audio y codificación/composición hasta la salida final |
| Remotion / FFmpeg | El primero sirve para escribir animaciones de video con código React; el segundo se encarga de la codificación y composición de audio y video |
| ffprobe | Herramienta de inspección incluida con FFmpeg, que se usa para leer información del video como resolución, tasa de frames, duración y pistas de audio |
| Cache Hit | Tasa de aciertos de caché: la proporción de contexto repetido que se lee desde la caché; afecta directamente el costo de API de las tareas largas |
| BenchCAD 2.0 | Evaluación de ingeniería que pone a prueba la capacidad de la IA en reconstrucción de piezas 3D, diseño de ensamblajes mecánicos e identificación de conexiones de PCB |
1 Primero la conclusión: GPT ya entró en la franja competitiva de Opus 5.5 en la creación de video
1.1 ¿Qué tipo de «escritura de video» compara este artículo?
La creación de video con IA tiene actualmente dos rutas. La generación de video nativa hace que el modelo emita directamente imágenes continuas, y destaca en personajes, movimiento físico y lenguaje cinematográfico. La generación de video impulsada por código hace que el modelo actúe como director y programador: entiende los requisitos, escribe guiones y storyboards, crea animaciones con Remotion, Three.js, Cairo o Blender, genera la voz en off con TTS y luego compone y revisa el video final con FFmpeg.
Este artículo aborda la segunda ruta, es decir, la capacidad de entregar un MP4 completo y un proyecto editable mediante agentes como Codex CLI o Claude Code. Esta ruta es adecuada para visualización de datos, presentaciones de productos, divulgación del conocimiento, infografías animadas y videos promocionales de marca, y también es el campo en el que GPT y Claude tienen actualmente benchmarks independientes comparables.
La propia línea de productos de video nativo de OpenAI ya ha cambiado: el producto Sora dejó de funcionar el 26 de abril de 2026; el modelo Sora 2 y la Videos API se cerraron el 24 de septiembre, y el aviso oficial de descontinuación indicaba que no existe una API de reemplazo uno a uno. GPT-Image-2.6, publicado el 4 de noviembre, admite salida de animaciones GIF de 2–16 fotogramas, adecuada para memes, acciones en bucle y vistas previas de storyboards, lo que pertenece a un flujo de trabajo distinto del de la producción completa de MP4. Por tanto, la capacidad de «escribir video» de la familia GPT se manifiesta hoy principalmente en la ruta impulsada por código.
1.2 Respuesta en una frase a la pregunta del título
GPT-6 Astra está muy cerca de Opus 5.5 en VibeVideoBench: su puntuación global es ligeramente superior y su estabilidad de entrega, ligeramente inferior. El modelo de próxima generación de OpenAI presenta señales técnicas de que puede seguir mejorando, pero los resultados públicos específicos de video siguen tomando a Astra como referencia.
2 239 tareas reales de video: ¿quién es más fuerte, GPT-6 Astra o Opus 5.5?
2.1 Cómo VibeVideoBench mide la capacidad de video de GPT y Opus 5.5
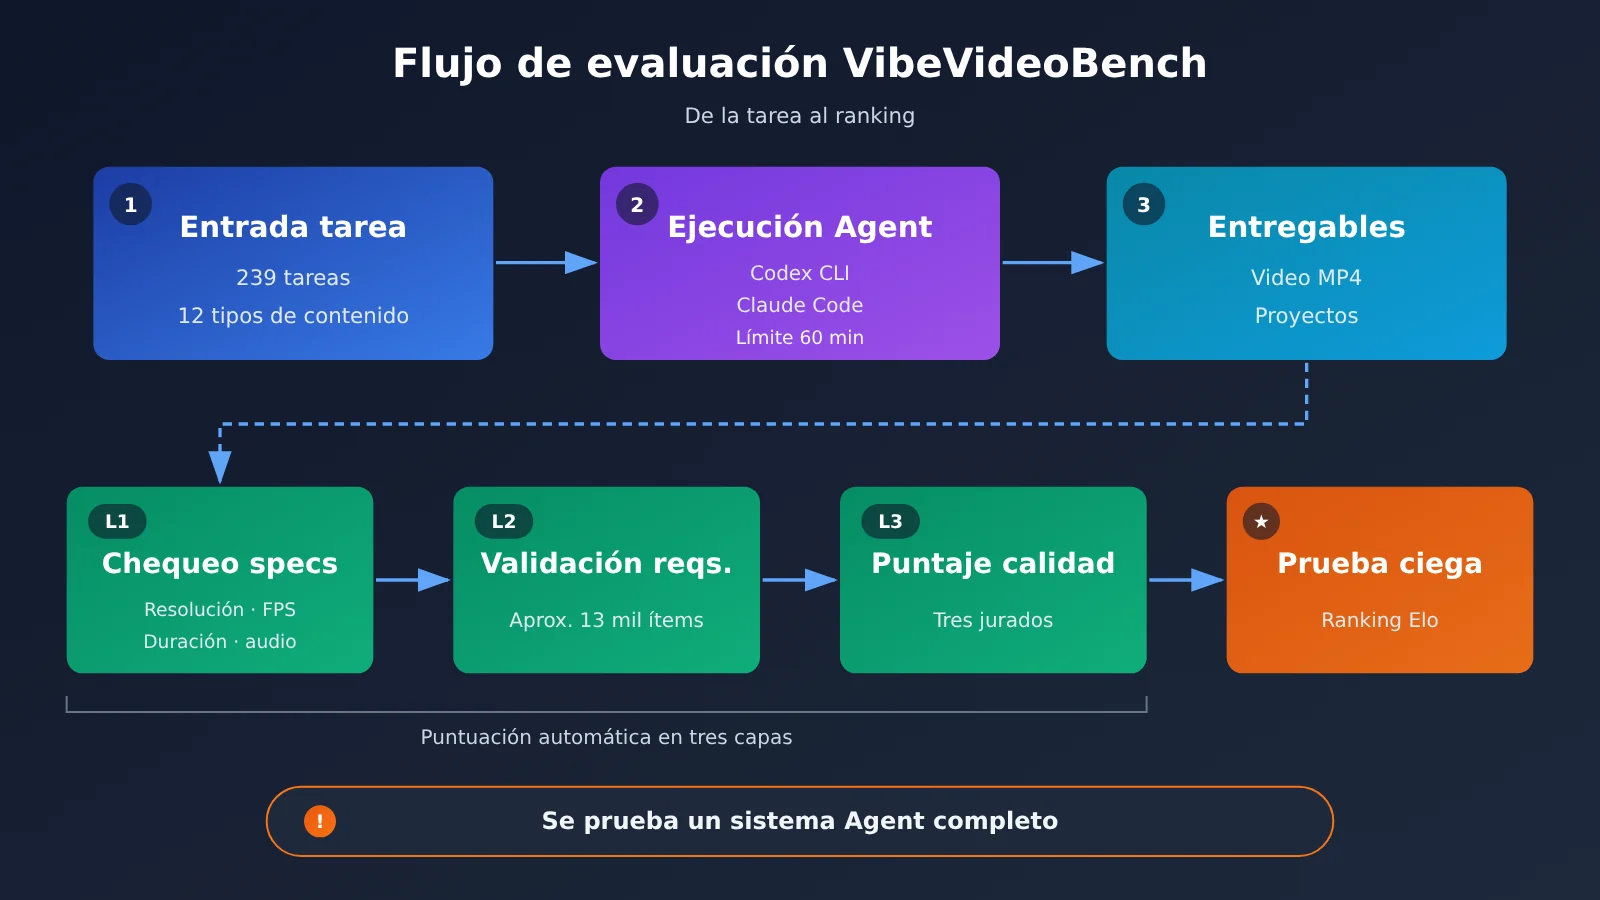
VibeVideoBench ha construido 239 tareas reales de producción de video, que cubren 12 categorías de contenido y en las que se probaron 9 sistemas Agent, con un total de 2,151 ejecuciones. Cada tarea exige que la IA la complete de forma autónoma dentro de un sandbox, entregando un MP4 reproducible, un proyecto de ingeniería capaz de regenerar el video y una descripción del proceso de producción. Cada tarea tiene un límite de 60 minutos, y todos los sistemas usaron su propio entorno de desarrollo nativo y la máxima intensidad de razonamiento disponible, sin instrucciones humanas añadidas durante la ejecución.
GPT-6 Astra se ejecuta en Codex CLI, y Claude Opus 5.5 en Claude Code. Los demás sistemas participantes incluyen Claude Sonnet 5.5, Gemini 4 Argon, DeepSeek V4.1 Flash, Kimi K3, GLM-5.3 Flash, GPT-5.6 Sol y Gemini 3.8 Flash. La evaluación tiene tres niveles: L1 comprueba si se entrega el MP4 y especificaciones como resolución, tasa de fotogramas, duración y pista de audio; L2 verifica punto por punto unos 13.000 requisitos de tarea; L3 cuenta con tres sistemas de evaluación multimodal que valoran la calidad de imagen, la estética, la lógica del contenido, el ritmo del movimiento y la sincronización de audio.
2.2 Comparación general de resultados entre GPT-6 Astra y Opus 5.5
| Métrica | GPT-6 Astra | Claude Opus 5.5 | Ventaja |
|---|---|---|---|
| Videos entregados con éxito | 238/239 | 239/239 | Opus |
| Tasa de entrega de videos | 99.6% | 100% | Opus |
| Tasa de cumplimiento de especificaciones | 93.7% | 99.6% | Opus |
| Tasa de aprobación de requisitos de la tarea | 97.1% | 97.3% | Opus |
| Calidad del video | 4.08 | 3.99 | Astra |
| Estética visual | 4.30 | 4.19 | Astra |
| Lógica del contenido | 4.20 | 4.18 | Astra |
| Movimiento y ritmo | 3.95 | 3.95 | Empate |
| Calidad y sincronización de audio | 4.10 | 4.07 | Astra |
| Puntuación de calidad integral | 4.109 | 4.074 | Astra |
| Tasa de éxito en tareas estrictas | 74.5% | 76.3% | Opus |
| Elo de preferencia humana | 1242 | 1203 | Estadísticamente indistinguible |
Los datos provienen del resultado promedio de tres paneles de evaluación, con una escala de puntuación de 1 a 5. Ambos sistemas superan a los demás sistemas participantes.
Esta tabla muestra una división de tareas bastante clara: Astra tiene una ligera ventaja en “qué tan bien se ve el video producido”, lidera en calidad integral por 0.035 puntos y en estética visual por 0.11 puntos; Opus 5.5 es más confiable en “si puede entregarse según las especificaciones”, con una tasa de cumplimiento de especificaciones 5.9 puntos porcentuales mayor y una tasa de éxito en tareas estrictas 1.8 puntos porcentuales mayor. La diferencia de 0.035 puntos es muy pequeña; si se considera el intervalo de confianza de Elo, ambos están en el mismo nivel.
2.3 Distribución de ventajas de GPT y Opus 5.5 según el tipo de video
| Categoría de video | Astra | Opus 5.5 | Líder |
|---|---|---|---|
| Marca y marketing | 4.18 | 4.18 | Empate |
| Presentación de productos y funcionalidades | 4.20 | 4.24 | Opus |
| Música y contenido sonoro | 3.83 | 3.92 | Opus |
| Explicación de artículos académicos | 4.03 | 4.07 | Opus |
| Explicación de conceptos y procesos | 4.19 | 4.15 | Astra |
| Historias basadas en datos y hechos | 4.14 | 4.01 | Astra |
| Arte visual | 3.94 | 3.91 | Astra |
| Juegos y deportes | 4.15 | 4.12 | Astra |
| Eventos y expresión personal | 4.03 | 3.93 | Astra |
| Narrativa y comedia visual | 4.00 | 3.88 | Astra |
| Construcción y procesos de fabricación | 3.97 | 3.94 | Astra |
| Enseñanza en el aula | 4.47 | 4.45 | Astra |
Los datos provienen del Apéndice E.4 del artículo; los videos no entregados se contabilizan con cero puntos.
Astra lidera en 8 de las 12 categorías, y las mayores diferencias aparecen en historias basadas en datos y hechos (0.13) y en narrativa y comedia visual (0.12). Opus 5.5 va por delante en presentación de productos, música y explicación de artículos académicos, con una diferencia de 0.09 en música. Las tareas musicales exigen una alta sincronización entre audio e imagen, mientras que la presentación de productos requiere precisión en especificaciones y detalles, lo que coincide con la ventaja de Opus en la tasa de cumplimiento de especificaciones. En la mayoría de las categorías la diferencia está dentro de 0.05 puntos: la elección del modelo ya muestra diferencias según el tipo de tarea, pero la brecha en cada categoría concreta todavía debe valorarse junto con pruebas repetidas.
2.4 Por qué Opus 5.5 sigue siendo competitivo
La prueba ciega con evaluadores humanos utiliza el modelo Bradley–Terry para calcular el Elo. Astra obtiene 1242 (intervalo de confianza del 95%: 1134–1387) y Opus 1203 (1111–1327); en ambos casos el intervalo de confianza del ranking es 1–3, y el artículo reporta una probabilidad de comparación P=0.69, con la conclusión de que estadísticamente no se pueden distinguir. Conviene tener en cuenta que la prueba humana solo evalúa vídeos ya entregados y no puede medir la capacidad de entregar a tiempo, que resulta ser precisamente el punto fuerte de Opus.
El comportamiento de autoverificación lo explica. Opus consulta las imágenes renderizadas una media de 7.9 veces por ejecución y usa ffprobe 3.9 veces; Astra, 3.4 y 2.1 respectivamente. Opus revisa su propia salida con más frecuencia, detecta problemas y los corrige, lo que se traduce en una tasa de entrega del 100% y una tasa de cumplimiento de especificaciones del 99.6%. Anthropic posiciona Opus 5.5 como un modelo de Agentic Coding para ejecuciones prolongadas, y en la comunidad hay usuarios que cuentan haberlo usado durante unos 30 minutos para completar el vídeo promocional de una app para iOS y para producir automáticamente un vídeo vertical de noticias en 1080×1920 con subtítulos SRT; se trata de casos individuales que sirven como evidencia indirecta de la integridad del flujo de trabajo.
2.5 Coste de las tareas de vídeo: GPT-6 Astra cuesta más por unidad, pero menos por tarea
| Métrica | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| Precio estándar de entrada (USD por millón de tokens) | 10 | 4 |
| Precio estándar de salida (USD por millón de tokens) | 50 | 20 |
| Coste medio por tarea | $8.19 | $15.38 |
| Coste mediano por tarea | $7.88 | $10.19 |
| Coste por tarea P90 | $11.88 | $31.22 |
| Tokens de salida medios | 61K | 130.7K |
| Llamadas API por tarea | 46 | 51 |
| Acierto de caché (Cache Hit) | 97% | 65% |
El precio unitario estándar de Astra es 2,5 veces el de Opus 5.5, pero su coste medio por tarea es aproximadamente un 46,7% más bajo. Hay dos razones: Astra genera alrededor de un 53,3% menos tokens de salida; y Astra alcanza una tasa de acierto de caché del 97%, mientras que en Opus cerca del 76% del coste por tarea proviene de Cache Write. La diferencia de coste en P90 es aún más clara, y Opus presenta una variación de coste mayor en tareas complejas. El artículo también señala que aumentar el consumo de tokens por sí solo no aporta una mejora de calidad equivalente.
Estos costes son costes equivalentes calculados a partir de los precios públicos de API, y no incluyen los gastos de personal y materiales de una producción comercial de vídeo completa. La Batch API oficial de Opus 5.5 ofrece un 50% de descuento en entrada y salida, por lo que la estructura de costes cambia cuando se produce en lote fuera de línea.
💰 Optimización de costes: el coste por tarea de un agente de vídeo depende enormemente de la tasa de acierto de caché y de la longitud de salida; fijarse solo en el precio unitario lleva fácilmente a conclusiones erróneas. Recomendamos que, en APIYI apiyi.com, ejecutes la misma tarea con cada uno de los dos modelos y calcules el coste según el «consumo real por cada vídeo finalizado», en lugar de comparar los precios de lista.
3 Señales de mejora de capacidades del próximo GPT de OpenAI
3.1 Investigación sobre Navier–Stokes: el modelo interno es claramente superior a GPT-6 Astra
El 8 de septiembre de 2026, OpenAI publicó los resultados de su investigación sobre el problema del Milenio de Navier–Stokes. El artículo oficial indica que el modelo interno utilizado es claramente superior a GPT-6 Astra, que se entrenó con aprendizaje por refuerzo a gran escala y que el entrenamiento seguía en curso cuando se anunció.
La escala de ejecución de esta investigación es una demostración directa de la capacidad multiagente: alrededor de 10,000 agentes participaron simultáneamente, la investigación duró unas 88 horas y generó 2.7 millones de mensajes y cerca de 130 mil millones de tokens de salida; los agentes se dividieron en grupos para estudiar distintas versiones del problema, los grupos intercambiaron información, Codex integró los resultados intermedios y el sistema concentró recursos de forma continua en las rutas más prometedoras. La verificación formal final en Lean requirió 17 horas adicionales y utilizó GPT-6 Astra.
Para la creación de video, lo más relevante aquí es la coordinación de tareas de larga duración y la colaboración entre múltiples agentes, no la capacidad matemática en sí. Un video complejo también requiere procesar en paralelo el guion, la animación y el audio, para luego integrarlos, revisarlos y retrabajar lo necesario.
3.2 BenchCAD 2.0: la capacidad de ingeniería pasa de 0.594 a 0.875
El 3 de noviembre de 2026, OpenAI anunció en «Accelerating engineering for the physical world» que un modelo interno más reciente obtuvo una puntuación media de 0.875 en BenchCAD 2.0, frente a 0.594 de GPT-6 Astra con el nivel máximo de razonamiento, una mejora relativa de aproximadamente 47.3%. Las pruebas incluyen reconstrucción de piezas en 3D, diseño de ensamblajes mecánicos e identificación de conexiones de PCB.
Estas dos evidencias deben considerarse por separado. OpenAI no aclaró si el modelo evaluado en BenchCAD es el mismo que el utilizado en la investigación de Navier–Stokes, y tampoco se publicaron ni el nombre ni la fecha de lanzamiento. BenchCAD es una prueba de ingeniería publicada por la propia OpenAI; representa una señal de progreso en comprensión espacial y conocimiento complejo de ingeniería, pero no tiene una correspondencia directa con las tareas de generación de video.
3.3 Cuándo se lanzará el próximo GPT: estado público al 15 de noviembre
| Fecha | Avances públicos |
|---|---|
| 2 de noviembre | Según The National, Altman dijo en ADIPEC que la investigación matemática utilizó un modelo GPT que estaba por lanzarse, con cerca de 10,000 agentes colaborando durante unos cuatro días; el artículo aclara que esa afirmación no fue verificada de forma independiente |
| 3 de noviembre | OpenAI publicó los datos de BenchCAD 2.0 del modelo interno |
| 4 de noviembre | The Information, citando fuentes conocedoras, informó que OpenAI podría lanzar, como muy pronto, el 6 de noviembre la nueva generación de Astra, Sol y el modelo de ciberseguridad |
| 5 de noviembre | OpenAI API Changelog confirmó el lanzamiento de GPT-6 Cyber, pero no el de la nueva generación de Astra o Sol de propósito general |
| 15 de noviembre | Los modelos insignia de propósito general del catálogo oficial siguen siendo GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra y GPT-6 Luna |
Los nombres que circulan en internet, como GPT-6.2 Astra y GPT-6.2 Sol, no han sido confirmados oficialmente por OpenAI. También hay que tener en cuenta que VibeVideoBench evalúa GPT-6 Astra y GPT-5.6 Sol, por lo que los resultados de Astra no pueden trasladarse directamente a GPT-6.1 Sol o Terra.
4 Lo que la próxima generación de GPT aún necesita para superar a Opus 5.5 en la creación de video
4.1 El verdadero cuello de botella de los agentes de video: gestión del tiempo y entrega
De las 2,151 ejecuciones totales de VibeVideoBench, 224 no entregaron un video reproducible. De ellas, 169 correspondieron a problemas de gestión del tiempo: el renderizado final se inició demasiado tarde, la ejecución fue demasiado lenta o no llegó a iniciarse siquiera, lo que representa alrededor del 75% de todos los fallos. El entorno de prueba era un contenedor Docker uniforme con CPU de 8 núcleos, 32GB de memoria y sin GPU, y el propio renderizado ya consume una cantidad considerable de tiempo.
Esto demuestra que, una vez que mejora la capacidad de razonamiento del modelo, todavía hay que aterrizarla en el ritmo de ejecución. Por muy refinada que sea la animación que escribe un modelo, si inicia el renderizado en el minuto 55, el resultado sigue siendo cero. Astra y Opus 5.5 ya están muy parejos en calidad; el margen para que la próxima generación de GPT marque la diferencia está principalmente en la parte de entrega.
4.2 Siete puntos de mejora para la próxima generación de GPT en el flujo de trabajo de video
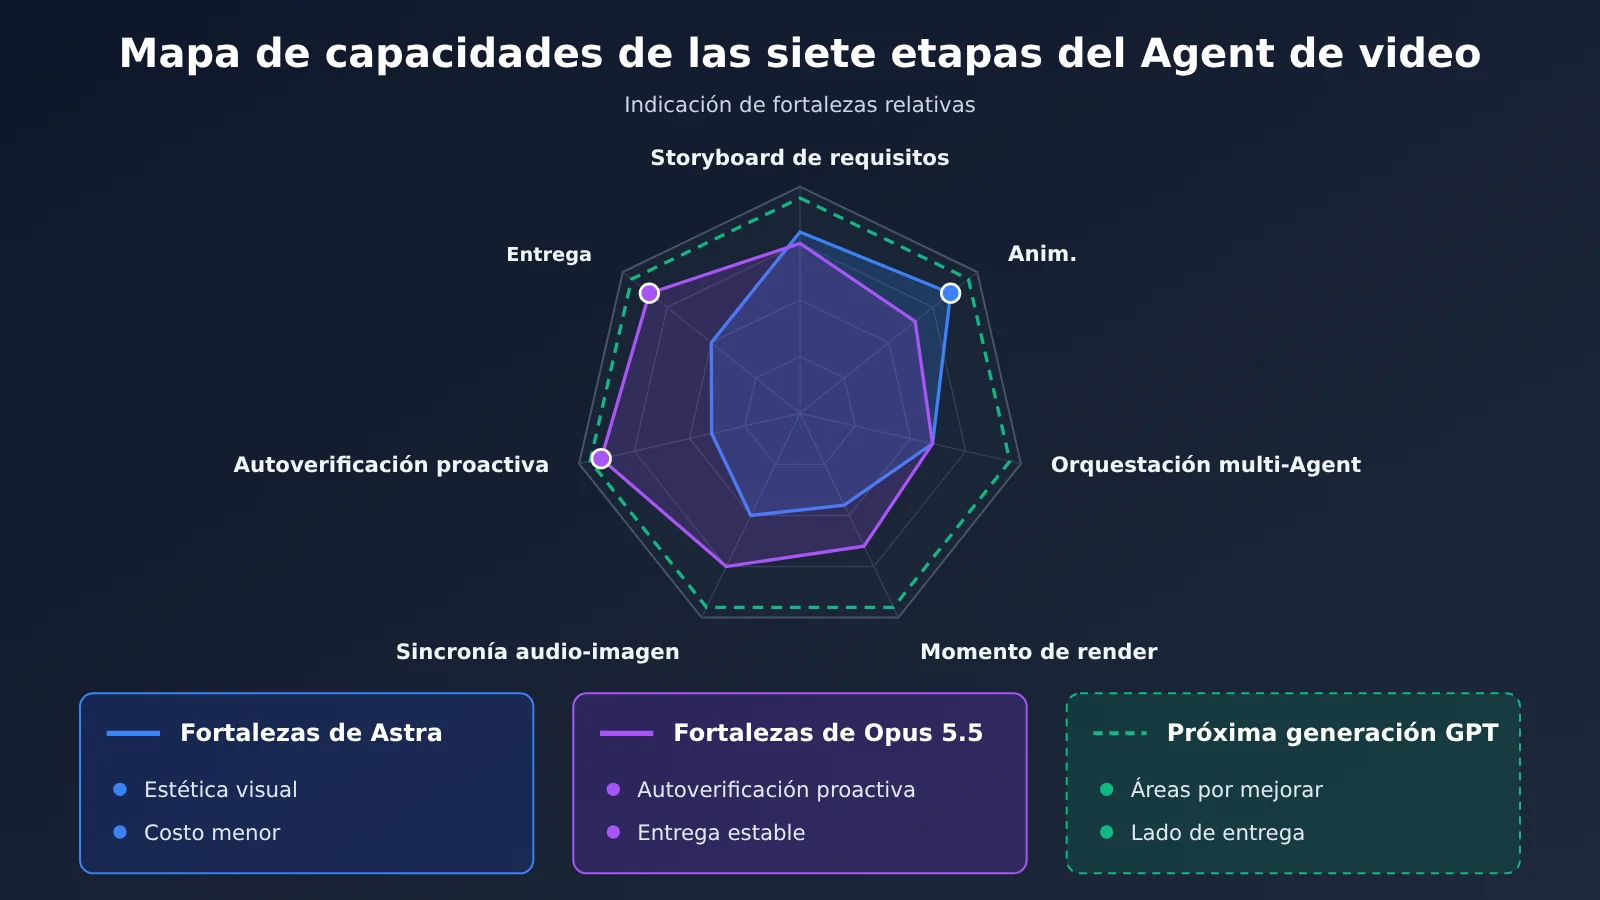
Teniendo en cuenta los puntos fuertes y débiles actuales de ambos, para que el próximo modelo supere claramente a Opus 5.5, necesita avanzar al mismo tiempo en los siguientes aspectos:
- Comprensión de requisitos y storyboard: captar con precisión el tema, la audiencia y el estilo, y desglosar los requisitos en orden de planos y línea de tiempo.
- Código de animación complejo: que las animaciones con Remotion, Three.js y Python queden bien a la primera, reduciendo renderizados repetidos.
- Orquestación de múltiples agentes: paralelizar guion, animación y audio; la capacidad de orquestación que el modelo interno demostró en investigación matemática debe trasladarse a este tipo de tareas de ingeniería.
- Momento del renderizado: reservar suficiente tiempo de renderizado para evitar los problemas de gestión del tiempo que representan cerca de tres cuartas partes del total de fallos.
- Sincronización de audio e imagen: alinear la narración, los efectos de sonido y el ritmo de la imagen; esta es la dirección en la que Opus lleva ventaja en tareas impulsadas por música.
- Autoevaluación proactiva: Opus revisa las imágenes un promedio de 7.9 veces, frente a 3.4 veces de Astra; la frecuencia de autoevaluación está directamente relacionada con la tasa de cumplimiento de especificaciones.
- Entrega estable: un MP4 completo más un proyecto editable, cumpliendo las especificaciones a la primera.
5 Tras el lanzamiento de la próxima generación de GPT, ¿cómo verificar si de verdad supera a Opus 5.5?
5.1 Método de prueba comparativa en siete pasos
Los rankings públicos solo se ejecutan una vez, con un límite de 60 minutos y con tareas mayoritariamente en inglés (209 de las 239 tareas son en inglés), así que los escenarios de negocio en chino requieren una reevaluación propia. El método que sigue se puede reutilizar directamente el mismo día en que se lanza un nuevo modelo:
| Paso | Cómo hacerlo | Métricas a seguir |
|---|---|---|
| 1 Fijar el conjunto de tareas | Elegir de 10 a 20 requisitos reales de video de negocio, cubriendo guion, animación, visualización de datos y presentación de producto | Cobertura de tareas |
| 2 Fijar el entorno | Unificar la cadena de herramientas (versiones de Remotion/FFmpeg), la configuración de las máquinas y el límite de tiempo; registrar por separado las diferencias de Harness | Comparabilidad |
| 3 Probar por etapas | Primero probar con la API por separado el storyboard y el código de animación, y después ejecutar el flujo completo en el entorno de Agent | Puntuación por etapa |
| 4 Registrar el consumo | Tiempo de ejecución, tokens de entrada y salida, y aciertos de caché de cada ejecución | Costo por video |
| 5 Revisar la entrega | Verificar con ffprobe la resolución, la tasa de fotogramas, la duración y la pista de audio | Tasa de entrega, tasa de cumplimiento de especificaciones |
| 6 Prueba ciega y repetición | Ocultar el nombre del modelo y hacer comparaciones por pares, con al menos 3 ejecuciones por tarea | Tasa de victoria por preferencia, varianza |
| 7 Puntuación integral | Ponderar calidad, tasa de éxito, costo de modificación y costo por video | Conclusión final de selección |
El paso 3 separa la «capacidad del modelo» de la «capacidad del entorno de Agent». VibeVideoBench mide un sistema de Agent completo, y Codex CLI y Claude Code también difieren entre sí; usando la misma interfaz compatible con OpenAI para invocar directamente a ambos modelos y generar storyboard y código de animación, primero se puede quitar la influencia del Harness y ver con claridad la diferencia entre los modelos en sí.
5.2 Ejemplo de código para comparar etapas con una interfaz unificada
El siguiente ejemplo minimalista llama a dos modelos usando el mismo base_url para generar el storyboard de una misma necesidad de video. Los nombres de los modelos deben tomarse de la lista de modelos de la plataforma.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI: una sola clave para llamar a GPT y Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
Ver el script completo de prueba comparativa multi-turno (registra tiempo y tokens)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Llamada unificada a través de APIYI, para facilitar el cambio y la comparación
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # Tomar como referencia la lista de modelos de la plataforma; añadir directamente cuando se publique un nuevo modelo
RUNS = 3  # Número de repeticiones por tarea

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# Guardar los resultados y ocultar el nombre del modelo antes de entregarlos al jurado para una prueba a ciegas
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 Inicio rápido: la comparación por etapas exige llamar a GPT y Claude al mismo tiempo. Con APIYI apiyi.com, usando una clave API y la interfaz compatible con OpenAI, puedes cambiar entre ambos modelos. Los nuevos usuarios tienen una cuota de prueba gratuita; cuando llegue la siguiente generación de GPT, basta añadir el nombre del modelo a la lista
MODELSpara volver a ejecutar el mismo conjunto de tareas.
5.3 Consideraciones para las pruebas de flujo completo
Una vez superadas las pruebas por etapa, ejecuta la tarea de video completa en Codex CLI y Claude Code, y registra la tasa de entrega y los resultados de la verificación con ffprobe. En las pruebas ciegas manuales evalúa únicamente los videos ya entregados; la tasa de entrega debe contabilizarse por separado, de lo contrario repetirás el punto ciego de las pruebas manuales de VibeVideoBench. Repite cada tarea al menos 3 veces y calcula la media y la varianza, para no tomar el resultado de una sola ejecución como si fuera un rendimiento estable.
6 Recomendaciones de decisión: cómo elegir entre GPT y Opus 5.5 en escenarios de video
6.1 Elegir GPT-6 Astra u Opus 5.5 según el escenario
Según las puntuaciones por categoría y los datos de entrega de VibeVideoBench, por ahora puedes distribuir así:
- Prioriza GPT-6 Astra: videos de datos e historias fácticas, explicaciones de conceptos y procesos, videos de historias y de juegos; producción en lote y escenarios sensibles al costo unitario, con un costo medio por tarea de 8.19 dólares y un costo P90 también más controlable.
- Prioriza Claude Opus 5.5: demostraciones de productos y funciones, videos impulsados por música, análisis de artículos; entregas comerciales con requisitos estrictos de especificaciones y entrega, como materiales publicitarios con resolución y duración fijas y pista de audio obligatoria.
- Marketing de marca: ambos obtienen la misma puntuación, 4.18; decide según el costo y la cadena de herramientas que ya tenga tu equipo.
6.2 ¿Esperar la próxima generación de GPT o lanzar ahora?
Los dos modelos actuales ya pueden producir videos utilizables de forma estable, así que el negocio no necesita esperar a la próxima generación de modelos. Lo más práctico es crear tu propio conjunto de tareas y resultados de referencia con el método de la sección 5, volver a ejecutar el día del lanzamiento del nuevo modelo y decidir con datos si cambiar.
💡 Recomendación de elección: la diferencia entre ambos se concentra en la estabilidad de entrega y la estructura de costos; la elección final depende de tu tipo de video y tus requisitos de entrega. Te sugerimos probar por separado con el mismo lote de tareas reales a través de APIYI apiyi.com; la interfaz unificada facilita la comparación en paralelo y el cambio posterior al nuevo modelo.
7 Conclusión final: el objetivo competitivo del próximo GPT ya no es solo igualar a Opus 5.5
7.1 Puntos clave de las capacidades de video de GPT y Opus 5.5
- Situación actual: GPT-6 Astra y Claude Opus 5.5 están ambos en la primera liga en las tareas de video guiadas por código de VibeVideoBench, con una calidad global de 4.109 frente a 4.074.
- Ventajas de Astra: estética visual, puntuaciones en la mayoría de las categorías de contenido y un costo medio por tarea aproximadamente 46,7 % menor.
- Ventajas de Opus 5.5: 239/239 entregas completadas, 99,6 % de tasa de cumplimiento de especificaciones y autoverificaciones más frecuentes.
- Preferencia humana: 1242 frente a 1203, con intervalos de confianza solapados, estadísticamente indistinguibles.
- Señales del próximo modelo: el modelo interno alcanza 0.875 en BenchCAD 2.0 (Astra 0.594) y ha demostrado capacidad de colaboración a escala de decenas de miles de agentes; ni el nombre, ni la fecha de lanzamiento, ni los resultados de video se han anunciado.
- El verdadero cuello de botella: cerca del 75 % de los fallos de entrega se deben a la gestión del tiempo, y el foco de la competencia está pasando de la calidad de generación a la ejecución y la entrega.
- Cómo verificarlo: tareas fijas, entorno fijo, múltiples rondas de pruebas ciegas y cálculo por costo unitario de video permiten repetir la medición por etapas con una interfaz unificada en APIYI apiyi.com.
7.2 La meta final de la competencia es la eficiencia productiva de extremo a extremo
Volviendo al título: GPT ya ha alcanzado a Opus 5.5; el Astra actual lleva una ligera ventaja en calidad y costo, mientras que Opus 5.5 mantiene el liderazgo en fiabilidad de entrega. El modelo interno de OpenAI muestra una capacidad general más sólida y un mayor potencial de ejecución multiagente, y la próxima generación de GPT de propósito general tiene la oportunidad de mejorar aún más su capacidad de producción de video; cuánto exactamente habrá que responderlo con evaluaciones independientes tras el lanzamiento y con tus propias pruebas de negocio.
La competencia a partir de ahora se librará en la eficiencia productiva de extremo a extremo: desde entender una idea creativa hasta producir un video fiable, preciso y editable, quien logre completar más tareas a menor costo. La recomendación es que construyas ya tu propia línea base de tareas de video en APIYI apiyi.com, para poder comparar directamente en cuanto el nuevo modelo salga al mercado.
Referencias
- Sitio web oficial de evaluación VibeVideoBench: clasificación de agentes de vídeo y puntuaciones de calidad
- Enlace:
vibevideobench.github.io -
Descripción: visión general de la clasificación general y del diseño de evaluación
-
Artículo de VibeVideoBench: metodología, puntuaciones por categoría, coste, preferencia humana y causas de fallo
- Enlace:
arxiv.org/abs/2610.35864 -
Descripción: principal fuente de los datos de las tablas de este artículo; las puntuaciones por categoría aparecen en el Appendix E.4
-
Anuncio de lanzamiento de Anthropic Claude Opus 5.5: posicionamiento del modelo y casos oficiales
- Enlace:
anthropic.com/claude-opus-5-5 -
Descripción: descripción oficial de las capacidades y la evolución de costes de Opus 5.5
-
OpenAI: On the Navier–Stokes Millennium Prize Problem: modelos internos e investigación multiagente
- Enlace:
openai.com/index/navier-stokes-solution -
Descripción: datos como 10.000 agentes concurrentes y 88 horas de investigación
-
OpenAI: Accelerating engineering for the physical world: resultados de modelos internos en BenchCAD 2.0
- Enlace:
openai.com/index/accelerating-engineering-for-the-physical-world -
Descripción: comparación entre el modelo interno 0.875 y GPT-6 Astra 0.594
-
OpenAI API Changelog y catálogo de modelos: verificación del avance de los lanzamientos
- Enlace:
developers.openai.com/api/docs/changelog,developers.openai.com/api/docs/models -
Descripción: registro del lanzamiento de GPT-6 Cyber y el modelo buque insignia público actual
-
OpenAI API Deprecations: información sobre el cierre de Sora 2 y Videos API
- Enlace:
developers.openai.com/api/docs/deprecations - Descripción: estado actual de la vía nativa de generación de vídeo
Autor: equipo técnico de APIYI
Contacto técnico: te invitamos a ponerte en contacto con nosotros desde la página principal de APIYI apiyi.com para intercambiar experiencias sobre pruebas de agentes de vídeo; más material de integración está disponible en el centro de documentación docs.apiyi.com