Resumen: La creación de video con IA ya se ha dividido en dos rutas técnicas: la generación nativa de video y el renderizado de código por Agentes. La primera destaca en imágenes realistas y movimiento natural; la segunda sobresale en animación precisa, expresión de datos y producción de ingeniería modificable. Solo entendiendo las diferencias entre ambas se puede construir un flujo de trabajo de producción de video eficiente.
Conclusión primero: La generación nativa de video y el renderizado de código por Agentes son adecuados para tareas distintas. Los personajes, la sensación de grabación real, el movimiento natural y el lenguaje cinematográfico se dejan a modelos de video nativos como Seedance, Kling y Veo; las gráficas de datos, las fórmulas, los tutoriales de software, los parámetros de precios y el contenido por lotes basado en plantillas se dejan a la cadena de renderizado de código compuesta por Remotion, Manim y FFmpeg. Combinados, ambos permiten obtener a la vez imágenes naturales y control preciso, lo cual es la solución de producción más práctica en la actualidad.
Avance del contenido: A continuación se explica primero la diferencia fundamental entre las dos rutas en cuanto al mecanismo de salida; luego se desglosan por separado las capacidades y los costes de los modelos de video nativos (Seedance 2.5, Kling 4.0, Veo 3.1) y de la cadena de herramientas de renderizado de código (Remotion, Manim, FFmpeg, Claude Motion, Codex); y, con los datos de evaluación independiente de VibeVideoBench, se muestra el nivel real de los Agentes a la hora de hacer video. Por último, se ofrece un flujo de producción híbrido tomando como ejemplo un anuncio de producto, explicando qué parte del trabajo asume cada modelo y herramienta.
Para saber: Glosario de rutas técnicas de video con IA
| Término | Explicación |
|---|---|
| Text-to-Video | Generar video directamente a partir de una indicación de texto |
| Image-to-Video | Generar video dinámico a partir de una imagen de referencia |
| Multimodal Reference | Usar simultáneamente imágenes, videos, audio y otros materiales para guiar la generación |
| Keyframe | Fotograma clave, usado para definir el estado de la imagen en un momento temporal específico |
| Timestamp-level Editing | Editar con precisión un segmento de contenido según puntos temporales del video |
| Agent | Sistema de IA capaz de planificar tareas de forma autónoma, invocar herramientas, verificar resultados y corregir |
| Remotion | Herramienta para crear animaciones de video con componentes de React y código |
| Manim | Motor para crear animaciones matemáticas y científicas con Python |
| FFmpeg | Herramienta de línea de comandos para codificación de video, síntesis de audio, edición y conversión de formato |
| ffprobe | Herramienta de inspección incluida con FFmpeg que puede leer resolución, tasa de fotogramas, duración y pistas de audio |
| TTS | Texto a voz, usado para generar narraciones automáticamente |
| Deterministic Rendering | Renderizado determinista: el mismo código y los mismos parámetros producen la misma imagen cada vez |
| Claude Motion | Función de Anthropic que empaqueta la animación impulsada por código como producto; actualmente en Beta |
| Cache Hit | Tasa de aciertos de caché: el contexto repetido se lee directamente de la caché, lo que puede reducir significativamente el costo de tokens |
1 Las dos rutas técnicas del vídeo con IA: mecanismos de salida completamente distintos
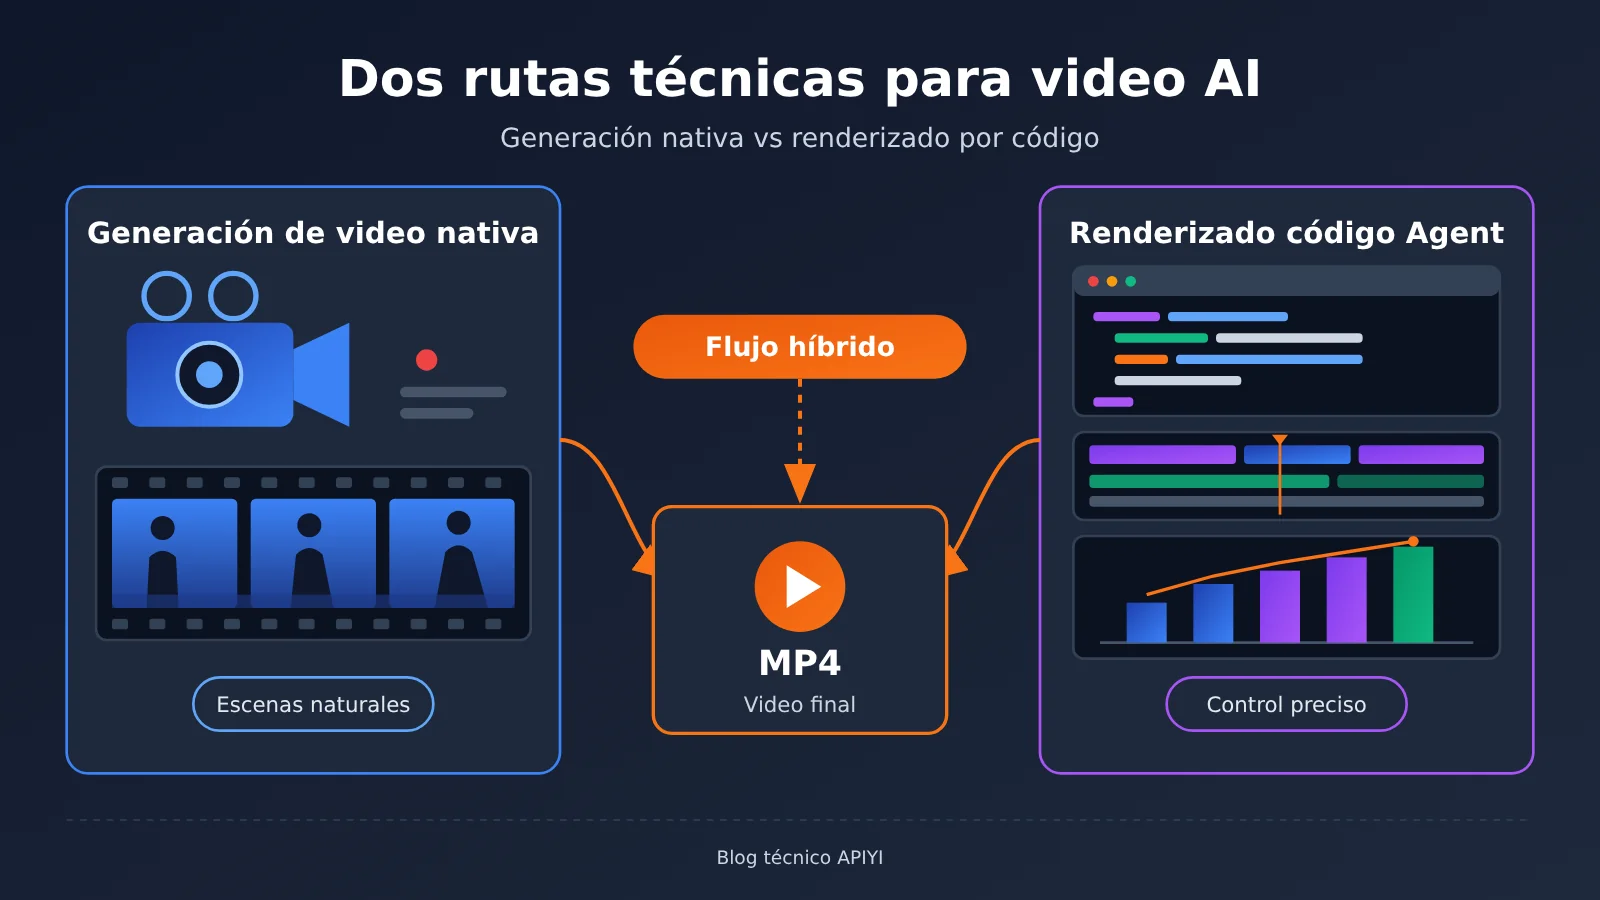
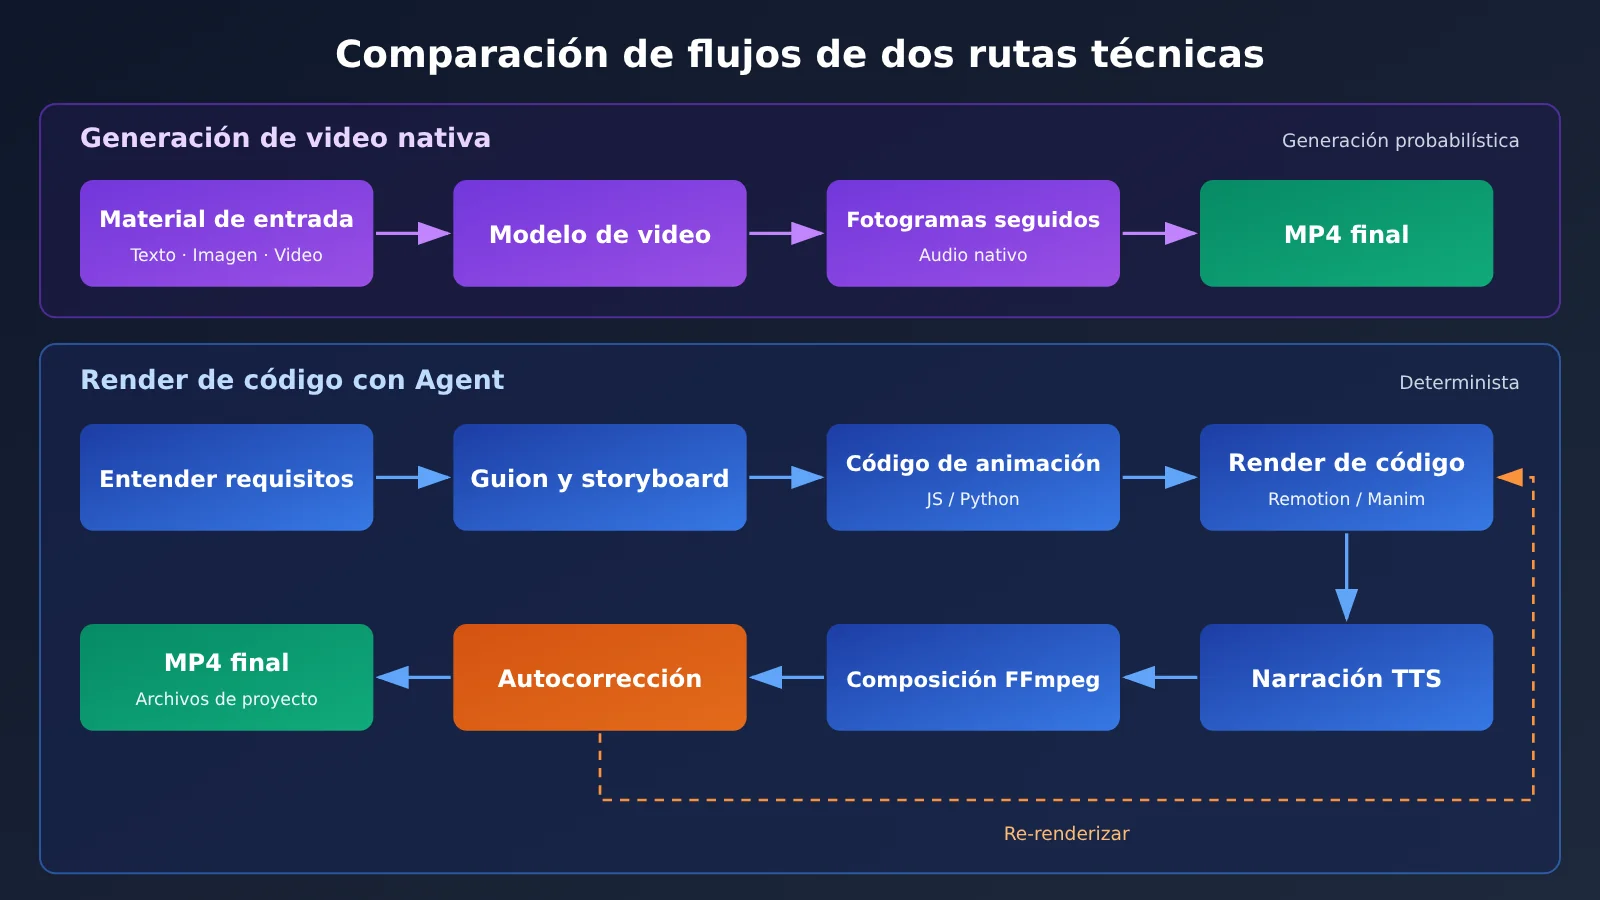
Ambas rutas pueden entregar un MP4, pero la forma en que producen las imágenes es totalmente distinta. En la generación de vídeo nativa, el modelo «dibuja» directamente cada fotograma; en el renderizado por código de un agente, el modelo escribe un programa de producción de vídeo y después un motor de renderizado produce las imágenes siguiendo ese programa. Esa diferencia determina todas las demás: precisión de control, capacidad de modificación y coste.
1.1 Generación de vídeo nativa: el modelo crea directamente imágenes continuas
La generación de vídeo nativa se apoya en texto a vídeo e imagen a vídeo. El usuario aporta una descripción textual o una imagen de referencia, y el modelo entrega directamente fotogramas de vídeo continuos: las personas, los objetos, el entorno, las acciones continuas y el movimiento físico de la escena los genera el modelo de una sola vez. Los movimientos de cámara (zoom, travelling), los cambios de plano y las transiciones de escena también se pueden indicar en la indicación.
Las nuevas generaciones de modelos ya generan audio nativo de forma sincronizada y permiten controlar la apariencia de los personajes, la escena y el estilo visual mediante varias imágenes de referencia y vídeos de referencia. Su ventaja es una imagen natural, con gran sensación de realismo; el precio es que cada fotograma proviene de una generación probabilística: la misma indicación da dos resultados distintos, y las modificaciones con precisión de píxel dependen de volver a generar o de funciones de edición específicas.
1.2 Renderizado por código de un agente: la IA escribe su propio programa de producción de vídeo
El renderizado por código de un agente hace que el Modelo de Lenguaje Grande actúe a la vez como director y como programador. Un flujo completo suele incluir:
- Entender los requisitos y definir el tema, el público y el estilo visual;
- Escribir el guion, la voz en off, el storyboard y la línea de tiempo;
- Escribir código de animación en JavaScript o Python (Remotion, Manim, Three.js, Cairo, Blender, etc.);
- Llamar al TTS para generar la voz en off y crear la música y los efectos sonoros;
- Llamar a FFmpeg para combinar audio e imagen;
- Revisar la imagen, el audio y la sincronización temporal, y corregir y volver a renderizar cuando aparezca algún problema;
- Entregar el MP4 final y los archivos de proyecto reutilizables.
La salida de esta ruta es determinista: si el código y los parámetros no cambian, el resultado del renderizado tampoco cambia. Para modificar un número, una línea de subtítulo o un color basta tocar el código y volver a renderizar, y el resto de la imagen se mantiene tal cual. Es especialmente buena en visualización de datos, presentaciones de producto, divulgación de conocimiento e infografías dinámicas; para generar personas reales y tomas de acción real hay que apoyarse en material ya existente o en activos 3D.
2 Ruta de generación de video nativa: para qué tareas es adecuada
En 2026, los modelos de video nativos ya han llevado la duración de una sola generación hasta los 30 segundos, y el foco de la competencia se ha desplazado hacia las referencias multimodales, el control de fotogramas clave y la edición continua después de generar. La siguiente tabla resume las capacidades públicas de tres modelos representativos.
| Capacidad | Seedance 2.5 | Kling 4.0 | Veo 3.1 |
|---|---|---|---|
| Fecha de lanzamiento/disponibilidad | Lanzado el 2026-07-31 | API totalmente disponible el 2026-10-28 | Incluido en la documentación de Gemini API |
| Duración de una sola generación | Hasta 30 segundos | Hasta 30 segundos | Admite extensión de video |
| Materiales de referencia | 30 imágenes, 10 videos, 10 audios | 10 imágenes y 5 videos, hasta 15 elementos combinados | Generación guiada por imágenes |
| Modo de control principal | Extensión en varias rondas, edición por marca de tiempo, edición de pantalla verde y de posición de cámara | Hasta 10 fotogramas clave, referencia de voz | Control del fotograma final, extensión de video |
| Audio | Admite referencia de audio | Admite referencia de voz | Generación de audio nativa |
| Facturación | Por resolución y duración (incluye consumo de Token) | Por Unit/segundo | Por especificación de generación |
2.1 Seedance 2.5: generación continua de 30 segundos y referencias multimodales
Seedance 2.5 fue lanzado por el equipo Seed de ByteDance el 31 de julio de 2026. Genera hasta 30 segundos en una sola pasada y una generación puede incluir varios planos consecutivos. Su capacidad de referencia es la más amplia entre los parámetros públicos disponibles hasta ahora: hasta 30 imágenes de referencia, 10 videos de referencia y 10 audios de referencia, de modo que el diseño de personajes, las fotos de escenarios, las referencias de movimiento y la banda sonora se pueden entregar juntos al modelo para que organice escenas complejas.
En el plano de la edición, Seedance 2.5 permite extender un video existente en varias rondas manteniendo en lo posible la consistencia de personajes, escenarios y sonido; permite modificar en momentos concretos las acciones de los personajes y la trama; y también admite edición sobre fondo verde, edición del ángulo de cámara y consistencia entre múltiples personajes. Además, puede usar referencias de Clay Render (renderizado en arcilla) para controlar la estructura espacial, la ubicación de los personajes y el movimiento de cámara. Los ejemplos oficiales abarcan actuaciones de personajes de la ópera de Pekín, espectáculos escénicos, interacción entre varios personajes y transiciones de escenas continuas. Justamente este tipo de contenido —varios personajes, planos largos y narrativa continua— es lo más difícil de lograr con renderizado por código.
2.2 Kling 4.0: control mediante fotogramas clave y referencias de video
Kling 4.0 abrió su API de forma completa el 28 de octubre de 2026. Genera hasta 30 segundos por vez, admite 720p y 1080p, y ofrece relaciones de aspecto como 21:9 y proporción adaptativa. Su rasgo distintivo son hasta 10 fotogramas clave: el creador puede fijar varios estados de imagen en la línea de tiempo y dejar que el modelo complete el movimiento entre ellos, lo que hace más controlables la dirección del plano y la postura de los personajes.
En cuanto a material de referencia, Kling 4.0 admite hasta 10 imágenes de referencia y 5 videos de referencia, con un máximo de 15 elementos en una entrada mixta, y ofrece referencias multimodales Omni y referencias de voz. Integra generación de texto, generación de imágenes, material de referencia y edición de video, lo que lo hace adecuado para proyectos que necesitan una imagen de personaje estable, una ruta de cámara específica o una segunda edición sobre un video ya existente.
2.3 Veo 3.1: audio nativo y extensión de video
Google ofrece dos tipos de productos de generación de video en la API de Gemini. Veo 3.1 se centra en la generación de audio nativo, la extensión de video, el control del fotograma final y la generación guiada por imágenes; es adecuado para producir de una vez un clip con “imagen y sonido”. Gemini Omni Flash se centra en la entrada multimodal, la consistencia de personajes, la comprensión de video y la edición conversacional de múltiples turnos. Cada uno representa una de las dos direcciones del ámbito del video nativo: generar clips de alta calidad y, tras generarlos, seguir editándolos, modificándolos y extendiéndolos.
En el caso de OpenAI, el producto Sora dejó de funcionar el 26 de abril de 2026, y el modelo Sora 2 y la Videos API se cerraron el 24 de septiembre de 2026; el aviso oficial de descontinuación indicaba que no había una API de reemplazo uno a uno. Images 2.6, lanzado por OpenAI el 4 de noviembre de 2026, admite la salida de animaciones GIF de 2 a 16 fotogramas, adecuada para emoticonos animados, bucles de movimiento de personajes y previsualización de storyboard; forma parte de un flujo de trabajo distinto al de la producción de video MP4 completo.
2.4 Ventajas y costos de la generación de video nativo
Las ventajas principales de la generación de video nativo se concentran en cuatro aspectos: movimientos humanos naturales, movimiento físico creíble, movimientos de cámara cinematográficos y expresión creativa abierta. Implementar estas capacidades mediante código exige muchos recursos de animación y ajustes manuales; con un modelo de video, se pueden generar de una sola vez.
En cuanto al costo, el video nativo se factura según la especificación de salida y la duración. Tomemos como ejemplo los precios oficiales de Seedance 2.5 actualizados por BytePlus ModelArk el 13 de noviembre de 2026:
| Especificación de salida | Precio de referencia de video de 5 segundos | Estimación por segundo |
|---|---|---|
| 480p | $0.514 | $0.103 |
| 720p | $1.156 | $0.231 |
| 1080p | $2.843 | $0.569 |
De 720p a 1080p, el costo por segundo se multiplica por aproximadamente 2.5. La tabla anterior es una estimación para las especificaciones típicas oficiales; la duración, la resolución, la tasa de fotogramas y el consumo real de tokens del video de entrada afectan la factura final. Kling 4.0, por su parte, se factura por Unit de la plataforma: 720p cuesta 1 Unit/segundo, 1080p cuesta 1.5 Units/segundo y Kling 4.0 Flash 720p cuesta 0.6 Units/segundo. Cuando se usa un video de entrada existente, también influye la duración de la entrada; Unit es la unidad de facturación de la plataforma y debe convertirse a un monto real según las reglas de la plataforma.
Cabe tener en cuenta que estos precios corresponden al costo de “una generación”. El video nativo tiene aleatoriedad; en la producción real, a menudo hay que generar varias veces y luego seleccionar, por lo que el costo de las tomas finales utilizables suele ser mayor que el precio de una sola generación.
3 Ruta de renderizado mediante código con Agent: hacer que la IA se convierta en ingeniero de producción de video
La base de la ruta de renderizado mediante código es un conjunto de herramientas maduras, ya sean de código abierto o comerciales. El Modelo de Lenguaje Grande se encarga de convertir los requisitos en el código que esas herramientas pueden ejecutar, y también de coordinar, verificar y corregir el proceso.
3.1 Remotion: animación con React y producción automatizada de video
Remotion describe la escena con componentes de React y controla la posición, el tamaño, la opacidad y el movimiento de los elementos mediante el número de fotograma. Los desarrolladores pueden crear animaciones directamente con React, HTML, CSS y JavaScript; en la escena se pueden combinar texto, gráficos, imágenes, video y audio, y controlar con precisión cada fotograma. Además, admite renderizado por lotes desde la CLI, renderizado en el servidor y renderizado en la nube con Lambda, y también permite generar por lotes videos con contenido distinto pasando distintos parámetros.
El flujo oficial de renderizado es muy sencillo:
# Instalar Remotion
npm install remotion @remotion/cli

# Renderizar la composición (Composition) de video indicada y exportar a MP4
npx remotion render HelloWorld out.mp4
En cuanto a la licencia, Remotion es gratuito para personas individuales y para empresas pequeñas de hasta 3 personas; si se cumplen los términos, se puede usar comercialmente. El plan Automators cobra $0.01 por renderizado, con un gasto mínimo mensual de $100; el plan Creators cuesta $25 por puesto/mes; el plan Enterprise parte de $500/mes (actualizado el 14 de noviembre de 2026). La tarifa de licencia de renderizado de Remotion y el costo de los tokens que consume el modelo de IA al escribir código son dos costos independientes, y hay que calcularlos por separado.
3.2 Manim: animaciones matemáticas y científicas precisas
Manim es un motor de animación en Python, diseñado específicamente para demostraciones de fórmulas matemáticas, transformaciones de figuras geométricas, procesos de movimiento físico, principios de funcionamiento de algoritmos y explicaciones de experimentos científicos. Las relaciones de movimiento entre fórmulas, ejes de coordenadas, estructuras geométricas y objetos se definen mediante código, por lo que la posición de cada símbolo y de cada curva es precisa y controlable. Las fórmulas que generan los modelos de video nativos suelen presentar errores de caracteres o errores estructurales, y este es precisamente el terreno donde Manim destaca.
El ejemplo oficial de inicio rápido produce un MP4 con un solo comando:
manim -pql main.py CreateCircle
3.3 FFmpeg: convertir todo tipo de materiales en el video final
FFmpeg es la «línea de ensamblaje final» de toda la cadena de renderizado por código. Se encarga de la codificación y transcodificación de video, la combinación de audio, el empalme de múltiples clips, la incrustación de subtítulos, el recorte y escalado, la conversión de velocidad de fotogramas y la conversión de formatos. El ffprobe complementario puede leer la resolución, la velocidad de fotogramas, la duración y la información de las pistas de audio del video final; el Agent lo usa para la verificación automática: si las especificaciones no cumplen, se vuelve al paso anterior para corregirlo.
# Empalmar clips (en list.txt se enumeran los archivos de cada clip, una línea por archivo)
ffmpeg -f concat -safe 0 -i list.txt -c copy merged.mp4

# Combinar la narración e incrustar los subtítulos
ffmpeg -i merged.mp4 -i voice.mp3 -vf subtitles=subs.srt \
  -map 0:v -map 1:a -c:v libx264 -c:a aac final.mp4

# Verificar las especificaciones de salida
ffprobe -v error -show_entries stream=codec_type,width,height,r_frame_rate \
  -show_entries format=duration final.mp4
3.4 Claude Motion: la animación por código se convierte en una función de producto común
Anthropic lanzó Claude Motion Beta el 8 de octubre de 2026 para poner la animación impulsada por código directamente en manos de los usuarios empresariales. Los usuarios describen sus necesidades de animación en lenguaje natural; Claude organiza texto, gráficos, formas e imágenes en animaciones de código y las guarda en Artifacts. Después, pueden seguir modificándolas mediante conversación, entrar en el editor para ajustarlas manualmente y, por último, exportarlas como MP4.
Entre los usos típicos están: convertir el informe trimestral en una animación explicativa de 30 segundos, transformar los planes de precios en un gráfico comparativo dinámico, convertir los pasos de uso de un producto en una animación de guía y convertir materiales de reuniones en vídeos promocionales internos. En cuanto a las condiciones de uso, la Beta está abierta a usuarios de Team y Enterprise: Team la tiene activada por defecto, mientras que en Enterprise debe activarla un administrador de la organización. El uso se contabiliza dentro de la cuota del plan. Claude Motion no utiliza modelos nativos de generación de vídeo, por lo que no puede generar personas reales ni planos continuos con estilo de acción real.
El valor de producto de Claude Motion está en la barrera de entrada: el personal de operaciones, finanzas y marketing de las empresas puede obtener directamente la precisión y la capacidad de modificación de la animación por código sin necesidad de montar un proyecto Remotion.
3.5 GPT + Codex: agentes que invocan herramientas para completar la producción de video
Otra modalidad consiste en permitir que un modelo generalista invoque herramientas de forma autónoma dentro de un entorno de desarrollo de agentes. VibeVideoBench, publicado el 26 de octubre de 2026, evalúa específicamente esta capacidad: 239 tareas reales de producción de video abarcan 12 categorías de contenido, como historias basadas en datos, cursos educativos, explicaciones de artículos, marketing de marca y demostraciones de funcionalidades de producto. Cada tarea exige que la IA entregue de forma autónoma, en un sandbox y en un plazo de 60 minutos, un MP4 reproducible, un proyecto de ingeniería capaz de regenerar el video, y una programación temporal y notas de producción. Nueve sistemas de agentes completaron un total de 2.151 ejecuciones, todas en sus respectivos entornos de desarrollo nativos y con la máxima intensidad de razonamiento disponible, sin permitir instrucciones humanas adicionales durante el proceso.
La comparación de los dos sistemas mejor clasificados es la siguiente (promedio de tres jurados, puntuaciones de 1 a 5):
| Métrica | GPT-6 Astra (Codex CLI) | Claude Opus 5.5 (Claude Code) |
|---|---|---|
| Videos entregados con éxito | 238/239 (99,6 %) | 239/239 (100 %) |
| Tasa de cumplimiento de especificaciones | 93,7 % | 99,6 % |
| Tasa de aprobación de requisitos de la tarea | 97,1 % | 97,3 % |
| Puntuación de calidad global | 4,109 | 4,074 |
| Tasa de éxito estricta en las tareas | 74,5 % | 76,3 % |
| Elo de preferencia humana | 1242 | 1203 |
| Costo medio por tarea | $8,19 | $15,38 |
| Costo mediano / P90 por tarea | $7,88 / $11,88 | $10,19 / $31,22 |
| Tokens de salida medios | 61K | 130,7K |
| Aciertos de caché (Cache Hit) | 97 % | 65 % |
En este conjunto de pruebas, GPT-6 Astra obtuvo una calidad global y una preferencia humana ligeramente superiores, y su costo medio por tarea fue alrededor de 46,7 % menor; Claude Opus 5.5 entregó las 239 tareas, con mayores tasas de cumplimiento de especificaciones y de éxito estricto. La principal fuente de la diferencia de costos es la eficiencia en el uso de tokens: Astra genera aproximadamente 53,3 % menos tokens de salida y alcanza un 97 % de aciertos de caché, mientras que cerca del 76 % del costo por tarea de Opus proviene de Cache Write. Aunque el precio unitario estándar de entrada y salida de Astra es 2,5 veces el de Opus, el gasto real para completar una sola tarea resulta menor.
Para interpretar estos datos hay que tener en cuenta el criterio de evaluación: el objeto evaluado es un sistema de agentes completo formado por «modelo + entorno de ejecución», y Codex CLI y Claude Code, usados respectivamente por GPT y Claude, difieren entre sí; cada tarea se ejecuta una sola vez, con un límite de 60 minutos; el coeficiente de correlación de ranking entre los tres jurados es de 0,933–0,950, y con el ranking Elo humano es de 0,98, pero la coincidencia entre la preferencia humana por un video individual y el resultado del jurado es del 73,3 %. Por lo tanto, estas puntuaciones sirven para juzgar el nivel aproximado a escala de sistema, no para extrapolarlas a todas las tareas de video, ni sustituyen la evaluación de modelos nativos de texto a video.
VibeVideoBench también reveló el principal cuello de botella de los agentes al producir video: de 2.151 ejecuciones, 224 no entregaron un video reproducible; 169 de ellas corresponden a problemas de gestión del tiempo, como iniciar demasiado tarde el renderizado final, ejecutar demasiado lento o no iniciarlo en absoluto, lo que representa alrededor del 75 % de los casos de fallo. La dificultad de los agentes de video ya no está en «saber escribir código de animación», sino en la programación del renderizado y la gestión de la entrega.
En comparación con Claude Motion, entornos de agentes como Codex y Claude Code están orientados a desarrolladores: pueden combinar libremente Remotion, Manim, FFmpeg, TTS y grabación de pantalla, producir archivos de proyecto completos y encajan bien en líneas de producción automatizadas; Claude Motion está orientado a usuarios finales empresariales, su interacción es más sencilla y sus capacidades se concentran en animaciones de texto, gráficos y formas.
4 Cómo elegir entre generación nativa de video y renderizado de código por agentes
4.1 Tareas adecuadas para la generación nativa de video
- Estilo de rodaje con personas reales: actores de carne y hueso, expresiones faciales y movimientos corporales;
- Escenarios de uso del producto: imágenes del producto utilizándose en un entorno real;
- Movimiento natural y lenguaje cinematográfico: zoom, paneos, travelling, tomas de seguimiento y cambios de encuadre;
- Anuncios con sensación cinematográfica: videos de marca que priorizan la iluminación, la atmósfera y la textura;
- Actuaciones de personajes y tramas continuas: interacción entre varios personajes y narrativa con planos secuencia;
- Entornos naturales complejos: escenarios difíciles de modelar, como el clima, las corrientes de agua o los paisajes urbanos.
4.2 Tareas adecuadas para la producción impulsada por código
- Gráficos de datos precisos: los números, las coordenadas y las proporciones deben ser exactos;
- Tutoriales de operación de software: grabación de pantalla de la interfaz con anotaciones, resaltados y descripción de pasos;
- Explicaciones matemáticas y científicas: derivación de fórmulas, transformaciones geométricas, demostración de algoritmos;
- Infografías dinámicas: presentación paso a paso de información estructurada;
- Comparación de parámetros de productos y descripción de precios: cada valor se puede verificar y modificar;
- Contenido masivo basado en plantillas: generar por lotes cientos de videos reemplazando datos en la misma plantilla.
La siguiente tabla resume el grado de adecuación de las dos rutas en tareas comunes:
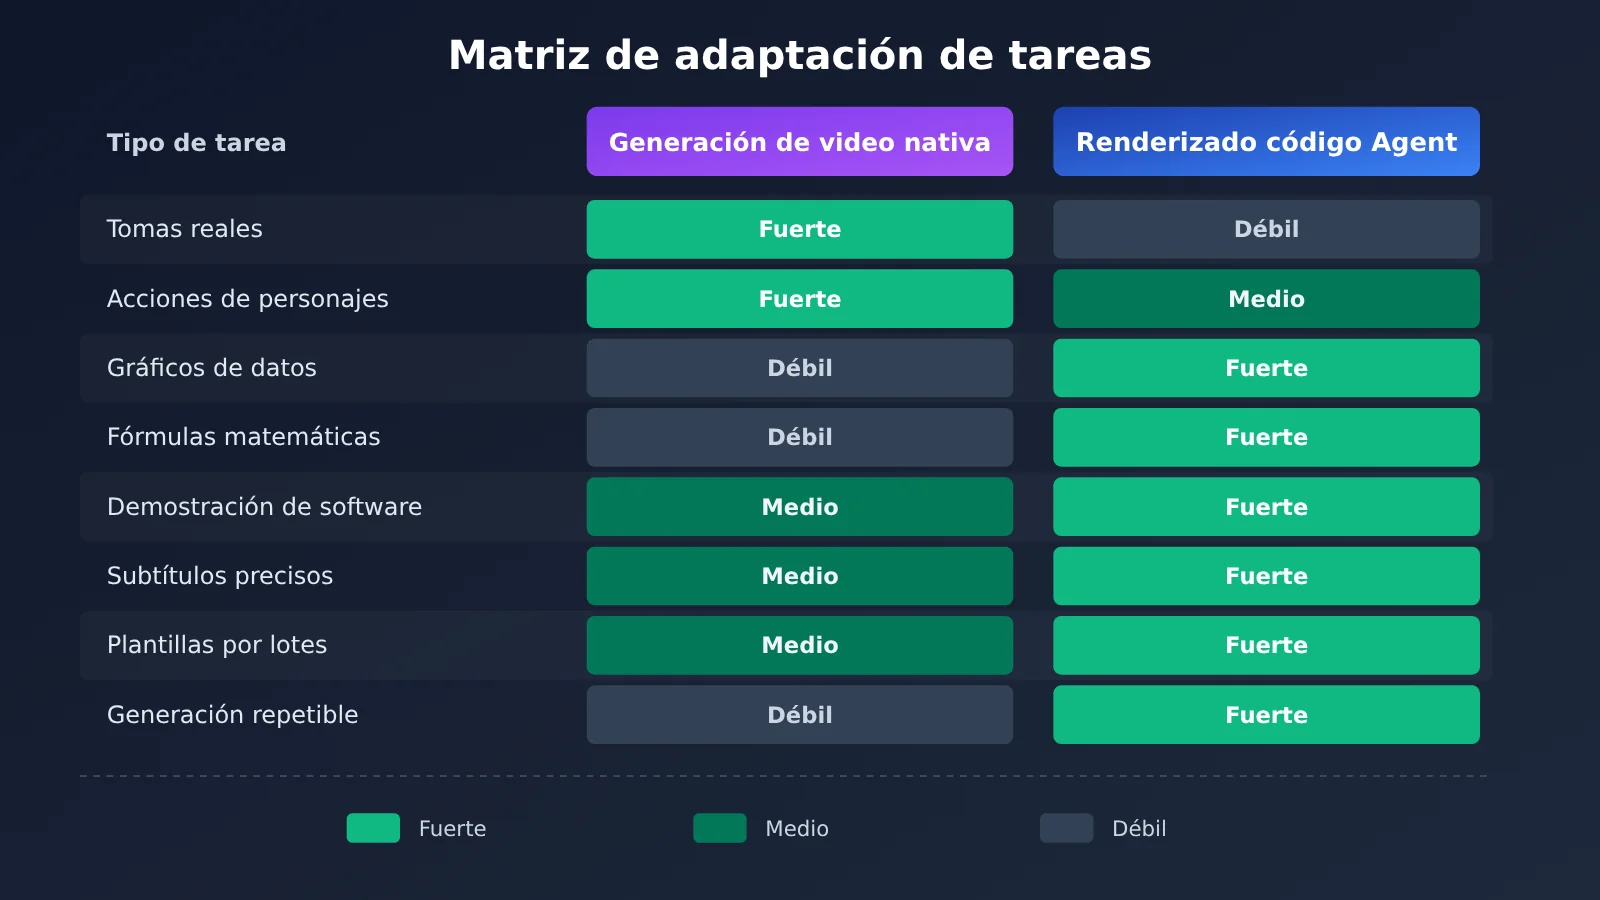
| Tarea | Generación nativa de video | Renderizado de código por Agent |
|---|---|---|
| Tomas reales con sensación cinematográfica | Fuerte | Requiere material existente o activos 3D |
| Acciones naturales de personas | Fuerte | Depende de activos de animación |
| Movimientos de cámara complejos | Fuerte | Se puede programar con precisión |
| Presentación precisa de datos | Difícil de garantizar | Fuerte |
| Animación de fórmulas matemáticas | Propenso a errores | Fuerte |
| Demostración de interfaz de software | Requiere referencia y postprocesamiento | Fuerte |
| Subtítulos precisos | Requiere revisión posterior | Fuerte |
| Exhibición dinámica de productos | Fuerte | Fuerte |
| Producción masiva con plantilla unificada | Requiere múltiples generaciones y filtrado | Fuerte |
| Modificación precisa de un solo detalle | Depende de regeneración o edición | Fuerte |
| Generación repetible de la misma animación | Afectado por la aleatoriedad | Fuerte |
La investigación de VibeVideoBench también señala que el renderizado de código es especialmente adecuado para tareas como fórmulas precisas, gráficos de datos, imágenes de juegos con reglas consistentes y narración sincronizada.
💡 Consejo para elegir: el criterio se puede resumir en una frase: si la imagen necesita «parecer real», usa el modelo de video nativo; si la información necesita ser «exacta y sin errores», usa el renderizado de código. Los scripts, storyboards y código de animación en la cadena de renderizado de código dependen del Modelo de Lenguaje Grande general; recomendamos probar primero GPT, Claude y Gemini con la misma clave API a través de APIYI apiyi.com en tus tareas de scripts y código, y luego decidir el modelo principal.
4.3 Estructura de costes de las dos rutas
La estructura de costes de las dos rutas es muy diferente, así que comparar directamente el precio unitario tiene poco sentido:
- Generación de video nativa: se cobra principalmente por resolución y duración de salida, más el consumo adicional que implica introducir un video de referencia; las generaciones múltiples y el filtrado provocados por la aleatoriedad son costes ocultos.
- Renderizado de código por agente: incluye el coste de tokens del modelo general (entrada, salida, lectura y escritura de caché), la potencia de cómputo para ejecutar código y renderizar, licencias de herramientas (como la licencia comercial de Remotion) y el coste de materiales de TTS, música y efectos de sonido.
A la hora de comparar, hay que fijarse en «el coste total del video final entregable»: si un plano de video nativo tiene que generarse cinco veces para dar con un resultado usable, su coste real es cinco veces el precio cotizado; si una tarea de agente tiene una tasa baja de aciertos de caché y se vuelve a renderizar una y otra vez, el coste de tokens también se dispara. Los datos de VibeVideoBench muestran que un modelo con un precio unitario más alto puede lograr un coste por tarea más bajo gracias a menos tokens de salida y a una mayor tasa de aciertos de caché; a la hora de elegir modelo, hay que mirar el gasto real medido por tarea.
💰 Optimización de costes: en la cadena de renderizado de código, el coste del modelo pesa bastante y, además, suele tratarse de llamadas de contexto largo y de múltiples turnos. Con APIYI apiyi.com puedes invocar varios modelos populares y pagar por uso; así, con el mismo código, comparas el gasto real de distintos modelos al completar una misma tarea de video y luego asignas modelos según el tipo de tarea.
5. La solución más eficaz: combinar las dos rutas tecnológicas de video con IA
5.1 Flujo de producción híbrido
Combinar ambas rutas —dejando que los modelos de video nativos se encarguen de las imágenes naturales y que el renderizado por código se ocupe de la expresión precisa— es la opción más viable hoy en día:
- Creatividad y storyboard: GPT o Claude se encargan de la idea creativa, el guion y el storyboard, e indican el método de producción de cada toma;
- Tomas naturales: Seedance, Kling o Veo generan las tomas de personas, escenarios y uso del producto;
- Planos precisos: Remotion se encarga de gráficos de datos, subtítulos, elementos de marca y animaciones de especificaciones del producto;
- Narración: TTS genera la narración a partir del guion;
- Composición: FFmpeg une las tomas, combina las pistas de audio e incrusta los subtítulos;
- Validación y corrección: el agente de IA usa ffprobe para comprobar las especificaciones, además de verificar la sincronización entre audio e imagen y los subtítulos; si detecta algún problema, vuelve al paso correspondiente para corregirlo.
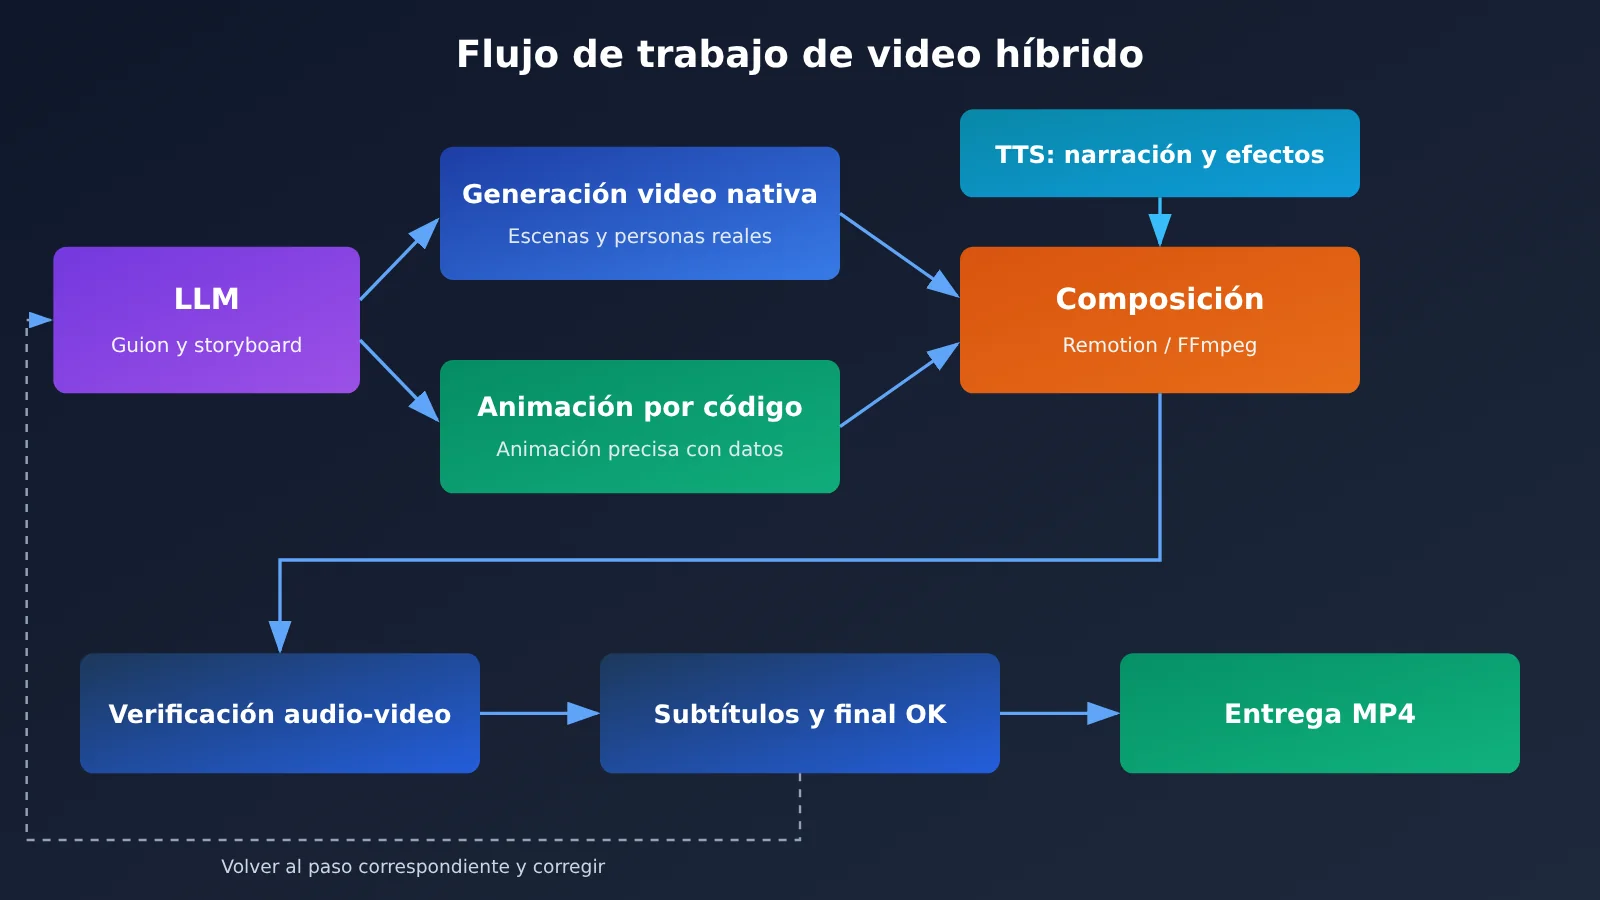
En la imagen anterior, tanto la fase de guion y storyboard como la de revisión del video final las realizan modelos de lenguaje grandes de propósito general. Estas invocaciones pueden centralizarse a través de APIYI (apiyi.com), usando una única interfaz compatible con OpenAI para alternar entre GPT, Claude y Gemini.
5.2 Ejemplo transversal: reparto de tareas en un video promocional de producto
Tomemos como ejemplo un video promocional para una aplicación móvil. El trabajo se puede repartir así:
- Tomas de ambiente inicial (usuarios usando el producto en el trayecto al trabajo o en la oficina): se delegan a Seedance 2.5 o Kling 4.0. Se usan fotos del producto y fichas de diseño de personajes como referencias para garantizar la consistencia facial y de la apariencia del producto; con Kling 4.0 se pueden fijar los encuadres de apertura y cierre mediante keyframes. Según la estimación oficial de Seedance 2.5, 720p cuesta aproximadamente $0.231 por segundo; al planificar el presupuesto hay que reservar margen para varias generaciones.
- Segmento de demostración de funciones: se graba la interfaz real de la aplicación y luego se superponen con Remotion recuadros de resaltado, numeración de pasos y anotaciones dinámicas. El contenido de la interfaz proviene de una grabación de pantalla real, por lo que no aparecerán botones «inventados» por el modelo.
- Segmento de parámetros y precios: se renderizan la tabla comparativa de funciones y las tarjetas de precios con componentes de Remotion. Cuando cambian los precios, basta modificar el archivo de datos y volver a renderizar; el resto de las imágenes permanece igual.
- Locución y subtítulos: un Modelo de Lenguaje Grande redacta el guion de locución, TTS genera la voz y al mismo tiempo se exporta el archivo de subtítulos SRT.
- Ensamblaje final y control de calidad: FFmpeg une todos los fragmentos y combina la pista de audio; el Agent verifica con ffprobe la duración, la resolución y la pista de audio, y después revisa fragmento por fragmento si los subtítulos y la locución están sincronizados.
El resultado de este reparto es el siguiente: las tomas con apariencia realista las garantiza el modelo de video, toda la información verificable la garantiza el código, y para futuras revisiones solo hay que volver a renderizar los fragmentos correspondientes.
5.3 Generar un storyboard con etiquetas de enrutamiento mediante API
El primer paso del flujo híbrido consiste en pedir al Modelo de Lenguaje Grande que produzca un storyboard estructurado y que indique, para cada plano, qué ruta debe seguir. El siguiente ejemplo usa la interfaz compatible con OpenAI para completar este paso:
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

MODEL = "your-model-name"  # Reemplaza con el nombre real del modelo en el listado de modelos de la plataforma

prompt = """为一款记账 App 写 30 秒宣传片分镜,输出 JSON 数组。
每个镜头包含 id、duration、description、route 字段。
route 只能是 native(真实人物与场景,交给视频模型)
或 code(数据、参数、字幕、界面标注,交给 Remotion 渲染)。"""

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": prompt}],
)
print(resp.choices[0].message.content)
Ver la implementación completa: enrutamiento del storyboard + generación de parámetros de renderizado de Remotion
import json
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PLANNER_MODEL = "your-planner-model"  # Modelo responsable de la creatividad y del storyboard
CODER_MODEL = "your-coder-model"      # Modelo responsable de generar los parámetros de renderizado/código


def plan_storyboard(brief: str) -> list[dict]:
    """Hace que el modelo genere un JSON de storyboard con etiquetas route."""
    resp = client.chat.completions.create(
        model=PLANNER_MODEL,
        messages=[
            {"role": "system", "content": "你是视频导演,只输出合法 JSON 数组。"},
            {"role": "user", "content": brief},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def build_remotion_props(shot: dict) -> dict:
    """Genera los parámetros del componente Remotion para los planos de la ruta code."""
    resp = client.chat.completions.create(
        model=CODER_MODEL,
        messages=[
            {"role": "system", "content": "把镜头描述转换为 Remotion 组件 props,只输出 JSON 对象。"},
            {"role": "user", "content": json.dumps(shot, ensure_ascii=False)},
        ],
    )
    return json.loads(resp.choices[0].message.content)


def render_code_shot(shot_id: str, props: dict) -> str:
    """Llama a la CLI de Remotion para renderizar un solo plano."""
    out = f"out/{shot_id}.mp4"
    subprocess.run(
        ["npx", "remotion", "render", "InfoCard", out,
         f"--props={json.dumps(props, ensure_ascii=False)}"],
        check=True,
    )
    return out


if __name__ == "__main__":
    shots = plan_storyboard("为一款记账 App 写 30 秒宣传片分镜,"
                            "字段:id、duration、description、route(native/code)。")
    for shot in shots:
        if shot["route"] == "code":
            path = render_code_shot(shot["id"], build_remotion_props(shot))
            print("已渲染:", path)
        else:
            # Los planos native se delegan al modelo de generación de video; aquí se registra la indicación para generarlos después
            print("待原生生成:", shot["id"], shot["description"])
🚀 Inicio rápido: los pasos anteriores de generación del storyboard y de los parámetros solo necesitan un Modelo de Lenguaje Grande de uso general. Se recomienda registrarse en APIYI apiyi.com y usar el crédito gratuito de prueba para nuevos usuarios: primero haz que dos o tres modelos ejecuten la misma solicitud de video promocional, compara la calidad del storyboard y el consumo de tokens, y luego fija la configuración en el flujo de producción.
6 Conclusión: el foco de la competencia en video con IA es el flujo completo de producción
La relación entre ambas rutas tecnológicas y las tareas que cubren ya está bastante clara: la generación nativa de video se encarga de imágenes reales, la actuación de personajes y el lenguaje de cámara —Seedance 2.5, Kling 4.0 y Veo 3.1 ponen el acento en la generación continua de 30 segundos, las referencias multimodales, los fotogramas clave y la edición continua—; el renderizado por código de agente se encarga de la información exacta, el renderizado reproducible y la producción por lotes, donde Remotion, Manim y FFmpeg forman la base de herramientas, Claude Motion lo convierte en producto para usuarios corporativos, y Codex y Claude Code permiten a los desarrolladores montar un pipeline de automatización completo.
Los resultados de VibeVideoBench muestran que los sistemas de agente de primer nivel ya entregan videos completos de forma estable, y que las causas principales de fallo se concentran en la programación del renderizado y la gestión del tiempo; mientras que el coste de una tarea depende de la eficiencia de tokens y la tasa de aciertos de caché, no del precio unitario del modelo. Esto significa que la competencia en la producción de video está pasando de la calidad de imagen de un modelo concreto a la capacidad de organizar todo el flujo de trabajo: «generar, editar, renderizar y entregar».
Repaso de los puntos clave:
- Diferencia entre rutas: la generación nativa produce la imagen directamente desde el modelo; el renderizado por código hace que el modelo escriba un programa y luego lo renderice;
- Cuándo usar generación nativa: personas, sensación de grabación real, movimiento natural, anuncios con estética cinematográfica e historias continuas;
- Cuándo usar renderizado por código: gráficos de datos, fórmulas, tutoriales de software, comparativas de parámetros y precios, y contenido por lotes con plantillas;
- Criterio de comparación de costes: tomar como referencia el coste total del video final entregable, incluyendo reintentos, tokens, renderizado y licencias;
- Mejor práctica: un flujo de trabajo híbrido, dejando que el modelo de video se encargue de las imágenes naturales y que el código se encargue de la expresión precisa;
- Invocación de múltiples modelos: guion, storyboard, código de animación y revisión del montaje final encajan con modelos distintos, y una interfaz unificada reduce el coste de cambiar entre ellos.
En la producción real, un video suele requerir varios Modelos de Lenguaje Grande trabajando por separado en la idea creativa, la codificación y la revisión. Recomendamos usar APIYI apiyi.com para invocar GPT, Claude, Gemini y otros modelos con una sola clave API de forma unificada, asignando cada modelo según la tarea y pagando por consumo, para concentrar el esfuerzo en el propio flujo de trabajo.
Referencias
- Evaluación oficial de VibeVideoBench: benchmark de agentes para la generación de video basada en código
- Enlace:
vibevideobench.github.io -
Descripción: ranking de 239 tareas, puntuaciones de calidad, análisis de costes y causas de fallo
-
Anuncio oficial de Seedance 2.5: generación de 30 segundos y referencias multimodales
- Enlace:
seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5 -
Descripción: límite de material de referencia, extensión y edición con marcas de tiempo
-
Precios de BytePlus ModelArk: tarifas de la API de Seedance 2.5
- Enlace:
docs.byteplus.com/en/docs/modelark/model-pricing -
Descripción: precios de referencia para la generación de video según la resolución
-
Documentación de la API de Kling: anuncio de actualización y facturación de Kling 4.0
- Enlace:
kling.ai/document-api/apiReference/updateNotice -
Descripción: fotogramas clave, referencias con múltiples materiales y reglas de facturación por Unit
-
Documentación de generación de video de Gemini API: Veo 3.1 y Gemini Omni Flash
- Enlace:
ai.google.dev/gemini-api/docs/video -
Descripción: audio nativo, extensión de video y edición multiturno
-
Documentación y precios de licencia de Remotion
- Enlace:
remotion.dev/docs/render,remotion.dev/docs/license/pricing -
Descripción: comandos de renderizado y opciones de licencia comercial
-
Documentación de Manim Community
- Enlace:
docs.manim.community/en/stable -
Descripción: uso del motor de animación matemática y científica
-
Documentación oficial de FFmpeg
- Enlace:
ffmpeg.org/documentation.html -
Descripción: codificación, composición, subtítulos e inspección con ffprobe
-
Guía de uso de Claude Motion
- Enlace:
support.claude.com/en/articles/17454997-get-started-with-claude-motion -
Descripción: flujo de la función Beta y condiciones de acceso
-
Deprecaciones de la API de OpenAI
- Enlace:
developers.openai.com/api/docs/deprecations - Descripción: información sobre el cierre de Sora 2 y la API de Videos
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal del sitio oficial de APIYI; para más material de integración, visita el centro de documentación docs.apiyi.com