Autorhinweis: Eine Einordnung, wie sich der 12-Stunden-Prompt-Cache von OpenAI auf die Kosten der GPT-6-API auswirkt – mit einer Break-even-Formel und fünf Beurteilungskriterien, die zeigen, in welchen Szenarien sich das Aktivieren des Caches lohnt und in welchen der Nutzen begrenzt bleibt.
OpenAI hat beim Prompt-Cache eine Cache-Aufbewahrung von 12 Stunden eingeführt. Für Teams, die die GPT-6-API nutzen, ist das ein Signal, die Kosten neu zu kalkulieren. Bisher war der Cache meist nur für Leerlaufzeiten von wenigen Minuten gültig; viele Anfragen mit geringer Frequenz profitierten überhaupt nicht vom Rabatt. Jetzt ist das Cache-Fenster deutlich länger, sodass auch viele Anfragen, die erst nach einigen Stunden erneut eingehen, einen Cache-Treffer erzielen können.
Das ist kein Marketing-Slogan nach dem Motto „Cache an – und schon spart man automatisch die Hälfte“. Ob der Cache Kosten spart, hängt davon ab, ob das Präfix stabil ist, wie groß die Abstände zwischen den Anfragen sind, wie groß das Präfix pro Anfrage ist und ob das Schreiben in den Cache zusätzliche Kosten verursacht. Dieser Artikel liefert eine einfache Break-even-Formel, mit der Sie einschätzen können, ob sich der 12-Stunden-Cache für Ihren Anwendungsfall lohnt.
Der zentrale Nutzen: In 5 Minuten verstehen, was sich beim 12-Stunden-Prompt-Cache geändert hat, und mit 5 Kriterien beurteilen, wann der Cache bei der GPT-6-API wirklich Kosten spart.
OpenAI 12-Stunden-Prompt-Cache: Die wichtigsten Informationen auf einen Blick
Zuerst ein tabellarischer Überblick über die wichtigsten Punkte dieses Updates. Da OpenAI Preise und Parameter laufend anpasst, sind für alle Angaben zur Abrechnung die offizielle OpenAI-Dokumentation und die Preisseite maßgeblich.
| Information | Details |
|---|---|
| Was ist neu | Der Prompt-Cache bietet jetzt eine Aufbewahrungsoption von 12 Stunden |
| Anbieter | OpenAI |
| Betroffene Modelle | GPT-6-API und andere Modelle, die Prompt-Caching unterstützen (maßgeblich ist die offizielle Modellliste) |
| Abrechnungslogik | Input-Tokens, die einen Cache-Treffer erzielen, werden zu einem niedrigeren Stückpreis als reguläre Input-Tokens abgerechnet; der konkrete Rabatt steht auf der offiziellen Preisseite |
| Zentrale Änderung | Die Cache-Aufbewahrung wurde von „Verfall nach Minuten im Leerlauf“ auf bis zu 12 Stunden verlängert |
| Betroffene Szenarien | Lange System-Prompts, Agent-Tool-Definitionen, festes RAG-Wissen, Multi-Turn-Dialoge und ähnliche Fälle |
Wie der Prompt-Cache funktioniert
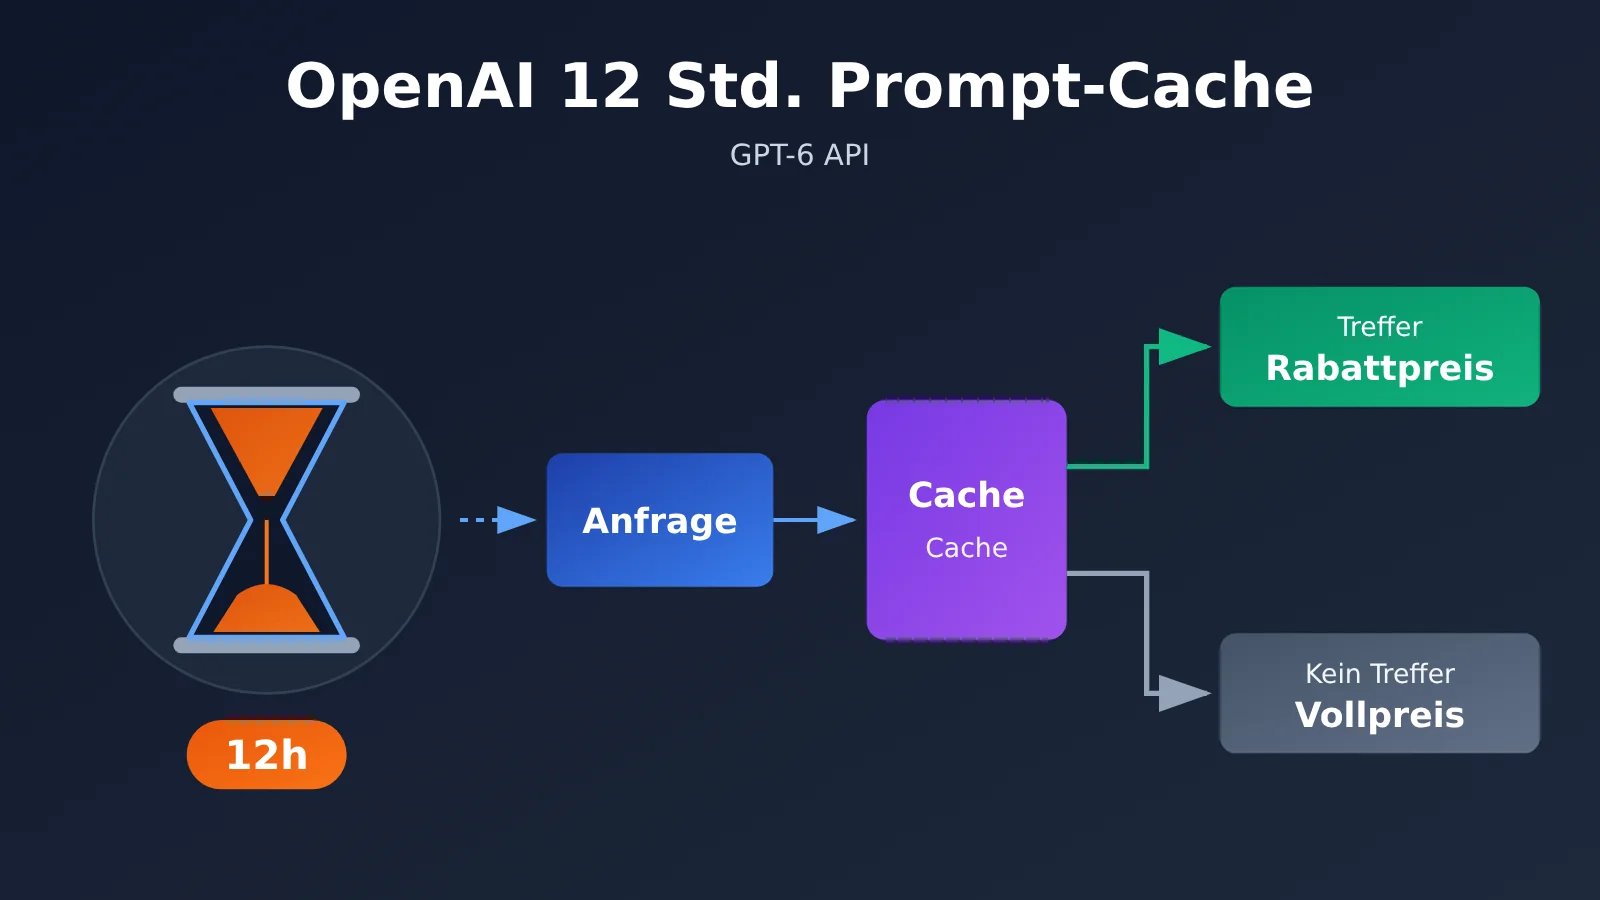
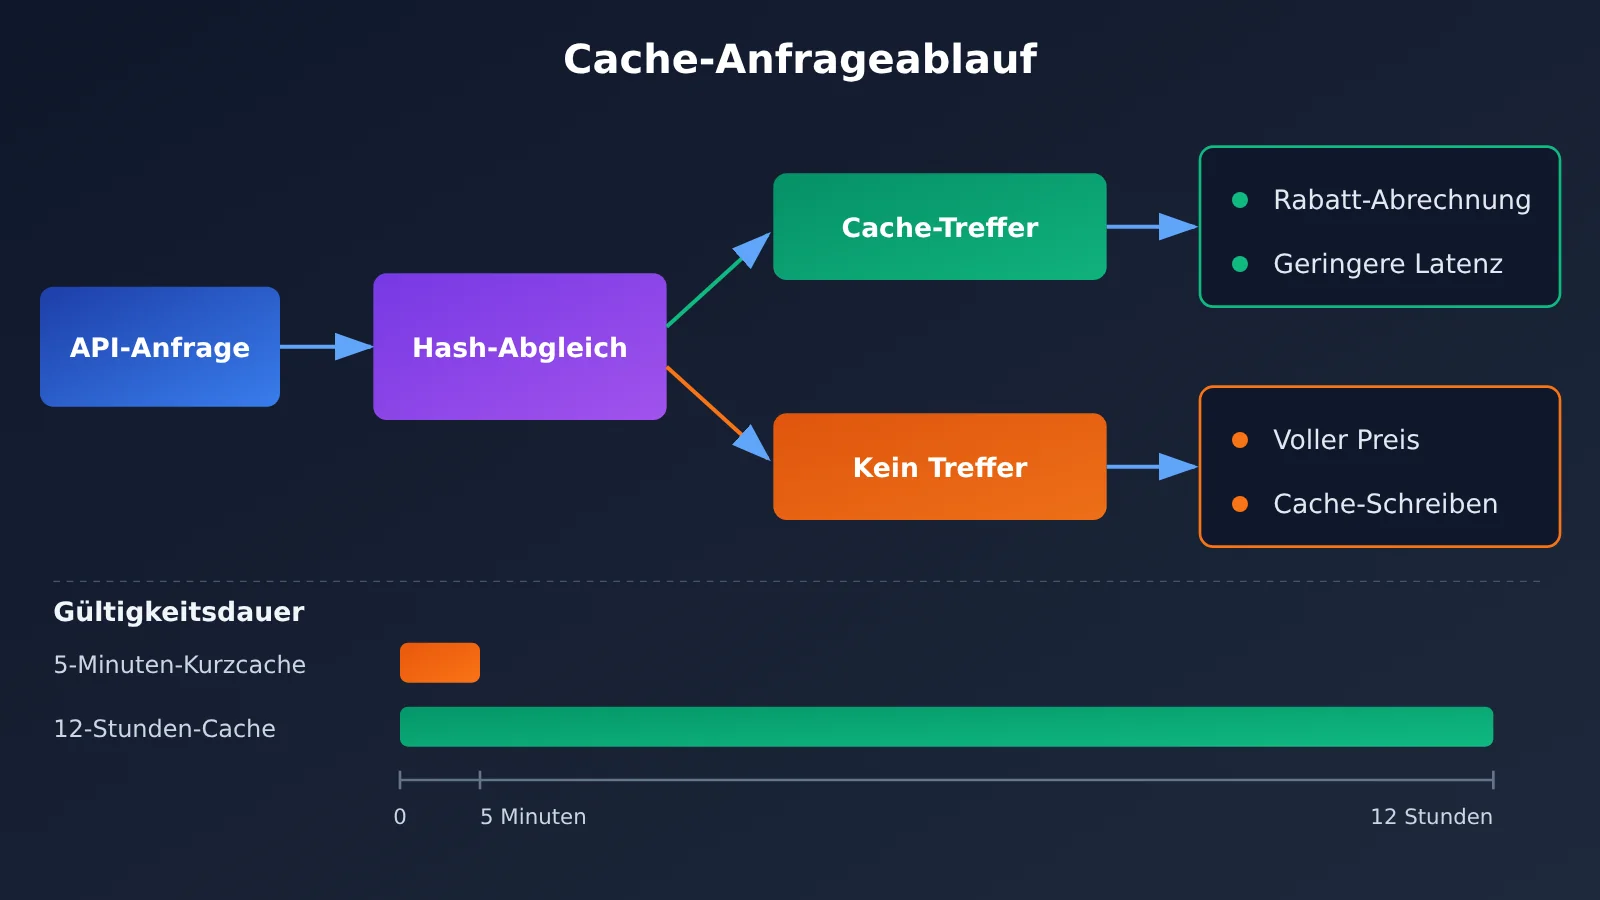
OpenAIs Prompt-Caching basiert auf einem Mechanismus der Präfixübereinstimmung. Wenn der Anfang einer Anfrage (System-Prompt, Tool-Definitionen, feste Dokumente usw.) exakt mit einer früheren Anfrage übereinstimmt und die Länge den offiziell festgelegten Mindestschwellenwert erreicht, werden diese Tokens als Cache-Treffer erkannt, zum rabattierten Preis abgerechnet und die Latenz bis zum ersten Token sinkt deutlich.
Wichtig: Der Cache erkennt nur den Teil, der vom ersten Token an durchgehend identisch ist. Sobald irgendwo im Präfix ein Zeitstempel oder eine Benutzer-ID eingefügt wird, kann der Rest nicht mehr als Treffer erkannt werden. Deshalb ist das Design der Prompt-Struktur wichtiger als die Frage, ob man den Cache überhaupt aktiviert: statische Inhalte nach vorne, dynamische Inhalte ans Ende.
Unterschiede zwischen dem 12-Stunden-Cache und dem kurzen Cache
Der bisherige kurze Cache wurde nach wenigen Minuten Leerlauf gelöscht; nur häufige, aufeinanderfolgende Anfragen konnten zuverlässig Treffer erzielen. Die 12-Stunden-Aufbewahrung erweitert das „Trefferfenster“ von Minuten auf einen halben Tag – und verändert damit direkt die Kostenstruktur in Szenarien mit geringer Anfragefrequenz.
| Vergleichsdimension | Standard-Kurzcache | 12-Stunden-Cache |
|---|---|---|
| Aufbewahrungsdauer | verfällt nach wenigen Minuten Leerlauf | bis zu ca. 12 Stunden |
| Geeignete Anfragerate | hohe Frequenz, aufeinanderfolgende Anfragen | mittlere bis niedrige Frequenz, intermittierende Anfragen |
| Typische profitierende Szenarien | Echtzeit-Kundenservice, kontinuierliche Batch-Aufrufe | Nutzer kehren nach mehreren Stunden zur Sitzung zurück, zeitgesteuerte Aufgaben innerhalb eines Tages |
| Stabilität der Trefferquote | stark von Traffic-Schwankungen abhängig | besser bei Traffic-Tälern |
| Zusätzliche Kosten | normalerweise keine zusätzliche Schreibgebühr | ob eine zusätzliche Gebühr anfällt, gemäß offizieller Angaben |
Wann sich der GPT-6-API-Cache wirklich lohnt: die Break-even-Formel
Viele Artikel sagen nur, dass „Caching Geld spart“, erklären aber nicht, wie viel und unter welchen Bedingungen. Mit einer allgemeinen Formel lässt sich das quantifizieren – Sie müssen nur Ihre eigenen Geschäftsparameter einsetzen.
Herleitung der Break-even-Formel für den Prompt-Cache
Definieren wir die folgenden Variablen:
L: Anzahl der Token im cachefähigen PräfixP: regulärer Preis pro Eingabe-Tokend: Verhältnis des Preises bei einem Cache-Treffer zum regulären Preis (0 < d < 1)w: zusätzlicher Kostenanteil für das erstmalige Schreiben in den Cache (bei keinem Aufpreis gilt w = 0)N: Anzahl der Aufrufe mit demselben Präfix innerhalb der Cache-Gültigkeitsdauer
Ohne Cache betragen die Gesamtkosten für das Präfix N × L × P. Mit Cache wird der erste Aufruf zum Schreibpreis abgerechnet, alle weiteren zum Trefferpreis. Die Gesamtkosten sind dann L × P × (1 + w) + (N − 1) × L × P × d.
Subtrahiert man beides, ergibt sich eine sehr einfache Break-even-Bedingung: N > 1 + w / (1 − d). Die Formel zeigt zwei Dinge: Wenn das Schreiben keinen Aufpreis kostet (w = 0), reicht eine einzige Wiederverwendung desselben Präfix innerhalb der Gültigkeitsdauer, um zu sparen. Fallen Schreibkosten an, muss die Zahl der Wiederverwendungen einen Schwellenwert überschreiten, damit sich das Caching rechnet – und je größer der Rabatt (je kleiner d), desto schneller ist der Break-even erreicht.
Break-even-Berechnungen für verschiedene Szenarien
Die folgende Beispielrechnung mit angenommenen Parametern dient nur der Veranschaulichung der Formel und gibt nicht die tatsächlichen Preise von OpenAI wieder. Wir nehmen an, dass der Cache-Trefferpreis einem bestimmten Anteil des regulären Preises entspricht, und betrachten die Zahl der Aufrufe bis zum Break-even mit und ohne Schreibaufpreis.
| Szenario | Schreibaufpreis w | Trefferrabatt d | Benötigte Aufrufe N bis Break-even | Fazit |
|---|---|---|---|---|
| Kein Schreibaufpreis | 0 | beliebig | N > 1 | Schon bei 1 Wiederverwendung sparen |
| Kleiner Schreibaufpreis | niedrig | großer Rabatt | ca. 2 | In den meisten Szenarien lohnt es sich |
| Hoher Schreibaufpreis | hoch | kleiner Rabatt | 3 oder mehr | Nur bei hoher Wiederverwendung lohnt es sich |
Die Rechnung zeigt: Der eigentliche Wert des 12-Stunden-Caches liegt nicht im „Rabatt selbst“, sondern darin, dass N größer wird. Bei Anfragen, die ohnehin nur alle paar Stunden eintreffen, ist N mit einem kurzen Cache im Grunde gleich 1 – von Ersparnis kann keine Rede sein. Erst mit 12 Stunden Laufzeit wird derselbe Präfix innerhalb eines Tages mehrfach wiederverwendet, und der Spareffekt zeigt sich wirklich.
🚀 Schnellstart: Wenn Sie die Break-even-Formel mit echtem Traffic prüfen möchten, empfehle ich, über APIYI apiyi.com mit demselben API-Schlüssel die Cache-Trefferquoten verschiedener Modelle zu vergleichen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle, und neue Nutzer erhalten ein kostenloses Testguthaben.
So überprüfen Sie Prompt-Cache-Treffer in der GPT-6-API
Ob der Cache wirklich Geld spart, erkennen Sie am zuverlässigsten am Feld usage in der Antwort. Die OpenAI-kompatible Schnittstelle liefert in usage.prompt_tokens_details.cached_tokens die Anzahl der Token, die bei diesem Aufruf aus dem Cache kamen – daraus lässt sich die tatsächliche Trefferquote berechnen.
Minimalbeispiel
Der folgende Code schickt zweimal eine Anfrage mit demselben Präfix und zeigt, ob cached_tokens beim zweiten Mal größer als 0 ist:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI – einheitliche Schnittstelle, OpenAI-kompatibel
)

SYSTEM_PROMPT = "Du bist ein erfahrener technischer Berater … (hier den festen, langen Prompt einsetzen, der über der Mindest-Cache-Schwelle liegt)"

for i in range(2):
    resp = client.chat.completions.create(
        model="gpt-6",  # maßgeblich ist der tatsächliche Name in der Modellliste der Plattform
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"Anfrage {i+1}: Wie lassen sich die API-Kosten senken?"}
        ]
    )
    cached = resp.usage.prompt_tokens_details.cached_tokens
    print(f"Anfrage {i+1}: Token aus dem Cache: {cached}")
Vollständige Implementierung anzeigen (inkl. Trefferquoten-Statistik und Cache-Routing-Key)
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class CacheStats:
    total_prompt: int = 0
    total_cached: int = 0
    records: list = field(default_factory=list)

    def add(self, prompt_tokens: int, cached_tokens: int):
        self.total_prompt += prompt_tokens
        self.total_cached += cached_tokens
        self.records.append((prompt_tokens, cached_tokens))

    @property
    def hit_rate(self) -> float:
        if self.total_prompt == 0:
            return 0.0
        return self.total_cached / self.total_prompt


def build_messages(static_prefix: str, user_input: str) -> list:
    """Statischer Inhalt zuerst, dynamischer zuletzt – so bleibt das Präfix stabil"""
    return [
        {"role": "system", "content": static_prefix},
        {"role": "user", "content": user_input},
    ]


def ask(static_prefix: str, user_input: str, cache_key: str, stats: CacheStats,
        model: str = "gpt-6") -> str:
    resp = client.chat.completions.create(
        model=model,
        messages=build_messages(static_prefix, user_input),
        # prompt_cache_key sorgt dafür, dass Anfragen mit gleichem Präfix im selben Cache landen
        # Für die 12-stündige Aufbewahrung den entsprechenden Parameter laut OpenAI-Doku ergänzen
        extra_body={"prompt_cache_key": cache_key},
    )
    usage = resp.usage
    cached = getattr(usage.prompt_tokens_details, "cached_tokens", 0) or 0
    stats.add(usage.prompt_tokens, cached)
    return resp.choices[0].message.content


if __name__ == "__main__":
    stats = CacheStats()
    prefix = open("system_prompt.txt", encoding="utf-8").read()
    questions = ["Wie entwerfe ich einen cache-freundlichen Prompt?", "Wo gehören Tool-Definitionen hin?", "Wie erfasse ich die Trefferquote?"]

    for q in questions:
        ask(prefix, q, cache_key="kb-v1", stats=stats)

    print(f"Gesamte Cache-Trefferquote: {stats.hit_rate:.1%}")
    for idx, (p, c) in enumerate(stats.records, 1):
        print(f"Anfrage {idx}: prompt={p}, cached={c}")
Empfehlung: Lassen Sie das Ganze zunächst einen Tag mit wenig Traffic laufen und erfassen Sie dabei die Gesamttrefferquote sowie die Verteilung der Anfrageabstände. Erst danach entscheiden Sie, ob der 12-Stunden-Cache in der Produktion flächendeckend aktiviert wird. Über APIYI auf apiyi.com erhalten Sie Testguthaben und können solche Prüfungen direkt durchführen, ohne mehrere offizielle Konten separat eröffnen zu müssen.
5 Kriterien, wann sich der 12-Stunden-Prompt-Cache lohnt
Überträgt man die Break-even-Formel auf die Praxis, lassen sich daraus die folgenden fünf Kriterien ableiten. Je mehr davon erfüllt sind, desto deutlicher ist der Nutzen, wenn Sie den 12-Stunden-Cache aktivieren.
- Das Präfix ist lang genug: Der cachefähige feste Teil muss die offizielle Mindestschwelle erreichen, und je länger er ist, desto größer ist der Rabatt insgesamt. Bei kurzen Prompts mit nur wenigen hundert Tokens ist die Ersparnis selbst bei einem Treffer sehr begrenzt.
- Das Präfix ist stabil genug: System-Prompt, Tool-Definitionen und Schema-Reihenfolge bleiben über den Tag hinweg unverändert. Häufige Änderungen am Prompt machen den Cache immer wieder ungültig.
- Der Abstand zwischen den Anfragen liegt unter 12 Stunden: Wenn dasselbe Präfix alle paar zehn Minuten bis hin zu einigen Stunden aufgerufen wird, liegt genau hier der größte zusätzliche Nutzen des 12-Stunden-Caches gegenüber einem kurzen Cache.
- Die Wiederverwendung liegt über der Break-even-Schwelle: Prüfen Sie mit
N > 1 + w / (1 − d), ob die Wiederverwendungen pro Tag stabil über der Schwelle liegen. - Die Eingabekosten haben einen hohen Anteil: Wenn Ihre Rechnung überwiegend aus Ausgabe-Tokens besteht, optimiert der Cache nur die Eingabeseite, und die Gesamtreduktion fällt entsprechend geringer aus.
Wie gut verschiedene Geschäftsszenarien zum 12-Stunden-Cache passen
| Geschäftsszenario | Merkmal des Anfrageintervalls | Wirkung des kurzen Caches | Zusätzlicher Wert des 12-Stunden-Caches |
|---|---|---|---|
| Echtzeit-Kundenservice-Chatbot | hochfrequent, kontinuierlich | bereits gut | mäßig; gleicht vor allem Lasttäler aus |
| Unternehmens-Wissensdatenbank (RAG) | mittlere Frequenz, fester Dokumentpräfix | schwankt stärker | deutlich; festes Wissen wird tagsüber mehrfach wiederverwendet |
| Coding-Agent-Sitzung | Nutzer kehren zeitweise zur Sitzung zurück | häufig wirkungslos | sehr hoch; langer Kontext wird über Stunden wiederverwendet |
| Zeitgesteuerte Batch-Verarbeitung innerhalb eines Tages | alle paar Stunden ein Batch | praktisch wirkungslos | sehr hoch; dasselbe Template läuft mehrmals täglich |
| Einmalige Analyse eines langen Dokuments | nur ein Aufruf | wirkungslos | kaum; N = 1 erreicht den Break-even nicht |
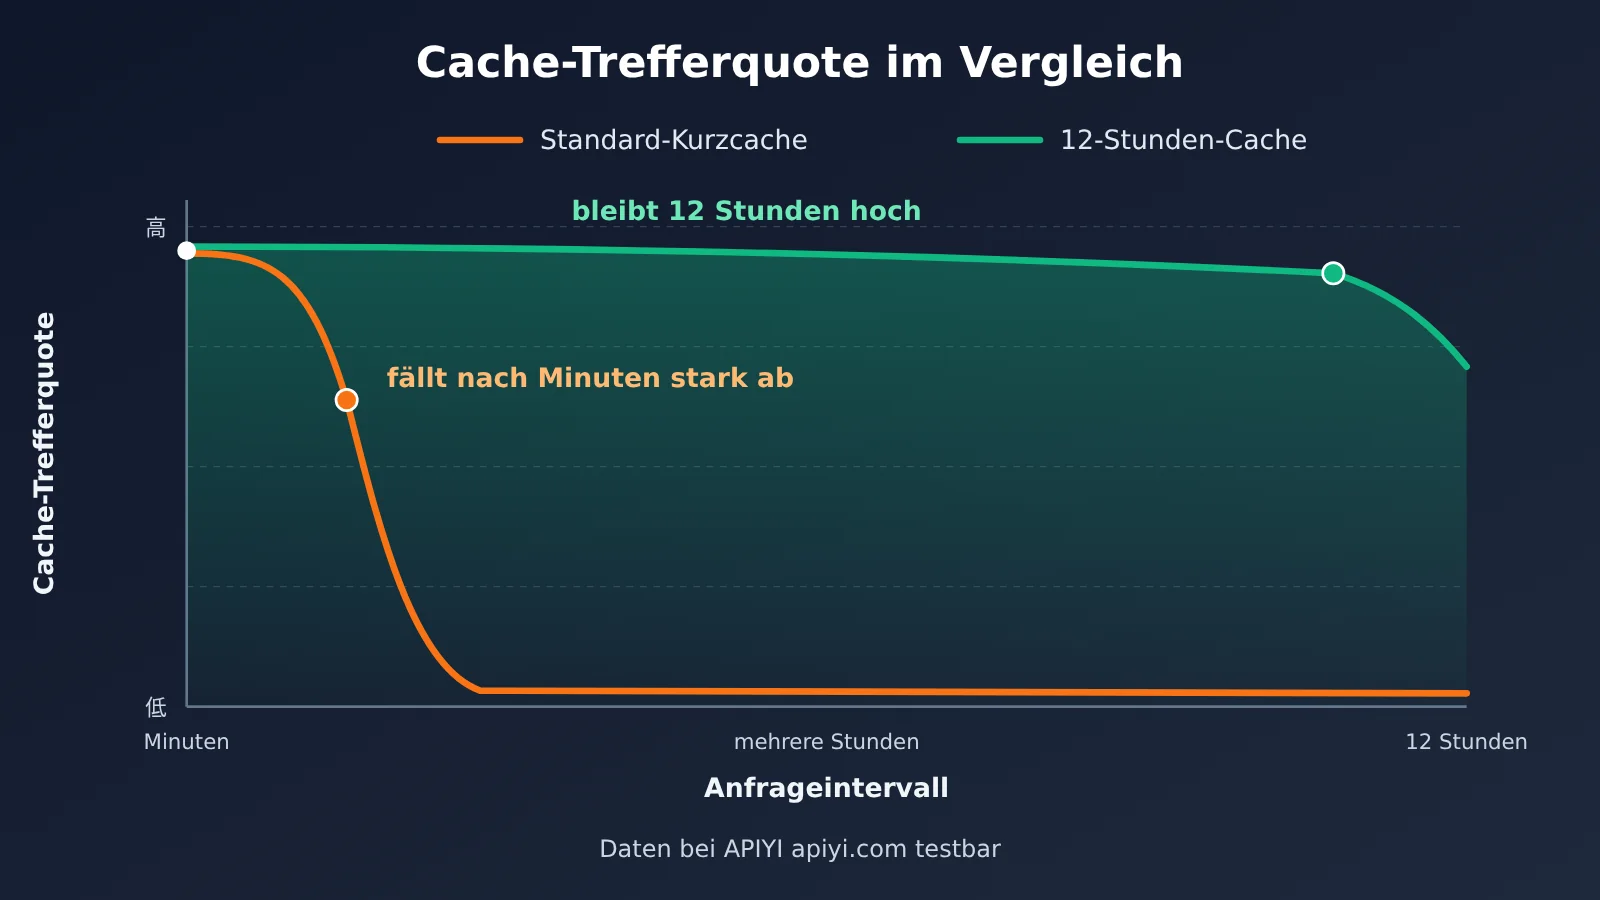
Vergleichshinweis: Die Abbildung zeigt die unterschiedlichen Trends der Trefferquoten beider Cache-Strategien bei verschiedenen Anfrageintervallen. Die tatsächliche Trefferquote hängt von der Stabilität Ihres Präfixes und der Verteilung Ihrer Anfragen ab. Vergleichen Sie am besten Ihre eigenen echten Anfrageprotokolle.
Analyse der Auswirkungen des 12-Stunden-Prompt-Cache von OpenAI
Auswirkungen auf Entwickler
- Aus Prompt-Engineering wird „Cache-Engineering“: System-Prompts, Tool-Definitionen und festes Wissen müssen zu stabilen Präfixblöcken gebündelt und explizit versioniert werden, damit eine kleine Änderung nicht den gesamten Cache ungültig macht.
- Kostenbewertung verschiebt sich vom „Stückpreis“ zum „effektiven Stückpreis“: Beim selben GPT-6 API können sich die tatsächlichen Kosten pro 1.000 Anfragen zwischen Teams mit hoher und niedriger Trefferquote deutlich unterscheiden. Die Überwachung von
cached_tokenssollte zur Standardkennzahl werden. - Agenten mit langem Kontext werden praktikabler: Coding-Assistenten und Research-Agenten arbeiten oft mit sehr langen Kontexten. Früher musste alles zum Vollpreis neu berechnet werden, sobald ein Nutzer kurz weg war – jetzt lässt sich über Stunden hinweg wiederverwenden, was die Wirtschaftlichkeit langer Sitzungen spürbar verbessert.
- Auch die Latenz verbessert sich: Bei einem Cache-Treffer ist die Latenz bis zum ersten Token geringer – für Produkte, bei denen ein flüssiges Interaktionserlebnis zählt, ein zusätzlicher Gewinn.
Auswirkungen auf die Branche
- Caching wird zur Wettbewerbsdimension im Model-Pricing: Alle großen Anbieter haben eigene Prompt-Caching-Lösungen. Aufbewahrungsdauer, Rabatthöhe und die Frage, ob Schreibgebühren anfallen, werden für Entwickler bei der Auswahl immer wichtiger.
- Aggregatoren gewinnen beim Modellvergleich an Wert: Weil sich die Cache-Regeln der Anbieter stark unterscheiden, sagt ein Vergleich der tatsächlichen Rechnungen über eine einheitliche Schnittstelle mehr aus als ein Blick auf die offiziellen Listenpreise.
- RAG-Architekturen werden womöglich neu bewertet: Wenn sich lange Dokument-Präfixe einen halben Tag lang kostengünstig wiederverwenden lassen, könnten kleinere und mittlere Knowledge-Base-Szenarien vom „Retrieval in Chunks“ zu „ganzes Dokument in den Kontext + Cache“ wechseln.
Auswahlhilfe für Caching-Lösungen verschiedener Modelle
| Modellrichtung | Cache-Merkmale (maßgeblich ist die offizielle Dokumentation des jeweiligen Anbieters) | Geeignete Szenarien | Verfügbare Plattformen |
|---|---|---|---|
| GPT-6 API | Automatischer Präfix-Cache, neu mit Option auf 12 Stunden Aufbewahrung | Lange System-Prompts, Agent-Sitzungen | APIYI apiyi.com, OpenAI offiziell |
| Claude-Serie | Cache-Breakpoints müssen explizit markiert werden, verschiedene Aufbewahrungsdauern möglich | Szenarien mit feiner Kontrolle über die Cache-Position | APIYI, Anthropic offiziell |
| Gemini-Serie | Unterstützt implizites und explizites Context-Caching | Sehr lange Dokumente, multimodale Kontexte | APIYI, Google offiziell |
💡 Auswahlempfehlung: Die Cache-Regeln der einzelnen Modelle unterscheiden sich stark. Testen Sie denselben Business-Prompt auf mehreren Modellen und vergleichen Sie Trefferquote und Rechnung – und entscheiden Sie dann auch mit Blick auf die Ergebnisqualität.
Häufige Fragen (FAQ)
F1: Was ist der OpenAI 12-Stunden-Prompt-Cache?
Es ist die Option mit verlängerter Aufbewahrungsdauer im Prompt-Caching-Mechanismus von OpenAI. Anfragen mit demselben Präfix haben bis zu etwa 12 Stunden lang die Chance, den Cache zu treffen. Die gecachten Input-Token werden zum rabattierten Preis abgerechnet, außerdem sinkt die Latenz bis zum ersten Token.
F2: Worin unterscheidet sich der 12-Stunden-Cache vom standardmäßigen Kurzzeit-Cache?
Der standardmäßige Kurzzeit-Cache verfällt bereits nach wenigen Minuten Leerlauf und eignet sich nur für hochfrequente, aufeinanderfolgende Anfragen. Der 12-Stunden-Cache deckt dagegen auch niederfrequente, intermittierende Anfragen ab. Bei Szenarien wie Echtzeit-Kundenservice mit hoher Frequenz macht das kaum einen Unterschied; bei Agent-Sitzungen oder geplanten Batch-Verarbeitungen mit Abständen von mehreren Stunden ist der zusätzliche Nutzen des 12-Stunden-Caches deutlich spürbar.
F3: Spare ich durch den 12-Stunden-Cache garantiert Kosten?
Nicht unbedingt. Fallen für das Schreiben in den Cache keine Zusatzgebühren an, beginnt die Ersparnis bereits, sobald dasselbe Präfix innerhalb der Gültigkeitsdauer einmal wiederverwendet wird. Gibt es Zusatzgebühren, müssen Sie das Präfix öfter als `1 + w / (1 − d)` Mal wiederverwenden, um die Kosten wieder hereinzuholen. Bei einmaligen Aufrufen, häufig wechselnden Präfixen und sehr kurzen Präfixen ist der Nutzen sehr begrenzt.
F4: Wie erhöhe ich die Cache-Trefferquote bei der GPT-6-API?
Das Kernprinzip lautet „Statisches nach vorne, Dynamisches nach hinten“:
– System-Prompt, Tool-Definitionen und feste Dokumente ganz an den Anfang der Nachrichten stellen und die Reihenfolge unverändert lassen
– Dynamische Inhalte wie Zeitstempel, User-IDs und Suchergebnisse ans Ende setzen
– Für dieselbe Art von Anfrage einen festen Cache-Routing-Key verwenden, um die Wahrscheinlichkeit zu erhöhen, dass sie auf denselben Cache geroutet wird
– Prompt-Überarbeitungen gebündelt veröffentlichen und häufige kleine Änderungen innerhalb eines Tages vermeiden
F5: Wie teste ich die Wirkung des 12-Stunden-Caches schnell über die API?
Empfohlen ist der Test über eine API-Aggregationsplattform, die mehrere Modelle unterstützt:
1. Besuchen Sie APIYI apiyi.com und registrieren Sie ein Konto
2. Holen Sie sich einen API-Schlüssel und ein kostenloses Testkontingent
3. Nutzen Sie das Codebeispiel aus diesem Artikel (ersetzen Sie base_url durch `https://api.apiyi.com/v1`) und lesen Sie `cached_tokens` aus, um die Trefferquote zu ermitteln
APIYI verwendet eine OpenAI-kompatible Schnittstelle – mit einem einzigen Schlüssel lassen sich die Cache-Eigenschaften von GPT, Claude und Gemini vergleichen.
F6: Welche bekannten Einschränkungen hat der Prompt-Cache?
Der Cache greift nur bei zusammenhängenden Präfixen, die einen Mindestlängen-Schwellenwert erreichen, und optimiert ausschließlich die Kosten auf der Input-Seite – Output-Token erhalten keinen Rabatt. Caching ist ein „Best-Effort“-Mechanismus: Bei hoher Parallelität oder Änderungen im Traffic-Routing können Fehltreffer auftreten, die Trefferquote sollte also nicht als 100-prozentige Garantie verstanden werden. Die konkrete Abrechnung der 12-Stunden-Aufbewahrung und die unterstützten Modelle entnehmen Sie bitte der offiziellen OpenAI-Dokumentation.
12-Stunden-Prompt-Cache: Kernpunkte und Key Takeaways
- Funktionsweise: Basiert auf exakter Präfixübereinstimmung; die übereinstimmenden Eingabe-Token werden zum rabattierten Preis abgerechnet.
- Wesentliche Änderung: Die Aufbewahrungsdauer wurde von Minuten auf etwa 12 Stunden verlängert und deckt damit auch niederfrequente Anfragen ab.
- Amortisationsformel: Erst wenn die Wiederverwendungshäufigkeit N > 1 + w / (1 − d) erfüllt ist, beginnt man zu sparen.
- Szenarien mit dem größten Nutzen: Lange Agenten-Sitzungen, RAG mit Wissensdatenbank, zeitgesteuerte Batch-Verarbeitung innerhalb eines Tages.
- Szenarien mit begrenztem Nutzen: Einmalige Aufrufe, kurze Präfixe, häufig geänderte Eingabeaufforderungen.
- Entscheidend für die Umsetzung: Statische Inhalte an den Anfang stellen und die Trefferquote laufend mit cached_tokens überwachen.
- Validierung: Über APIYI apiyi.com mit echtem Traffic zunächst im kleinen Maßstab testen und erst danach vollständig aktivieren.
Zusammenfassung
Die zentralen Auswirkungen des 12-Stunden-Prompt-Cache von OpenAI auf die Kosten der GPT-6-API:
- Der Schlüssel zum Sparen ist die Wiederverwendungshäufigkeit: Das 12-Stunden-Fenster ermöglicht es auch mittel- und niederfrequenten Anfragen, dasselbe Präfix mehrmals zu verwenden. Erst wenn N von 1 nach oben steigt, entsteht der eigentliche Mehrwert.
- Die Schreibkosten bestimmen die Amortisationsschwelle: Ohne zusätzliche Schreibgebühr rechnet es sich fast immer; mit Gebühr muss man die Amortisationsformel heranziehen.
- Die Prompt-Struktur ist wichtiger als der Schalter: Statische Inhalte an den Anfang, Versionsverwaltung und Überwachung der Trefferquote – nur so kommt der Cache-Rabatt tatsächlich auf der Rechnung an.
Empfohlen ist, mit ertragreichen Szenarien wie langen System-Eingabeaufforderungen und Agenten-Sitzungen zu beginnen, einen Tag lang echten Traffic laufen zu lassen, um die Trefferquote zu prüfen, und erst dann über den Umfang der breiten Einführung zu entscheiden. Für einen schnellen Vergleich der Cache-Effekte mehrerer Modelle empfiehlt sich APIYI apiyi.com; die Plattform bietet kostenloses Testguthaben und eine einheitliche OpenAI-kompatible Schnittstelle.
📚 Referenzen
- Offizieller Leitfaden zu OpenAI Prompt Caching: Cache-Mechanismus, Mindestschwelle und Erläuterung des
usage-Felds - Link:
platform.openai.com/docs/guides/prompt-caching -
Beschreibung: Autoritative Quelle zu den Regeln für Cache-Hits und den neuesten Parametern zur Aufbewahrungsdauer
-
OpenAI API-Preisseite: Preise pro Einheit für reguläre Eingaben, gecachte Eingaben und Ausgaben je Modell
- Link:
openai.com/api/pricing -
Beschreibung: Wenn Sie die Break-even-Formel anwenden, sind die aktuellen Preise auf dieser Seite maßgeblich
-
OpenAI API Reference: Parameterbeschreibung für die Chat-Completions- und Responses-Schnittstellen
- Link:
platform.openai.com/docs/api-reference - Beschreibung: Konkrete Verwendung cachebezogener Parameter wie
prompt_cache_keynachschlagen
Autor: APIYI-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI, um weitere Lösungen zur Modellanbindung und Kostenoptimierung zu erhalten