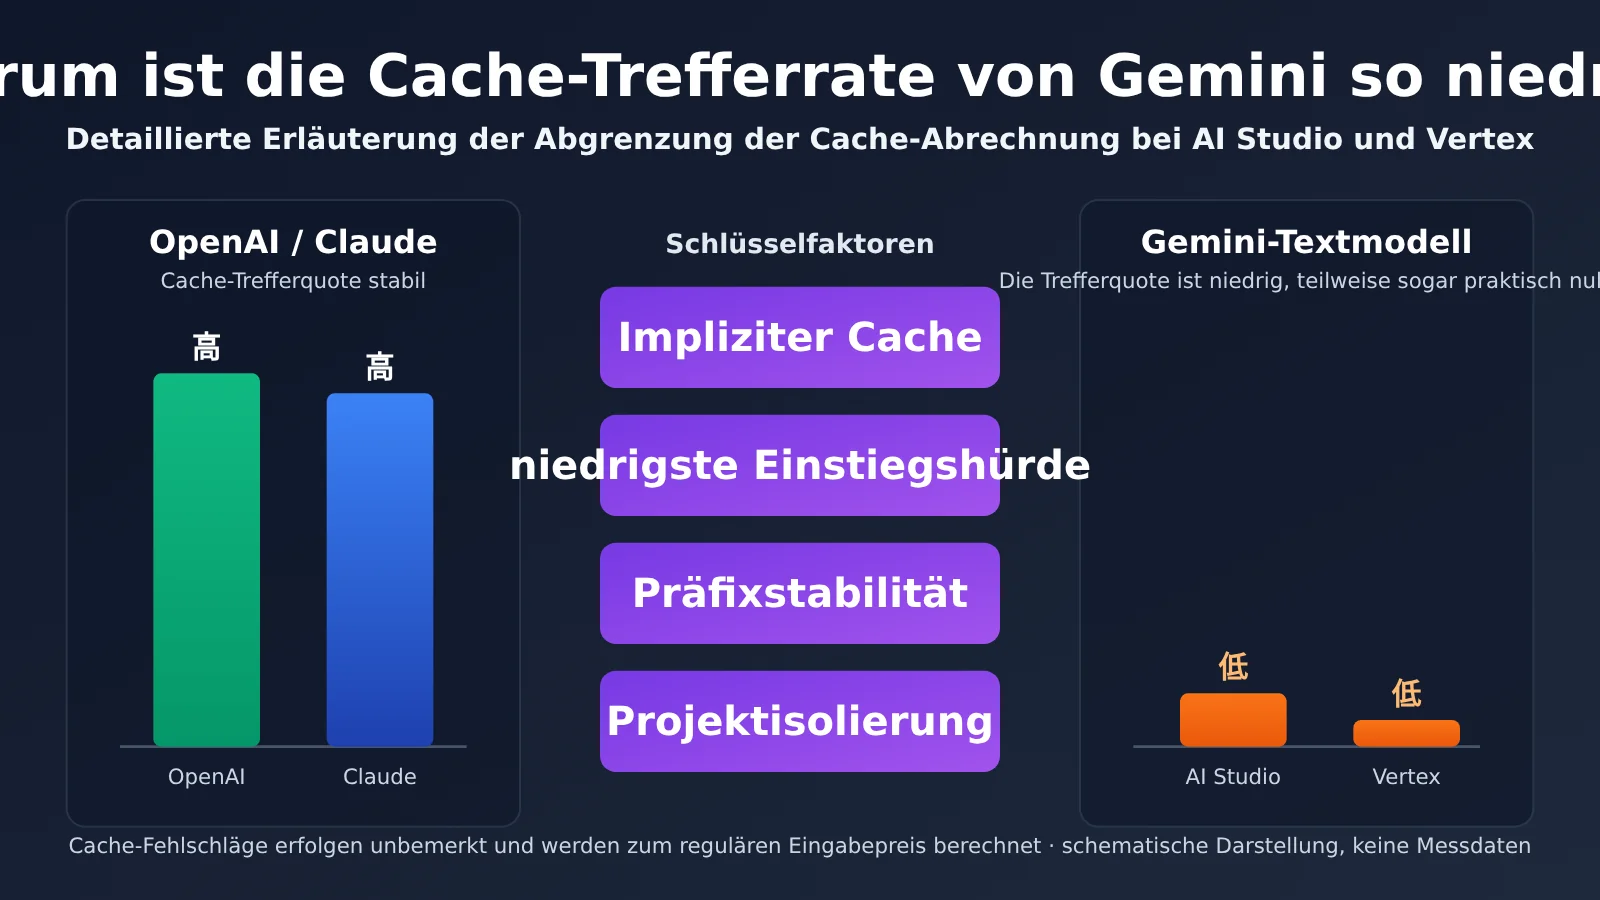
Bei der praktischen Nutzung von APIYI funktionieren Cache-Schreibvorgänge und Cache-Treffer bei OpenAI und den Claude-Modellen zuverlässig; auch die Trefferquote ist hoch. Bei den Gemini-Textmodellen sieht es anders aus: Die Cache-Trefferquote ist niedrig, teilweise gibt es praktisch gar keine Treffer. Das lässt sich in den Rechnungen und Nutzungsdetails nachvollziehen und sorgt bei vielen Entwicklern beim Abgleich der Abrechnung für Verwirrung.
Dieser Artikel basiert auf der offiziellen Google-Dokumentation mit Stand vom 20. Oktober 2026. Er schlüsselt die 5 Ursachen für eine niedrige Gemini-Cache-Trefferquote auf und erklärt, wie die Cache-Abrechnung in AI Studio (Gemini Developer API) und Vertex AI geregelt ist.
Dies ist keine Analyse, bei der die Verantwortung einfach weitergereicht wird. Google hat keine offizielle Regel, nach der die Nutzung eines API-Proxy-Dienstes die Gemini-Cache-Trefferquote senkt. Ohne Zugriff auf die Anfrageprotokolle des Upstream-Anbieters können auch wir nicht behaupten, dass eine bestimmte Ursache im Einzelfall tatsächlich vorliegt. Stattdessen erklären wir zunächst die offiziellen Regeln, zeigen dann, unter welchen Bedingungen sie nicht greifen, und stellen schließlich eine Prüfmethode vor, mit der Sie die Nutzung und Abrechnung selbst überprüfen können.
Der zentrale Nutzen: Nach der Lektüre wissen Sie, wann Gemini einen Cache-Treffer erzielt und wann nicht. Außerdem kennen Sie den Abrechnungsgrundsatz, dass die Gesamteingabe auch den gecachten Anteil umfasst, und können die Rechnung anhand der offiziellen Antwortfelder selbst prüfen.
Die wichtigsten Punkte zur Gemini-Cache-Trefferquote
Das Wichtigste vorweg: Um das Caching bei Gemini zu verstehen, muss man zwischen implizitem und explizitem Caching unterscheiden. Beide Mechanismen funktionieren unterschiedlich und werden auch unterschiedlich abgerechnet.
| Typ | Verwendung | Wie Sie von günstigeren Cache-Preisen profitieren | Speichergebühr |
|---|---|---|---|
| Implizites Caching (Implicit caching) | Bei unterstützten Modellen automatisch aktiviert; es muss kein Cache-Objekt erstellt werden | Nur tatsächlich getroffene Anfragen werden für den gecachten Anteil zum Cache-Preis abgerechnet. Ein Treffer ist nicht garantiert. | Nein |
| Explizites Caching (Explicit caching) | Cache-Objekt wird gezielt erstellt und in späteren Anfragen referenziert | Für gecachte Eingaben, auf die gültig verwiesen wird, gilt der Cache-Preis. | Ja |
In der offiziellen Dokumentation zur impliziten Zwischenspeicherung der Developer API findet sich ein wichtiger Hinweis: Sie garantiert keine Kosteneinsparungen. Explizites Caching ist zwar zuverlässiger, erfordert aber zusätzlichen Entwicklungsaufwand. Dazu gehören das Erstellen von Cache-Objekten, die Verwaltung ihrer Gültigkeitsdauer und die Referenzierung in späteren Anfragen.
Warum sich Gemini anders verhält als OpenAI und Claude
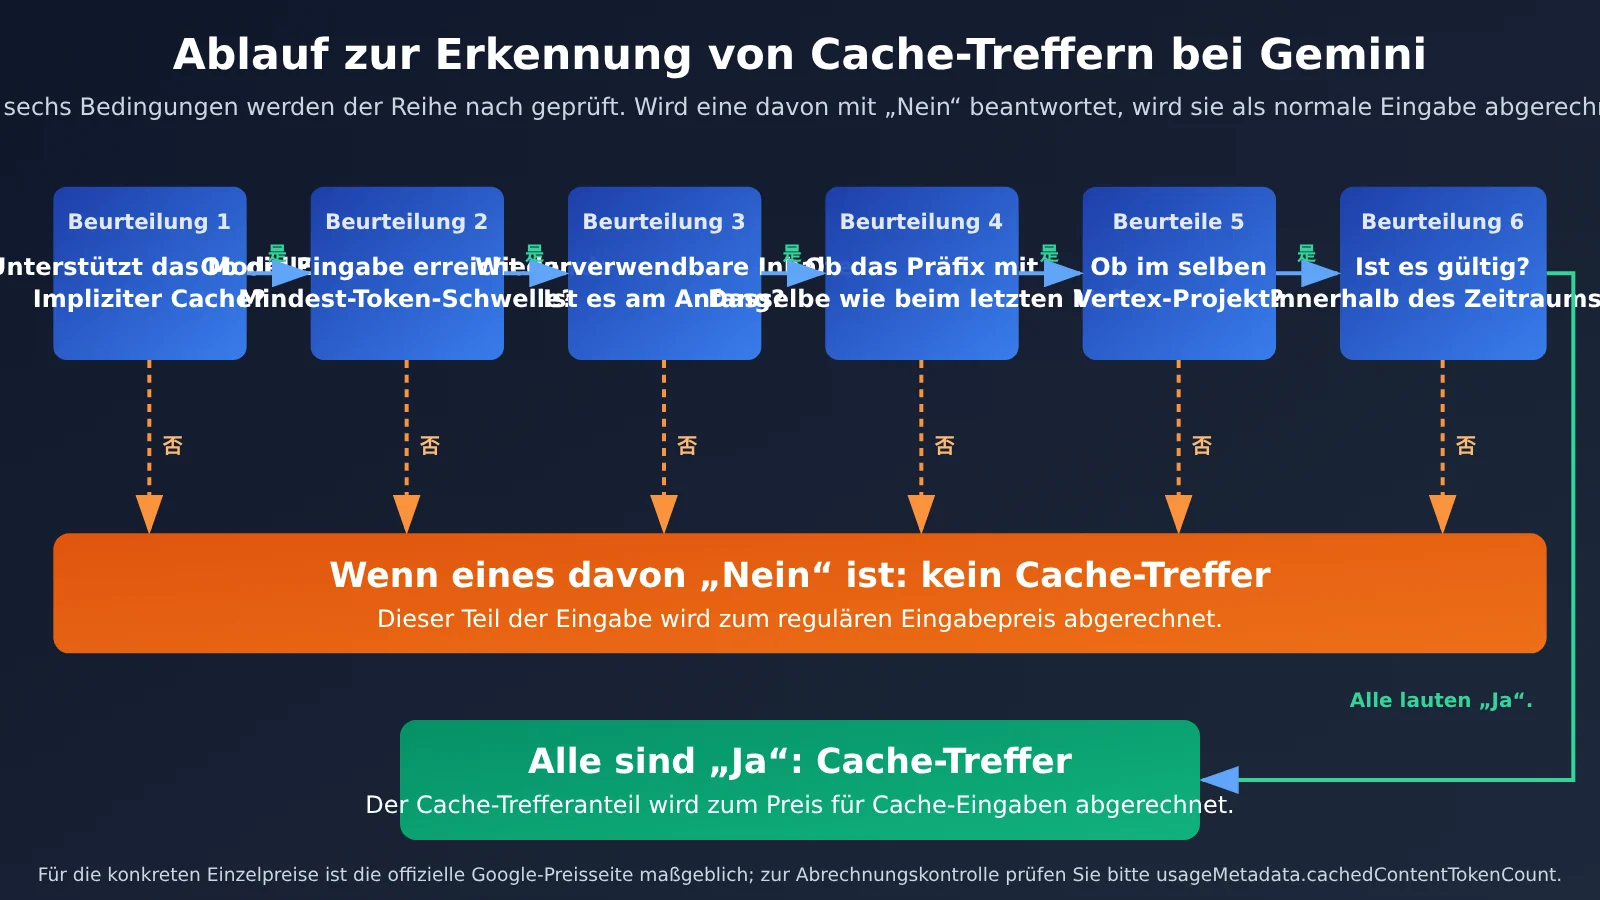
Aus Sicht der Nutzer zeigen OpenAI und die Claude-Modelle auf APIYI ein typisches Muster: „Wenn ich dasselbe lange Präfix sende, sehe ich zuverlässig Cache-Schreibvorgänge und Treffer.“ Bei Gemini müssen dagegen mehrere Bedingungen gleichzeitig erfüllt sein: Das Modell muss implizites Caching unterstützen, die Anfrage muss die modellabhängige Mindestzahl an Tokens erreichen, wiederverwendbare Inhalte müssen am Anfang der Eingabe stehen, ähnliche Anfragen müssen innerhalb eines kurzen Zeitraums eingehen, und bei Vertex müssen sie außerdem zum selben Google-Cloud-Projekt gehören.
Ist auch nur eine dieser Bedingungen nicht erfüllt, wird die Anfrage zum regulären Eingabepreis abgerechnet. Es gibt weder einen Fehler noch einen Hinweis. Deshalb bleibt eine niedrige Trefferquote oft unbemerkt: Cache-Fehler treten still im Hintergrund auf.
Zunächst eine Begriffsdefinition: Was ist mit AI Studio gemeint?
In diesem Artikel bezeichnet „AI-Studio-Kanal“ die Gemini Developer API – also den Zugriffsweg über einen mit AI Studio erstellten API-Schlüssel. Sie wird mit Vertex AI auf Google Cloud verglichen. Die Caching-Mechanismen funktionieren im Prinzip ähnlich, unterscheiden sich aber bei den Mindestschwellen, dem Umfang der Isolierung und den Speichergebühren. Darauf gehen wir im Folgenden im Einzelnen ein.
5 Gründe für eine niedrige Gemini-Cache-Trefferrate
Die folgende Analyse hat zwei Ebenen: Die ersten beiden Punkte beruhen auf Regeln, die in der offiziellen Dokumentation ausdrücklich genannt werden. Die übrigen drei erklären unter bestimmten Bedingungen, wie diese Regeln durch Proxy-Dienste oder in der technischen Praxis verletzt werden können. Allein aus der Tatsache, dass ein Proxy verwendet wird, lässt sich nicht ableiten, welcher Grund zutrifft. Dafür benötigen wir Informationen zum Upstream-Projekt und zu den Anfragen.
Grund 1: Die Anfrage erreicht nicht die Mindestanzahl an Cache-Tokens
Für implizites Caching gibt es eine Mindestanzahl an Tokens. Anfragen mit zu wenig Inhalt werden nicht zwischengespeichert. Außerdem unterscheiden sich die Mindestwerte je nach Plattform. Die folgende Tabelle zeigt einige Werte aus der aktuellen Dokumentation:
| Modell | Mindestwert für implizites Caching in der Developer API | Mindestwert für implizites Caching in Vertex |
|---|---|---|
| Gemini 3.8 Flash | 4.096 | 6.144 |
| Gemini 3.1 Pro Preview | 4.096 | 6.144 |
| Gemini 2.5 Pro (Vorgängergeneration, zum Vergleich) | 2.048 | 2.048 |
Dabei gibt es zwei leicht zu übersehende Fallstricke. Erstens liegt der Mindestwert bei neueren Modellen wie Gemini 3.8 Flash höher als bei der 2.5-Serie. Wer mit dem früheren Wert von 2.048 rechnet, kommt daher möglicherweise zu einem falschen Ergebnis. Zweitens kann der Mindestwert für dasselbe Modell in Vertex höher sein: Eine Anfrage mit 5.000 Tokens reicht in der Developer API aus, in Vertex aber nicht.
Anfragen für alltägliche Gespräche umfassen meist nur einige Hundert bis ein paar Tausend Tokens und liegen damit von vornherein unter dem Mindestwert. Das ist einer der direktesten Gründe für die niedrige Trefferrate von Gemini in Chats. Wichtig ist: Das Erreichen des Mindestwerts ist nur eine notwendige Voraussetzung und garantiert keinen Cache-Treffer.
Grund 2: Wiederverwendbare Inhalte stehen nicht am Anfang der Eingabeaufforderung
Google empfiehlt für beide Plattformen dasselbe: Längere, wiederholt verwendete Inhalte sollten am Anfang der Eingabeaufforderung stehen. Außerdem sollten ähnliche Anfragen mit gleichem Präfix in kurzen Abständen gesendet werden. Caching basiert auf einem gemeinsamen Präfix – nicht darauf, dass „dieselbe Datei in der Anfrage enthalten ist“.
Anders gesagt: Dass zwei Anfragen dasselbe Dokument enthalten, reicht für einen Cache-Treffer nicht aus. Entscheidend ist auch, wo das Dokument in der Anfrage steht und ob der davorliegende Inhalt unverändert bleibt. Die folgende Schreibweise kann das gemeinsame Präfix leicht zerstören:
# 反例:变化内容放在最前面
[当前时间:2026-10-20 10:31:07]
[请求 ID:a8f3...]
{system 指令}
{长文档}
{用户问题}
Schon ein einziges abweichendes Zeichen am Anfang verhindert, dass das nachfolgende lange Dokument ein gemeinsames Präfix mit der vorherigen Anfrage bildet. Diese Schlussfolgerung ergibt sich aus den offiziellen Empfehlungen, ist in der technischen Praxis aber sehr häufig relevant.
Grund 3: Die Proxy-Schicht verändert das Präfix (bedingt)
Fügt die Proxy-Schicht am Anfang der Eingabeaufforderung einen variablen Zeitstempel, eine Kennung oder ein Tracking-Feld ein oder ordnet sie den mehrstufigen Kontext um, kürzt oder komprimiert ihn, verändert sich das gemeinsame Präfix und die Wahrscheinlichkeit eines Cache-Treffers sinkt. Diese Erklärung gilt nur unter bestimmten Bedingungen; daraus lässt sich nicht direkt ableiten, dass ein bestimmter Dienst solche Änderungen vornimmt.
Bei der Fehlersuche sollten zwei Ebenen getrennt betrachtet werden: Bleibt das Präfix der Anfrage stabil, die du an den Proxy sendest? Und bleibt auch das Präfix der Anfrage stabil, die der Proxy an Google weiterleitet? Ersteres kannst du selbst kontrollieren. Für Letzteres benötigst du die Upstream-Anfrageprotokolle.
Grund 4: Anfragen werden auf verschiedene Vertex-Projekte verteilt (bedingt)
Vertex legt ausdrücklich fest: Caches sind nach Google-Cloud-Projekt getrennt und werden nicht projektübergreifend gemeinsam genutzt. Werden mehrere Anfragen derselben Sitzung abwechselnd an verschiedene Vertex-Projekte geleitet, kann Projekt B den in Projekt A angelegten Cache nicht verwenden.
Dabei ist Vorsicht geboten: Ob ein „Schlüsselwechsel“ den Cache unbrauchbar macht, hängt davon ab, ob gleichzeitig auch das Projekt gewechselt wird. Es lässt sich nicht pauschal sagen, dass jeder Schlüsselwechsel den Cache verwirft. Zunächst muss geklärt werden, welchem Projekt die jeweiligen Schlüssel zugeordnet sind.
Grund 5: Es werden nur Generierungsanfragen weitergeleitet, aber kein expliziter Cache verwendet
Wenn die Aufrufkette lediglich generateContent-Anfragen weiterleitet, ohne ein Cache-Objekt anzulegen und in späteren Anfragen darauf zu verweisen, ist sie vollständig auf implizites Caching angewiesen. Für implizites Caching gibt es keine Erfolgsgarantie. Deshalb bietet es nicht denselben verlässlichen Nutzen wie ein expliziter Cache, bei dem ein Cache einmal angelegt und anschließend wiederholt referenziert wird.
Die folgende Tabelle ordnet typische Proxy-Szenarien den offiziellen Regeln zu:
| Tatsächliches Verhalten | Mögliche Auswirkung | Zugehörige offizielle Regel |
|---|---|---|
| Anfragen derselben Sitzung werden abwechselnd an verschiedene Vertex-Projekte geleitet | Ein Cache aus einem anderen Projekt kann nicht wiederverwendet werden | Caches sind nach Projekt getrennt |
| Am Anfang werden variable Zeitstempel oder Kennungen eingefügt oder der Kontext wird umgeordnet | Das gemeinsame Präfix wird verändert, die Trefferwahrscheinlichkeit sinkt | Lange Inhalte an den Anfang stellen, ähnliche Präfixe verwenden |
| Die Anfrage ist kurz, der feste, wiederverwendbare Inhalt reicht nicht aus | Der Mindestwert für den Cache wird nicht erreicht | Mindestanzahl an Tokens |
| Es werden nur Generierungsanfragen weitergeleitet, ohne ein explizites Cache-Objekt anzulegen und darauf zu verweisen | Die Anfrage ist auf implizites Caching ohne Erfolgsgarantie angewiesen | Für explizites Caching muss ein Objekt angelegt und referenziert werden |
🎯 Technischer Tipp: Wenn du Probleme mit dem Gemini-Cache untersuchst, sende zunächst über APIYI (apiyi.com) mehrmals hintereinander Anfragen mit demselben festen, langen Präfix und vergleiche die in den Antworten zurückgegebenen Cache-Token-Felder. Mit kontrollierten Anfragen kannst du zuerst Probleme mit dem Präfix und dem Mindestwert ausschließen und anschließend prüfen, ob die Ursache in der Übertragungskette liegt.
Ohne Angaben zum Upstream-Projekt und zu den Anfragen lässt sich die Ursache nicht allein daraus ableiten, dass ein Proxy verwendet wird. Es gibt auch keine offizielle Grundlage für die Annahme, dass die Trefferrate in Vertex grundsätzlich höher ist als in der Developer API.
Wie die Cache-Abrechnung bei AI Studio und Vertex geregelt ist
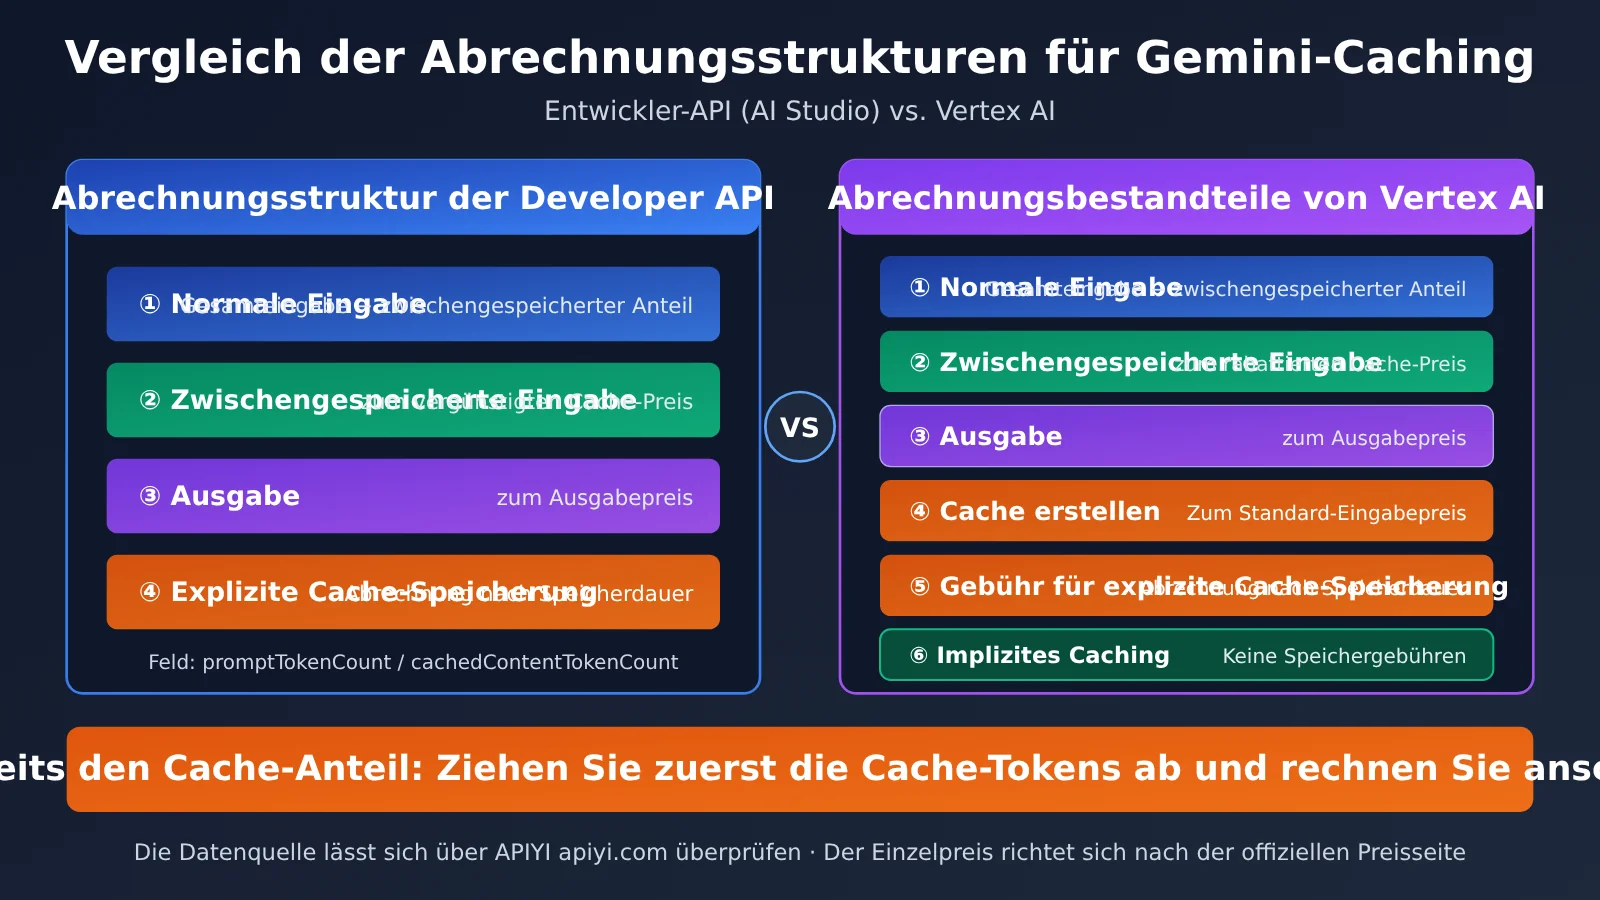
Viele verstehen unter einem „Cache-Treffer“, dass die Anfrage kostenlos ist oder pauschal rabattiert wird. Das stimmt nicht. Bei beiden Angeboten müssen vier Kostenarten unterschieden werden: normale Eingabe, Cache-Eingabe, Ausgabe und Speichergebühren für explizite Caches.
Abrechnungsregeln im Vergleich
| Abrechnungsposten | Developer API (AI Studio) | Vertex AI |
|---|---|---|
| Normale Eingabe (nicht gecachter Anteil) | Zum regulären Eingabepreis | Zum regulären Eingabepreis |
| Cache-Eingabe (Treffer) | Zum Cache-Eingabepreis, der auf der Preisseite separat aufgeführt ist | Zum Cache-Eingabepreis, der auf der Preisseite separat aufgeführt ist |
| Ausgabe | Wird separat berechnet | Wird separat berechnet |
| Eingabe zum Erstellen eines Caches | Wird als Cache-Token-Nutzung berechnet | Wird zum Standard-Eingabepreis berechnet |
| Speichergebühr für implizite Caches | Keine | Keine |
| Speichergebühr für explizite Caches | Abhängig von der Speicherdauer | Fällt an |
In der Dokumentation zur Developer API werden Cache-Token-Nutzung, Speicherdauer, nicht gecachte Eingaben und Ausgaben als Abrechnungsfaktoren aufgeführt. Vertex stellt außerdem zwei Punkte klar: Die Eingabe zum Erstellen eines Caches wird zum Standard-Eingabepreis berechnet. Für implizite Caches fallen keine Speichergebühren an, für explizite dagegen schon. Die aktuellen Preise finden Sie auf den offiziellen Preisseiten der beiden Angebote. Sie variieren je nach Modell und Version.
Formel zur Berechnung der Eingabekosten
Bei gewöhnlichen Textgenerierungsanfragen lässt sich die Berechnung der Eingabekosten so darstellen:
Eingabekosten =
(Gesamtzahl der Eingabe-Tokens − Cache-Treffer-Tokens) × regulärer Eingabepreis
+ Cache-Treffer-Tokens × Cache-Eingabepreis
Die Ausgabekosten werden separat berechnet. Bei expliziten Caches kommen zusätzlich Speichergebühren hinzu. Ein hypothetisches Beispiel: Eine Anfrage umfasst insgesamt 10.000 Eingabe-Tokens, davon sind 8.000 Cache-Treffer. Dann werden 2.000 Tokens zum regulären Preis und 8.000 Tokens zum Cache-Preis berechnet.
Ein häufiger Rechenfehler: Die Gesamteingabe enthält bereits den Cache-Anteil
Prüfen Sie beim Abgleich die ursprüngliche Antwort von Google und verlassen Sie sich nicht nur auf die im Proxy-Backend angezeigte „Cache-Trefferrate“. In usageMetadata der generateContent-Antwort sind zwei Felder wichtig:
| Feld | Bedeutung | Hinweis zum Abgleich |
|---|---|---|
usageMetadata.promptTokenCount |
Gesamtzahl der Eingabe-Tokens | Enthält den Cache-Anteil |
usageMetadata.cachedContentTokenCount |
Tokens im Cache-Anteil | Anzahl der Cache-Treffer |
Berechnen Sie also nicht zuerst den gesamten Wert von promptTokenCount zum regulären Preis und addieren Sie dann noch die Cache-Eingabegebühr. Das würde zu einer doppelten Berechnung führen. Ziehen Sie stattdessen zunächst den Cache-Anteil von der Gesamteingabe ab. Der verbleibende Teil wird zum regulären Preis berechnet. Wenn Sie die neue Interactions API verwenden, gibt die offizielle Dokumentation usage.total_cached_tokens als Feld für Cache-Statistiken an.
Zwei Dinge, die getrennt betrachtet werden müssen
Unterscheiden Sie außerdem zwischen zwei Fragen: Wie viele Cache-Treffer gab es tatsächlich bei Google, und wie berücksichtigt der Proxy den Preisvorteil in Ihrer Rechnung? Den ersten Wert können Sie anhand der offiziellen Felder überprüfen. Der zweite hängt von den Abrechnungsregeln des jeweiligen Proxy-Anbieters ab und lässt sich nicht durch Googles offizielle Dokumentation belegen. Vergleichen Sie deshalb beim Abgleich sowohl die Cache-Felder in der Antwort des Upstream-Dienstes als auch die Berechnungsgrundlage in den Rechnungsdetails.
💡 Tipp zur Auswahl: Prüfen Sie beim Abgleich zuerst die Cache-Tokens auf Anfrageebene und danach die Rechnungsübersicht. Wenn Sie OpenAI, Claude und Gemini nach denselben Maßstäben vergleichen möchten, können Sie über APIYI apiyi.com dieselbe Eingabeaufforderung an die verschiedenen Modelle senden und schnell zwischen ihnen wechseln.
Unterschiede bei der Cache-Abrechnung von Gemini, Claude und OpenAI
Die drei Anbieter gehen unterschiedlich mit Caches um, entsprechend unterscheiden sich auch die Abrechnungsgrundlagen. Die folgende Tabelle vergleicht, wie Caches aktiviert und abgerechnet werden. Rabatte und Gültigkeitsdauern können sich mit den Modellversionen ändern. Die Angaben in der Tabelle entsprechen ungefähr dem Stand zum Zeitpunkt der Erstellung. Verbindlich sind die aktuellen Preise auf den offiziellen Preisseiten der Anbieter.
| Vergleichspunkt | Gemini | Claude | OpenAI |
|---|---|---|---|
| Auslöser | Zwei Verfahren: implizit und automatisch sowie explizite Cache-Objekte | Explizit: Cache-Grenzen werden in der Anfrage mit cache_control markiert |
Automatisch, keine Codeänderung nötig |
| Kosten beim Schreiben in den Cache | Implizit kostenlos; beim Erstellen expliziter Caches wird die Eingabe berechnet, zusätzlich fallen Speichergebühren an | Ja, der Schreibpreis liegt über dem regulären Eingabepreis. Für Gültigkeitsdauern von 5 Minuten und 1 Stunde gelten unterschiedliche Preise. | Keine separate Schreibgebühr |
| Preis für Cache-Lesezugriffe (Treffer) | Unter dem regulären Eingabepreis; der Rabatt hängt vom Modell ab | Etwa ein Zehntel des regulären Eingabepreises | Unter dem regulären Eingabepreis; der Rabatt hängt vom Modell ab |
| Speichergebühr | Nur bei expliziten Caches; abhängig von der Speicherdauer | Keine; die Gültigkeitsdauer wird beim Schreiben festgelegt | Keine |
| Mindestumfang | Variiert je nach Modell und Angebot; bei Vertex möglicherweise höher als bei der Developer API | Variiert je nach Modell, häufig mindestens 1.024 Tokens | In der Regel ab 1.024 Tokens |
| Garantie auf Cache-Treffer | Bei impliziten Caches keine, bei expliziten Caches zuverlässiger | Nach dem Markieren einer Cache-Grenze sind Treffer während der Gültigkeitsdauer in der Regel stabil | Automatischer Präfixabgleich, keine Garantie |
| Nutzungsfelder | cachedContentTokenCount (in promptTokenCount enthalten) |
cache_creation_input_tokens, cache_read_input_tokens; werden getrennt von den normalen Eingabe-Tokens aufgeführt |
prompt_tokens_details.cached_tokens (in prompt_tokens enthalten) |
Drei Punkte in dieser Tabelle sorgen besonders häufig für Verwirrung:
- Schreibgebühr: Bei Claude kostet das Schreiben in den Cache mehr; erst das Lesen ist günstiger. Wer viel schreibt und wenig liest, kann daher mehr zahlen als ohne Cache. Bei OpenAI gibt es keine Schreibgebühr, sodass auch ein Cache-Fehlschlag keine zusätzlichen Kosten verursacht. Für implizite Gemini-Caches fällt ebenfalls keine Schreibgebühr an; nur bei expliziten Caches entstehen Kosten für das Erstellen und Speichern.
- Wer entscheidet über das Caching? Bei Claude markiert die anfragende Seite die Cache-Grenzen ausdrücklich. Dadurch sind Treffer am vorhersehbarsten. Bei den impliziten Caches von OpenAI und Gemini entscheidet die Plattform automatisch. Entwickler können die Trefferwahrscheinlichkeit nur durch stabile Präfixe erhöhen. Das ist einer der Gründe, warum Cache-Treffer bei Claude und OpenAI für viele Nutzer stabiler wirken als bei Gemini: Bei Gemini spielen gleichzeitig Mindestumfang, Präfix und die Trennung zwischen Kanälen eine Rolle.
- Berechnungsgrundlage für die Gesamteingabe: Bei Gemini und OpenAI ist der Cache-Anteil bereits in der gesamten Eingabe enthalten und muss vor der Preisberechnung abgezogen werden. Bei Claude enthält
input_tokensweder die Cache-Lese- noch die Cache-Schreib-Tokens. Die drei Werte müssen separat berechnet und anschließend addiert werden. Wenn Sie die Formel eines Anbieters auf einen anderen übertragen, stimmt die Rechnung nicht. Prüfen Sie beim modellübergreifenden Abgleich über APIYI apiyi.com zuerst, welche Berechnungsgrundlage für die jeweiligen Felder gilt.
Gemini: Cache-Trefferrate schnell testen
Theorie ist das eine, aber am zuverlässigsten ist ein eigener Test. Die Idee: Erstellen Sie einen festen, langen Präfix, der die Mindestanforderungen erfüllt, setzen Sie die variable Frage ans Ende und senden Sie mehrere Anfragen hintereinander. Beobachten Sie dabei, wie sich die Felder für Cache-Tokens verändern.
Minimalbeispiel
Der folgende Code verwendet das OpenAI-kompatible Format und gibt die zurückgegebenen Nutzungsinformationen aus. Die Feldnamen richten sich nach der tatsächlichen Antwort und können je nach Anbindung unterschiedlich lauten:
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

# 固定的长前缀:务必超过目标模型的最低缓存门槛
LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800

for i in range(3):
    resp = client.chat.completions.create(
        model="gemini-3.8-flash",
        messages=[
            {"role": "system", "content": LONG_PREFIX},
            {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
        ],
    )
    print(i, resp.usage)
    time.sleep(2)
Vollständigen Test- und Abrechnungscode anzeigen
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

LONG_PREFIX = "这里放一段稳定不变的长文档或系统指令……" * 800


def extract_cached_tokens(usage) -> int:
    """尝试从 usage 中读取缓存 token 数,字段名以实际返回为准"""
    details = getattr(usage, "prompt_tokens_details", None)
    if details is not None:
        cached = getattr(details, "cached_tokens", None)
        if cached is not None:
            return cached
    return 0


def estimate_input_cost(total_in: int, cached: int,
                        normal_price: float, cached_price: float) -> float:
    """
    按官方口径估算输入费用:
    总输入已包含缓存部分,所以普通部分 = 总输入 - 缓存部分
    单价请填入官方定价页当前数值(每百万 token)
    """
    normal_part = total_in - cached
    return (normal_part * normal_price + cached * cached_price) / 1_000_000


def run_test(model: str, rounds: int = 3):
    results = []
    for i in range(rounds):
        resp = client.chat.completions.create(
            model=model,
            messages=[
                {"role": "system", "content": LONG_PREFIX},
                {"role": "user", "content": f"请用一句话总结,第 {i} 次提问"},
            ],
        )
        usage = resp.usage
        cached = extract_cached_tokens(usage)
        results.append((i, usage.prompt_tokens, cached))
        print(f"第 {i} 次:总输入={usage.prompt_tokens},缓存命中={cached}")
        time.sleep(2)
    return results


if __name__ == "__main__":
    for m in ["gemini-3.8-flash"]:
        print("模型:", m)
        run_test(m)
🚀 Schnellstart: Für diesen Vergleichstest empfiehlt sich APIYI unter apiyi.com. In demselben Skript müssen Sie nur den Parameter
modelaustauschen, um nacheinander Gemini-, OpenAI- und Claude-Modelle zu testen und die Unterschiede beim Caching direkt zu sehen.
Diese Variablen sollten Sie beim Test kontrollieren
Gehen Sie die folgende Checkliste beim Testen Punkt für Punkt durch. So vermeiden Sie, ein Problem im eigenen Setup fälschlich der API-Anbindung zuzuschreiben:
| Prüfkriterium | Vorgehensweise | Zweck |
|---|---|---|
| Präfixlänge | Sicherstellen, dass sie über der aktuellen Mindestanforderung des Zielmodells liegt | Probleme mit der Mindestlänge ausschließen |
| Stabilität des Präfixes | Keine Zeitstempel oder Request-IDs am Anfang einfügen | Verhindern, dass der Präfix verändert wird |
| Position variabler Inhalte | Die Nutzerfrage ans Ende setzen | Einen möglichst langen gemeinsamen Präfix sicherstellen |
| Abstand zwischen Anfragen | Mehrere Anfragen in kurzer Folge senden | Den offiziellen Empfehlungen entsprechen |
| Vergleichsgruppe | Dieselbe Eingabeaufforderung mit OpenAI oder Claude testen | Zwischen einem Problem der Modellmechanik und der API-Anbindung unterscheiden |
So interpretieren Sie die Testergebnisse
Wenn der Präfix lang genug und strukturell stabil ist und die Anfragen in kurzem Abstand erfolgen, Gemini aber dennoch kaum Cache-Treffer erzielt, während dieselbe Eingabeaufforderung bei OpenAI oder Claude zuverlässig Treffer erzielt, liegt der Unterschied an Geminis eigenem Caching-Mechanismus und den Bedingungen der Upstream-Anbindung – nicht an der Formulierung Ihrer Eingabeaufforderung. In diesem Fall können Sie explizites Caching in Betracht ziehen: Die wiederzuverwendenden langen Inhalte werden dabei festgeschrieben, ein Cache-Objekt wird aktiv erstellt und in den Anfragen referenziert.
Wenn Ihre Anwendung ohnehin nur kurze Dialoge umfasst, lohnt es sich nicht, einer hohen Trefferrate hinterherzujagen. Akzeptieren Sie, dass Gemini in solchen Szenarien nur begrenzte Cache-Vorteile bietet, und konzentrieren Sie Ihre Kostenoptimierung stattdessen auf die Modellauswahl und die Begrenzung der Ausgabelänge.
Häufig gestellte Fragen
F1: Warum ist die Cache-Trefferrate bei Gemini deutlich niedriger als bei OpenAI und Claude?
Geminis implizites Caching setzt voraus, dass das Modell es unterstützt, die Mindestanzahl an Tokens erreicht wird, der Präfix stabil bleibt und die Anfragen zeitlich nah beieinanderliegen. Bei Vertex kommt außerdem die projektbezogene Isolation hinzu. Darüber hinaus garantiert Google offiziell keine Cache-Treffer. Ist eine dieser Bedingungen nicht erfüllt, werden die Eingaben stillschweigend zum regulären Preis abgerechnet. Um die Ursache bei einer bestimmten API-Anbindung zu ermitteln, müssen die Upstream-Request-Protokolle geprüft werden.
F2: Hat Google offiziell gesagt, dass ein API-Proxy-Dienst die Cache-Trefferrate senkt?
Nein. Google nennt lediglich die Bedingungen, von denen das Caching abhängt: einen wiederverwendbaren Präfix, eine Mindestanzahl an Tokens und den Geltungsbereich. Wenn sich durch die API-Anbindung diese Bedingungen ändern, kann die Trefferrate sinken. Um das Cache-Verhalten verschiedener Modelle zu vergleichen, können Sie mit derselben Eingabeaufforderung über APIYI unter apiyi.com einen kontrollierten Test durchführen.
F3: Ist der Anteil mit Cache-Treffern kostenlos?
Nein. Treffer werden zum Preis für gecachte Eingaben abgerechnet. Dieser liegt unter dem Preis für reguläre Eingaben, ist aber nicht kostenlos. Die Preislisten beider Anbieter führen die Preise für reguläre und gecachte Eingaben separat auf. Für explizites Caching fallen zusätzlich Speicherkosten an.
F4: Muss ich die gecachten Tokens auf die Eingabe-Tokens in der Abrechnung noch draufrechnen?
Nein. `promptTokenCount` bezeichnet die Gesamtzahl der Eingabe-Tokens und enthält den gecachten Anteil bereits. Ziehen Sie `cachedContentTokenCount` von der Gesamtzahl der Eingabe-Tokens ab, um den Anteil zu ermitteln, der zum regulären Preis abgerechnet wird. Berechnen Sie anschließend den gecachten Anteil separat.
F5: Gelten für AI Studio und Vertex dieselben Mindestanforderungen fürs Caching?
Nicht ganz. Laut aktueller Dokumentation liegt die Mindestanforderung für Gemini 3.1 Pro Preview und Gemini 3.8 Flash bei 4.096 Tokens für die Developer API und bei 6.144 Tokens für Vertex. Für die ältere Generation Gemini 2.5 Pro beträgt sie bei beiden 2.048 Tokens. Die Anforderungen können sich mit neuen Modellversionen ändern. Maßgeblich sind daher die aktuellen Angaben in der offiziellen Dokumentation.
F6: Geht der Cache verloren, wenn ich den API-Schlüssel wechsle?
Das hängt davon ab, ob Sie auch das Projekt wechseln. Bei Vertex ist der Cache auf das jeweilige Google-Cloud-Projekt beschränkt und wird nicht projektübergreifend geteilt. Ein API-Schlüssel für ein anderes Projekt bedeutet daher, dass der Cache nicht mehr verfügbar ist. Bei verschiedenen Schlüsseln innerhalb desselben Projekts lässt sich dagegen nicht pauschal sagen, dass der Cache verloren geht.
F7: Sollte ich implizites oder explizites Caching verwenden?
Wenn Sie regelmäßig dieselben umfangreichen Inhalte wie lange Dokumente oder Systemanweisungen wiederverwenden, ist explizites Caching zuverlässiger. Dafür müssen Sie jedoch Entwicklungsaufwand und Speicherkosten einplanen. Bei gelegentlicher Wiederverwendung ist implizites Caching kostenlos, der Nutzen lässt sich aber nicht vorhersagen. Führen Sie zunächst einen kleinen Vergleichstest über APIYI unter apiyi.com durch und entscheiden Sie dann, ob sich die Entwicklung einer expliziten Cache-Lösung lohnt.
F8: Kann ich die im API-Proxy-Dashboard angezeigte Trefferrate direkt als Grundlage für die Abrechnung nehmen?
Das ist nicht empfehlenswert. Maßgeblich sind die Cache-Felder in der originalen Antwort des Anbieters. Außerdem sind tatsächliche Cache-Treffer beim Google-Upstream und die Art, wie der API-Proxy-Dienst sie Ihrer Rechnung zugrunde legt, zwei verschiedene Dinge. Für Letzteres müssen Sie die Abrechnungsregeln des API-Proxy-Dienstes prüfen.
Wichtigste Erkenntnisse zur Cache-Trefferrate
- Das Muster ist eindeutig: Bei OpenAI- und Claude-Modellen sind Cache-Treffer stabil. Bei Gemini ist die Trefferrate niedrig oder geht gegen null – das muss gesondert untersucht werden.
- Treffer werden offiziell nicht garantiert: Der implizite Cache von Gemini garantiert keine Kostenersparnis. Für den expliziten Cache müssen Sie selbst ein Cache-Objekt erstellen und darauf verweisen.
- Die Mindestgrenze hängt vom Modell ab: Bei neueren Modellen liegt sie höher. Außerdem können die Werte für Vertex und die Developer API voneinander abweichen.
- Der Präfix entscheidet über den Treffer: Platzieren Sie längere Inhalte am Anfang. Fügen Sie dort keine variablen Inhalte wie Zeitstempel oder IDs ein, denn dadurch wird der gemeinsame Präfix unterbrochen.
- Vertex trennt Caches nach Projekt: Caches werden nicht projektübergreifend geteilt. Werden Anfragen auf verschiedene Projekte verteilt, gehen Cache-Treffer verloren.
- Die Gesamteingabe umfasst auch Cache-Tokens:
promptTokenCountenthält bereits den gecachten Anteil. Ziehen Sie diesen bei der Abrechnung zuerst ab und berechnen Sie die Anteile anschließend getrennt. - Gleichen Sie die Felder ab: Maßgeblich sind die Cache-Felder in der offiziellen Antwort. Vergleichen Sie außerdem über APIYI auf apiyi.com dieselbe Eingabeaufforderung mit verschiedenen Modellen.
Zusammenfassung
Die niedrige Cache-Trefferrate von Gemini hat mehrere Ursachen: Implizite Cache-Treffer sind nicht garantiert, die Mindestanzahl an Tokens steigt mit dem Modell, der Präfix muss stabil bleiben, Vertex trennt Caches nach Projekt und explizite Caches müssen aktiv erstellt werden. Werden einige dieser Bedingungen auf Ebene der Verarbeitungskette verändert, sinkt die Trefferrate. Die konkrete Ursache lässt sich jedoch nur anhand der Projekte und Anfrageprotokolle des vorgelagerten Systems ermitteln.
Bei der Abrechnung sollten Sie drei Punkte beachten: Cache-Treffer sind nicht kostenlos; die Gesamteingabe umfasst bereits den gecachten Anteil, der daher nicht doppelt berechnet werden darf; und für explizite Caches fallen zusätzliche Speicherkosten an, für implizite nicht. Maßgeblich für den Abgleich sind die Felder in der offiziellen Antwort. Prüfen Sie außerdem separat, nach welchen Regeln Ihr API-Proxy-Dienst abrechnet.
Als Nächstes empfiehlt sich ein Vergleichstest mit dem Skript aus diesem Artikel: Verwenden Sie einen festen, langen Präfix und vergleichen Sie Gemini mit OpenAI und Claude. Entscheiden Sie anschließend, ob sich der Einsatz eines expliziten Caches lohnt. Mit APIYI auf apiyi.com können Sie die Ergebnisse schnell überprüfen. Da mehrere Modelle dieselbe Schnittstelle nutzen, ist der Kostenvergleich unkompliziert.
Referenzen
- Gemini-API-Caching-Dokumentation: offizielle Erläuterungen zu implizitem und explizitem Caching
- Link:
ai.google.dev/gemini-api/docs/caching -
Hinweis: Enthält Informationen zur Mindestanzahl an Tokens und zu den Abrechnungsfaktoren.
-
Gemini-API-Preisseite: Preise für reguläre Eingaben, gecachte Eingaben, Ausgaben und Speicher
- Link:
ai.google.dev/gemini-api/docs/pricing -
Hinweis: Dient als Grundlage zur Überprüfung der aktuellen Preise.
-
Vertex-AI-Übersicht zum Kontext-Caching: Projektisolierung und Abrechnungsregeln für den Cache
- Link:
docs.cloud.google.com/vertex-ai/generative-ai/docs/context-cache/context-cache-overview -
Hinweis: Erläutert, dass Vertex-Caches nicht projektübergreifend gemeinsam genutzt werden.
-
Gemini-API-Referenz für generateContent: das Feld
usageMetadatain der Antwort - Link:
ai.google.dev/api/generate-content - Hinweis: Enthält das Cache-Token-Feld, das für den Abgleich der Abrechnung verwendet wird.
Autor: APIYI Team
Technischer Austausch: Diskutieren Sie Ihre Erfahrungen mit der Fehlersuche beim Gemini-Caching gern in den Kommentaren. Weitere Informationen finden Sie im Dokumentationszentrum von APIYI unter docs.apiyi.com.