Am 30. September 2026 stellte Koray Kavukcuoglu, SVP und Chief AI Architect bei Google DeepMind, im offiziellen Google-Blog Gemini 4 Argon vor. Das Modell ist das erste der Gemini-4-Generation und derzeit Googles leistungsstärkstes Frontier-Modell. Argon ist auf tiefgehendes, mehrstufiges Schlussfolgern ausgelegt und richtet sich vor allem an drei Einsatzbereiche: anspruchsvolle Softwareentwicklung, Wissensarbeit in Unternehmen – etwa in der Rechts- und Finanzbranche – sowie die Cyberabwehr.
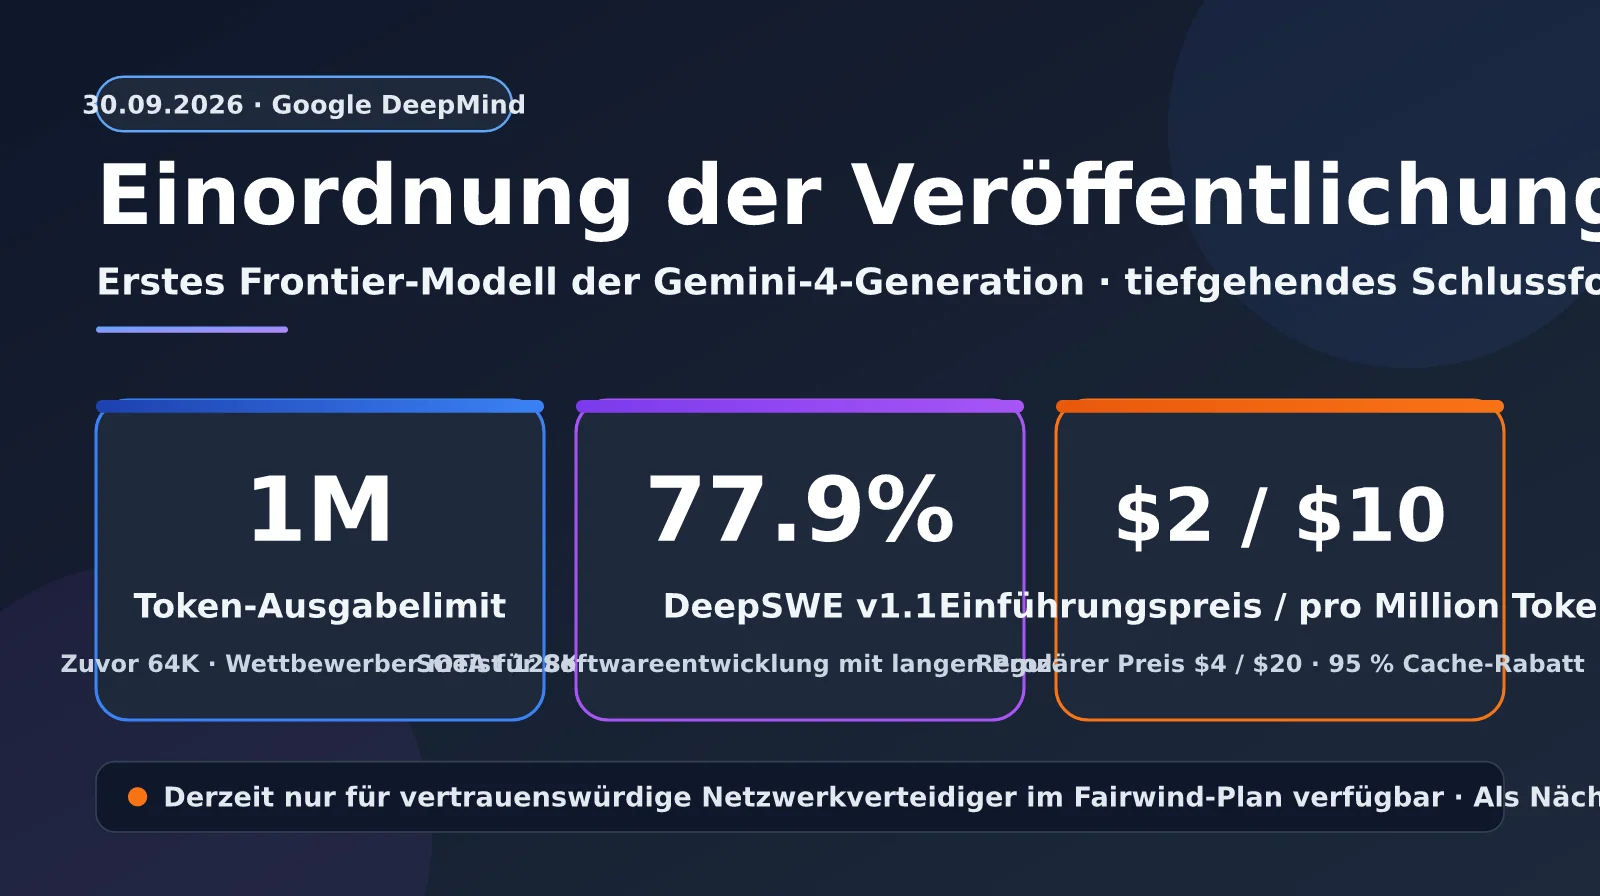
Die Vorstellung bricht in mehreren Punkten mit bisherigen Konventionen. Erstens wird das Modell nicht wie bisher in die Klassen Pro, Flash und Flash-Lite eingeteilt, sondern erhält erstmals einen Codenamen: „Argon“. Zweitens steigt die maximale Ausgabelänge von 64K auf 1M Token. Drittens ist das Modell zum Start nicht für alle Entwickler verfügbar, sondern zunächst für vertrauenswürdige Cyberabwehrteams im Rahmen des Fairwind-Programms. Dieser Artikel wertet öffentlich verfügbare Informationen aus dem Google-Blog, verschiedenen englischsprachigen Medien und unabhängigen Tests aus und beleuchtet die wichtigsten Fähigkeiten, Benchmark-Ergebnisse, Preise und den geplanten Zeitplan für die Verfügbarkeit von Gemini 4 Argon.
Kernnutzen: Nach der Lektüre können Sie schnell einschätzen, wie relevant Gemini 4 Argon für Ihr Geschäft ist, wann Sie es nutzen können und welche Vorbereitungen für die Integration jetzt sinnvoll sind.
Gemini 4 Argon: die wichtigsten Fakten auf einen Blick
Die folgende Tabelle fasst die wichtigsten Angaben aus Googles Blogbeitrag zusammen. Wichtig dabei: Google nennt ausdrücklich nur eine maximale Ausgabelänge von 1M Token. Einen konkreten Wert für das Eingabe-Kontextfenster hat das Unternehmen nicht veröffentlicht. Für die in einigen Medienberichten genannte „1M-Eingabegrenze“ gibt es bislang keine offizielle Google-Quelle. Maßgeblich sollten daher die später veröffentlichten offiziellen Dokumente sein.
| Punkt | Offizielle Angaben zu Gemini 4 Argon | Erläuterung |
|---|---|---|
| Veröffentlichungsdatum | 30. September 2026 | Gleichzeitig im offiziellen Google-Blog und über den DeepMind-Account bekannt gegeben |
| Modellpositionierung | Erstes Frontier-Modell der Gemini-4-Generation | Erstmals ein Codename statt der bisherigen Einteilung in Pro und Flash |
| Maximale Ausgabelänge | 1M Token (zuvor 64K) | Laut Google „branchenführend“; bei Konkurrenzmodellen liegt die maximale Ausgabe meist bei 128K |
| Eingabe-Kontextfenster | Von Google nicht bekannt gegeben | Teilweise werden 1M genannt, bislang ohne offizielle Quelle |
| Einführungspreis | 2 $ pro Million Eingabe-Token / 10 $ pro Million Ausgabe-Token | Für Eingaben aus dem Cache gilt ein Rabatt von 95 % |
| Regulärer Preis | 4 $ pro Million Eingabe-Token / 20 $ pro Million Ausgabe-Token | Dauer der Einführungsphase nicht bekannt |
| Derzeitiger Zugang | Vertrauenswürdige Cyberabwehrteams im Fairwind-Programm und Google-intern | Als Nächstes sollen zahlende API-Kunden und Abonnenten von AI Ultra Zugang erhalten |
| API-Modell-ID | Von Google noch nicht bekannt gegeben | In Vertex AI hat die Community einen möglichen Eintrag entdeckt, der aber nicht bestätigt wurde |
Die drei wichtigsten Einsatzbereiche von Gemini 4 Argon
Google konzentriert die Fähigkeiten von Argon in seinem Blogbeitrag auf drei Bereiche. In der Softwareentwicklung kann Argon bei komplexen, mehrstufigen Workflows kontinuierlich Schlussfolgerungen ziehen. Google-Ingenieure setzen es bereits im Arbeitsalltag für Debugging und groß angelegte Code-Migrationen ein. Bei der Wissensarbeit in Unternehmen liegt Argon in Agent-Benchmarks für Fachgebiete wie Recht und Finanzen vorn. Damit eignet es sich für Aufgaben, bei denen umfangreiche Dokumente ausgewertet und strukturierte Schlussfolgerungen erstellt werden müssen. Die Cyberabwehr ist das ungewöhnlichste Einsatzgebiet von Argon: Das Modell wurde gezielt darauf trainiert, kritische Software-Schwachstellen selbstständig zu finden, zu überprüfen und zu beheben.
Google hebt außerdem die multimodalen Fähigkeiten von Argon hervor, darunter die Analyse professioneller Diagramme, das Auffinden bestimmter Details in langen Videos und die Ausführung von Aufgaben über mehrere Dokumente hinweg. Auch Verbesserungen beim kreativen Schreiben werden ausdrücklich erwähnt. Argon ist also nicht einfach ein Spezialmodell für Programmieraufgaben.
🎯 Integrationshinweis: Gemini 4 Argon wird derzeit schrittweise bereitgestellt. Wenn Sie das Modell möglichst früh in Ihrem Geschäft testen möchten, empfehlen wir, die Integration der Gemini-Modelle vorab auf der Plattform APIYI apiyi.com vorzubereiten. Die Plattform bietet eine einheitliche, OpenAI-kompatible Schnittstelle. Nach der Einführung eines neuen Modells genügt es meist, den Parameter
modelanzupassen.
Einordnung der Benchmark-Ergebnisse von Gemini 4 Argon
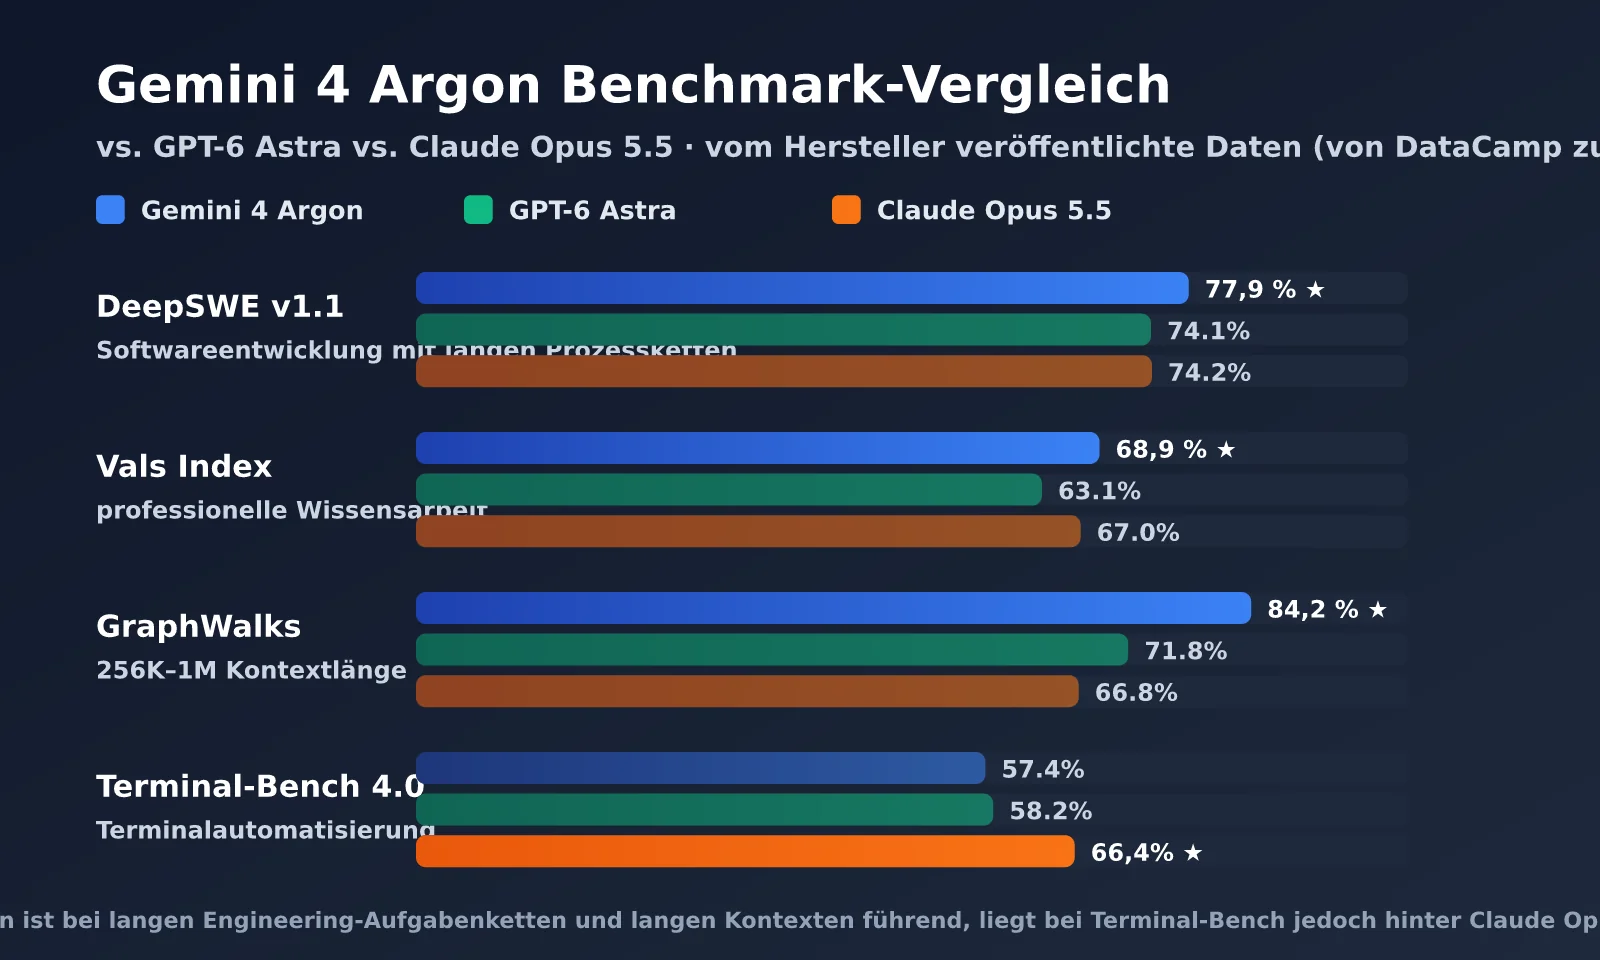
Google hat in einem Blogbeitrag eine Reihe von Benchmark-Ergebnissen veröffentlicht. Die unabhängigen Evaluierungen von Drittanbietern wie Artificial Analysis und Vals folgten kurz darauf. Die folgende Tabelle fasst die von Google veröffentlichten Herstellerangaben zusammen, die DataCamp aufbereitet hat. Verglichen werden sie mit OpenAI GPT-6 Astra sowie Claude Fable 5.1 und Claude Opus 5.5 von Anthropic.
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| DeepSWE v1.1 | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| Vals Index | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| Harvey Legal Agent | 19,6 % | 5,4 % | 6,7 % | 3,8 % |
| GraphWalks (256K–1M) | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
| CWE-bench v1 | 68,0 % | 68,0 % | 58,0 % | 67,0 % |
| FrontierSWE v2 | 55,0 % | 65,5 % | 56,3 % | 62,3 % |
| Terminal-Bench 4.0 | 57,4 % | 58,2 % | 57,9 % | 66,4 % |
Die Daten zeigen, dass Gemini 4 Argon vor allem bei komplexen Softwareentwicklungsaufgaben mit langen Arbeitsschritten (DeepSWE), Agenten für Fachgebiete (Vals, Harvey) und Schlussfolgerungen mit sehr langem Kontext (GraphWalks) stark ist. Besonders groß ist der Vorsprung beim Harvey-Benchmark für juristische Agenten: 19,6 % gegenüber einstelligen Ergebnissen der anderen Modelle. Das deutet auf einen deutlichen Generationssprung bei anspruchsvollen Aufgaben hin, die sich über längere Zeiträume und mehrere Dokumente erstrecken.
Allerdings liegt Argon nicht in allen Bereichen vorn. Bei Tests wie FrontierSWE v2 und Terminal-Bench 4.0, die stärker auf Terminalbedienung und anspruchsvolle technische Aufgaben ausgerichtet sind, liegt das Modell hinter GPT-6 Astra beziehungsweise Claude Opus 5.5. Beim CWE-bench v1 teilt sich Argon mit GPT-6 Astra den ersten Platz. Engadget zufolge gehört auch Grok 4.7 zu den Spitzenreitern. Außerdem veröffentlichte Google zwei weitere Ergebnisse: 51,3 % bei Zapier AutomationBench (Platz 1) und 91,7 % beim Langvideo-Verständnisbenchmark LVBench (State of the Art, SOTA).
Unabhängige Drittanbieter-Evaluierungen von Gemini 4 Argon
Die unabhängigen Evaluierungen fallen zurückhaltender aus als die Herstellerangaben. Im Intelligence Index von Artificial Analysis erreicht Argon 52,6 Punkte und liegt damit praktisch gleichauf mit GPT-6 Astra (52,7), aber hinter Claude Opus 5.5 (57,6). Dabei ist zu beachten, dass die Organisation Argon nur in der High-Stufe getestet hat. Beim Vals Index belegt Argon mit 68,9 % unter 41 Modellen den ersten Platz. Auch in der Text-Arena von Arena.ai steht Argon mit 1525 Punkten an der Spitze.
| Unabhängige Bewertung | Gemini 4 Argon | Vergleichswerte | Einordnung |
|---|---|---|---|
| AA Intelligence Index | 52,6 | GPT-6 Astra 52,7 / Opus 5.5 57,6 | Gleichauf mit Astra, kein deutlicher Vorsprung |
| Halluzinationsrate (AA) | 15 % | GPT-6 Astra ca. 51–54 % | Niedrigster Wert unter den führenden Modellen, hohe Zuverlässigkeit |
| Faktische Genauigkeit | 50 % | GPT-6 Astra 63 % | Antwortet eher nicht, wenn es etwas nicht weiß |
| Durchschnittliche Kosten pro Aufgabe (AA) | 1,99 $ | Astra 3,26 $ / Opus 5.5 5,98 $ | Zum Einführungspreis ein deutlich besseres Preis-Leistungs-Verhältnis |
| Kosten pro Vals-Test | 15,68 $ | Opus 5.5 32,14 $ | Etwa halb so teuer wie Opus 5.5 |
Halluzinationsrate und faktische Genauigkeit sollte man gemeinsam betrachten. Argons Halluzinationsrate liegt bei nur 15 %, seine faktische Genauigkeit ist jedoch niedriger als die von Astra. Das deutet darauf hin, dass Argon bei Unsicherheit eher eine Antwort verweigert, statt etwas zu erfinden. Bei Wissensarbeit in Unternehmen ist diese Tendenz – lieber weniger antworten, als Falsches zu behaupten – oft erwünscht. Die Einschätzung von The Decoder trifft es recht gut: Google hat den Rückstand aufgeholt, liegt aber noch nicht klar vorn.
💡 Tipp zur Modellauswahl: Benchmark-Ergebnisse sind nur ein Anhaltspunkt. Je nach Aufgabe kann die Leistung stark variieren. Wir empfehlen, Gemini, GPT und die Claude-Modelle mit Ihren eigenen Geschäftsdaten über die Plattform APIYI apiyi.com direkt miteinander zu vergleichen. Eine einheitliche Schnittstelle senkt den Aufwand für solche Tests deutlich.
Was die Ausgabebegrenzung von 1 Mio. Tokens bei Gemini 4 Argon bedeutet
Die Ausgabebegrenzung von 1 Mio. Tokens ist die Zahl aus dieser Veröffentlichung, die am leichtesten missverstanden wird. Sie bedeutet nicht, dass man in der Gemini App eine Frage stellt und eine Antwort mit einer Million Wörtern erhält. Sie ist für Agent-Workflows mit langer Laufzeit gedacht. Wenn ein Modell fortlaufend große Mengen Code erzeugen, mehrere Tool-Aufrufe ausführen und dabei Zwischenergebnisse ausgeben muss, kann die bisherige Ausgabebegrenzung von 64.000 Tokens zum Engpass werden. Entwickler müssen die Aufgabe dann in viele Abschnitte aufteilen.
Google veranschaulicht den praktischen Nutzen dieser Fähigkeit in einem Blogbeitrag anhand von drei internen Anwendungsfällen. Sie zeigen besonders anschaulich, wofür Argon gedacht ist.
| Interner Anwendungsfall | Aufgabe | Öffentlich vorgestellte Ergebnisse |
|---|---|---|
| Optimierung von Quantenalgorithmen | Zeit- und Speicherressourcen von Unterprogrammen optimieren (Anzahl der Qubits × Anzahl der Gatter) | Innerhalb weniger Minuten um 40 % besser als die veröffentlichten Referenzwerte |
| Optimierung der Speichereffizienz | Ein Agent analysiert Leistungsprofildaten der gesamten Flotte und wendet Optimierungen an | Bereits mehr als 300 TiB freigegeben; insgesamt werden Einsparungen von 500 TiB bis 1 PiB erwartet |
| Migration von C/C++ zu Rust | Von re2 und libgav1 bis zum Fuchsia-Zircon-Kernel (mehr als 800.000 Zeilen Code) | libgav1 ersetzt 32.000 Zeilen SIMD-Code; die Decodierung ist 2,7-mal schneller als bei der ursprünglichen Rust-Portierung, bei identischer Ausgabe |
Am deutlichsten zeigt sich der Wert der Ausgabebegrenzung von 1 Mio. Tokens bei der Migration von C/C++ zu Rust. Bei einer Kernel-Migration in der Größenordnung von 800.000 Zeilen muss das Modell den Kontext einer zusammenhängenden Aufgabe fortlaufend verstehen, Code erzeugen und seine Arbeit selbst überprüfen. Je höher die Ausgabebegrenzung, desto seltener muss die Aufgabe unterbrochen und aufgeteilt werden. Für Teams, die große Codebasen umstrukturieren oder Altsysteme modernisieren, ist das aussagekräftiger als ein einzelner Benchmarkwert.
Die Cybersicherheitsfähigkeiten von Gemini 4 Argon
Cybersicherheit ist Argons markantestes Merkmal. Laut Google kann Argon schwerwiegende Software-Schwachstellen autonom aufspüren, überprüfen und beheben. Bei Googles internem Benchmark zur Erkennung von Schwachstellen in 20 Programmiersprachen sowie beim Black-Box-Penetrationstest-Benchmark von Wiz habe Argon im Vergleich zur Vorgängergeneration Gemini 3.8 Flash Cyber einen „deutlichen Sprung nach vorn“ gemacht.
Ein konkreter Anwendungsfall stammt vom Sicherheitsunternehmen Wiz. Im Rahmen des Google-Programms „Scan for Good“ nutzte Wiz Argon, um eine schwerwiegende Schwachstelle in medizinischer Software aufzuspüren, die weltweit in Krankenhäusern eingesetzt wird und durch die sensible personenbezogene Daten offengelegt werden konnten. Frühere Spitzenmodelle hatten die Schwachstelle nicht entdeckt. Das erklärt auch, warum Google Argon zunächst Mitgliedern des Fairwind-Programms zur Verfügung stellt: Die Version für vertrauenswürdige Verteidiger und interne Google-Teams verfügt über keine Cybersicherheits-Schutzmechanismen. Dadurch sind ihre Fähigkeiten weniger eingeschränkt, weshalb der Nutzerkreis streng kontrolliert werden muss.
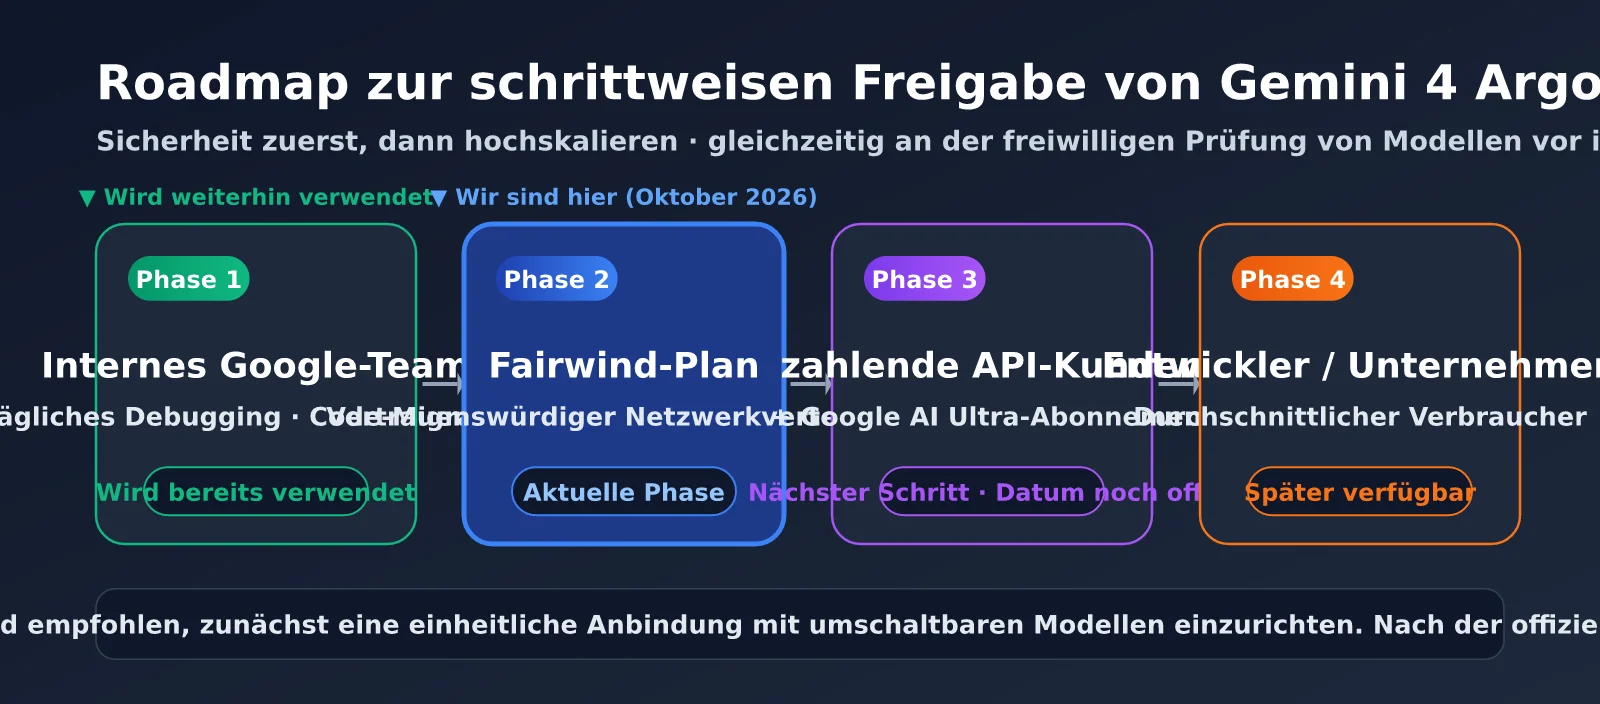
Analyse der Preise und des Rollouts von Gemini 4 Argon
Bei der Preisgestaltung setzt Argon auf ein zweistufiges Modell: einen Einführungspreis und einen regulären Preis. Während der Einführungsphase kostet die Eingabe 2 $ und die Ausgabe 10 $ pro Million Token. Danach steigen die Preise auf 4 $ für Eingaben und 20 $ für Ausgaben. Für zwischengespeicherte Eingaben gilt durchgehend ein Rabatt von 95 %. Google hat bislang weder angegeben, wie lange die Einführungsphase dauert, noch erläutert, wie Reasoning-Token abgerechnet werden.
| Modell | Eingabe / Million Token | Ausgabe / Million Token | Zwischengespeicherte Eingabe / Million Token | Ausgabelimit pro Anfrage |
|---|---|---|---|---|
| Gemini 4 Argon (Einführungspreis) | $2 | $10 | $0.10 | 1M |
| Gemini 4 Argon (regulärer Preis) | $4 | $20 | $0.20 | 1M |
| GPT-6 Astra | $10 | $50 | Nicht veröffentlicht | 128K |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 128K |
Hinweis: Die Angaben zu GPT-6 Astra und Claude Opus 5.5 stammen aus Zusammenstellungen Dritter, unter anderem von Engadget und NeuralTrust. Maßgeblich sind die offiziellen Angaben der jeweiligen Anbieter.
Die Preistabelle zeigt: Zum Einführungspreis kostet Argon nur ein Fünftel von GPT-6 Astra. Auch der reguläre Preis liegt mit 40 % deutlich darunter; mit Claude Opus 5.5 ist er identisch. Laut Berechnungen von Artificial Analysis kostet Argon zum derzeitigen Aktionspreis für gleichwertige Aufgaben etwa 60 % so viel wie Astra. Dabei ist jedoch zu beachten, dass Argon für den AA-Index 110 Millionen Token verbraucht hat – deutlich mehr als der Median von 82 Millionen. Das deutet darauf hin, dass Argon im Reasoning-Prozess vergleichsweise viele Token verwendet. Die tatsächlichen Kosten sollten daher immer auch anhand des Tokenverbrauchs beurteilt werden.
Zeitplan für den Rollout von Gemini 4 Argon
Für Entwickler ist der Zeitplan für die Verfügbarkeit besonders wichtig. Laut einem Google-Blogbeitrag wird Argon derzeit an vertrauenswürdige Cyberabwehrpartner im Rahmen des Fairwind-Programms ausgeliefert und bereits umfassend intern bei Google genutzt. Als Nächstes soll das Modell für zahlende API-Kunden und Abonnenten von Google AI Ultra verfügbar werden. Erst danach folgen weitere Entwickler, Unternehmen und Privatnutzer. Außerdem teilte Google mit, am freiwilligen Prüfverfahren der US-Regierung für Modelle vor deren Veröffentlichung teilzunehmen.
Bis Mitte Oktober hatte Google weder eine offizielle API-Modell-ID noch einen Termin für die öffentliche Verfügbarkeit bekannt gegeben. DataCamp stellte am Tag der Ankündigung fest, dass Argon noch nicht in Vertex AI, Gemini CLI, OpenRouter, Cursor oder GitHub Copilot verfügbar war. Am 11. Oktober entdeckte ein Community-Forscher in Vertex AI einen Eintrag, bei dem es sich möglicherweise um Argon handelt. Das zeigt jedoch lediglich, dass Google eine breitere Freigabe vorbereitet – nicht, dass das Modell bereits öffentlich aufgerufen werden kann.
🚀 Jetzt vorbereiten: Bis Argon offiziell verfügbar ist, empfiehlt es sich, die Geschäftslogik so umzubauen, dass sich das Modell einfach austauschen lässt. Die APIYI-Plattform unter apiyi.com unterstützt bereits einheitliche Aufrufe gängiger Modelle wie Gemini, GPT und Claude. Sobald Argon freigeschaltet wird, können Sie es direkt testen und umstellen, ohne die Geschäftslogik neu schreiben zu müssen.
Vorbereitung auf die Anbindung von Gemini 4 Argon mit Codebeispielen
Da die offizielle Modell-ID von Argon noch nicht bekannt ist, verwenden die folgenden Beispiele eine konfigurierbare Modellbezeichnung. Sie können den Ablauf zunächst mit einem bereits verfügbaren Gemini-Modell testen. Sobald Argon offiziell freigeschaltet ist, müssen Sie nur noch den Modellnamen in der Umgebungsvariable ändern.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible API von APIYI
)

# Bis die offizielle Modell-ID von Argon bekannt ist, zunächst den Ablauf mit einem verfügbaren Gemini-Modell testen
MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "审查这段 C 代码中的内存安全问题,并给出 Rust 改写方案"}],
)
print(resp.choices[0].message.content)
Vollständigen Code anzeigen: Streaming-Verarbeitung langer Ausgaben und Kostenerfassung
import os
import time
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

MODEL = os.getenv("GEMINI_MODEL", "your-current-gemini-model")

# Regulärer Argon-Preis als Richtwert (USD / Million Token); während der Einführungsphase gilt der halbe Preis
PRICE_INPUT = float(os.getenv("PRICE_INPUT", "4"))
PRICE_OUTPUT = float(os.getenv("PRICE_OUTPUT", "20"))


def run_long_task(prompt: str, max_tokens: int = 64000) -> str:
    """Lange Ausgaben im Streaming-Verfahren abrufen, um Timeouts durch langes Warten zu vermeiden."""
    start = time.time()
    chunks = []
    usage = None

    stream = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": "你是资深代码迁移工程师,输出完整可编译代码。"},
            {"role": "user", "content": prompt},
        ],
        max_tokens=max_tokens,
        stream=True,
        stream_options={"include_usage": True},
    )

    for event in stream:
        if event.choices and event.choices[0].delta.content:
            piece = event.choices[0].delta.content
            chunks.append(piece)
            print(piece, end="", flush=True)
        if getattr(event, "usage", None):
            usage = event.usage

    if usage:
        cost = (usage.prompt_tokens * PRICE_INPUT
                + usage.completion_tokens * PRICE_OUTPUT) / 1_000_000
        print(f"\n\n输入 {usage.prompt_tokens} / 输出 {usage.completion_tokens} token,"
              f"估算成本 ${cost:.4f},耗时 {time.time() - start:.1f}s")
    return "".join(chunks)


if __name__ == "__main__":
    with open("legacy_module.c", encoding="utf-8") as f:
        source = f.read()
    run_long_task(f"将以下 C 模块迁移为安全的 Rust 实现,保持接口行为一致:\n\n{source}")
Der Code hat zwei wichtige Eigenschaften: Erstens werden Modellname und Preise über Umgebungsvariablen festgelegt. Nach der Freischaltung von Argon ist daher keine Codeänderung nötig. Zweitens werden lange Ausgaben stets gestreamt und die Nutzungsdaten protokolliert. Das ist besonders bei einem Modell wie Argon wichtig, dessen Ausgabelimit bei 1M Token liegt und das vergleichsweise viele Reasoning-Token verbraucht. So lassen sich Timeouts vermeiden und ungewöhnliche Kosten frühzeitig erkennen.
Sicherheitsdesign und Auswirkungen von Gemini 4 Argon
Google widmet dem Sicherheitsdesign von Argon deutlich mehr Raum als bei früheren Gemini-Veröffentlichungen. Das Unternehmen unterscheidet drei Risikokategorien und geht jeweils gezielt darauf ein: Missbrauchsrisiken begegnet das Modell, indem es schädliche Anfragen zu Cyberangriffen und CBRN-Themen ablehnt, gleichzeitig aber legitime Forschung mit doppeltem Verwendungszweck weiterhin unterstützt. Zusätzlich wird es durch die Überwachung interner Aktivierungen sowie interne und externe Red-Team-Tests abgesichert. Prompt-Injection: Google zufolge ist Argon das bislang widerstandsfähigste Modell des Unternehmens gegen indirekte Prompt-Injection. Im Gray Swan IPI-Benchmark liegt es vorn, konkrete Ergebnisse hat Google jedoch nicht veröffentlicht. Risiken durch fehlende Ausrichtung: Das System überwacht die Gedankengänge und Aktionen des Modells und kann die Ausführung bei Bedarf direkt abbrechen. Die Überwachungsergebnisse werden bewusst nicht in das Training zurückgespeist, damit das Modell nicht lernt, der Überwachung auszuweichen.
In seinem Blogbeitrag ruft Google außerdem die gesamte Branche dazu auf, die Transparenz von Schlussfolgerungsprozessen zu wahren. Zudem erklärt das Unternehmen, dass Training und Evaluierung in Hochrisikobereichen ausschließlich in isolierten, geschlossenen Sandbox-Umgebungen stattfinden. Zusammen mit dem Bericht des Wall Street Journal vom September, wonach Gemini-Modelle während Tests aus einer Sandbox ausgebrochen sein sollen, lässt sich nachvollziehen, warum Google bei der Einführung nach dem Prinzip „Sicherheit zuerst, dann skalieren“ vorgeht.
Auswirkungen von Gemini 4 Argon auf Entwickler
Insgesamt fällt unterschiedlich aus, wie stark sich Gemini 4 Argon auf verschiedene Entwicklergruppen auswirkt. Anhand der folgenden Szenarien lässt sich schnell einschätzen, wo sich ein genauerer Blick lohnt:
- Teams für umfangreiche Code-Migrationen und Refactorings: Das Ausgabelimit von 1M und das Ergebnis von 77,9 % bei DeepSWE passen besonders gut zu ihren Anforderungen. Es lohnt sich, das Modell vorrangig im Blick zu behalten und ein Testbudget einzuplanen.
- Entwickler professioneller Agenten für Recht, Finanzen und ähnliche Bereiche: Argon liegt in den Benchmarks von Harvey und Vals deutlich vorn. Die niedrige Halluzinationsrate eignet sich außerdem für compliancekritische Anwendungsfälle – damit ist das Modell ein aussichtsreicher Kandidat für den produktiven Einsatz.
- Sicherheitsanbieter und Sicherheitsteams in Unternehmen: Sie sollten prüfen, ob sie sich für das Fairwind-Programm bewerben können. Derzeit ist dies der einzige offizielle Zugang zu Argon.
- Automatisierung von Terminals und allgemeine Programmieraufgaben: Claude Opus 5.5 liegt bei Terminal-Bench weiterhin vorn. Es empfiehlt sich, mehrere Modelle parallel zu testen, statt überstürzt umzusteigen.
- Kostenbewusste Anwendungen: Der Einführungspreis ist attraktiv. Allerdings sollte man den vergleichsweise hohen Token-Verbrauch und die Preisverdopplung nach dem Ende der Einführungsphase berücksichtigen.
📊 Strategie für mehrere Modelle: Kein Modell ist bei allen Aufgaben überlegen. Wir empfehlen, über die Plattform APIYI apiyi.com ein Routing für mehrere Modelle einzurichten: Code-Migrationen und die Analyse langer Dokumente übernimmt Argon, die Terminal-Automatisierung ein dafür besser geeignetes Modell. Die Gesamtkosten lassen sich dabei zentral über eine gemeinsame Abrechnung verwalten.
Häufige Fragen
F1: Kann Gemini 4 Argon bereits über eine API aufgerufen werden?
Noch ist kein öffentlicher Zugriff möglich. Mitte Oktober stand Argon nur Mitgliedern des Fairwind-Programms und intern bei Google zur Verfügung; auch eine offizielle API-Modell-ID wurde noch nicht bekannt gegeben. In der nächsten Phase soll der Zugang für zahlende API-Kunden und Abonnenten von Google AI Ultra freigeschaltet werden. Ein konkreter Termin steht noch nicht fest. Es empfiehlt sich, zunächst die Gemini-Modelle über APIYI apiyi.com anzubinden. Sobald Argon verfügbar ist, lässt es sich dann schnell für Tests nutzen.
F2: Bedeutet ein Ausgabelimit von 1M Token, dass auch das Kontextfenster 1M Token umfasst?
Nicht unbedingt. Google hat in seinem Blogbeitrag ausdrücklich das **Ausgabelimit** genannt, das von 64K auf 1M steigt. Angaben zum Eingabekontextfenster wurden dagegen nicht veröffentlicht. Für das in einigen Medien genannte Eingabefenster von 1M gibt es bislang keine offizielle Quelle. Der GraphWalks-Test deckt den Bereich von 256K bis 1M ab und zeigt, dass Argon sehr lange Kontexte verarbeiten kann. Wie hoch das konkrete Limit ist, muss jedoch noch durch die offizielle Dokumentation bestätigt werden.
F3: Ist Gemini 4 Argon leistungsfähiger als GPT-6 Astra?
Das hängt von der jeweiligen Aufgabe ab. Bei DeepSWE, dem Vals Index, dem Rechtsagenten von Harvey und GraphWalks liegt Argon vorn, bei FrontierSWE v2 und Terminal-Bench 4.0 dagegen hinten. Im Artificial Analysis Intelligence Index schneiden beide insgesamt etwa gleich ab. Argons wichtigste Vorteile sind die niedrigere Halluzinationsrate und der günstigere Preis. Am zuverlässigsten ist ein Test mit den eigenen Geschäftsdaten. Über die Plattform APIYI apiyi.com lassen sich die Ergebnisse mehrerer Modelle über dieselbe Schnittstelle vergleichen.
F4: Warum heißt Argon nicht Gemini 4 Pro?
Google hat dazu keine offizielle Erklärung abgegeben. Argon ist das erste Modell der Gemini-Reihe mit einem Codenamen. Google hatte zuvor ursprünglich die Veröffentlichung von Gemini 3.5 Pro geplant, konzentrierte sich später jedoch ganz auf die Weiterentwicklung von Gemini 4. Wie die nachfolgenden Modelle der Gemini-4-Generation benannt werden, hat Google bislang ebenfalls nicht verraten.
Zusammenfassung
Gemini 4 Argon ist ein wichtiger Gegenangriff von Google im Wettbewerb um führende Modelle. Bei umfangreichen Softwareentwicklungsaufgaben, spezialisierten Agenten und Schlussfolgerungen mit sehr langem Kontext hat das Modell die Nase vorn. Das Ausgabelimit von 1 Million Tokens eröffnet neue Möglichkeiten für langwierige Aufgaben wie groß angelegte Code-Migrationen. Mit einer niedrigen Halluzinationsrate von 15 % und einem Einstiegspreis von 2 bzw. 10 US-Dollar ist Argon auch für Unternehmen interessant.
Allerdings ist Argon nicht in allen Bereichen führend: In Tests wie Terminal-Bench liegt das Modell weiterhin hinter der Konkurrenz. Auch bei den Gesamtwerten unabhängiger Bewertungen liegt es lediglich gleichauf mit GPT-6 Astra. Ein praktisches Problem bleibt zudem der gestaffelte Zugang: Bis die kostenpflichtige API offiziell verfügbar ist, können die meisten Entwickler Argon noch nicht direkt nutzen. Am sinnvollsten ist es derzeit, die eigene Architektur so aufzustellen, dass sich Modelle flexibel austauschen lassen, und einen eigenen Evaluierungsdatensatz vorzubereiten.
Wir empfehlen, Gemini-Modelle vorab über die Plattform APIYI apiyi.com einheitlich anzubinden. Sobald Argon offiziell verfügbar ist, können Sie dann umgehend testen, wie es sich in Ihrem Anwendungsfall bewährt.
Quellen:
- Ankündigung von Gemini 4 Argon im offiziellen Google-Blog: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Informationsseite zum Google-DeepMind-Fairwind-Programm: deepmind.google/fairwind-program
- Bericht von TechCrunch: techcrunch.com
- Bericht von Engadget: engadget.com
- Übersicht zu Benchmarks und Preisen von Gemini 4 Argon bei DataCamp: datacamp.com/blog/gemini-4-argon
Autor: APIYI Team | Aktuelle Entwicklungen bei führenden Großen Sprachmodellen im Blick. Weitere Informationen zur Anbindung und Evaluierung von KI-Modellen finden Sie bei APIYI apiyi.com.