Anmerkung des Autors: Auf Basis offizieller Demos und unabhängiger Tests von 智东西 und TOKRACE beleuchtet dieser Artikel die tatsächlichen Fähigkeiten von LongCat-2.5 bei der Umwandlung von Screenshots in Webseiten, bei interaktiven Seiten und bei der 3D-Generierung – einschließlich typischer Fehler und der Grenzen bei der Abnahme.
Meituan hat LongCat-2.5 am 2026-11-02 offiziell vorgestellt. Als eine der Kernfähigkeiten hebt das Unternehmen Visual Coding (visuelle Programmierung) hervor. Zu den gezeigten Beispielen gehören eine Flüssigkeitssimulation in Echtzeit, eine 3D-Darstellung des bronzenen Götterbaums von Sanxingdui und eine aus einem Foto generierte Einladungsseite für eine Veranstaltung. Viele Frontend-Entwickler stellen sich da als Erstes die Frage: Kann man dem Modell einen Designentwurf oder einen Webseiten-Screenshot geben und direkt eine auslieferbare Webseite erhalten?
Dieser Artikel wiederholt nicht einfach die offiziellen Werbeaussagen. Die offiziellen Demos zeigen ausgewählte Erfolgsgeschichten. In unabhängigen Tests entstanden dagegen sowohl sehr ausgereifte Ergebnisse als auch Projekte, deren Abmessungen um den Faktor 1000 danebenlagen. Wir stellen beide Arten von Belegen gegenüber und zeigen, welche Schlussfolgerungen sie stützen – und welche bisher nicht.
Das nehmen Sie mit: Sie erfahren, wie weit LongCat-2.5 beim Visual Coding kommt, anhand welcher fünf Kriterien Sie eine Webseite vor der Auslieferung prüfen sollten und welche Schritte eine menschliche Kontrolle erfordern.
LongCat-2.5: Die wichtigsten Fakten zur visuellen Programmierung
Hier sind zunächst die öffentlich bekannten Fakten zur visuellen Programmierung im Überblick. Die Angaben stammen aus dem offiziellen Technikblog von Meituan, der API-Dokumentation und Berichten zur Veröffentlichung. Die Modellgewichte standen zum Veröffentlichungszeitpunkt noch nicht zum Download bereit. „Die offizielle API ist verfügbar“ bedeutet also nicht, dass das Modell bereits Open Source ist.
| Information | Öffentlich bekannte Angaben |
|---|---|
| Offizielles Veröffentlichungsdatum | 2026-11-02 (die Preview-Version war seit 2026-09-25 auf der API-Plattform verfügbar) |
| Herausgeber | LongCat-Team von Meituan |
| Modellgröße | Insgesamt 1.6T Parameter, davon rund 48B pro Token aktiv; sparsame MoE-Architektur |
| Kontextfenster | 1,048,576 Tokens (rund 1M) |
| Visuelle Eingaben | Bilder in PNG, JPG, JPEG, WebP und GIF; Videos per URL |
| Ergebnisse zur visuellen Programmierung | Vision2Web 78.6, 3DCodeBench Text→3D 55.4 (offizielle Tabelle) |
| Schnittstellenformate | OpenAI-kompatibel und Anthropic-kompatibel |
| Open-Source-Status | Die Gewichte der finalen Version waren bei Veröffentlichung nicht verfügbar; laut offizieller Aussage sollen sie später bereitgestellt werden |
Wichtig: Die offizielle Dokumentation nennt die Analyse von Bildern und Videos als unterstützte Funktion. Das bedeutet nicht, dass LongCat-2.5 Schnittstellen zur Bilderzeugung oder Videogenerierung anbietet. Bilder und Videos aus Tests von Drittanbietern wurden mit Werkzeugen wie Blender oder einem Browser gerendert, nachdem das Modell den entsprechenden Code geschrieben hatte.
Screenshot-Reproduktion und Webseitengenerierung mit visueller Vorlage sind nicht dasselbe
Bevor wir über „Screenshot zu Webseite“ sprechen, müssen wir zwei Aufgaben unterscheiden. Die erste ist die Generierung anhand einer visuellen Vorlage: Das Modell erhält ein Foto einer Location oder ein Stimmungsbild sowie eine schriftliche Anforderung und gestaltet daraus eine Webseite im passenden Stil. Dabei darf es das Layout frei entwerfen – solange das Ergebnis zur gewünschten Atmosphäre passt, gilt die Aufgabe als erfüllt.
Die zweite ist die möglichst genaue Screenshot-Reproduktion: Hier erhält das Modell einen Screenshot einer bestehenden Webseite und soll Layout, Abstände, Schriftarten, Interaktionen und responsives Verhalten möglichst genau nachbilden. Die Abnahmekriterien sind deutlich strenger, denn jede Abweichung fällt auf. Das offizielle Beispiel einer Einladungsseite für eine Veranstaltung gehört zur ersten Kategorie. Derzeit gibt es nicht genügend unabhängige Beispiele, um die allgemeine Reproduktionsgenauigkeit von LongCat-2.5 bei der zweiten Aufgabe zu belegen. Erst recht lässt sich nicht behaupten, dass das Modell bereits pixelgenau reproduzieren kann.
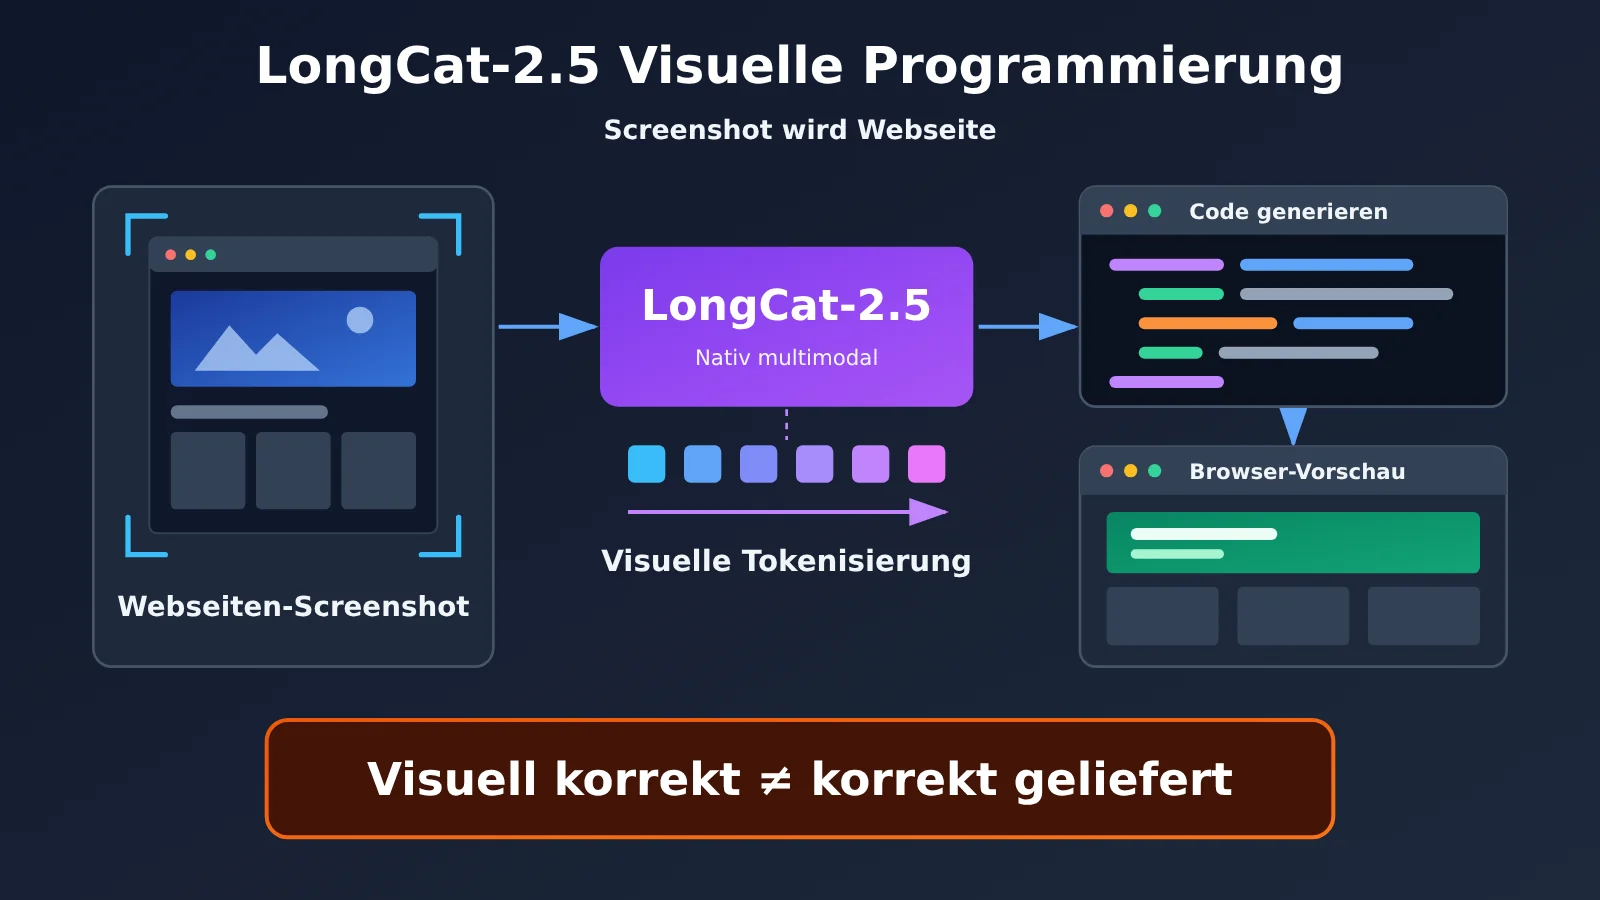
Der visuelle Token-Mechanismus von LongCat-2.5 im Überblick
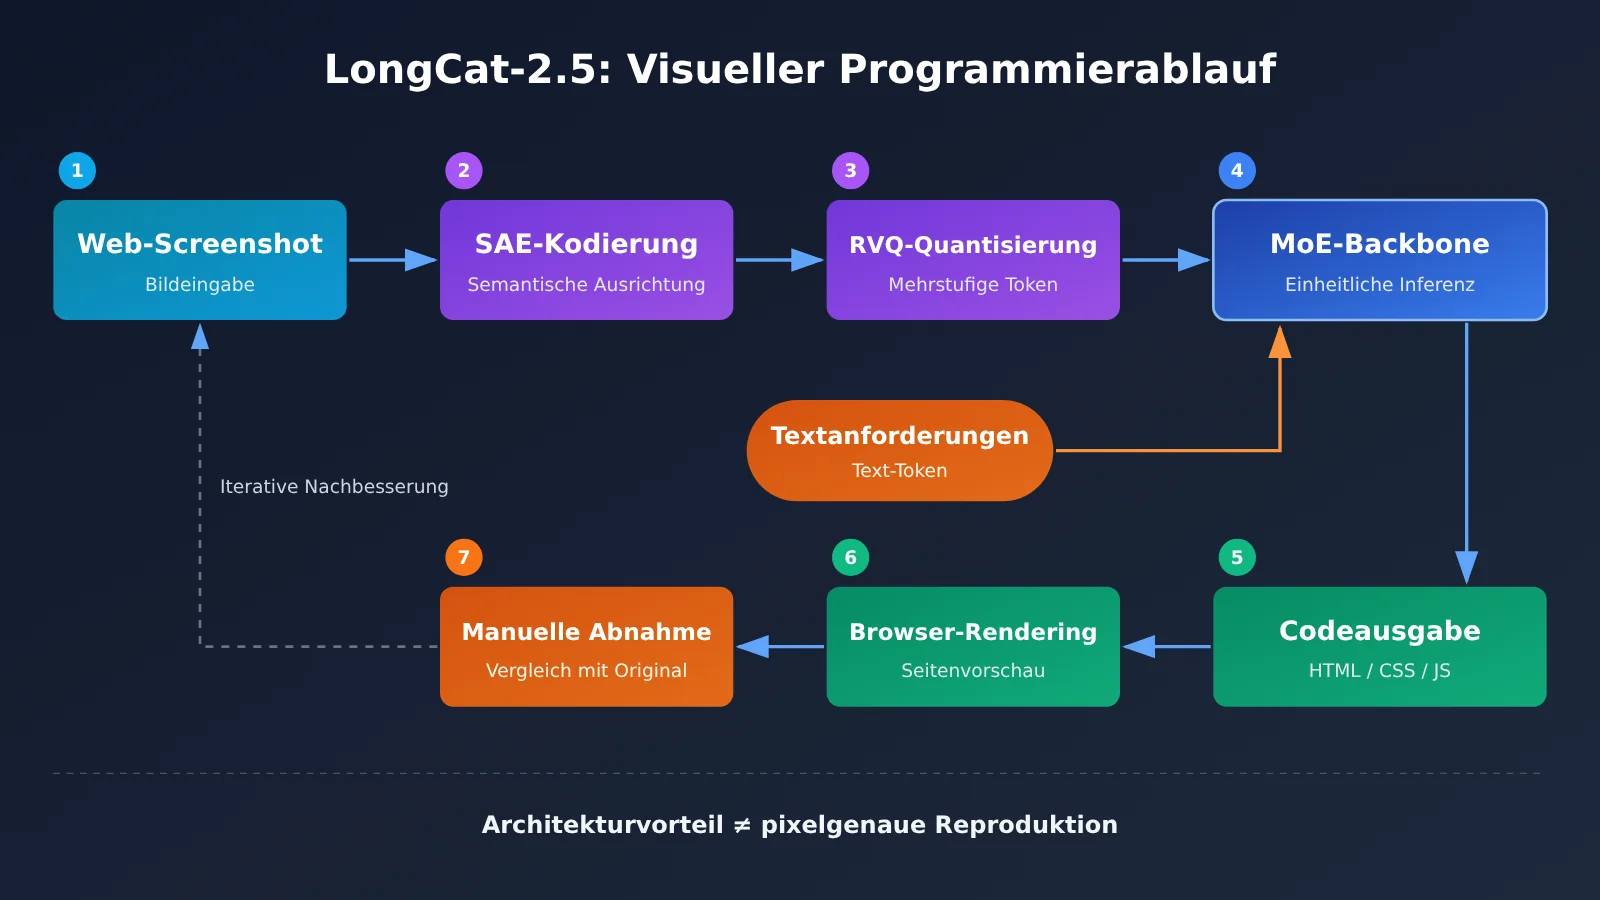
Die „native Multimodalität“ von LongCat-2.5 beruht auf der Art, wie das Modell Bilder verarbeitet. Laut den offiziellen Angaben extrahiert es zunächst mit SAE, einem semantischen Alignment-Encoder, visuelle Merkmale. Anschliessend codiert RVQ, eine residuale Vektorquantisierung, diese Merkmale in mehrstufige diskrete Token. Zusammen mit den Text-Token werden sie schliesslich im Backbone-Modell einheitlich verarbeitet.
Das Verfahren umfasst ausserdem die visuelle Diskretisierung in nativer Auflösung, die Offline-Vorberechnung visueller Token sowie das gemeinsame Lernen der Embeddings des visuellen Codebuchs und des Backbone-Modells. Für Entwickler lässt sich das so verstehen: Das Bild wird nicht erst in eine Textbeschreibung „übersetzt“ und dann an das Modell übergeben, sondern fliesst in einer nahezu nativen Form in die Verarbeitung und Codeerstellung ein. Der Architekturvorteil bildet allerdings nur die Grundlage für diese Fähigkeiten – er bedeutet nicht, dass sich jeder Screenshot exakt reproduzieren lässt.
Wie sind die Vision2Web-Ergebnisse von LongCat-2.5 einzuordnen?
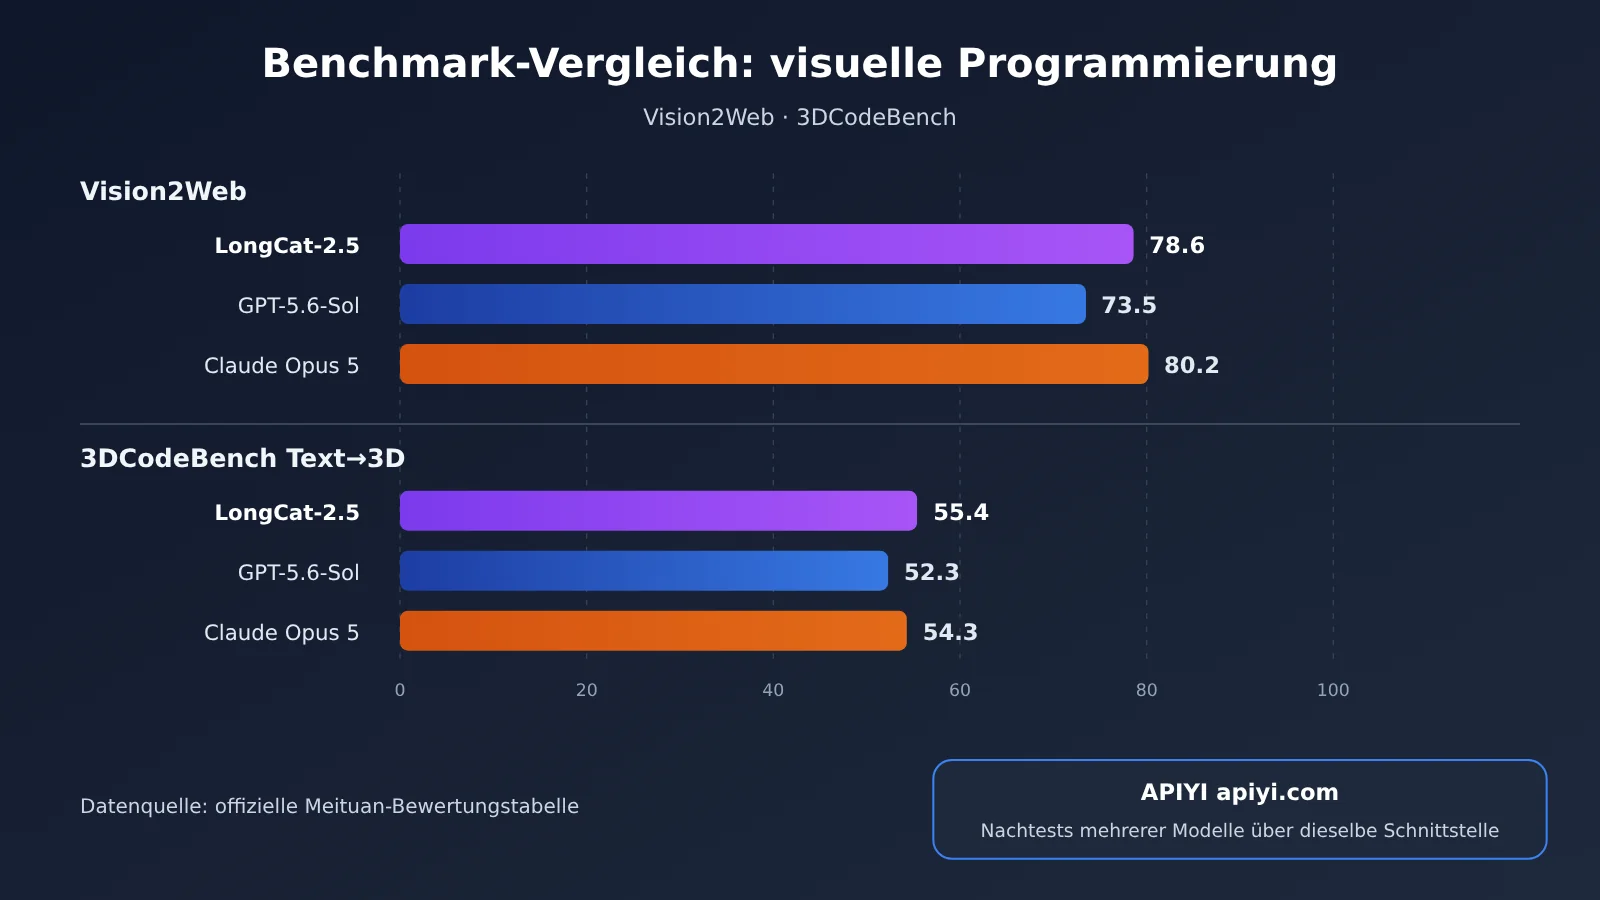
Meituan hat zwei Benchmarks veröffentlicht, die direkt mit visueller Programmierung zu tun haben. Alle Daten stammen aus der offiziellen Bewertungstabelle. Verglichen wird LongCat-2.5 nur mit den beiden anderen Modellen in dieser Tabelle, nicht mit allen bis zum 2026-11-03 verfügbaren aktuellen Modellen.
| Benchmark | LongCat-2.5 | GPT-5.6-Sol | Claude Opus 5 | Erläuterung |
|---|---|---|---|---|
| Vision2Web | 78.6 | 73.5 | 80.2 | Claude Code v2.1.7, 256K Sequenzlänge, top_k=50 |
| 3DCodeBench Text→3D | 55.4 | 52.3 | 54.3 | Generierung von 3D-Code aus Text |
| DeepSWE v1.1 (Referenz) | 64.6 | 72.7 | 68.8 | Behebung von Problemen in realen Software-Repositories, mini-swe-agent |
LongCat-2.5 liegt bei Text→3D in der offiziellen Vergleichstabelle vorn. Bei Vision2Web erzielt es 5.1 Punkte mehr als GPT-5.6-Sol, aber 1.6 Punkte weniger als Claude Opus 5. DeepSWE als Referenz hinzuzuziehen, ist sinnvoll: Visuelle Programmierung muss sich letztlich auch im Anwendungscode bewähren. Bei der Behebung von Problemen in realen Software-Repositories liegt LongCat-2.5 noch 8.1 Punkte hinter GPT-5.6-Sol.
Noch wichtiger: Ein Benchmark-Ergebnis entspricht weder einer pixelgenauen Umsetzung noch einer Quote bestandener Produktabnahmen. LongCat-2.5 wurde standardmäßig mit aktiviertem Denkmodus, temperature=1.0 und top_p=0.95 getestet. Einige Ergebnisse der verschiedenen Modelle stammen aus öffentlichen Berichten, andere aus Tests von Meituan selbst. Die Testbedingungen sind also nicht vollständig einheitlich.
💡 Empfehlung zur Auswahl: Öffentliche Bestenlisten dienen nur als Anhaltspunkt. Wirklich aussagekräftig ist ein Test mit Ihren eigenen Screenshots und Anforderungen. Über eine OpenAI-kompatible Sammelschnittstelle wie APIYI apiyi.com können Sie mit demselben Testskript die Ausgaben mehrerer visueller Modelle vergleichen und sich dann für ein Hauptmodell entscheiden.
LongCat-2.5 im Vergleich: Erfolge und Misserfolge beim visuellen Programmieren
Die folgenden Beispiele stammen aus drei Quellen. Die offizielle Präsentation zeigt ausgewählte Erfolgsgeschichten, während 智东西 und TOKRACE unabhängige Tests mit wenigen Beispielen durchgeführt haben. Die Aussagekraft der drei Quellen unterscheidet sich entsprechend.
| Quelle | Aufgabe | Konkrete Anforderung | Beobachtetes Ergebnis |
|---|---|---|---|
| Offizielle Präsentation | Echtzeit-Fluid-Simulation | Interaktive Webseite mit Fluid-Simulation | Mausklicks und Ziehen lösen Fluideffekte aus |
| Offizielle Präsentation | Webseite für eine Veranstaltungseinladung | Foto des Veranstaltungsorts + Anforderungen in natürlicher Sprache | Passender Stil, mit Anmeldeformular, Listenverwaltung und Export |
| 智东西 | Animation eines Pelikans auf einem Fahrrad | HTML-Animation | Motiv klar erkennbar und einheitlicher Stil, Schal stellenweise falsch positioniert |
| TOKRACE | SVG-Veranstaltungsplakat auf Chinesisch | 6 vorgegebene chinesische Textabschnitte beibehalten | Alle 6 Abschnitte korrekt und jeweils einmal vorhanden, übersichtliches Layout |
| TOKRACE | SVG-Diagramm mit Quartalsdaten | Balkendiagramm anhand der Daten erstellen | Proportionen und Gesamtwert 84 korrekt, aber Geschäftsjahr, Dollar-Einheit und Datenquelle erfunden |
| TOKRACE | 3D-Modell eines Planetengetriebes | Abmessung von 140 mm und Lieferung eines Videos | Zahnflanken fehlerhaft, 140 m statt 140 mm angegeben, Video nicht geliefert |
| TOKRACE | Raummodell einer Zweizimmerwohnung | Modellierung der Innenraumaufteilung | Keine Öffnungen für Türen und Fenster, Bett und Trennwand überschneiden sich, zweites Schlafzimmer falsch ausgerichtet |
Offizielle Beispiele: Visuelle Referenzen und Interaktionslogik erfolgreich umgesetzt
Der offizielle Blog stellt acht End-to-End-Aufgaben vor. Direkt mit Webseiten zu tun haben die Flüssigkeitssimulation, eine 3D-Darstellung des bronzenen Götterbaums von Sanxingdui, ein interaktives Stadtmodell, ein visuelles Design im chinesischen Stil und eine Einladungsseite für eine Veranstaltung. Beim Sanxingdui-Beispiel müssen 3D-Struktur, Materialien sowie Dreh- und Zoominteraktionen zusammenspielen. Die Einladungsseite soll die Atmosphäre eines Fotos in einen Seitenstil übertragen und Anmeldung, Listenverwaltung und Tabellenexport ermöglichen.
Diese Beispiele zeigen, dass LongCat-2.5 visuelle Anforderungen in ausführbaren Frontend-Code umsetzen kann. Sie belegen aber weder, dass sich „alle interaktiven Webseiten in einem Durchgang fertigstellen lassen“, noch, dass die Performance der Seiten bereits den Anforderungen eines kommerziellen Launchs genügt.
Praxistest von 智东西: Insgesamt gelungen, einzelne Details brauchen Nacharbeit
智东西 ließ LongCat-2.5 am 2026-11-02 eine HTML-Animation eines Pelikans auf einem Fahrrad erzeugen. Die Reporterin beziehungsweise der Reporter stellte fest, dass die Animation insgesamt weitgehend fertiggestellt war: Das Hauptmotiv war klar erkennbar, der Stil einheitlich und die Darstellung detailreich. Lediglich die Position des Schals wich an einer Stelle leicht ab.
Bei einer weiteren Aufgabe sollte das Modell eine PowerPoint-Präsentation zu Amazons Quartalszahlen für das dritte Quartal erstellen. Das Analysegerüst war vollständig und enthielt Trend- und Strukturdiagramme sowie Risikohinweise. Bei einem ersten Abgleich fand die Redaktion keine offensichtlichen Datenfehler. Die Probleme lagen vor allem in der Darstellung: Einige Folien waren zu dicht gepackt, die Schrift teils zu klein und einzelne Schlussfolgerungen zu absolut formuliert. Das ist auch für die Webentwicklung relevant: Inhaltlich weitgehend korrekte Ergebnisse sind nicht automatisch gut lesbar oder sinnvoll gestaltet.
TOKRACE-Praxistest: Je klarer die Vorgaben, desto höher die Erfolgsquote
TOKRACE band LongCat-2.5 in Claude Code ein und bearbeitete mit Blender und einem Browser 15 kreative Aufgaben: sechs 3D-Aufgaben, vier Wissensvideos, vier statische SVGs und eine Animation. Die erfolgreichen Fälle hatten eines gemeinsam: klare Vorgaben und eine einfache Struktur.
- Parametrisches Bücherregal: Die 0,8-m-Version mit drei Fächern und die 1,0-m-Version mit vier Fächern hatten die richtigen Abmessungen. Die Plattenstärke von 18 mm entsprach den Vorgaben, und alle sechs Ansichten wurden geliefert. Dauer: rund 36 Minuten, 47 Anfragen und 69.708 ausgegebene Token.
- Chinesisches Veranstaltungsplakat: In rund drei Minuten und mit zehn Anfragen fertiggestellt. Alle sechs chinesischen Textabschnitte blieben korrekt erhalten, und die Symbole drängten den Text nicht zusammen.
- Viersekündige Radfahranimation: Räder, Pedale und Beine bewegten sich synchron. Bei Stichproben an 40 Zeitpunkten betrug die maximale Abweichung zwischen Fuß und Pedal rund 0,19 px. Allerdings war der Kontrast der hellen Hauptfigur etwas zu gering.
Die fehlgeschlagenen Fälle zeigen dagegen, welche Probleme bei der visuellen Programmierung leicht übersehen werden. Beim Planetengetriebe waren die drei Planetenräder zwar weitgehend richtig positioniert, doch aus 140 mm wurden 140 m – ein Einheitenfehler um den Faktor 1.000. Auch das geforderte Video wurde nicht geliefert. Das Modell einer Zweizimmerwohnung „sah wie ein Wohnzimmer aus“, wies aber strukturelle Fehler auf: Für Türen und Fenster fehlten die Öffnungen, Bett und Trennwand überschnitten sich, und einige Kameraperspektiven waren durch Wände verdeckt. Bei einer SVG-Uhr standen die Zeiger für 9:41 im richtigen Winkel, aber die Ziffern überlappten mit den dicken Skalenstrichen.
TOKRACE verglich auch den Denkmodus: Mit aktiviertem Denkmodus war die Anordnung mancher Bilder klarer, allerdings konnten die Kosten für die Schlussfolgerung und die Anfragen deutlich steigen. Beim Vergleich einer SVG mit einem radfahrenden Pelikan entstand ohne Denkmodus bereits bei der ersten Anfrage ein Bild; mit Denkmodus erst bei der fünften. Das ist nur die Beobachtung einer einzelnen Aufgabe und lässt keinen Rückschluss auf die durchschnittliche Erfolgsquote mit oder ohne Denkmodus zu.
Fünf Abnahmekriterien für visuelle Programmierung mit LongCat-2.5
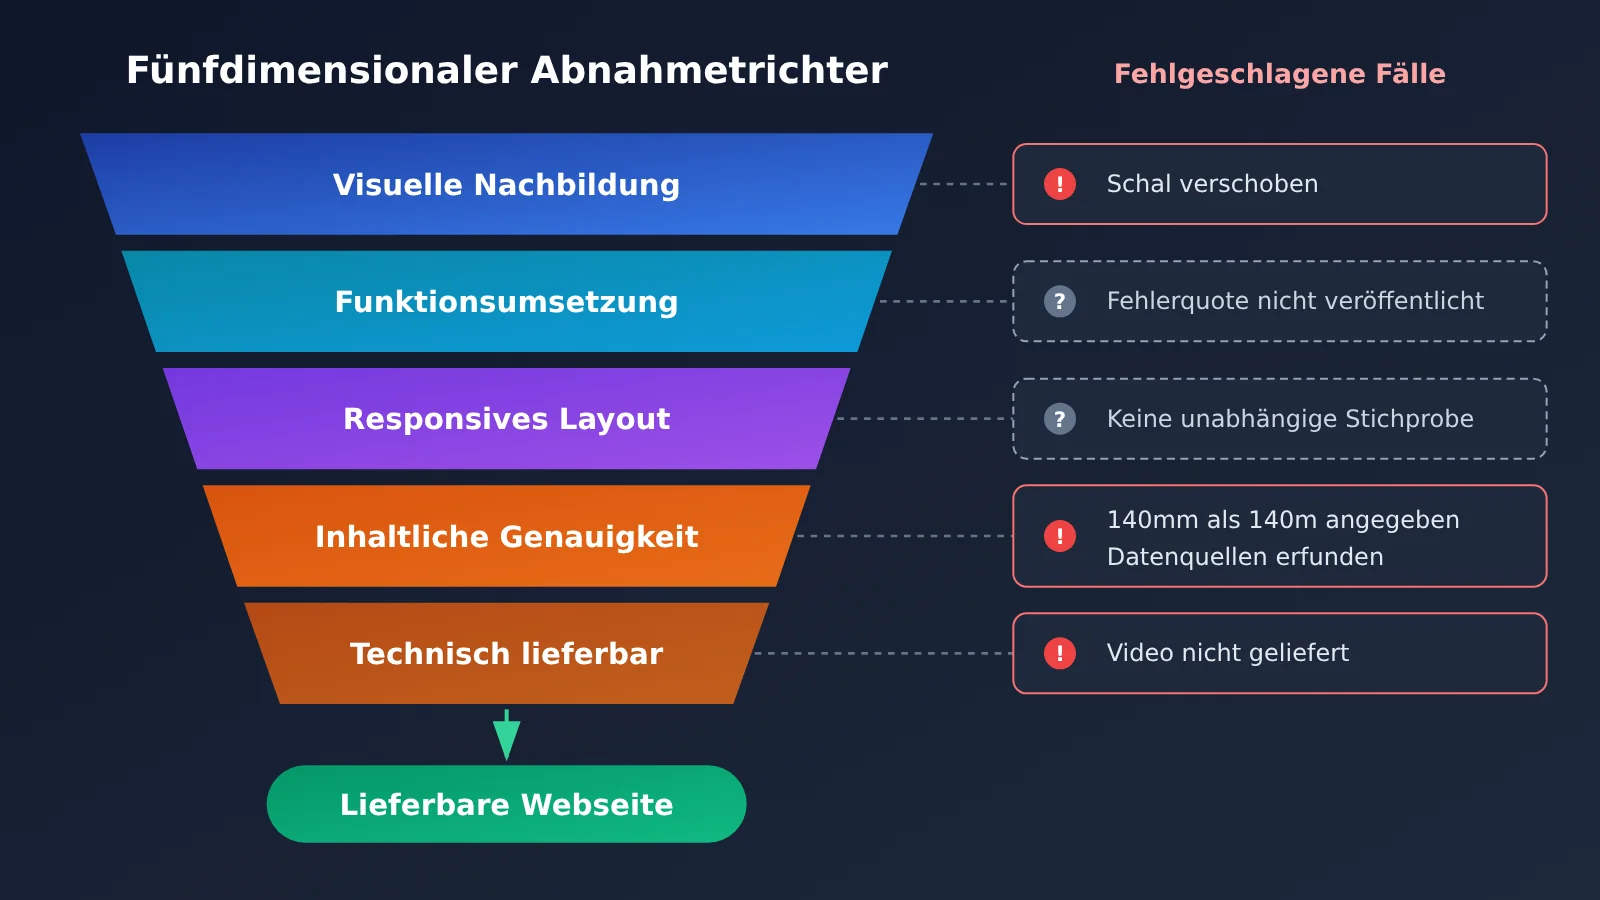
Die Beispiele oben zeigen: Zwischen „sieht richtig aus“ und „ist lieferfähig“ liegen mindestens vier Hürden. Der folgende Abnahmerahmen fasst technische Prüfmethoden aus den Beispielen zusammen. Er ist kein offizieller Bewertungsstandard von LongCat.
| Abnahmekriterium | Was wird geprüft? | Im Beispiel aufgedecktes Risiko | Empfohlene Prüfung |
|---|---|---|---|
| Visuelle Umsetzung | Farben, Layout, Schriftarten, Abstände, Grafiken | Verschobener Schal, überlappende Zahlen und Skalenmarkierungen | Mit dem Originalbild überlagern und Screenshots Bereich für Bereich vergleichen |
| Funktionalität | Klicks, Navigation, Formulare, Zustandsänderungen | In der offiziellen Präsentation wurde keine Fehlerquote veröffentlicht | Den Hauptablauf manuell durchgehen und einfache E2E-Tests schreiben |
| Responsives Layout | Überläufe und Überdeckungen bei verschiedenen Bildschirmbreiten | Bisher fehlen unabhängige Beispiele | Mindestens die drei Breakpoints für Smartphone, Tablet und Desktop prüfen |
| Inhaltliche Genauigkeit | Zahlen, Einheiten, Texte, Quellen | Erfundenes Geschäftsjahr und erfundene Datenquellen, 140mm als 140m angegeben | Alle Texte und Einheiten einzeln abgleichen |
| Technische Lieferfähigkeit | Installation der Abhängigkeiten, Ausführung, Build und Vollständigkeit der Dateien | Video nicht geliefert, lange Aufgabe durch Zeitüberschreitung abgebrochen | Lieferumfang anhand einer Checkliste Punkt für Punkt prüfen |
Bei diesen fünf Kriterien lässt man sich von KI-generierten Ergebnissen am leichtesten über die inhaltliche Genauigkeit und die technische Lieferfähigkeit hinwegtäuschen. Wenn eine Seite schöne Farben und flüssige Animationen hat, übersieht man leicht eine zusätzlich erfundene Datenquelle oder eine fehlende Datei. Beim Umsetzen eines Screenshots in eine Webseite empfiehlt es sich, „Was hat das Modell zusätzlich eingefügt?“ als eigenen Prüfpunkt aufzunehmen.
LongCat-2.5 per API für die Umsetzung von Screenshots in Webseiten testen
Wenn Sie LongCat-2.5 mit eigenen Designvorlagen testen möchten, können Sie im OpenAI-kompatiblen Format „Bild + Textanforderungen“ senden. Bilder lassen sich als Base64 oder über eine öffentliche URL übermitteln. Ein einzelnes Bild darf maximal 10 MB groß sein, pro Anfrage sind höchstens 50 Bilder möglich. Überschreitet das ursprüngliche Seitenverhältnis 200:1, wird ein Fehler ausgegeben. Lange Screenshots müssen Sie daher vorher aufteilen.
Wichtig: Zum Zeitpunkt der Recherche für diesen Artikel (2026-11-03) war noch nicht bestätigt, dass LongCat-2.5 auf der Plattform APIYI verfügbar ist. Ob das Modell inzwischen verfügbar ist, entnehmen Sie bitte der Modellliste von APIYI. Das folgende Skript verwendet das OpenAI-Standardformat. Sie können damit zunächst ein bereits auf der Plattform verfügbares Vision-Modell anbinden und den Ablauf testen. Sobald LongCat-2.5 verfügbar ist, müssen Sie nur den Modellnamen ersetzen.
Minimalbeispiel
import base64, openai

client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")
img = base64.b64encode(open("screenshot.png", "rb").read()).decode()

resp = client.chat.completions.create(
    model="LongCat-2.5",  # Den tatsächlichen Namen aus der Modellliste von APIYI verwenden
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "按截图复刻为单文件 HTML,只用截图中出现的文字,不要补充任何数据"},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{img}"}}
    ]}],
)
print(resp.choices[0].message.content)
Vollständigen Implementierungscode anzeigen (mit Abnahmekriterien und Wiederholungsversuchen)
import base64
import time
import openai
from pathlib import Path

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

SYSTEM_PROMPT = """你是前端工程师。根据截图生成单文件 HTML(内联 CSS/JS)。
硬性要求:
1. 只使用截图中可见的文字,禁止补充数据、单位、来源或年份
2. 无法辨认的文字用 [待确认] 占位
3. 支持 375px / 768px / 1440px 三个断点
4. 代码末尾用注释列出:你做的假设、未实现的交互"""

def encode_image(path: str) -> str:
    data = Path(path).read_bytes()
    if len(data) > 10 * 1024 * 1024:
        raise ValueError("单张图片超过 10MB,请压缩后再试")
    return base64.b64encode(data).decode()

def screenshot_to_html(path: str, model: str = "LongCat-2.5",
                       retries: int = 3) -> str:
    img = encode_image(path)
    messages = [
        {"role": "system", "content": SYSTEM_PROMPT},
        {"role": "user", "content": [
            {"type": "text", "text": "请复刻这张网页截图。"},
            {"type": "image_url",
             "image_url": {"url": f"data:image/png;base64,{img}"}},
        ]},
    ]
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=model, messages=messages, max_tokens=16000
            )
            return resp.choices[0].message.content
        except openai.RateLimitError:
            time.sleep(2 ** i)  # Exponentielles Backoff bei Rate-Limit-Fehler 429
    raise RuntimeError("多次重试失败")

if __name__ == "__main__":
    html = screenshot_to_html("screenshot.png")
    Path("output.html").write_text(html, encoding="utf-8")
    print("已生成 output.html,请按五维清单验收")
Zwei Entscheidungen im Code sind besonders wichtig. Erstens verbietet die System-Eingabeaufforderung ausdrücklich, Daten, Einheiten und Quellen hinzuzufügen. Das schützt direkt vor dem Problem aus dem TOKRACE-Diagrammbeispiel, bei dem Geschäftsjahre und Datenquellen erfunden wurden. Zweitens soll das Modell seine Annahmen am Ende des Codes auflisten. So lassen sich bei der manuellen Prüfung die „geratenen“ Stellen schnell finden. Die genaue Struktur einer Anfrage im Denkmodus entnehmen Sie bitte der offiziellen Parameterdokumentation von LongCat. Übernehmen Sie nicht einfach die Reasoning-Parameter anderer Modelle.
🚀 Schnellstart: Holen Sie sich zunächst auf APIYI apiyi.com das kostenlose Testguthaben für neue Nutzer. Testen Sie den gesamten Ablauf mit 3-5 Screenshots unterschiedlicher Komplexität – etwa einer Landingpage, einer Formularseite und einem Daten-Dashboard. Bewerten Sie die Ergebnisse anhand der Checkliste mit fünf Dimensionen, bevor Sie entscheiden, ob Sie den Ablauf in Ihren regulären Workflow aufnehmen.
Analyse der Auswirkungen von LongCat-2.5 auf die visuelle Programmierung
Auswirkungen auf Frontend-Entwickler
- Deutlicher Zeitgewinn beim Prototyping: Aus visuellen Vorlagen lassen sich schnell interaktive Seiten erzeugen. Das eignet sich für Konzeptpräsentationen, erste Entwürfe von Aktionsseiten und interne Tools. Die offizielle Einladungsseite für eine Veranstaltung und das TOKRACE-Poster sind Beispiele dafür.
- Der Prüfaufwand entfällt nicht: Das Modell kann Seiten schreiben, die „richtig aussehen“. Fehler bei Einheiten, Texten und strukturellen Zusammenhängen sind jedoch schwerer zu erkennen. Die Rolle der Entwickler verschiebt sich daher teilweise vom „Code schreiben“ zum „Vorgaben definieren und Ergebnisse prüfen“.
- Je klarer die Vorgaben, desto besser: Im Bücherregal-Beispiel waren die Ergebnisse gut, nachdem klare Abmessungen und eine Liste der zu liefernden Ergebnisse vorgegeben wurden. Bei vagen Anforderungen interpretiert das Modell dagegen eher frei.
Auswirkungen auf AI-Coding-Workflows
Die offizielle Dokumentation zu LongCat-2.5 enthält Anleitungen zur Anbindung von Tools wie Claude Code, Codex, OpenCode und Cline. Meist müssen nur Base URL, API-Schlüssel und Modellname geändert werden. Damit lässt sich visuelle Programmierung in bestehende Agent-Workflows integrieren, statt dafür ein separates Chatfenster zu öffnen. Ein kompatibles API-Format bedeutet allerdings nicht, dass alle Funktionen und Parameter der Tools vollständig übereinstimmen. Bei langen Aufgaben kann es zudem zu Zeitüberschreitungen oder Abbrüchen kommen – einige Videoaufgaben von TOKRACE wurden deshalb nicht abgeschlossen.
Bei den Kosten nennt der Anbieter aktuell zeitlich begrenzte Angebotspreise von ¥2.00 für nicht im Cache gespeicherte Eingaben, ¥0.04 für im Cache gespeicherte Eingaben und ¥8.00 für Ausgaben – jeweils pro Million Token. Massgeblich sind die Angaben auf der offiziellen Plattform und die tatsächliche Abrechnung. Bei mehrstufigen Aufgaben wie dem Bücherregal-Beispiel umfasst die Ausgabe fast 70.000 Token. Wer visuelle Programmieraufgaben in grösserem Umfang plant, sollte daher Anfragenzahl und Ausgabelänge stärker beachten als den Einzelpreis.
Grenzen von LongCat-2.5 bei der Umwandlung von Screenshots in Webseiten
Auf Grundlage aller vorliegenden Ergebnisse lassen sich die Einsatzszenarien in drei Stufen einteilen:
| Stufe | Typische Szenarien | Empfehlung |
|---|---|---|
| Direkt nutzbar | Erste Entwürfe für Aktionsseiten, SVG-Poster, einfache interaktive Animationen, interne Demoseiten | Nach der Generierung visuelle Darstellung und Texte prüfen |
| Manuelle Prüfung erforderlich | Nachbau veröffentlichter Webseiten anhand von Screenshots, Datendiagramme, responsive Landingpages, mehrstufige Formulare | Anhand der Checkliste mit fünf Prüfdimensionen kontrollieren, insbesondere Daten und Einheiten |
| Nicht empfehlenswert, sich darauf zu verlassen | Hochpräzise technische Abmessungen, räumliche Strukturen, Markenseiten mit pixelgenauer Wiedergabe, lange unbeaufsichtigte Aufgaben | Nur für Entwürfe einsetzen; das Endergebnis von Menschen erstellen lassen |
💰 Kostenempfehlung: Visuelle Programmierung erfordert oft mehrere Iterationen. Testen Sie zunächst eine kleine Anzahl von Screenshots, um den durchschnittlichen Token-Verbrauch pro Seite zu ermitteln. APIYI apiyi.com bietet nutzungsbasierte Abrechnung und eine einheitliche Rechnung. So lassen sich die Kosten pro Seite zwischen verschiedenen Modellen leichter vergleichen.
Häufige Fragen (FAQ)
Q1: Kann LongCat-2.5 aus einem Screenshot direkt eine vollständige Webseite erstellen?
Es kann eine lauffähige Webseite erzeugen, bei „vollständig und auslieferungsbereit“ sind aber Abstriche nötig. Offizielle Demonstrationen und Tests von Drittanbietern zeigen, dass es visuelle Vorlagen in interaktiven Frontend-Code umsetzen kann. Es gibt bislang jedoch keine unabhängigen Stichproben, die eine allgemeine Genauigkeit bei der Nachbildung von Screenshots belegen. Auch von einer pixelgenauen Umsetzung kann keine Rede sein.
Q2: Wie schneidet LongCat-2.5 bei Vision2Web im Vergleich zu Claude Opus 5 ab?
In der offiziellen Tabelle erreicht LongCat-2.5 einen Wert von 78,6, Claude Opus 5 liegt bei 80,2 und GPT-5.6-Sol bei 73,5. Bei Text→3D liegt LongCat-2.5 vorn, bei Vision2Web aber noch knapp hinter Claude Opus 5. Die Daten stammen von Meituan, und die Testbedingungen sind nicht vollständig einheitlich. Am besten testest du die Modelle daher mit deinen eigenen Aufgaben.
Q3: Welche Fehler treten bei LongCat-2.5 am häufigsten bei der visuellen Programmierung auf?
Der TOKRACE-Test zeigt vor allem vier Fehlerarten: falsche Einheiten (140mm wird zu 140m), Fehler in der räumlichen Struktur (Bett und Trennwand überlappen), erfundene Inhalte (ein Diagramm enthält eine nicht vorhandene Datenquelle) und unvollständige Ergebnisse (ein angefordertes Video wird nicht erzeugt). Visuell fallen diese Probleme oft nicht sofort auf und müssen gezielt geprüft werden.
Q4: Kann ich LongCat-2.5 über APIYI aufrufen?
Stand 2026-11-03 ist noch nicht bestätigt, dass LongCat-2.5 auf der Plattform APIYI verfügbar ist. Massgeblich ist die aktuelle Modellliste auf APIYI unter apiyi.com. Du kannst zunächst mit dem OpenAI-kompatiblen Skript aus diesem Artikel und einem bereits verfügbaren visuellen Modell den Abnahmeprozess durchspielen. Sobald LongCat-2.5 verfügbar ist, musst du nur den Modellnamen austauschen.
Q5: Liefert der Denkmodus beim Umsetzen von Screenshots in Webseiten bessere Ergebnisse?
Eine allgemeingültige Antwort gibt es nicht. TOKRACE beobachtete, dass einige Layouts mit aktiviertem Denkmodus übersichtlicher waren, die Kosten aber deutlich steigen können. Beim SVG-Vergleich mit einem Pelikan entstand das Bild dagegen ohne Denkmodus schon beim ersten Versuch. Am besten testest du auf APIYI unter apiyi.com dieselben Screenshots mit und ohne Denkmodus und entscheidest anhand der tatsächlichen Erfolgsquote und des Token-Verbrauchs.
Q6: Kann LongCat-2.5 Bilder oder Videos erzeugen?
Die offizielle API unterstützt das Verständnis von Bildern und Videos, nicht aber deren Erzeugung. Bilder, Videos und 3D-Szenen in Tests von Drittanbietern entstanden, indem das Modell Code schrieb, der anschliessend von Browsern, Blender oder anderen Tools gerendert wurde. Das ist keine native Bilderzeugungsfähigkeit des Modells.
Die wichtigsten Punkte zu Visual Programming mit LongCat-2.5
- Leistungsprofil: LongCat-2.5 kann visuelle Vorlagen in ausführbaren Webseitencode umwandeln, reproduziert Screenshots aber nicht zwangsläufig pixelgenau.
- Offizielle Ergebnisse: Vision2Web 78.6, knapp hinter Claude Opus 5; Text→3D 55.4, an der Spitze der offiziellen Vergleichstabelle.
- Was gut funktioniert: Aufgaben mit klaren Vorgaben und einfachen Strukturen, etwa Poster-SVGs und parametrische Bücherregale.
- Typische Fehlerquellen: Maßeinheiten, räumliche Beziehungen, erfundene Inhalte und unvollständige Ergebnisse.
- Abnahme: Visuelle Übereinstimmung, Funktionalität, responsives Verhalten, Inhaltsgenauigkeit und technische Lieferfähigkeit einzeln prüfen.
- Einstieg: Mit einem OpenAI-kompatiblen Skript lässt sich bei APIYI apiyi.com ein Testablauf einrichten. Ob LongCat-2.5 verfügbar ist, zeigt die Modellliste.
Fazit
Die wichtigsten Erkenntnisse zur Umwandlung von Screenshots in Webseiten mit LongCat-2.5:
- Prototypen ja, direkte Auslieferung nicht unbedingt: Offizielle Beispiele und unabhängige Tests belegen die Fähigkeiten beim Visual Programming. Zwischen einem Screenshot und einer produktionsreifen Seite liegt aber noch ein deutlicher Abstand.
- Ein passendes Aussehen ist nur die erste Hürde: Interaktionen, responsives Verhalten, Inhaltsgenauigkeit und technische Vollständigkeit müssen separat geprüft werden. Besonders leicht übersieht man dabei, was das Modell zusätzlich eingefügt hat.
- Klare Vorgaben sorgen für stabilere Ergebnisse: Konkrete Abmessungen, Texte, Breakpoints und eine Liefer-Checkliste helfen. Wer in der Eingabeaufforderung zusätzliche Daten ausdrücklich untersagt, kann Fehler durch freie Ergänzungen deutlich reduzieren.
Wenn Sie Visual Programming in Ihre tägliche Entwicklung integrieren möchten, testen Sie es zunächst mit einigen echten Screenshots aus Ihrem Arbeitsalltag. Legen Sie den Einsatzbereich anschließend anhand der drei im Artikel beschriebenen Abstufungen fest. Über APIYI apiyi.com können Sie die Leistung mehrerer visueller Modelle über eine einheitliche Schnittstelle vergleichen. Die Plattform bietet neuen Nutzern ein kostenloses Guthaben für Tests mit geringem Kostenaufwand.
📚 Quellen
- Offizieller LongCat-2.5-Technikblog: Modellarchitektur, Benchmarks und offizielle Anwendungsbeispiele
- Link:
longcat.ai/blog/longcat-2.5 -
Hinweis: Originalquelle für die Ergebnisse und Evaluierungsbedingungen von Vision2Web und 3DCodeBench
-
Blog des Meituan-Technikteams: Technische Erläuterungen zu visuellen Token in LongCat-2.5
- Link:
tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html -
Hinweis: Einführung in visuelle Kodierungsmechanismen wie SAE und RVQ
-
LongCat-Schnittstellendokumentation zur visuellen Verarbeitung: Einschränkungen für Bild- und Videoeingaben
- Link:
longcat.ai/platform/docs/image-video-understanding -
Hinweis: Einschränkungen für Bildformat, Größe, Anzahl und Seitenverhältnis
-
Praxistest von Zhidongxi: Tests mit einer Pelikan-Animation und einer PowerPoint-Präsentation zu Geschäftszahlen
- Link:
tech.ifeng.com/c/8xjHpT7wJEN -
Hinweis: Erfahrungen mit der veröffentlichten Version aus Mediensicht
-
TOKRACE-Test der veröffentlichten Version: Dokumentation von 15 kreativen Aufgaben
- Link:
www.tokrace.com/zh-CN/guides/longcat-2-5-release - Hinweis: Enthält Originalbilder, Projekte und Ausführungsprotokolle sowie erfolgreiche und fehlgeschlagene Beispiele
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Website apiyi.com. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.